
Бірнеше апта бұрын High режиміндегі Opus 5.5 қарапайым тапсырмаларда кейде қателесіп, үйреншікті «Кешіріңіз, бұл менің қателігім» деген жауаптар бере бастағанын байқадым. Жеке әсерім ештеңені дәлелдемейді, сондықтан басқа пайдаланушылардың пікірін іздедім.
Claude Code қауымдастығында Anthropic модельдерді шығарғаннан кейін жасырын нашарлата ма, әлде агенттік жүйедегі өзгерістер модель қабілетінің төмендеуі ретінде қабылдана ма деген пікірталас жүріп жатыр. Reddit зерттеушілері жергілікті журналдардан сервер конфигурацияларының идентификаторларын тауып, оларды модель мінез-құлқындағы өзгерістермен байланыстыруға тырысты.
Пайдаланушылар жауаптарды, токен шығынын және эксперименттік параметр қосылған және қосылмаған жағдайларды салыстырды. LiveNerf Opus 5.5-те елеулі регрессия таппады, бірақ өз тексерісі тест сезімталдығының шектеулі екенін көрсетті: ол Opus 5 пен Opus 5.5-ті сенімді ажырата алмады. Сонымен бірге Anthropic дистилляциядан қорғауды және қолжетімділікті бақылауды күшейтіп жатыр, ал қаржылық құжаттар IPO алдындағы есептеу шығындарын көрсетеді. Бұлардың қайсысы байланысты және өз аккаунтыңызды қалай тексеруге болады?
Күдіктен эксперименттік ID-лерге дейін
Қараша басында Reddit қолданушысы DerAlbi «The nerf is real» жазбасын жариялап, Claude Code жергілікті файлдарындағы эксперименттік идентификаторларды сессия тарихымен салыстыруға болатынын атап өтті.
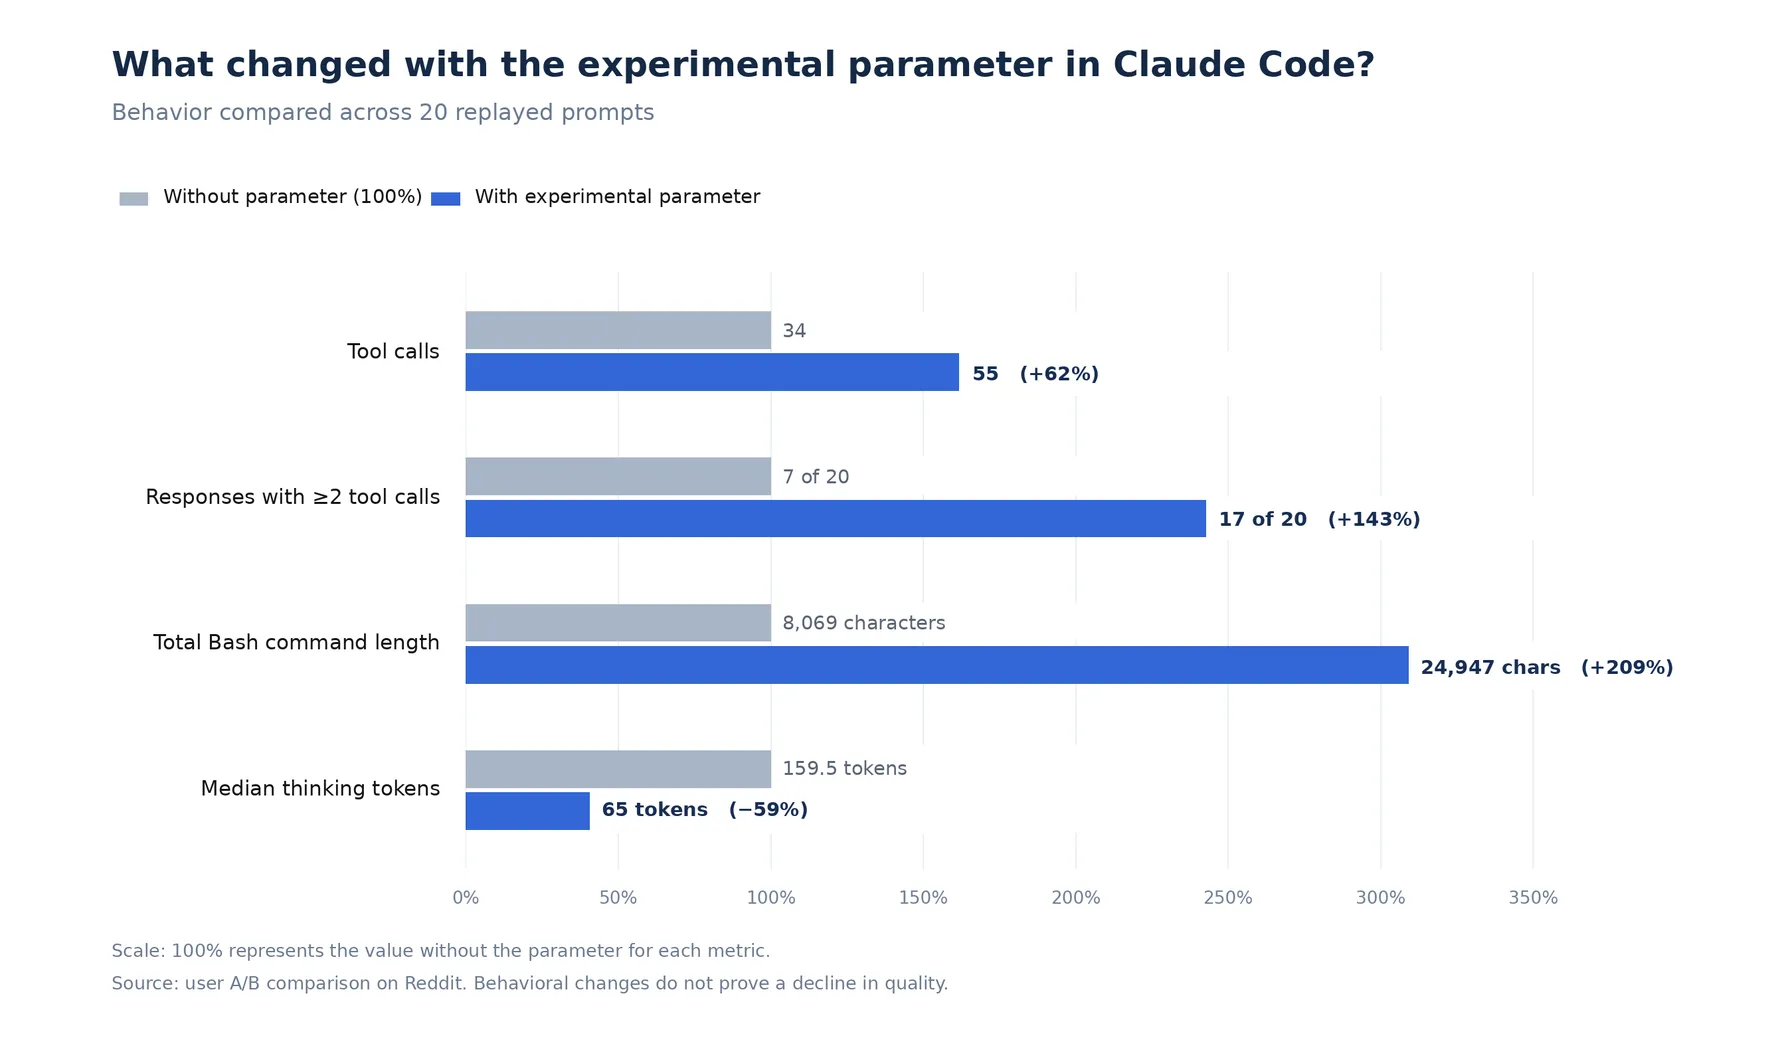
Зерттеу WuM1ha1nho жарияланымына сүйенді. Зерттеуші клиент журналдарын қарап, сақталған 20 сұрауды эксперименттік параметрмен және онсыз қайта жіберді. Сұраулардың мазмұны бірдей болды.
| Көрсеткіш | Параметрсіз | Параметрмен |
|---|---|---|
| Құралдарды шақыру саны | 34 | 55 |
| Екі немесе одан көп шақыруы бар жауаптар | 20-ның 7-уі | 20-ның 17-сі |
| Bash командаларының жалпы ұзындығы | 8 069 таңба | 24 947 таңба |
| Ой қорыту токендерінің медианасы | 159,5 | 65 |
Параметр қосылғанда Claude операцияларды жиірек біріктіріп, ұзағырақ командалар жасап, орындау алдында азырақ ой қорыту токенін пайдаланды. Бұл мінез-құлықтың байқалған өзгерісі, бірақ тест тапсырмалардың дұрыс шешілгенін тексермеген. Ұзын команда тиімдірек те, қателігі көбірек те болуы мүмкін. Параметрді беру сервердегі A/B тобының толық қайталануына кепіл емес.
Сондықтан бұл нәтиже модель әдейі нашарлатылғанын дәлелдемейді. Алайда модель атауы бірдей болғанымен, бүкіл Claude Code жүйесінің мінез-құлқы бірдей болмауы мүмкін екенін көрсетеді.
Токен шығыны туралы шағымдар
Қазан соңында әзірлеушілер Claude Code лимиттері тезірек таусылатынын хабарлады. r/ClaudeAI қолданушысы апталық лимиттің жұмсалу жылдамдығы шамамен 3,8 есе өскенін айтты. Ол мұны қосалқы агенттерге көбірек тапсырма беру, файлдарды қайта оқу және артық қадамдармен байланыстырды.
Кейінгі «Usage Explosion» талқылауында бес сағаттық лимиттердің тез таусылуы айтылды. Басқалары нашарлауды байқамаған немесе шығынның өсуін күрделірек жобалармен байланыстырған. Лимиттің тез таусылуы, токен санының өсуі және қате жауаптар - бөлек көрсеткіштер; оларды жеке өлшеу қажет.
6 638 жауапты талдау
GitHub-тағы #105112 мәселесінде автор өз сессияларындағы Opus 5.5-тің 6 638 жауабын талдады. Жанама көрсеткіш ретінде пайдаланушы түзеткен немесе модель кейін қате деп мойындаған жауаптардың үлесі алынған.
| Кезең | Жауап саны | Түзетілген үлес |
|---|---|---|
| 19 қазанға дейін | 5 738 | 5,2% |
| 19 қазаннан бастап | 900 | 25,4% |
Айырмашылық шамамен бес есе. Жаңа сұрақтарға берілген алғашқы жауаптарды ғана салыстырғанда да автордың бағалауынша үлес 5,2%-дан 15,4%-ға өскен. Бірақ бұл бір жұмыс процесі және әңгіме тарихын соқыр емес бағалау. Мұндай дерек қосымша тексеруді қажет етеді, алайда барлық Claude пайдаланушылары үшін жаппай регрессияны дәлелдемейді.
Көрсетілетін thinking мәтінінің өзгеруі модельдің өзгергенін білдірмейді
Қолданушылар Opus 5.5 атауы өзгермесе де, Claude Code көрсететін ой қорыту мәтінінің стилі әр аккаунтта әр күнде өзгергенін байқады. Anthropic құжаттамасына сәйкес, көрсетілетін thinking ішкі ой қорыту процесінің қысқаша мазмұны болуы мүмкін. Сондықтан мәтіннің өзгеруі модель салмақтары өзгергенін дәлелдемейді: көрсету механизмі жаңарған болуы ықтимал.
LiveNerf: Opus 5 пен 5.5-ті ажырата алмаған тест
LiveNerf Opus 5.5-ті Claude Code арқылы бекітілген тапсырмаларда күн сайын тексереді. 2026 жылғы 8 қарашаға дейін жарияланған деректе бақылау кезеңінде дәлдіктің статистикалық маңызды төмендеуі табылмады. Бірақ бұл шағымдарды сенімді түрде жоққа шығармайды: авторлар әдістің сезімталдығы шектеулі екенін өздері өлшеген.
Тексеру кезінде зерттеушілер Opus 5.5 орнына Opus 5 қойып, effort high деңгейінде сынады. Дәлдік айырмасы −3,8 пайыздық тармақ, стандартты қате 6,3 тармақ болды. Екі модельді сенімді ажырату мүмкін болмады.
Opus 5.5 effort high деңгейімен салыстыру | Дәлдік өзгерісі | Стандартты қате |
|---|---|---|
Opus 5, effort high | −3,8 п. т. | 6,3 п. т. |
Opus 5.5, effort medium | −4,2 п. т. | 3,9 п. т. |
Opus 5.5, effort low | −8,3 п. т. | 4,5 п. т. |
Авторлардың есебіне сәйкес, таңдалған статистикалық критерийлермен он күндік аралықта анықталатын ең аз әсер шамамен 7,5 пайыздық тармақ. Одан кіші регрессия байқалмай қалуы мүмкін. Тест шығыс токендері өзгерісіне сезімталырақ: high деңгейінен medium және low деңгейіне ауысқанда токен саны тиісінше 26% және 62% азайған. Алайда токеннің азаюы өздігінен сапаның төмендеуін білдірмейді.
Негізгі жиынтықта MMLU-Pro, GPQA, математика жарыстары мен AIME-ден алынған 78 академиялық сұрақ бар. Тест Claude Code-тың бекітілген нұсқасымен бос бумада, құралдарсыз, MCP серверлерінсіз және агенттік сценарийлерсіз өтеді. Ол нақты репозиторийдегі кодты түзетуді, ұзақ сессияларды, контекст басқаруды немесе қосалқы агенттерді бағаламайды.
LiveNerf өз тар тапсырмалар жиынында тест сезімталдығы шегінде үлкен құлдырау таппады. Бұл Claude Code-та регрессия жоқ екенін дәлелдемейді.
Anthropic бұрын да Claude Code регрессияларын мойындаған
2026 жылғы 23 сәуірдегі талдауында Anthropic әдепкі ой қорыту тереңдігінің өзгеруі, thinking тарихын басқарудағы қателер және сәтсіз жүйелік нұсқау сияқты мәселелерді мойындады. Компания түзетулерді сипаттап, пайдаланушылардың лимиттерін қалпына келтірді. Бұл қарашадағы ықтимал нашарлауды дәлелдемейді, бірақ жүйелік қабат жаңартуы модель салмақтары өзгермей-ақ нәтижеге әсер ететінін көрсетеді.
Есептеу құны және алдағы IPO
Anthropic 2026 жылғы 26 қазанда IPO-ға өтінім беріп, оны 2 қарашада жаңартты. SEC құжатында есептеу тиімділігі негізгі бизнес факторларының бірі деп көрсетілген. Үшінші тоқсандағы табыс шамамен 16,96 млрд доллар, ал тоқсандық өсім 47% болды. Операциялық нәтиже екінші тоқсандағы 974 млн доллар пайдадан үшінші тоқсанда 567 млн доллар шығынға ауысты. Компания 5 млрд долларлық қысқа мерзімді есептеу міндеттемелерін алғанын, олардың ұзақ мерзімді келісімдерден едәуір қымбат екенін хабарлады. Reuters инфрақұрылым шығындарының қысымын да атап өтті.
Бұл әр сұраудың құнын маршрутизация, кештеу, контекст басқару, агент алгоритмдері немесе ой қорыту деңгейлерін сынау арқылы төмендетуге ынтаны түсіндіреді. Бірақ қаржылық ынта жауаптар әдейі нашарлатылғанын білдірмейді: компанияға өнім сапасын сақтау да маңызды. Қуат тапшылығы кідіріс, лимит және қолжетімділік қателерін тудыруы мүмкін, ал сапаның төмендеуін түсіндіру үшін қосымша механизмге дәлел қажет. Қазандағы ID-лерге қатысты мұндай механизм көпшілікке расталмаған.
Аккаунт бұғаттаулары және дистилляциядан қорғау
Қолданушылар жеке басын тексеру мен аккаунттардың бұғатталуын да талқылады. Anthropic Transparency Hub дерегінше, 2026 жылғы қаңтар-маусымда 11,4 млн аккаунт бұғатталған, 398 мың апелляцияның 42 мыңы шешімнің күшін жоюмен аяқталған. Бұл қазан айындағы толқынның ауқымы емес, бірінші жартыжылдық статистикасы. Anthropic мәліметінше, пайдалану ережелерін сақтау және теріс пайдаланудың алдын алу үшін жеке басты растау қажет болуы мүмкін.
Бақылау неге күшейтіледі?
Қыркүйектегі қауіптер туралы есебінде Anthropic бөгде ұйымдар аккаунттар мен делдалдар желісі арқылы Claude жауаптарын жаппай алып, өз модельдерін үйретуге қолданатын рұқсатсыз дистилляция науқандарын сипаттады. Компания күмәнді белсенділікті анықтап, байланысты аккаунттарды бұғаттайтынын және қажет кезде жеке басты растауды талап ететінін айтты.
Көрсетілетін thinking ішкі ой қорытудың қысқаша мазмұны болуы мүмкін. 12 қазандағы жарияланымда компания алдын ала бағалау бойынша жаңа қорғаныс әдістері шабуылдаушылар шығара алатын дерек көлемін шамамен 90-99% азайтқанын хабарлады. Anthropic жанама әсерлер бар екенін және адал клиенттерге интеграцияларын жаңарту қажет болуы мүмкін екенін мойындады. Ой қорытуды қорғау - ресми саясат, бірақ қарашадағы нақты стиль өзгерістері немесе atis ID-лері осы қорғаныстан туындағаны расталмаған.
Бұғаттаулар, A/B тесттер және IPO өзара байланысты ма?
| Бағыт | Не расталған | Не гипотеза болып қалады |
|---|---|---|
| Есептеу үнемділігі | Қысқа мерзімді қуат құны мен тиімділікке ынта SEC құжатында көрсетілген | IPO үшін белгілі топтардың ой қорыту тереңдігі азайтылды ма |
| Дистилляциядан қорғау | Компания қорғаныс пен аккаунт желілеріне қарсы шараларды растады | Табылған atis ID-лері осыған байланысты ма |
| Бұғаттаулар | Ресми статистика мен пайдаланушылар хабарламалары бар | Толқынның басты мақсаты сервер жүктемесін азайту болды ма |
| Claude Code сапасы | Жекелеген таңдауларда мінез-құлық пен түзетулер өзгерген | Өзгерістердің ортақ себебі бар ма |
Anthropic есептеу экономикасын оңтайландырып, агенттік өнімді дамытып және қолжетімділікті қорғауды күшейтіп жатыр. Бұл пайдаланушы тәжірибесіне әсер етуі мүмкін, бірақ бұғаттаулар, atis эксперименттері және болжамды нашарлау арасындағы себеп-салдар байланысы дәлелденбеген. Пайдаланушыларға құралдарды басқару, көрсетілетін ой қорыту және қолжетімділік ережелеріндегі өзгерістер туралы ашық ақпарат қажет.
Claude Code эксперименттерін өзіңіз қалай тексересіз?
Claude Code үй каталогында .claude.json файлын сақтайды, ал сессиялар тарихы әдетте ~/.claude/projects/ ішінде орналасады. .jsonl файлдарынан түрі atis-latch және өрісі atis жазбаларын іздеңіз:
{"type":"atis-latch","atis":"abc...","sessionId":"..."}atis - мағынасы ашылмаған идентификатор. Салыстыру үшін әдетте алғашқы үш таңба қолданылады, бірақ бұл эксперименттің ресми атауы емес. Бос мән сервер эксперименттері жоқ екенін дәлелдемейді.
PowerShell: ID және сессия санын алу
Windows жүйесінде келесі скрипт үй каталогындағы журналдарды іздейді және деректерді интернетке жібермейді.
$root = Join-Path (Join-Path $HOME '.claude') 'projects'
$groups = @{}
Get-ChildItem -LiteralPath $root -Directory | ForEach-Object {
    Get-ChildItem -LiteralPath $_.FullName -Filter '*.jsonl' -File | ForEach-Object {
        $session = $_.FullName
        foreach ($line in [System.IO.File]::ReadLines($session)) {
            if ($line -notlike '*"atis-latch"*') { continue }
            try { $entry = $line | ConvertFrom-Json -ErrorAction Stop }
            catch { continue }
            if ($entry.type -ne 'atis-latch') { continue }
            $raw = $entry.atis
            if ($raw -is [string] -and -not [string]::IsNullOrWhiteSpace($raw)) {
                $id = $raw.Substring(0, [Math]::Min(3, $raw.Length))
            } elseif ($null -eq $raw -or [string]::IsNullOrWhiteSpace([string]$raw)) {
                $id = 'none'
            } else { $id = 'other-format' }
            if (-not $groups.ContainsKey($id)) { $groups[$id] = @{} }
            $groups[$id][$session] = $true
        }
    }
}
$groups.GetEnumerator() | ForEach-Object {
    [PSCustomObject]@{ ID = $_.Key; Sessions = $_.Value.Count }
} | Sort-Object Sessions -Descending | Format-Table -AutoSize
Скрипт қайталанған жазбаларды емес, бірегей негізгі сессияларды санайды; қосалқы агент журналдары кірмейді. Бір сессияда бірнеше ID болса, ол бірнеше жолға түседі. none жазбадағы өрістің бос немесе жоқ екенін білдіреді, эксперимент жоқтығын дәлелдемейді. atis-latch жазбалары жоқ сессиялар көрсетілмейді. Жазбалардың өзінде көбіне timestamp жоқ, сондықтан күнді көрші хабарламалар бойынша тек шамамен анықтауға болады.
Бұл неге әлі де нашарлаудың дәлелі емес?
Қателер пайда болған күні жаңа ID көрінсе де, корреляция жеткіліксіз. Бірдей тапсырмаларды бірдей модель, Claude Code нұсқасы және reasoning effort деңгейінде салыстырып, құрал шақыруларын, түзетулерді және токен шығынын өлшеу қажет. ID жергілікті жазбаның барын көрсетеді, сервер экспериментінің мақсатын ашпайды.
Қауіпсіздік: бастапқы .jsonl, толық .claude.json, толық atis мәндері мен сессия ID-лерін жарияламаңыз. Оларда жеке сұраулар, бастапқы код және басқа құпия ақпарат болуы мүмкін. Скрипт тек ID-дің алғашқы үш таңбасын және жиынтық сандарды көрсетеді.
Қорытынды
Claude Code жүйесіне модельден бөлек нұсқаулар, тапсырмаларды бөлу, контекст басқару, құрал таңдау және ой қорытуды көрсету кіреді. Пайдаланушылар өзгерістерді байқады, кейбір шағымдар сандық деректермен толықтырылған. Қаржылық құжаттар есептеу тиімділігіне ынтаны, ал Anthropic есептері дистилляциядан қорғаныстың күшеюін көрсетеді. Бірақ бұлардың ешқайсысы компания IPO немесе есептеу ресурстарын үнемдеу үшін Claude мүмкіндігін әдейі төмендеткенін дәлелдемейді. Негізгі мәселе - сервердегі өзгерістерді ашық диагностикалау және оларды модель регрессиясынан ажырату.
Материал 2026 жылғы 9 қарашадағы жағдай бойынша дайындалды. Пайдаланушылар эксперименттері идентификаторлардың мақсатын ресми растамайды.