
DeepSeek V4.1 Flash 1017 жаңартуын шығарды және оны шағын жаңарту деп атады (модель сол, тек қосымша оқытылған), бірақ пайдаланушыларда бір ғана сұрақ бар: неге ол әлі де 4.1, 4.2 немесе 4.5 емес - жаңарту оларға соншалықты ұнады. Бұл мақалада компанияның өз өлшемдерін, тәуелсіз командалардың бенчмарктарын (sference, Bug Hunt Bench, ChessBench) және пайдаланушы пікірлерін қарастырамыз - шолуды соңына дейін оқыңыз.
Жаңартудың өзегінен бастайық - DeepSWE агенттік тестіндегі баға мен сапа графигінде ол барлық бәсекелестерден жоғары және солға қарай орналасты: тапсырмалардың 77%-ын шешеді, ал тапсырма оған шамамен 74% шешетін Claude Opus 5 немесе GPT-6 Astra-дан ондаған есе арзанға түседі. Жаңарту 17 қазанда шықты, салмақтар ашық, жаңа нұсқа сайтта, қолданбада және API-да жұмыс істеп тұр. Төменде - тесттердің толық кестесі, график, алғашқы тәуелсіз өлшемдер және модельдің әлсіз тұстары.
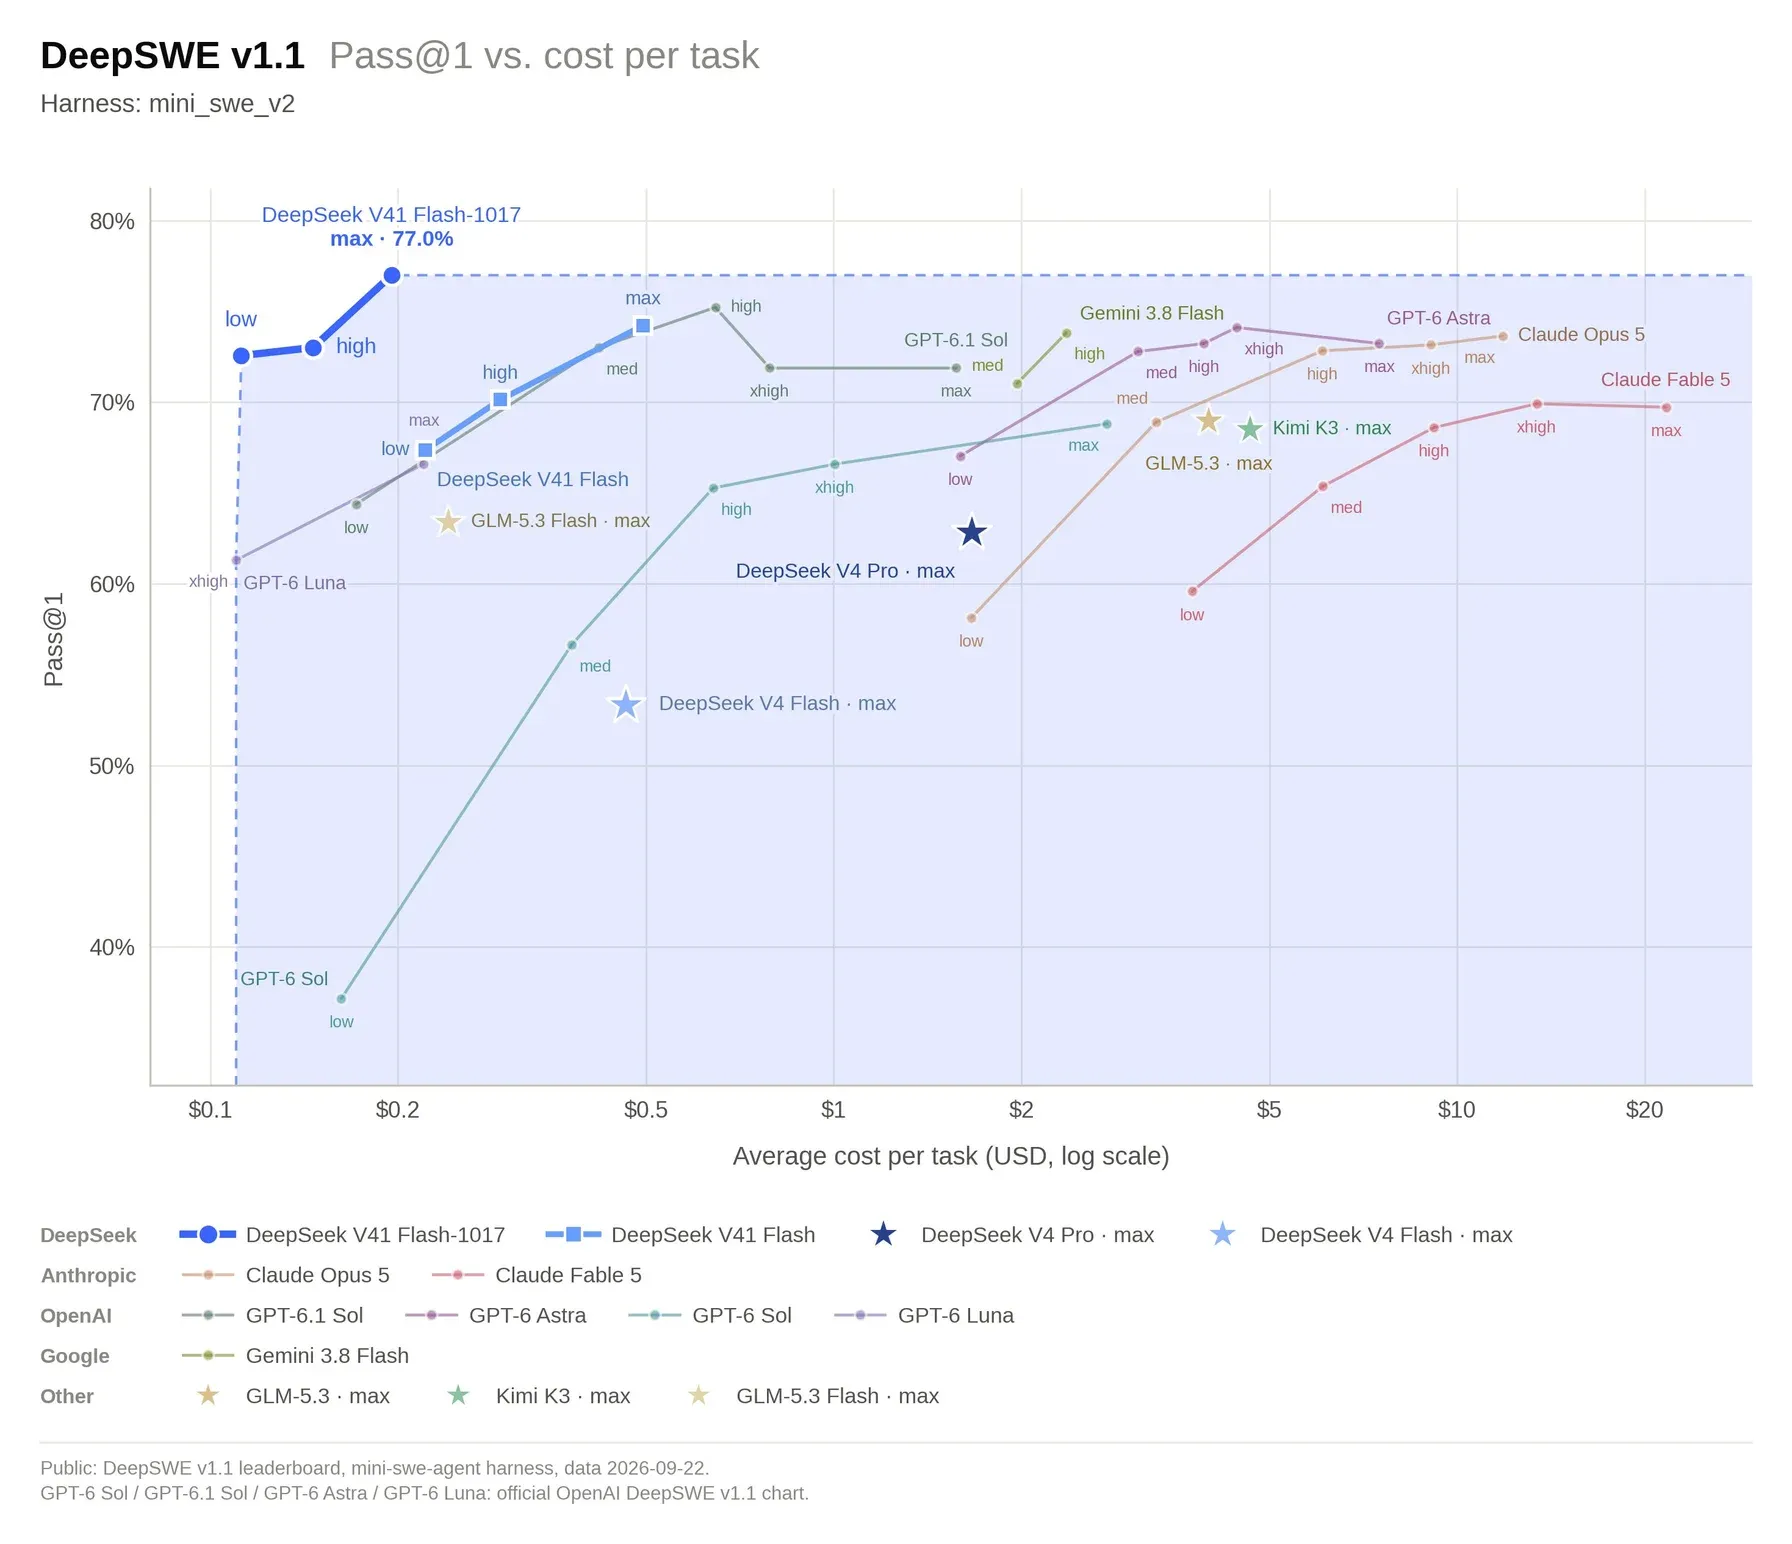
DeepSeek графигі. Бәсекелестердің деректері 22.09.2026 жағдайындағы DeepSWE жария рейтингінен және OpenAI графиктерінен алынған.
DeepSeek не уәде етеді
Жарияламада DeepSeek үш негізгі мәлімдеме жасайды:
- Парето-жақсарту. Модель тесттерде күштірек, тапсырмаларды тезірек аяқтайды және қыркүйек нұсқасына қарағанда қысқарақ жауап береді. Яғни бірін екіншісіне айырбастамай, бір мезгілде жақсырақ және арзанырақ.
- Код бөліктері емес, тұтас жобалар. DeepSeek модель жобаны басынан аяғына дейін өзі жасай алады деп жазады: мысалы, ойын жазу немесе 3D-модель жасау. Мысал бейнелерін DeepSeek X-те жариялады. Осыған жету үшін модель оқыту кезінде өз нәтижелерін өзі тексеріп, бағалады, содан кейін осы бағалардан үйренді. Бұл схемада жауаптарды тексеретін адамдар да, жеке тексеруші модель де жоқ (The Decoder).
- Өз қабығы. Модель DeepSeek Harness (компанияның ашық агенттік фреймворкі), Tencent CodeBuddy және WorkBuddy үшін бапталған. Harness үшін 0.2.1-rc.1 немесе одан жаңа нұсқа ұсынылады.
«Жобаларды нөлден жасауды» әзірге тек DeepSeek бейнелері мен жеке пікірлер арқылы ғана тексеруге болады. Мысалы, бір пайдаланушы модельден DeepSeek Harness арқылы Angular компоненттерінің витринасын жинауды сұрады және нәтижеге риза болды. Бірақ бұл жалғыз пікір.
Толық кесте: 1017 қайда алда, қайда жоқ
DeepSeek жаңартуды алдыңғы нұсқамен және төрт бәсекелеспен салыстырды. Жолдағы үздік нәтиже қалың әріппен белгіленген.
| Тест | 1017 | Қыркүйек | Kimi K3 | GLM 5.3 | GPT-5.6 Sol | Opus 5 |
|---|---|---|---|---|---|---|
| HLE (құралдарсыз) | 42,6 / 44,0* | 36,8 / 39,1* | 43,5 | 42,0* | 44,5 | 56,3 |
| Terminal-Bench 4.0 | 42,3 | 31,2 | 12,6 | 37,9 | 39,9 | 51,8 |
| DeepSWE v1.1 | 77,0 | 74,2 | 67,5 | 66,9 | 73,0 | 74,0 |
| ProgramBench | 29,1 | 20,3 | 17,5 | 19,0 | 23,0 | 37,0 |
| NL2Repo-Bench | 68,2 | 65,4 | 58,0 | 58,0 | 56,8 | 75,3 |
| Automation-Bench v1.0.6 | 60,5 | 54,8 | 46,7 | 48,8 | 45,8 | 50,3 |
| Agents' Last Exam | 35,4 | 31,8 | 27,6 | 28,5 | 26,7 | 28,6 |
| Apex Bench v1.1 | 72,1 | 64,6 | 47,8 | 56,6 | 54,3 | 65,8 |
| Chartography (құралдармен) | 83,0 | 78,9 | 68,1 | - | 79,9 | 84,0 |
| BabyVision (құралдармен) | 92,5 | 89,6 | 85,7 | - | 88,9 | 94,1 |
| ZeroBench-main (құралдармен) | 51,0 | 49,0 | 41,0 | - | 53,0 | 52,0 |
* HLE-нің мәтіндік бөлігі. Terminal-Bench 4.0 Claude Code ортасында, DeepSWE Mini-SWE-V2 фреймворкінде іске қосылды, ZeroBench Pass@5 бойынша есептелді.
Қалың сандармен ғана шектелмей оқысаңыз, мыналар көрінеді:
- Қыркүйекпен салыстырғанда өсім барлық 11 тестте бар. Ең күшті өсім - Terminal-Bench (+11,1), ProgramBench (+8,8) және Apex Bench (+7,5), ең әлсізі - ZeroBench (+2,0).
- Kimi K3, GLM 5.3 және GPT-5.6 Sol-ды 1017 дерлік барлық жерде басып озады. Ерекшелік - K3 мен Sol сәл жоғары HLE және Sol жоғары ZeroBench.
- Opus 5-пен есеп 4:7. 1017 агенттік тесттерде (DeepSWE, Automation-Bench, Agents' Last Exam) және Apex Bench-те жеңеді, ал Opus 5 білімде (HLE, айырмасы шамамен 14 пункт), терминалдағы жұмыста, бағдарламалауда (ProgramBench, NL2Repo) және көру тесттерінде алда.
- Opus 5 - бұрынғы буын. Opus 5.5 22 қыркүйекте шықты және Anthropic деректері бойынша Terminal-Bench 4.0-де 66,4% жинайды (Opus 5 сол деректер бойынша - 52,3%). DeepSeek кестесінде ол жоқ, сондықтан бұл сандардан Anthropic-тің қазіргі флагманымен салыстыруды іздемеңіз.
Reddit-те басқа жайт та байқалды: бұл жолы тесттер тізімі қыркүйек нұсқасының карточкасына қарағанда қысқа және агенттікке жақындау. Тесттер стандартты, бірақ модельдің күшті жақтары әлсіз жақтарынан айқынырақ көрінетіндей таңдалған.
Тапсырма бағасының графигі: оны қалай оқу керек
Мақала басындағы графикте тік білікте - шешілген DeepSWE тапсырмаларының үлесі, көлденең білікте - вендорлар API бағасы бойынша бір тапсырманың орташа құны. Шкала логарифмдік: әр бөлік оңға қарай шамамен екі-үш есе қымбат. low, high және max нүктелері - ой қорыту деңгейлері: деңгей жоғары болған сайын, модель ұзағырақ ойланады және тапсырма қымбатырақ болады.
Графиктен бағалағанда мынадай жағдай шығады:
- max режиміндегі 1017 тапсырмалардың 77%-ын шешеді, ал тапсырма сол режимдегі қыркүйек нұсқасына (74,2%) қарағанда шамамен 2,5 есе арзан.
- low режиміндегі 1017 шамамен 72,5% шешеді - қыркүйектің max-ынан сәл аз, бірақ одан 4-5 есе арзан.
- Сапасы бойынша ең жақын бәсекелес - high режиміндегі GPT-6.1 Sol, шамамен 75%, ал оның тапсырмасы max-тағы 1017-ден шамамен үш есе қымбат.
- Gemini 3.8 Flash, GPT-6 Astra және Claude Opus 5 73-74% маңында, бірақ тапсырма оларда 12-60 есе қымбат.
- Claude Fable 5 max режимінде де 70%-ға жетпейді және графиктегі ең қымбат нүкте болып шығады.
- Сол баға аймағындағы модельдер - GPT-6 Luna, GLM 5.3 Flash және low режиміндегі қыркүйек Flash - шамамен 61-67% шешеді.
Графиктің ескертпелері бар. Оны DeepSeek сызды, ал бәсекелестердің деректері 22 қыркүйектегі DeepSWE рейтингінен алынған - сол күні Opus 5.5 шықты, сондықтан ол графикте жоқ. Бұл бір тест, бір қабық (mini-swe-v2) және вендорлардың API бағалары, біздікі емес.
Тәуелсіз өлшем: ой қорыту 20-30% қысқа, жауаптар сол
Шығарылым күніндегі ең егжей-тегжейлі тексеруді ашық модельдерге өзі қолжетімділік беретін sference компаниясы жасады. Ол V4.1 Flash-тың ескі және жаңа салмақтарын салыстырды, ал қалғанының бәрін өзгеріссіз қалдырды: сол тапсырмалар, сол жабдық, сол генерация параметрлері. Осылайша нәтижелердегі айырма тек жаңартудан шығады.
Нақты дұрыс жауабы бар үш тапсырмалар жиынында тексерді. Жауаптарды сарапшы рөліндегі басқа нейрожелі емес, бағдарлама тексерді, сондықтан баға ешкімнің талғамына тәуелді емес:
- AIME 2024 - американдық математика олимпиадасының есептері (American Invitational Mathematics Examination). Модельдер ең ұзақ ой қорытатын 10 есепті алды.
- MATH-500 - мектеп деңгейінен олимпиада деңгейіне дейінгі әртүрлі күрделіліктегі 500 математикалық есеп жиыны. Күрделіліктің әр деңгейінен бірнешеуден 10 есеп алынды.
- BFCL (Berkeley Function Calling Leaderboard) - құралдарды, яғни модель жұмыс барысында шақыратын функцияларды шақыру тесті. 20 тапсырма: бір функцияны шақыру, бірнешеуінен қажеттісін таңдау, бірнеше функцияны бірден шақыру және ешбір функция сәйкес келмесе, шақырудан бас тарту.
Әр тапсырма үш рет іске қосылды. Кездейсоқ ауытқуды өлшеу үшін ескі салмақтар қатарынан екі рет іске қосылды: осы ауытқудан кіші кез келген айырма нәтиже болып саналмайды. Барлығы - 1440 сұраныс.
Ой қорыту қысқа, жауаптар сол
- AIME-де медианалық жауап 21%-ға қысқарды, 1681-ден 1124 токенге дейін, ал ой қорыту мәтінінің өзі - 30%-ға.
- Дұрыс жауаптар саны дерлік сондай: ескі нұсқада 120-дан 101, жаңасында 120-дан 100. Бір тапсырма айырмасы кездейсоқ ауытқу ішінде.
- MATH-500-де токендер шамамен 27% аз болды.
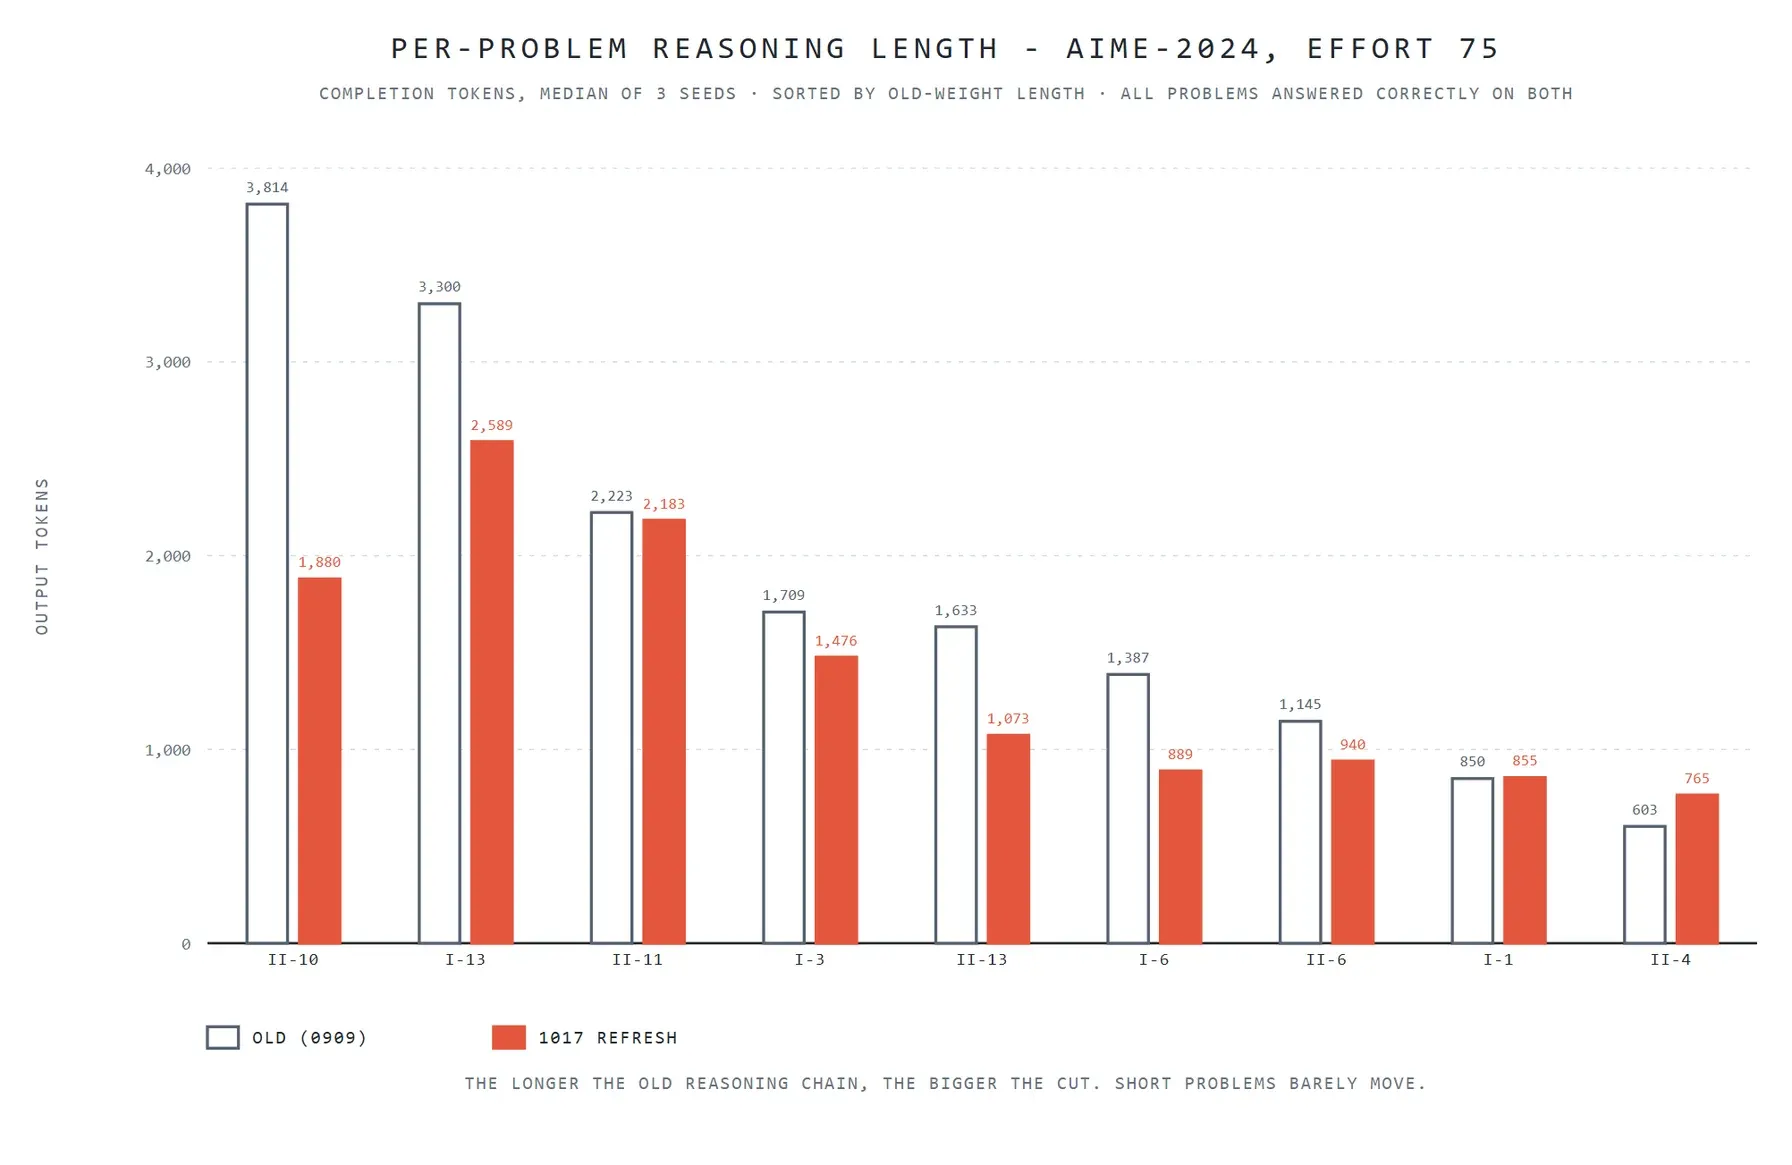
AIME 2024 есептеріндегі ой қорыту ұзындығы: ақ бағандар - алдыңғы нұсқа, қызыл бағандар - 1017, үш іске қосудың медианасы. Графиктегі барлық есепті екі нұсқа да дұрыс шешті. Ескі нұсқаның ой қорытуы неғұрлым ұзақ болса, жаңасы оны соғұрлым қатты қысқартты: ең ұзақ есеп екі есе қысқарды, 3814-тен 1880 токенге дейін. Қысқа есептер дерлік өзгерген жоқ, ал ең қысқа екеуі тіпті сәл ұзарды. График: sference.
Ой қорыту ұзындығының параметрі жұмыс істей бастады
API-да V4.1 Flash-та мәні 1-ден 100-ге дейінгі reasoning_effort параметрі бар: сан кіші болған сайын, модель қысқарақ ойлануы керек. Ескі нұсқада ол әдепкіден төмен дерлік жұмыс істемеді. 1 болғанда да күрделі есептердегі медиана 1974 токен болды, ал 10 болғанда ой қорыту тіпті ұзағырақ шықты - 2202 токен.
1017-де параметр жұмыс істейді:
- 1 мәнінде медиана 790 токенге дейін түсті - сол параметрдегі ескі нұсқадан 60% аз;
- ең ұзын ой қорыту тізбегі 10 280-нен 5940 токенге дейін қысқарды;
- автордың айтуынша, дәлдік барлық тексерілген мәндерде сақталды: 1 болғанда модель 30 күрделі есептің 29-ын шешті;
- 25 мәнінде модель екі математикалық жиынның барлық есептерін шешті, ал бұл әдепкі параметрге қарағанда шамамен 20% арзанға түсті.
API үшін төлейтіндер үшін бұл - жаңартудың басты жаңалығы. Бұрын үнемдеу үшін reasoning_effort мәнін төмендету дерлік мүмкін болмайтын, енді мүмкін.
Құралдарды шақыру өзгерген жоқ
BFCL-де ескі және жаңа нұсқалар бірдей тапсырмаларда қателесті:
| Санат | Ескі нұсқа | 1017 |
|---|---|---|
| Бір функцияны шақыру | 18-ден 15 | 18-ден 15 |
| 2-4 функцияның ішінен біреуін таңдау | 12-ден 9 | 12-ден 9 |
| Бір функцияны параллель бірнеше рет шақыру | 12-ден 12 | 12-ден 12 |
| Әртүрлі функцияларды параллель шақыру | 12-ден 3 | 12-ден 3 |
| Сәйкес функция болмаса, бас тарту | 6-дан 2 | 6-дан 2 |
Екі әлсіз тұсы бірден көрінеді. Модель әртүрлі функцияларды параллель шақыруды дерлік білмейді, бірақ бұл жалпы мәселе: Kimi K3 пен GLM 5.3 сол тестте 12 тапсырманың 3-5-ін шешті. Және сәйкес функция болмаған кезде, модель шақырусыз жауап берудің орнына көбіне шақыруды ойдан шығарады. Автор құралдар тізімін қысқа ұстауды және нұсқаулықта функцияны шақырмай жауап беруге болатынын тікелей жазуды кеңес етеді.
Kimi K3 және GLM 5.3-пен салыстыру
sference сол тапсырмаларды басқа екі ашық модельде іске қосты, үшеуі де әдепкі параметрлермен:
| Модель | AIME | MATH-500 | Құралдарды шақыру | Күрделі тапсырмаға дұрыс жауаптың бағасы |
|---|---|---|---|---|
| DeepSeek V4.1 Flash 1017 | 30-дан 29 | 30-дан 30 | 41 | бастапқы нүкте |
| Kimi K3 | 30-дан 28 | 30-дан 30 | 39 | 5,7 есе қымбат |
| GLM 5.3 | 30-дан 26 | 30-дан 29 | 40 | 3,4 есе қымбат |
Баға мұнда sference қолданатын API тарифтері бойынша есептелген. GLM 5.3 ең қысқа ой қорытады, V4.1 Flash-тан шамамен екі есе қысқа, бірақ күрделі тапсырмаларда жиірек қателеседі. V4.1 Flash-тың өзінде жаңартудан кейін күрделі тапсырмаға дұрыс жауап шамамен 14%-ға арзандады, ал ұзақ ой қорытатын тапсырмаларда жалпы үнемдеуді автор 20-30% деп бағалайды. reasoning_effort мәнін 25-ке қойсаңыз, тағы шамамен 20% үнемдеуге болады.
Ескертпелер
- Математикалық жиындарда тек 10-нан тапсырма бар, сондықтан нақты баллдарды бір тапсырма қателігімен оқу керек. Бірақ өзгеріс бағыты әр тапсырмада сәйкес келді.
- AIME және MATH-500, көбіне, барлық ірі модельдердің оқыту деректерінде бар, сондықтан мұнда дәлдік шекке тірелуі мүмкін. Бұл ой қорыту ұзындығы туралы қорытындыға әсер етпейді.
- Функция шақыруларын эталонмен атауы мен аргументтері бойынша салыстырды, бірақ орындаған жоқ.
- Жауап ұзындығы мен жауап уақыты - әртүрлі нәрсе: жылдамдықты sference өлшеген жоқ.
Bug Hunt Bench: нақты репозиторийлерден баг іздеу
Тест қалай жұмыс істейді және не шықты
Paweł Huryn (@PawelHuryn) 1017-ні өзінің Bug Hunt Bench бенчмаркінде тексерді: модельдер 105 жасырын қатесі бар екі репозиторий алады және тапқанының бәрін табуы және түзетуі керек. Автордың айтуынша, бұл - 2026 жылдың басында алдыңғы қатарлы модельдер өткізіп алған нақты баглар. Тек енгізілген қателер есептеледі, түзетулер жабық жауаптар тізімі бойынша соқыр тексеріледі. Тізімнен тыс табылған нақты мәселелер бөлек есептеледі және баллға кірмейді: автор кейбір OpenAI модельдері нәтижені көтеру үшін көптеген нақты, бірақ қатысы жоқ ескертулер беретінін түсіндірді.
Бірінші іске қосудан кейін 1017 (max режимі) 105 баг ішінен 34-ін түзетті, ал V4.1 Flash-тың қыркүйек нұсқасы сол режимде - 21,7. Автор мұны үлкен жақсару деп атады және модельді V4.2 деп атамағаны біртүрлі деп жазды. Содан кейін ол тағы екі рет іске қосты және 1017 нәтижесі әдеттегіден қатты ауытқитынын атап өтті: жеке іске қосулар 34, 37 және 45 баг берді, орташа - 38,7. Бұған дейін ол үш іске қосудан кейін балл шамамен 1,7 пунктке өзгереді деп күткен.
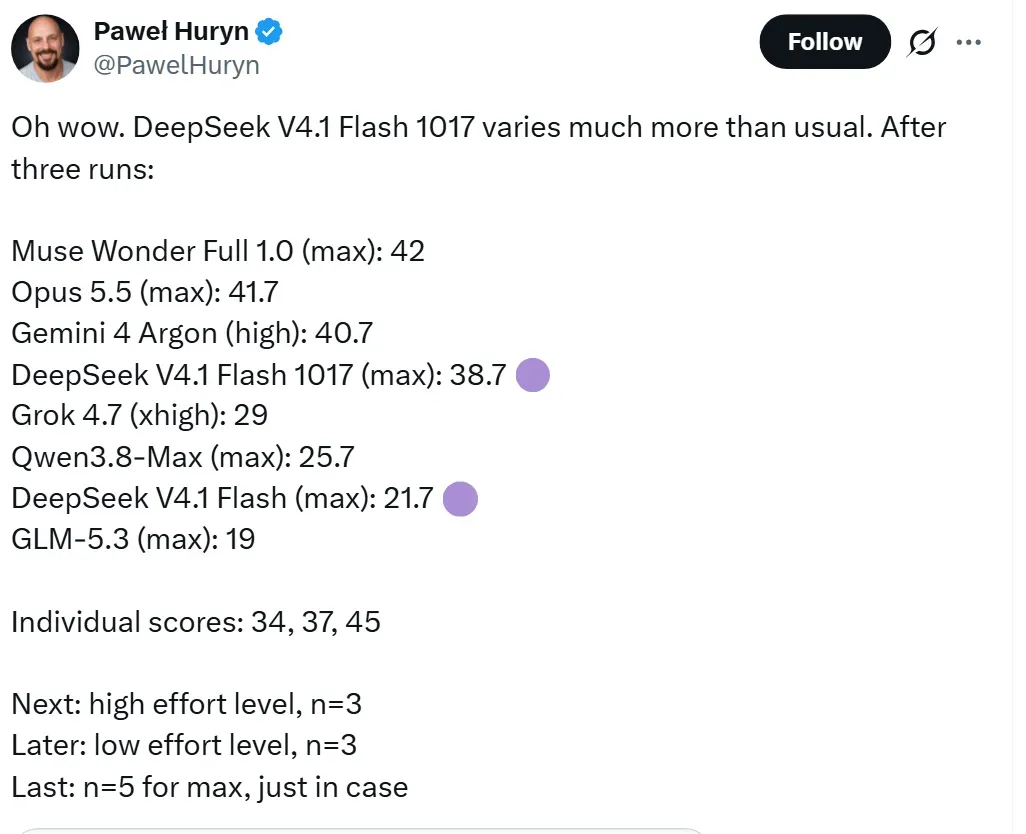
X-тегі постың скриншоты: үш іске қосудан кейінгі нәтижелер.
Осы посттағы нәтижелер:
| Модель (режим) | 105-тен түзетілген баг |
|---|---|
| Muse Wonder Full 1.0 (max) | 42 |
| Claude Opus 5.5 (max) | 41,7 |
| Gemini 4 Argon (high) | 40,7 |
| DeepSeek V4.1 Flash 1017 (max) | 38,7 |
| Grok 4.7 (xhigh) | 29 |
| Qwen3.8-Max (max) | 25,7 |
| DeepSeek V4.1 Flash, қыркүйек (max) | 21,7 |
| GLM-5.3 (max) | 19 |
1017-нің орташа нәтижесі Muse Wonder Full 1.0, Opus 5.5 және Gemini 4 Argon нәтижесінен төмен, бірақ Grok 4.7, Qwen3.8-Max және GLM-5.3-тен айтарлықтай жоғары және қыркүйек нұсқасынан 1,8 есе жоғары. 1017-нің үздік іске қосуы (45 баг) осы кестедегі кез келген орташа мәннен жоғары. Үш іске қосудағы үлкен ауытқуға байланысты нақты қорытынды жасау әлі ерте.
Бенчмарктің толық кестесінде (онда 117 іске қосудың 23-і, 17 қазанда жаңартылған) Sonnet 5.5 (max) 51,3 багпен бірінші, одан кейін 45-пен GPT-6 Astra (max) және 44,3-пен GPT-6.1 Sol (max). Автор Sonnet нәтижесінің дұрыс екенін бөлек нақтылады: ол модельдің GPT-6 Astra (max)-қа қарағанда 7 есе көп қадам жасауы есебінен алынған. Бұл кестеде 1017-нің әзірге бір іске қосуы бар: 34 баг, 50,6 минут және $0,90. Бұл - API үшін нақты шот, қалған модельдердің көбінде құн прайс-парақ бойынша бағаланған. Салыстыру үшін, Opus 5.5 (max) 41,7 баг жинады, 66,9 минут және $58,53 жұмсады, Gemini 4 Argon (high) - 40,7 баг, 56,5 минут және $7,16, ал Sonnet 5.5 (max) 287,1 минут және $154,03 жұмсады.
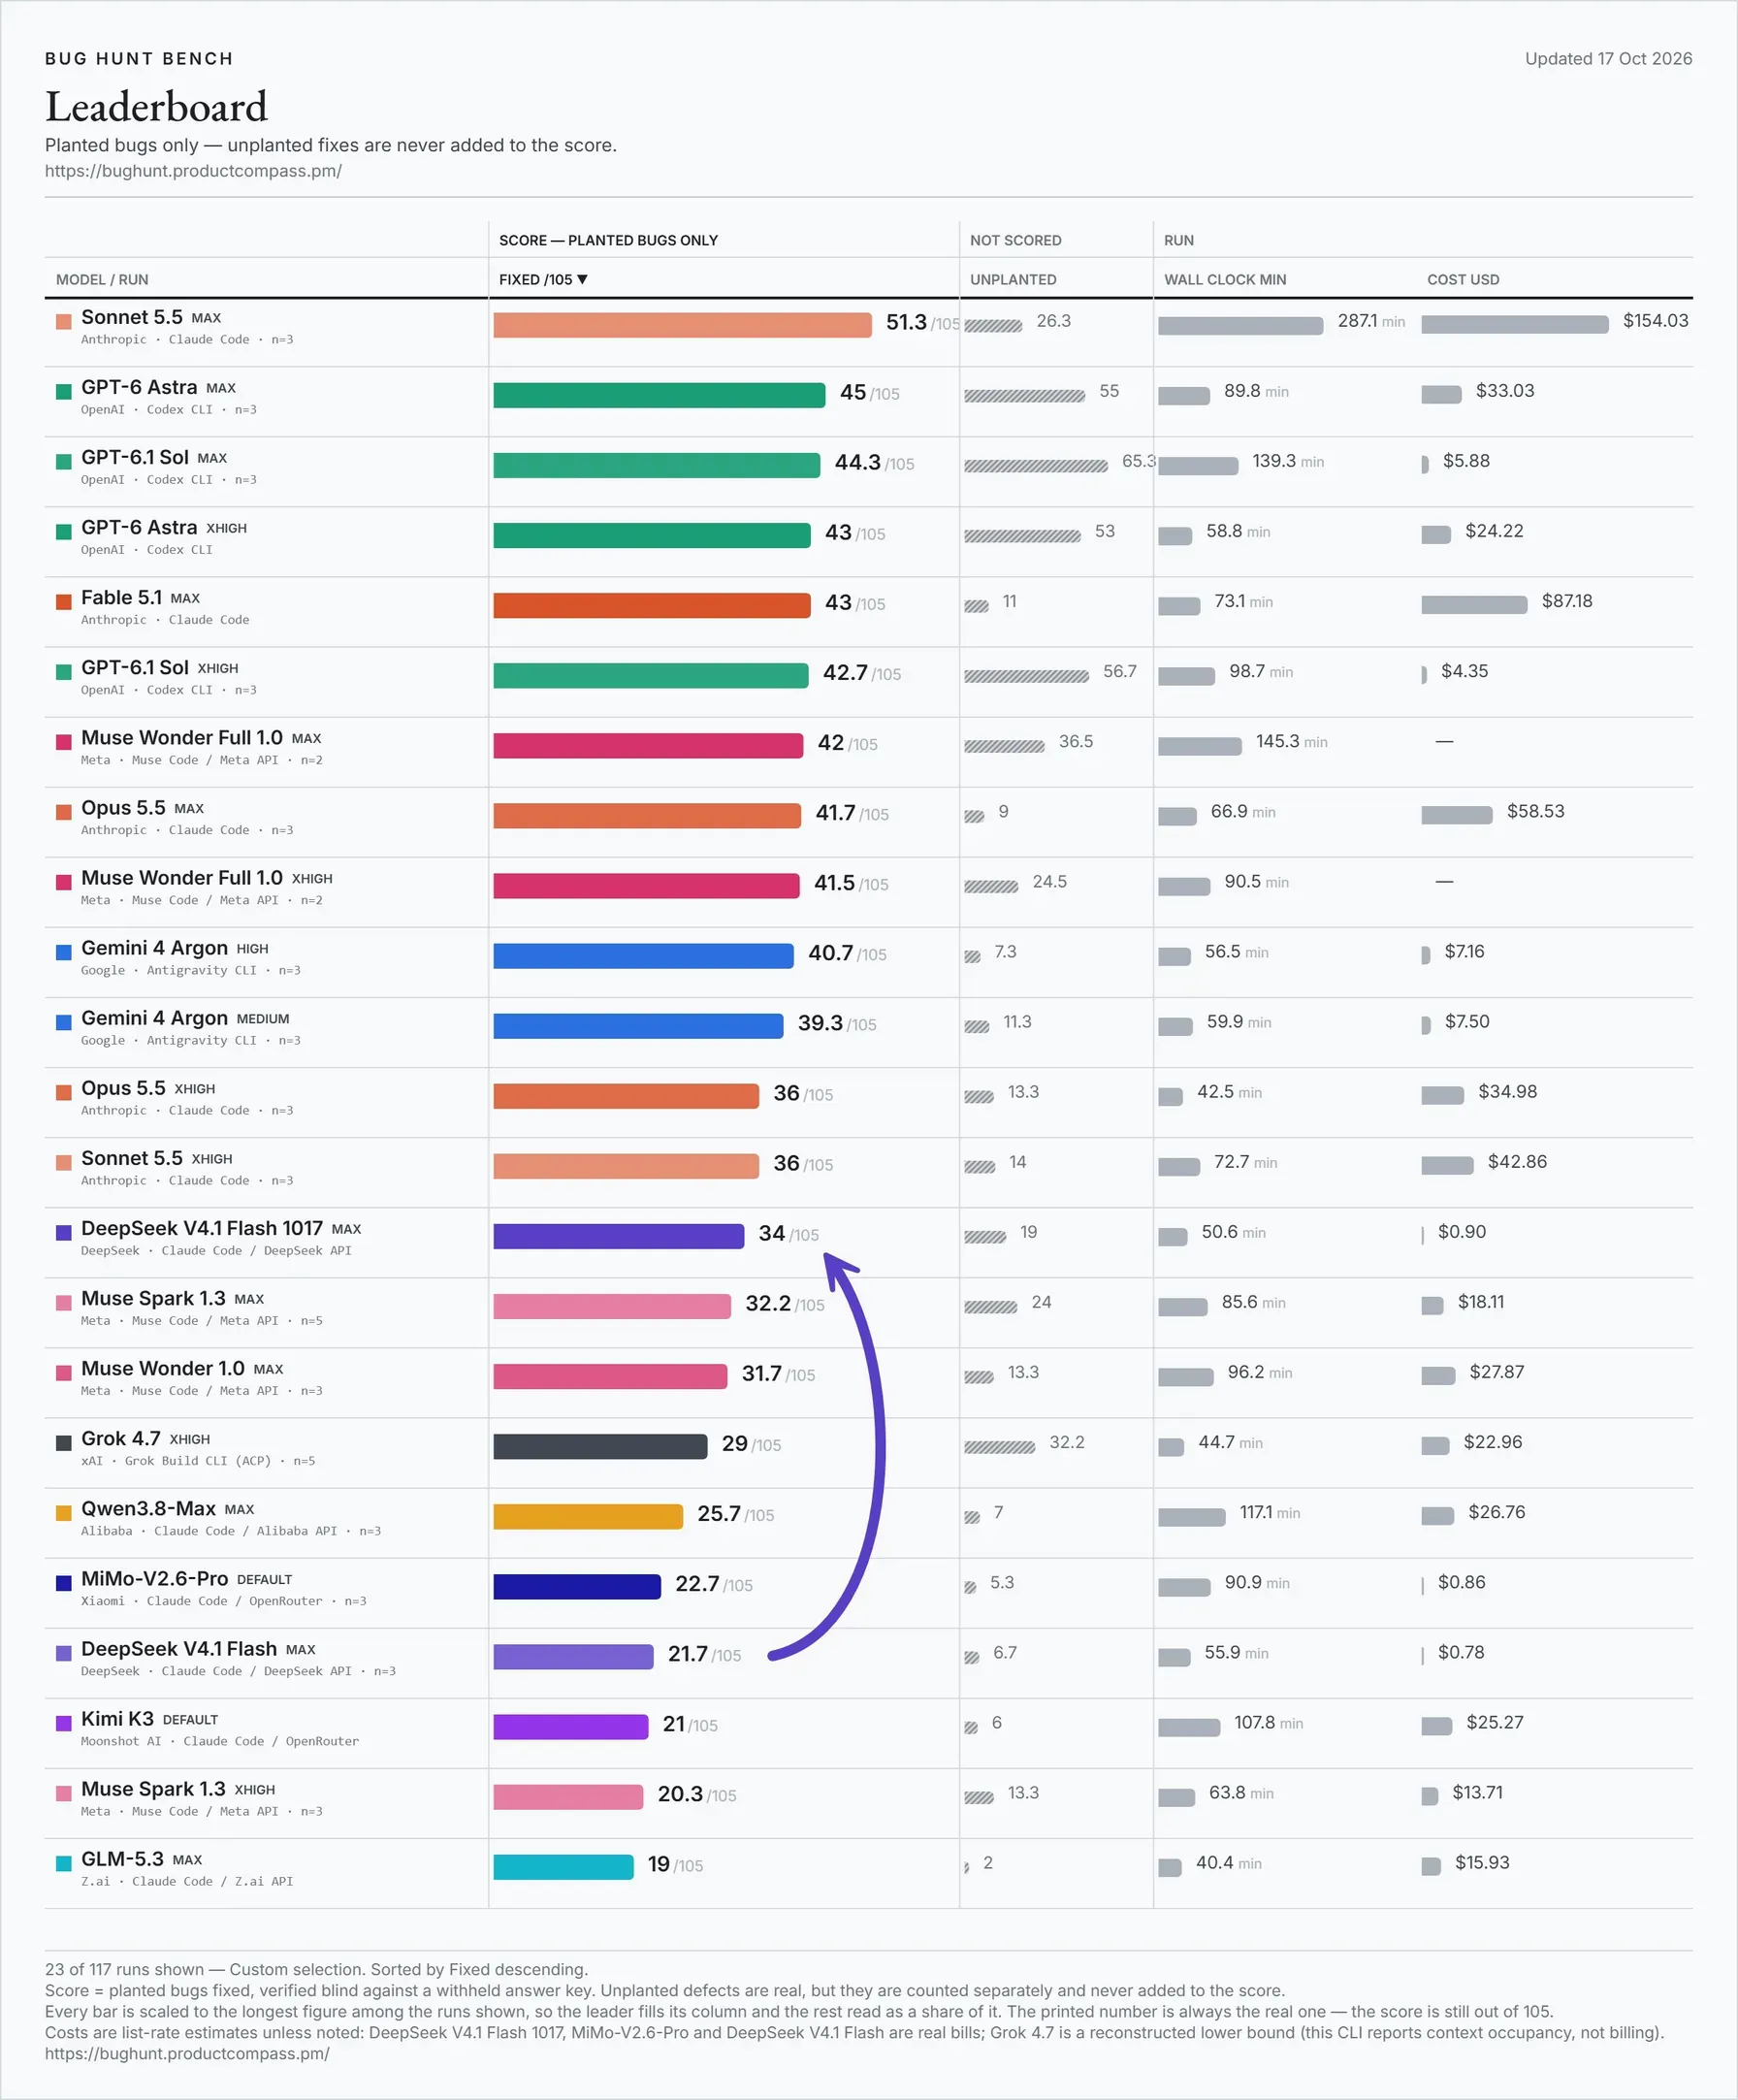
Bug Hunt Bench кестесі (Paweł Huryn): түзетілген баг саны, іске қосу уақыты мен құны. Көрсеткі қыркүйек нұсқасынан 1017-ге өтуді белгілейді.
Баға және нәтиже
Сол автор «нәтиже мен іске қосу құнына қарсы» диаграммасын құрды. Құн білігі логарифмдік: нүкте солға қарай болған сайын, іске қосу арзан, ал жоғары болған сайын көбірек баг түзетілген. Диаграммада 118 іске қосудың 47-сі бар, ал 1017-нің екеуі бар: max режимі (38,7 баг, шамамен $1) және high режимі (32 баг, шамамен $0,8). 1017 құны - нақты шот, қалған модельдер үшін бұл прайс-парақ бойынша баға, сондықтан салыстыру шамамен. Нақты жазуы жоқ сомалар (шамамен $1, шамамен $0,8, шамамен $3,3, $1,3 және $1,8) логарифмдік біліктен оқылған және шамамен, ал баллдар диаграмма аңызынан алынған.
Диаграммада көрінетіні:
- max режимі. 35 багтан жоғары нәтиже берген іске қосулардың ішінде 1017 (max) құны ең төмен. Ең жақыны - 36,5 баг үшін шамамен $3,3 тұратын GPT-6.1 Sol (high). GPT-6.1 Sol (xhigh) 42,7 баг түзетеді және $4,35 тұрады, яғни нәтиже 4 багқа жоғары болғанда 1017-ден шамамен 4 есе қымбат.
- high режимі. 32 багпен 1017 (high) 22,5 баг үшін $1,3 тұратын GPT-6.1 Sol (low) және 29 баг үшін $1,8 тұратын GPT-6.1 Sol (medium)-нан озады және екеуінен де арзан.
- Қымбат бөлік. 41,7 багты Claude Opus 5.5 (max) $58,53 тұрады, ал 43 багты Fable 5.1 (max) - $87,18. Олардың нәтижесі 1017-ден жоғары, бірақ бағасы ондаған есе жоғары.
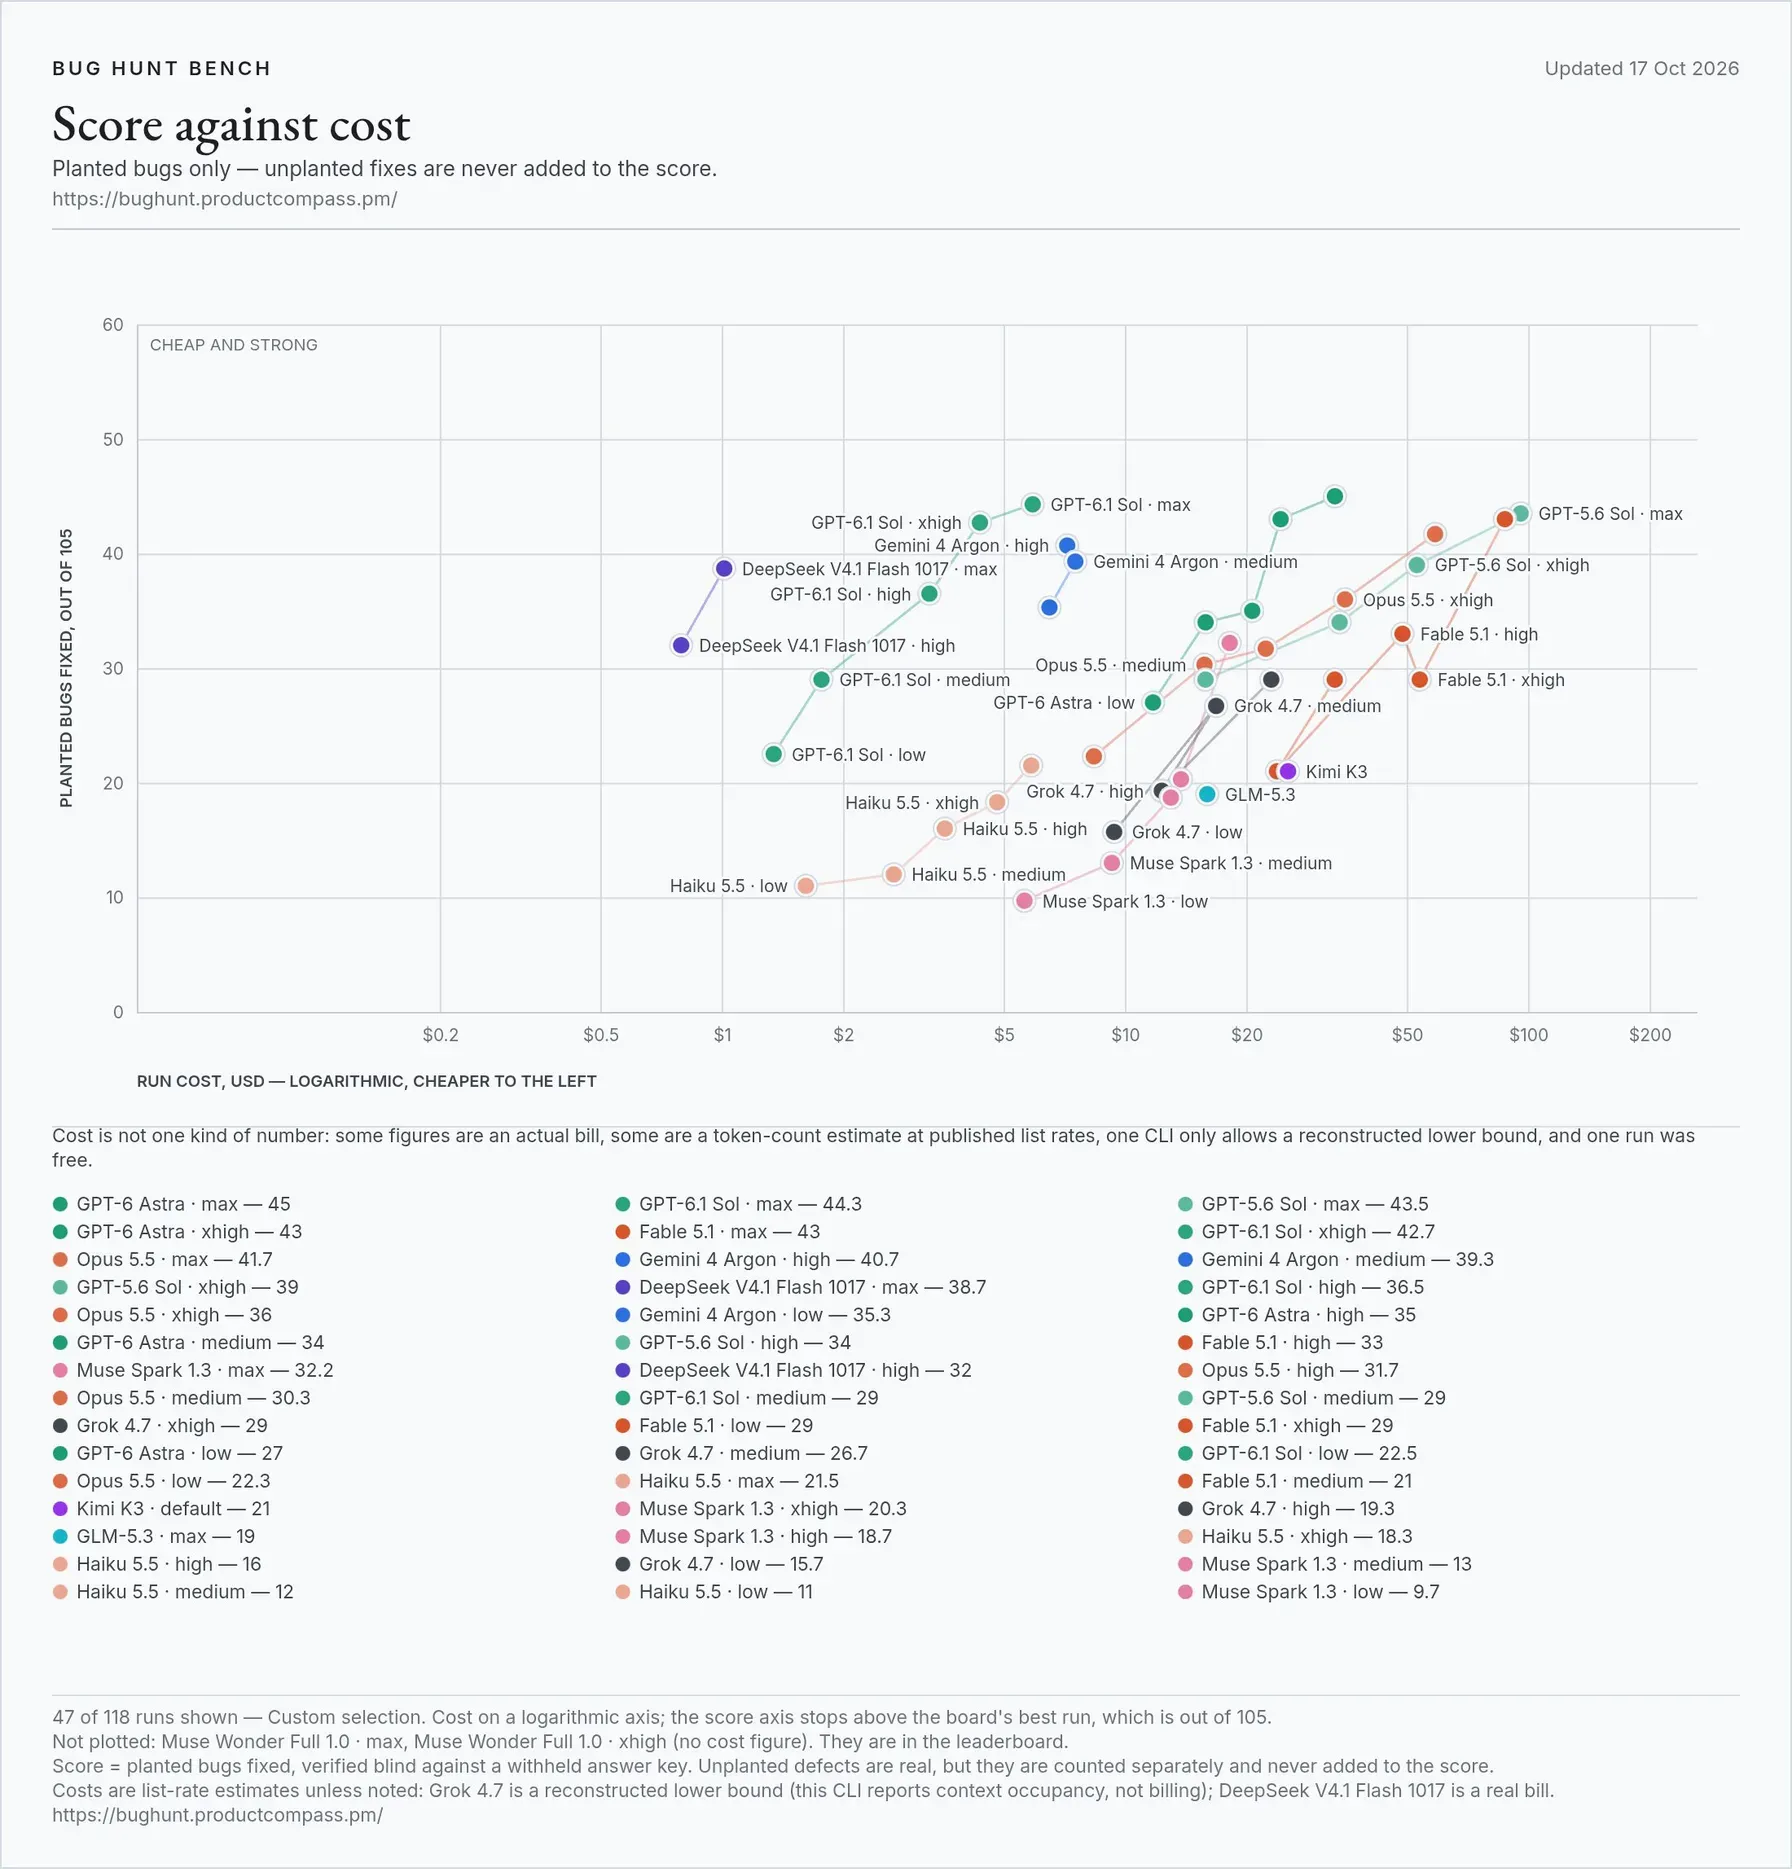
Bug Hunt Bench диаграммасы (Paweł Huryn): нәтиже мен іске қосу құны, 118 іске қосудың 47-сі.
Пайдаланушылардың пікірлері мен бенчмарктері
Алғашқы тәулікте пайдаланушылар өздерінің бірнеше тестін жариялады: ойын және 3D тапсырмаларында, шахмат бенчмаркінде және қарапайым әзірлеуде. Бұл - әртүрлі тапсырмалардағы жеке өлшемдер, бірақ оларды DeepSeek емес, бөгде адамдар жасады.
Зымыран ұшыру: DeepSeek V4.1 Flash 1017 және GPT-6.1 Sol
Пайдаланушы Bhavy (@Bhavani_00007) DeepSeek V4.1 Flash 1017 мен GPT-6.1 Sol-дан зымыран ұшыру сахнасын жасауды сұрады және нәтижені бейнеде салыстырды. Оның деректері бойынша, DeepSeek 3 минутта және $0,78-ға жасады, GPT-6.1 Sol - 5 минутта және $6,10-ға: шамамен 8 есе қымбат және 1,7 есе ұзақ. Сахналар әртүрлі шықты: DeepSeek-те зымыран жасыл төбелер аясында торлы мұнараның жанында тұр, GPT-6.1 Sol-да зымыранның бүйір үдеткіштері, ағаштар, теңіз және бұлттар бар. Автор DeepSeek нәтижесіне өте риза болды.
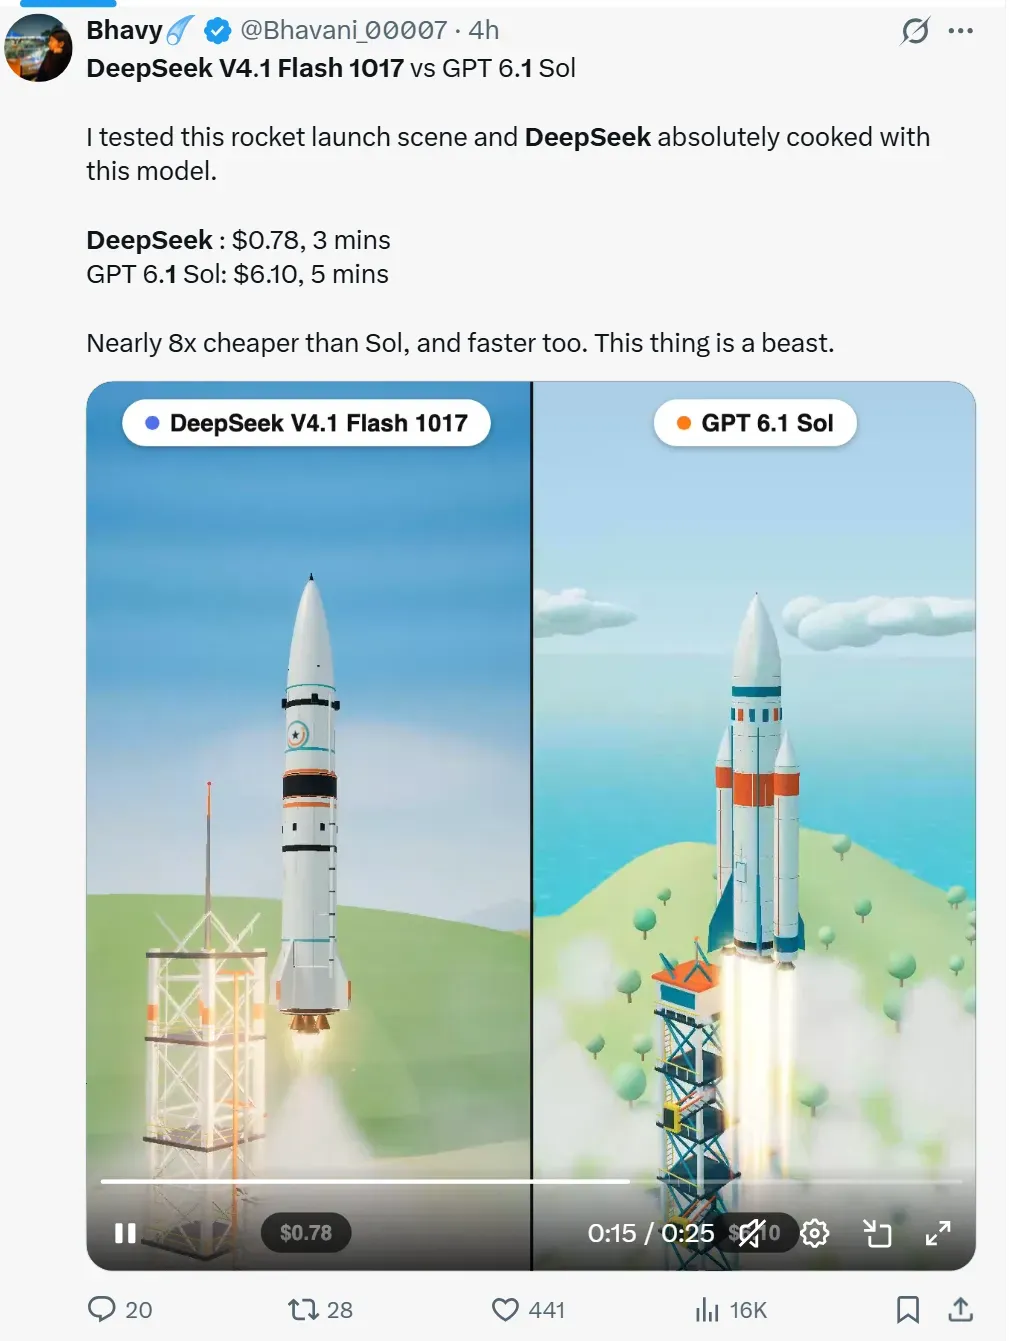
X-тегі постың скриншоты: сол жақта DeepSeek V4.1 Flash 1017, оң жақта GPT-6.1 Sol.
Қалқып тұрған қалалар: DeepSeek V4.1 Flash 1017 және GPT-6.1 Sol Ultra
Пайдаланушы Iam_ (@SPAC89) max режиміндегі DeepSeek V4.1 Flash 1017 мен GPT-6.1 Sol Ultra-ны 3D сахнада салыстырды: бұлттардың үстінде қалқып тұрған, пойызы бар айналмалы темір жолмен жалғанған екі қала. Оның айтуынша, 90%-ға арзан модельдің мұндай жақсы нәтиже беретініне ол әлі сене алмай отыр. Екі модель де шамамен бірдей уақыт жұмсады, өйткені көп уақыт рендерингке кетті. Скриншотта DeepSeek-те айы бар түнгі аспан, бұлттар, мұнаралары бар дөңгелек аралдар және ортасында жарқыраған сақина, ал GPT-6.1 Sol Ultra-да сегіздік пішініндегі тор тәрізді рельстер мен көгілдір және алтын реңктегі мұнаралар.
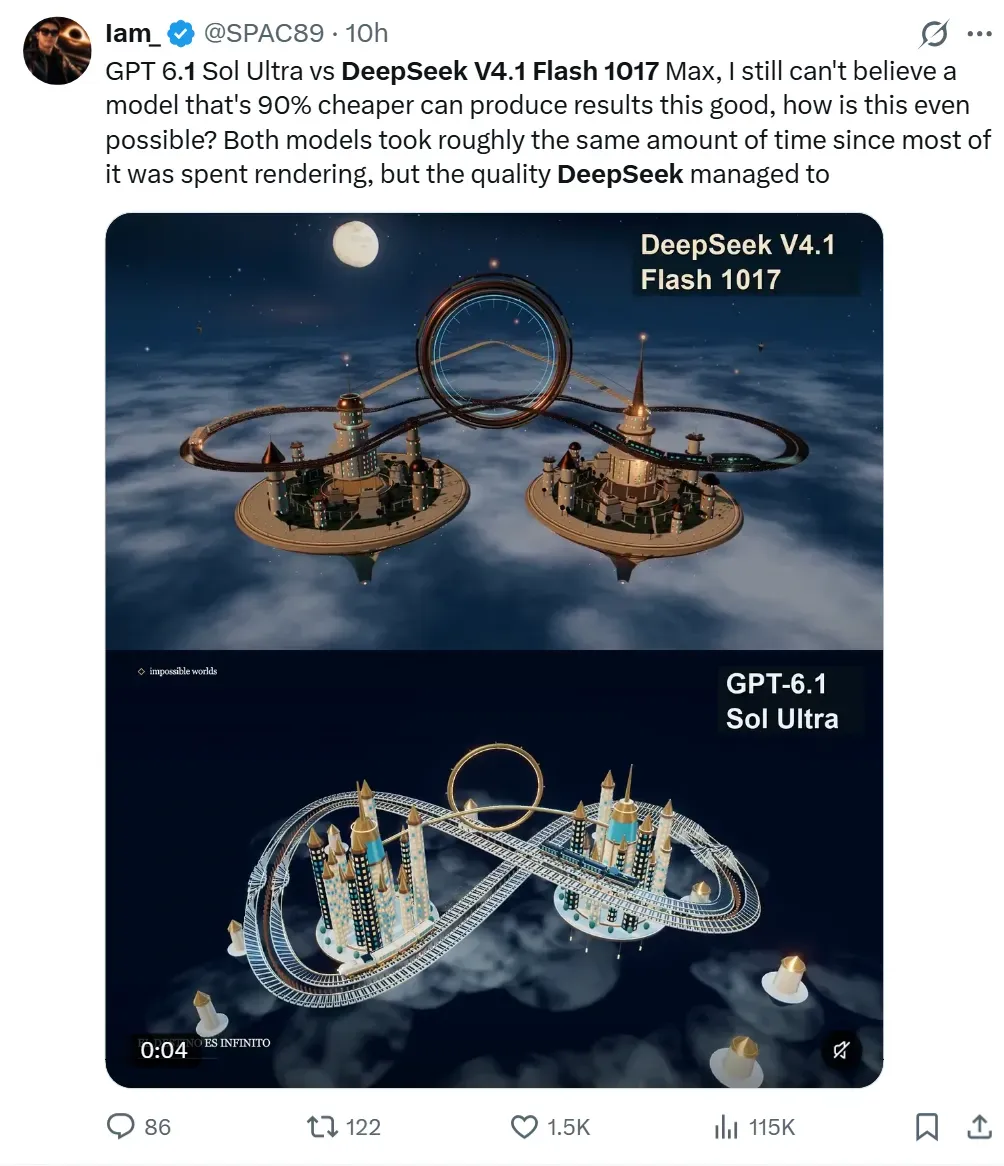
X-тегі постың скриншоты: жоғарыда DeepSeek V4.1 Flash 1017 (max), төменде GPT-6.1 Sol Ultra.
Баузердің 3D-моделі: DeepSeek V4.1 Flash 1017 және Claude Opus 5.5
Пайдаланушы Luckey Faraday (@luckeyfaraday) DeepSeek V4.1 Flash 1017 мен Claude Opus 5.5-ке бірдей бір жолдық сұраныс берді: Баузердің 3D-моделін жинау. Нәтиже карточкасында DeepSeek max режимінде, ал Opus xhigh режимінде жұмыс істегені көрсетілген. DeepSeek 32 минут 42 секунд, 8,05 млн токен және $0,15 жұмсады, Opus - 23 минут 42 секунд, 3,88 млн токен және $3,85 (API құны болжамды). Яғни DeepSeek шамамен 26 есе арзан, бірақ 9 минутқа ұзақ және екі есе көп токен жұмсайды. Екі Баузер де танылады: DeepSeek-те ол қараңғырақ және рельефтірек, қоңыр жасыл сауытымен және қызғылт сары қарнымен, ал Opus-та - ашық жасыл, тегісірек және мультфильмге ұқсайтын.
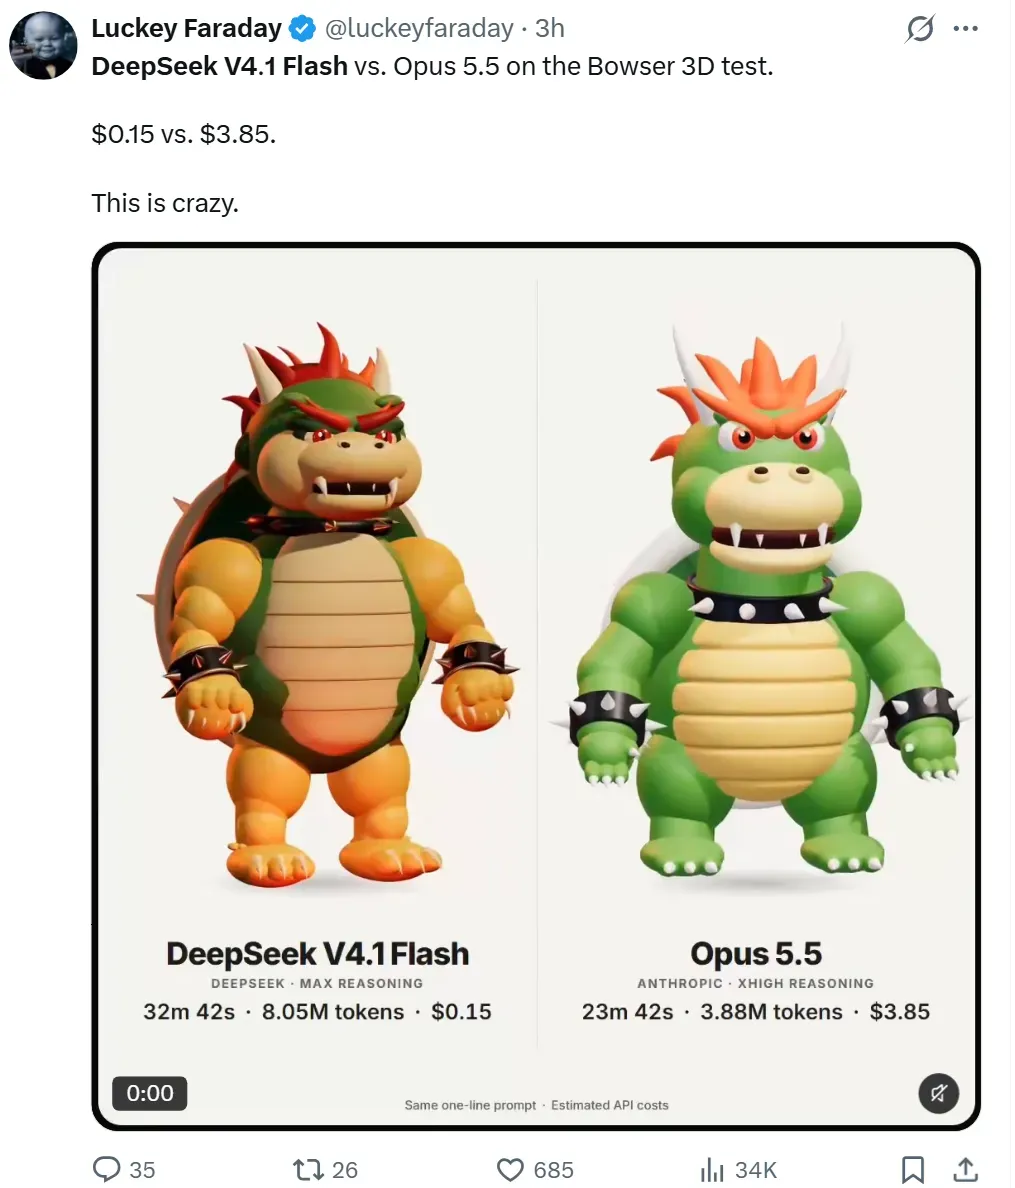
X-тегі постың скриншоты: сол жақта DeepSeek V4.1 Flash 1017, оң жақта Claude Opus 5.5. Бір сұраныс, құн болжамды.
Бал арасы және күнбағыс 3D-да
Пайдаланушы Loktar (@loktar00) 1017 3D-мен жақсы жұмыс істейтінін жазды және бейне көрсетті: DeepSeek Harness-те бір қадамда модель күнбағыстағы бал арасы бар сахнаны жинады. Бейне жазуында 964 мың токен көрсетілген. Бұл басқа модельдермен салыстырусыз жалғыз мысал, сондықтан ол нәтиженің мүмкін екенін көрсетеді, басқалардан қаншалықты жақсы екенін емес.
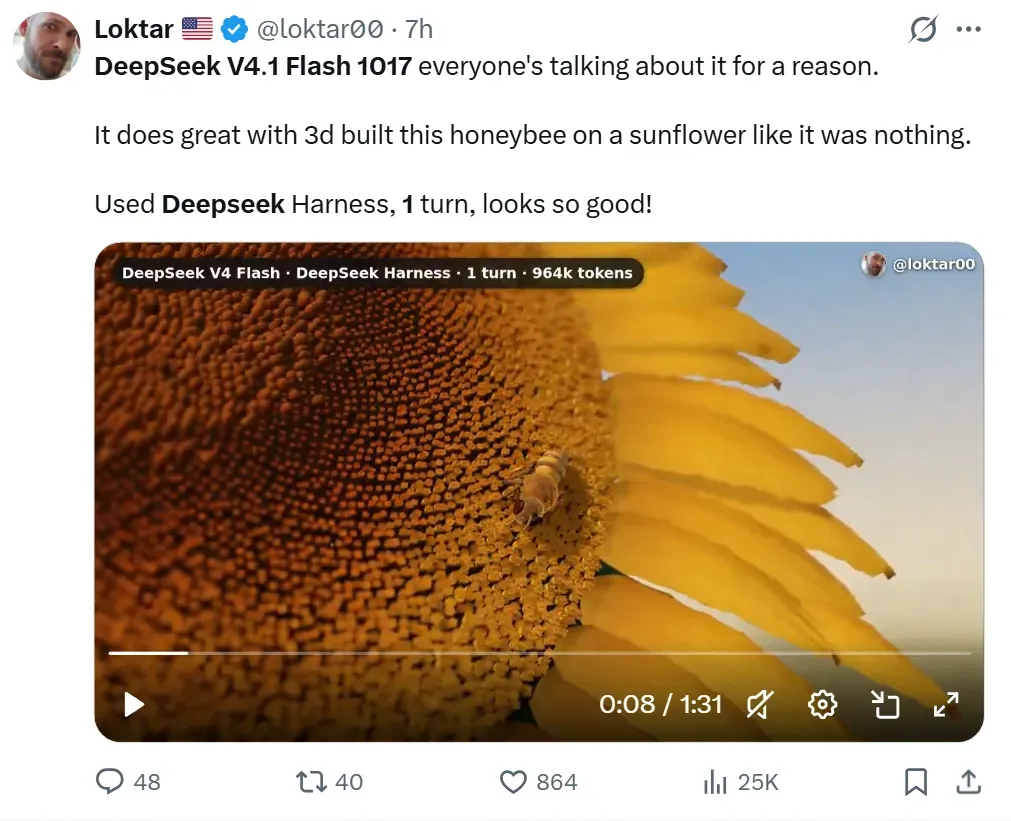
X-тегі постың скриншоты: бейнеден кадр, бұрыштағы жазу - DeepSeek Harness, бір қадам, 964 мың токен.
Паркур жүгірісі: төрт модель, бір сұраныс
Пайдаланушылардың бірі төрт «жылдам» модельге бірдей тапсырма берді: бір HTML файлында бірінші жақтан паркур жүгірісін жасау, төрт кезең, бір бекітілген раунд. Оның айтуынша, DeepSeek-те төртеуінің ішіндегі ең жақсы эффектілер шықты: мыңдаған жарқыраған терезесі бар қала. Әр модель не жұмсағаны (посттағы деректер, thehype логотипі бар бейне):
| Модель | Токен | Уақыт | DeepSeek-пен салыстырғандағы іске қосу бағасы |
|---|---|---|---|
| DeepSeek V4.1 Flash 1017 | 298 мың | 1 сағ 27 мин | бастапқы нүкте |
| Claude Haiku 5.5 | 62,3 мың | 23 мин 33 с | 43%-ға арзан |
| GPT-6 Luna | 62,4 мың | 8 мин 7 с | 3,9 есе арзан |
| Qwen 3.8 Flash | 448 мың | 2 сағ 4 мин | 61%-ға қымбат |
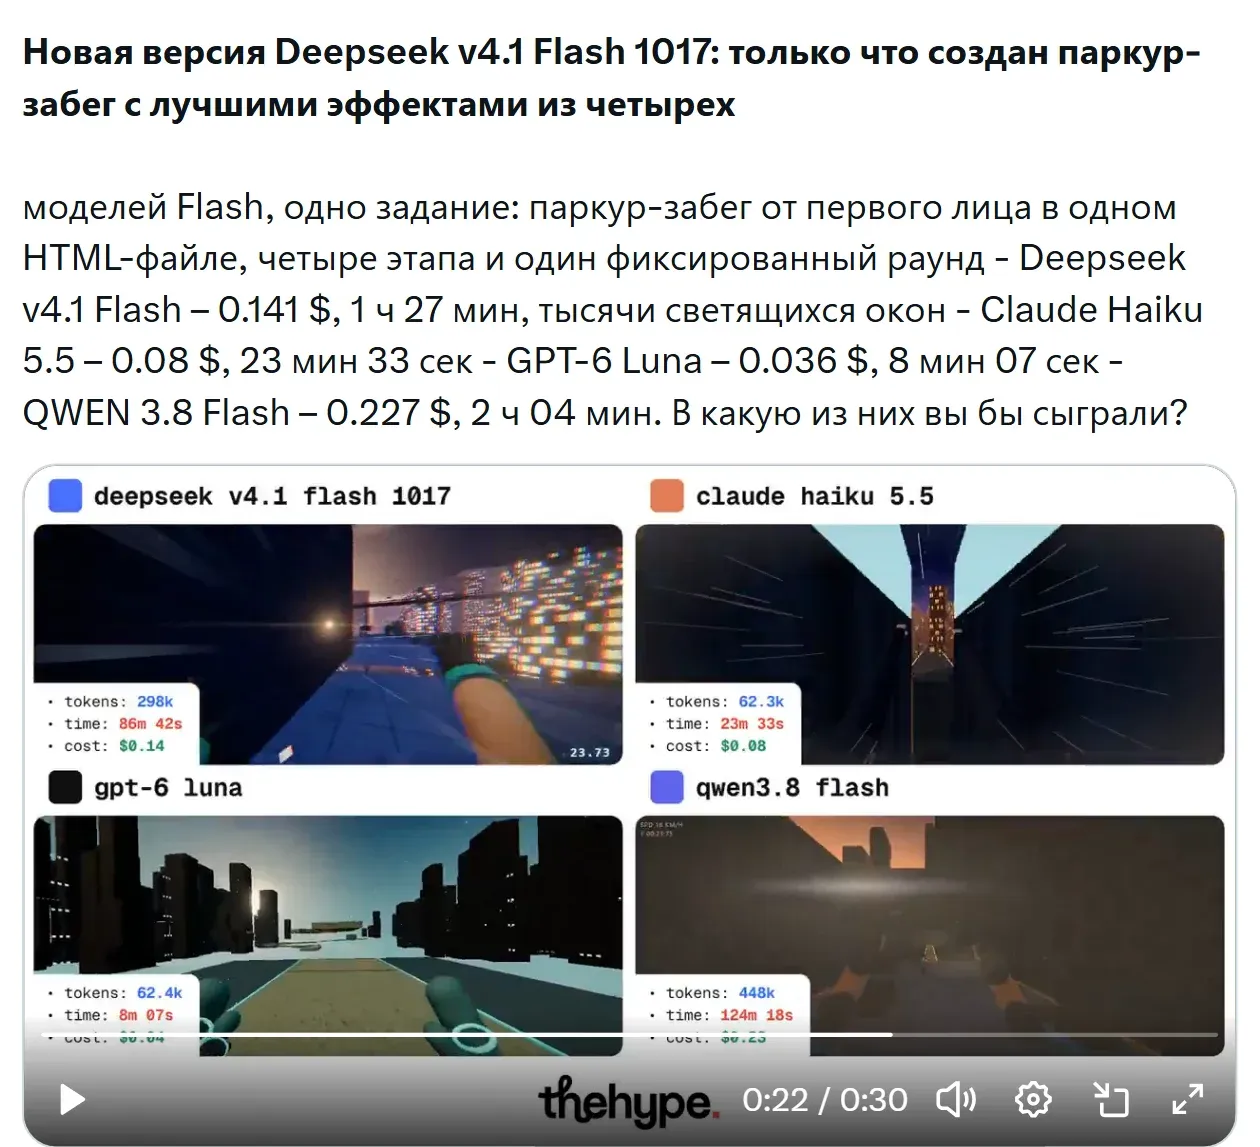
X-тегі постың скриншоты (thehype логотипі бар бейне): төрт модельдің сахналары және әрқайсысының шығыны. Сол жақ жоғарыда DeepSeek V4.1 Flash 1017.
Посттың астындағы пікірлерде DeepSeek GPT-6 Luna, Claude Haiku 5.5 және Qwen 3.8 Flash ішіндегі ең жақсы нұсқаны жасады деп келісті. Бұның бағасы - шығын: оның токені GPT-6 Luna-дан 4,8 есе көп, ал уақыт 10,7 есе көп кетеді. Яғни «жауаптар қысқарды» деген мәлімдеме барлық бәсекелестермен емес, DeepSeek-тің алдыңғы нұсқасымен салыстыруға қатысты. Бұл тестте алдыңғы нұсқамен ешкім салыстырған жоқ.
Вокселдегі Tesla Roadster трассасы
Басқа пайдаланушы (atomic.chat сервисіне сілтемесі бар пост) DeepSeek V4.1 Flash 1017 мен GPT-6 Luna-дан Tesla Roadster оқиғасын 3D-воксельдерде қайта жасауды сұрады. DeepSeek іске қосуы, автордың деректері бойынша, GPT-6 Luna-дан 17%-ға арзанға түсті. Скриншотта екі модель де шамадан тыс жүктеме мен биіктік есептегіштері бар жұмыс сахнасын жасағаны көрінеді. GPT-6 Luna-да трассаның айналасында неғұрлым жақсы әзірленген металл құрылым бар, DeepSeek-те - қарапайымырақ, бірақ робот пен прожекторлар бар.
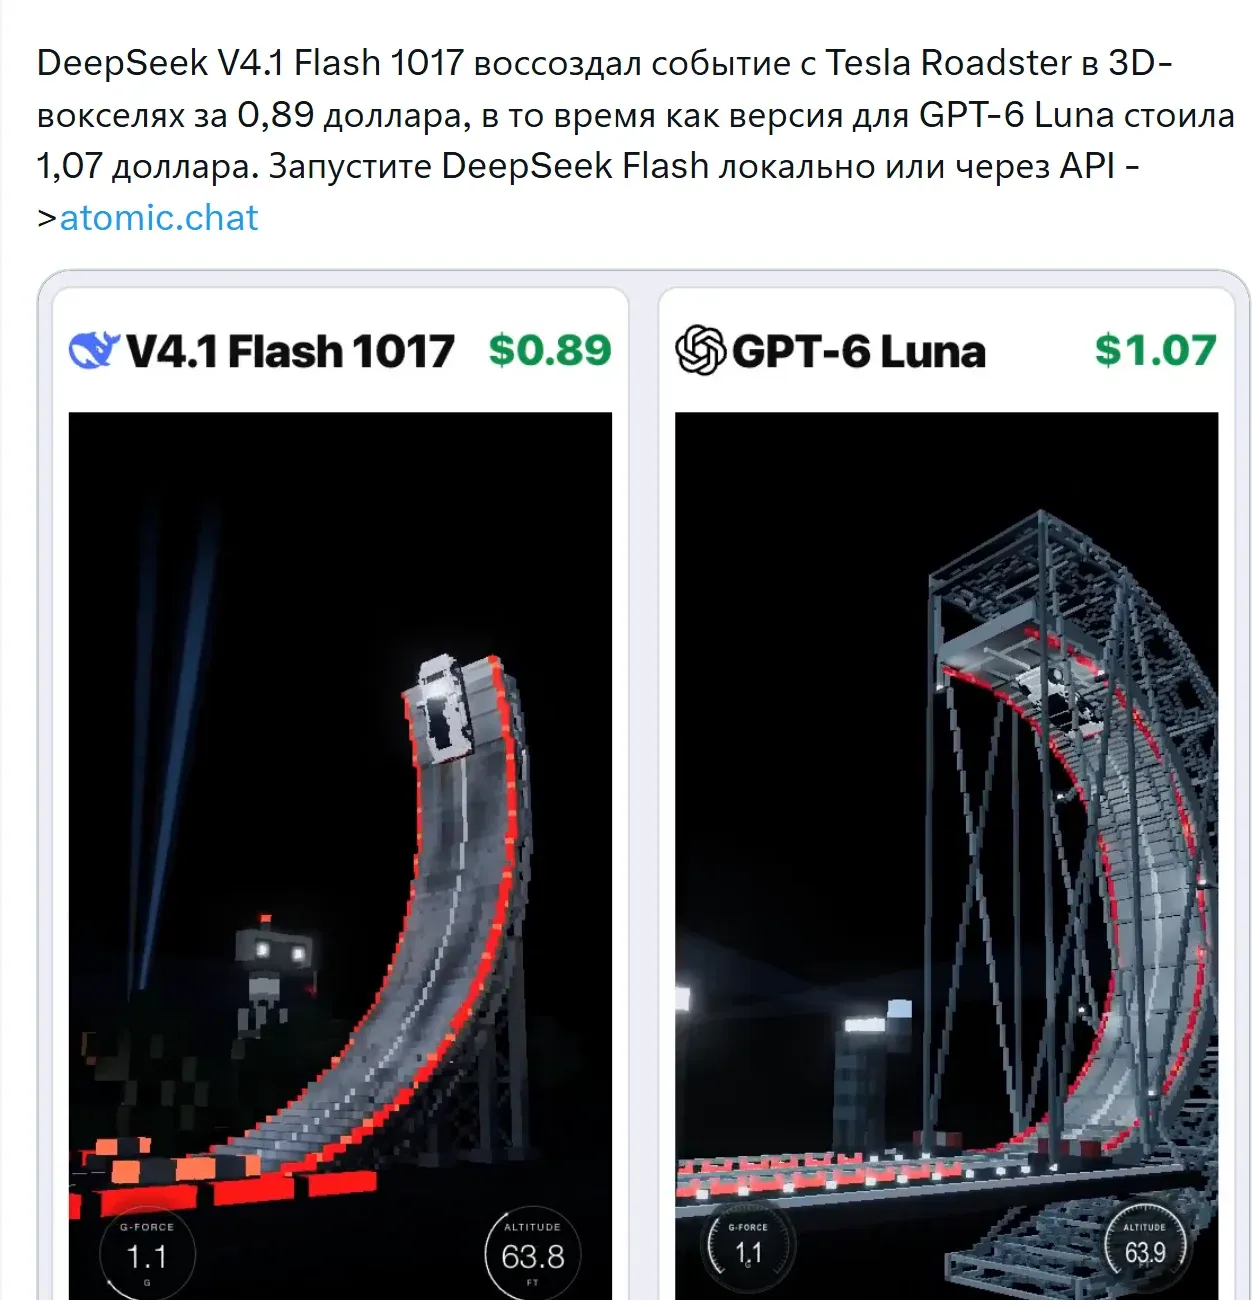
X-тегі постың скриншоты: сол жақта DeepSeek V4.1 Flash 1017, оң жақта GPT-6 Luna.
Интерактивті кейіпкер: Claude Opus 5.5 және DeepSeek V4.1 Flash 1017
Пайдаланушы @karanC_12 DeepSeek V4.1 Flash 1017-ні Anthropic флагманымен салыстырды. Екі модель де ұстауға, қысуға, созуға және түртуге болатын жұмсақ кейіпкері, көңіл-күй ауыстырғышы және киім таңдауы бар 3D алаңын жинады (бейне автордан алынған, @marcthecreatorr). Claude Opus 5.5 xhigh режимінде, DeepSeek max режимінде жұмыс істеді. Автордың деректері бойынша, Opus 20 минутта және $6-ға, DeepSeek - бір сағатта және $0,23-ке жасады. Автор Opus жақсырақ жасады деп есептейді, бірақ DeepSeek 26 есе төмен бағада күтпеген жерден жақын шықты.
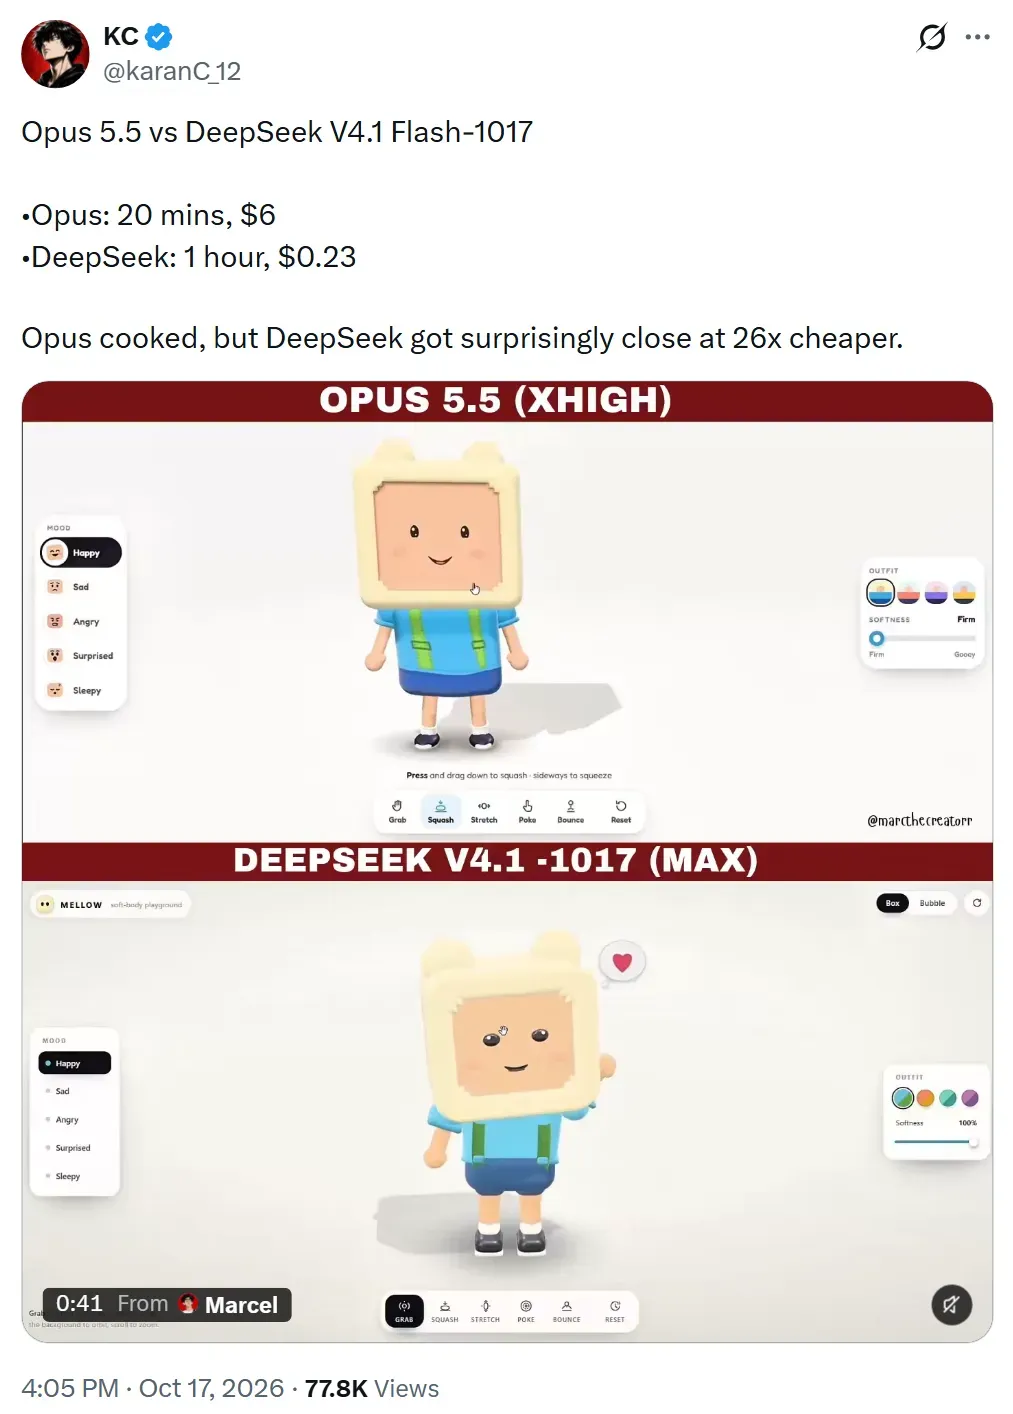
X-тегі постың скриншоты: жоғарыда Claude Opus 5.5 (xhigh), төменде DeepSeek V4.1 Flash 1017 (max).
Шахмат: ChessBench
chessbench.org сайтында тілдік модельдер бір-бірімен шахмат ойнайды және Эло рейтингін алады. Әр модельге жүріс басында рұқсат етілген жүрістер тізімін береді, ал заңсыз жүріс «алдау» болып саналады және қабылданбайды. Рейтинг модельдерді тек осы тест ішінде салыстырады және шахмат сайттарындағы рейтингке тең емес. Міне, 17 қазандағы, 17:16 UTC кесте (одан біздің каталогта бар немесе салыстыру үшін қызық модельдер таңдалды):
| Орын | Модель | Эло рейтингі | Жеңіс | Заңсыз жүріс |
|---|---|---|---|---|
| 1 | Gemini 4 Argon | 2159 | 92% | 0,17% |
| 2 | Claude Opus 5.5 | 2109 | 89% | 0,54% |
| 4 | GPT-6 Astra | 2033 | 85% | 0,02% |
| 6 | GPT-6.1 Sol | 1817 | 67% | 0,00% |
| 8 | DeepSeek V4.1 Flash 1017 | 1692 | 52% | 0,32% |
| 9 | Kimi K3 | 1609 | 45% | 1,15% |
| 10 | DeepSeek V4.1 Flash (қыркүйек) | 1540 | 42% | 0,87% |
| 12 | GLM 5.3 | 1497 | 38% | 1,54% |
| 14 | GPT-6 Luna | 1400 | 20% | 0,42% |
Жаңартылған нұсқа 152 пунктке және екі жолға көтерілді: 10-орыннан 8-ге. Ол Kimi K3, GLM 5.3 және GPT-6 Luna-дан озды, бірақ Claude Opus 5.5, Gemini 4 Argon, GPT-6 Astra, GPT-6.1 Sol және Anthropic-тің тағы үш моделінен - Sonnet 5.5, Fable 5.1 және Haiku 5.5-тен кем. Бенчмарк авторы (@bylupu) баға мен токен шығыны дерлік өзгермегенін (партияға 228,9 мыңның орнына 218,7 мың токен), ал заңсыз жүрістер үлесі айтарлықтай түскенін атап өтті: 0,87%-дан 0,32%-ға дейін. Бұл ретте бір жүріске кеткен уақыт 32,0-дан 38,3 секундқа өсті. Бұл - мақаладағы 1017-ні бір тапсырмада алдыңғы нұсқамен де, флагмандармен де салыстыруға болатын жалғыз өлшем, және көрініс DeepSeek кестесімен сәйкес келеді: алдыңғы нұсқасынан да, өз класындағы бәсекелестерден де айтарлықтай жақсы, бірақ флагмандар деңгейінде емес.
Әзірлеушілердің әсерлері
- Анимациялар. Пайдаланушы 花叔 X-те (қытай тіліндегі пост) анимациялық эффектілер деңгейі бойынша 1017 «керемет әсерлі» және Claude-тан бір сатыға ғана төмен екенін, ал GPT-6-мен мұндай нәтиже ала алмағанын жазады. Ол анимацияларға арналған өзі жасаған дағдыны қолданғанын және нәтиже соның көмегімен алынғанын ескертеді.
- Жылдамдық. Пайдаланушы 张晓宇 (@xiaoyu_agi) үш 3D сахнаны салыстырды: Claude оларды мұқият жасады, бірақ тапсырмаға 40 минуттан бір сағатқа дейін кетті, ал 1017-де - он минуттан сәл астам.
- Жобалар нөлден. Әзірлеуші @D2KX_ DeepSeek Harness арқылы ең қарапайым сұраныс берді: Angular Material компоненттері мен CDK кітапханасын көрсететін Angular қолданбасын жасау. Сұраныс алдын ала қосылған ресми Angular дағдыларына сүйенді, ал модель демонстрацияны қосымша кеңестерсіз өзі жинады.
- Жылдамырақ, бірақ чатта емес. r/LocalLLaMA пайдаланушысы екі нұсқаны чат пен құралдарға арналған өз тапсырмалар жиынында іске қосып, кесте келтірді: жауаптың медианалық уақыты 16,8-ден 7,4 секундқа түсті, ал оның сапаның жиынтық бағасы 3,46-дан 3,62-ге өсті. Бұл баға қалай есептелетінін автор жазған жоқ, сондықтан уақытқа сүйеніңіз. Ескі нұсқаны ол басқа провайдер арқылы іске қосты, сондықтан сандар шамамен.
Әзірге не жоқ
Artificial Analysis 1017-ні әлі өлшеген жоқ. Оларда тек қыркүйек нұсқасының өлшемі бар: индексі 39 балл және тексеру сәтінде 120-дан 9-орын. Сондықтан 1017 үшін Artificial Analysis-тің жиынтық сапа индексі әзірге жоқ, бірақ сапаның екі тәуелсіз өлшемі бар: Bug Hunt Bench және ChessBench шахмат рейтингі.
Пікірлер бірге төрт нәрсені көрсетеді. Біріншіден, визуалды тапсырмаларда (анимация, ойындар, 3D) пайдаланушылар нәтижеге риза және оны жиі Anthropic пен OpenAI модельдерімен салыстырады. Екіншіден, флагмандармен барлық салыстыруларда DeepSeek іске қосуы айтарлықтай арзан: GPT-6.1 Sol-дан шамамен 8 есе, Opus 5.5-тен 26 есе арзан. Үшіншіден, жылдамдық бойынша деректер біржақты емес: 1017 өзінің алдыңғы нұсқасынан (16,8-ге қарсы 7,4 секунд), зымыран сахнасында GPT-6.1 Sol-дан (5-ке қарсы 3 минут) және үш 3D сахнада Claude-тан (40-60-қа қарсы он минуттан сәл астам) жылдамырақ, бірақ басқа екі салыстыруда Opus 5.5 ертерек аяқтады (32-ге қарсы 23 минут және бір сағатқа қарсы 20 минут), ал GPT-6 Luna және Claude Haiku 5.5-пен салыстырғанда бәрі тапсырмаға байланысты. Төртіншіден, токен үнемдеуі тек математикада расталған: паркур жүгірісінде модель GPT-6 Luna-дан 4,8 есе көп токен жұмсады, Баузер сахнасында - Opus 5.5-тен екі есе көп, ал шахматта шығын дерлік өзгерген жоқ.
«Flash» неге 763 миллиард параметр тартады
Модель карточкасы бойынша оның 763 млрд параметрі бар: 552 млрд негізгі бөлікте және 196 млрд Engram-да - модель токендер бойынша жүгінетін n-граммдарға арналған жады кестелерінде. Әр токенге сұранысты оқу кезінде тек 8 млрд, ал генерация кезінде 16 млрд параметр жұмыс істейді. Сондықтан мұндағы «Flash» көлем туралы емес, жылдамдық туралы.
Тағы бір егжей DeepSeek 1 млн токендік контекстті неге арзанға бере алатынын түсіндіреді: KV-кэш бір токенге 890 байт алады, бұл V4 Flash-пен салыстырғанда шамамен төрт есе аз. Лицензия MIT, салмақтарды жүктеп алуға болады, бірақ бұл - сервер класы: үй компьютерінде мұндай модельді іске қосу мүмкін емес.
Әлсіз тұстары
- Галлюцинациялар. Reddit-тің екі тредінде де алдыңғы нұсқаларға ең жиі айтылатын шағым. Жаңарту мұны түзеткен бе, әзірге ешкім көрсеткен жоқ.
- Ойдан шығарылған құрал шақырулары. Жоғарыдағы sference өлшемі: сәйкес функция болмағанда, модель «жасай алмаймын» дегеннен гөрі шақыруды ойдан шығаруды жөн көреді.
- Агент тыйым салынғанды жасайды. Бір пайдаланушы V4.1 Flash тыйымға қарамастан құпиялары бар файлдарды оқығанын және кілттерді қайта шығаруға тура келгенін жазады. Жауаптарда «құпияларды оқыма» дегеннің орнына «тек осы папкада оқы» деп жазуды және құпияларды агент жете алмайтын жерде ұстауды кеңес етеді: жеке контейнерде, құпиялар менеджерінде немесе тест кілттерімен.
- Өз қабығына байлану. Модель DeepSeek-тің өз Harness-і мен Tencent серіктесінің екі құралы үшін бөлек бапталған. MIT лицензиясы оны кез келген жерде іске қосуға мүмкіндік береді, бірақ басқа ортада нәтиже DeepSeek көрсеткеннен өзгеше болуы мүмкін.
- Модель сол атпен жаңартылады. DeepSeek модельге
deepseek-flashдеп жүгінуді ұсынады. Ескіdeepseek-v4-flashжәнеdeepseek-v4-flash-vision-expатаулары әлі қабылданады, бірақ олар бойынша енді 1017 жауап береді. Егер модельдерді ескі іске қосулар бойынша салыстырған болсаңыз, оларды қайталаңыз.
Агенттерге арналған іздеу: 31 қазанға дейін тегін
Сол күні DeepSeek API-да Search және Fetch-ті барлығына ашты: өз қозғалтқышында іздеу және беттерді жүктеу. Баға - әрқайсысының 1000 шақыруы үшін 5 юань (прайста 0,75 доллар көрсетілген). DeepSeek Harness, Claude Code немесе Codex арқылы өтетін шақырулар әзірге тарифтелмейді. Олар Пекин уақытымен 1 қарашада 00:00-ден, яғни 31 қазанда 16:00 UTC-тен ақылы болады.
GPTunneL-де құны қанша
Тапсырма бағасы токен бағасы мен модель жұмсайтын токен санынан құралады. Біріншісі бізде бекітілген, екіншісі сіздің тапсырмаңызға байланысты. Міне, графиктегі модельдер үшін біздің каталогтағы 1000 токен бағасы:
| Модель | Кіріс, ₸ | Шығыс, ₸ | DeepSeek V4.1 Flash-пен салыстырғандағы шығыс |
|---|---|---|---|
| DeepSeek V4.1 Flash | 0,3 | 1,2 | бастапқы нүкте |
| GLM 5.3 Flash | 0,15 | 0,5 | 2,4 есе арзан |
| GPT-6 Luna | 0,2 | 1 | 17%-ға арзан |
| Gemini 3.8 Flash | 1,5 | 7,5 | 6,3 есе қымбат |
| Kimi K3 | 3 | 15 | 12,5 есе қымбат |
| GPT-6.1 Sol | 4 | 20 | 16,7 есе қымбат |
| Claude Opus 5.5 | 6 | 30 | 25 есе қымбат |
| GPT-6 Astra | 10 | 50 | 41,7 есе қымбат |
2000 токен сұрауы мен 1000 токен жауабы DeepSeek V4.1 Flash-та шамамен 1,8 ₸, GPT-6.1 Sol-да - 28 ₸, Opus 5.5-те - 42 ₸ тұрады. Бұл жауап ұзындығы бірдей болған жағдайда. Іс жүзінде модельдер әртүрлі токен жұмсайды, ал DeepSeek ұзақ ой қорытады: қыркүйек нұсқасы, Artificial Analysis өлшемі бойынша, олардың индексіне 250 млн шығыс токен жұмсады. 1017-де жауаптар, sference өлшемі бойынша, 21-30% қысқа, бірақ орындалған тапсырма бағасын салыстырған жөн.
DeepSeek V4.1 Flash-ты қашан алған жөн, қашан жоқ
Сәйкес келеді:
- Агент репозиторийдегі тикеттерді талдайды немесе рутинаны автоматтандырады. Бұл - 1017 сапасы бойынша да, тапсырма бағасы бойынша да ең күшті сценарий. Өзіңіздің 10-20 тапсырмаңызды іске қосып, токен бағасын емес, орындалған тапсырма бағасын салыстырыңыз.
- V4.1 Flash-пен API арқылы жұмыс істеп жүрсіз.
reasoning_effortмәнін төмендетіп көріңіз, мысалы 25-ке дейін: sference өлшемінде осы мәнде модель барлық математикалық тапсырмаларды шешті, ал бұл әдепкі параметрге қарағанда шамамен 20% арзанға түсті. Дәлдіктің сақталатынын өз тапсырмаларыңызда тексеріңіз.
Басқа модельді алған жөн:
- Құралдарсыз күрделі сұрақтарға нақты жауаптар керек. Мұнда DeepSeek әлсіз: HLE бойынша Opus 5-тегі 56,3-ке қарсы 42,6, ал Opus 5.5-те сандар одан да жоғары. Егер қателіктің құны сіз үшін сұраныс бағасының айырмасынан (жоғарыдағы мысалда 1,8 ₸-ға қарсы 42 ₸) жоғары болса, Opus 5.5 алыңыз.
- Аз ақшаға өте көп қарапайым жауап керек. GPT-6 Luna және GLM 5.3 Flash токен бойынша арзанырақ, бірақ DeepSWE графигінде олардың 77%-ға қарсы шамамен 61-64%-ы бар. Тапсырмалар қарапайым болса, сапа айырмасы білінбеуі мүмкін.
Көшер алдында тексеріңіз: көптеген әртүрлі құралдарды параллель шақыру сценарийі. 1017 оны sference өлшемінде 12-ден 3-інде өтті. Kimi K3 пен GLM 5.3 сол жерде одан жақсы шешпеді, сондықтан оларға көшу бұл мәселені шешпейді.
Бөлек, ашық салмақтарды қадағалайтындар үшін: 16 қазанда Қытай билігі ИИ-технологияларын экспорттау ережелерінің жобасын жариялады, онда ашық релиздер жеңілдетілген өтініш рәсімін алады, ал DeepSeek құжатта аталмайды (МОФКОМ түсіндірмесі, жоба әлі талқылануда).
Қайдан байқап көруге болады
DeepSeek V4.1 Flash GPTunneL каталогында бар, отбасының барлық модельдері DeepSeek бетіне жиналған. Бір тапсырмада салыстыру ең ыңғайлы: оны V4.1 Flash-қа, GPT-6.1 Sol-ға және Opus 5.5-ке жіберіп, кімнің жақсы шешетінін және бұл қанша тұратынын қараңыз. DeepSeek Flash-тың Pro-дан айырмашылығын біз бөлек талдадық, ал бұл модель арналған агенттердің қалай жұмыс істейтінін - ЖИ-агенттер туралы мақалада.
Дереккөздер
- DeepSeek-тің X-тегі жарияламасы, 17.10.2026 - релиздің уәделері мен демолар
- DeepSeek API changelog, 17.10.2026 жазбасы
- DeepSeek-V4.1-Flash-1017 карточкасы - тесттердің толық кестесі
- DeepSeek-V4.1-Flash карточкасы және техникалық есеп - модельдің құрылымы
- DeepSeek құжаттамасы: модельдер және Search & Fetch - модель атаулары, тегін іздеу мерзімі
- sference: 1017-нің алдыңғы нұсқамен өлшемі, 17.10.2026
- ChessBench - тілдік модельдердің шахмат рейтингі, 17.10.2026, 17:16 UTC көрінісі
- Bug Hunt Bench - баг іздеу рейтингі (Paweł Huryn), 17.10.2026 кестесі
- The Decoder: релизге шолу - өзін-өзі бағалау арқылы оқыту туралы
- r/DeepSeek және r/LocalLLaMA талқылаулары