
Сізге 2025 жылдың 24 желтоқсанындағы газетті беріп, наурыз аяғына дейін не болатынын жазып шығуды сұрады деп елестетіңіз. Күн сайын жаңа нөмір әкеледі, ал сіз ойыңызды өзгерте аласыз: пайыздарды қайта жазу, кешегі сөзіңіздің бос сөз екенін мойындау, басқа нұсқаға бәс тігу. Соңында жауаптарды көрсетеді, және бағаланатыны дөп түскен жауаптардың саны емес, сенімділігіңіздің шындыққа қаншалықты сай келгені. Сенімді түрде өтірік айтсаңыз, минус. Үнсіз қалсаңыз, нөл. Дөп басып, күмәнданбасаңыз, бір.
FutureSim дәл осылай құрылған, оны ELLIS Tübingen, Макс Планк атындағы интеллектуалдық жүйелер институты және Штутгарт университетінен әріптестерімен бірге Шашват Гоэл, Нихил Чандак және Арвинд Арун жасаған. Жұмыс 2026 жылдың мамырында жарық көрді және ICML 2026 аясындағы болжау воркшопында Best Paper сыйлығын алды. 15 қарашада авторлар үшінші тоқсанның нәтижелерін жариялады, және олар лидербордтағы жай жолдан қызығырақ: үздік модель онда 50% дәлдік көрсетеді, ал бірінші жүрісте 25% болған, дегенмен сұрақтар жинағы басқа және тікелей салыстыруға болмайды.
Бұл хроника, хрусталь шар емес
Ең алдымен түсіну керек: агент болашақты болжамайды. Әлем 2025 жылдың 24 желтоқсанына кейін шегіндіріліп, күн сайын алға жылжытылады. Жаңалықтар бөліп-бөліп келеді, сұрақтар жабылады, ал дұрыс жауаптар зерттеушілерде әлдеқашан бар: оқиғалар қаңтар мен наурыз аралығында болғандардан таңдалған.
Бұл ишараға айналмау үшін тесте күн шектеуі бар. Корпус Common Crawl News-тен жиналған: 141 дереккөзден 7,36 миллион мақала, 88 күндік симуляция барысында оларға тағы 244 мың қосылады. Симуляцияның ағымдағы күнінен кейін шыққан мақаланы агент ала алмайды: іздеумен де, терминалмен де, көндірумен де.
Оның бар болғаны екі әрекеті бар: submit_forecasts() - ықтималдықтарды қою немесе қайта жазу, және next_day() - келесі күнге өту. Нені болжау, қанша рет жаңарту, қашан әрі қарай жылжу - агент өзі шешеді. Міне, бәрі осында: модель «жауап бере ала ма» емес, «жауабын уақытында өзгерте ала ма» тексеріледі.
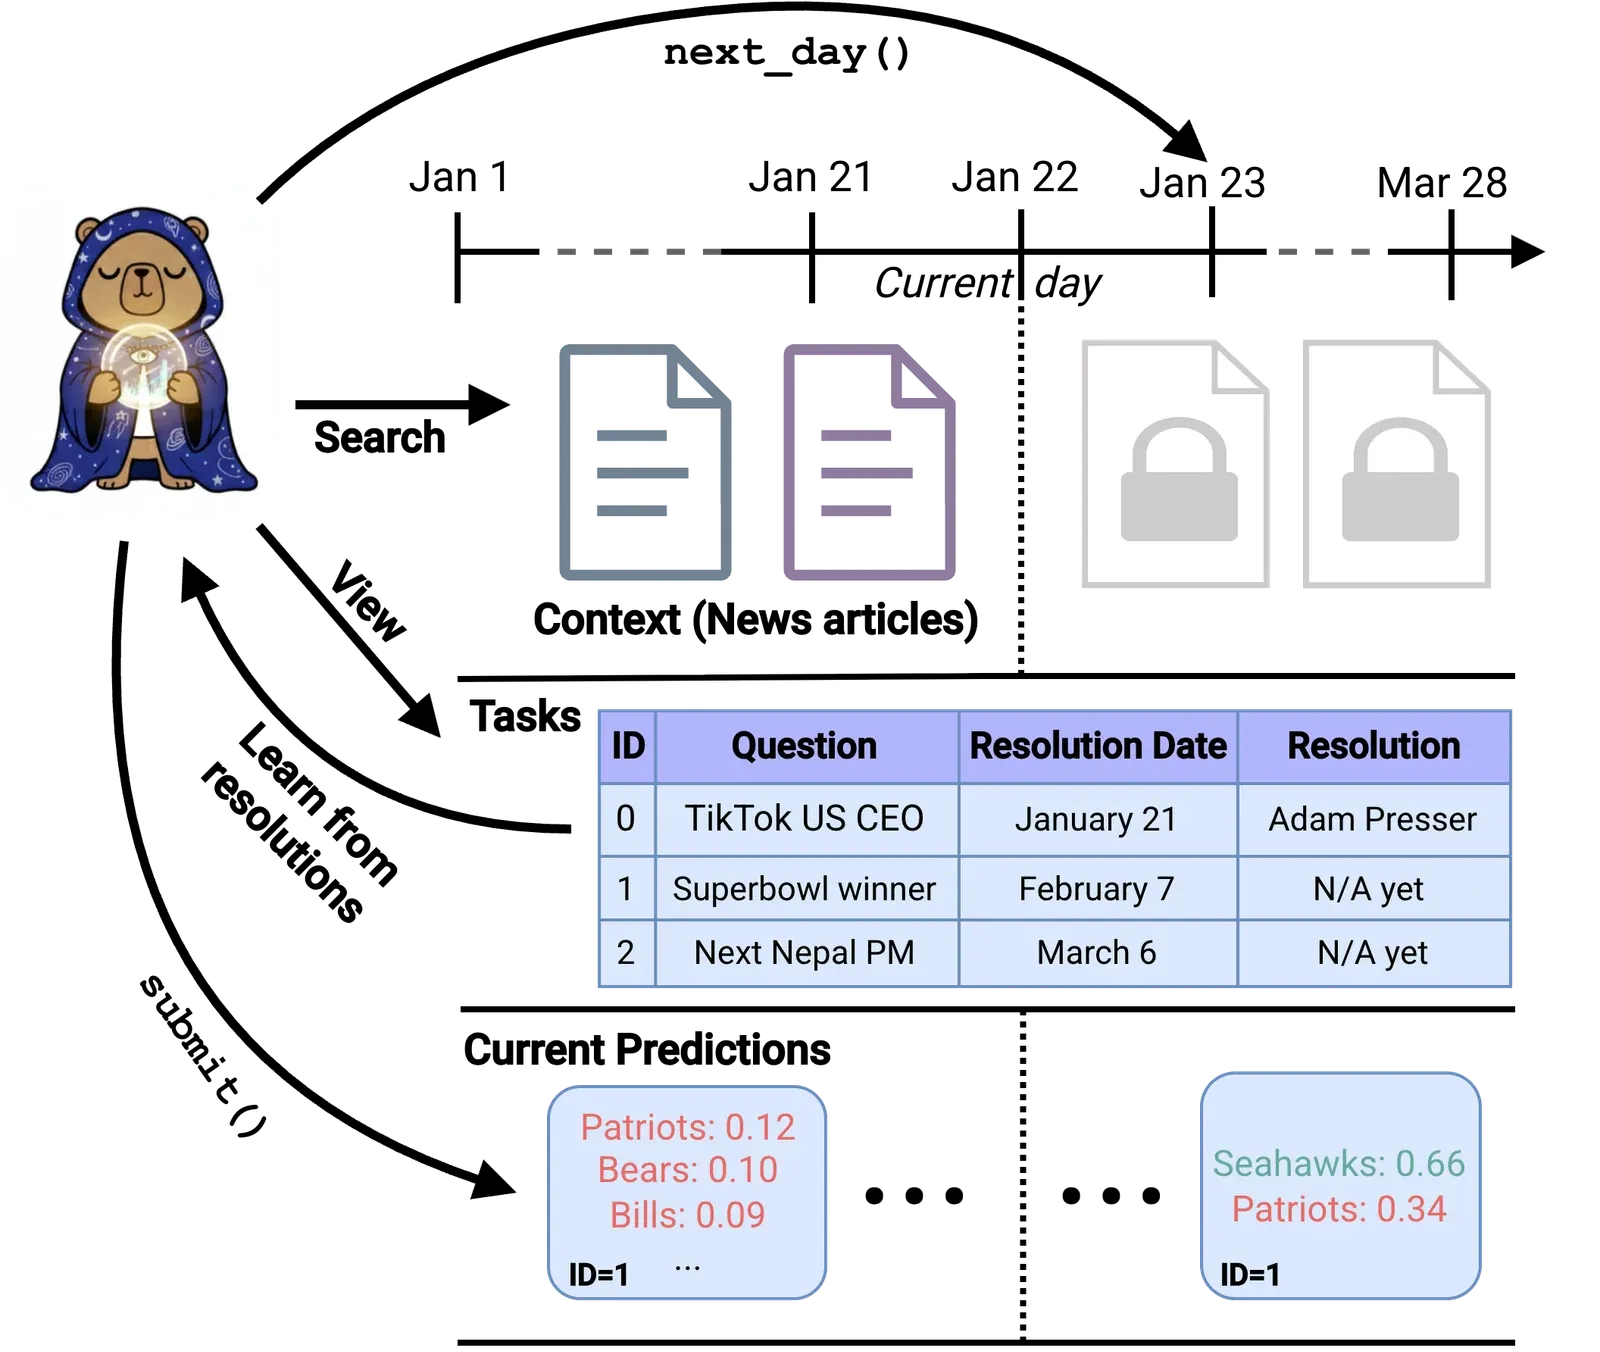
Схема: FutureSim. Одан неге бұл викторина емес екені көрінеді: келесі күнге өтпейінше болжамды өзгертуге болады, ал дұрыс жауап тапсырмалар кестесінде шешім күні келгенде ғана пайда болады, оған дейін сонда «N/A yet» деп тұрады. Пунктирдің оң жағында агентке әлі қолжетімсіз нәрсе: мақалалар да, жауаптар да.
330 сұрақ, 88 күн және 25%
Бірінші жинақ - Al Jazeera жаңалықтарынан жиналған 330 қысқа сұрақ. Агент нәтиже нұсқаларын өзі ойлап табады: «иә/жоқ» емес, ықтималдықтары бар кандидаттар тізімі, букмекердегідей, тек коэффициенттің орнына пайыз.
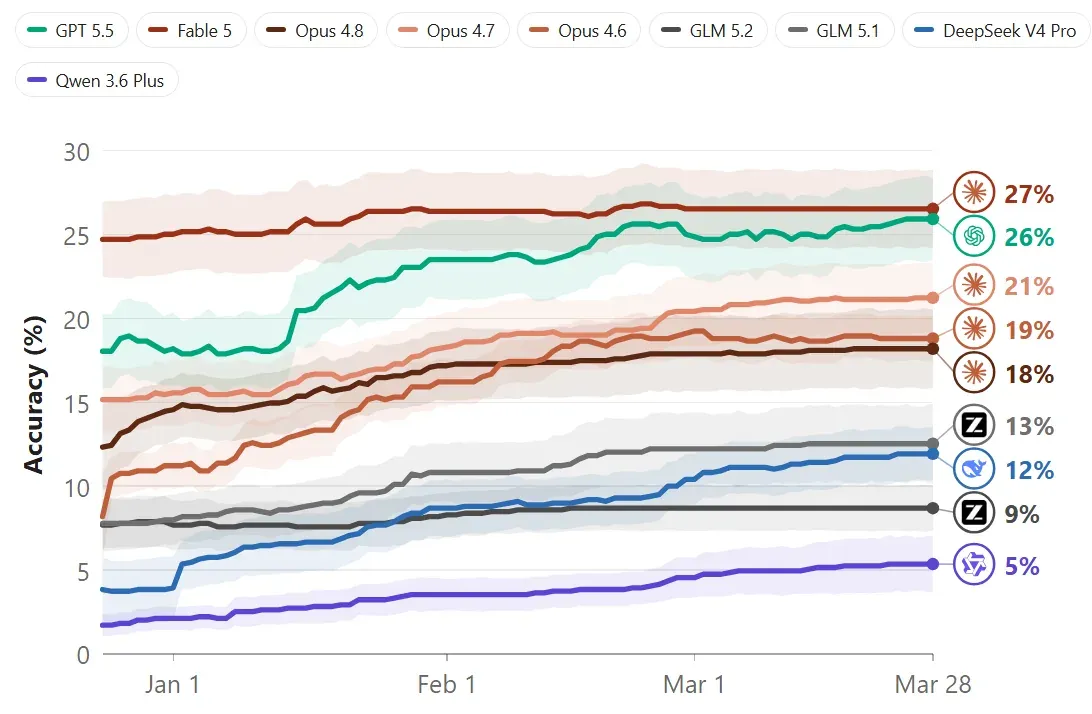
График: FutureSim, 2026 жылғы 16 қарашадағы жағдай. Тік ось - пайызбен дәлдік: 28 наурызға қарай көшбасшыда 27%, ең төменгі модельде 5%. arXiv мақаласында үздік агент үшін 25% көрсетілген: препринттегі сан мен жаңартылған лидербордтағы сан аздап алшақтайды, ал тақырыпта жарияланған мән тұр.
Әрі қарай Brier skill score есептеледі. Формула қарапайым: әр нұсқа үшін жарияланған ықтималдық пен факт арасындағы айырма алынады (нұсқа дұрыс болса бір, болмаса нөл), ол квадратқа шығарылып, қосылады. Нәтиже бірден алынады. Бір - сенімді және дұрыс. Нөл - үнсіз қалу. Минус - сенімді түрде қателесу.
Міне, енді қызығы басталады. Бірінші жүрісте үздік агент 25% дәлдік берді, яғни сұрақтардың төрттен бірінде ең үлкен ықтималдық қойылған нұсқа дұрыс болып шықты. Ал көп модель минусқа кетті: олардың Brier skill score-ы нөлден төмен, яғни мүлде болжамағаннан да нашар.
Неге «нөлден төмен» парадокс емес
Бір қарағанда бос сөз сияқты: қалайша жауап бермегеннен де нашар болуға болады? «0% дөп түсу» түбі емес пе?
Жоқ. Бұл шкалада нөл - «бірде-бір дөп түспеу» емес, нақты әрекет: бірде-бір ықтималдық қоймау. Сонда айыппұл тек нөл алған дұрыс жауап үшін жазылады. Бірден айырма - бір, квадратта - бір. Балл = 1 − 1 = 0. Санақ басы «мен үнсіз қалдым».
Ал енді модель B нұсқасына 0,8, A нұсқасына 0,3 қойды, ал дұрысы A болып шықты. Айыппұл: 0,8² + (0,3 − 1)² = 0,64 + 0,49 = 1,13. Балл: −0,13. Ол жай ғана қателескен жоқ, сенімділігін босқа жұмсады, үнсіз қалу әділдеу болар еді. Оның үстіне ықтималдықтардың қосындысы бірге тең болуы міндетті емес, сондықтан бірден екі қате нұсқаға сенімді түрде бәс тігіп, минусқа одан әрі кетуге болады.
Осыдан тестің кез келген кестеден маңыздырақ негізгі қорытындысы шығады: мәселе модельдердің аз білуінде емес. Мәселе - олар өз білімінің шегін сезінбейді. 30% қою керек жерде 80% қояды және жаңа жаңалықтар келгенде бағасын қайта қарастырмайды.
Бөлек эксперимент мұны екінші жақтан растады. Барлық агентке бірдей әлсіз бастапқы болжам берілді, ал ешқайсысы нөлдік деңгейден асып түспеді. Айналадағы оқиғалар өзгерді, жаңалықтар келіп жатты, ал модельдер алғашқы нұсқасына жабысып қалды. Пікірін өзгерту - оларда болмаған дағды.
Екінші тоқсан: калибрлеу бар, бейімделу жоқ
Сәуір-маусым оқиғалары бойынша жүріс суретті қайта аударды. Дәлдік бойынша үздік - GPT 5.6 Sol: 28 маусымға қарай 31%, ал 15%-тен бастаған. Өсімнің барлығы дерлік симуляция барысында жиналды, бастапқы білім есебінен емес.
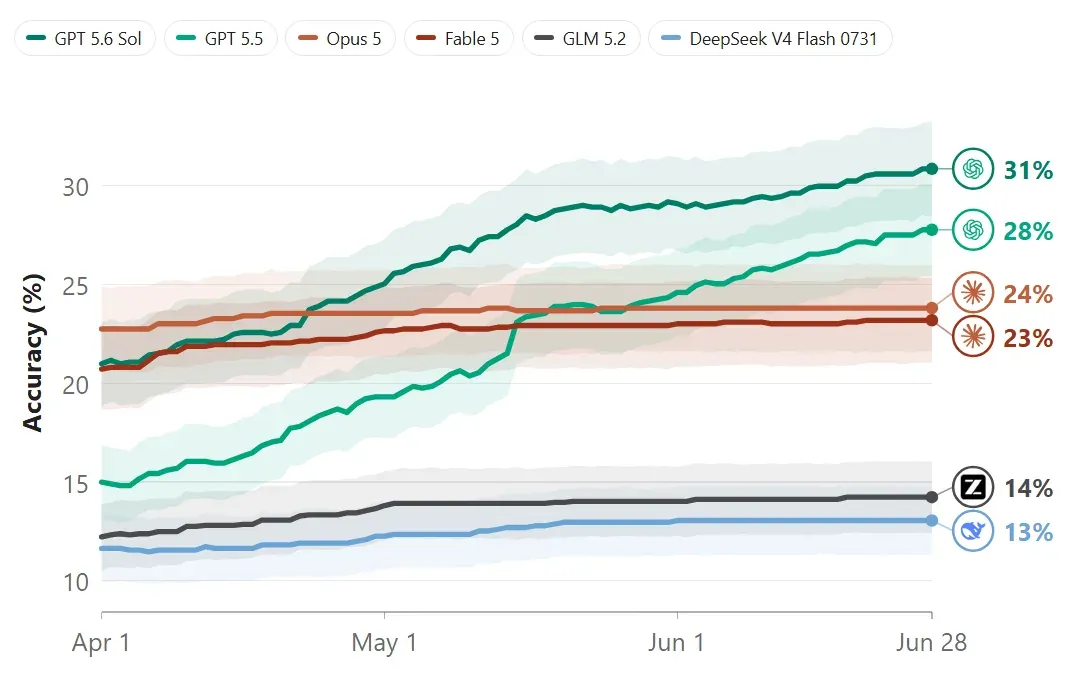
График: FutureSim, 2026 жылғы 16 қарашадағы жағдай. Тік ось - пайызбен дәлдік. Екі түрлі стратегия көрінеді: Claude-тың бастапқы деңгейі жоғары, бірақ сызығы дерлік көлденең, ал GPT төменнен бастап тік өседі, симуляция ортасында GPT дәлдік бойынша Claude-тан озып кетеді.
Дәл осы жүрісте DeepSeek-тен теріс калибрлеу табылды: модель қателескен жерде жоғары ықтималдық қойған. Ал GPT 5.6 Sol шамамен 15 мың құрал шақыруын жасады, бұл кез келген басқа модельден көп, және алдыңғы нұсқасынан дәл белсенді іздеу есебінен озды.
Үшінші тоқсанда модельдер ойын өзгертуді үйренді
15 қарашадағы жаңарту шілде-қыркүйек оқиғаларын 252 ашық сұрақта қайта ойнатады, ал сурет басқа. Іздеу енді қолмен корпус бойынша емес, әр жүріске 3000 шақыру шектелген Exa Snapshot арқылы жүреді.
Ең бастысы: екінші тоқсанның жазық қисықтарының орнына модельдердің көбі симуляция барысында 5-15% қосады. Оларға айтып қойғанынан емес, өздері алатын жаңалықтарды оқып, болжамды түзеткендіктен. Барлық модель, ашықтары да, оң калибрленген болды: 70% қойса, шамамен 70%-ға дөп түседі.
Дәлдік калибрлеумен бірге өсті: Opus 5.5-те 50%, GPT 6.1 Sol-да 47%, DeepSeek V4.1 Flash-те 41%, Muse Wonder Full-да 38%, GLM 5.3 Flash-те 30%. Бриер шкаласы бойынша бұл тоқсанда айырма 0,13-тен 0,35-ке дейін, барлық мән оң. Бірінші жүрістің 25%-ымен тікелей салыстыруға болмайды: басқа сұрақтар жинағы, басқа іздеу, басқа модельдер. Бірақ бағыт көрінеді: жарты жылда үздік нәтиже екі есе өсті.
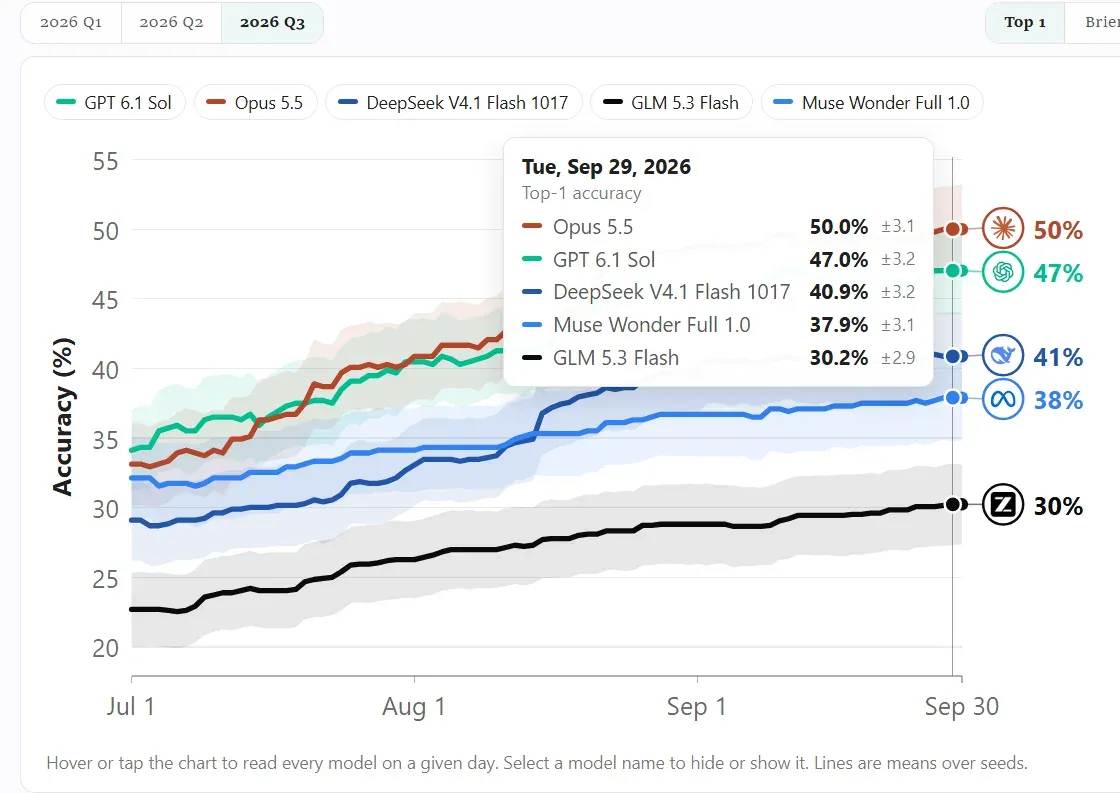
График: FutureSim, 2026 жылғы 16 қарашадағы жағдай. Тік ось - пайызбен дәлдік, Brier емес: 1 шілдеде үздік модельдерде 33-35%, 30 қыркүйекте Opus 5.5-те 50%. Көшбасшы 17 пайыздық тармақ қосады, ең төменгі модель шамамен 7.
Brier skill score бойынша бірінші орын басында да, финалда да Claude Opus 5.5-те. Авторлар қызық детальді атап өтті: модель бағалаудың қалай құрылғанын тез түсініп, «ештеңе болмайды» мен «басқа» нұсқаларына бәс тігуді дерлік қойды, бұл тесте мұндай жауаптар ұтыс әкелмейді. Бұл алаяқтық емес, бірақ болжау да емес: агент ойын ережесін түсініп, соған бейімделген.
Модельдер арасындағы айырма әдеттегі код рейтингімен сәйкеспейді: үшінші тоқсанда соңғы орында GLM 5.3 Flash 0,13-пен, ал DeepSeek V4.1 Flash 0,25-пен ортада тұр. Дәлдік көшбасшысы да ауысты: екінші тоқсанда GPT болды, үшіншіде Opus 5.5 алға шықты.
Мен үшін мұнда күштердің орналасуы емес, бейімделудің жеке дағды болып шыққаны маңызды. Оны модельдің көлемімен сатып алуға да, код рейтингінен көруге де болмайды.
Тест ұрланып қарауға жол берді
Ең адамдық оқиға бірінші тоқсанда болды. Әлемде бір шулы тақырып бар еді, ол туралы сұрақтар көп болды. Модельдер жауаптарды көршілес сұрақтардың тұжырымынан шығара бастады: кім жеңетінін білмесең, қасында не сұрап жатқанын қара.
Мұны cross-task leakage деп атады. Адал түрде түзетті: әр сұрақ үшін күшті модельден қалған сұрақтарға қолжетімділікпен және онсыз болжам сұрады, ал айырмасы күдікті үлкен сұрақтарды алып тастады. Сабақ әмбебап: агенттік тесте байланысты тапсырмалар көбейсе, «тәуелсіз сұрақтар» тәуелсіз болудан қалады, ал агент ешкім жоспарламаған ишара алады.
Бұл маған сандардың өзінен де қатты ұнайды. Бенчмарк жасайтын адамдар өз өлшеу құралы қай жерде тайғанын ашық айтып, оны қалай түзеткенін көрсетті. Дұрыс жұмыс осылай көрінеді, әдіснамасында тесігі бар кестелерге ұқсамайды.
Бенчмарк жазбасаңыз, мұнымен не істеу керек
Тесттің сыртқы тексерісі бар екені пайдалы: болжам нарықтары. Сұрақ Polymarket-пен сәйкес келген жерде ЖИ әртүрлі ұстанымда болды: Непалдағы сайлауда көпшілікке ілесіп, орынды дәйектер келтірді, сауда көлемі 700 миллион доллар болатын Super Bowl-де кейде алда болды, ал Grammy мен Ұлыбританиядағы округтік сайлауларда адамдарға айтарлықтай ұтылды.
Практика үшін қорытынды қарапайым. Тар, жақсы зерттелген сюжеттерде ЖИ болжамы екінші пікір ретінде пайдалы. Ал дәм, кездейсоқтық немесе кенеттен болған оқиға шешетін кең сюжеттерде пайдасы жоқ.
Ал егер агентті жаңалықтар, логтар немесе есептер ағынында іске қосатын болсаңыз, кез келген бенчмарктан арзан бір нәрсені тексеріп көріңіз. Оған тапсырма беріңіз, содан кейін бірінші қорытындыға қайшы келетін жаңа факт қосыңыз да, ол жауабын өзгерте ме, қараңыз. Алғашқы нұсқасын қайсарлықпен қайталайтын модель сізге айлар бойы сенімді түрде өтірік айтады, ал жалпы рейтингтерден оны көрмейсіз.
Бұл тест нені көрсетпейді
Әділдік үшін, 25% - үкім емес. Авторлардың өздері нәтижелерді төменгі шек деп атайды: корпус шектеулі, құралдар шектеулі, ал күн бойынша сенімді сүзгімен іздеу - жеке шешілмеген мәселе. Деректерге қолжетімділік кеңірек болса, агенттер көбірек көрсетер еді.
Тағы үш ескерту. Бірінші: сандар харнеске байланған. Codex, Claude Code және OpenCode - әртүрлі қаптамалар, модельдер арасындағы айырманың бір бөлігі қаптамалар арасындағы айырма болуы мүмкін. Екінші: «симуляция барысында 5-15%» өсімі іздеу сапасымен араласқан, модель ойлауды жақсартты ма әлде жай ғана іздеуді үйренді ме, белгісіз. Үшінші: барлық доменге бір балл. Саясат, спорт және сайлау қиындығы бойынша тең емес, ал кестеде олар біріктірілген.
Сондықтан бұл сандардан «ЖИ болашақты болжайды» деген әдемі сурет шықпайды. Керісінше де, ЖИ мұны істей алмайды деген де шықпайды.
Қорытындының орнына
Пікірін өзгерте алу - интеллектіге қосымша бонус емес, оның бөлігі. Біз модельдерді не білетінімен өлшеуге үйренгенбіз, ал қателескенін білгенде қалай әрекет ететінін өлшеуді ұмытып кетеміз. FutureSim, барлық ескертулеріне қарамастан, дәл осыны өлшейді және ең жақсы модельдердің өзі мұны әлі қиналып үйреніп жатқанын көрсетеді.
Дереккөздер
- FutureSim беті - лидерборд, тест дизайны және 2026 жылғы 15 қарашадағы Q3 жаңартуы.
- FutureSim: Replaying World Events to Evaluate Adaptive Agents - мақала, 2026 жылғы 14 мамыр.
- FutureSim коды және OpenForesight деректер жинағы.