
Әзірлеуші Tarek Ziadé шамамен 180 млрд параметрі бар Qwen3.8-Flash-Next үлгісін 32 ГБ бірыңғай жадысы бар MacBook-те іске қосу экспериментін жариялады. Нәтиженің негізгі кілті — Mixture of Experts (MoE) сәулеті және SSD жинақтағышынан таңдалған нейрожелілік блоктарды ағындық жүктеу. Жобаның соңғы нұсқасында генерация жылдамдығы секундына 13,9 токенге жетіп, сол құрылғыдағы мамандандырылған Strata қозғалтқышының көрсеткішіне жақындады.
Бұл нәтиженің маңызы — модельдің басым бөлігі жедел жадыға бір уақытта толық жүктелмейді. Дегенмен қате тұжырымнан аулақ болған жөн: 180B параметрлі модель кәдімгі мағынада «32 ГБ жадыға сыйып кеткен жоқ». Оның салмақтарының айтарлықтай бөлігі дискіде қалды, ал жүйенің жұмысы кванттауға, кэштеуге және SSD өткізу қабілетіне тікелей байланысты. Бұл әмбебап шешім емес, зерттеу прототипі болып табылады.
Неліктен 180 млрд параметр әдетте әлдеқайда көп жадыны талап етеді
Тығыз (dense) нейрожелілерде әр токенді өңдеу кезінде іс жүзінде барлық параметрлер қатысады. 180 млрд параметрлі модель үшін тіпті салмақтардың 8-биттік квантталған нұсқасы қызметтік құрылымдар мен контекстті есептемегенде шамамен 180 ГБ жадыны қажет етеді. 4-биттік форматта бұл шамамен 90 ГБ, ал метадеректер мен аралас деректер түрлері бар нақты файлдар одан да көп орын алады.
MoE жағдайында жағдай өзгеше. Модель көптеген мамандандырылған есептеу блоктарын — сарапшыларды қамтиды, бірақ әр токен үшін маршрутизатор олардың тек шағын бөлігін ғана белсендіреді. Qwen3.8-Flash-Next үшін автор әрқайсысында 512 сарапшыдан тұратын 48 қабатты көрсетеді, олардың ішінде әр қабатта тек 10 сарапшы белсендіріледі. Сонымен қатар модельдің ортақ компоненттері мен маршрутизатор үнемі орындалуы керек, ал таңдалған сарапшылар сенімді сақталып, есептеуішке уақытылы жеткізілуі тиіс.
Сарапшылар — бұл желінің математикалық блоктары, олар міндетті түрде адам ұғымындағы «бағдарламалау сарапшысы» немесе «биология сарапшысы» болып бөлінбейді. Олардың мамандануы оқыту барысында қалыптасады.
Эксперимент қалай құрылған
Автор сарапшыларды ағындық жүктеу (expert streaming) әдісін пайдаланды. Негізгі идея: жылдам құрылғыда шектеулі кэшті сақтау, ал қалған сарапшы салмақтарын SSD-де ұстау. Маршрутизатор қажетті сарапшыларды таңдаған кезде жүйе олардың кэште бар-жоғын тексереді, жоқ салмақтарды жүктеп, есептеулерге қосады. Кэшке дөп түсу үлесі неғұрлым жоғары болса, процессор немесе GPU дискілік операцияларды күтуге соғұрлым аз уақыт жұмсайды.
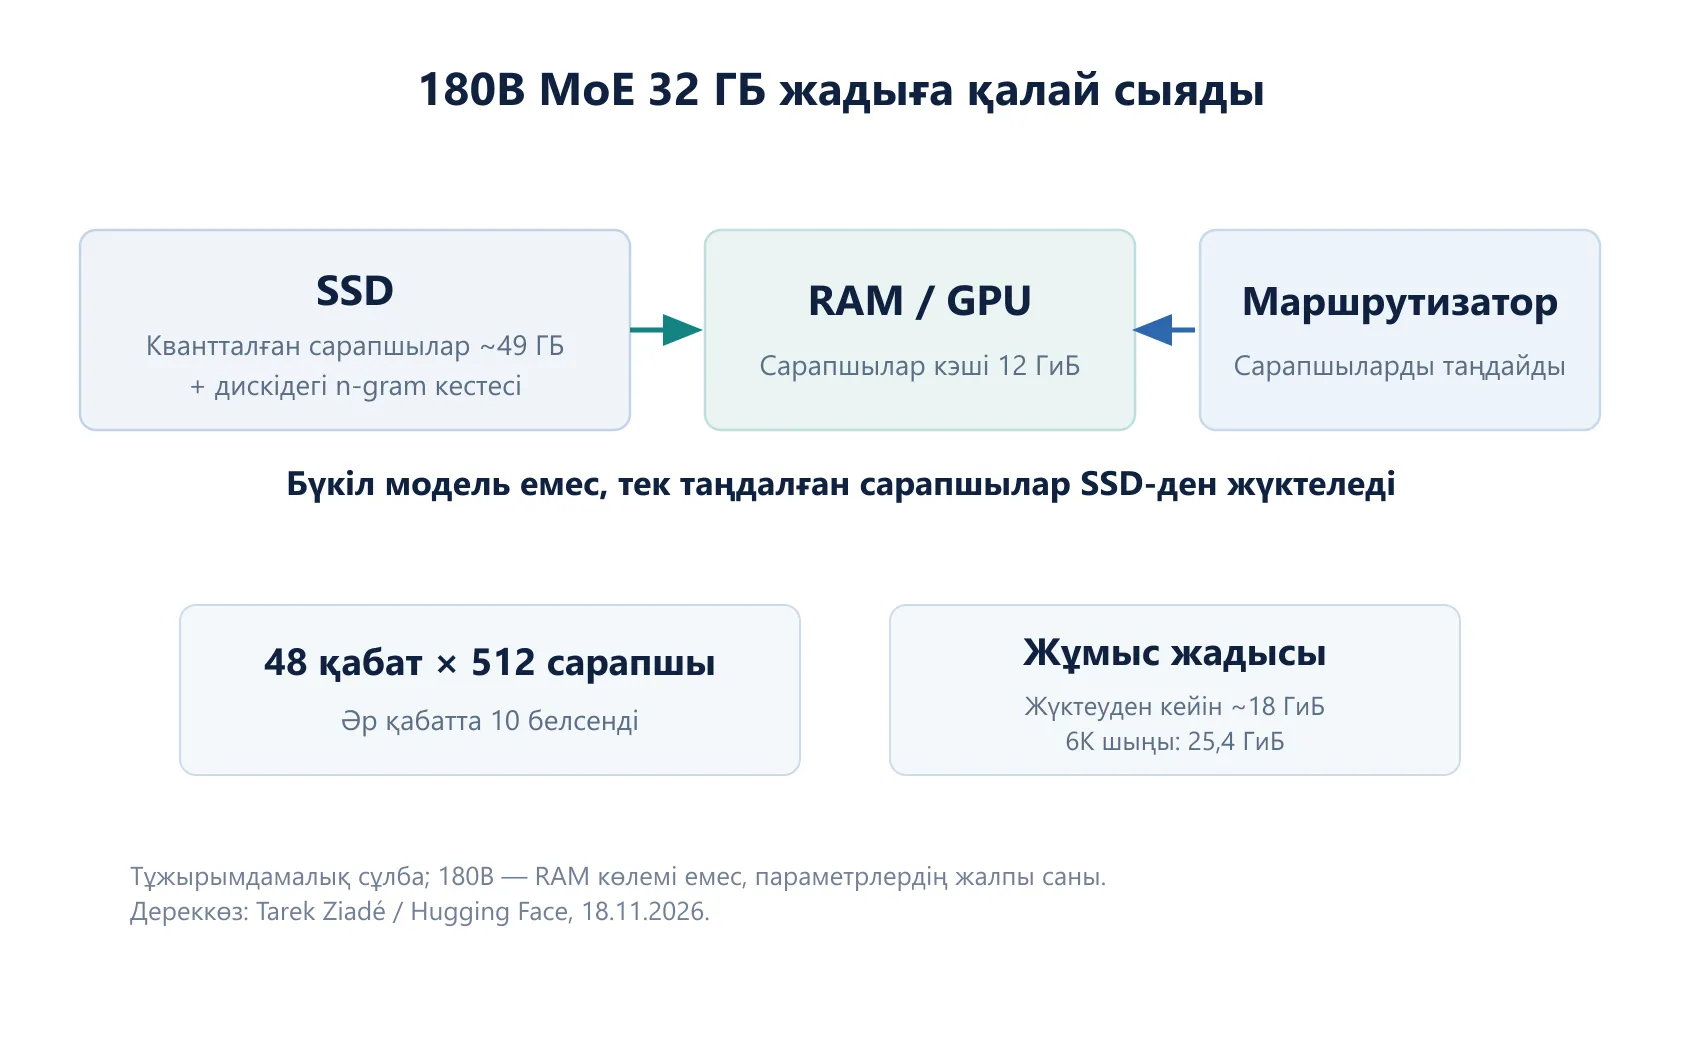
1-сурет. SSD және шектеулі кэшпен жұмыс істеу сұлбасы. Мәндер Tarek Ziadé техникалық есебінен алынған.
Бастапқы конфигурацияда Qwen3.8-Flash-Next сарапшылары FP8 форматында 121 ГБ орын алған. Ноутбукте іске қосу үшін автор оларды 3-биттік форматқа ауыстырып, дискіде шамамен 49 ГБ көлемін алды және кэш үшін 12 ГиБ бөлді. Тығыз қабаттар 8 битке дейін квантталып, шамамен 5,4 ГБ алды. Тағы бір мәселе көлемі 51 ГБ болатын n-gram кестесі болды, ол үшін дискілік жолдарды бөлек жүктеуді енгізуге тура келді.
Жүктеуден кейін бағдарлама шамамен 18 ГиБ пайдаланды, ал 6000 токендік промптті өңдеу кезінде ең жоғары тұтыну 25,4 ГиБ-ке жетті. 32 ГБ жедел жадысы бар машинада macOS свопты белсенді пайдаланбауы үшін авторға браузерді және басқа қолданбаларды жабуға тура келді. Файлдарды дайындау шамамен бес сағатты алды.
Transformers кітапханасында не өзгертілді
Transformers пен Accelerate ішіндегі стандартты разгрузка әдістері мұндай схемаға бейімделмеген еді. Қабатты толық шығарып тастаған кезде олар ағымдағы токенге қажет емес ондаған сарапшыны қоса тасымалдайды. Егер модель RAM-ға сыймаса, дискіге тұрақты сұраулар басталып, өнімділік күрт төмендейді.
Автор Transformers үшін pull request #50717 арқылы experts_offload тәжірибелік қолдауын жүзеге асырды. Барлық сарапшылар тобын шығарудың орнына қозғалтқыш жадыда алдын ала бөлінген слоттар пулын сақтайды. Сәйкестік кестесі сарапшы идентификаторларын бос емес слоттармен байланыстырады, бұл есептеулерді grouped_mm оңтайландырылған операцияларымен орындауға мүмкіндік береді.
Дискімен жұмыс үшін параллельді оқу қолданылады, ал келесі қабаттар қандай салмақтар қажет болатынын алдын ала болжауға тырысады. Автор macOS-та тиімді жүзеге асыруы жетіспейтін сәулет бөліктері үшін арнайы Metal ядроларын қосты.
Ашық эксперимент, түрлендіру скрипттері мен толық өлшемдер moe-expert-streaming Hugging Face Space алаңында және GitHub-та орналастырылған.
Нәтижелер: секундына қанша токен
Бірдей 32 ГБ бірыңғай жадысы бар Mac M5 құрылғысында автор Transformers пен Strata 0.1.60 нұсқасын бірдей промпттарда салыстырды. Қорытынды өлшеулерде Transformers 200 токен генерациялау кезінде 13,9 токен/с көрсетті (Strata — 14,8 токен/с). 4000 токендік кіріс промптін өңдеу кезінде Transformers 228 токен/с көрсетті (Strata — 220). 6000 токендік құжатты оқығаннан кейінгі генерация сәйкесінше 12,4 және 13,7 токен/с құрады.
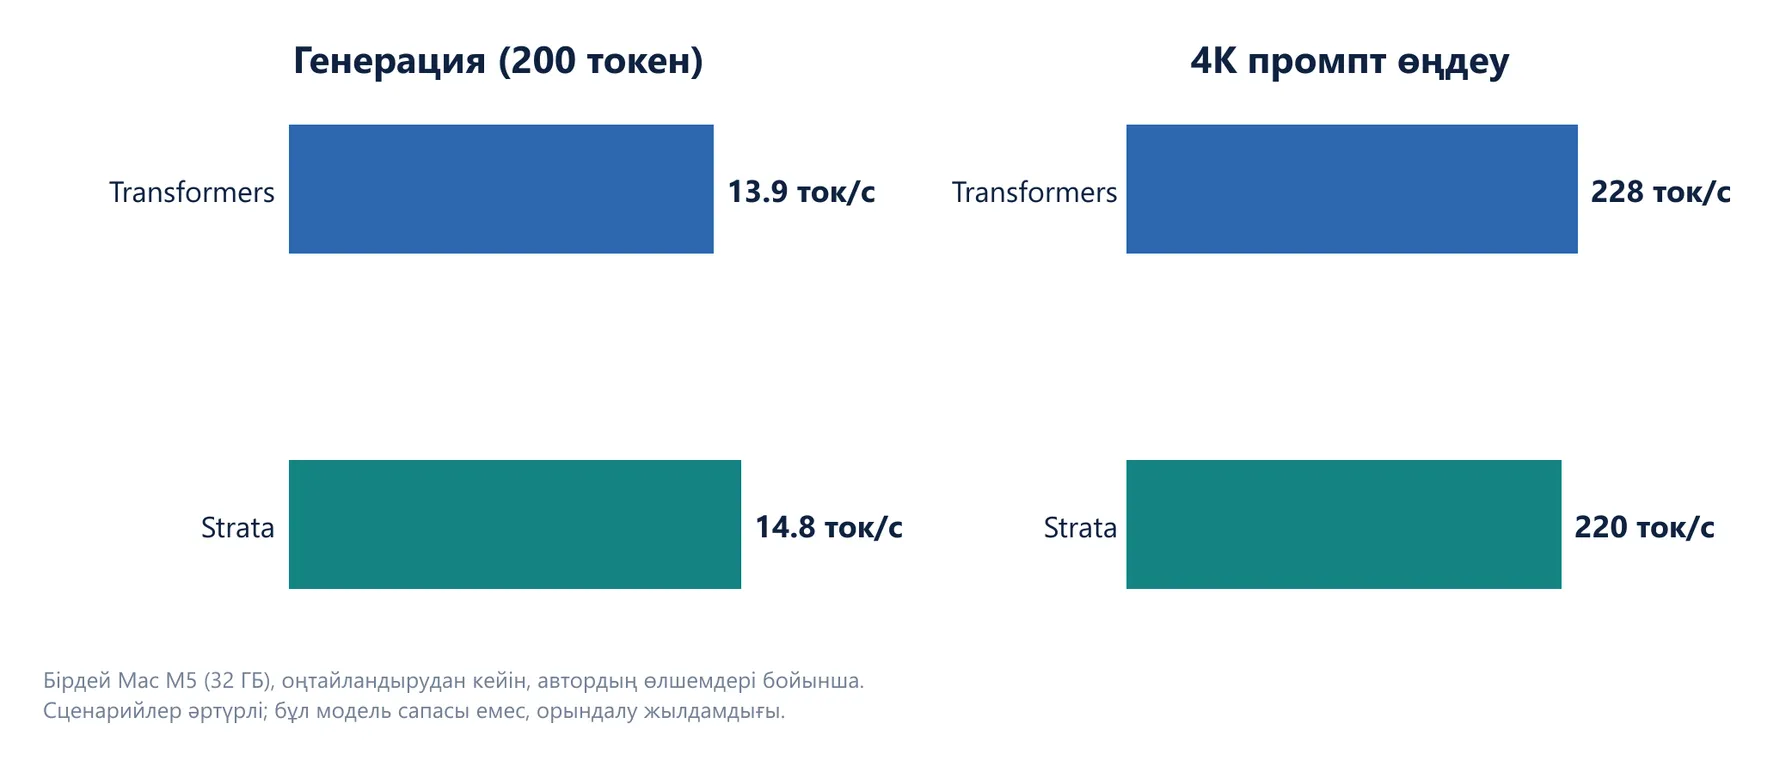
2-сурет. Бір Mac M5 құрылғысындағы қорытынды өлшемдер. Кіріс промптті өңдеу және генерация жылдамдығы бөлек көрсетілген.
Прототиптің алғашқы нұсқалары әлдеқайда баяу болды (шамамен 10 токен/с). Кэш, кванттау, алдын ала жүктеу және GPU есептеулері оңтайландырылғаннан кейін Strata-мен айырмашылық қысқа жауап генерациясында шамамен 6%-ға дейін қысқарды.
Сонымен бірге 14 токен/с нәтижесі код жазатын бағдарламалық агенттерді қарқынды пайдалану үшін әлі де шектеулі. Автор күнделікті жұмыс процесі үшін мұның жеткіліксіз екенін және қуатты қашықтағы серверлерді пайдалануды жалғастыратынын ашық айтады.
llama.cpp және vLLM-мен айырмашылығы
Сол есепте 24 ГБ жадысы бар A10G GPU-да басқа Qwen3.6-35B-A3B MoE моделінің бөлек сынағы келтірілген. Онда Strata Q8_0 форматында 82–88 токен/с, ал llama.cpp жүйесі --fit on режимінде 63–64 токен/с алды.
Бұл цифрларды 180B моделінің диаграммасына қосуға болмайды: оларда модель өлшемі, жабдық және орындалу режимдері мүлдем бөлек. Салыстыру мәні басқада: llama.cpp сарапшылар жедел жадыға еркін сыйған кезде тамаша жұмыс істейді, ал vLLM серверлік жүктемелерге бейімделген. Егер тіпті жедел жады жетіспесе, жалғыз жұмыс істейтін механизм — таңдалған сарапшыларды SSD-ден ағындық оқу.
Экспериментті үйде қайталауға бола ма
Бұл конфигурация Apple Silicon / MPS платформасына, Qwen моделіне және дайындалған салмақтарға байланған. 32 ГБ бірыңғай жадыдан бөлек, үлкен файлдар үшін бос орны бар жылдам SSD қажет. Қарапайым pip install transformers бұл тармақты қамтымайды: арнайы PR және Metal ядролары талап етіледі.
Қайталау үшін Hugging Face шолуынан және модельдер репозиторийінен бастаған жөн. 14 токен/с қарапайым сұрақ-жауап үшін жарамды болғанымен, бағдарламалық агенттердің күрделі циклдері үшін ыңғайсыз болуы мүмкін.
Бұл нәтиже неліктен маңызды
Жергілікті модельдер нарығы бұрыннан кванттау мен салмақтарды CPU/RAM-ға шығаруды дамытып келеді. Мұнда келесі қадам жасалды: SSD үлкен MoE-нің жекелеген бөліктері үшін қосымша жады деңгейіне айналады, ал есептеу жүйесі олардың қайсысы қажет болатынын алдын ала болжауға тырысады.
Дегенмен модель параметрлерінің саны оның интеллектуалдық сапасына кепілдік бермейді, ал оны іске қосу мүмкіндігі жоғары жылдамдықты білдірмейді. Жобаның басты жетістігі — эксперименттік Transformers нұсқасын арнайы Strata қозғалтқышының жылдамдығына жақындату және сарапшыларды икемді жүктеу сәулетін көрсету.