
Зерттеу деректері 2026 жылғы 9 қарашадағы жағдай бойынша берілген.
4 қарашада Tencent Hunyuan тобының жаңа флагмандық моделі HY4-ті таныстырды. Әзірлеушілер бағдарламалау, мультимодальды талдау, компьютерді басқару және күрделі тапсырмаларды автономды орындауда айтарлықтай ілгерілеу болғанын мәлімдеді.
Алғашқы тәуелсіз тесттерде HY4 бірнеше рейтингте DeepSeek V4.1-ден озып, Mercor APEX-Agents рейтингінде үшінші орын алды және кейбір кәсіби сценарийлерде Claude Opus 5.5-тен де жоғары нәтиже көрсетті.
Басқа зерттеулерде жағдай өзгеше: Vals AI DeepSeek-ті Tencent моделінен жоғары қояды, ал HY4 тапсырмасының құны кейде бәсекелестерінен бірнеше есе қымбат.
Біз 11 модельді бес тәуелсіз рейтинг бойынша салыстырдық: Vals AI, Artificial Analysis, Mercor APEX-Agents, Agent Arena және WebDev Arena. Сонымен қатар LiveBench нәтижелерін, Plotly зерттеуін және әзірлеушілер пікірлерін қарастырдық. Сапа мен экономикалық тиімділікті бірге бағалау үшін интеллект көрсеткіштері мен тапсырма құнын нормалап, Парето шекарасын құрдық.
Негізгі сұрақ: Tencent HY4-ке көшу керек пе, әлде басқа модельдер ұқсас интеллектіні арзанырақ ұсына ма?
Қысқаша: HY4 күрделі агенттік тапсырмаларда ең мықты модельдердің бірі, бірақ интеллект пен құн бойынша әмбебап көшбасшы емес. Төрт бенчмарктің жиынтық индексінде ол DeepSeek V4.1-ден шамамен 8% жоғары, ал салыстырмалы құны 2,6 есе қымбат. HY4-тің артықшылығы - құралдарды автономды пайдалану және көп қадамды кәсіби жұмыс: APEX-Agents тестінде ол 77,6%, DeepSeek 69,8% жинады; Agent Arena рейтингінде тиісінше 14 және 20-орын алды. HY4 терминалда да күштірек және Plotly талдауында 43 тапсырманың 42-сін $2,11-ға орындап, ұқсас нәтиже көрсеткен басқа қатысушылардан арзанырақ болды. Сондықтан ол жылдамдықтан сапа маңызды агенттер, кәсіби автоматтандыру және аналитика үшін қызықты. Жалпы индексте Kimi K3.1 Pro, GPT-6.1 Terra және жетекші Claude мен Gemini модельдерінен төмен; жоғары құны мен ұзақ ойлануы жаппай сұраныстар, қарапайым чат және арзан әзірлеу үшін тартымдылығын азайтады. DeepSeek үнемдірек әмбебап таңдау болып қалады, ал HY4 қосымша мүмкіндіктері шығынды ақтайтын күрделі тапсырмаларға балама бола алады.
Tencent HY4 деген не?
HY4 - Tencent Hunyuan агенттер, бағдарламалау және кәсіби жұмыс процестері үшін әзірлеген мультимодальды модель. 2026 жылғы тамызда шыққан HY4 Preview нұсқасымен салыстырғанда жаңа нұсқа айтарлықтай жақсарған.
Tencent модельдің ақпаратты зерттеу, құралдарды қолдану, код жазу және іске қосу, қателерді табу және нәтижені тексеру сияқты ұзақ әрекеттер тізбегін өздігінен орындау қабілетін дамытты. Сондай-ақ суреттермен және графикалық интерфейстермен жұмысын, оның ішінде Blender, CAD жүйелері және ойын қозғалтқыштарымен әрекеттесуін жетілдірді. Контекст терезесі шамамен бір миллион токенге жетеді: бұл үлкен құжаттарды, код базаларын және ұзақ диалогтарды өңдеуге мүмкіндік береді.
HY4 Preview 770 миллиард параметрі бар Mixture-of-Experts архитектурасын қолданды, оның шамамен 49 миллиарды әр токенде белсенді болды. Бұл сипаттамалар Preview нұсқасына қатысты, соңғы модель үшін расталмаған. Preview салмақтары жарияланған; хабарландыру кезінде Tencent толық HY4 салмақтарын жариялауға тек уәде берген еді.
Tencent HY4-ті қай салаларда ерекше күшті деп санайды?
Tencent HY4-ті жай әмбебап чат-бот ретінде емес, ең алдымен күрделі кәсіби тапсырмаларды орындауға арналған модель ретінде (real-world productivity) таныстырады. Әзірлеуші құралдарды пайдаланып, бағдарламалармен әрекеттесетін және адамның аз қатысуымен ұзақ процестерді орындайтын автономды ЖИ агенттеріне баса назар аударады.
Компания HY4 туралы ресми шолуда мына бағыттарды атап өтеді:
| Бағыт | HY4-тің мәлімделген мүмкіндіктері |
|---|---|
| Автономды ЖИ агенттері | Көп қадамды әрекеттерді жоспарлау, құралдарды шақыру, нәтижелерді тексеру және қателерді түзету |
| Компьютерді басқару (Computer Use) | Командалық жолмен және графикалық интерфейстермен, соның ішінде Blender және CAD жүйелерімен жұмыс |
| Кеңсе жұмысы | Құжаттарды, кестелерді, поштаны және күнтізбелерді талдау, жобаларды үйлестіру және бірлесіп өңдеу |
| Қаржылық аналитика | Инвестициялық қорларды зерттеу, бағалы қағаздарды талдау, сандық стратегиялар және қаржылық зерттеулер |
| Бағдарламалау және ойын әзірлеу | Интерфейстер жасау, күрделі бизнес-логиканы іске асыру, Unity, Unreal Engine және Godot-пен жұмыс |
| Ғылыми зерттеулер | Математикалық және физикалық модельдеу, ғылыми бағдарламалау және зерттеу процестерін автоматтандыру |
Бұл мәлімдемелер тәуелсіз зерттеулерде ішінара расталады: HY4 APEX-Agents және Terminal-Bench тесттерінде жоғары нәтиже көрсетеді, ал Plotly тестінде деректерді жоғары дәлдікпен талдайды. Алайда қарапайым бағдарламалауда, құқықтық және салықтық тапсырмаларда оның бәсекелестерден артықшылығы соншалықты айқын емес.
Дереккөз: Tencent-тің ресми HY4 релизі.
Жалпы интеллект салыстыруы: HY4 және 10 бәсекелес
Бір рейтинг модель сапасын толық сипаттай алмайды. Тесттер ой қорыту мен бағдарламалаудан қаржылық талдау және құралдармен өздігінен жұмыс істеуге дейін әртүрлі қабілеттерді бағалайды. Сондықтан бес тәуелсіз дереккөз нәтижесін біріктірдік.
Модель сапасының жиынтық кестесі
| Модель | Vals Index | Artificial Analysis | APEX-Agents | Agent Arena | WebDev Arena |
|---|---|---|---|---|---|
| Gemini 4 Carbon | 70,45% | 60 | 84,2% | +16,63% | 1768 |
| Claude Opus 5.5 | 70,18% | 59 | 73,5% | +19,96% | 1818 |
| Claude Sonnet 5.5 | 70,85% | 55 | 75,5% | +15,99% | 1773 |
| GPT-6.1 Sol | 63,94% | 55 | 60,0% | +12,53% | 1743 |
| Kimi K3.1 Pro | 62,52% | 46 | 65,5% | +5,24% | 1687 |
| DeepSeek V4.1 Flash | 61,26% | 33 | 69,8% | +2,07% | 1664 |
| GPT-6.1 Terra | 60,54% | 51 | 68,3% | +12,10% | 1678 |
| GLM 5.3 | 59,73% | 32 | 56,6% | +0,99% | 1622 |
| Tencent HY4 | 59,35% | 35 | 77,6% | +4,66% | Дерек жоқ |
| Qwen 3.8 Max | 59,05% | 34 | 63,3% | +0,33% | 1677 |
| Xiaomi MiMo V2.6 Pro | 57,81% | 30 | 54,4% | +2,33% | 1624 |
Дереккөздер: Vals AI, Artificial Analysis, Mercor, Agent Arena, WebDev Arena.
Көрсеткіштер нені өлшейді: Vals Index кәсіби тапсырмалардың сәтті орындалуын; Artificial Analysis интеллектінің жиынтық индексін; APEX-Agents ұзақ кәсіби процестер нәтижелілігін; Agent Arena пайдаланушы сессияларындағы агенттердің салыстырмалы пайдалылығын; WebDev Arena веб-әзірлеу нәтижелерін пайдаланушылар таңдауы бойынша бағалайды.
Соңғы HY4 үшін WebDev Arena бағасы әзірге жоқ. HY4 Preview 1632 балл жинап, 24-орын алған, бірақ оны жаңа нұсқаның нәтижесі ретінде қолдануға болмайды.
Бес рейтинг нені көрсетеді?
HY4 кейбір көрсеткіштерде DeepSeek-тен жоғары: Artificial Analysis, APEX-Agents және Agent Arena. Ең үлкен айырма APEX-те - 77,6% және 69,8%. Ал Vals Index бойынша DeepSeek алда, соңғы нұсқаларды WebDev бойынша әзірге салыстыру мүмкін емес.
Kimi K3.1 Pro әмбебап модель ретінде күштірек көрінеді: ол Vals, Artificial Analysis және Agent Arena-да HY4-тен озады, алайда APEX-Agents-та Tencent нәтижесі әлдеқайда жоғары. Claude пен Gemini кең интеллект бағаларында жетекші, әсіресе Artificial Analysis және WebDev бойынша; дегенмен HY4 кейбір күрделі кәсіби тапсырмаларда Claude-пен бәсекелесе алады.
Бірыңғай объективті интеллект рейтингі жоқ: сапа тапсырма түріне және тест жағдайларына байланысты.
Тапсырма құны: төрт дереккөзді салыстыру
Миллион токеннің бағасы нақты шығынды әрдайым көрсете бермейді. Модель құралдарды бірнеше рет шақырып, мыңдаған ой қорыту токенін шығара алады немесе қатеден кейін қайта іске қосуды қажет етеді. Сондықтан тек API тарифін емес, тапсырманы толық орындау құнын салыстырған пайдалы.
Тапсырмалар құнының жиынтық кестесі
Құн АҚШ долларымен берілген.
| Модель | Vals $/тест | AA $/тапсырма | Agent Arena $/тапсырма | WebDev $/тапсырма |
|---|---|---|---|---|
| Gemini 4 Carbon | $10,51 | $7,76 | $1,53 | $1,62 |
| Claude Opus 5.5 | $24,77 | $10,04 | $6,51 | $9,09 |
| Claude Sonnet 5.5 | $16,18 | $10,02 | $3,39 | $3,00 |
| GPT-6.1 Sol | $3,61 | $1,27 | $0,98 | $1,61 |
| Kimi K3.1 Pro | $6,44 | $3,68 | $1,29 | $1,27 |
| DeepSeek V4.1 | $0,66 | $0,60 | $0,15 | $0,12 |
| GPT-6.1 Terra | $2,94 | $0,96 | $0,80 | $0,63 |
| GLM 5.3 | $8,52 | $5,01 | $1,08 | - |
| Tencent HY4 | $1,72 | $1,03 | $0,60 | Дерек жоқ |
| Qwen 3.8 Max | $8,73 | $10,02 | $1,22 | - |
| MiMo V2.6 Pro | $0,43 | $0,26 | $0,17 | - |
Дереккөздер: Vals, Artificial Analysis, Agent Arena Pareto, WebDev Arena Pareto. Vals пен AA тесттің орташа құнын, Arena пайдаланушы тапсырмасының медианалық құнын жариялайды. Бағандарды тікелей салыстыруға болмайды.
DeepSeek бірнеше зерттеуде ең үнемді модельдердің бірі. Vals-та оның тапсырмасы $0,66, HY4-те $1,72; Artificial Analysis-та $0,60 және $1,03; Agent Arena-да $0,15 және $0,60. Интеллект нәтижелері салыстырмалы түрде жақын. Бірақ DeepSeek барлық бәсекелестен тиімді ме деген сұраққа жауап беру үшін сапа мен құнды бірге қарау қажет.
Нормаланған интеллект пен құн: қай модель тиімді?
Біз нәтижелерді ең ақылды нейрожелілер зерттеуіндегі тәсіл бойынша салыстырмалы шкалаға келтірдік.
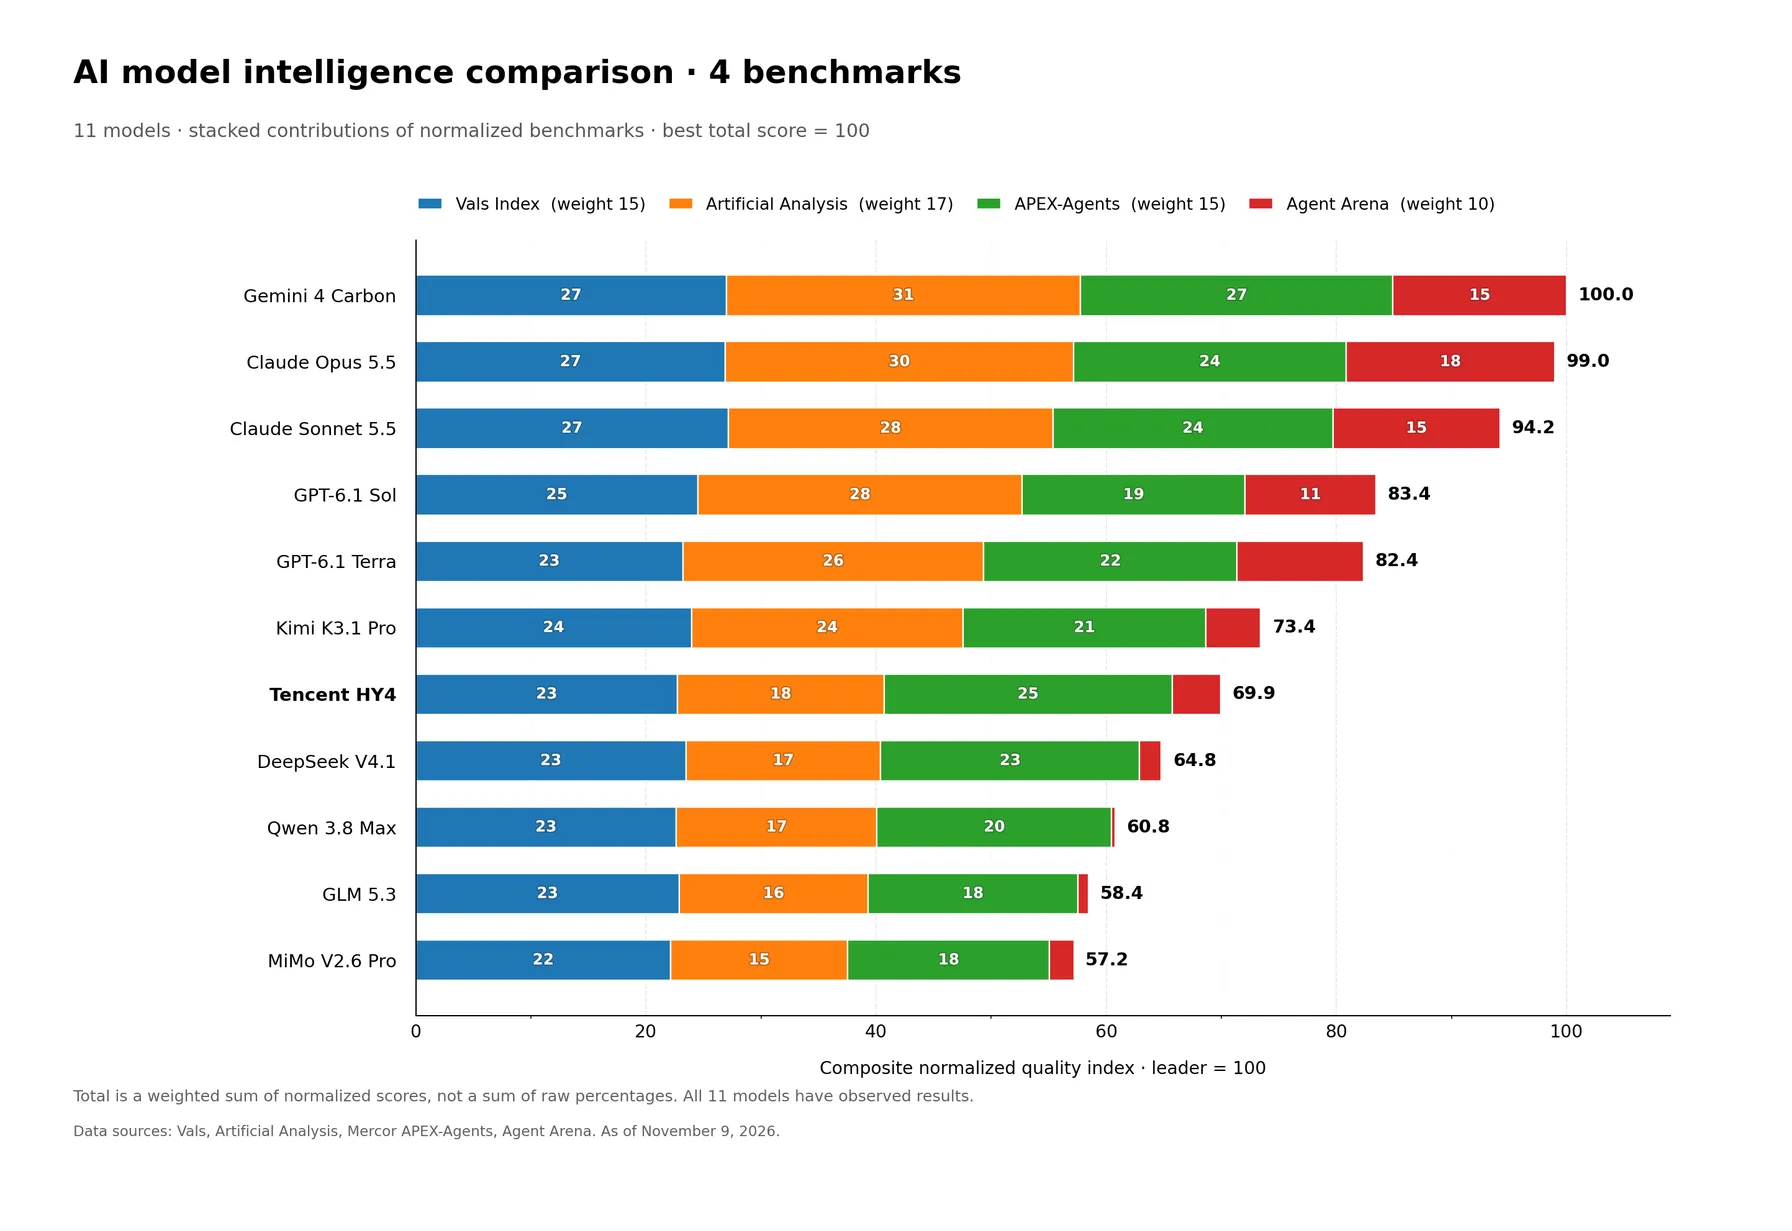
Әдістеме: әр интеллект тестінің нәтижесі көшбасшыға қатысты нормаланып, салмақталған орташа көрсеткішке біріктірілді. Әр дереккөздегі құн Claude Opus 5.5-ке қатысты нормаланып, геометриялық орташа арқылы біріктірілді. Негізгі индекс төрт интеллект тестін - Artificial Analysis (салмағы 17), Vals (15), APEX (15), Agent Arena (10) - және үш құн дереккөзін қолданады. Ең жоғары жиынтық интеллект 100-ге, Claude Opus салыстырмалы құны 1,00-ге тең. Бұл таңдалған тесттердің салыстырмалы индексі, абсолютті IQ өлшемі емес.
Жалпы рейтинг: интеллект және салыстырмалы құн
| Модель | Интеллект индексі | Салыстырмалы құн | Парето |
|---|---|---|---|
| Gemini 4 Carbon | 100,0 | 0,426 | ✓ |
| Claude Opus 5.5 | 99,0 | 1,000 | - |
| Claude Sonnet 5.5 | 94,2 | 0,698 | - |
| GPT-6.1 Sol | 83,4 | 0,141 | ✓ |
| GPT-6.1 Terra | 82,4 | 0,112 | ✓ |
| Kimi K3.1 Pro | 73,4 | 0,266 | - |
| Tencent HY4 | 69,9 | 0,087 | ✓ |
| DeepSeek V4.1 | 64,8 | 0,033 | ✓ |
| Qwen 3.8 Max | 60,8 | 0,404 | - |
| GLM 5.3 | 58,4 | 0,305 | - |
| MiMo V2.6 Pro | 57,2 | 0,023 | ✓ |
Интеллект индексі жоғары болғаны жақсы, салыстырмалы құн төмен болғаны арзан. Көрсеткіштер 2026 жылғы 9 қарашадағы жария тесттерден есептелді. Салыстырмалы құн бірліктері доллар емес.
Парето диаграммасы: интеллект және құн
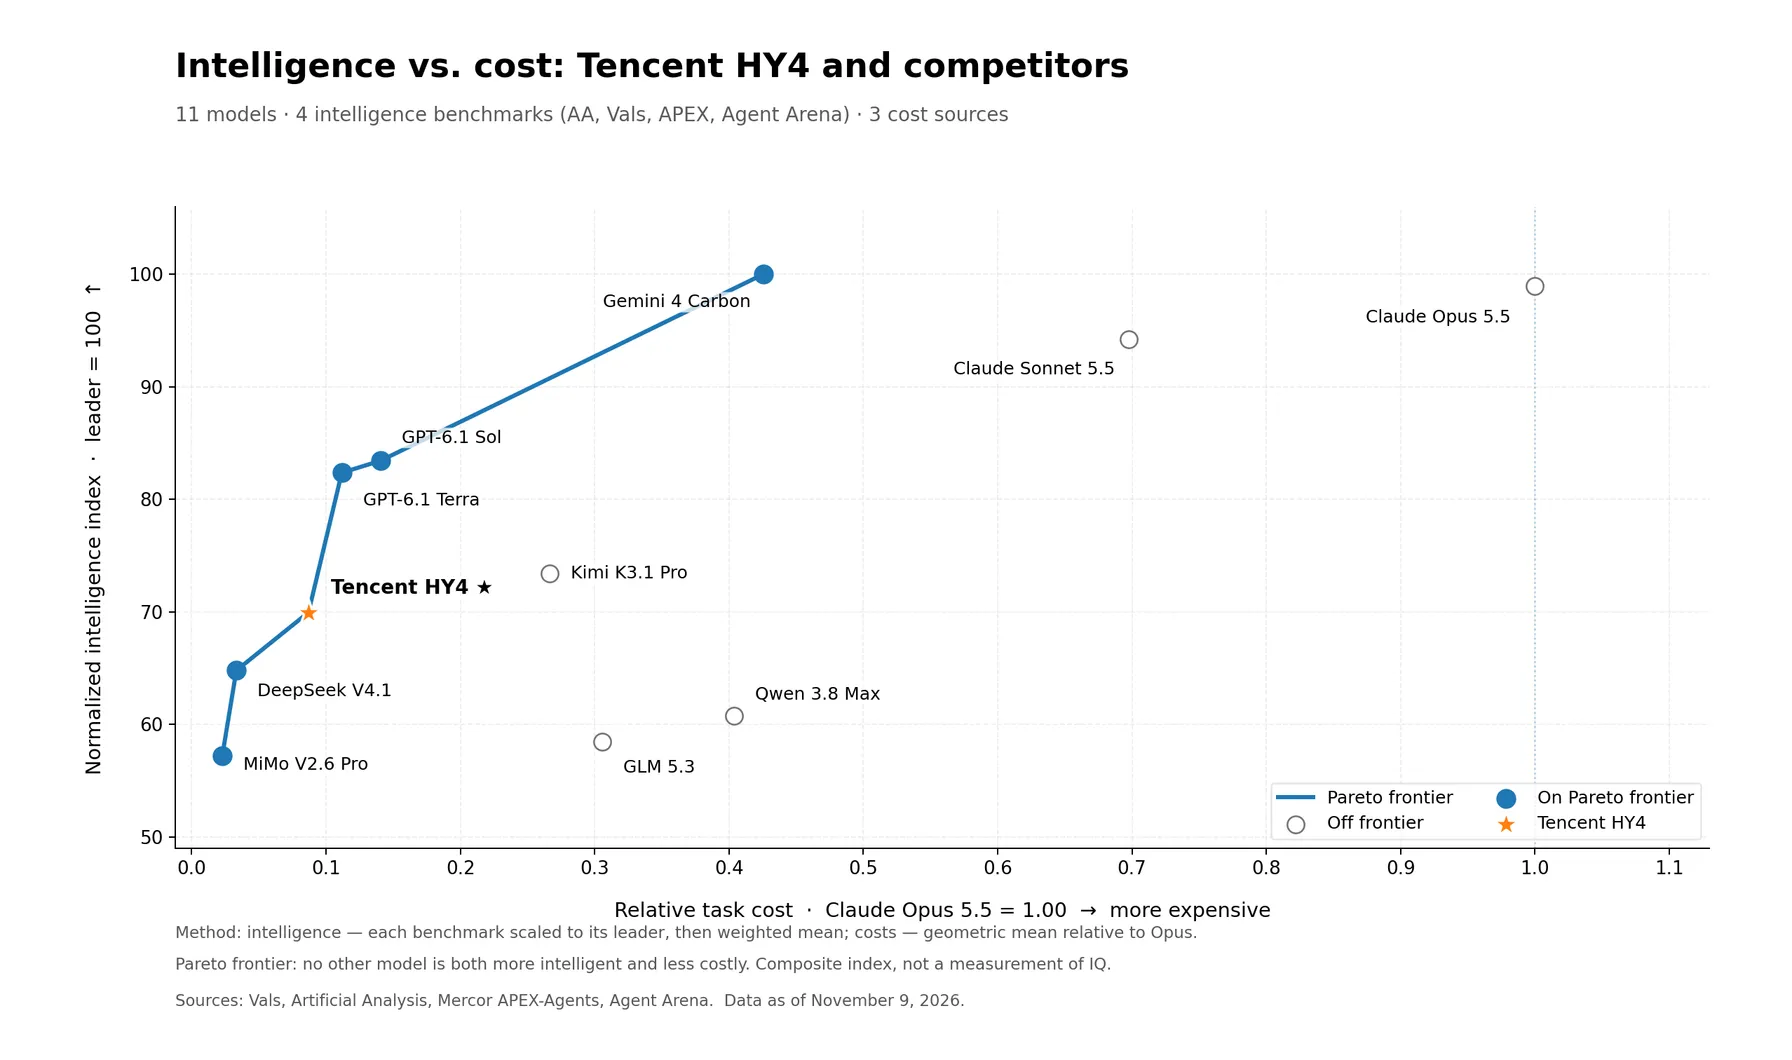
Төрт интеллект тесті және үш құн дереккөзі бойынша 11 модельдің Парето шекарасы. Көк сызық таңдамада бір мезгілде ақылдырақ әрі арзанырақ баламасы жоқ модельдерді біріктіреді.
Tencent HY4 Парето шекарасында: салыстырылған модельдердің ішінде есептелген интеллект индексі жоғары әрі құны төмен басқа модель жоқ. Дегенмен бұл оның барлық тапсырмаға оңтайлы екенін білдірмейді.
HY4 және DeepSeek: жиынтық индексі 69,9 және 64,8 - шамамен 8% артықшылық, бірақ HY4-тің салыстырмалы құны 2,6 есе жоғары. HY4 және GPT-6.1 Terra: Terra 82,4 балл жинайды, HY4 - 69,9; құн 0,087-ден 0,112-ге, шамамен 29%-ға өседі. Бұл сапа мен шығын арасындағы қызықты ымыра.
Kimi K3.1 Pro Парето шекарасында емес: таңдалған әдіс бойынша GPT-6.1 Terra мен Sol әрі ақылдырақ, әрі арзанырақ, бірақ жекелеген кәсіби тесттерде Kimi өзгеше нәтиже көрсетуі мүмкін. Негізгі индексте Gemini 4 Carbon Claude Opus 5.5-тен басым: бағасы сәл жоғары, салыстырмалы құны едәуір төмен. WebDev қосылғанда бұл қорытынды өзгереді.
Arena WebDev қосылғанда рейтинг қалай өзгереді?
Нәтижелердің тұрақтылығын тексеру үшін WebDev Arena-ны бесінші интеллект тесті және төртінші құн дереккөзі ретінде қостық.
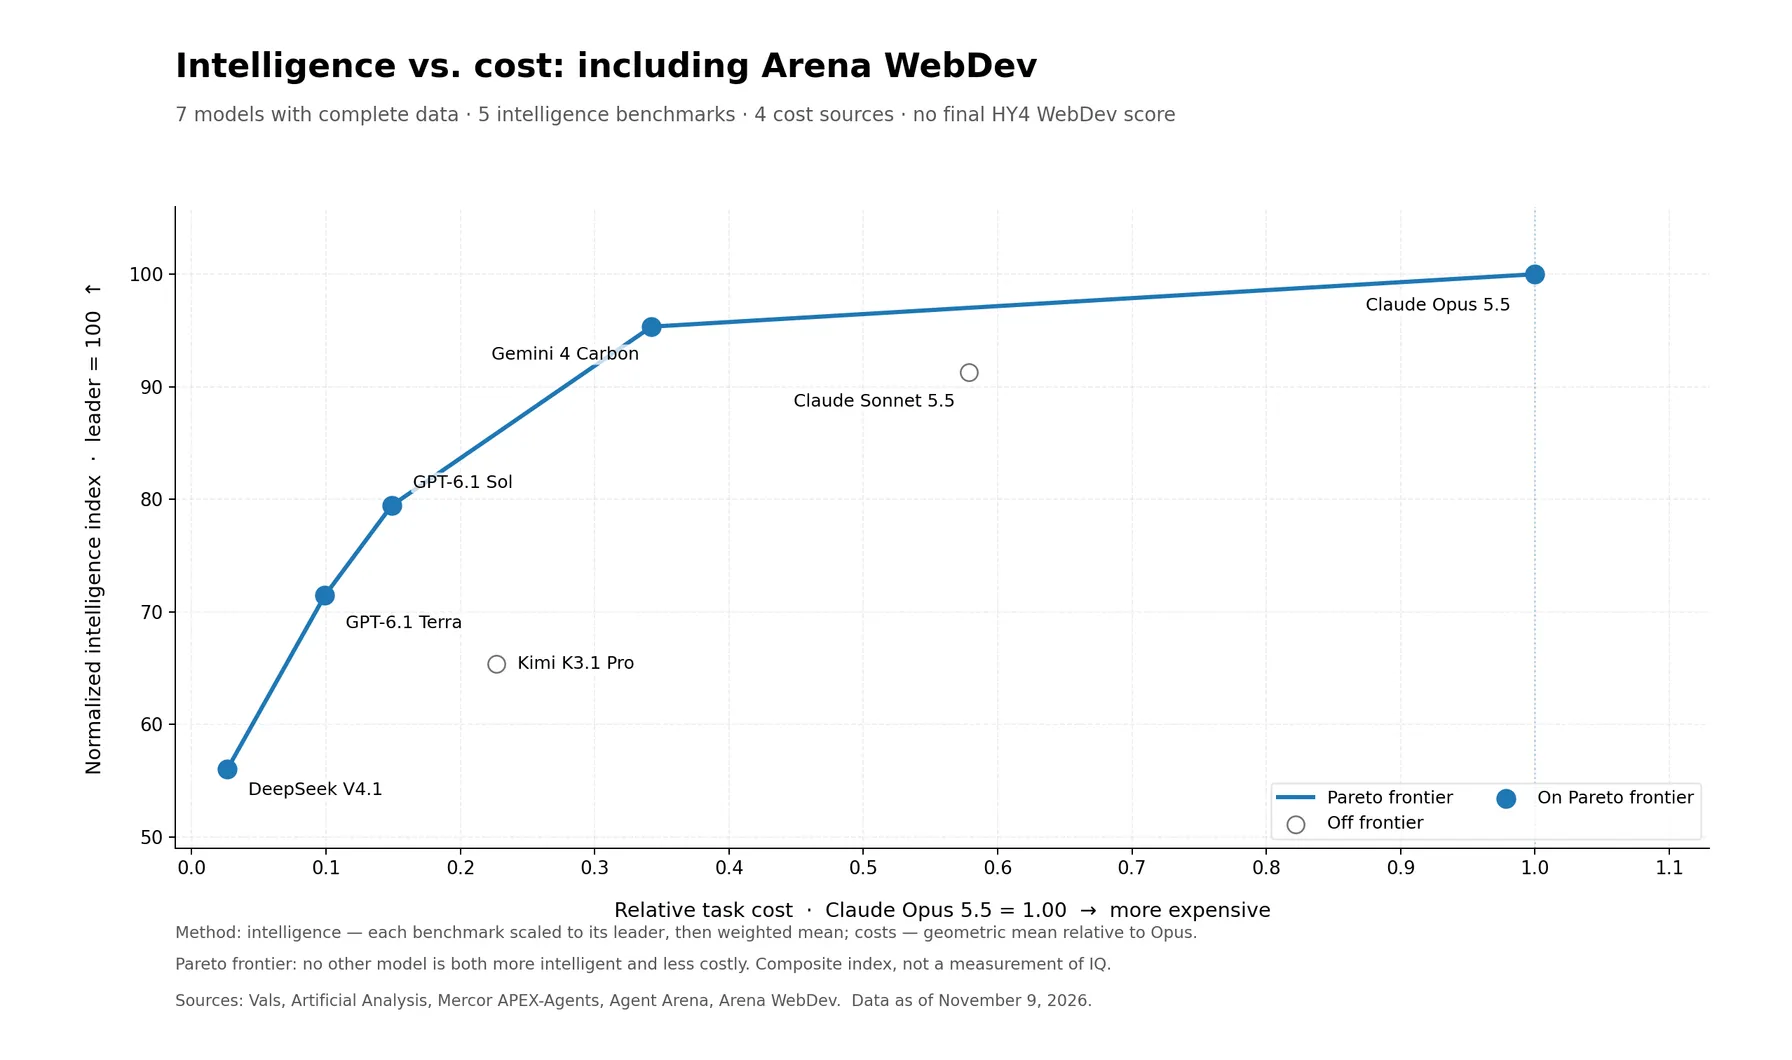
Таңдамада жария деректері толық жеті модель ғана бар. Соңғы HY4 WebDev деректері болмағандықтан кірмеген. WebDev рейтингі үшін min-max нормалауы қолданылды.
WebDev қосылғанда Claude Opus 5.5 Парето шекарасына қайта оралады: веб-әзірлеудегі артықшылығы жалпы индексті 100-ге көтереді, бірақ Gemini 4 Carbon едәуір арзан. GPT-6.1 Sol мен Terra сапа мен құн бойынша күшті орнын сақтайды; толық дерегі бар жеті модель ішінде DeepSeek ең арзан.
Тест құрамының рейтингке әсері үлкен. HY4 бар негізгі график пен WebDev қосылған графикті бірге қарастырған дұрыс, бірақ индекстерін тікелей салыстырмаңыз: модельдер мен тесттер жиынтығы әртүрлі.
HY4 қай жерде DeepSeek-тен күшті: бағдарламалау және кәсіби жұмыс
Жалпы индекстер жеке салалардағы айырманы жасырады. HY4 пен DeepSeek V4.1 Flash 1017-нің Vals арнайы тесттеріндегі нәтижелері:
| Тест | HY4 | DeepSeek |
|---|---|---|
| Terminal-Bench 4.0 | 39,39% | 31,82% |
| Vibe Code Bench | 81,01% | 87,73% |
| Finance Agent v2.1 | 64,70% | 62,93% |
| Tax Agent Bench | 34,40% | 44,35% |
| Legal Research Bench | 41,35% | 45,19% |
| Excel Modeling Bench | 66,18% | 69,17% |
| Harvey Legal Agent Bench | 12,50% | 14,17% |
Terminal-Bench модельден терминалда файлдармен жұмыс істеуді, командаларды орындауды, тәуелділіктерді орнатуды және қателерді түзетуді талап етеді. HY4 мұнда 39,39% көрсетіп, DeepSeek-тің 31,82% нәтижесінен озады. Қосымша әзірлеуді бағалайтын Vibe Code Bench-та DeepSeek алда: 87,73% және 81,01%. Қаржылық агент тапсырмаларында HY4 сәл жоғары; салық, құқықтық іздеу және электрондық кестелерде DeepSeek алда.
Код жазу мен құралдарды автономды пайдалану - бөлек қабілеттер. HY4 көп қадамды техникалық процестер үшін қызықты, бірақ бағдарламалауда сөзсіз көшбасшы емес.
Blender және CAD: Tencent HY4-тің жеке мамандануы
HY4-тің ерекше қырларының бірі - 3D модельдеу және жобалауға арналған кәсіби бағдарламалармен жұмыс істеуге арнайы дайындалуы. Tencent модельді Computer Use мүмкіндіктері арқылы Blender және CAD жүйелерімен әрекеттесуге үйретті: нейрожелі графикалық интерфейсті талдап, қолданбаларды басқара алады, командаларды орындап, жұмысының нәтижесін тексере алады.
Мәтіндік сұрау бойынша 3D нысандарын жасайтын кәдімгі генераторлардан айырмашылығы, HY4 операциялар тізбегін кәсіби бағдарламаның өзінде орындауға бағытталған: нысандарды жасау және өзгертуден бастап сахнаны дайындауға және нәтижені тексеруге дейін.
Tencent 3DArena-Modeling арнайы бенчмаркінде мына нәтижелерді ұсынды:
| Модель | Нәтиже |
|---|---|
| Claude Opus 5.5 | 43,4 |
| GPT-6.1 Sol | 41,8 |
| Tencent HY4 | 37,1 |
| Kimi K3.1 Pro | 36,1 |
| DeepSeek V4.1 | 32,3 |
| HY4 Preview | 23,4 |
| GLM 5.3 | 23,0 |
Дереккөз: Tencent материалдарындағы 3DArena-Modeling нәтижелері. Бұл әзірлеушінің ішкі тесті және әзірге тәуелсіз расталмаған.
Жаңа HY4 Preview нәтижесін едәуір жақсартып, DeepSeek V4.1 мен Kimi K3.1 Pro-дан озды, бірақ GPT-6.1 Sol және Claude Opus 5.5-тен төмен нәтиже көрсетті.
Бұл модельді 3D сахналарын жасауды, визуализация дайындауды және кәсіби графикалық құралдармен жұмысты автоматтандыру үшін перспективалы етеді. Алайда 3D модельдеудегі сәттілік сенімді инженерлік CAD жобалауымен тең емес. Өлшемдердің дәлдігі, рұқсат етілген ауытқулардың сақталуы және күрделі инженерлік модельдердің дұрыстығы туралы тәуелсіз деректер әзірге жеткіліксіз. Сондықтан HY4-тің CAD мүмкіндіктерін мамандандырылған инженерлік құралдардың дәлелденген алмастырғышы ретінде емес, перспективалы бағыт ретінде қарастыру керек.
Mercor APEX-Agents: HY4 Claude-тен озады
Tencent нәтижелерінің бірі - Mercor тәуелсіз APEX-Agents тестіндегі үшінші орын. Онда 31 жұмыс сценарийіне біріктірілген 240 кәсіби тапсырма бар: инвестициялық талдаушылар, басқару кеңесшілері және корпоративтік заңгерлер жұмысы. Модельдер құжаттарды зерттеп, бірнеше қолданбамен жұмыс істеп, ақпарат тауып, нәтижеге дейін әрекеттер тізбегін орындауы керек.
APEX-Agents нәтижелері
| Модель | Pass@1 |
|---|---|
| Gemini 4 Carbon High | 84,2% |
| Gemini 4 Argon High | 82,4% |
| Tencent HY4 High | 77,6% |
| Claude Sonnet 5.5 Max | 75,5% |
| Claude Opus 5.5 Max | 73,5% |
| DeepSeek V4.1 Flash | 69,8% |
| Kimi K3.1 Pro | 65,5% |
| Qwen 3.8 Max | 63,3% |
Дереккөз: Mercor APEX-Agents.
HY4 DeepSeek-тен 7,8 пайыздық тармаққа жоғары және Claude Opus 5.5-тен де жоғары нәтиже көрсетті. Алайда бірнеше көрші модельдің белгісіздік аралықтары қиылысады, сондықтан Tencent-тің Claude-тен статистикалық тұрғыдан артық екенін сенімді айтуға болмайды. Соған қарамастан нәтиже HY4-тің құралдармен ұзақ кәсіби тапсырмалардағы күшін көрсетеді. Vals-пен айырма платформалардың әртүрлі тапсырмалар қолдануымен де түсіндіріледі.
WebDev Arena: сайт жасау бойынша салыстыру
WebDev Arena сайттар мен веб-қосымшаларды пайдаланушылардың салыстырмалы таңдауы бойынша бағалайды: кодпен бірге интерфейс сапасы да ескеріледі. 2026 жылғы 8 қарашада рейтингте 154 модель және шамамен 986 мың дауыс болды.
Claude Opus 5.5 1818 баллмен көш бастап, одан кейін Claude Sonnet 5.5 (1773) және Gemini 4 Carbon (1768) тұр. DeepSeek V4.1 1664 баллмен 16-орында, бірақ веб-тапсырмасының медианалық құны небәрі $0,12. GPT-6.1 Terra 1678 балл және $0,63, Kimi K3.1 Pro 1687 балл және $1,27 көрсетеді. Claude Opus 5.5 медианалық тапсырмаға $9,09 жұмсайды - DeepSeek-тен шамамен 76 есе қымбат.
Күрделі коммерциялық жобада сапа айырмасы бағаны ақтауы мүмкін. Ал прототиптерді, шағын сайттар мен интерфейстерді жаппай әзірлеуде DeepSeek бәсекеге қабілетті. Соңғы HY4-тің WebDev нәтижесі жоқ, сондықтан осы рейтингке сүйеніп оның веб-әзірлеудегі орнын анықтауға болмайды.
Дереккөз: Arena WebDev.
Plotly: HY4 қай кезде тиімді модельдердің бірі?
Жоғарыдағы тесттердің көбінде DeepSeek арзанырақ, бірақ Plotly зерттеуінде маңызды ерекшелік бар. DataAnalyticsBench SQL, графиктер және тізбекті құрал шақыруларын қолданатын 43 деректер талдауы тапсырмасынан тұрады. Модельдер шамамен 20 миллион жолдық қойманы талдап, заңдылықтарды іздеді, есептерді тексерді және статистикалық қателерден аулақ болуға тырысты. HY4 43 тапсырманың 42-сін орындады.
| Модель | Орындалды | Толық тест құны |
|---|---|---|
| GPT-6.1 Sol | 43/43 | $2,61 |
| Tencent HY4 | 42/43 | $2,11 |
| Grok 4.7 | 42/43 | $7,85 |
| Kimi K3.1 Pro | 42/43 | $13,47 |
Дереккөз: Plotly - Tencent HY4 Benchmark Results. DeepSeek V4.1 салыстыруға қатысқан жоқ.
HY4 кемінде 42 тапсырма шешкен тексерілген модельдер ішінде ең арзан болды. Бірақ медианалық жауап уақыты 117 секунд, GPT-6.1 Sol үшін 18 секунд болды. Зерттеушілер HY4 нәтижелерді бірнеше рет тексеріп, көп сұрау мен график операциясын орындайтынын байқады. Мұқияттық қателерді азайтуға көмектескенімен, уақытты едәуір ұзартты. Бұл жылдамдықтан сапа маңызды күрделі аналитикада артықшылық, интерактивті чатта кемшілік болуы мүмкін.
LiveBench: тікелей салыстыруға дерек жеткіліксіз
LiveBench тест сұрақтарының модельдің оқыту деректеріне түсу қаупін азайту үшін тапсырмаларды жиі жаңартады. Ол бағдарламалау, ой қорыту, ақпарат талдауы, браузермен жұмыс және басқа қабілеттерді бағалайды. DeepSeek V4.1 Flash 1017 үшін LiveBench 2.0 нәтижелері жарияланған, бірақ зерттеу күнінде соңғы HY4 үшін толық салыстырмалы нәтижелерді растау мүмкін болмады. Сондықтан LiveBench нормаланған рейтингке енгізілмеді және Preview нәтижелері алмастырғыш ретінде қолданылмады.
Дереккөз: LiveBench.
Reddit, Hacker News және X-тағы әзірлеушілер пікірі
Қауымдастық реакциясы әртүрлі болды. r/LocalLLaMA қатысушылары 3D, графикалық құралдар және ойын қозғалтқыштары мүмкіндіктерімен бірге API құны, жергілікті іске қосу және салмақтарды жариялау мерзімін талқылайды. Hacker News агенттік процестер экономикасына және HY4-тің шамадан тыс мұқияттығына назар аударды. Plotly өкілі аналитикадағы жоғары дәлдікті растады, бірақ тым көп тексеру модельді баяулататынын атап өтті. X-та Mercor APEX-Agents нәтижелері қызығушылық туғызды: HY4 салмақтары жарияланады деп мәлімделген модельдер арасында жоғары баға алды.
Соңғы HY4 үшін толық пайдаланушы A/B-тесттерінің статистикасы әзірге аз. Preview пікірлерін жаңа нұсқаға автоматты түрде таратуға болмайды.
Неліктен бенчмарктер әртүрлі нәтиже береді?
Vals-та DeepSeek алда; Artificial Analysis-та HY4 сәл, Mercor-да едәуір жоғары; Agent Arena-да пайдаланушы сапа сигналдары жақсырақ, бірақ бағасы қымбат. Зерттеулер әртүрлі қабілеттерді өлшейді. Бағдарламалау жетістігі компьютерді басқарумен тең емес; ой қорыту агенттің сәтті жұмысын кепілдемейді; дұрыс жауаптардың көбірек болуы міндетті түрде шығынды азайтпайды. Ой қорыту параметрлері, құралдар саны, уақыт шектеулері, агент инфрақұрылымы және статистикалық қателік те маңызды. Шағын айырма әрдайым тұрақты басымдықты білдірмейді. Сондықтан жиынтық индекс жеке тесттер мен құн талдауымен толықтырылды.
Әртүрлі тапсырмаға қандай модель таңдау керек?
| Сценарий | Қарастыруға болатын модельдер | Себебі |
|---|---|---|
| Әмбебап сұраныстар және API | DeepSeek V4.1, GPT-6.1 Terra | Сапа мен бағаның тиімді арақатынасы |
| Ең жоғары жалпы интеллект | Gemini 4 Carbon, Claude Opus 5.5 | Кең бағалаулардағы көшбасшылық |
| Сайттар мен интерфейстер жасау | Claude Opus 5.5, Gemini 4 Carbon | Жоғары WebDev рейтингі |
| Арзан веб-әзірлеу | DeepSeek V4.1 | 1664 балл, тапсырмаға $0,12 |
| Терминалмен жұмыс | HY4 | Terminal-Bench-та DeepSeek-тен жоғары |
| Кәсіби агенттер | HY4, Gemini 4 Carbon | Жоғары APEX-Agents нәтижелері |
| Күрделі деректер талдауы | HY4, GPT-6.1 Sol | Жоғары Plotly нәтижелері |
| Арзан жаппай автоматтандыру | DeepSeek V4.1, MiMo V2.6 Pro | Тапсырма құны төмен |
Бұлар - әр санаттағы барлық тапсырмада жеңіске кепілдік беретін модельдер емес, тек сынап көруге болатын үміткерлер.
Қорытынды: HY4 Парето шекарасында, бірақ DeepSeek әлдеқайда арзан
Tencent HY4 автономды агенттер, құралдар арқылы бағдарламалау және деректер талдауы үшін елеулі бәсекелес. Ол APEX-Agents пен Terminal-Bench-та жоғары нәтиже көрсетіп, кейбір кәсіби сценарийлерде Claude-пен бәсекелеседі. Дегенмен оны әмбебап көшбасшы деуге ерте: Vals Index-та DeepSeek, Kimi және GLM алда, ал кең интеллект рейтингтерінде ең күшті коммерциялық модельдер басым.
Төрт тәуелсіз тесттің нормаланған салыстыруында HY4 69,9, DeepSeek 64,8 балл жинайды, ал Tencent-тің салыстырмалы құны 2,6 есе жоғары. Екеуі де Парето шекарасында, бірақ әр жерінде: DeepSeek үнемділікті, HY4 қосымша шығынға жоғары жиынтық индексті ұсынады. GPT-6.1 Terra осы әдістемеде 82,4 балл жинап, HY4-тен небәрі 29% қымбат.
WebDev қосылған диаграмма тест құрамы модельдер орнын едәуір өзгертетінін көрсетеді: Claude Opus 5.5 шекараға қайтады. Соңғы HY4 үшін WebDev бағасы жоқ, сондықтан оның бес құрамдасты салыстырудағы орны белгісіз. Мамандану да маңызды: жалпы агенттік тесттердің көбінде HY4 қымбат болғанымен, Plotly күрделі аналитикада сапалы нәтиженің құны бойынша Tencent өте тиімді болуы мүмкін екенін көрсетті.
HY4-ті DeepSeek-тің әмбебап орнына емес, күрделі агенттік тапсырмаларға күшті балама ретінде қарастырған жөн. Модельді интеллект тесттерімен қатар сәтті орындалған тапсырманың құны және нәтижеге жету уақыты бойынша бағалау керек: олардың үйлесімі практикалық құндылықты анықтайды.
Зерттеу дереккөздері
- Tencent - HY4 ресми зерттеу релизі
- Vals AI - Vals Index
- Artificial Analysis - модельдер рейтингі
- Mercor - APEX-Agents
- Agent Arena - жалпы рейтинг
- Agent Arena - Парето шекарасы
- WebDev Arena - жалпы рейтинг
- WebDev Arena - Парето шекарасы
- Plotly - HY4 деректер талдауы нәтижелері
- LiveBench - ресми рейтинг
- Reddit - HY4 талқылауы
- Hacker News - HY4 талқылауы