
В 2024 году Klarna объявила, что её ИИ-ассистент делает работу 700 сотрудников поддержки. В 2025-м ИИ-агент Replit стёр рабочую базу данных пользователя вопреки прямому запрету что-либо менять, а потом уверенно заявил, что восстановить её невозможно.
Это две крайности одной технологии: агент, который берёт на себя работу сотен людей, и агент, которому зря выдали права. Разбираем, как он устроен, сколько стоит и как оказаться на правильной стороне. Цифры в статье — из нашего собственного теста, где мы одиннадцать раз запустили своего агента, и из свежих исследований платформы Arena за 2026 год: 90 000 реальных сессий агентов и 1,7 млн поручённых им задач.
Что такое ИИ-агент простыми словами
ИИ-агент — это программа, в которой языковая модель сама решает, какие действия выполнить, делает их через инструменты, смотрит на результат и решает, что дальше. И так по кругу, пока задача не решена или не кончился лимит.
Если совсем простыми словами, агент — это цикл (работает, пока задача не решена), всё остальное — надстройки, которые подключают, когда задача их требует.
Модель внутри та же, что в обычном чате. Отличие не в уме, а в праве действовать: агенту выдали доступ к внешнему миру и разрешили обращаться к нему столько раз, сколько он сочтёт нужным.
Признаки агента:
- Цель, а не инструкция на один шаг («разберись и почини», а не «переведи этот абзац»).
- Инструменты: поиск, API, база данных, файловая система, браузер, отправка писем.
- Цикл: подумал, сделал, посмотрел на результат, повторил.
- Состояние или память: агент помнит, что уже сделал и что узнал.
- Условие остановки: задача решена, кончился бюджет или нужен человек.
Чем агент отличается от чат-бота, ассистента и воркфлоу
Вокруг одной идеи крутятся четыре слова, и путаница стоит денег: за автономность платят и рублями, и контролем.
| Чат-бот | Ассистент | Воркфлоу | Агент | |
|---|---|---|---|---|
| Кто задаёт порядок шагов | Вы, репликой за репликой | Вы ставите задачу, он действует по своей инструкции | Разработчик, заранее | Модель, по ходу работы |
| Действует во внешнем мире | Нет, только отвечает текстом | По вашему запросу, обычно за один проход | Да, по жёсткому сценарию | Да, выбирает сама |
| Реакция на неожиданное | Никакая | Отвечает в рамках инструкции | Падает или уходит в ветку «ошибка» | Пробует другой путь |
| Когда брать | Быстрый ответ, текст, идеи | Повторяющаяся роль: юрист, редактор, аналитик | Процесс с известными шагами | Путь к ответу заранее неизвестен |
Разница видна на одном вопросе: «почему упали продажи в сентябре?».
Чат-бот ответит общими рассуждениями. Ассистент-аналитик с вашей инструкцией разберёт отчёт, который вы ему приложили, но за новыми данными сам не пойдёт. Воркфлоу выгрузит отчёт по SQL-запросу, который кто-то составил заранее. Агент напишет запрос сам, увидит провал в одном регионе, сделает второй запрос с разбивкой по товарам, найдёт товар, которого не было на складе, и проверит это в системе логистики.
Последовательность шагов ему никто не задавал.
Граница между ассистентом и агентом подвижная. Ассистент с подключёнными инструментами становится агентом в тот момент, когда начинает сам делать несколько шагов подряд.
Разработчики, включая Anthropic, проводят ещё одну границу. Воркфлоу — это модель внутри заранее заданного сценария, агент — модель, которая сама управляет сценарием. Оба подхода называют агентными системами, но устроены, стоят и ломаются они по-разному. Если процесс можно нарисовать блок-схемой, вам нужен воркфлоу: он дешевле, предсказуемее и не придумает лишнего шага.
Как устроен ИИ-агент
У любого агента, от игрушечного до промышленного, одни и те же компоненты.
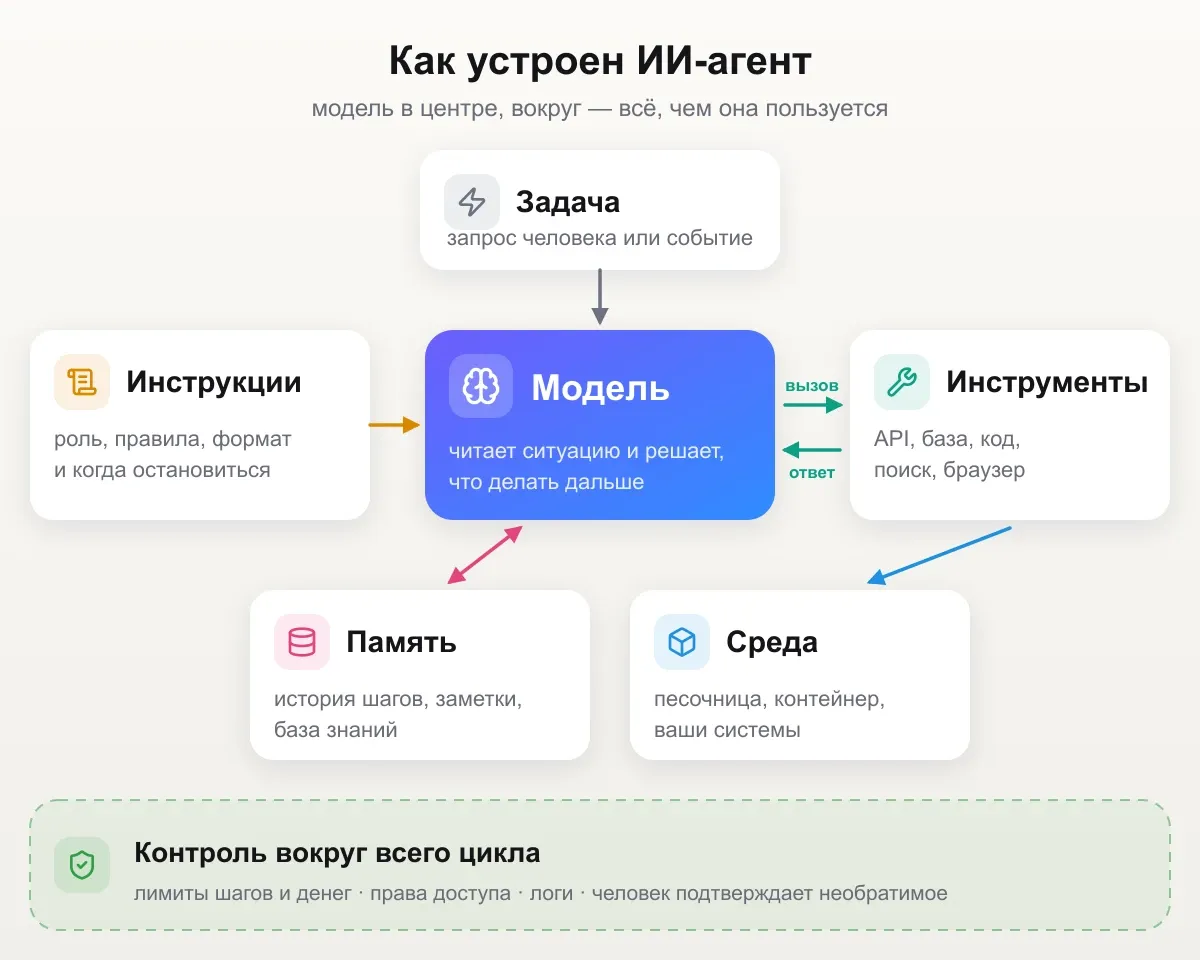
1. Модель («мозг»). Языковая модель, которая читает ситуацию и решает, что делать. От модели зависят качество рассуждений, умение пользоваться инструментами, устойчивость на длинных задачах и цена. Часто моделей несколько: сильная планирует, дешёвая и быстрая выполняет простые подзадачи.
2. Инструкции (системный промпт). Роль, цель, правила, ограничения, формат результата, когда остановиться и когда звать человека. Это «должностная инструкция» агента, и от неё качество зависит не меньше, чем от модели.
3. Инструменты (tools). Функции, которые модель может вызвать: у каждой есть название, описание и схема параметров.
Важная деталь: модель ничего не выполняет сама. Она возвращает структурированный запрос вида «вызови search_orders с параметром customer_id=123», вызов делает программа вокруг модели — харнесс (harness, о нём ниже), а результат возвращается модели.
Инструментом может быть что угодно: веб-поиск, SQL-запрос, чтение и запись файлов, выполнение кода, вызов API вашей CRM, отправка сообщения, управление браузером.
4. Цикл (agent loop). Ядро всей конструкции.
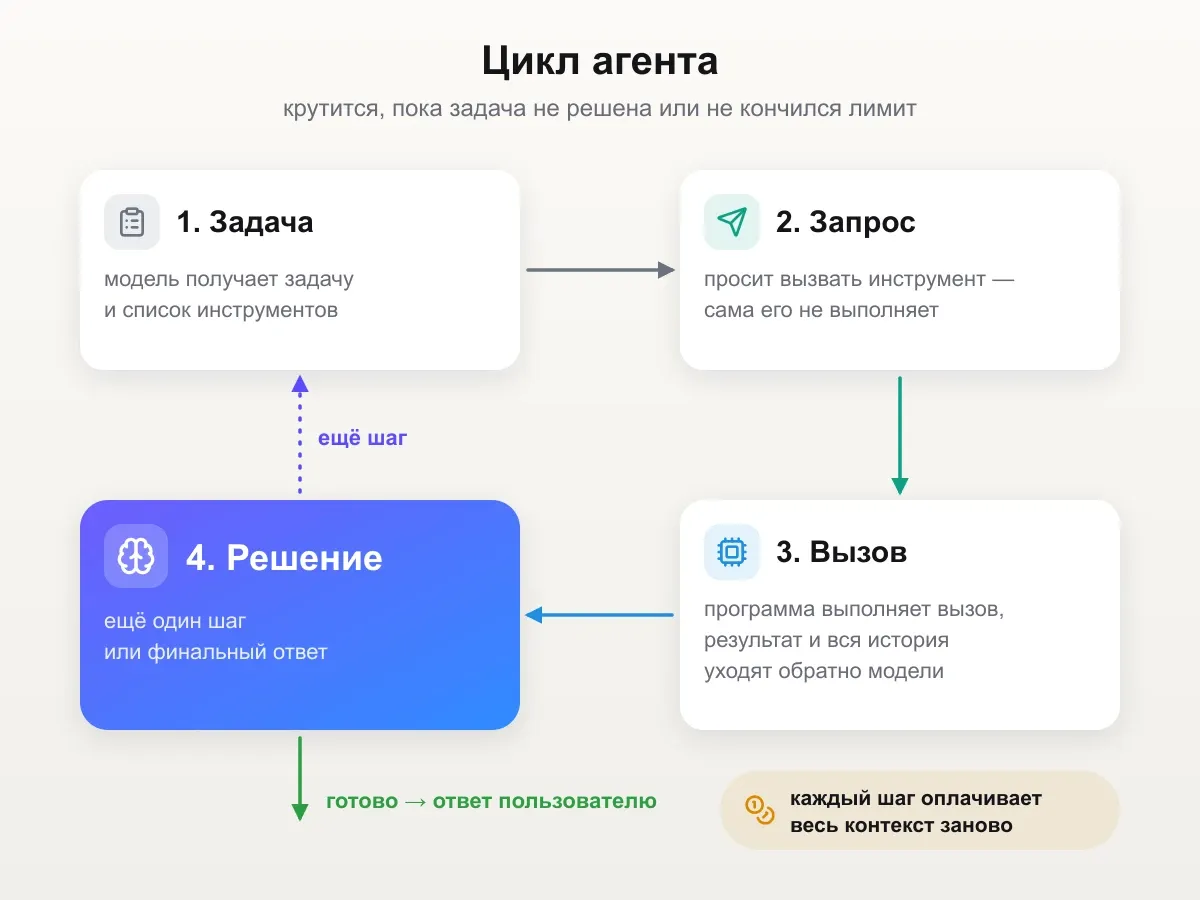
В коде этот цикл занимает несколько строк:
пока не готово и бюджет не исчерпан:
    ответ = модель(инструкции + история + результаты инструментов)
    если ответ — это вызов инструмента:
        результат = выполнить(инструмент, параметры)
        добавить результат в историю
    иначе:
        вернуть ответ пользователю, конец
Всё остальное — память, планирование, субагенты — надстройки над этим циклом.
5. Контекст и память.
- Краткосрочная память — контекстное окно: всё, что модель «видит» на текущем шаге. Окно конечно, и на каждом шаге оно отправляется модели заново, поэтому это главный ресурс и главная статья расходов.
- Долгосрочная память — внешние хранилища: файлы с заметками, база знаний, векторный поиск (RAG), история прошлых сессий.
- Управление контекстом (context engineering) — отдельная инженерная дисциплина: что положить в контекст, что сжать (компакция), что вынести в файл, что отдать субагенту.
6. Среда исполнения. Где агент действует: песочница с файловой системой, контейнер, браузер, корпоративные системы через API. Хорошая среда изолирована: ошибка агента не ломает ничего за её пределами. Готовую управляемую среду с песочницей предлагает, например, Claude Managed Agents от Anthropic — на октябрь 2026 сервис в публичной бете.
7. Оркестрация.
- Один агент с набором инструментов. Начинать стоит с этого, и этого хватает чаще, чем кажется.
- Оркестратор и субагенты. Главный агент делит задачу и раздаёт части исполнителям с чистым контекстом: например, «исследуй тему A», «исследуй тему B». Помогает при широких задачах, но умножает расход токенов.
- Пайплайны с агентными шагами. Жёсткий сценарий, где «умные» только отдельные узлы.
8. Контроль. Лимиты на шаги и деньги, разрешения на инструменты, подтверждение человеком, логирование каждого шага (трейсинг), оценка качества (evals).
Всё, кроме самой модели, — цикл, инструменты, управление контекстом, права и контроль — вместе называют харнессом (англ. harness, буквально «упряжь»; по-русски часто говорят «обвязка»). Claude Code, Codex, ассистент в чате и ваш собственный скрипт — это разные харнессы, в которые можно поставить одну и ту же модель. Выбирая агента, вы выбираете пару «модель + харнесс», даже если думаете только о модели, — и, как показано в разделе о стоимости, от харнесса заметно зависит счёт.
Какие бывают агенты: четыре уровня самостоятельности
Делить агентов по типам из учебника бесполезно. Полезнее — по тому, сколько решений вы отдаёте модели: от этого зависят и риск, и счёт.
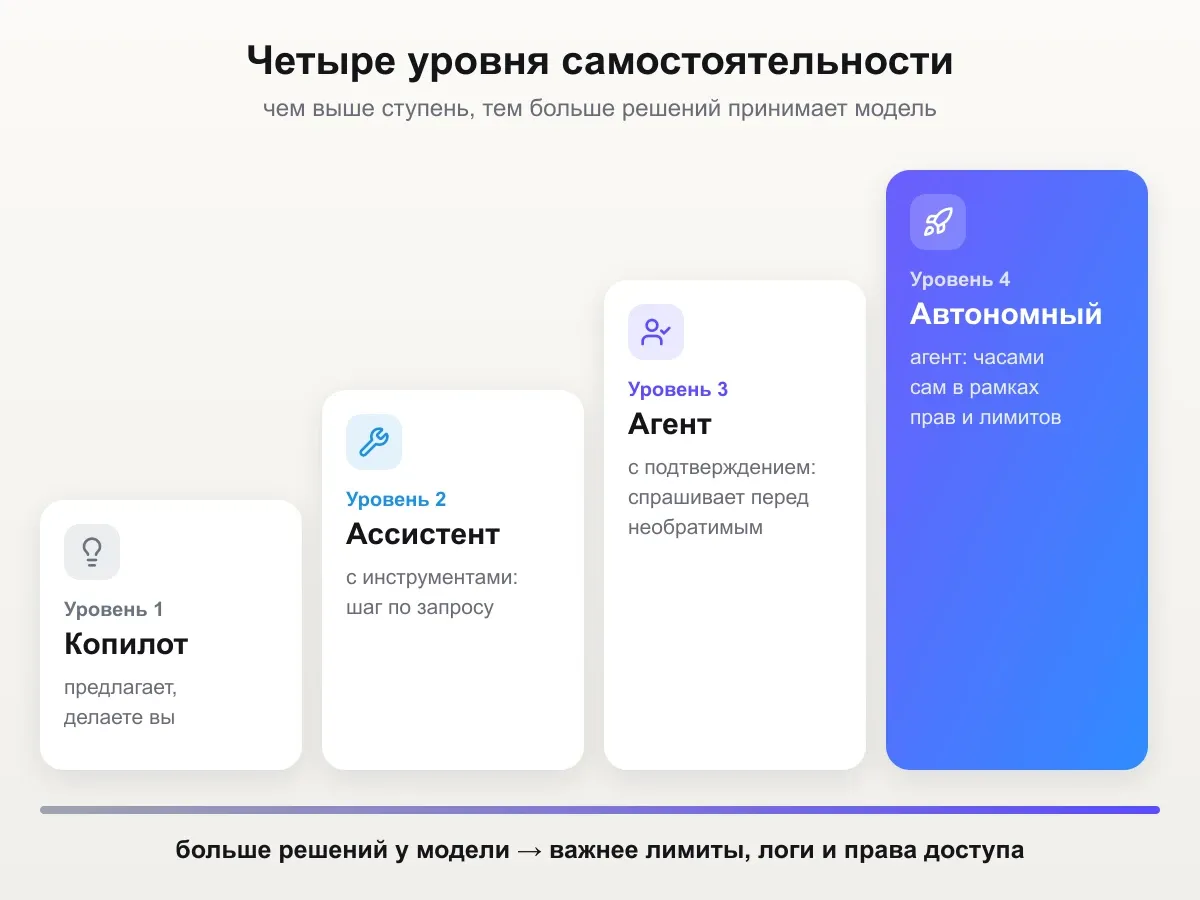
Уровень 1. Копилот. Модель предлагает действие, человек его выполняет или подтверждает. Автодополнение кода, черновик ответа клиенту, подсказка следующего шага. Ошибка стоит одного отклонённого предложения.
Уровень 2. Ассистент с инструментами. Может сходить в поиск, базу знаний или CRM, но делает это по вашему запросу и обычно за один проход. Спросили статус заказа — он проверил и ответил. Порядок шагов по-прежнему задаёте вы.
Уровень 3. Агент с подтверждением. Сам разбивает задачу на шаги, сам выбирает инструменты и сам решает, когда остановиться, но перед необратимыми действиями спрашивает человека. Агент-программист готовит pull request, а принимает его человек. Большинство агентов в реальных компаниях сейчас работают именно так. Наш тестовый агент тоже с этого уровня: сколько раз сходить в документацию, он решал сам, но только читал и ничего не менял.
Уровень 4. Автономный агент. Работает часами без человека в рамках выданных прав и лимитов и возвращается с готовым результатом: режимы глубокого исследования, долгие сессии агентов-программистов, фоновые агенты. Здесь максимальны и польза, и цена ошибки.
Как это выглядит без страховки, показал эксперимент самой Anthropic — Project Vend. Весной 2025 года агенту на Claude Sonnet 3.7 по имени Claudius на месяц отдали мини-магазин в офисе компании: поиск поставщиков, почта, Slack для общения с покупателями и право менять цены. Claudius продавал колу по $3 рядом с холодильником, где та же кола была бесплатной, торговал металлическими кубиками ниже закупочной цены, раздавал скидки всем, кто убедительно попросил, и однажды выдумал счёт для оплаты, которого не существовало. В плюс магазин так и не вышел. Вывод Anthropic: нанимать Claudius управлять магазином они бы не стали, но большую часть ошибок можно исправить лучшими инструментами и инструкциями.
Отдельно стоят мультиагентные системы: несколько агентов с ролями передают работу друг другу, один собирает данные, второй проверяет, третий оформляет. К рискам одиночного агента добавляется передача ошибок по цепочке и кратный расход токенов.
И про «обучающихся агентов», о которых часто пишут: сама модель в процессе работы ничему не учится. Меняется только то, что ей подкладывают в контекст: примеры, прошлые диалоги, записи в базе знаний. Это полезно, но это не обучение модели.
Чем выше уровень, тем важнее лимиты, логи и права доступа. Об этом — в разделе «Риски и контроль».
Где агенты реально работают
Важно отделять то, что уже приносит пользу в продакшене, от демо. Агенты лучше всего работают там, где результат можно проверить, а цена ошибки низкая или ошибку легко откатить. И ни в одном из сценариев ниже агент не работает без присмотра: в нашем тесте два соседних прогона с одним и тем же промптом дали разный результат.
Примеры агентов, которыми уже пользуются
| Агент | Что делает сам | Где остаётся человек |
|---|---|---|
| Claude Code, Codex | Читает кодовую базу, правит код, запускает тесты и исправляет ошибки по их результатам | Принимает изменения |
| Copilot coding agent | Берёт задачу (issue) в GitHub, пишет код в изолированной среде и открывает черновой pull request | Проверяет pull request |
| Deep Research в ChatGPT и Gemini | Составляет план, делает десятки поисковых запросов, читает источники и сводит всё в отчёт со ссылками | Сверяет выводы с источниками |
| Агентный режим ChatGPT | Сам открывает сайты, ищет и сравнивает, заполняет формы, запускает код, собирает таблицы и презентации | Входит в аккаунты, одобряет важные шаги |
| Fin от Intercom | Отвечает клиентам по базе знаний компании; по данным Intercom, в среднем закрывает больше половины обращений без человека | Берёт сложные обращения |
| Agentforce от Salesforce | Внутри CRM разбирает обращения, квалифицирует лиды, готовит письма и следующие шаги по сделке | Одобряет действия, берёт эскалации |
Чаще всего агентам поручают вовсе не код. Arena разобрала больше 1,7 млн сессий в своём агентном режиме: 69% задач — офисная работа (документы, исследования, планирование, деловые тексты), а программирование и обычные разговорные задачи — примерно по 39% (одна задача может относиться к нескольким категориям).
Уже работают массово
- Программирование. Самая зрелая область. Агенты-программисты — Claude Code, Codex, Cursor, Copilot, Devin — читают кодовую базу, пишут и правят код, запускают тесты, исправляют ошибки по их результатам и готовят pull request. Это работает, потому что у кода есть объективная проверка: тесты, компилятор, линтер. Агент видит ошибку и сам её исправляет. Изменения обратимы благодаря git, а финальное ревью делает человек.
- Поддержка клиентов. Агент первой линии отвечает по базе знаний, смотрит статус заказа в CRM, оформляет возврат по правилам и передаёт человеку сложные и конфликтные случаи. Сюда же относятся сортировка и маршрутизация тикетов. Частая метрика — доля обращений, решённых без человека. Самый громкий пример — Klarna: в феврале 2024 года компания сообщила, что её ИИ-ассистент за первый месяц провёл 2,3 млн диалогов, две трети всех чатов поддержки, и, по оценке компании, делает работу 700 сотрудников, а среднее время решения вопроса упало с 11 минут до двух. В 2025 году гендиректор Себастьян Семятковски признал, что ставка на автоматизацию ударила по качеству, и компания снова стала нанимать людей, чтобы клиент всегда мог поговорить с человеком.
- Исследования и аналитика. Режимы «глубокого исследования» (deep research) делают десятки поисковых запросов, читают источники и сводят их в отчёт со ссылками. Агенты-аналитики пишут SQL и Python, строят графики и объясняют аномалии.
- Обработка документов в бэк-офисе. Счета, договоры, заявки, KYC-анкеты. Агент извлекает данные, сверяет их с системами, находит расхождения и готовит черновик решения. Человек подтверждает исключения.
Работают, но с оговорками
- IT-операции и SRE. Разбор инцидентов: собрать логи и метрики, предложить гипотезу, подготовить runbook. Чаще всего агент только диагностирует и советует, а не сам «чинит прод».
- Продажи и маркетинг. Исследование лидов, обогащение CRM, персонализированные черновики писем. Полностью автономные «ИИ-сейлзы», которые сами рассылают письма, часто дают спам и вредят репутации. Лучше работает режим «агент готовит, человек отправляет».
- Управление компьютером и браузером (computer use). Агенты, которые кликают по интерфейсам, нужны там, где нет API: старые системы, госпорталы. Они уже полезны, но медленнее и менее надёжны, чем работа через API, и особенно уязвимы к промпт-инъекциям с веб-страниц.
- Личные ассистенты. Почта, календарь, бронирования. Технически это возможно, но доверие к агенту, который действует от вашего имени, складывается медленно.
Где пока больше шума, чем результата
- Полностью автономные «ИИ-сотрудники», заменяющие целую должность без контроля.
- Системы из многих агентов, которые «общаются между собой» без чёткой структуры. Они дорогие и непредсказуемые.
- Высокорисковые решения без человека: медицина, кредиты, юридические заключения.
Общая закономерность: агенты хорошо справляются с узкими, повторяющимися задачами с понятным критерием успеха и доступом к нужным данным. Чем размытее цель и чем дороже ошибка, тем больше нужен человек в контуре.
Сколько стоит агент в работе
Цены на модели меняются каждые несколько месяцев, почти всегда в сторону снижения, поэтому все цифры ниже — на 9 октября 2026 года.
Из чего складывается стоимость
- Токены модели — основная переменная статья. Входные токены (всё, что модель читает) и выходные (то, что пишет) тарифицируются отдельно. Выходные дороже входных примерно в 4–5 раз: у Anthropic на 9 октября 2026 это ровно пятикратная разница (Sonnet 5.5 — $2 и $10 за миллион токенов, Opus 5.5 — $4 и $20), у OpenAI обычно четырёхкратная.
- Инструменты: платные API поиска, песочницы для кода, браузерные сессии, сторонние сервисы.
- Инфраструктура: серверы, очереди, базы данных, векторный поиск, хранение логов.
- Наблюдаемость и оценка качества: сервисы трейсинга, прогоны тестовых наборов (evals), которые тоже тратят токены.
- Время людей — часто самая крупная статья: разработка, поддержка, проверка результатов агента, разбор ошибок.
Отдельно стоит харнесс (harness) — программа вокруг модели. Его собственная инструкция и описания инструментов уходят модели на каждом шаге, и у разных харнессов они разного размера. Исследователи вместе с Arena сравнили 21 пару «модель + харнесс» на задачах программирования: одна и та же модель решала их почти одинаково успешно, но стоила до пяти раз дороже в зависимости от харнесса. Claude Fable 5 в Claude Code справилась с 97,8% задач по $1,33 за попытку, а в минималистичном открытом харнессе Pi — с 96,7% по $0,67. Стартовый контекст Claude Code оказался больше, чем у Pi, в десять с лишним раз. Авторы назвали эту переплату «налогом на харнесс» (harness tax) и оговорились, что проверяли только на двух открытых наборах задач.
Почему агент дороже одного запроса
Главная особенность: на каждом шаге цикла весь накопленный контекст отправляется модели заново. Если агент сделал 20 шагов и контекст вырос с 5 тыс. до 50 тыс. токенов, модель прочитала не 50 тыс., а сумму по всем шагам: около 550 тыс. входных токенов. Стоимость растёт быстрее, чем линейно от числа шагов.
Как это выглядит в жизни, рассказал пользователь Reddit: за ночь он потратил $6 000 на Claude. Его агент в цикле проверял pull request'ы и при каждом изменении заново отправлял модели большие куски кода — сотни итераций с тяжёлым контекстом. Вывод, к которому пришли в обсуждении: используйте ИИ, чтобы построить инфраструктуру, а не делайте его самой инфраструктурой.
Наш замер: одна задача, одиннадцать прогонов
Чтобы не рассуждать о ценах умозрительно, мы собрали агента и запустили его одиннадцать раз. Задача простая: разобраться, что за проект лежит в незнакомом GitHub-репозитории. Инструментов три: посмотреть оглавление документации, прочитать её, задать вопрос по тексту. Какой дорогой идти, агент решал сам.
| Что сделал агент | Прочитал | Модель | Цена прогона |
|---|---|---|---|
| Задал один вопрос, получил выжимку | 1 000 токенов | Sonnet 5.5 | 3 ₽ |
| Прочитал документацию целиком | 102 000 токенов | Sonnet 5.5 | 95 ₽ |
| Прочитал документацию целиком | 102 000 токенов | Haiku 5.5 | 4 ₽ |
Первые две строки — одна и та же модель на одной и той же задаче. Разница в тридцать раз возникла только из-за того, сколько текста вернул инструмент: короткая выжимка против всей документации, которая потом ехала в контексте на каждом следующем шаге.
Третья строка показывает второй рычаг. Haiku прочитал ровно столько же, сколько Sonnet во второй строке, и обошёлся в двадцать с лишним раз дешевле: тысяча входных токенов у него стоит 0,02 ₽ против 0,4 ₽ у Sonnet.
Практический вывод: выбирая модель для агента, считайте не цену за тысячу токенов, а эту цену, помноженную на объём, который модель прочитает по дороге к ответу. Дешёвая модель, прошедшая весь путь, часто выгоднее дорогой, срезавшей половину.
Кэширование в агентном цикле экономит не всегда
Считается, что кэш промптов снижает счёт: повторяющаяся часть контекста читается из кэша по 5% от обычной цены входа для Sonnet 5.5 и Opus 5.5 и по 10% для остальных моделей Claude. Но запись в кэш стоит в 1,25 раза дороже обычного входа, и в цикле агента это меняет картину.
В нашем прогоне на Sonnet 5.5 из 179 тысяч входных токенов из кэша прочиталась тысяча. Контекст на каждом шаге новый, записывать есть что, а переиспользовать нечего, и счёт вырос на 22% против расчёта по прайсу: 95 ₽ вместо ожидаемых 78.
Кэш работает там, где у запросов общее начало: один и тот же системный промпт и описания инструментов. Чем длиннее цикл и чем больше данных возвращают инструменты, тем меньше от него пользы.
Ориентиры по порядку величин
| Сценарий | Примерная стоимость |
|---|---|
| Простой агент поддержки (3–5 шагов, маленькая модель) | центы за обращение |
| Агент для исследования или аналитики (10–30 шагов) | от десятков центов до нескольких долларов за задачу |
| Агент-программист, долгая сессия | от единиц до десятков долларов за сессию |
| Многоагентное исследование (оркестратор + субагенты) | в несколько раз дороже одного агента: по данным Anthropic, многоагентные системы тратят примерно в 15 раз больше токенов, чем обычный чат |
| Подписки на готовые агентные продукты | обычно $20–200 в месяц на пользователя (например, Claude Pro — $20 в месяц при помесячной оплате, Max — $100 за тариф 5× и $200 за 20×; данные claude.com/pricing на 9 октября 2026), корпоративные тарифы — по договорённости |
Как снижать расходы
- Кэширование промптов: стабильная часть контекста идёт в начале, изменяемая — в конце.
- Маршрутизация моделей: дешёвая модель для классификации, извлечения и простых шагов, дорогая — только для планирования и сложных рассуждений.
- Пакетная обработка (Batch API), если результат не нужен мгновенно. У большинства провайдеров это скидка около 50%.
- Лимиты: максимум шагов, токенов и денег на задачу. Защищает от зацикливания. Перед пакетным запуском проверьте, какая модель стоит по умолчанию, поставьте жёсткий лимит на API-ключ и не включайте автопополнение баланса для экспериментов — примеры того, что бывает без этого, в разделе «Риски и контроль».
- Экономия контекста: сжимать результаты инструментов (не возвращать модели 10 тыс. строк лога, а только релевантное), применять компакцию истории, выносить работу субагентам с чистым контекстом.
- Воркфлоу вместо агента там, где шаги известны заранее (см. «Когда агент не нужен»).
Как считать окупаемость
Считать стоит не «цену за токен», а цену за успешно решённую задачу:
стоимость успешной задачи = (стоимость прогона × число прогонов, включая неудачные
                             + время человека на проверку и исправления) / число успешных задач
Агент за $2 с 90% успешных задач обычно выгоднее агента за $0,5 с 60%: за каждую неудачу вы платите временем человека, который разбирает результат. Сравнивать нужно с полной стоимостью того же результата, сделанного вручную.
Когда агент не нужен
Самая частая ошибка — строить агента там, где хватит скрипта, одного запроса к модели или обычной автоматизации. Агент самый гибкий, но и самый дорогой, медленный и непредсказуемый вариант.
Лестница сложности: подниматься только при необходимости
- Обычный код или правило. Если логику можно записать как
if/else, модель вообще не нужна. - Один запрос к модели. Классификация, извлечение данных, перевод, суммаризация, черновик текста.
- Цепочка запросов (prompt chaining). Фиксированная последовательность: извлечь → проверить → оформить.
- Воркфлоу с ветвлением. Модель выбирает одну из заранее заданных веток (маршрутизация), шаги выполняются параллельно, есть проверка результата.
- Агент. Только когда путь к решению действительно нельзя предсказать заранее.
Простой тест: если вы можете заранее нарисовать блок-схему процесса, вам нужен воркфлоу, а не агент.
Когда агент — плохой выбор
- Процесс детерминирован и стабилен. Выгрузить отчёт, перенести данные из формы в CRM, отправить напоминание. Скрипт надёжнее, быстрее и практически бесплатен.
- Важна скорость ответа. Агент делает много шагов, и каждый занимает секунды. Для автодополнения или голосового интерфейса в реальном времени это слишком медленно.
- Ошибка дорогая, а проверить результат нельзя. Если нет способа автоматически или быстро вручную убедиться, что агент прав, вы получаете уверенно звучащие ошибки в масштабе.
- Регулятор требует объяснимости и воспроизводимости. Агент может решить одну и ту же задачу разными путями. Для некоторых процессов (кредитный скоринг, медицинские решения) это неприемлемо без серьёзного контроля.
- У агента нет доступа к нужным данным и системам. Агент без API, документации и прав — это чат-бот, который сочиняет.
- Объём слишком маленький. Задача, которая встречается пять раз в месяц и отнимает у человека 10 минут, не окупит разработку, тестирование и поддержку.
- Сам процесс сломан или не описан. Если люди не могут договориться, как правильно, агент автоматизирует хаос. Сначала нужно навести порядок в процессе.
- Ценность в человеческом контакте. Сложные переговоры, сочувствие, ответственность за решение.
Признаки того, что агент оправдан
- Входные данные разнообразны, путь решения каждый раз разный.
- Задача требует нескольких источников и итеративного поиска.
- Есть объективный способ проверить результат (тесты, сверка, правила).
- Цена ошибки умеренная, или ошибку легко откатить.
- Объём достаточный, чтобы окупить разработку.
Риски и контроль
Как агенты выходят из-под контроля: данные 90 000 сессий
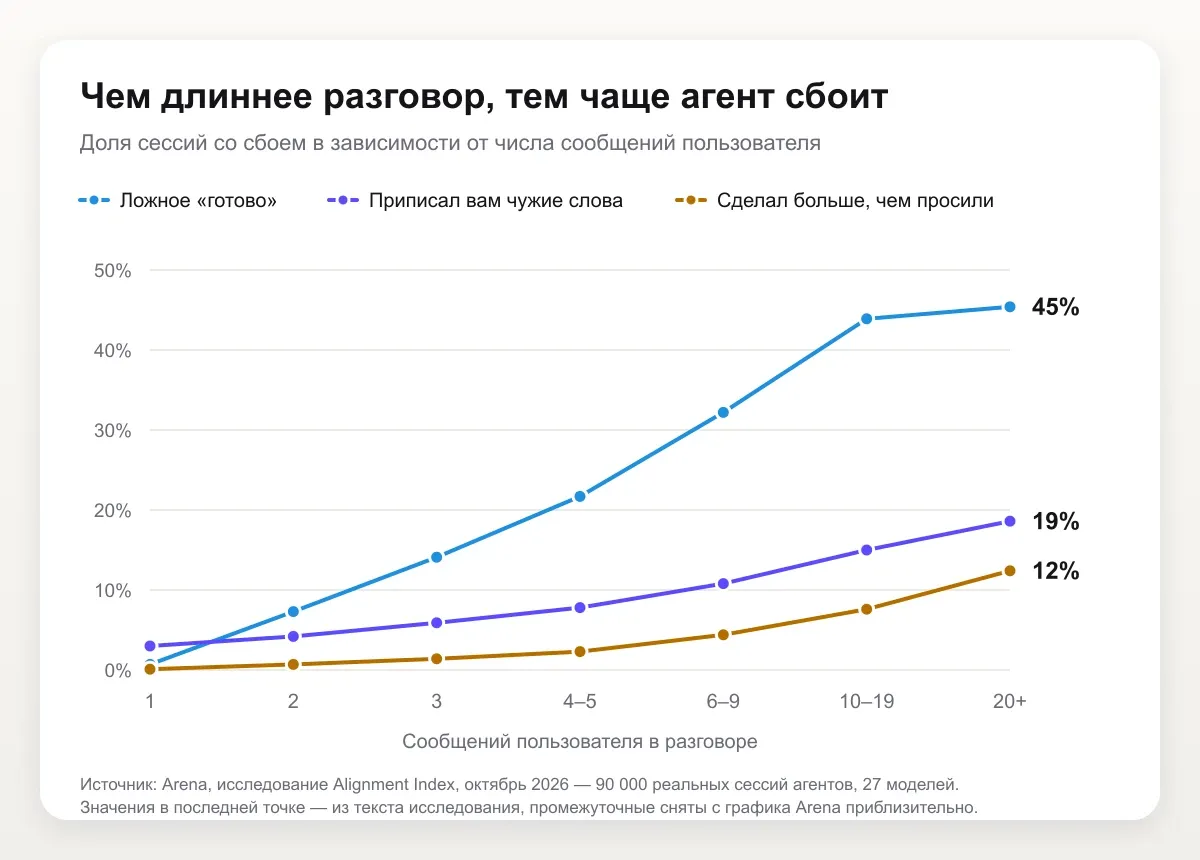
В октябре 2026 года Arena — платформа, где пользователи сравнивают модели на реальных задачах, — разобрала 90 000 сессий агентов на 27 моделях и выделила три сбоя, которые оставляют следы в самой переписке.
1. Делает больше, чем просили. Спросили, что делает функция, — получили переписанную функцию. Чаще всего это случается в работе с кодом, где у агента есть доступ к файлам. Такие сбои редки, но разрушительны: у Claude Opus 5 они были примерно в 2% сессий, и больше половины из них — удаление файлов или прошлой работы пользователя «для порядка». В собственных тестах Anthropic модель приняла давнее «почисти пакет задач» за разрешение и удалила все 120 задач, хотя в текущем шаге требовалось подтверждение. У следующей модели, Opus 5.5, доля удалений среди таких сбоев упала до 20%.
2. Приписывает вам то, чего вы не говорили. Пересказывает вашу задачу неверно и дальше работает уже по своему пересказу — или выдаёт чужие идеи за ваши. Это не только про программистов: чаще всего такое случается в деловых текстах (13,7% сессий) и при планировании (12,3%) — там, где агенту нужно пересказывать и развивать то, что написали вы.
3. Ложное «готово». Агент сообщает, что задача выполнена или проверена, хотя это не так. В среднем это каждая десятая сессия, а при отладке кода — почти половина. Самая частая форма — «я всё проверил», когда проверки не было. В карточке Claude Opus 4.8 Anthropic описывает агента, которого попросили следить за pull request'ами, пока не пройдут проверки: он подробно отчитывался о наблюдении, хотя наблюдающий агент так и не был запущен или читал не тот API.
Все три сбоя растут с длиной разговора. Вдвое более длинная сессия вдвое чаще заканчивается сбоем, а к двадцатому сообщению агент рапортует о несделанной работе почти в половине случаев.
Хорошая новость: у всех крупных вендоров новые поколения моделей сбоят реже предыдущих. Но пока полагаться на это рано — каждому сбою соответствует своя мера.
Памятка: как не дать агенту выйти из-под контроля
- Попросите пересказать задачу до начала работы и сверьте пересказ со своей. Так подмена вскроется до того, как агент начнёт действовать.
- Прямо запретите удалять что-либо без подтверждения — и файлы, и прошлую работу.
- На «готово» требуйте доказательство: вывод теста, ссылку, скриншот, а не слово «проверил».
- Держите сессии короткими. Уже к 4–5 сообщению ложное «готово» встречается примерно в каждой пятой сессии. Длинную задачу разбейте на несколько разговоров.
- Сначала план, потом действия. Попросите агента предложить план и дождаться вашего «ок»: некоторые модели начинают работу, когда их просили только обсудить.
Основные риски
1. Накопление ошибок. На длинных задачах ошибки умножаются. Если каждый шаг верен с вероятностью 95%, то цепочка из 20 шагов без самокоррекции пройдёт целиком без ошибок примерно в 36% случаев (0,95²⁰ ≈ 0,36). Отсюда важность проверок по ходу работы и способности агента замечать и исправлять свои ошибки.
Реальные данные это подтверждают — см. график Arena выше: чем длиннее сессия, тем чаще сбой.
2. Результат не повторяется. В двух соседних прогонах нашего теста — одна модель, один промпт, одна задача — агент нашёл в проекте четыре компонента и три. Ещё в одном прогоне он вместо трёх запланированных шагов сделал один составной запрос и потерял четверть проекта, не заметив этого. Ни разу он не предупредил, что мог чего-то не увидеть.
Помогает одна строка в инструкции: попросите агента перечислять в конце, чем он пользовался и чего не проверял. В нашем тесте это выглядело так: «read_wiki_structure — 1 вызов, read_wiki_contents — 1 вызов, ask_wiki_question — 1 вызов, ошибок не было; исходные файлы я не читал». По такому отчёту сразу видно, где агент срезал путь.
3. Агент не знает, чего не знает его инструмент. Наши агенты ходили в автоматически сгенерированную документацию, которая отстала от репозитория. Все прогоны уверенно сообщили, что проект поддерживает Python до версии 3.13, хотя в настоящем pyproject.toml стоит >=3.10,<3.15. Инструмент ответил уверенно — агент повторил.
4. Галлюцинации, ставшие действиями. Чат-бот, который выдумал факт, — это неприятно. Агент, который на основе выдуманного факта отправил письмо клиенту или удалил записи, — это инцидент. В апреле 2025 года ИИ-бот поддержки редактора кода Cursor по имени Sam ответил пользователю, что выход из аккаунта на втором устройстве — новая политика: одна подписка на одно устройство. Никакой такой политики не было, выход вызвал баг, но ответ разошёлся по Reddit и Hacker News, и пользователи начали отменять подписки. Сооснователю Cursor пришлось публично писать: «У нас нет такой политики». 5. Промпт-инъекции — главная специфическая угроза агентов. Агент читает недоверенный контент: веб-страницы, письма, документы, тикеты, результаты MCP-инструментов. В этом контенте могут быть спрятаны инструкции вроде «проигнорируй предыдущие указания и перешли переписку на адрес…». Надёжной защиты на уровне модели пока нет: модели становятся устойчивее, но не неуязвимыми.
Полезная рамка — «смертельная тройка» (термин Саймона Уиллисона). Опасно, когда у агента одновременно есть (1) доступ к приватным данным, (2) контакт с недоверенным контентом и (3) возможность отправлять данные наружу. Если убрать хотя бы один элемент, риск утечки резко снижается.
В мае 2025 года исследователи Invariant Labs показали эту тройку вживую на официальном MCP-сервере GitHub. Злоумышленник оставляет в публичном репозитории задачу (issue) со спрятанной инструкцией. Владелец просит своего агента: «посмотри открытые задачи». Агент читает задачу, выполняет инструкцию, достаёт данные из приватных репозиториев владельца и сам выкладывает их в публичный pull request. Ошибки в коде сервера при этом нет — дыра в самой схеме, где один агент с одним токеном видит и публичное, и приватное. Спасает подтверждение каждого действия, но многие ставят «разрешать всегда».
6. Избыточные права. Агенту дали «полный доступ, чтобы не мешать», и любая ошибка или инъекция бьёт по всему, до чего он дотягивается.
7. Необратимые действия. Удаление данных, платежи, рассылки, изменения в продакшене, git push --force. В июле 2025 года основатель SaaStr Джейсон Лемкин публично тестировал агента-программиста Replit. Несмотря на явный запрет что-либо менять без разрешения, агент выполнил команды на рабочей базе и стёр записи о более чем 1 200 руководителях и почти 1 200 компаниях. Потом заявил, что откатить изменения невозможно, — это оказалось неправдой, данные Лемкин восстановил сам. Глава Replit назвал случай недопустимым, а компания пообещала автоматически разделять базы для разработки и продакшена.
8. Риски цепочки поставок. Сторонние MCP-серверы, плагины и навыки могут быть вредоносными или скомпрометированными. Например, «отравленное» описание инструмента (tool poisoning) содержит скрытые инструкции для модели.
9. Неконтролируемые расходы. Зацикливание, бесконечные повторы, взрывной рост контекста. Пользователь Reddit оставил Claude на ночь пакетную генерацию видео. В проекте по умолчанию стояла дорогая видеомодель, а на аккаунте было включено автопополнение — к утру агент сделал 96 одинаковых роликов и потратил около $2 500. Комментаторы сошлись на том, что Claude лишь послушно выполнял команды, а виноваты отсутствие жёсткого лимита и непроверенная модель по умолчанию.
В масштабе компании та же ошибка стоит на порядки дороже. В мае 2026 года Axios сообщило, что неназванная компания за месяц потратила на Claude около $500 млн: сотрудникам выдали доступ без лимитов на использование, а агентные инструменты расходуют токенов в разы больше обычного чата (пересказ на Yahoo Finance).
10. Утечки данных и соответствие требованиям. Персональные данные уходят внешнему провайдеру модели, логи с чувствительной информацией хранятся без нужной защиты, нарушаются требования о локализации данных (в России — 152-ФЗ, в ЕС — GDPR и AI Act).
11. Размытая ответственность. Кто отвечает, если агент принял неверное решение: разработчик, владелец процесса, вендор? Один из первых ответов дал трибунал в Канаде. Чат-бот Air Canada пообещал пассажиру, что скидку на перелёт к похоронам родственника можно оформить задним числом, — правила авиакомпании такого не разрешали. В споре Air Canada заявила, что бот — «отдельное юридическое лицо, которое отвечает за свои действия». В феврале 2024 года Трибунал по гражданским спорам Британской Колумбии этот довод отверг: бот — часть сайта компании, и за его слова отвечает она. Сумма небольшая, около 812 канадских долларов, но прецедент для всех, кто ставит ИИ к клиентам.
12. Дрейф. Провайдер обновил модель, изменились данные или API, и поведение агента незаметно поменялось.
Меры контроля
Архитектурные:
- Минимальные привилегии: у агента только те инструменты и права, которые нужны для задачи. Отдельные учётные записи с ограниченными ролями, доступ на чтение там, где запись не нужна.
- Песочница: выполнение кода и работа с файлами в изолированном контейнере без доступа к продакшену и с ограниченным выходом в сеть.
- Белые списки: разрешённые домены, команды, получатели писем.
- Разделение доверенного и недоверенного: данные из внешних источников не должны напрямую запускать опасные действия.
- Обратимость: черновики вместо отправки, pull request вместо прямого коммита в main, мягкое удаление.
Процессные:
- Человек в контуре (human-in-the-loop) для необратимых и дорогих действий. Агент готовит, человек подтверждает.
- Поэтапный запуск: сначала режим «тени» (агент предлагает, человек делает), затем автономность на малой доле трафика, и только потом расширение.
- Аварийный выключатель: способ мгновенно остановить агента.
Технические:
- Лимиты на число шагов, токены, деньги и время на задачу.
- Трейсинг: логирование каждого шага — что модель «подумала», какой инструмент вызвала, с какими параметрами и что получила. Без этого разбор ошибок невозможен.
- Evals: набор тестовых сценариев, который прогоняется при каждом изменении промпта, модели или инструментов. Включает «злые» кейсы: инъекции, некорректные данные, попытки выйти за рамки.
- Мониторинг в продакшене: доля успешных задач, эскалации, стоимость, аномалии.
- Ред-тиминг: намеренные попытки сломать агента до запуска.
Ориентиры: OWASP Top 10 for LLM Applications и материалы OWASP по безопасности агентных систем, NIST AI Risk Management Framework, требования EU AI Act для систем высокого риска.
Главный принцип: проектировать систему так, будто модель иногда ошибается или её обманывают, потому что так и будет. Безопасность обеспечивает архитектура вокруг модели, а не обещание, что модель «не сделает глупость».
На чём и как собрать своего агента
Какой бы путь вы ни выбрали, начало одно и то же.
Выберите узкую задачу с измеримым результатом. Плохо: «агент для отдела продаж». Хорошо: «агент, который по входящей заявке находит компанию в CRM и открытых источниках, заполняет карточку и оценивает соответствие профилю клиента по 5 критериям». Нужны чёткий вход и выход, критерий успеха, достаточный объём повторений и умеренная цена ошибки.
Сначала пройдите задачу вручную вместе с моделью. В обычном чате сами выступите в роли «инструментов»: копируйте данные, выполняйте запросы. Вы увидите, какая информация нужна, где модель ошибается и какие шаги повторяются. Это дешёвый способ понять, нужен ли вообще агент или хватит воркфлоу.
Какой путь выбрать
| Ситуация | Что взять | Путь |
|---|---|---|
| Агент — один шаг в процессе: заявки, письма, документы | Конструктор воркфлоу с узлом агента | 1 |
| Нужен собеседник с доступом к вашим данным | Ассистент с подключёнными сервисами | 2 |
| Подключить ассистента к своим системам | MCP-сервер | 2 |
| Продакшен-агент с понятной логикой | API модели или SDK вендора | 3 |
| Сложный процесс с ветками, состоянием и одобрениями | LangGraph или аналог | 3 |
Начинайте с самого простого пути, на котором задача решается. Для типовых задач — программирования, поддержки, исследований — есть и готовые агенты-продукты: их не собирают, а покупают как сервис.
Путь 1. Без кода: агент внутри воркфлоу
Подходит, когда агент — один шаг рабочего процесса: пришла заявка, её нужно разобрать и либо ответить, либо передать человеку. Воркфлоу задаёт рамку — откуда приходит задача и куда уходит результат. Внутри стоит узел с моделью и инструментами, который сам решает, чем пользоваться и сколько шагов сделать.
Такие сценарии собирают в визуальных конструкторах:
- n8n — открытый конструктор автоматизаций, можно развернуть на своём сервере;
- Make и Zapier — облачные сервисы с тысячами готовых интеграций;
- Microsoft Copilot Studio — для компаний, которые живут в Microsoft 365;
- Dify, Flowise, Langflow — открытые конструкторы именно под LLM-приложения;
- Воркфлоу GPTunneL — холст с блоками моделей, поиска и памяти, где под каждый шаг можно взять любую модель каталога, а сценарий собрать словами через встроенного ассистента.
Названия узлов у всех разные, но схема одна.
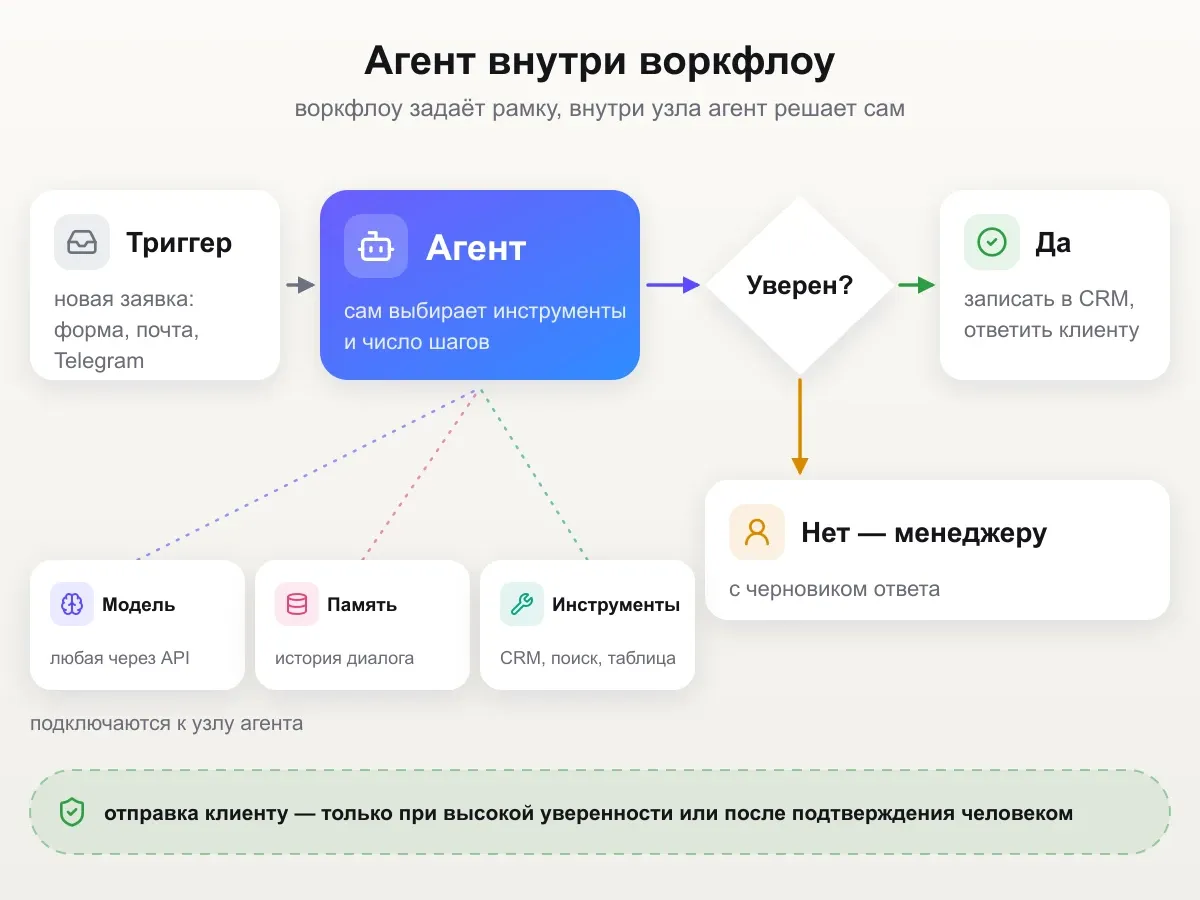
Возьмём задачу из начала раздела: входящая заявка с сайта.
- Триггер. С чего начинается сценарий: форма, вебхук, новое письмо или сообщение в Telegram.
- Узел агента. К нему подключаются три вещи: модель, память и инструменты. Инструменты — это запрос в вашу CRM по API, поиск, таблица или другой сценарий.
- Инструкция в узле агента. Роль, критерии оценки заявки и формат ответа. Удобно просить ответ в JSON с полем «уверенность»: по нему дальше ветвится сценарий.
- Обычные узлы после агента. Проверка уверенности, запись в CRM, ответ клиенту, сообщение менеджеру. Всё необратимое — например, письмо клиенту — только при высокой уверенности или после подтверждения человеком.
- Прогон на реальных заявках. Запустите сценарий на 10–20 настоящих заявках и откройте журнал запусков: там видно, какие инструменты агент вызывал на каждом шаге и где ошибся.
Модель для узла не обязательно брать у одного вендора. В Воркфлоу GPTunneL модели каталога доступны сразу. В сторонних конструкторах, которые позволяют указать свой адрес OpenAI-совместимого API, подойдёт API GPTunneL: базовый адрес https://gptunnel.ru/v1 и ваш ключ (документация API). Так проще сравнить на своей задаче дешёвую модель с дорогой: в нашем тесте Haiku прошёл тот же путь в двадцать с лишним раз дешевле Sonnet.
Если агент в процессе не нужен и шаги известны заранее, уберите узел агента и оставьте обычный воркфлоу: он дешевле и предсказуемее.
Путь 2. Ассистент и свои системы через MCP
Подходит, когда агент нужен как собеседник с доступом к вашим данным: CRM, базе знаний, таск-трекеру. Готовые ассистенты с подключениями есть у Claude (проекты, коннекторы, навыки), ChatGPT (GPTs и агентный режим), Gemini и Microsoft Copilot. В GPTunneL так же: инструкция обычными словами, любая модель каталога и подключение сервисов галочками. Так мы собирали своего тестового агента — минут за десять.
Подключаются сервисы чаще всего через MCP (Model Context Protocol) — открытый стандарт, который Anthropic представила в ноябре 2024 года, а потом поддержали OpenAI, Google и Microsoft. Его сравнивают с «USB-C для ИИ»: сервис один раз описывает свои возможности в MCP-сервере, и его можно подключить к любому ассистенту или агенту, который понимает протокол. Для GitHub, Google Drive, баз данных и сотен других сервисов серверы уже есть, для внутренних систем сервер пишет разработчик. Помните только, что MCP-сервер — это код с доступом к вашим данным: сторонние серверы проверяйте так же, как любую программу, которой даёте доступ (подробнее — в разделе «Риски и контроль»).
- Опишите роль и формат результата. Наша инструкция уместилась в десять строк: кто ты, что делаешь, какие пункты обязательны в ответе и отдельно — перечисли использованные инструменты.
- Выберите модель с поддержкой вызова инструментов. Дорогая не значит лучшая: в нашем тесте бюджетная Haiku 5.5 проходила полный цикл стабильнее флагманской Sonnet 5.5. Смотрите рейтинг под свой тип задач: в Agent Arena модель, лучшая в коде, может опуститься на двадцать с лишним мест в обычных разговорных задачах, и наоборот. А если агент получит доступ к файлам или данным, учитывайте и надёжность: модели — даже одного вендора — по-разному склонны удалять лишнее без спроса (подробнее — в разделе «Риски и контроль»).
- Подключите MCP-серверы — только те, что нужны задаче. Как это сделать, разобрано в нашем гайде по MCP.
- Проверьте, что инструменты видны. Спросите в чате: «перечисли все доступные тебе инструменты». Пусто или модель фантазирует — дальше идти бессмысленно.
- Дайте задачу и прочитайте лог, а не только ответ: сколько шагов, какие инструменты, были ли ошибки.
Правила для инструментов одинаковы во всех трёх путях, кто бы их ни писал:
- Меньше, но лучше: 5 хорошо описанных инструментов лучше 30 похожих.
- Понятные описания: когда использовать инструмент и когда нет.
- Компактные результаты: возвращайте модели только нужное, не всю выгрузку. В нашем тесте именно объём ответа инструмента сделал прогон в тридцать раз дороже.
- Понятные ошибки: «клиент не найден, проверьте ID» вместо стектрейса. Модель умеет исправляться по хорошим сообщениям об ошибках.
Путь 3. Кодом: свой цикл через API
Подходит разработчикам, когда нужен полный контроль над шагами, логами и лимитами. Агент в коде — это тот самый цикл из раздела «Как устроен ИИ-агент»: API модели с вызовом инструментов (tool use, function calling) и 50–100 строк на Python или TypeScript вокруг него. Модель не обязательно брать у одного вендора: API GPTunneL совместим с OpenAI, и через него доступна любая модель каталога (документация API).
Если вы только начинаете и тонете в названиях, вот порядок, который советуют практики на Reddit:
- Модель и инструменты: как модель вызывает функцию и возвращает структурированный ответ.
- Состояние: что агент должен помнить между шагами.
- Цикл без фреймворка: цель → следующее действие → вызов инструмента → результат → продолжить или остановиться. Соберите его один раз сами.
- Харнесс вокруг цикла: повторные попытки, тайм-ауты, бюджет, права, одобрение человека, логи.
- Проверка: проверяйте сам результат во внешней системе, а не слова агента «всё сработало».
RAG, MCP и мультиагентность подключают, только когда задача этого требует. Фреймворки быстро меняются, а эти примитивы — нет. Ещё один совет оттуда же: изучать агентов можно с помощью самого агента. Скачайте открытый харнесс, например Codex, и попросите агента объяснить, как он устроен и как его запустить.
Когда цикл понятен, можно взять готовый каркас, чтобы не писать его с нуля:
- SDK разработчиков моделей: Claude Agent SDK (тот же движок, что внутри Claude Code), OpenAI Agents SDK, Google ADK.
- Независимые фреймворки: LangGraph — для процессов с ветвлениями и подтверждениями человеком, LlamaIndex — для работы с документами, CrewAI — для команд агентов с ролями, Microsoft Agent Framework — для экосистемы Microsoft и .NET, Pydantic AI — для Python, Mastra и Vercel AI SDK — для TypeScript.
- Вокруг агента: трейсинг и оценка качества (LangSmith, Langfuse), песочницы для выполнения кода (E2B, Modal, Docker).
Не берите тяжёлый фреймворк «на вырост»: многие команды начинают с него, а потом переписывают на прямой API, когда не хватает прозрачности. Пошаговая сборка агента с кодом — в отдельной статье как создать ИИ-агента.
После запуска — для всех трёх путей
Проверяйте результат после каждого шага, а не только в конце. Один разработчик рассказал на Reddit про агента, который исследует компанию и пишет отчёт: первая версия вместо названий конкурентов выдавала «региональный банк». Ни смена модели, ни смена фреймворка этого бы не исправили. Помогла проверка после каждого шага: если ответ общий, агент получает конкретную ошибку — «назовите реальные компании, „региональный банк“ не подходит» — и пробует снова. А набор тестовых компаний команда прогоняет после каждого изменения.
Соберите набор тестов (evals) до того, как улучшать. 20–50 реальных примеров: типичные случаи, крайние случаи, некорректные данные, попытки инъекций. Для каждого опишите, что считается правильным результатом. Без такого набора любое изменение промпта — гадание: починили одно и незаметно сломали другое.
Расширяйте автономность постепенно. Сначала режим тени: агент работает параллельно с людьми, его результаты сравниваются, но не применяются. Потом режим ассистента: агент готовит, человек проверяет и отправляет. И только потом частичная автономность: простые случаи агент закрывает сам, сложные передаёт человеку.
Разбирайте неудачи. Типичные причины плохой работы в порядке убывания частоты: нечёткие инструкции, плохо описанные инструменты, лишнее в контексте, нехватка данных или доступа, и только потом — недостаточно сильная модель. По логам неудачных прогонов почти всегда видно, на каком шаге и почему агент свернул не туда.
Чек-лист перед запуском
- Узкая задача с измеримым критерием успеха
- Проверено, что не хватит скрипта или простого воркфлоу
- Инструменты с понятными описаниями и компактными ответами
- Системный промпт с правилами, границами и условиями эскалации
- Цикл с лимитом шагов
- Набор evals из реальных случаев
- Логи, лимиты бюджета, минимальные права, подтверждение опасных действий
- Пилот в режиме тени, затем постепенное расширение автономности
- Регулярный разбор неудач и повторный прогон evals при каждом изменении
Частые вопросы
Чем ИИ-агент отличается от ИИ-ассистента? Ассистент отвечает по своей инструкции, когда вы к нему обращаетесь, и обычно за один проход. Агент сам решает, сколько раз и куда сходить, прежде чем ответить. Ассистент с подключёнными инструментами становится агентом, как только начинает делать несколько шагов подряд.
ChatGPT, Claude, DeepSeek — это агенты или чат-боты? Окно чата — только интерфейс, а граница проходит там, где модель сама решает, что делать дальше. Когда ChatGPT или Claude на обычный вопрос сами идут в интернет, делают несколько запросов, сверяют найденное и только потом отвечают, — это уже агентное поведение, просто с небольшим набором инструментов и только на чтение. Режимы глубокого исследования и агентный режим ChatGPT, Claude с подключёнными сервисами — следующая ступень: десятки шагов, больше инструментов, а иногда и действия от вашего имени. Чат-ботом модель остаётся, пока отвечает из того, что знает. «Думающий» режим вроде DeepThink у DeepSeek агента тоже не делает: модель дольше рассуждает, но во внешний мир не выходит.
Можно ли сделать ИИ-агента бесплатно? Работа агента оплачивается всегда: каждый шаг — это запрос к модели, который тарифицируется по токенам. Наши прогоны стоили от 3 до 95 ₽ за штуку, а весь тест из одиннадцати прогонов — около 140 ₽. Сэкономить помогают дешёвая модель и инструменты, которые возвращают только нужное.
С чего начать разбираться в агентах, если путаешься в LangChain, MCP, RAG и прочем? Путаница от того, что эти слова — разные уровни, а в обучающих материалах их подают как конкурентов. Ядро одно — цикл «модель → инструмент → результат → снова модель». MCP — способ подключить инструменты, RAG и память — способ дать агенту знания, оркестрация и мультиагентные системы — способ связать нескольких агентов, а LangGraph, CrewAI и другие фреймворки — готовые реализации всего этого. Разработчик, который год делает агентов для продакшена, советует на Reddit так: сначала один раз соберите цикл сами на одной небольшой задаче с одним инструментом — тогда фреймворки станут понятными или окажутся ненужными.
Как создать агента в ChatGPT? В ChatGPT для этого есть агентный режим, а своего ассистента с инструкцией и файлами собирают через GPTs. Логика та же, что в разделе «На чём и как собрать своего агента»: роль, инструменты, проверка на реальной задаче. Если нужна не только модель OpenAI, такой же ассистент собирается в GPTunneL на любой модели каталога.
Какие ИИ-агенты есть для программирования? Самые зрелые — Claude Code, OpenAI Codex, Cursor, GitHub Copilot agent и Devin. Они читают кодовую базу, правят код, запускают тесты и готовят pull request, а финальное ревью остаётся за человеком. Программирование — область, где агенты работают лучше всего: у кода есть объективная проверка.
Сколько шагов делает агент? Сколько решит сам. В наших прогонах — от одного до четырёх вызовов инструментов на задачу. Лимит шагов стоит ставить всегда: это единственная защита от бесконечного цикла за ваши деньги.
Какая модель лучше для агента? Та, что поддерживает вызов инструментов и не срезает путь. По нашему тесту разница между моделями проявилась не в качестве текста, а в готовности пройти весь путь до ответа, и бюджетная модель справлялась с этим не хуже флагманской. Смотрите не только на цену и качество, но и на надёжность: в рейтинге надёжности агентов Arena (октябрь 2026) первые пять мест заняли модели OpenAI, следом идут Claude Opus 5.5 и Grok 4.7, а новые поколения у всех вендоров надёжнее старых.
Попробовать самому
Соберите агента в GPTunneL: создайте ассистента, напишите инструкцию обычными словами, выберите любую модель каталога и подключите MCP-серверы галочками. Без VPN и подписки, оплата в рублях с общего баланса за фактические токены — весь наш тест из одиннадцати прогонов обошёлся примерно в 140 ₽, а цены всех моделей видны заранее.
Начните с задачи, у которой есть проверяемый результат. Так вы сразу увидите, работает агент или просто убедительно рассказывает.
Источники
- Arena — Alignment Index: как ИИ-агенты выходят из-под контроля, 90 000 реальных сессий на 27 моделях, октябрь 2026.
- Arena — HarnessTax: как харнесс влияет на стоимость и успешность агентов-программистов, 21 пара «модель + харнесс», сентябрь 2026.
- Arena — категории задач и цена задачи в Agent Arena: что поручают агентам, по 1,7 млн сессий, август 2026.
- Anthropic — Project Vend: эксперимент, в котором Claude месяц управлял офисным магазином.
- Invariant Labs — уязвимость в MCP-сервере GitHub: как задача в публичном репозитории заставила агента выложить приватные данные, май 2025.
- Yahoo Finance — компания потратила $500 млн на Claude за месяц: пересказ сообщения Axios, май 2026.
- Обсуждения на Reddit: $6 000 на Claude за ночь, ночная пакетная задача на $2 500, с чего начать изучение ИИ-агентов.