
Пару недель назад я поймал себя на мысли, что Opus 5.5 в режиме High начал периодически тупить в простых задачах, выдавая типичные бесячие "Извини/ Это моя ошибка" и тому подобное 😄 Естественно, мой субъективный опыт ничего не доказывает, поэтому я решил немного покопаться, замечает ли кто-то еще подобные "эффекты".
Выяснилось, что в сообществе Claude Code действительно разгорается спор: действительно ли Anthropic незаметно ухудшает работу нейросетей после выпуска или разработчики принимают изменения в агентной системе за снижение интеллекта модели? Поводом для новой волны обсуждений стало расследование на Reddit: пользователи обнаружили в локальных журналах Claude Code идентификаторы серверных конфигураций и попытались связать их с изменениями поведения модели.
История сложнее привычных жалоб на то, что нейросеть «стала глупее». Энтузиасты собирали статистику ответов, изучали расход токенов и сравнивали работу с экспериментальным параметром и без него. Независимый проект LiveNerf не зафиксировал значимой регрессии Opus 5.5, однако его собственная проверка показала низкую чувствительность: тест не смог достоверно отличить Opus 5 от Opus 5.5. Одновременно Anthropic усиливает защиту моделей от дистилляции и контроль доступа, а финансовые документы раскрывают цену вычислений перед IPO. Что из этого связано, что удалось доказать и как проверить собственный аккаунт?
От подозрений к экспериментальным ID: что обнаружили на Reddit
В начале ноября пользователь Reddit DerAlbi опубликовал в r/ClaudeCode пост «The nerf is real». Он обратил внимание на то, что локальные файлы Claude Code содержат следы экспериментальных идентификаторов, которые можно сопоставить с историей сессий.
Расследование опиралось на публикацию WuM1ha1nho. Исследователь изучил журналы клиента и повторил 20 сохранённых запросов с экспериментальным параметром и без него. Содержание запросов было одинаковым.
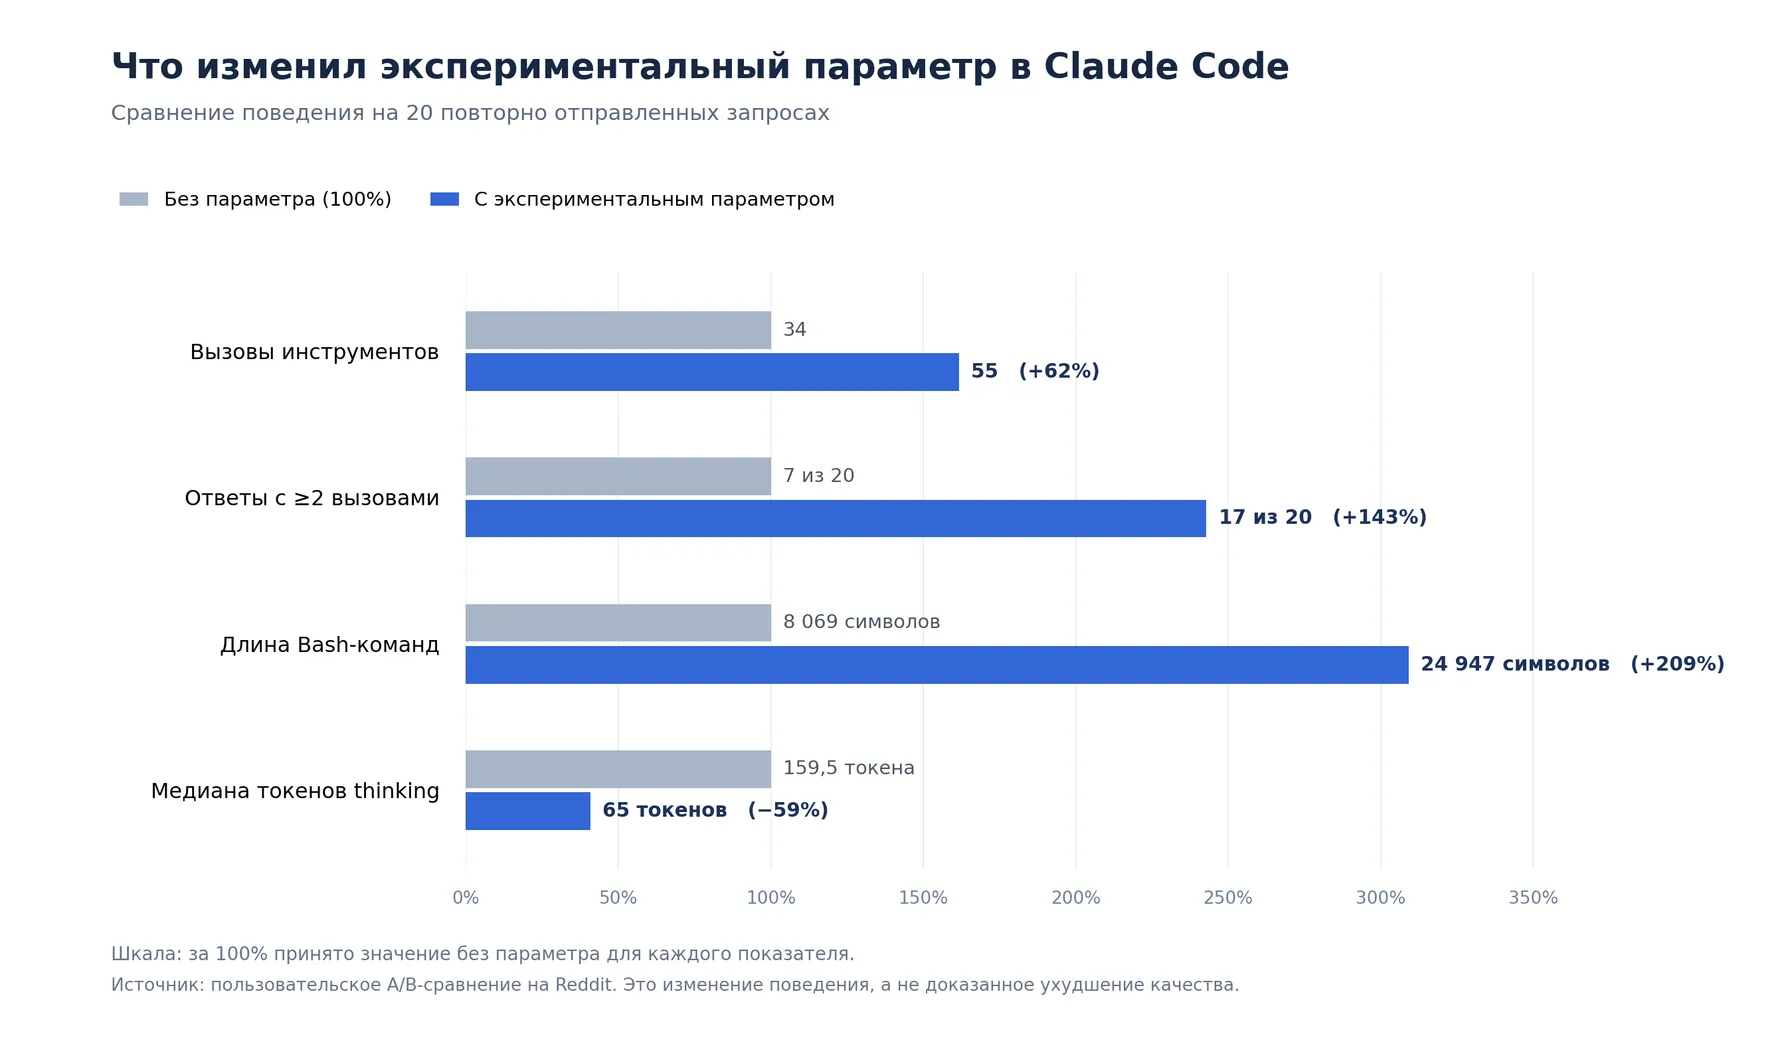
| Показатель | Без экспериментального параметра | С параметром |
|---|---|---|
| Сгенерированные вызовы инструментов | 34 | 55 |
| Ответы с двумя и более вызовами инструментов | 7 из 20 | 17 из 20 |
| Общая длина Bash-команд | 8 069 символов | 24 947 символов |
| Медианное количество токенов рассуждения | 159,5 | 65 |
В экспериментальном режиме Claude чаще объединял операции, генерировал длинные команды и меньше рассуждал перед их выполнением. Это наблюдаемое изменение поведения. Но тест не проверял, насколько правильно решены задачи. Более длинная команда может быть как эффективнее, так и ошибочнее. Кроме того, передача экспериментального параметра не гарантирует полного воспроизведения серверной A/B-группы.
Поэтому находка не доказывает намеренное ухудшение модели, но показывает: одинаковое название модели не обязательно означает одинаковое поведение всей системы Claude Code.
Жалобы на рост расхода токенов
В конце октября разработчики начали жаловаться, что лимиты Claude Code стали расходоваться быстрее. Один из авторов на r/ClaudeAI сообщил о росте скорости расходования недельного лимита примерно в 3,8 раза. Он связывал это с дополнительным делегированием задач субагентам, повторным чтением файлов и лишними шагами при выполнении привычной работы.
Позднее в обсуждении «Usage Explosion» пользователи рассказывали о резком расходе пятчасовых лимитов. Но встречались и противоположные отзывы: часть разработчиков не замечала ухудшения или связывала увеличение расходов с более сложными проектами.
Важно не смешивать разные показатели. Быстрый расход лимита, увеличение числа токенов и неправильные ответы - не одно и то же. Для проверки причин нужны раздельные измерения.
Числа вместо впечатлений: анализ 6 638 ответов
В GitHub-обращении #105112 автор проанализировал 6 638 ответов Opus 5.5 из собственных рабочих сессий. В качестве косвенной метрики он использовал долю ответов, которые пришлось исправлять пользователю или которые модель позднее сама признавала ошибочными.
| Период | Ответов | Доля исправленных |
|---|---|---|
| До 19 октября | 5 738 | 5,2% |
| С 19 октября | 900 | 25,4% |
Разница почти пятикратная. Даже при более строгом сравнении первых ответов на новые вопросы доля исправлений, по оценке автора, выросла с 5,2% до 15,4%.
При этом речь идёт об одном рабочем процессе и неслепой оценке качества по истории переписки. Такие данные заслуживают проверки, но не доказывают масштабную регрессию для всех пользователей Claude.
Изменения текста thinking - не обязательно изменение модели
Другая линия расследования связана с текстом рассуждений, который отображает Claude Code. В начале ноября пользователи заметили изменение его стиля при неизменном названии Opus 5.5. Анализ больших выборок показал, что такие изменения появлялись на разных аккаунтах в разные дни.
Однако официальная документация Anthropic объясняет, что показываемый пользователю thinking может быть кратким изложением исходного процесса рассуждения. Поэтому изменение формулировок само по себе не доказывает изменение весов Opus 5.5: обновиться мог механизм отображения.
LiveNerf: тест, который не смог отличить Opus 5 от Opus 5.5
Проект LiveNerf ежедневно проверяет Opus 5.5 через Claude Code на фиксированном наборе задач. По данным, опубликованным к 8 ноября 2026 года, статистически значимого ухудшения точности за период наблюдений авторы не обнаружили. Однако это нельзя считать убедительным опровержением жалоб на ухудшение Claude Code: чувствительность методики ограничена, причём сами авторы измерили это ограничение.
Во время проверки инструмента исследователи заменили Opus 5.5 на предыдущую Opus 5 и повторили тест при одинаковом уровне усилий (effort high). Разница в точности составила −3,8 процентного пункта, при стандартной ошибке 6,3 пункта. Статистически достоверно различить две модели в этой проверке не удалось. Авторы прямо отмечают, что инструмент не способен уверенно обнаруживать замену модели внутри одного семейства с таким размером эффекта.
Проверка относительно Opus 5.5 с effort high | Изменение точности | Стандартная ошибка |
|---|---|---|
Opus 5 с effort high | −3,8 п. п. | 6,3 п. п. |
Opus 5.5 с effort medium | −4,2 п. п. | 3,9 п. п. |
Opus 5.5 с effort low | −8,3 п. п. | 4,5 п. п. |
Согласно расчётам авторов, минимальный обнаруживаемый эффект для десятидневного окна составляет около 7,5 процентного пункта при заданных критериях статистической мощности и значимости. Поэтому меньшая регрессия может остаться незамеченной. При этом тест заметно лучше распознаёт изменения расхода выходных токенов: переход с effort high на medium и low уменьшал их количество соответственно на 26% и 62%. Но уменьшение числа токенов само по себе не равнозначно ухудшению качества.
Есть и более фундаментальное ограничение. Основной набор LiveNerf включает 78 отобранных академических вопросов из MMLU-Pro, GPQA, математических соревнований и AIME. Проверка запускается с закреплённой версией Claude Code, в пустой рабочей папке без инструментов, MCP-серверов и агентных сценариев. Она не оценивает исправление кода в реальном репозитории, длинные сессии, управление контекстом и работу субагентов - то есть как раз те сценарии, на которые жалуются разработчики.
Корректный вывод: LiveNerf не выявил крупного падения точности на своём узком наборе задач в пределах чувствительности теста. Он не доказал отсутствия регрессии в Claude Code и не смог надёжно отличить даже Opus 5 от Opus 5.5 в контрольной проверке. Отсутствие обнаруженного ухудшения - не доказательство того, что ухудшения не было.
Anthropic уже признавала регрессии Claude Code
В разборе инцидентов от 23 апреля 2026 года Anthropic признала несколько проблем, ухудшавших работу Claude Code: изменение стандартной глубины рассуждений, ошибки в управлении историей thinking и неудачную правку системной инструкции. Компания описала исправления и предоставила пользователям сброс лимитов.
Это не доказательство ноябрьского «нерфа», но убедительный пример того, как обновление системного слоя способно влиять на результат без изменения базовых весов модели.
Почему Anthropic может менять Claude Code: нагрузка, вычисления и предстоящее IPO
У подозрений пользователей есть экономический фон. 26 октября 2026 года Anthropic подала регистрационное заявление для IPO, а 2 ноября обновила его. В отчётности для SEC компания прямо называет эффективность вычислений одним из основных факторов бизнеса.
Выручка за III квартал 2026 года составила около $16,96 млрд, увеличившись на 47% к предыдущему кварталу. При этом операционный результат сменился с прибыли $974 млн во II квартале на убыток $567 млн в III квартале. Anthropic отдельно пояснила, что в течение квартала привлекла дополнительные вычислительные ресурсы на $5 млрд по краткосрочным обязательствам: они обходятся значительно дороже сопоставимых долгосрочных контрактов. Reuters также отмечает давление инфраструктурных обязательств и риск для оценки компании перед размещением.
Эти данные объясняют, почему компания заинтересована в снижении стоимости каждого запроса. Один из потенциальных способов - совершенствовать маршрутизацию, кеширование, управление контекстом и агентные алгоритмы, а также тестировать разные уровни усилий при рассуждении. Однако из финансовой мотивации не следует, что Anthropic сознательно ухудшает ответы. У компании есть и противоположный стимул: сохранить качество продукта, от которого зависят удержание клиентов и будущая выручка.
Нехватка мощностей тоже может быть частью картины, но её обычные проявления - задержки, лимиты и ошибки доступности. Для объяснения именно снижения качества пришлось бы показать дополнительный механизм: например, что при нагрузке сервер изменяет параметры рассуждения или поведение агента. Публичного подтверждения такого механизма применительно к октябрьским экспериментальным ID пока нет.
Волна блокировок Claude: отдельная проблема или часть тех же изменений?
Одновременно с жалобами на качество Claude Code пользователи стали чаще обсуждать проверки личности и блокировки аккаунтов. По данным Anthropic Transparency Hub, за январь-июнь 2026 года компания заблокировала 11,4 млн аккаунтов. За тот же период было подано 398 тыс. апелляций, из которых 42 тыс. завершились отменой решения. Это официальная статистика за первое полугодие, не оценка масштаба именно октябрьской волны.
29 октября The Insider описал жалобы пользователей с российскими паспортами на блокировки после верификации через Persona - в том числе случай человека, который, по его словам, жил в Новой Зеландии и пользовался платной подпиской. При этом основания конкретных решений не были раскрыты. В тот же день РБК привёл мнение экспертов: новая волна проверок затрагивала пользователей разных стран, а доказательств целенаправленной массовой блокировки именно россиян не было. Сама Anthropic указывает, что идентификация может потребоваться для соблюдения правил использования и предотвращения злоупотреблений.
Зачем Anthropic ужесточает контроль: борьба с незаконной дистилляцией
Здесь есть более прямая связь с техническими изменениями Claude. В сентябрьском отчёте об угрозах Anthropic описала кампании по незаконной дистилляции: сторонние организации массово получают ответы Claude через сети подставных аккаунтов и посредников, чтобы использовать их для обучения собственных моделей. Компания заявила, что выявляет такие сети по сигналам аномальной активности, блокирует связанные аккаунты и при необходимости требует подтверждения личности.
Anthropic также раскрыла меры защиты интеллектуальных возможностей модели. Видимый пользователю текст thinking может быть кратким изложением внутренних рассуждений, что затрудняет их извлечение для обучения конкурирующих систем. В публикации от 12 октября компания сообщила, что новые антидистилляционные методы, по её предварительной оценке, сократили объём извлекаемых злоумышленниками данных примерно на 90-99%. Anthropic признала, что такие меры имеют побочные эффекты и иногда требуют от добросовестных клиентов обновлять интеграции.
Эта информация помогает интерпретировать ноябрьские наблюдения об изменении отображаемого thinking. Защита рассуждений - не просто догадка пользователей, а официально описанная политика Anthropic. Но нет подтверждения, что конкретные изменения стиля Opus 5.5 в начале ноября или экспериментальные ID atis вызваны именно этой защитой.
Можно ли объединить блокировки, A/B-тесты и IPO в одну историю?
Три процесса действительно происходят в одном временном контексте, но решают потенциально разные задачи:
| Направление | Что подтверждено | Что остаётся гипотезой |
|---|---|---|
| Экономия вычислений | Высокая стоимость краткосрочных мощностей и стремление улучшать вычислительную эффективность отражены в SEC | Уменьшала ли Anthropic глубину рассуждений конкретным группам ради IPO |
| Защита от дистилляции | Компания подтвердила борьбу с сетями подставных аккаунтов и защиту рассуждений | Связаны ли с ней найденные пользователями ID atis |
| Блокировки и проверки | Есть официальная статистика и сообщения о новой волне в октябре | Было ли её целью прежде всего разгрузить серверы |
| Изменения качества Claude Code | Пользователи зафиксировали отличия в поведении и рост исправлений в отдельных выборках | Имеют ли эти изменения одну общую причину |
Наиболее осторожное объяснение: Anthropic одновременно оптимизирует экономику вычислений, развивает агентный продукт и усиливает защиту от несанкционированного доступа. Эти изменения способны затрагивать пользовательский опыт, но причинно-следственная связь между волной банов, экспериментами atis и предполагаемым «нерфом» не доказана.
Для разработчиков это всё равно важная история. Когда под прежним названием модели меняются управление инструментами, видимые рассуждения и правила доступа, пользователю трудно понять, связано ли ухудшение с самой моделью, серверным экспериментом или политикой безопасности. Поэтому главный запрос сообщества - не только «вернуть качество», но и сделать изменения более прозрачными.
Как самому узнать, какие эксперименты были у вашего Claude Code
Главное практическое открытие Reddit-расследования - возможность искать следы конфигураций в локальных журналах. В домашнем каталоге Claude Code хранится файл .claude.json, а историю сессий обычно можно найти в ~/.claude/projects/ (знак ~ означает домашнюю папку пользователя).
В файлах сессий .jsonl нужно искать записи с типом atis-latch и полем atis. Упрощённый пример:
{"type":"atis-latch","atis":"abc...","sessionId":"..."}atis - непрозрачный идентификатор. Для сопоставления пользователи обычно используют первые три символа, но префикс не является официальным названием эксперимента. Пустое значение atis также не доказывает отсутствия серверных экспериментов.
PowerShell: получить ID и число сессий
На Windows можно запустить следующий скрипт в PowerShell. Он автоматически ищет журналы в домашнем каталоге, не требует вручную вписывать имя пользователя или путь к проекту и не отправляет данные в интернет.
$root = Join-Path (Join-Path $HOME '.claude') 'projects'
$groups = @{}

Get-ChildItem -LiteralPath $root -Directory | ForEach-Object {
    Get-ChildItem -LiteralPath $_.FullName -Filter '*.jsonl' -File | ForEach-Object {
        $session = $_.FullName
        foreach ($line in [System.IO.File]::ReadLines($session)) {
            if ($line -notlike '*"atis-latch"*') { continue }
            try { $entry = $line | ConvertFrom-Json -ErrorAction Stop }
            catch { continue }
            if ($entry.type -ne 'atis-latch') { continue }

            $raw = $entry.atis
            if ($raw -is [string] -and -not [string]::IsNullOrWhiteSpace($raw)) {
                $id = $raw.Substring(0, [Math]::Min(3, $raw.Length))
            } elseif ($null -eq $raw -or [string]::IsNullOrWhiteSpace([string]$raw)) {
                $id = 'none'
            } else {
                $id = 'other-format'
            }
            if (-not $groups.ContainsKey($id)) { $groups[$id] = @{} }
            $groups[$id][$session] = $true
        }
    }
}

$groups.GetEnumerator() | ForEach-Object {
    [PSCustomObject]@{ ID = $_.Key; Sessions = $_.Value.Count }
} | Sort-Object Sessions -Descending | Format-Table -AutoSize
Скрипт считает уникальные основные сессии, а не число повторений atis-latch: один ID может встречаться десятки раз в пределах одного разговора. Журналы субагентов не включены, чтобы не завышать количество сессий.
Если в одной сессии встречались несколько ID, она попадёт в несколько строк, поэтому итог по строкам может превышать число уникальных сессий. Значение none означает пустое или отсутствующее поле atis в записи, а не доказанное отсутствие эксперимента. Если записей atis-latch нет вообще, скрипт не выведет ID для такой сессии.
Чтобы установить даты появления ID, недостаточно просто сгруппировать записи: у atis-latch зачастую нет собственного поля timestamp. Дату можно лишь приблизительно восстановить по соседним сообщениям журнала.
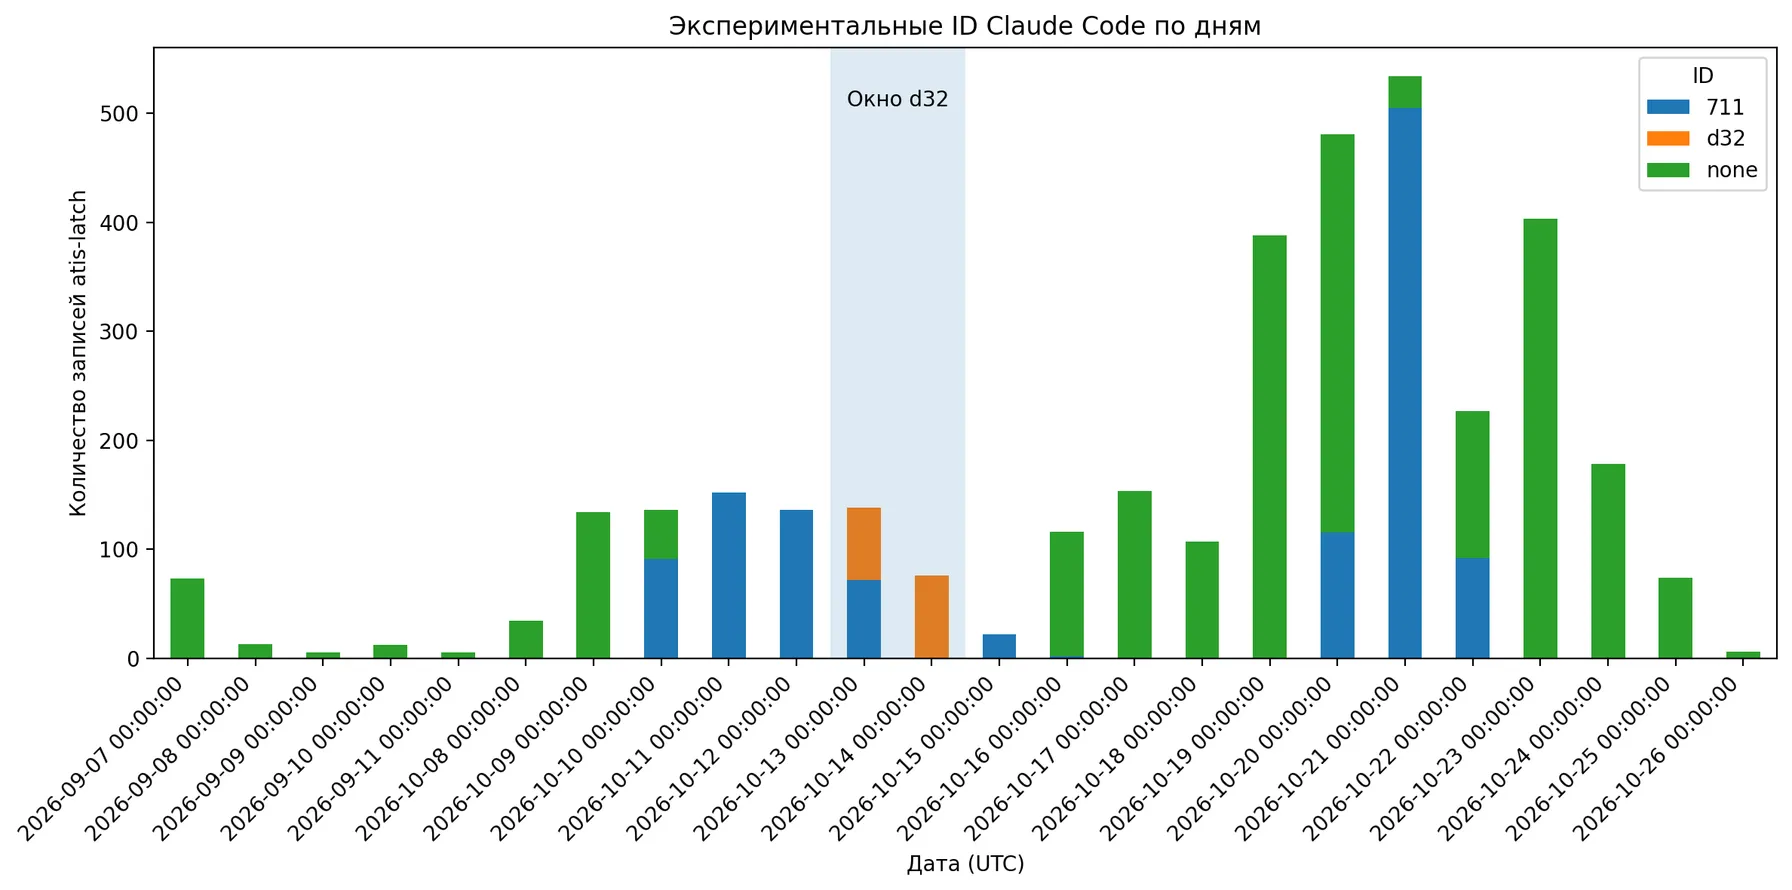
Рис. 1. Хронология экспериментальных идентификаторов Claude Code. Анализ локальных журналов одного пользователя за сентябрь-октябрь 2026 года. Видно кратковременное появление ID d32 12-14 октября на фоне использования 711. Значение none означает отсутствие идентификатора в соответствующих записях. Назначение экспериментов неизвестно.
Почему это ещё не доказательство ухудшения
Даже если в день возникновения ошибок появляется новый ID, корреляции недостаточно. Чтобы проверить влияние конфигурации, необходимо сравнивать одинаковые задачи при одинаковой модели, версии Claude Code и уровне reasoning effort; учитывать количество вызовов инструментов, исправлений и расход токенов. Обнаружение ID подтверждает наличие записи в локальном журнале, но не раскрывает назначения серверного эксперимента.
Безопасность: не публикуйте исходные .jsonl, полный .claude.json, целиком значения atis и идентификаторы сессий. Эти файлы могут содержать приватные запросы, исходный код и другую чувствительную информацию. Приведённый скрипт выводит только первые три символа atis и агрегированные количества.
Вывод: изменения поведения подтверждаются, единая причина - нет
История с экспериментами Claude Code показывает, почему пользователи могут наблюдать ухудшение работы инструмента без очевидной смены базовой модели. Система включает не только Opus или Sonnet, но и управляющие инструкции, распределение задач, управление контекстом, выбор инструментов и способы отображения reasoning.
Наблюдаемые изменения конфигурации реальны, а некоторые жалобы подкреплены количественными данными. Финансовая отчётность подтверждает стимул повышать эффективность вычислений, а отчёты Anthropic - ужесточение защиты от незаконной дистилляции и блокировку подозрительных сетей аккаунтов. Но ни сам факт наличия atis, ни рост числа ошибок в отдельных сессиях, ни совпадение по времени с волной банов не доказывают, что Anthropic специально делает Claude менее способным ради IPO или экономии серверных ресурсов.
Для разработчиков главный вопрос теперь - прозрачность: какие изменения вводятся на сервере, как их диагностировать и можно ли отличить проблему модели от регрессии всего агентного продукта?
Материал подготовлен по состоянию на 9 ноября 2026 года. Пользовательские эксперименты не являются официальным подтверждением назначения экспериментальных идентификаторов.