
22 сентября OpenAI выпустила две модели поколения GPT-6 — Sol и Luna. Главное в релизе не прирост интеллекта, а экономика: обе модели обучены теми же методами, что и флагман GPT-6 Astra, а стоят вдвое дешевле своих предшественниц из GPT-5.6. Релиз вышел примерно через полтора часа после Claude Opus 5.5, так что выбор модели под задачу за один день поменялся дважды.
Если у тебя в продукте или пайплайне стоит GPT-5.6 Sol, вопрос теперь не «переходить ли», а что делать с освободившимся бюджетом: сэкономить или отдать часть шагов более сильной модели.
Что вышло
- GPT-6 Sol — средняя модель поколения, в API
gpt-6-sol. OpenAI позиционирует её под сложную рабочую нагрузку и агентный код с запасом по лимитам и цене. - GPT-6 Luna — самая лёгкая и дешёвая модель семейства, в API
gpt-6-luna. - GPT-6 Astra, вышедшая 3 сентября, остаётся лучшей моделью OpenAI «по всем фронтам» — это формулировка самой компании.
В ChatGPT обе модели раскатывают в течение дня в ChatGPT Work и Codex для Plus, Pro, Business, Enterprise и Edu. Бесплатным пользователям и тарифу Go доступна Luna, но только в десктопном приложении; в обычном чате ChatGPT моделей пока нет. В GitHub Copilot Sol открыли с плана Pro+, Luna — с Pro. В GPTunneL обе модели уже в каталоге и отвечают через API.
Цена
| Модель | Вход, $ за 1M | Выход, $ за 1M | В GPTunneL за 1K, вход / выход |
|---|---|---|---|
| GPT-5.6 Sol | $4 | $20 | 1 ₽ / 6 ₽ |
| GPT-6 Sol | $2 | $10 | 0,5 ₽ / 3 ₽ со скидкой 50%, без неё 1 ₽ / 6 ₽ |
| GPT-5.6 Luna | $0,20 | $1,20 | 0,04 ₽ / 0,24 ₽ |
| GPT-6 Luna | $0,10 | $0,50 | 0,02 ₽ / 0,12 ₽ со скидкой 50%, без неё 0,04 ₽ / 0,24 ₽ |
OpenAI объясняет снижение улучшениями кэширования и инференса. Для агентов важнее даже не прайс, а кэш: у GPT-6 выше доля попаданий по умолчанию, чтение кэша идёт со скидкой 90%, а смена глубины рассуждений или набора инструментов посреди диалога больше не сбрасывает кэш. Появились и явные точки разреза, чтобы самому решать, где заканчивается кэшируемый префикс. Цены в рублях — из каталога GPTunneL на день релиза, актуальные всегда на странице цен.
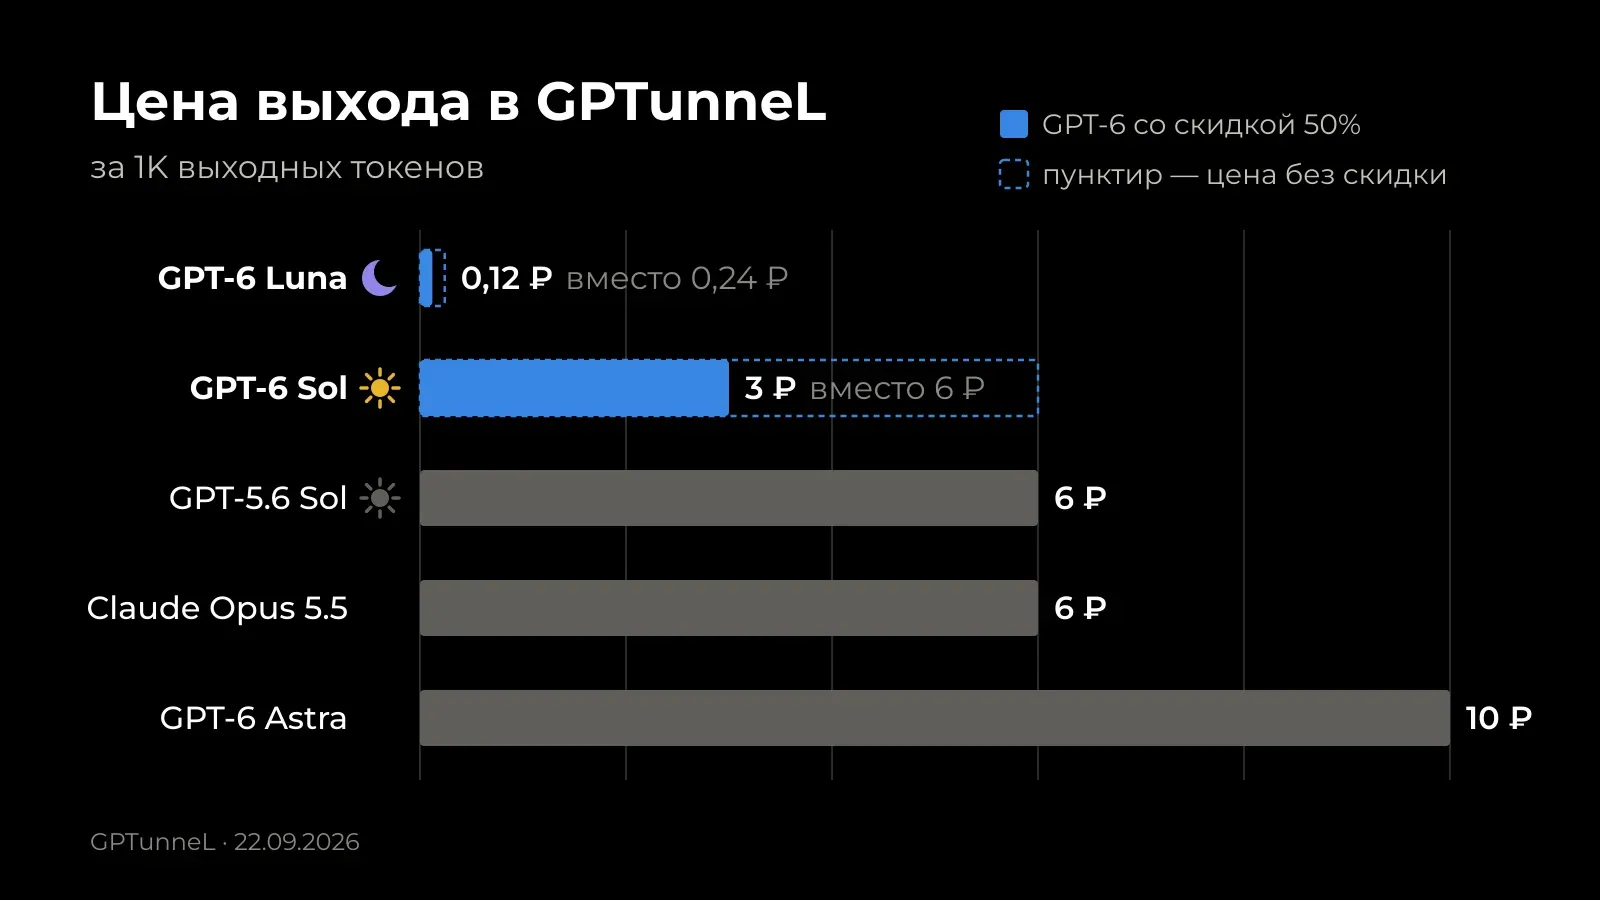
В GPTunneL обе модели сейчас идут со стартовой скидкой 50%. Со скидкой Sol на выходных токенах вдвое дешевле GPT-5.6 Sol и Claude Opus 5.5 и втрое с лишним дешевле Astra, а Luna — вдвое дешевле GPT-5.6 Luna. Пока скидка действует, разница между средней и старшей моделью заметнее обычного, и это меняет расчёт, на какие шаги ставить дорогую модель.
Что по качеству
Всё ниже — цифры из анонса OpenAI, независимых замеров на день релиза нет. Режимы усилия в сравнениях разные: новые модели обычно на xhigh или max, конкуренты часто на medium.
| Бенчмарк | GPT-6 Sol | Для сравнения |
|---|---|---|
| AutomationBench 1.0.6 (бизнес-процессы, 47 инструментов) | 33,2% на xhigh, $0,27 за задачу | Astra на low — 30,3% в 3,9 раза дороже; Claude Opus 5 на max — 26,9% в 11,1 раза дороже |
| Agents' Last Exam | 56,4% на max | выше лучшего результата Claude Opus 5 при стоимости задачи на 60% ниже |
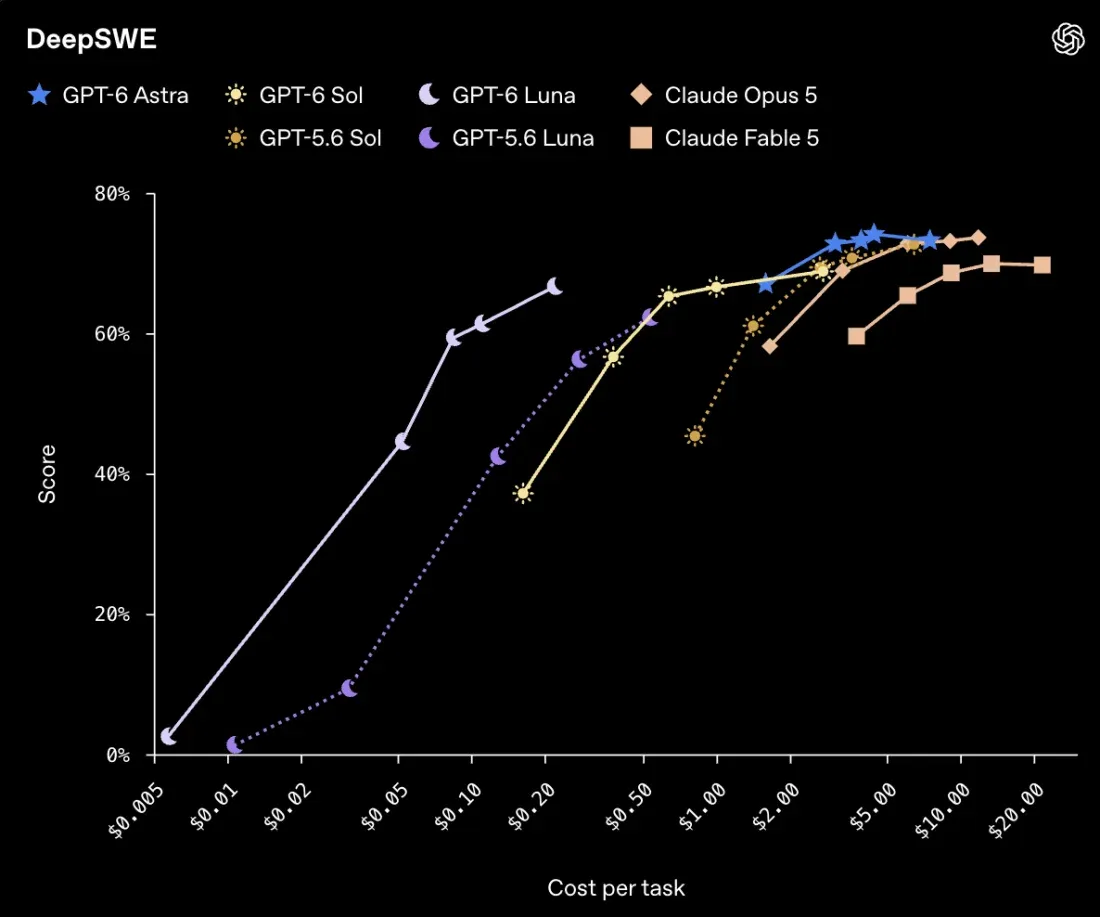
| DeepSWE 1.1 (код в реальных репозиториях) | 68,8% на max | Claude Fable 5 на xhigh — 69,9% при стоимости задачи примерно на 80% выше |
| OSWorld 2.0 (работа с компьютером) | 60,5% на xhigh | Claude Opus 5 на medium — 60,3% при стоимости задачи примерно на 80% выше |
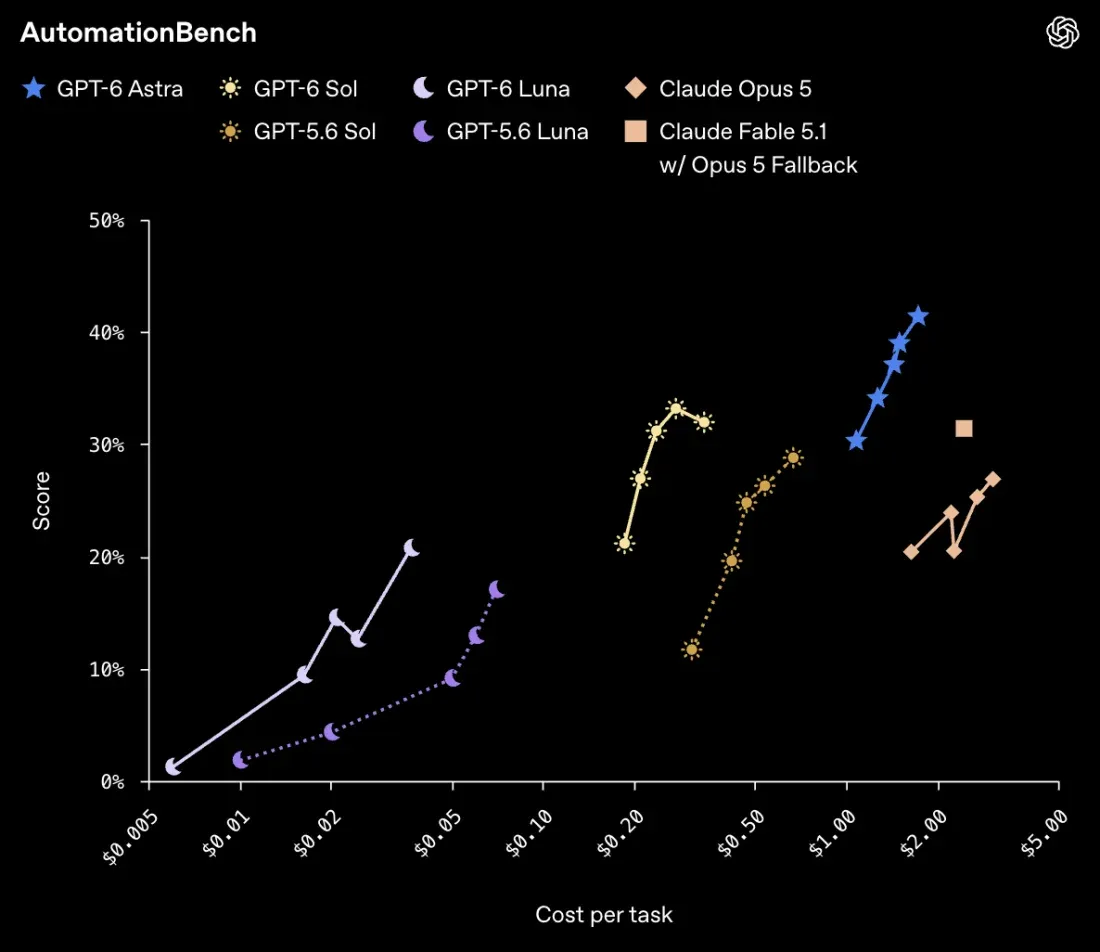
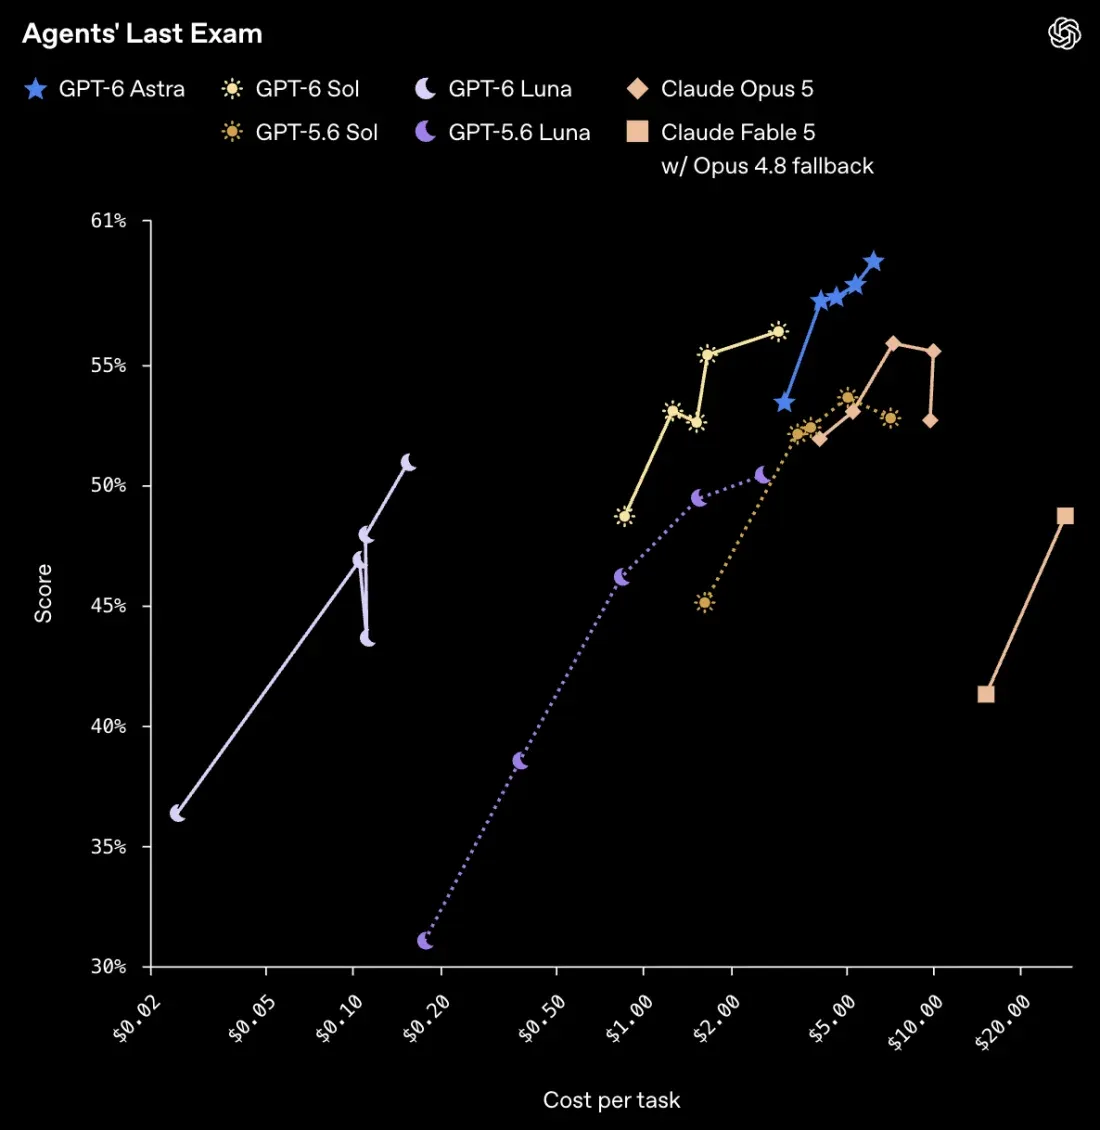
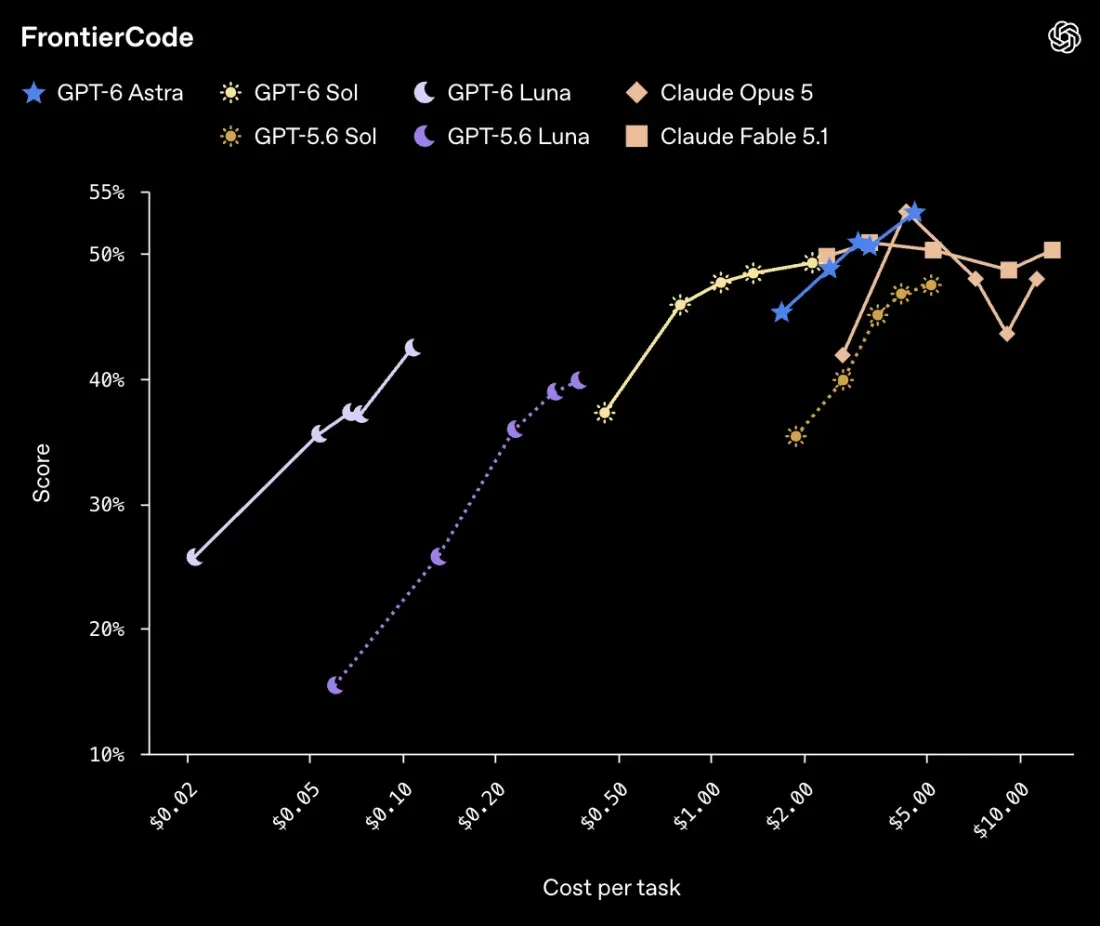
На FrontierCode, где код оценивают ещё и по готовности к мержу, OpenAI заявляет, что Sol сравнялась с Claude Fable 5.1 на xhigh при заметно меньшей стоимости, но точные цифры приводит только на графике.
Три вещи здесь важнее отдельных процентов.
Luna близко к Sol в коде. На DeepSWE у Luna 66,6% против 68,8% у Sol — это уровень Claude Opus 5 и Fable 5 на среднем усилии, при стоимости задачи на 93% ниже, чем у Opus 5. На OSWorld Luna на max обходит GPT-5.6 Sol на medium за десятую часть цены. Бенчмарк меряет изолированные задачи, а не долгую работу в чужой кодовой базе, поэтому заменять Sol на Luna везде не стоит. Но на многих шагах пайплайна разрыв по качеству меньше, чем разрыв в цене — а он в 20–25 раз.
Sol ошибается вдвое реже. На внутреннем тесте фактической точности, собранном из реальных диалогов, где пользователи отметили ошибку, Sol делает примерно вдвое меньше ошибок, чем GPT-5.6 Sol, и приближается к Astra. Luna на высоком усилии держит уровень GPT-5.6 Sol примерно за сотую часть цены. Оговорка OpenAI: это нарочно трудные диалоги, в обычной работе ошибок меньше.
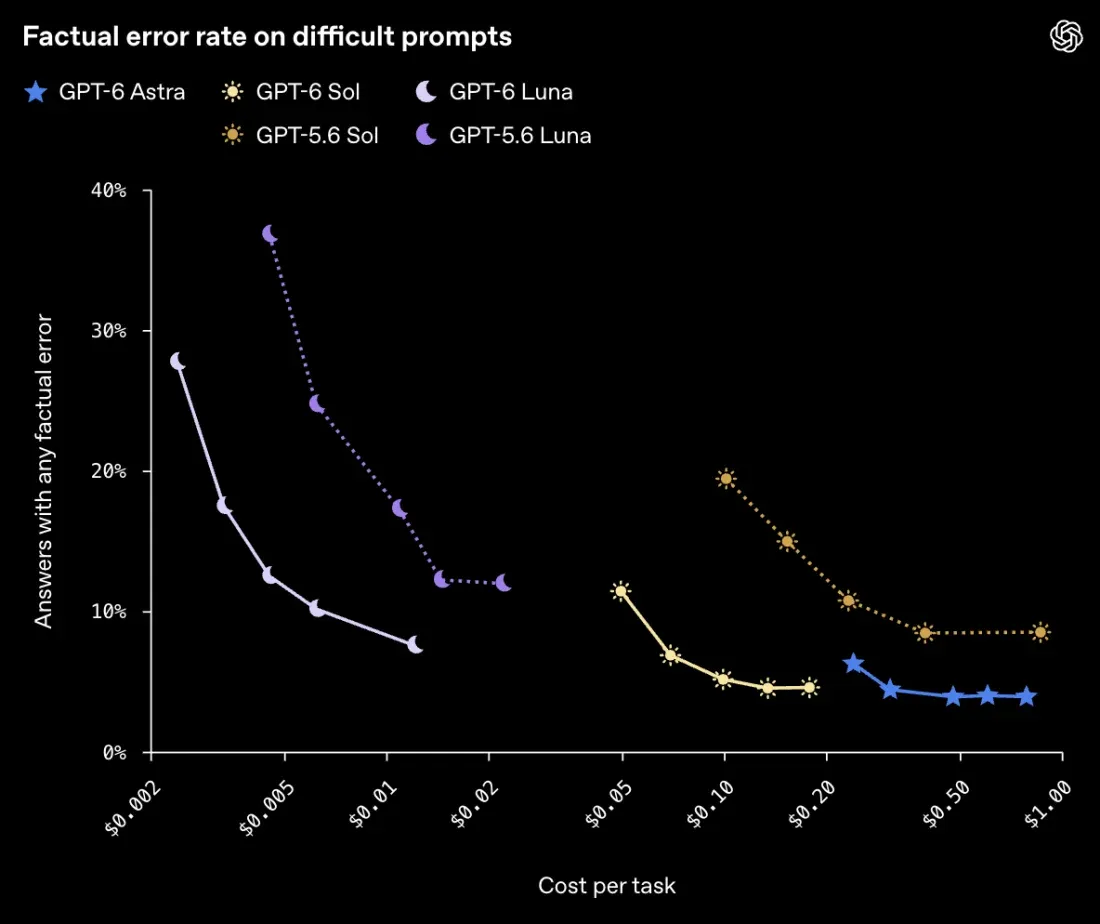
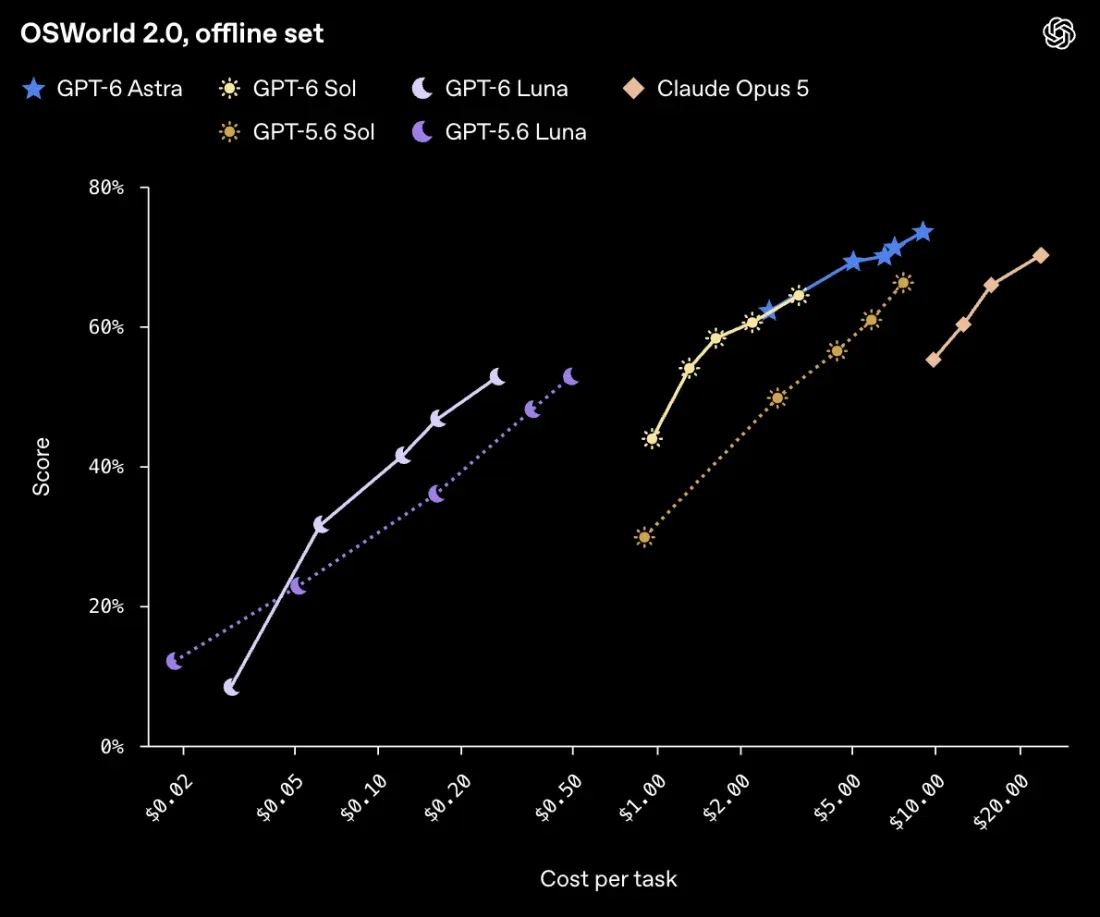
Графики — из анонса OpenAI: по горизонтали стоимость задачи в логарифмической шкале, точки на линии — разные уровни усилия.
Модели честнее рассказывают о своей работе. По оценкам согласованности обе модели реже делают вводящие в заблуждение заявления о своём коде, чем версии 5.6. Для агента это важнее скорости: агент, который скрывает сбой инструмента, дороже того, который честно останавливается. Тесты специально провоцирующие и не отражают частоту ошибок в обычном использовании.
Отдельно OpenAI перенесла в Sol и Luna стиль ответов Astra: меньше жаргона и лишних деталей, ответы немного короче. На длинных сессиях это тоже экономия выходных токенов.
С Opus 5.5 прямого сравнения в анонсе нет: он вышел в тот же день, и OpenAI сравнивает с Opus 5 и Fable 5.1. Для Opus 5.5 Anthropic приводит 81,8% на OSWorld 2.0, но сопоставлять это с 60,5% у Sol по таблицам из двух разных анонсов некорректно. Надёжный способ один — прогнать свои задачи на обеих моделях.
Где хватит Luna, где нужна Sol
Моя рекомендация — не выбирать одну модель на всё, а раскладывать задачи по шагам.
| Задача | Модель | Почему |
|---|---|---|
| Классификация, извлечение полей, маршрутизация запросов | Luna | ответ короткий и проверяемый, цена решает |
| Подзадачи агента: поиск по файлам, сводка результата инструмента | Luna | много вызовов, каждый простой |
| Интерактивный код, ревью, агент на десятки шагов | Sol | важна надёжность всей цепочки, а не цена одного вызова |
| Ответ клиенту или текст в документ | Sol | вдвое меньше фактических ошибок, чем у GPT-5.6 Sol |
| Долгие автономные задачи, большой контекст, работа с компьютером | Astra или Opus 5.5 | там Sol слабее, и переплата окупается |
Пограничный случай — код. Если в пайплайне много коротких правок по понятному описанию, стоит сначала прогнать их на Luna и перевести на Sol только те, где Luna ошибается. Разница в цене позволяет потратить часть бюджета на такую проверку.
Ограничения
- Бенчмарки — от OpenAI. Режимы усилия в сравнениях не совпадают, результаты конкурентов взяты из их публичных отчётов, а для Fable местами использованы цифры Fable 5, потому что по 5.1 данных не было.
- Astra остаётся сильнее. Sol — дешёвый способ получить надёжность, близкую к Astra, на типовых задачах, а не её замена на самых сложных.
- Переезд — не одна строчка. Промпты, настроенные под GPT-5.6, стоит перепроверить: модели пишут короче и честнее сообщают о проблемах, поэтому парсеры и сценарии, завязанные на старый формат ответа, могут вести себя иначе.
Частые вопросы
GPT-6 Sol и GPT-6 Luna уже вышли? Да, 22 сентября 2026 года. В API — сразу, в ChatGPT Work и Codex — постепенно в течение дня.
Сколько стоят? У OpenAI Sol стоит $2 за миллион входных токенов и $10 за миллион выходных, Luna — $0,10 и $0,50. В GPTunneL сейчас действует стартовая скидка 50%: Sol — 0,5 ₽ за 1K входных и 3 ₽ за 1K выходных токенов, Luna — 0,02 ₽ и 0,12 ₽. Без скидки — 1 ₽ / 6 ₽ и 0,04 ₽ / 0,24 ₽.
Чем Sol отличается от Astra? Astra — флагман для самых сложных и долгих задач, Sol в прайсе OpenAI в пять раз дешевле. На типовых задачах разрыв по качеству небольшой: на AutomationBench Sol на xhigh даже обходит Astra на low.
Можно пользоваться бесплатно? Постоянного бесплатного доступа в GPTunneL нет: платишь за израсходованные токены, без подписки. На Luna короткий запрос стоит доли копейки.
Нужен ли VPN? Нет. В GPTunneL обе модели работают из России без VPN, оплата российскими картами в рублях.
Что проверить у себя
Если у тебя сейчас стоит GPT-5.6 Sol, самый дешёвый эксперимент — прогнать тот же набор запросов на GPT-6 Sol и GPT-6 Luna и посмотреть, какие шаги Luna закрывает без потери качества. В GPTunneL обе модели, Astra и Claude Opus 5.5 работают на одном балансе, так что сравнить их можно в одном чате или одним ключом API.