
Разработчик Tarek Ziadé описал эксперимент по запуску Qwen3.8-Flash-Next с примерно 180 млрд параметров на MacBook с 32 ГБ объединённой памяти. Ключ к результату — архитектура Mixture of Experts (MoE) и потоковая загрузка выбранных нейросетевых блоков с SSD. В финальной версии проекта генерация достигла 13,9 токена в секунду, приблизившись к скорости специализированного движка Strata на том же устройстве.
Результат интересен тем, что большая часть модели никогда целиком не загружается в оперативную память. Но следует избегать неверного вывода: 180B-параметрическая модель не «поместилась в 32 ГБ» в обычном понимании. Значительная часть её весов осталась на накопителе, а работа зависит от квантования, кеширования и пропускной способности SSD. Это исследовательский прототип, а не универсальный метод запуска любой 180B-модели на недорогом ноутбуке.
Почему 180 млрд параметров обычно требуют намного больше памяти
В плотной (dense) нейросети при обработке каждого токена используются почти все параметры. Для модели на 180 млрд параметров даже 8-битное представление весов само по себе потребовало бы порядка 180 ГБ памяти без учёта служебных структур и контекста. В 4-битном формате это примерно 90 ГБ, хотя реальные файлы с метаданными и смешанными типами данных могут занимать больше.
В MoE ситуация другая. Модель содержит множество специализированных вычислительных блоков — экспертов, но для каждого токена маршрутизатор выбирает только часть из них. В случае Qwen3.8-Flash-Next автор указывает 48 слоёв по 512 экспертов, из которых в каждом слое активируются 10. При этом общие компоненты модели и маршрутизатор всё равно должны выполняться, а выбранные эксперты необходимо где-то хранить и своевременно доставлять вычислительному устройству.
Эксперты — это математические блоки сети, а не обязательно отдельные «специалисты по программированию» или «специалисты по биологии». Их специализация возникает в ходе обучения и не обязана соответствовать человеческим категориям.
Как устроен эксперимент
Автор использовал потоковую подгрузку экспертов (expert streaming). Основная идея: держать на быстром устройстве ограниченный кеш, а остальные веса экспертов хранить на SSD. Когда маршрутизатор выбирает нужный набор, система проверяет его наличие в кеше, подгружает отсутствующие веса и использует их в вычислениях. Чем точнее предзагрузка и выше доля попаданий в кеш, тем реже процессор или GPU ждёт дисковых операций.
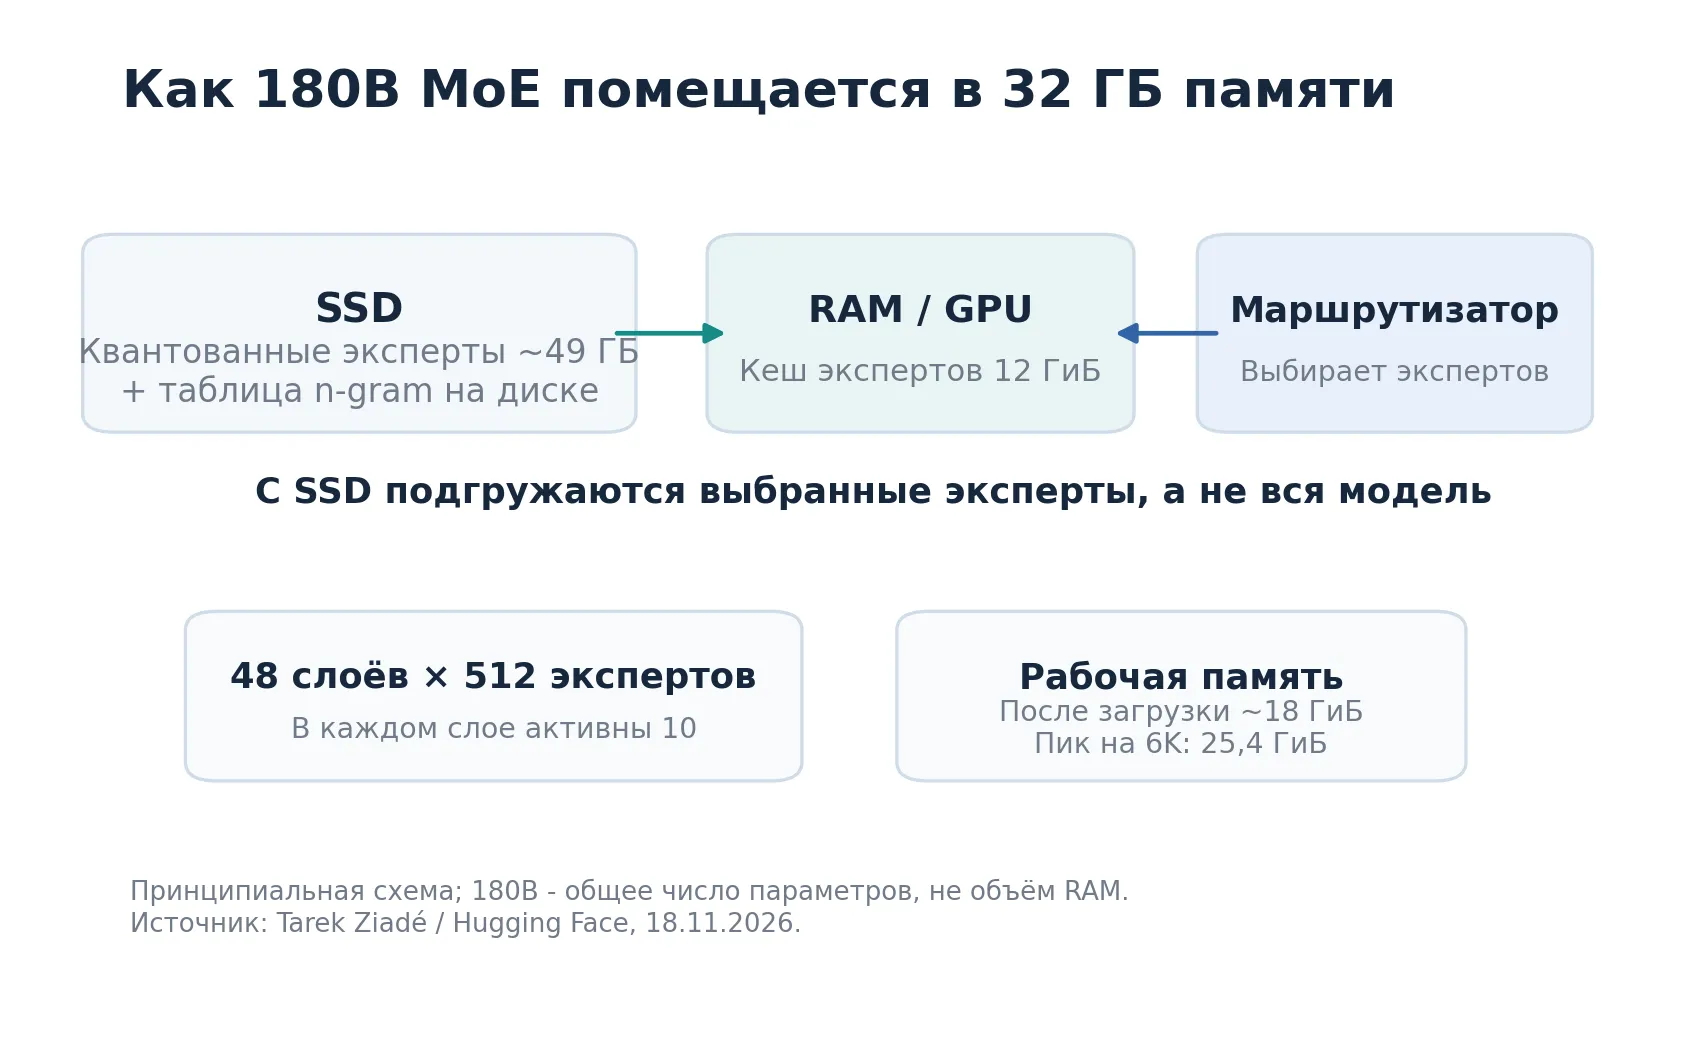
Иллюстрация 1. Редакционная схема работы с SSD и ограниченным кешем. Значения взяты из технического отчёта Tarek Ziadé; изображение упрощает устройство отдельных слоёв.
В исходной конфигурации эксперты Qwen3.8-Flash-Next занимали порядка 121 ГБ в FP8. Для запуска на ноутбуке автор перевёл их в 3-битный формат, получив около 49 ГБ на диске, и выделил под кеш 12 ГиБ. Плотные слои были квантованы до 8 бит и занимали примерно 5,4 ГБ. Ещё одной проблемой стала n-gram-таблица объёмом 51 ГБ, для которой пришлось реализовать отдельную загрузку строк с накопителя.
После загрузки программа занимала примерно 18 ГиБ, а при обработке промпта длиной 6000 токенов пиковое потребление достигало 25,4 ГиБ. На машине с 32 ГБ автору приходилось закрывать браузер и другие приложения, чтобы macOS не начала активно использовать swap. Подготовка файлов занимала около пяти часов.
Что пришлось изменить в Transformers
Обычные способы разгрузки модели, существовавшие в Transformers и Accelerate, не были приспособлены к такой схеме. При выгрузке целого слоя они могут переносить множество экспертов, которые не используются для текущего токена. Если модель не помещается в RAM, начинаются постоянные обращения к диску, и производительность резко падает.
Автор реализовал экспериментальную поддержку experts_offload в pull request к Transformers. Вместо выгрузки целого набора экспертов движок хранит в памяти заранее выделенный пул слотов. Таблица соответствий связывает идентификаторы экспертов с занятыми слотами, что позволяет выполнять вычисления существующими оптимизированными операциями grouped_mm.
Для диска используется параллельное чтение, а следующая пара слоёв пытается заранее предсказать, какие веса потребуются. Автор добавил специализированные Metal-ядра для частей архитектуры, которым не хватало эффективной реализации на macOS, и скорректировал управление запуском GPU-операций. Всё это важно: одной инструкции «переместить веса на SSD» для приемлемой скорости недостаточно.
Открытый эксперимент, скрипты конвертации и подробные замеры размещены в Space moe-expert-streaming и в проекте на GitHub. Код из PR к Transformers на дату публикации ещё обсуждается с сопровождающими проекта; его нельзя считать стабильной функцией обычной установленной версии библиотеки.
Сколько токенов в секунду получилось
На одном Mac M5 с 32 ГБ объединённой памяти автор сравнил итоговую реализацию на Transformers с Strata 0.1.60 на одинаковых промптах. В финальных замерах Transformers достигала 13,9 токена/с при генерации 200 токенов против 14,8 токена/с у Strata. При обработке входного промпта на 4000 токенов Transformers показала 228 токенов/с против 220. После чтения документа на 6000 токенов скорости генерации составили 12,4 и 13,7 токена/с соответственно.
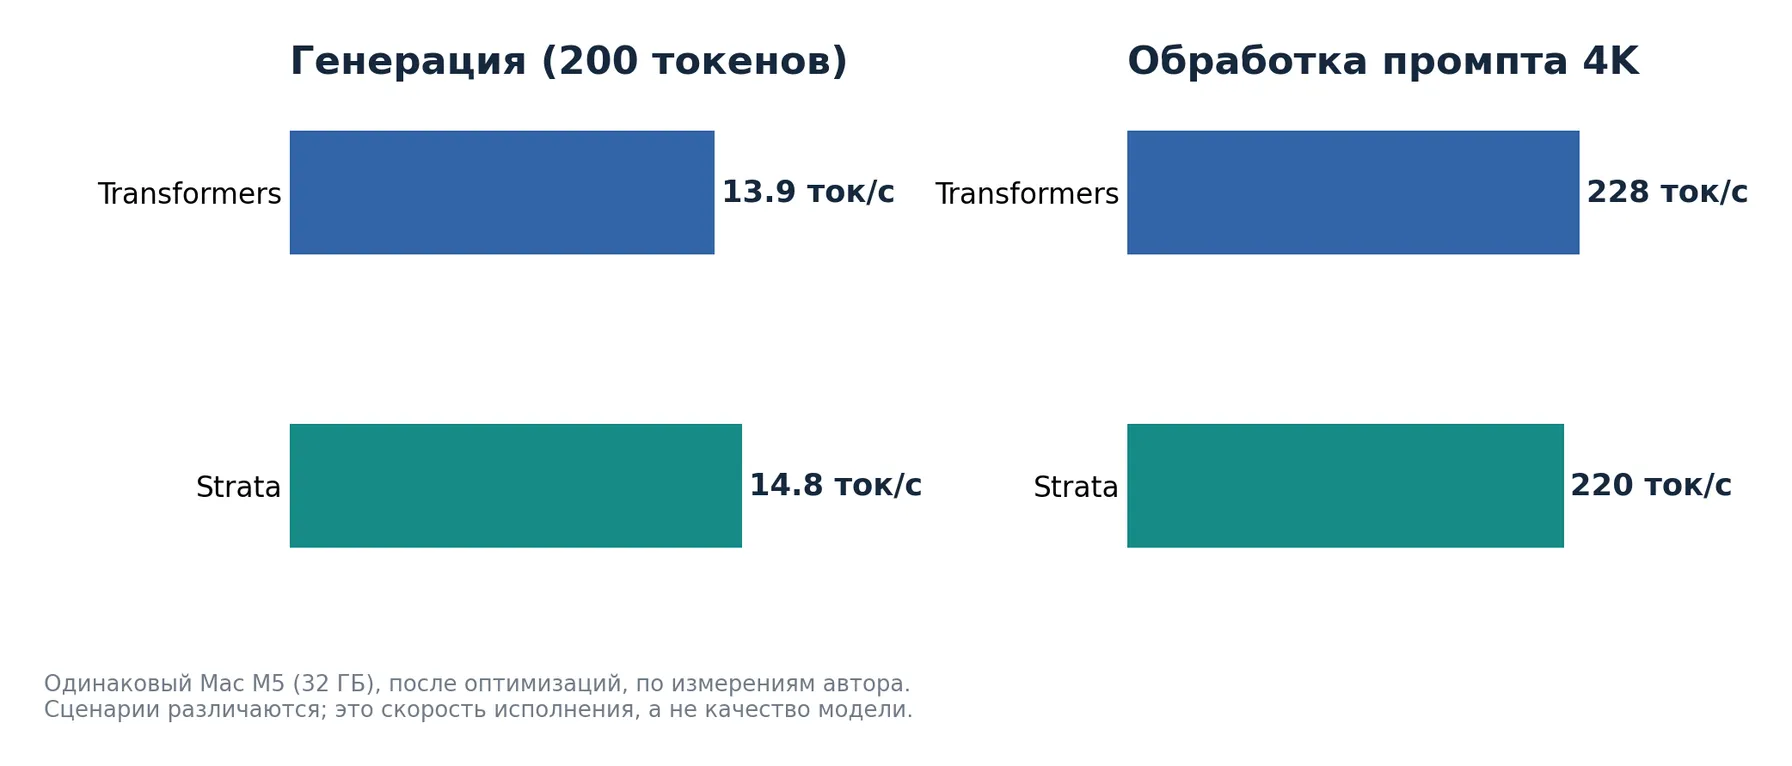
Иллюстрация 2. Два измерения из итоговых замеров на одном Mac M5. Скорость обработки входного промпта и скорость генерации приведены раздельно, поскольку это разные операции.
Первые версии прототипа были значительно медленнее. Автор начал примерно с 10 токенов/с на больших весах, а затем оптимизировал работу кеша, квантование, предварительную загрузку и вычисления на GPU. В финале разница со Strata сократилась примерно до 6% по генерации короткого ответа.
При этом результат в 14 токенов/с остаётся умеренным для интенсивного использования кодовых агентов. Сам автор прямо говорит, что для его ежедневного сценария этого недостаточно, и продолжает использовать более мощный удалённый компьютер. Эксперимент доказывает инженерную возможность запуска, но не равнозначен практической замене облачных сервисов.
Чем новый подход отличается от llama.cpp и vLLM
В том же материале приведён отдельный тест другой MoE-модели Qwen3.6-35B-A3B на GPU A10G с 24 ГБ памяти. В нём Strata с Q8_0 получила 82-88 токенов/с, а llama.cpp в режиме --fit on — 63-64 токена/с. Варианты vLLM с разгрузкой отдельных экспертов в RAM показали другие скорости, а стандартный путь Transformers + Accelerate оказался существенно медленнее.
Эти цифры нельзя добавлять на диаграмму 180B-модели: у теста другой размер модели, железо, форматы весов и режимы исполнения. Смысл сравнения в другом. llama.cpp хорошо работает, когда эксперты помещаются в оперативную память и вычисления можно проводить на CPU. vLLM умеет выгружать веса в RAM и оптимизирован для иных режимов нагрузки. Для ситуации, где даже оперативной памяти не хватает, нужный механизм — чтение только выбранных экспертов с диска и повторное использование горячих весов.
По мере роста размеров MoE-моделей выигрыш может оказаться значительным, но задержки SSD, перегрузка кеша и длинный контекст способны сделать такую систему слишком медленной.
Можно ли повторить эксперимент дома
Описанная конфигурация привязана к Apple Silicon / MPS, конкретному семейству Qwen и подготовленному формату весов. Помимо 32 ГБ объединённой памяти нужен достаточно быстрый SSD со свободным местом для больших файлов и промежуточной конвертации. Обычная установка pip install transformers не гарантирует поддержку этой ветки: на момент публикации используются экспериментальный PR, отдельные скрипты и специфические Metal-ядра.
Для воспроизведения разумно начать с подробной страницы Hugging Face, затем перейти к репозиторию с моделями и преобразованными весами и посмотреть системные требования в материалах автора. Взвешивать стоит реальный сценарий: интерактивные короткие вопросы с 14 токенами/с могут быть приемлемы, а длинные итерации программного агента быстро становятся неудобными.
Почему результат важен
Рынок локальных моделей давно развивает квантование и выгрузку весов в CPU/RAM. Здесь сделан следующий шаг: SSD превращается в дополнительный уровень памяти для отдельных частей большой MoE, а сама вычислительная система старается заранее предугадать, какие из них понадобятся. Это может сделать большие открытые модели доступнее для экспериментов, приватных задач и устройств с ограниченной памятью.
Однако параметры модели сами по себе не говорят о её качестве, а возможность запуска не гарантирует высокую скорость. Главное достижение проекта — приближение экспериментальной реализации на Transformers к специально созданному движку Strata и демонстрация возможностей более гибкой архитектуры выгрузки экспертов. Окончательная практическая ценность будет зависеть от поддержки в основных библиотеках, совместимости с разными MoE и воспроизводимости замеров.