
2026 жылғы 18 қарашада Arena ЖИ-агенттер рейтингін жаңартты. Бір ғана жалпы көрсеткіштің орнына енді бағдарламалау, кеңсе жұмысы, құралдарды пайдалану және пайдаланушының түзетулерін орындау қабілеті бойынша жеке бағалар қолжетімді. Жобаның басты ерекшелігі — агенттердің нақты тапсырмаларды қалай орындайтыны туралы деректер, тек алдын ала дайындалған тесттер ғана емес.
Хабарландыру сәтінде Arena 2,9 млн-нан астам пайдаланушы сессиясы туралы айтты. 20 қарашада қолжетімді рейтинг бетінде 3 093 488 сессия мен 68 модель көрсетілген. Сондықтан нәтижелер жұмыс ЖИ-агентін таңдауға пайдалы, дегенмен оларды барлық модельдердің сапасын өлшейтін әмбебап өлшем деп санауға болмайды.
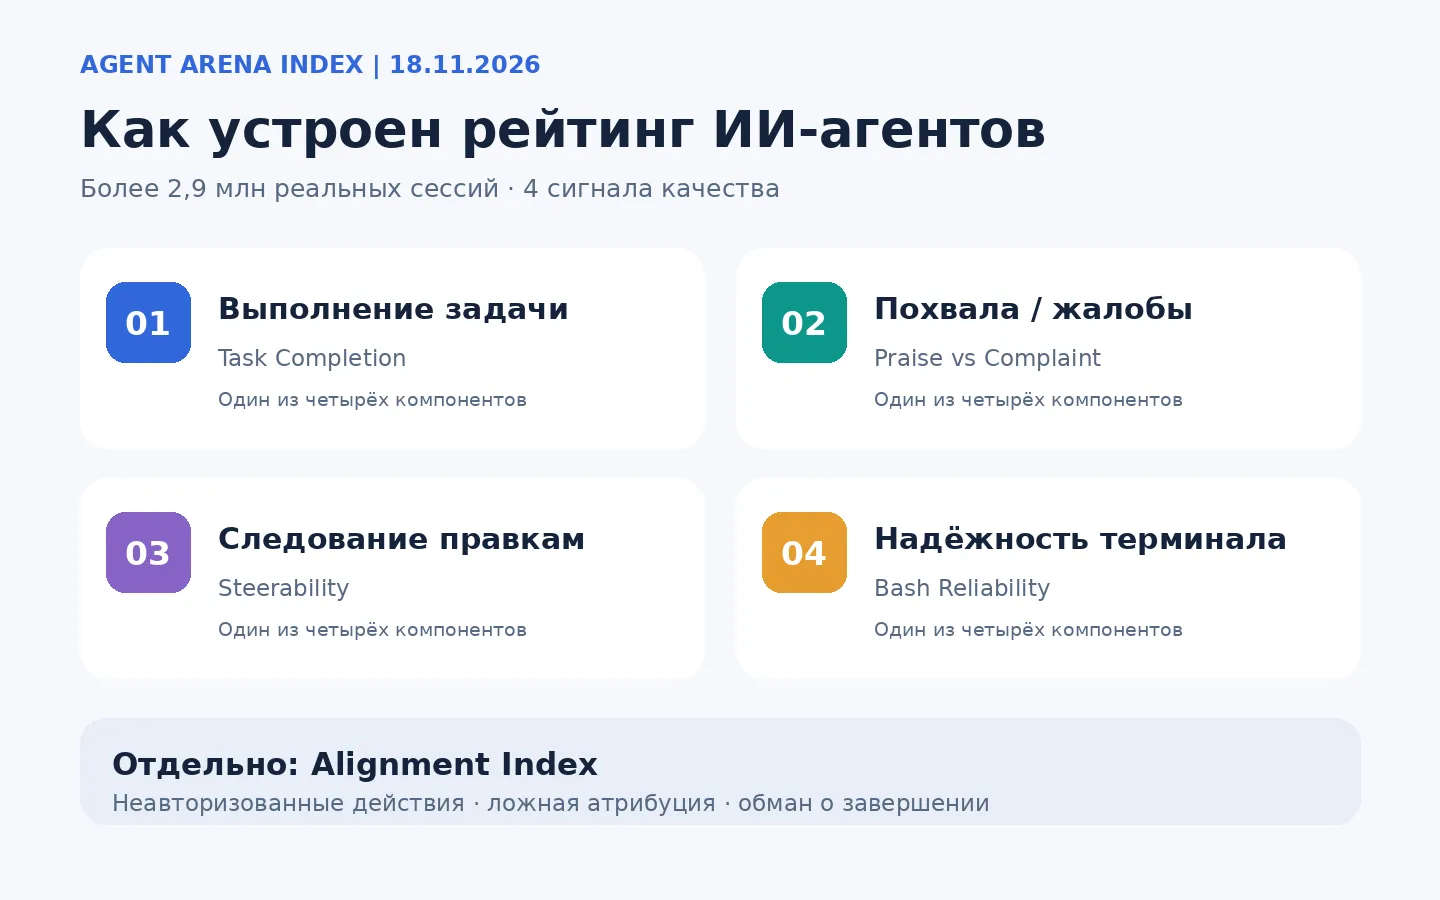
Иллюстрация: жалпы индекстің төрт құрамдас бөлігі және пайдаланушы ниетіне сәйкестіктің жеке көрсеткіштері. Arena әдіснамасы бойынша редакция схемасы.
Agent Arena Index нақты нені өлшейді
Дәстүрлі бенчмарктерде модель барлығына бірдей тапсырмаларды шешеді: функция жазады, сұраққа жауап береді немесе қатені түзетеді. Бұл қайталанатын салыстыру үшін ыңғайлы. Бірақ нақты агенттік жұмыс күрделірек: тапсырма ондаған қадамға созылып, файлдармен, браузермен және терминалмен жұмысты талап етуі мүмкін, ал пайдаланушы бастапқы талаптарды бірнеше рет өзгертеді.
Arena агенттермен өзара әрекеттесу іздерін өзінің Agent Mode режимінде талдайды. Модельдер пайдаланушыларға кездейсоқ тағайындалады, бұл пайдаланушылардың өздері модель таңдауындағы айырмашылықтардың ықпалын азайтуға көмектеседі. Содан кейін сессиялардан мінез-құлық сигналдары алынып, олардың үлесі статистикалық түрде, оның ішінде модельдің тағайындалу ықтималдығына түзетулермен бағаланады.
Жалпы Agent Arena Index индекске төрт сигнал кіреді:
- Task Completion: тапсырманың орындалғанын растау.
- Praise vs Complaint: пайдаланушының нәтижеге оң және теріс реакциялары.
- Steerability: жұмыс барысында нақтылауларды, ескертулерді және түзетулерді орындау қабілеті.
- Bash Reliability: терминал командаларын пайдаланудың сенімділігі.
Әр сигнал агенттік жұмыстың жеке жағын көрсетеді. Мысалы, модель кодты жақсы жаза алады, бірақ ескертулерді нашар ескереді немесе тапсырманың аяқталғанын мерзімінен бұрын мәлімдейді.
Кім көш бастады
20 қарашада қолжетімді рейтингте Claude Fable 5.2 Max режимінде көш бастап тұр. Төменде — Arena бетін тексеру кезінде көрсетілген көрсеткіштері бар алғашқы төрт орын:
| Орын | Модель | Agent Arena Index |
|---|---|---|
| 1 | Claude Fable 5.2 (Max) | 1448 |
| 2 | Claude Opus 5.5 (Max) | 1336 |
| 3 | Gemini 4 Neon (High) | 1333 |
| 4 | Gemini 4 Carbon (High) | 1303 |
Gemini 4 Neon нәтижесі алдын ала деп белгіленген. Бесінші орында — Claude Sonnet 5.5 (Max), алтыншыда — GPT-6.2 Astra (Max). Рейтинг динамикалық: сессиялар келуіне қарай орындар мен бағалар өзгереді. Бұл сандарды тек күнмен және бастапқы кестемен бірге пайдалану керек.
Бір модельдің әртүрлі режимдерінің болуы да маңызды. Max режимі көбірек есептеу мен уақыт жұмсауы мүмкін, сондықтан сапа бойынша көш бастау әлі ең жақсы баға немесе ең жылдам орындау дегенді білдірмейді. Arena-да құн, уақыт және токендер бойынша жеке салыстыру бар.
Алты жаңа бейіндік индекс
Жалпы рейтинг танысу үшін пайдалы, бірақ нақты іс үшін лайықты агент туралы аз айтады. Сондықтан Arena Work, Coding және Chat индекстерін бөліп шығарды — тиісті тапсырма санаттары бойынша бағалар. Тағы үш индекс жеке дағдыларды сипаттайды.
Task Outcome тапсырманың аяқталуы мен пайдаланушының қанағаттануын біріктіреді. Steering агенттің ескертулерден кейін қаншалықты басқарылатынын көрсетеді. Tool Use қазір негізінен Bash сенімділігіне сүйенеді: бұл барлық интеграциялардың толық бағасы емес және Arena сигналдар жиынын кеңейтуді жоспарлап отыр.
Alignment Index бөлек сақталған. Ол жұмыстың басқа жағын қадағалайды: рұқсат етілмеген әрекеттер, дереккөздерді немесе нәтижелерді жалған телу және нақты деректерге қайшы келетін сәтті аяқтау туралы мәлімдемелер. Күрделі тапсырманы орындаудың жоғары қабілеті пайдаланушының ниетін дәл солай ұстануға кепілдік бермейді.
Неге бағалау шкаласы өзгерді
Бұрынғы Agent Arena Net Improvement көрсеткішін пайдаланды: модель нәтижесінің белсенді модельдер жиынының орташа нәтижесінен қаншалықты ерекшеленетіні. Бұл жүйенің мәселесі болды. Егер рейтингке күштірек қатысушылар қосылса, бұрынғы модельдің бағасы оның өз мінез-құлқы өзгермесе де төмендеуі мүмкін еді.
Жаңартуда сызықтық түрлендіру қолданылады: бұрынғы нәтиже 1000-ға көбейтіліп, ортақ тіректік жылжыту қосылады. Тірек рейтингтің іргелес шығарылымдарында бар және сессиялары жеткілікті модельдер бойынша таңдалады. Осылайша әртүрлі күндердегі бағаларды салыстыру тұрақтырақ болады.
Барлық модельдерге бірдей шама қосылатындықтан, шкаланың өзгеруі қатысушылардың орындарын ауыстырмайды. Сонымен қатар Arena Tool Hallucination сигналын алып тастады: зерттеушілердің мәлімдеуінше, қазіргі озық модельдер жоқ құралдарға тым сирек жүгінеді. Confirmed Success өлшеу принципі өзгеріссіз Task Completion деп қайта аталды.
Мұндай рейтингке сенуге бола ма
Arena-ның күшті жағы — бақылау ауқымы мен нақты пайдалануға жақындығы. Сонымен бірге бір платформаның сессиялары талданады, яғни тапсырмалар құрамы, қолжетімді құралдар мен интерфейс нәтижелерге әсер етеді. Рейтинг модельдің басқа құралдар жиынымен автономды жұмыста немесе ерекше қолжетімділік құқықтары бар корпоративтік ортада қаншалықты жақсы екеніне тікелей жауап бермейді.
Әдіснамалық шектеу де бар: пайдаланушының қанағаттануы мен тапсырманың сәттілігі толық сәйкес келмейді. Пайдаланушы сенімді, бірақ қате жауапты мақтауы мүмкін немесе сәтті аяқталған жұмыстан кейін кері байланыс қалдырмауы мүмкін. Статистикалық түзетулер көмектеседі, бірақ барлық ықтимал ауытқуларды жоя алмайды.
GPTunnel интеллект индексі үшін жаңарту әсіресе маңызды: Arena-ның жаңа балдарын тарихи кестеге ескі Net Improvement мәндері ретінде қоюға болмайды. Әдіснама нұсқасын бекіту, модельдердің қамтылуын салыстыру және қабылданған нормалауды қайта орындау қажет. Бейіндік индекстерді жалпы индексспен де қосуға болмайды: олардың сигналдары ішінара қайталанады.
Бұл нені өзгертеді
Рейтинг «қандай ЖИ-агентті таңдау керек?» деген сұраққа практикалық жауап береді. Бір кестенің орнына кім жақсы бағдарламалайтынын, кім түзетулерді дәлірек орындайтынын және кім қалаусыз әрекеттерді сирек жасайтынын қарауға болады. Агенттер файлдарға, поштаға және жұмыс жүйелеріне қолжетімділік алған сайын тапсырманы орындау қабілеті мен орындау сенімділігі арасындағы айырмашылық барған сайын маңызды бола түседі.