
Бұл материалдан қазіргі уақытта қолжетімді барлық бенчмарктерді (AA, Vals, Arena, Google-дан алынған деректер - бәрін ыңғайлы диаграммаға біріктіріп, Carbon-ды Opus 5.5, Astra 6 және Argon-мен салыстырдым - осыны іздеп келсең, сілтемені бас) және Google-дың жаңа моделінің негізгі мәліметтерін табасың, сондай-ақ қауымдастықтың релизді қалай қабылдағанын жинақтадым. Алдымен Google-дың өзі нені мәлімдейтінін анықтаймыз, содан кейін бенчмарктерді қараймыз, ал соңында қауымдастықтың пікірін қараймыз.
Қысқаша: жаңа Gemini 4 Carbon моделі Google-дың бенчмарктерінде Opus 5.5-тен озады, Arena AI бенчмарктерінде (мұнда пайдаланушылар таңдайды) жеңіліп қалады, ал басқа тесттерде әртүрлі нәтиже көрсетіп бәсекелеседі. Ол тапсырма құны бойынша ұтады (яғни арзанырақ), және кибер қауіпсіздік саласында мүмкін жақсырақ. Нақты пайдаланушы тәжірибесінсіз соңғы бағалау жасау ерте, бұл туралы қауымдастық релизді қалай қабылдағаны бөлімінде жеке оқуға болады. Міне, бастайық.
28 қазан 2026 жылы Google Gemini 4 Carbon-ды ұсынды - күрделі бағдарламалау, ұзақ тапсырмалар және киберқорғау үшін жаңа модель. Қолжетімділікті кезең-кезеңімен ашады: анонс аптасында оны киберқорғау мамандарының шағын тобы ала бастайды, содан кейін Google Fairwind бағдарламасы арқылы пайдаланушылар шеңберін кеңейтеді, жалпы іске қосу күні әзірге белгісіз. Салыстыру үшін: Argon-ға жалпы қолжетімділік анонстан 13 күннен кейін ашылды, бұл шамамен екі апта.
Айтпақшы, Google басшысы Сундар Пичаи Carbon туралы хабарламасында модельдерді мезгіл-мезгіл шығару ниетін еске салды және жаңарту жылдамдығына баса назар аударды: Carbon Argon-ның кең көлемді іске қосылуынан 15 күн өткен соң жарияланды.
Gemini 4 Carbon не істей алады
Carbon Gemini 4 Argon негізінде құрылған. Google-дың анонсында басты назар - бағдарламалық жүйелерді қорғауға және көптеген әрекеттерді талап ететін күрделі тапсырмаларға. Компания жаңа модель туралы нақты не мәлімдейтінін міне.
Киберқорғау: осалдықты табудан түзетуге дейін
Google Carbon-ды қауіпсіздік маманының жұмысының үш кезеңінде тексереді: кодтағы осалдықты табу, оны шынымен пайдалануға болатынын тексеру және түзетуді дайындау. Екінші кезең табылғанның қауіптілігін бағалауға және алдымен қай мәселелерді түзету керектігін шешуге көмектеседі.
Google келтірген тесттерде Carbon SEC-bench Pro-да осалдықтарды іздеуде 88,2%, ExploitGym-де пайдалануды тексеруде 54,8%, ал CWE-bench-те түзетуде 71% көрсетті. Бұл сынақтар модельге қорғаныс шектеулерінсіз жүргізілді; нәтижелер мен шарттарды төменде толығырақ талдаймыз.
Компания сонымен қатар ішкі тесттерінде Carbon қауіпсіз кодты Argon-нан екі реттен астам жиі сәтті жасағанын хабарлайды. Google деректері бойынша, Chrome командасы Carbon-нан басқа зертхананың ірі модельдерінің бірімен салыстырғанда сапалырақ түзетулер алған. Бұл модельдің атауы мен салыстырудың толық мәліметі анонста келтірілмеген, сондықтан оны өз бетімен бағалау әзірге мүмкін емес.
Ұзақ уақыт күрделі кодпен жұмыс істеу
Carbon агенттің файлдарды бірізді зерттеуі, қатенің себебін іздеуі, түзету әрекеттерін сынауы және бірінші тәсіл көмектеспесе жұмысын жалғастыруы қажет тапсырмаларға арналған. Google үлкен кодтық базалардағы және төмен деңгейлі жүйелердегі түсінуі қиын қателерді табу және түзету мысалын келтіреді.
Компанияның айтуынша, оның командалары Carbon осындай көп қадамды тапсырмаларда бірнеше күн бойы қалай жұмыс істегенін бақылаған. Бұл Google-дың ішкі тәжірибесі, ал жария нұсқа кез келген жобаны дәл осындай ұзақ уақыт автономды жүргізе алатынына кепіл емес: нәтиже агенттің құралдарына да, жұмыс ортасының шектеулеріне де байланысты.
Ойдан шығарылған нәтижелер мен тапсырма шегінен шығу азайды
Google Carbon-ды күрделі жағдайлардағы әрекетке бөлек оқытты: деректер жетіспесе немесе әрекет бұғатталса, модель бұл туралы хабарлауы керек, ал тексерілмеген нәтижені орындалған жұмыс ретінде ұсынбауы тиіс. Компанияның ішкі тестілерінде растанбаған тұжырымдар Argon-дікіне қарағанда шамамен екі есе аз болған.
Компания сонымен қатар өз бағалауларында Carbon тапсырма шегінен 26%-ға сирек шыққанын және тапсырманы 29%-ға сирек толық орындамай қалдырғанын хабарлайды. Бұл Google-дың нақты тесттерінің нәтижелері, қателіктер жоқтығына кепілдік емес; оларды модельге қол жеткізусіз өз жобаңа қатысты әзірге тексеру мүмкін емес.
Carbon Argon-нан несімен ерекшеленеді
Argon-ды жария API арқылы қолданбаға қосуға болады. Carbon әзірге шектеулі іске қосу кезеңінде: Google модельдің жақсартуларын сипаттады, бірақ әзірлеушілерге арналған толық спецификацияны әлі ұсынбады. Сондықтан жаңа модельдің техникалық сипаттамаларының бір бөлігі әзірге белгісіз күйінде қалып отыр.
| Салыстырылатын нәрсе | Gemini 4 Argon | Gemini 4 Carbon жарияланған сәтте |
|---|---|---|
| Қолжетімділік | 13 қазаннан бастап жалпы қолжетімді: ақылы API, AI Studio және Google өнімдері | Киберқорғау мамандарына және Fairwind сенімді серіктестеріне кезең-кезеңмен қолжетімділік; жалпы іске қосу күні аталмаған |
| API-дағы идентификатор | Тұрақты модель gemini-4-argon | Ашық идентификатор әлі жарияланбаған |
| Контекст | 1 048 576 токен, кіріс пен шығыс үшін жалпы шек | Контекст көлемі әлі көрсетілмеген |
| Жауап ұзындығы | Әдепкі бойынша 65 536 токенге дейін; long decode арқылы жалпы терезе шегінде 1 048 576-ға дейін | Жауап шегі және long decode болуы әлі көрсетілмеген |
| Кіріс және шығыс | Кіріске мәтін, суреттер, бейне, аудио және PDF; шығысқа мәтін | Google мультимодальды түсінудің жақсарғанын мәлімдейді, бірақ кіріс пен шығыс форматтарының толық тізімін әлі ұсынбаған |
| Құралдар мен режимдер | Функцияны шақыру, кодты орындау, іздеу, құрылымдалған шығыс; пайымдау деңгейлері low, medium және high | Болашақ жария API-дағы құралдар құрамы мен пайымдау параметрлері әлі сипатталмаған |
| Кэштеу | Жасырын кэштеу қолдау табады; анық кэштеу қолжетімсіз | Кэштелген кіріс үшін 95% жеңілдік жарияланған; кэшпен жұмыс істеу тәсілі әлі нақтыланбаған |
Argon сипаттамалары - Gemini API құжаттамасынан, Carbon туралы мәліметтер - Google анонсынан. «Әзірге көрсетілмеген» дегенде жарияланған спецификацияда деректер жоқ екені түсініледі, функцияның жоқ екені емес. Argon-ның контекстін, форматтарын және құралдарын растаусыз Carbon-ға көшіруге болмайды.
Carbon-дың негізгі мәлімделген өзгерісі агенттің ұзақ жұмысына қатысты. Google модельдің күрделі инженерлік тапсырмаларды жақсы шешетінін, растанбаған тұжырымдарды азырақ беретінін және тапсырма шекараларын дәлірек сақтайтынын хабарлайды. Бұл компанияның ішкі бақылауларындағы жақсартулар; олардың жария нұсқада қалай көрінетінін тексеру әлі алда.
По жарияланған кіріспе тарифі бойынша Google Carbon API-і миллион кіріс токеніне $2 және миллион шығыс токеніне $10 болады. Кіріспе кезеңінен кейін бағалар миллион кіріс токеніне $4 және миллион шығыс токеніне $20 дейін көтеріледі. Кіріспе тарифіндегі кэштелген кіріс токендері әдеттегі кіріс токендерінен 95% арзан болады. Бұл Google Argon үшін жариялаған бағалармен бірдей; Carbon-ның кіріспе кезеңінің аяқталу күнін компания атаған жоқ.
Тәуелсіз сынақтардың нәтижелері: Arena, Artificial Analysis және Vals
WebDev Arena
WebDev Arena моделдерді веб-әзірлеу тапсырмаларында пайдаланушылардың бағалауы бойынша салыстырады. 27 қазандағы рейтинг үзіндісінде High режиміндегі Gemini 4 Carbon 1768 ұпаймен төртінші орынды алады.
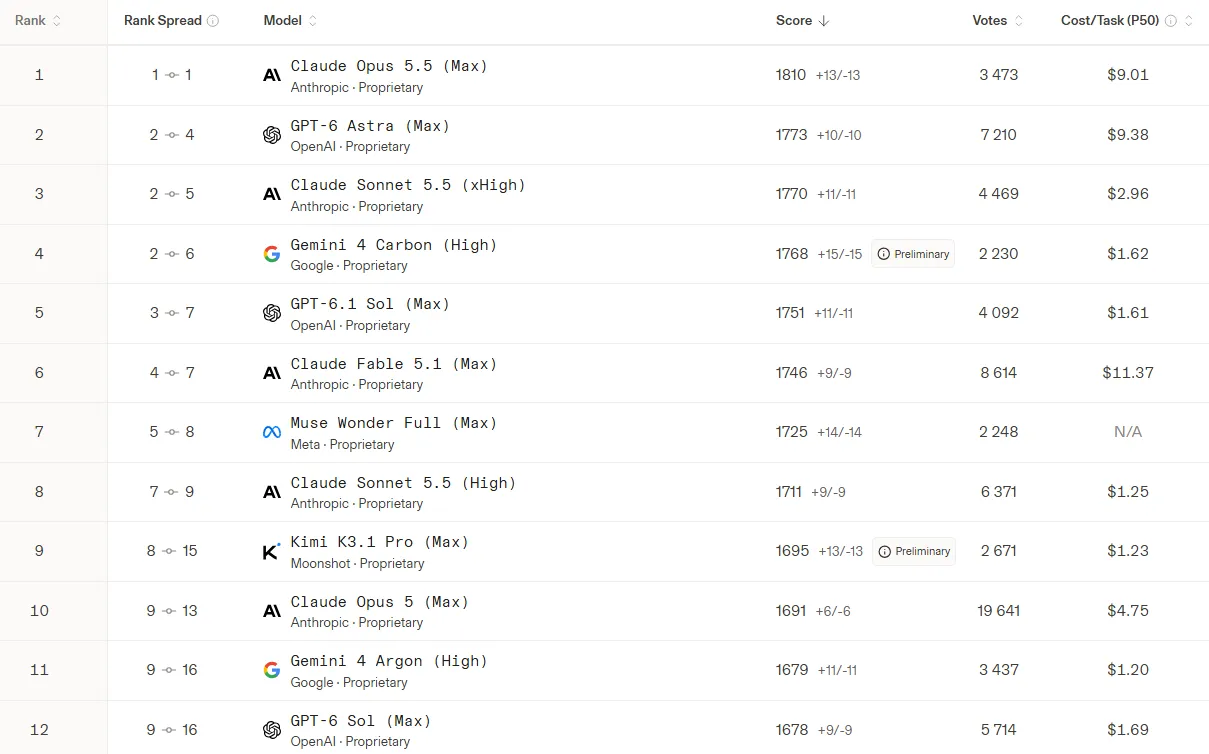
Carbon-нан алда - 1810 ұпаймен Claude Opus 5.5 Max, 1773 ұпаймен GPT-6 Astra Max және 1770 ұпаймен Claude Sonnet 5.5 xHigh. Оның артында 1751 ұпаймен GPT-6.1 Sol Max және 1746 ұпаймен Claude Fable 5.1 Max тұр. Алдыңғы нұсқа Gemini 4 Argon High 1679 ұпаймен 11-орында.
Carbon нәтижесі алдын ала: скриншотта 2230 дауыс есепке алынған, ал рейтингтегі мүмкін орын диапазоны - екіншіден алтыншыға дейін. Ұпайлар мен орындар жаңа бағалар түскен сайын өзгереді; Google жарнамасында Carbon үшін 1769 ұпай көрсетілген.
Жұптық салыстыруда Claude Opus 5.5 Max берілген WebDev Arena үзіндісіндегі дуэльдердің 69%-ында Gemini 4 Carbon High-ды жеңеді. Төмендегі матрицада басқа жұптар да көрсетілген: модель жолындағы мән сол модельдің сәйкес бағандағы модельге қарсы нәтижесін білдіреді.
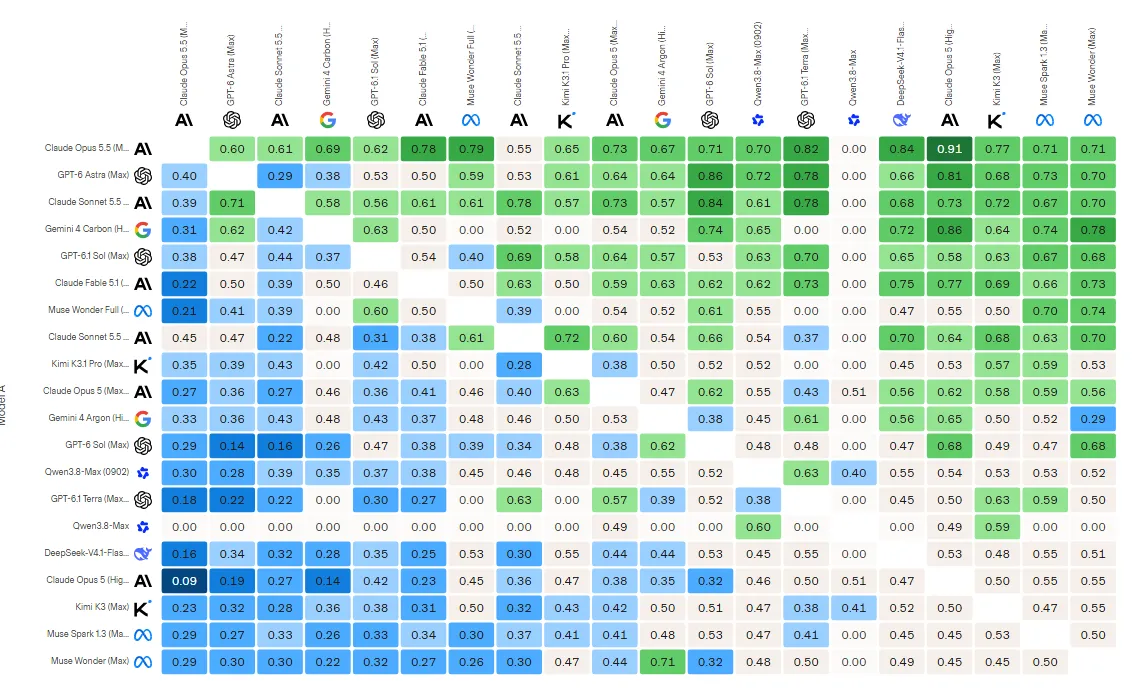
Жоғарыдағы рейтинг кестесі тапсырманың медиандық құнын да көрсетеді: Carbon үшін $1,62, Opus 5.5 Max үшін $9,01 және GPT-6 Astra Max үшін $9,38. Бұл Arena көрсеткіші, GPTunneL-дегі тапсырманың бағасы емес; Carbon-ға қолжетімділік пайда болғаннан кейін өзіндік құнын тексеру керек.
Agent Arena: пайдаланушы тапсырмаларындағы нәтижелер
Agent Arena жүйесінде модельдер агенттік режимнің нақты сессияларынан алынған сигналдар бойынша бағаланады. 28 қазандағы үзіндіде Carbon High екінші орынды алады, Net Improvement көрсеткіші +16,04 п.п., бұл Opus 5.5 Max-тің +20,94 п.п. көрсеткішінен төмен. Салыстыру үшін: Astra Max +12,96 п.п. көрсеткішімен бесінші, Argon High +10,73 п.п. көрсеткішімен жетінші орында. Carbon нәтижесі алдын ала деп белгіленген; оның мүмкін орын диапазоны - екіншіден төртіншіге дейін.
| Орын | Модель | Net Improvement | Расталған сәттілік | Мақтау және шағым |
|---|---|---|---|---|
| 1 | Claude Opus 5.5 Max | +20,94 ± 2,15 | +22,29 ± 3,11 | +45,97 ± 8,24 |
| 2 | Gemini 4 Carbon High | +16,04 ± 1,00 | +18,05 ± 1,60 | +37,95 ± 3,68 |
| 3 | Claude Sonnet 5.5 Max | +13,84 ± 2,65 | +20,76 ± 4,23 | +23,76 ± 10,30 |
| 4 | Claude Fable 5.1 Max | +13,35 ± 1,89 | +12,47 ± 3,51 | +27,07 ± 6,90 |
| 5 | GPT-6 Astra Max | +12,96 ± 2,02 | +12,59 ± 3,52 | +27,10 ± 7,30 |
| 6 | GPT-6.1 Sol Max | +12,47 ± 1,08 | +11,38 ± 1,91 | +27,67 ± 3,90 |
| 7 | Gemini 4 Argon High | +10,73 ± 0,81 | +12,84 ± 1,47 | +23,96 ± 2,78 |
| 8 | GPT-6.1 Terra Max | +10,57 ± 1,96 | +10,10 ± 3,48 | +16,84 ± 6,78 |
| 9 | Muse Wonder Full Max | +10,09 ± 0,94 | +11,93 ± 1,83 | +17,69 ± 3,27 |
| 10 | Claude Fable 5 High | +8,04 ± 1,09 | +5,57 ± 2,12 | +15,45 ± 3,54 |
Кестеде осы срездегі барлық он модель берілген; мәндер мен интервалдар пайыздық пункттермен көрсетілген. Arena 95%-дық сенімділік интервалдарын көрсетеді: интервалдары қиылысатын жақын нәтижелерді бір нүктелік бағаға қарап сенімді түрде реттеу мүмкін емес.
Arena әдістемесіне сәйкес Net Improvement бірнеше сигналды ескере отырып, орташа модельге қатысты бағаланған өзгерісті көрсетеді, соның ішінде тапсырманың орындалуын растау, пайдаланушылардың реакциясы және түзетулерді ескеру қабілеті. Бұл шешілген тапсырмалардың үлесі емес. Рейтингтегі жеке көрсеткіштер Confirmed Success және Praise vs Complaint де негізгі деңгейден ауытқуды білдіреді, абсолюттік табыс немесе мақтау пайызын емес.
Осы срезде тапсырманың медианалық құны Carbon үшін - $1,74, Opus үшін - $6,70, Astra үшін - $5,25, ал Argon үшін - $1,09. Бұл Agent Arena-дағы тапсырмалардың құны; ол WebDev Arena көрсеткішіне тең емес және GPTunneL тарифі де емес. Carbon 26 511 сессия бойынша есептелген, ал бүкіл рейтинг 2 875 897 сессиядан тұрады; жеке сигналдар бойынша бақылаулар саны әртүрлі болуы мүмкін.
Artificial Analysis индексі және Google бенчмарктары
Artificial Analysis Intelligence Index v5.0 бойынша Carbon High режимінде 59 ұпай алып, бағаланған модельдер арасында бірінші орынды иеленді. Одан кейін Claude Opus 5.5 58 ұпаймен, GPT-6 Astra 57 ұпаймен келеді, ал Argon 50 ұпай жинаған. Бұл Google төмендегі салыстырмалы кестеде берген нәтижелердің срезі.
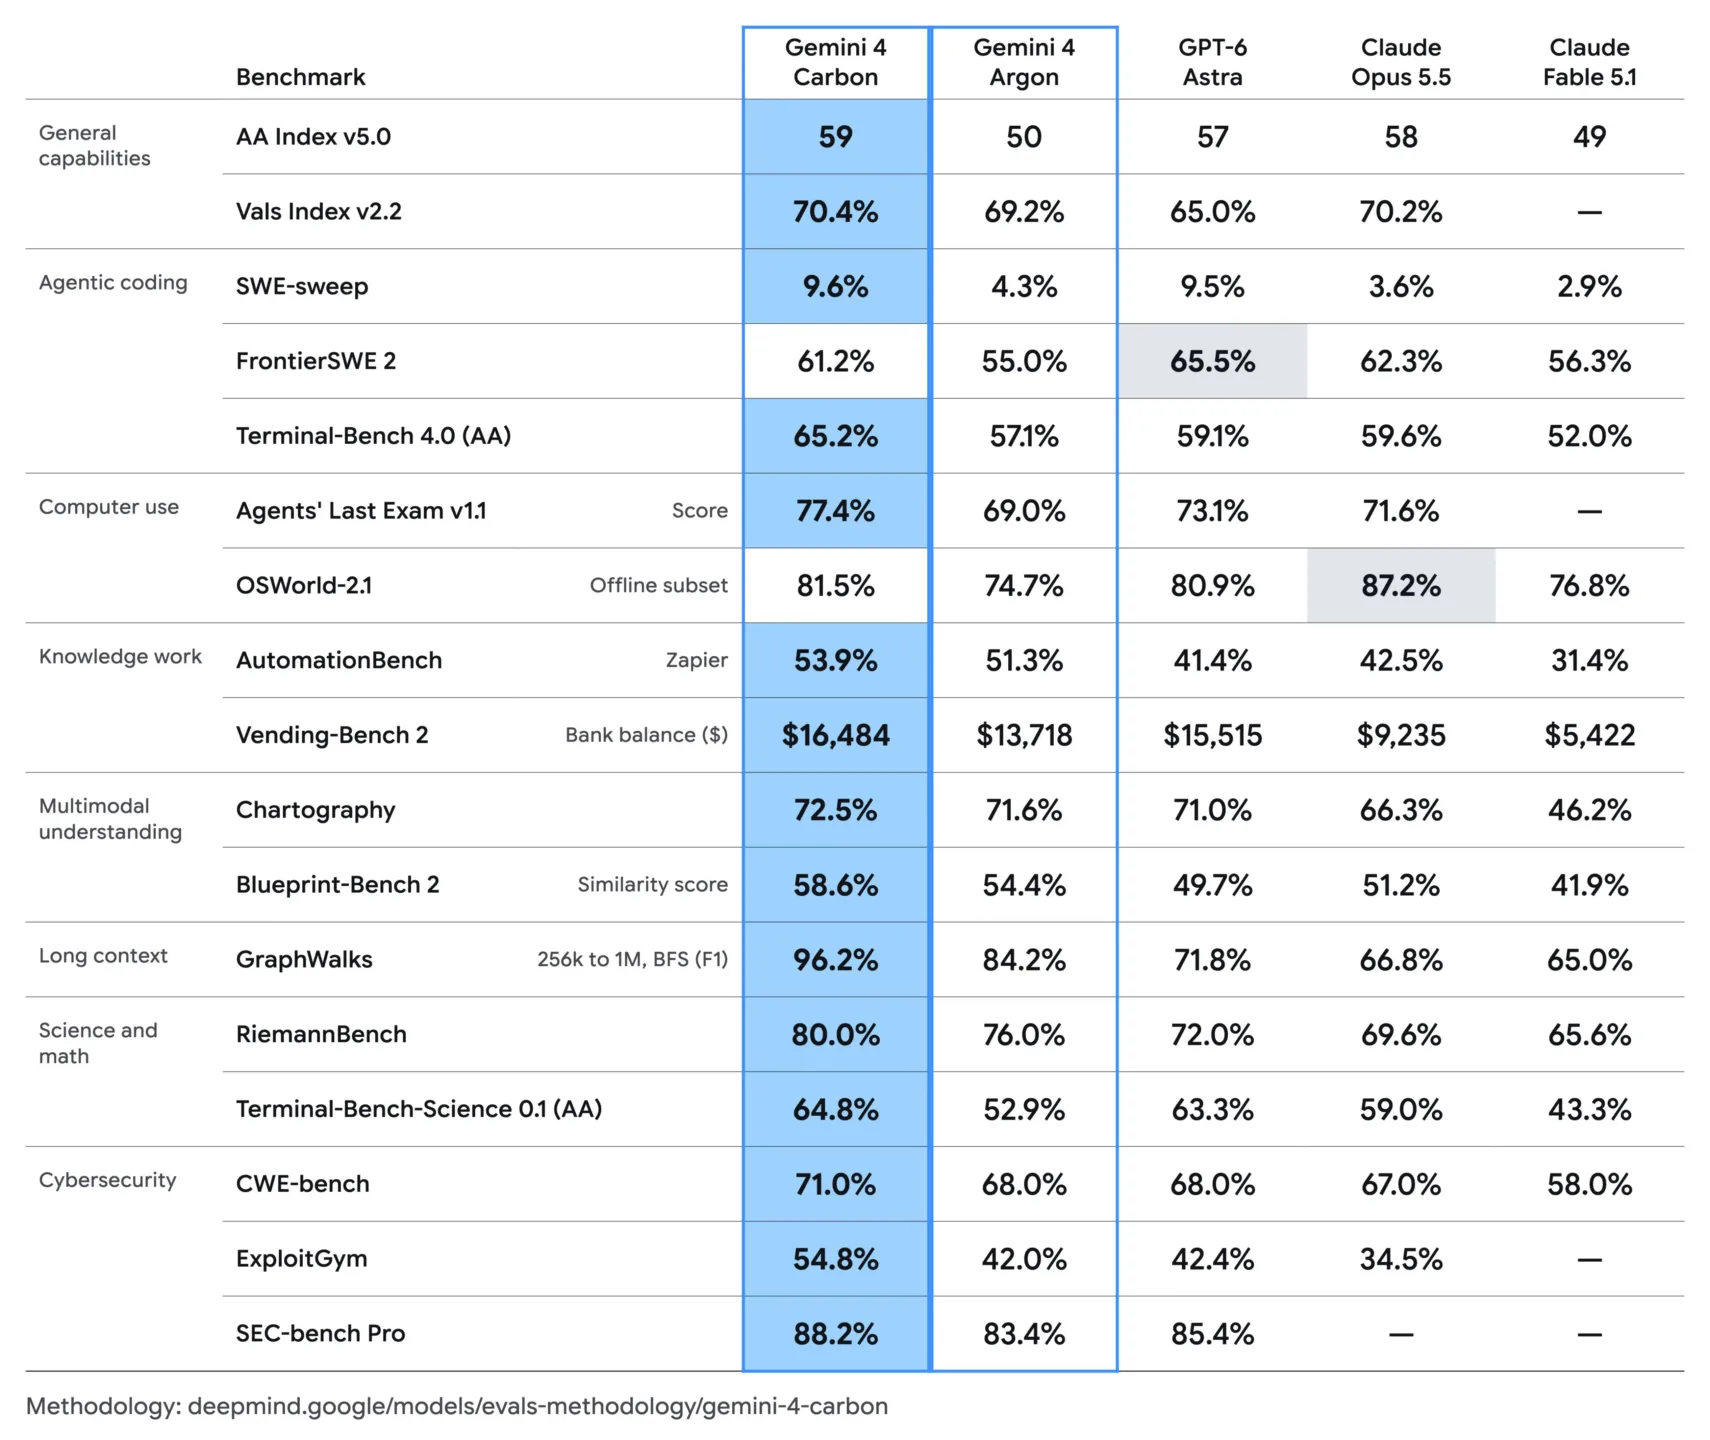
Пичаи бөліскен кестеде бір Artificial Analysis индексінің бөлінісі емес, әртүрлі бенчмарктар жиналған. Салыстыруды Google DeepMind дайындаған; Terminal-Bench 4.0 және Terminal-Bench-Science 0.1 нәтижелері AA бағалары ретінде белгіленген. Мысалы, AA-ның Terminal-Bench 4.0 тестінде Carbon 65,2% алды, бұл Argon-ның 57,1%-ына және Claude Opus 5.5-тің 59,6%-ына қарсы. FrontierSWE 2 тестінде Carbon 61,2% жинап, GPT-6 Astra-ның 65,5%-ынан және Opus 5.5-тің 62,3%-ынан төмен қалды.
Индекс бағдарламалау, пайымдау, математика және ғылыми тапсырмаларды қоса алғанда тоғыз тексеруді біріктіреді. Artificial Analysis бағалауларды өз бетінше жүргізетінін жазады. Бұл пайдалы жалпы бағдар, бірақ ол өз тапсырмаңдағы тестті алмастырмайды: жеке тексерулердің салмағы мен модель параметрлері нәтижеге әсер етеді.
Тағы бір қателік - жаңа 59 ұпайды индекстің ескі нұсқасының сандарымен салыстырып, дәл өсімді жариялау. v5.0 нұсқасы жаңартылған әдістемені қолданады, сондықтан салыстыру үшін рейтингтің бір нұсқасында алынған нәтижелерді алу керек.
Нәтиже қанша тұрады. Берілген Artificial Analysis срезінде индекс тапсырмасының орташа өлшенген құны Carbon High үшін $7,76 деп бағаланады. Салыстыру үшін: GPT-6 Astra Max - $6,24, резервтік модельмен Claude Opus 5.5 Max - $10,04. Демек, осы тексерулер жиынтығында Carbon осы екі модельден көп ұпай жинады, ал құны олардың арасында болды.
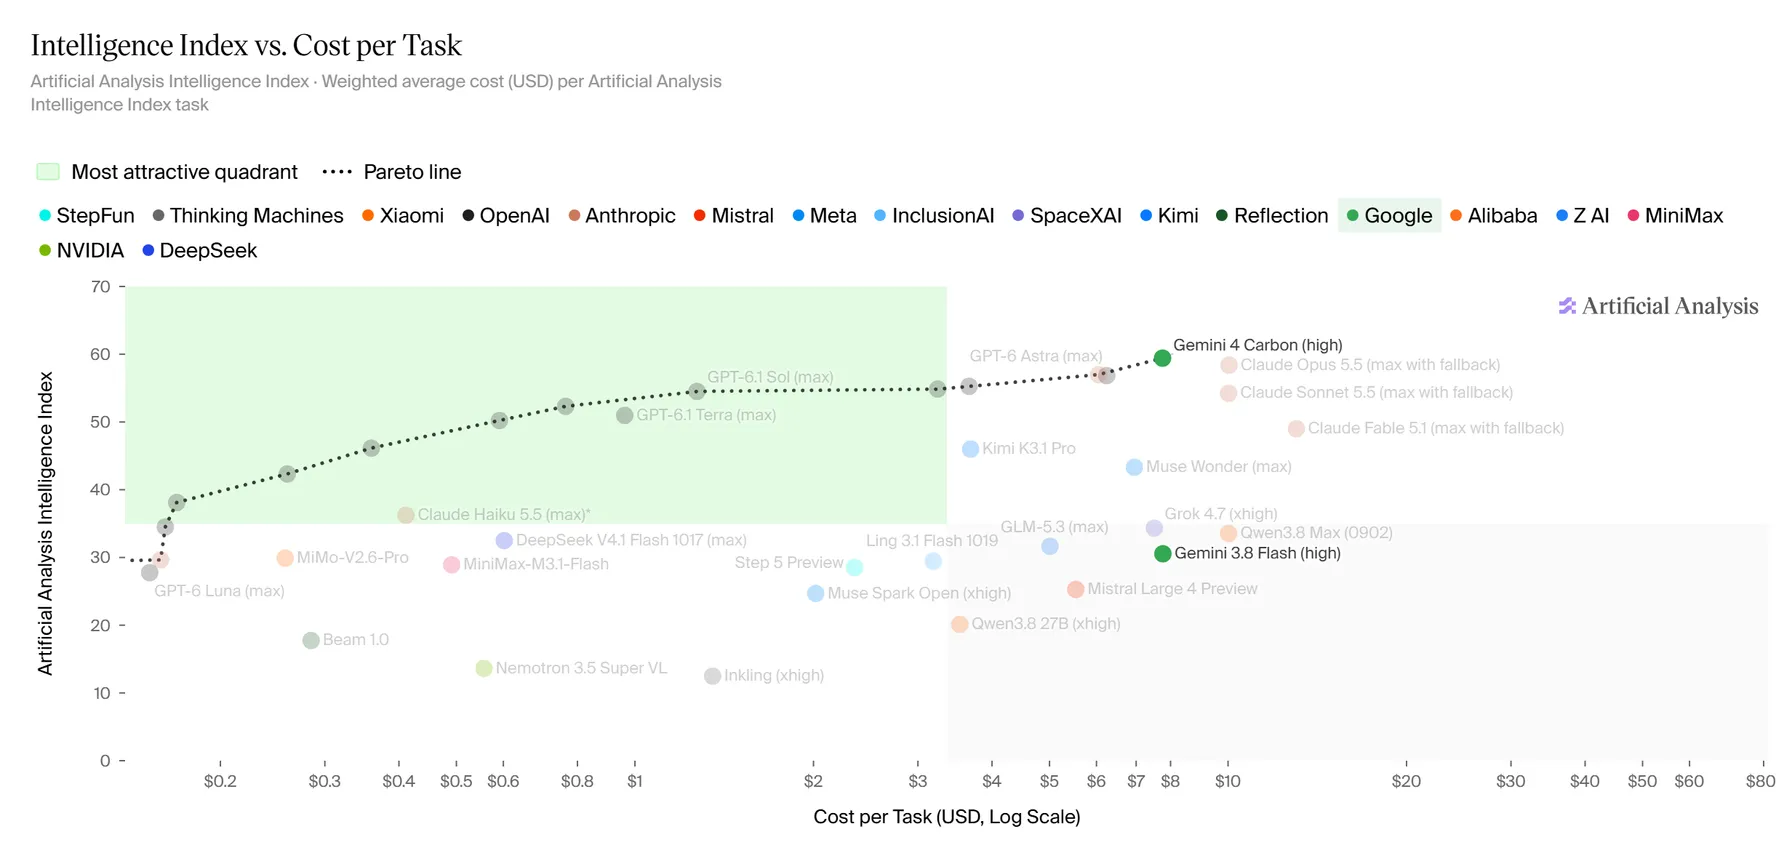
Графиктің көлденең осі - долларлармен тапсырма құны, шкаласы логарифмдік; тік осі - индекс ұпайы. Нүкте неғұрлым жоғары және солға орналасса, соғұрлым аз шығынмен жоғары нәтиже көрсетеді. Artificial Analysis құнды жеке тесттердегі токендер шығыны бойынша есептейді және әр тесттің индекстегі салмағын ескереді.
Vals Index: Carbon-ның салалар бойынша күшті жақтары
Vals Index бойынша Gemini 4 Carbon 29-дан екінші орынды алып, 70,36% нәтиже көрсетті. Алдында Claude Sonnet 5.5 70,85%-бен тұр, ал Carbon-нан кейін Claude Opus 5.5 70,18%-бен келеді. Индекс қаржы, бағдарламалау, құқық және салық бойынша тапсырмаларды біріктіреді; бағыттар АҚШ экономикасындағы үлесіне қарай салмақталады. Сондықтан бұл нақты жұмыс тапсырмаларының жинағындағы бағалау, әмбебап интеллект рейтингі емес.
Carbon-ның Vals профилінде жеке бағыттар мен тесттердегі орындар деректер кесіндісінде мынадай:
| Индекс немесе тест | Нені тексереді | Нәтиже | Орын |
|---|---|---|---|
| Vals Index | жалпы салмақталған индекс | 70,36% | 29-дан 2 |
| Vals Finance Index | қаржылық тапсырмалар | 66,35% | 33-тен 1 |
| Vals Legal Index | құқықтық тапсырмалар | 75,83% | 30-дан 3 |
| EMB v1.1 | кестелердегі қаржылық модельдеу | 76,47% | 35-тен 2 |
| Finance Agent v2.1 | көпқадамды қаржылық тапсырмалар | 67,16% | 33-тен 5 |
| Legal Research Bench | құқықтық зерттеулер | 55,77% | 87-ден 1 |
| Tax Agent Bench | салық зерттеулері | 48,86% | 78-ден 3 |
| Vibe Code Bench v1.1 | қолданбалар жасау | 89,06% | 121-ден 8 |
| HLAB-Vals-1.1 | құқықтық құжаттармен агенттік жұмыс | 17,50% | 30-дан 6 |
| Terminal-Bench 4.0 | пәрмен жолындағы тапсырмалар | 63,13% | 57-ден 4 |
Бұл 2026 жылдың 29 қазанындағы рейтингтердің суреті: модельдер мен нәтижелер қосылған сайын орындар өзгеруі мүмкін. Индекстер мен жеке тесттер әртүрлі тапсырмалар жинағын өлшейді, сондықтан олардың пайыздарын бір-бірімен тікелей салыстыруға болмайды. Мысалы, HLAB-Vals-1.1 бойынша Carbon 27,08% көрсеткен Argon-нан артта қалды: жаңа модель алдынғысынан әр тексеруде күштірек емес. Vals-тің Terminal-Bench нәтижесі де жоғарыда келтірілген Artificial Analysis бағасынан өзгеше, бұл әртүрлі бағалаушылардың жеке іске қосулары.
Баға, токендер және уақыт. Vals тек дәлдікті ғана емес, өз тесттеріне жұмсалған шығынды да көрсетеді. Төменде қолжетімді рейтинг деректеріндегі барлық 11 модель берілген:
| Модель | Vals Index | Тест құны | Тестке токендер | Тест уақыты |
|---|---|---|---|---|
| Claude Sonnet 5.5 | 70,85% | $18,70 | 78,59 млн | 1 сағ 26 мин |
| Gemini 4 Carbon | 70,36% | $10,51 | 18,29 млн | 47 мин 45 с |
| Claude Opus 5.5 | 70,18% | $28,12 | 59,46 млн | 1 сағ 25 мин |
| Gemini 4 Argon | 69,24% | $13,37 | 23,31 млн | 44 мин 58 с |
| Wonder Full | 66,79% | $6,81 | 18,37 млн | 59 мин 19 с |
| GPT-6 Astra | 65,02% | $21,28 | 8,15 млн | 33 мин 39 с |
| Wonder | 64,88% | $10,65 | 33,19 млн | 35 мин 24 с |
| GPT-6.1 Sol | 63,94% | $3,61 | 9,40 млн | 44 мин 24 с |
| Kimi K3.1 Pro | 62,52% | $6,44 | 20,14 млн | 1 сағ 4 мин |
| DeepSeek V4.1 Flash 1017 | 61,26% | $0,66 | 43,90 млн | 39 мин 55 с |
| GPT-6.1 Terra | 60,47% | $2,92 | 17,44 млн | 39 мин 35 с |
Осы жинақта Carbon Sonnet-ке жақын нәтиже көрсетті, бірақ құны төмен әрі уақыты шамамен екі есе аз; Opus-пен салыстырғанда оның есептелген құны шамамен 2,7 есе төмен. Бұл Vals-тің индекс тапсырмаларына арналған көрсеткіштері, кәдімгі сұраныстың құны немесе GPTunneL тарифі емес. Токендер саны өздігінен бағаны анықтамайды: кіріс және шығыс токендері әртүрлі тарифтеледі. Деректер кесіндісі кезінде Carbon-ның жалпыға қолжетімді API-і әлі жоқ, сондықтан құнды бағалауды оны ашқаннан кейін қайта тексеру керек.
Индекстің құрылымы. Vals әр бағыттағы тест нәтижелерінің орташа мәнін алады, содан кейін бағыттарды АҚШ ЖІӨ-дегі сәйкес салалардың үлесіне негізделген салмақтармен біріктіреді: қаржы және сақтандыру - 8,0, бағдарламалауға жуықтау ретінде ақпараттық сектор - 5,6, заңгерлік қызметтер - 1,2, бухгалтерлік және салық қызметтері - 0,5. Қосындыны 15,3-ке бөледі. Осылайша қаржы мен бағдарламалау жалпы бағаның басым бөлігін береді. Бұл таңдалған әдістеме үшін пайдалы бағдар, бірақ ЖИ-дің нақты экономикалық әсерін жеңілдетіп көрсетеді.
Бөлуде Carbon қаржылық EMB модельдеуінде 76,5%, Terminal-Bench-те 63,1%, Vibe Code-та 89,1%, ал индекс пайдаланатын Code Migration іріктемесінде 80,1% көрсетті. Салыстыру үшін, Argon сәйкесінше 74,8%, 57,6%, 91,9% және 74,4% алды. Carbon осы төрт тексерудің үшеуінде алда, ал Vibe Code-та Argon-нан күштірек. Сандар Vals кестесіндегідей дөңгелектенген. Индекс үшін Code Migration іріктемесі толық тест нұсқасынан ерекшеленеді.
Sonnet неге Opus-тан жоғары? Индекстің бұл нұсқасында бағдарламалау тапсырмаларының едәуір салмағы бар. Vals бөлінісі бойынша Sonnet индекс ескеретін Code Migration іріктемесінде 87,4% көрсетті, ал Opus-та бұл 80,5%. Vibe Code Bench-те Sonnet 92,4%, Opus 90,3% алды. Сонымен бірге Opus Terminal-Bench-те және басқа бірқатар тесттерде алда. Нәтиже нәтижелер мен салмақтардың тіркесіміне байланысты, модель линейкасының атына немесе бағасына емес. Vals бағаны дәлдік бағасынан бөлек көрсетеді.
Sonnet мен Opus арасындағы айырмашылық бар-жоғы 0,67 проценттік пункт ғана. Vals олардың бағалары үшін сәйкесінше ±0,93 және ±1,00 пункт көрсетеді. Бұл бағалардың стандартты қателіктері. Осындай бір срезге сүйеніп, шағын артықшылықты Sonnet-тің барлық жұмыс тапсырмаларында Opus-тан сенімді түрде күштірек екенінің дәлелі деп санау дұрыс емес.
Модель осалдықтарды қалай іздейді және түзетеді
Киберқауіпсіздік - Google анонсының басты баса назары. Компания үш сыртқы тесттің нәтижесін келтіреді:
| Тексеру | Нені өлшейді | Carbon нәтижесі Google деректері бойынша |
|---|---|---|
| SEC-bench Pro | бағдарламалық жасақтамадағы осалдықтарды іздеу | 88,2% |
| ExploitGym | осалдықтарды пайдалану мүмкіндігін тексеру | 54,8% |
| CWE-bench | коддағы мәселелерді іздеу және түзету | 71,0% |
Google-дің маңызды ескертуі: бұл киберсынақтар модельдің қорғаныс шектеулерінсіз жүргізілді. Мұндай тексерулердің нәтижелерін болашақ нұсқаға барлық пайдаланушылар үшін автоматты түрде көшіруге болмайды.
CWE-bench кестесінде Carbon pass@1 автоматты тексеруі бойынша 71% нәтижесімен көрсетілген. Argon - 68%. Тестте 120 тапсырма бар, әр модель үшін төрт әрекет қарастырылған, ал бір әрекетке бір сағатқа дейін уақыт беріледі. Осы кестедегі Google-дің екі моделі Antigravity арқылы жұмыс істеді. Басқа қатысушылар басқа агенттік құралдарды пайдаланған болуы мүмкін.
Үш проценттік пункттегі айырмашылықтың практикалық мәні тек тексеру шарттарымен бірге ғана түсінікті. Тіпті жоғары нәтиже модельдің қолданбаңдағы барлық осалдықтарды табатынын немесе оның түзетуін тексерусіз қабылдауға болатынын білдірмейді.
Модель сенімдірек бола ма
Google агенттің жұмыс барысындағы әрекетіне бөлек тоқталады. Компанияның өз тесттерінде Carbon расталмаған тұжырымдардың санын Argon-мен салыстырғанда шамамен екі есеге азайтты. Google командаларының жұмыс орталарында әрекеттің сәйкессіздігінің маңызды сигналдарының саны шамамен 80%-ға төмендеді.
Жанама промпт-инъекциялардан қорғау
Gray Swan IPI тестінде Google 15 әрекетке арналған көрсеткішпен Carbon-ға қарсы 0% сәтті шабуылдарды хабарлайды. Мұнда аз болған сайын жақсы. Салыстыру үшін графикте Argon-да 0,7%, Claude Opus 5.5-те - 1%. Нәтиже нақты тексерілген шабуылдарға және тест шарттарына қатысты.
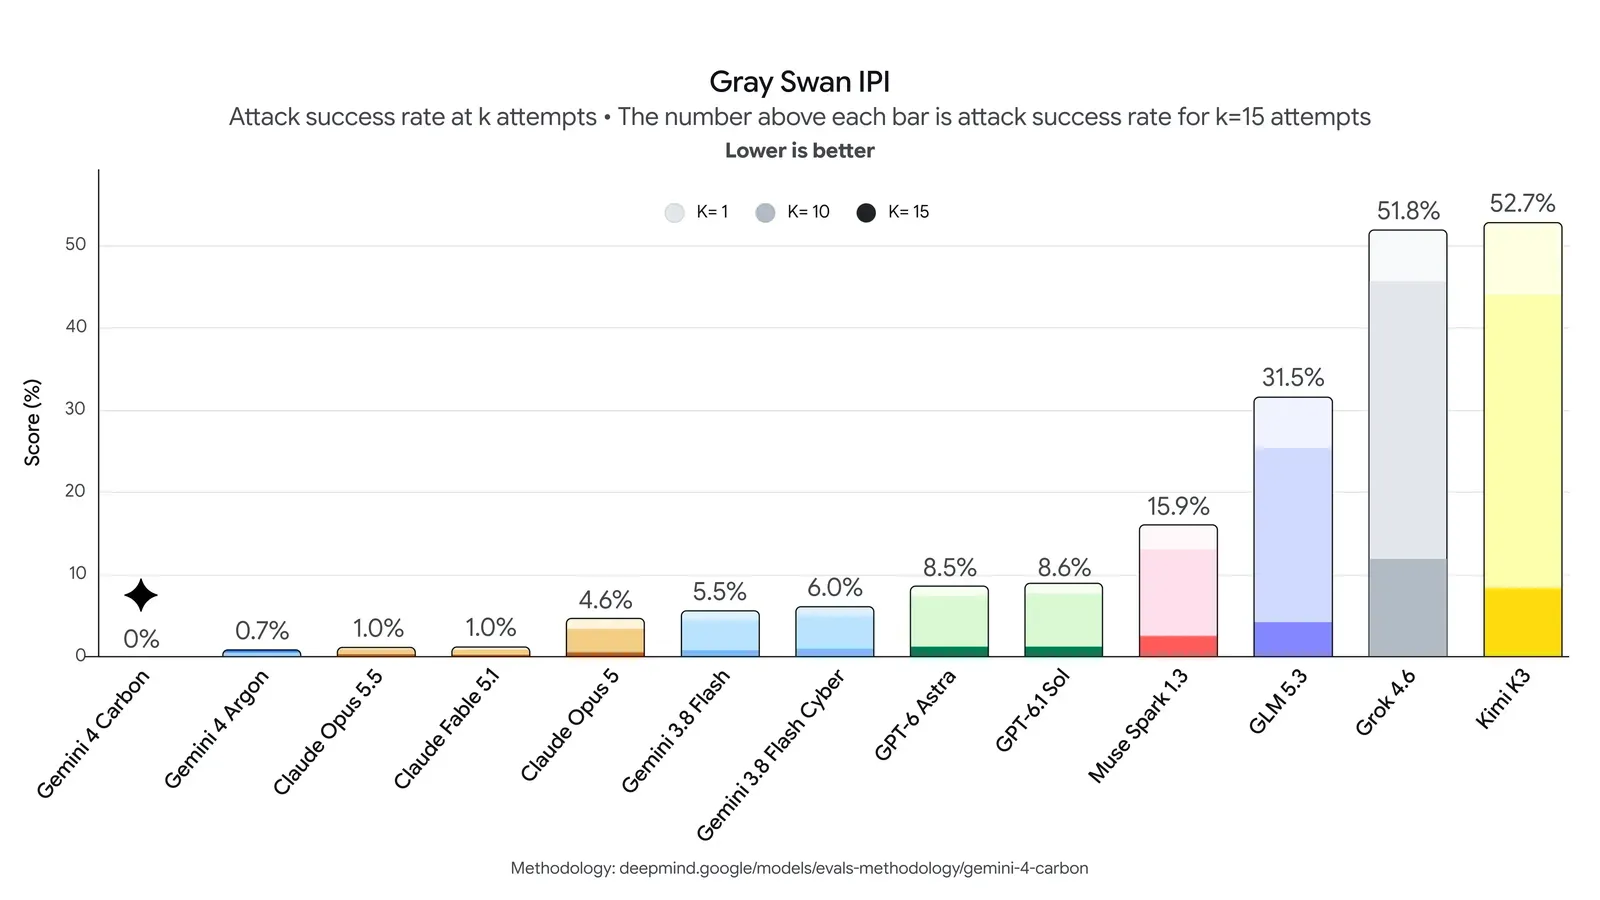
Жанама промпт-инъекция - бұл шабуылдаушы сыртқы материалға, мысалы, бетке, құжатқа немесе агент оқитын хатқа жасырып салатын нұсқау. Ол модельді пайдаланушының тапсырмасын елемеуге және басқа адамның нұсқауын орындауға мәжбүрлеуге тырысуы мүмкін.
Мұндай қорғаныс әсіресе пайдаланушының бақылауында емес мазмұнды оқитын және әрекет ете алатын ЖИ-агенттер үшін маңызды: олар құралдарды іске қосады, файлдарды өзгертеді немесе деректерді жібереді. Мұндай нұсқауларға төзімділік болмаса, шабуылдаушы агентті оның жұмыс үшін ашқан материалы арқылы басқаруға әрекет етуі мүмкін.
Бұл тестте нөл - күшті нәтиже, бірақ болашақтағы барлық шабуылдардан толық қорғайтын кепілдік емес. Жария нұсқада нәтижені әлі практикада тексеру керек.
Сондықтан код бойынша жұмыс істегенде мен әдеттегі тексерулерді сақтар едім: агенттің қол жеткізуін қажетті қалтамен шектеу, өзгерістерді қарау, тесттерді іске қосу және сезімтал учаскелерді бөлек тексеру. Модель іздеуді жеделдетіп, түзетуді дайындай алады, бірақ өзгерістерді қолдану жауапкершілігі команданың мойнында қалады.
Қауымдастықта Gemini 4 Carbon-ды қалай қабылдады
Тек бенчмарктарға және вендордың мәлімдемелеріне ғана емес, осындай релиздерде «ит жеген» тәжірибелі пайдаланушылардың не ойлайтынына да назар аудару орынды. Мен қауымдастықтағы танымал пікірлерді талдадым, және мынадай негізгі тұстарды бөліп көрсетуге болады:
- Бенч-максингке (bench-maxxing) деген скепсис: пікір білдірушілер Gemini 4 Carbon-ның жоғары тест нәтижелерін «қағаз жүзіндегі басымдық» деп атайды. Google тарихи тұрғыдан модельдерді нақты тесттерден өту үшін оңтайландыруда (мысалы, SWE-bench) сынға алынады, бұл әзірлеушілер үшін күнделікті ыңғайлылыққа зиян келтіреді. Алдыңғы Argon моделі де революциялық ретінде жарияланған, бірақ тәжірибеде сол Opus 5.5-тен төмен болды
Жалпы алғанда, модельдер рейтингінің нәтижелеріндегі сәйкессіздікті Artificial Analysis және Arena AI-да байқап отырмыз: біріншісінде модель рейтингте көш бастап тұр, ал Аренада ол 2-6 орында тұрып, Claude Opus 5.5 моделіне жұптық дуэльдердің 70%-ында утылады
-
Қолжетімділік мәселесі: бәрін ашуландырып отырған нәрсе - қазір Carbon АҚШ үкіметінің қауіпсіздік тексеруінде тұр. Пікір білдірушілер нақты релиз болғанға дейін Anthropic Opus пен Fable-дің келесі нұсқаларын шығарып үлгеретінін әзілдейді
-
Атаудың абсурдтығы: Google линейкаларын түсіну үшін химиктің ғылыми дәрежесі керек болатыны туралы көп әжу-мысқыл бар. Carbon моделі (Көміртек, атом нөмірі 6) Argon-нан (Аргон, нөмірі 18) кейін шықты, бұл Менделеев кестесінің барлық логикасын бұзады. Пікір білдірушілер, егер модель көміртек-14-ке негізделген болса, онда жартылай ыдырау периодына байланысты 5730 жылдан кейін салмақтарын жоғалтатынын, ал көміртек-12-ге негізделген болса, бұл тұрақты релиз екенін әзілдейді. Атау соншалықты түсініксіз, сондықтан біреу келесі ИИ моделінің атауы ретінде Gemini Tokyo Drift ұсынды 😄
-
Интерфейс мәселелері: көптеген адамдар Google экожүйесіне шағымданады. Жаңа функцияларды толық пайдалану тек Antigravity CLI-құралы арқылы ғана мүмкін, оны көп адам «кодтауға арналған ең нашар және ең ыңғайсыз фреймворк» деп атайды. Сондай-ақ, көп адам Carbon-мен тәжірибені еске алады: лимиттер таусылғанда Carbon чаты автоматты түрде әлсіз 3.5-lite моделіне ауысып, контекст тарихын толық өшіреді.
-
Сақ оптимизм: кейбіреулер Google-дың фронтир-модельдер жарысына оралып жатқанына қуанады және жаңа модельге мүмкіндік беруге дайын.
Қорытындылай келе, бенчмаксингке қатысты скепсис көп, және фронтир-модельдердің ішінде көшбасшылық әлі де Opus/Fable-да қалады деген күту бар.
Google Carbon, Opus 5.5, Astra 6, Argon жиынтық салыстыруы
Фронтир модельдердің қайсысы жақсырақ екенін анықтауға тырысайық: жаңа Google Carbon ме, әлде Claude Opus 5.5 пе. Astra 6 пен Argon-ды да ыңғайлы болу үшін қостым, бірақ олардың жақсы болатынын ешкім күтпейді. Спойлер: Carbon Google-дың бенчмарктарында жеңеді, бірақ Arena AI-дағы пайдаланушылар Opus-ты таңдайды. Басқа тәуелсіз бенчмарктарда жағдай басқаша.
Жоғарыда талданған кесінділердің нәтижелерін бір кестеге жинадым. Әр жолдың өз дереккөзі мен әдістемесі бар: модельдерді бір жол ішінде салыстыруға болады, бірақ әр түрлі тесттердің ұпайларын жалпы қорытындыға қосуға болмайды.
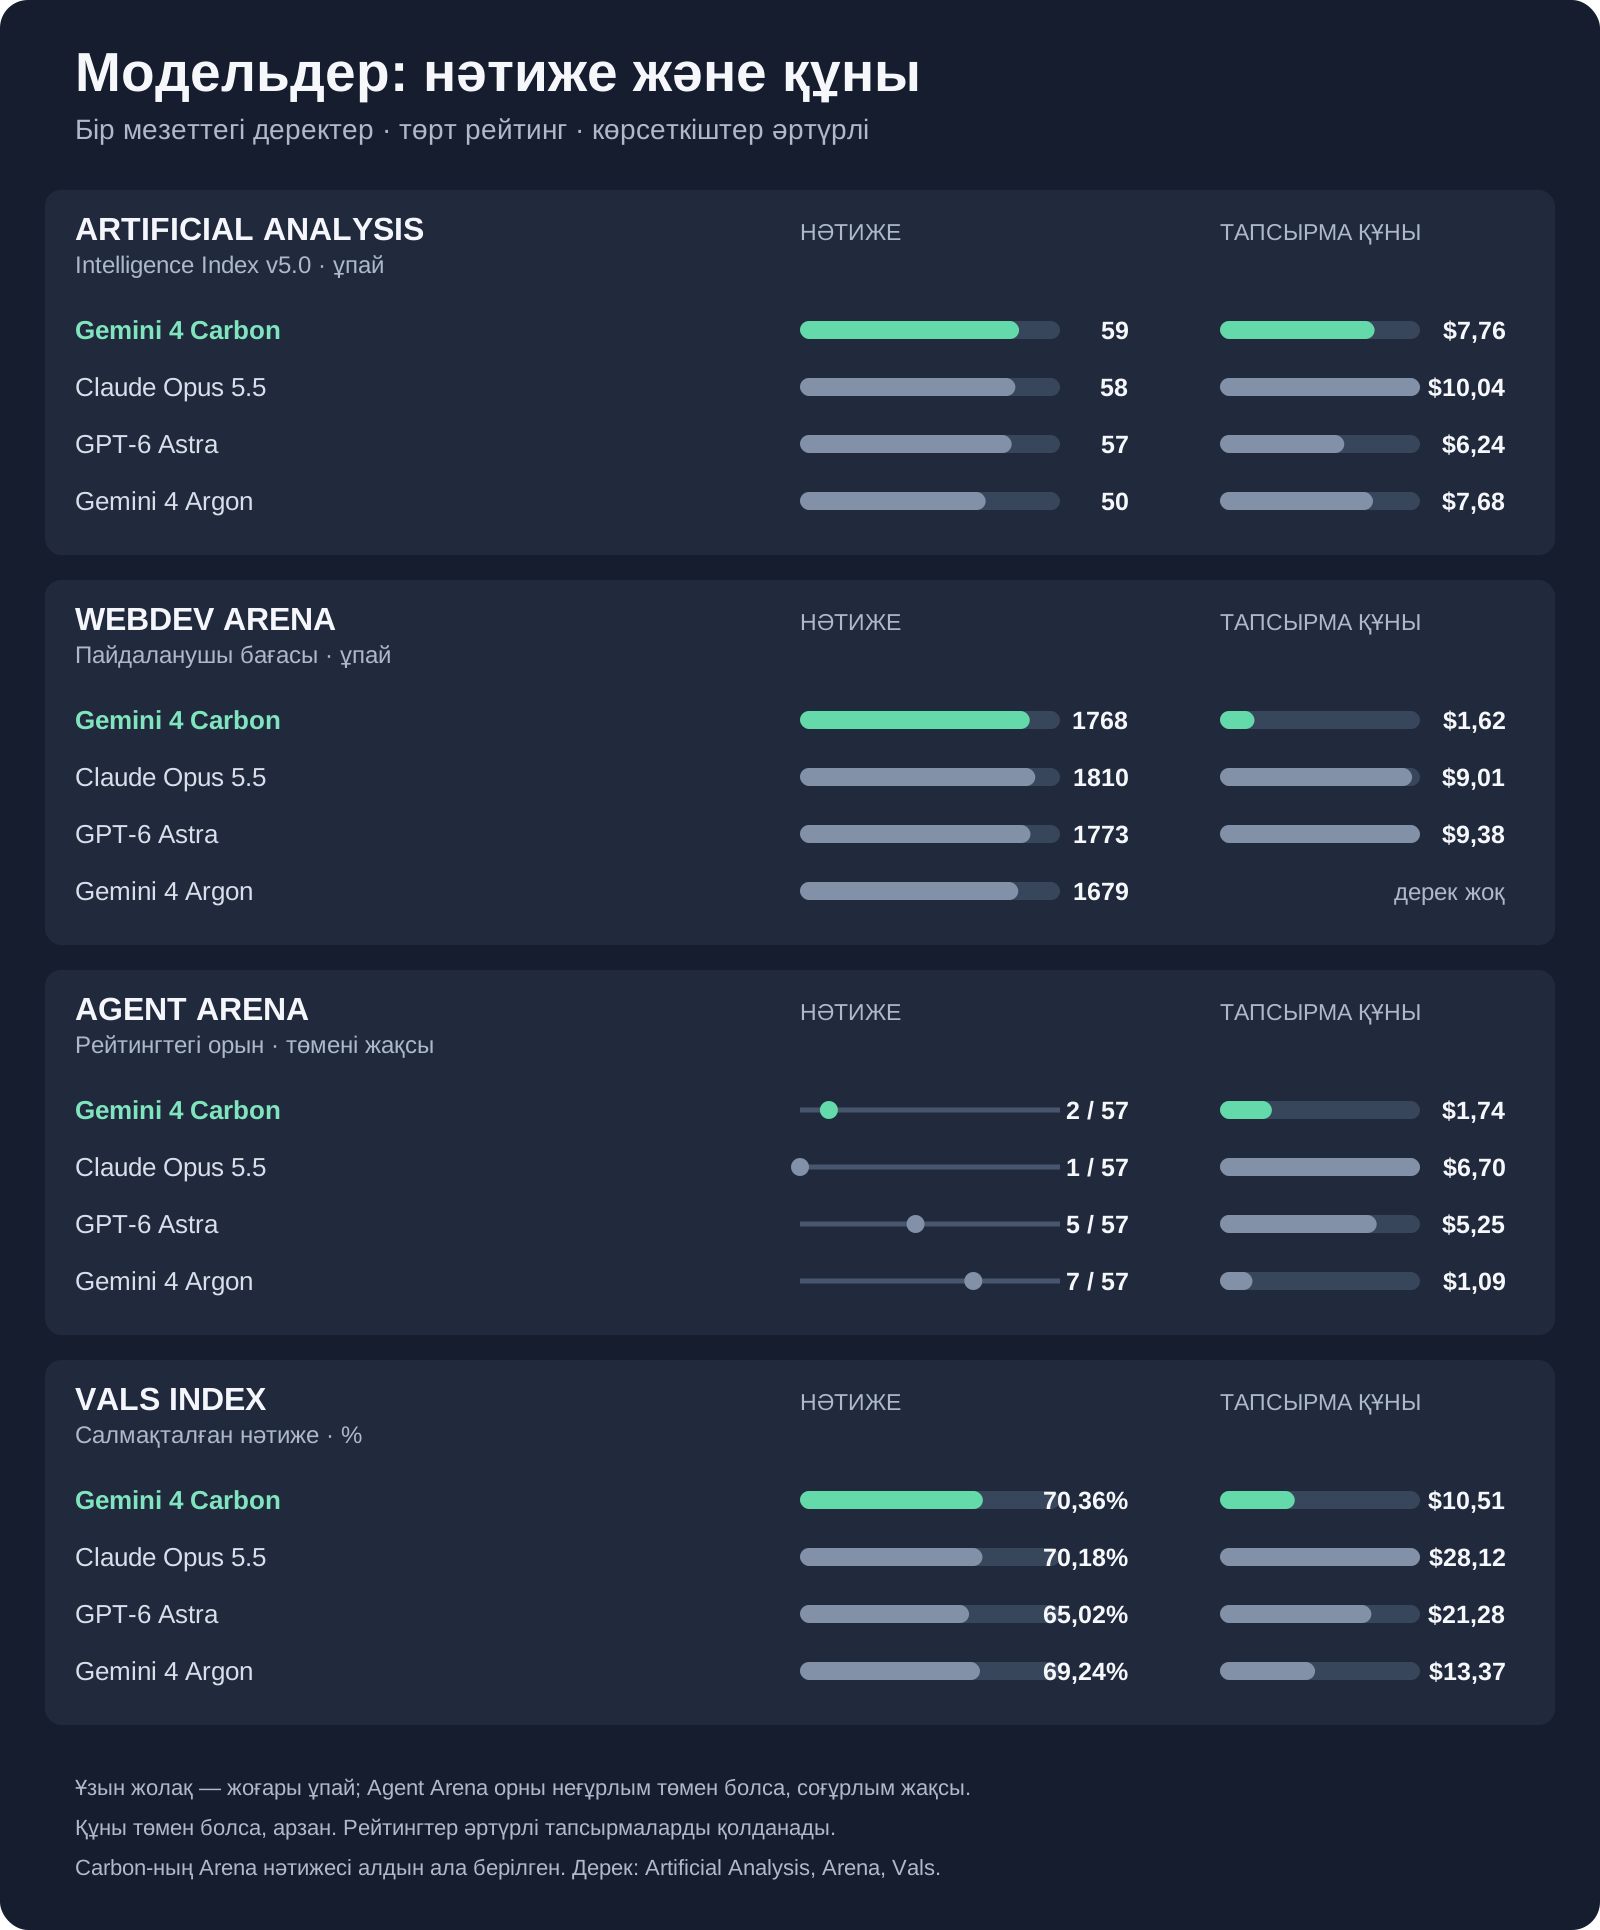
Толық салыстырмалы кесте төменде. Әр жолда төрт модель ішіндегі ең жақсы нәтиже жасыл түспен белгіленген: ұпайлар мен дәлдік үшін көбірек, орын, құн, уақыт, токендер және сәтті шабуылдар үшін азырақ болса жақсы. Бұл міндетті түрде рейтингтің жалпы көшбасшысы емес немесе статистикалық маңызды артықшылық емес.
| Көрсеткіш | Gemini 4 Carbon | Claude Opus 5.5 | GPT-6 Astra | Gemini 4 Argon |
|---|---|---|---|---|
| Жалпы рейтингтер және веб-әзірлеу | ||||
| Artificial Analysis Intelligence Index v5.0, ұпайлар | 59 | 58 | 57 | 50 |
| Artificial Analysis, тапсырма құны | $7,76 | $10,04 | $6,24 | $7,68 |
| WebDev Arena, ұпайлар | 1768 | 1810 | 1773 | 1679 |
| WebDev Arena, тапсырманың медиана құны | $1,62 | $9,01 | $9,38 | — |
| Agent Arena, орын | 2 / 57 | 1 / 57 | 5 / 57 | 7 / 57 |
| Agent Arena, тапсырманың медиана құны | $1,74 | $6,70 | $5,25 | $1,09 |
| Vals Index, дәлдік | 70,36% | 70,18% | 65,02% | 69,24% |
| Vals Index, орын | 2 / 29 | 3 / 29 | 6 / 29 | 4 / 29 |
| Vals Index, тест құны | $10,51 | $28,12 | $21,28 | $13,37 |
| Vals Index компоненттері | ||||
| Finance Agent v2.1 | 67,2% | 67,8% | 60,4% | 67,7% |
| ↳ тапсырма құны | $7,29 | $8,91 | $7,82 | $4,32 |
| EMB v1.1, қаржылық модельдеу | 76,5% | 75,8% | 72,7% | 74,8% |
| ↳ тапсырма құны | $5,76 | $11,02 | $5,83 | $11,80 |
| Terminal-Bench 4.0, Vals бағасы | 63,1% | 65,2% | 59,6% | 57,6% |
| ↳ тапсырма құны | $7,45 | $13,20 | $9,58 | $17,64 |
| Vibe Code Bench v1.1 | 89,1% | 90,3% | 89,6% | 91,9% |
| ↳ тапсырма құны | $8,25 | $57,92 | $38,51 | $8,11 |
| Code Migration v1.1, индекс үлгісі | 80,1% | 80,5% | 78,0% | 74,4% |
| ↳ тапсырма құны, толық тест | — | $72,40 | $62,07 | $44,79 |
| Legal Research Bench | 55,8% | 50,5% | 39,4% | 54,8% |
| ↳ тапсырма құны | $8,74 | $25,16 | $10,58 | $6,45 |
| HLAB-Vals-1.1 | 17,5% | 9,2% | 7,1% | 27,1% |
| ↳ тапсырма құны | $6,52 | $21,38 | $25,46 | $10,55 |
| Tax Agent Bench | 48,9% | 45,6% | 20,7% | 44,6% |
| ↳ тапсырма құны | $6,34 | $15,09 | $5,80 | $3,47 |
| Vals Index-тегі шығындар мен уақыт | ||||
| Токендер бір тестке | 18,29 млн | 59,46 млн | 8,15 млн | 23,31 млн |
| Тест уақыты | 47 мин 45 с | 1 сағ 25 мин | 33 мин 39 с | 44 мин 58 с |
| Агенттік бағдарламалау | ||||
| Artificial Analysis Coding Agent Index v2.0, ұпайлар | 59 | 62 | 55 | 53 |
| ↳ тапсырма құны | $7,74 | $11,42 | $7,04 | $11,73 |
| SWE-sweep, Google кестесі | 9,6% | 3,6% | 9,5% | 4,3% |
| FrontierSWE 2, Google кестесі | 61,2% | 62,3% | 65,5% | 55,0% |
| Terminal-Bench 4.0, Google кестесіндегі AA бағасы | 65,2% | 59,6% | 59,1% | 57,1% |
| Компьютермен жұмыс және жұмыс тапсырмалары: Google кестесі | ||||
| Agents' Last Exam v1.1 | 77,4% | 71,6% | 73,1% | 69,0% |
| OSWorld-2.1, офлайн ішкі жиыны | 81,5% | 87,2% | 80,9% | 74,7% |
| AutomationBench, Zapier | 53,9% | 42,5% | 41,4% | 51,3% |
| Vending-Bench 2, қорытынды балансы | $16 484 | $9 235 | $15 515 | $13 718 |
| Мультимодалдылық және ұзын контекст: Google кестесі | ||||
| Chartography | 72,5% | 66,3% | 71,0% | 71,6% |
| Blueprint-Bench 2, ұқсастық | 58,6% | 51,2% | 49,7% | 54,4% |
| GraphWalks, 256 мың - 1 млн токен, BFS F1 | 96,2% | 66,8% | 71,8% | 84,2% |
| Ғылым және математика: Google кестесі | ||||
| RiemannBench | 80,0% | 69,6% | 72,0% | 76,0% |
| Terminal-Bench-Science 0.1, AA бағасы | 64,8% | 59,0% | 63,3% | 52,9% |
| Киберқауіпсіздік: Google кестесі | ||||
| CWE-bench, осалдықтарды түзету | 71,0% | 67,0% | 68,0% | 68,0% |
| ExploitGym, эксплуатацияны тексеру | 54,8% | 34,5% | 42,4% | 42,0% |
| SEC-bench Pro, осалдықтарды іздеу | 88,2% | — | 85,4% | 83,4% |
| Промпт-инъекцияларға тұрақтылық | ||||
| Gray Swan IPI, сәтті шабуылдар; аз - жақсы | 0% | 1% | — | 0,7% |
Carbon қай жерде ең перспективалы көрінеді. Модельді іздеу және осалдықтарды түзету, код бойынша күрделі көп қадамды тапсырмалар, ұзын құжаттарды талдау, жұмыс процестерін автоматтандыру және қаржылық зерттеулер үшін қарастырған жөн. Киберқауіпсіздік және ұзын контекст тесттерінде ол күшті нәтижелер көрсетті; Coding Agent Index-те Carbon мен Antigravity байланысы Claude Code бар Opus-тан артта қалды, бірақ көрсетілген Astra мен Argon байланыстарынан озды. Бұл жалпы қолжетімділік ашылғаннан кейін тексеруге арналған бағыттар: код түзетулері мен талдамалық қорытындыларды тексеру керек, ал жекелеген тапсырмаларда бәсекелестер күштірек болуы мүмкін.
Дереккөздер: Artificial Analysis, WebDev Arena, Vals Index және тесттер бойынша бөлу, Google анонсы. Arena нәтижелері Carbon мен Argon үшін High режимінде, Opus мен Astra үшін Max режимінде берілген; әр түрлі бағалаушыларда параметрлер мен құралдар әртүрлі болуы мүмкін. Vals көрсеткіштері жекелеген тесттер бойынша оннан бірге дейін дөңгелектенген. Сызықша қолданылған деректерде салыстырмалы мән берілмегенін білдіреді. Құн мен уақыт көрсетілген бағалаушылардың тапсырмаларына қатысты, әдеткі сұраныстарға немесе GPTunneL тарифтеріне емес.
Agent Arena - 28 қазандағы срез: сигнал мәндері орташа модельге қатысты пайыздық пункттермен көрсетілген, ал Carbon нәтижесі алдын ала. Мысалы, Confirmed Success бойынша +18,05 п.п. оның тапсырмалардың 18,05% орындағанын білдірмейді. Орындар мен көрсеткіштер өзгеруі мүмкін; аз айырмашылықтарда бағалардың шашырауы маңызды.
«Google кестесі» белгісі бар жолдар Google DeepMind анонсындағы салыстыруды қайталайды; Terminal-Bench 4.0 және Terminal-Bench-Science 0.1 онда Artificial Analysis бағалары ретінде белгіленген. Киберқауіпсіздік тесттері модельдің қорғаныс шектеулерінсіз жүргізілді. GraphWalks ұзын контекстегі нәтижені өлшейді, Carbon-ның жария контекстік терезесінің өлшемін анықтамайды. Vending-Bench 2 балансы - агенттің жұмысын симуляциялау нәтижесі, тапсырма құны емес.
Coding Agent Index v2.0 модель мен агенттің комбинацияларын бағалайды: Carbon мен Argon Antigravity CLI-де High режимінде, Opus Claude Code-та Max режимінде резервтік модельмен, Astra Codex-те Max режимінде тексерілді. Құн индекс тапсырмалары үшін API тарифтері бойынша есептелген; Astra нәтижесі және оның құны Codex үшін берілген. Нәтиже құралға да, модельге де байланысты.
Стоимость задач Vals взята из таблиц соответствующих тестов: Finance Agent, EMB, Terminal-Bench, Vibe Code, Legal Research, HLAB және Tax Agent. Code Migration үшін толық тесттің бағаланған құны көрсетілген, ал жоғарыдағы жолдағы дәлдік - индекс үлгісі бойынша; Carbon-ның толық тесті үшін құн қолжетімді кестеде көрсетілмеген. Бағалар нәтиженің сапасын ескермейді және GPTunneL тарифтері емес.
Carbon осы төрт модель арасында Intelligence Index және Vals Index бойынша көшбасшы, бірақ WebDev Arena-да Opus пен Astra-дан артта қалады. Vals-тың жекелеген тесттерінде ол бәрінде бірінші емес: мысалы, Terminal-Bench-те Opus күштірек, ал HLAB-та - Argon. Vals-тағы Carbon мен Opus-тың жалпы бағаларының айырмашылығы аз, сондықтан таңдауды өз тапсырмаларыңызда тексерген жөн.
Әзірге белгісіз нәрселер
Google жариялауда жаппай қолжетімділіктің нақты күнін, Carbon-ның контекстік терезесінің өлшемін және API үшін жария модель идентификаторын көрсетпеген. Оларды Argon сипаттамаларынан автоматты түрде алуға болмайды. Нақты жылдамдықты, әдеттегі тапсырманың бағасын және өз кодыңыздағы жұмыс сапасын да әлі тексеру керек.
Әзірге Carbon-ды күшті алғашқы нәтижелері және шектеулі қолжетімділігі бар перспективалық модель ретінде қарастырған дұрыс. Егер қазірдің өзінде Argon-мен жұмыс істесең, бір мысал тапсырманы және оның нәтижесін сақтап қой: Carbon ашылғаннан кейін модельдерді бірдей промпт, сол құралдар мен тесттермен салыстыруға болады.
Егер саған осы отбасының қазір қолжетімді моделі керек болса, Gemini 4 Argon және біздің оның іске қосылуына шолуымызды қарауға болады.