
24 қазанда жаңартылды. Artificial Analysis, Arena, Bug Hunt Bench және түпнұсқа StealthMark бенчмаркының тәуелсіз нәтижелері шықты, сондықтан мақаланы осы деректерден бастаймын, ал Moonshot-тың өз сандары материалдың соңына жақын болады. Шолу барынша толық болуы үшін барлық бенчмарктарды, қауымдастықтың релиз туралы пікірлерін және 3D мүмкіндіктерінің демонстрацияларын жинауға тырыстым.
Сонымен, жаңа Kimi K3.1 Pro шынымен Claude Opus 5.5-ке теңесті ме? Қысқа жауап: жақын, бірақ әлі емес, және төменде жазған екі кемшілік бар, соның ішінде модельді бенчмарктарға «жаттықтырған» деген күдік.
Moonshot Kimi K3.1 Pro-ны 23 қазанда шығарды - сол күні таңертең компания модель атауын бейнеде өзі алдын ала көрсеткен болатын. Moonshot тесттерінде жаңа Kimi Claude Opus 5.5-пен дерлік тең жүр: Terminal-Bench 4.0-де 66,4%-ке қарсы 65,7%, ал он төрт тесттің алтауында бірінші орында. Онымен бірге K3.1 Pro Highspeed шықты - сол модель, бірақ 2-3 есе жылдам.
Релиз алдындағы ағып кетулерді жеке бөлімге жинадым: хронологияны және LuminaBench-тің сөзінше, K3.1-де шыққанға дейін жасалған воксельді пагода бейнесін.
Artificial Analysis өлшемдері
Moonshot-та да бар төрт тестте Artificial Analysis сандары вендордікінен 3,2 ұпайдан аспайтын шамаға ауытқиды, ал Terminal-Bench 4.0-де Artificial Analysis нәтижесі тіпті жоғары: 65,7-ге қарсы 67,2.
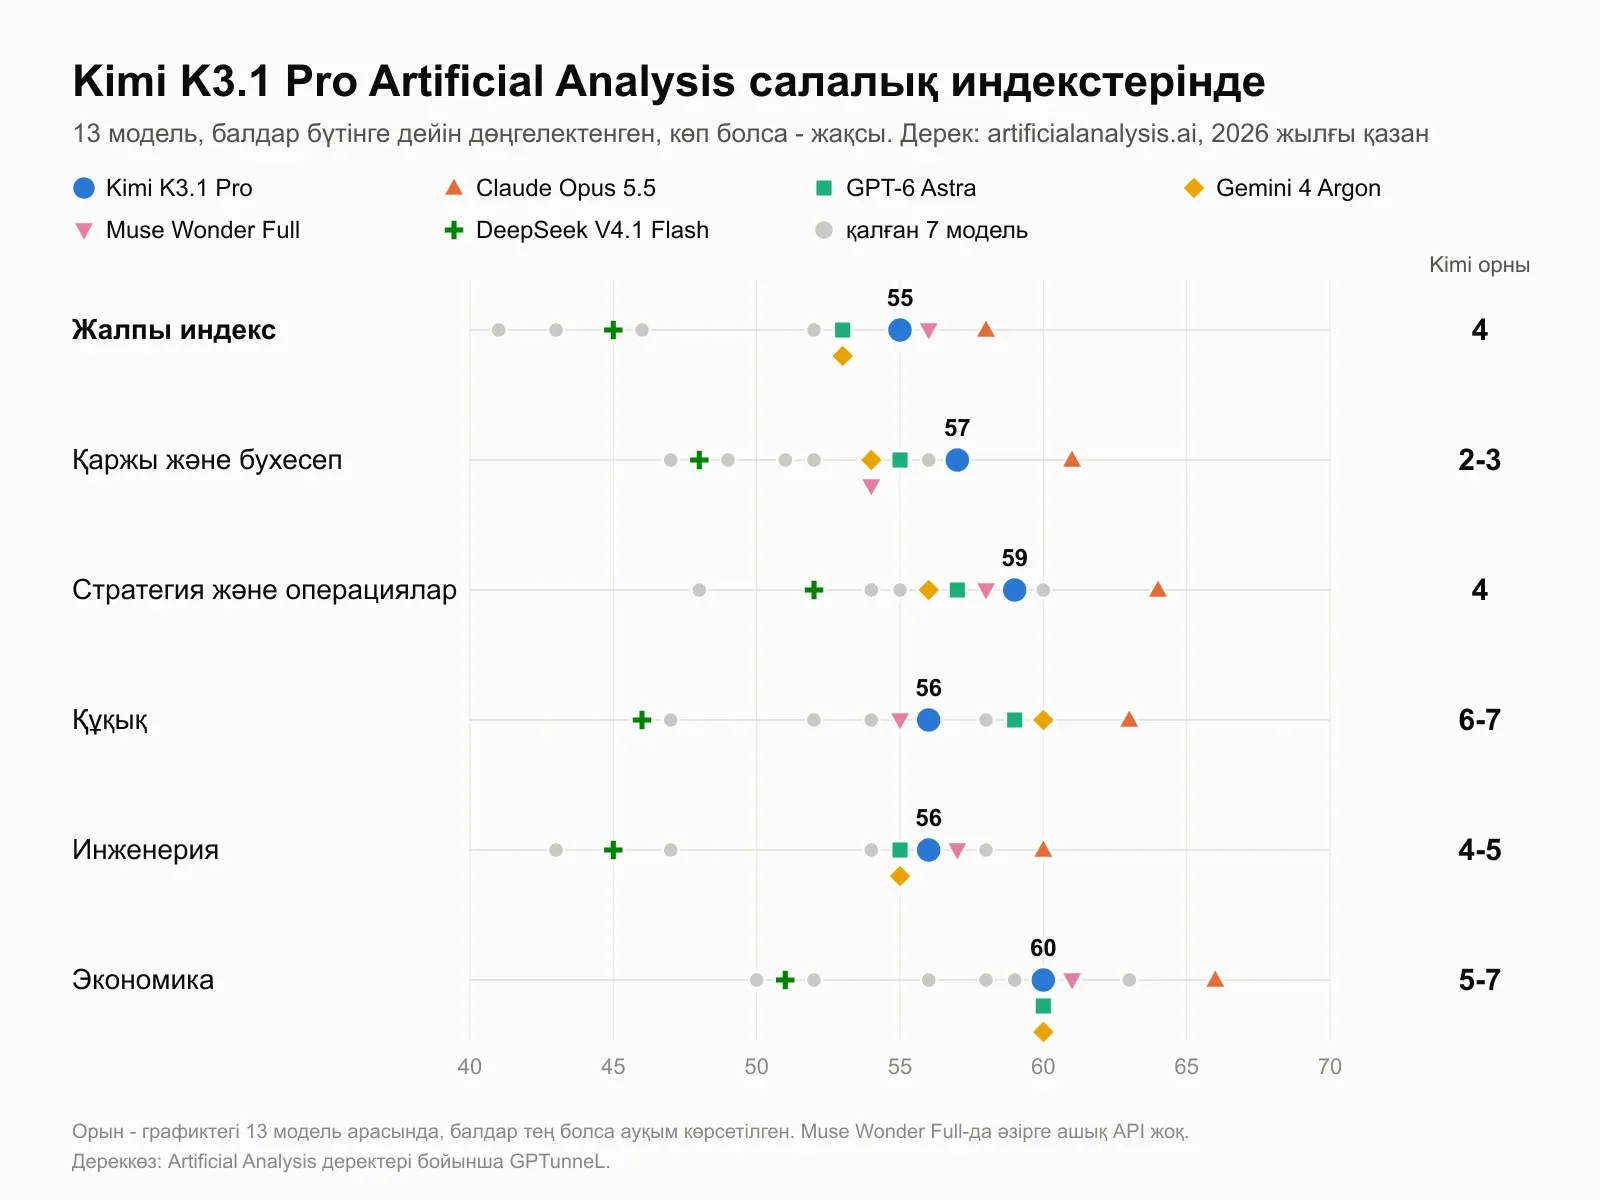
Artificial Analysis модельдерді өз тесттер жинағында тексеріп, жалпы индексті және салалық индекстерді есептейді - қаржы, құқық, инженерия және басқа тапсырмалар үшін. Мен оларды рейтингтің жоғарғы бөлігіндегі 13 модель үшін жинадым.
Кесте деректерін көрсету
| Модель | Жалпы | Қаржы және бухесеп | Стратегия және операциялар | Құқық | Инженерия | Экономика |
|---|---|---|---|---|---|---|
| Claude Opus 5.5 | 58 | 61 | 64 | 63 | 60 | 66 |
| Claude Sonnet 5.5 | 56 | 57 | 60 | 56 | 58 | 61 |
| Kimi K3.1 Pro | 55 | 57 | 59 | 56 | 56 | 60 |
| Muse Wonder Full | 56 | 54 | 58 | 55 | 57 | 61 |
| Claude Fable 5.1 | 53 | 56 | 60 | 60 | 56 | 63 |
| GPT-6 Astra | 53 | 55 | 57 | 59 | 55 | 60 |
| Gemini 4 Argon | 53 | 54 | 56 | 60 | 55 | 60 |
| GPT-6.1 Sol | 52 | 54 | 57 | 58 | 54 | 59 |
| Muse Wonder | 52 | 51 | 55 | 52 | 54 | 58 |
| Grok 4.7 | 46 | 52 | 54 | 54 | 47 | 56 |
| DeepSeek V4.1 Flash | 45 | 48 | 52 | 46 | 45 | 51 |
| MiniMax-M3.1-Flash | 43 | 49 | 55 | 47 | 43 | 50 |
| Gemini 3.8 Flash | 41 | 47 | 48 | 52 | 43 | 52 |
Дереккөз: Artificial Analysis, 2026 жылғы 24 қазан.
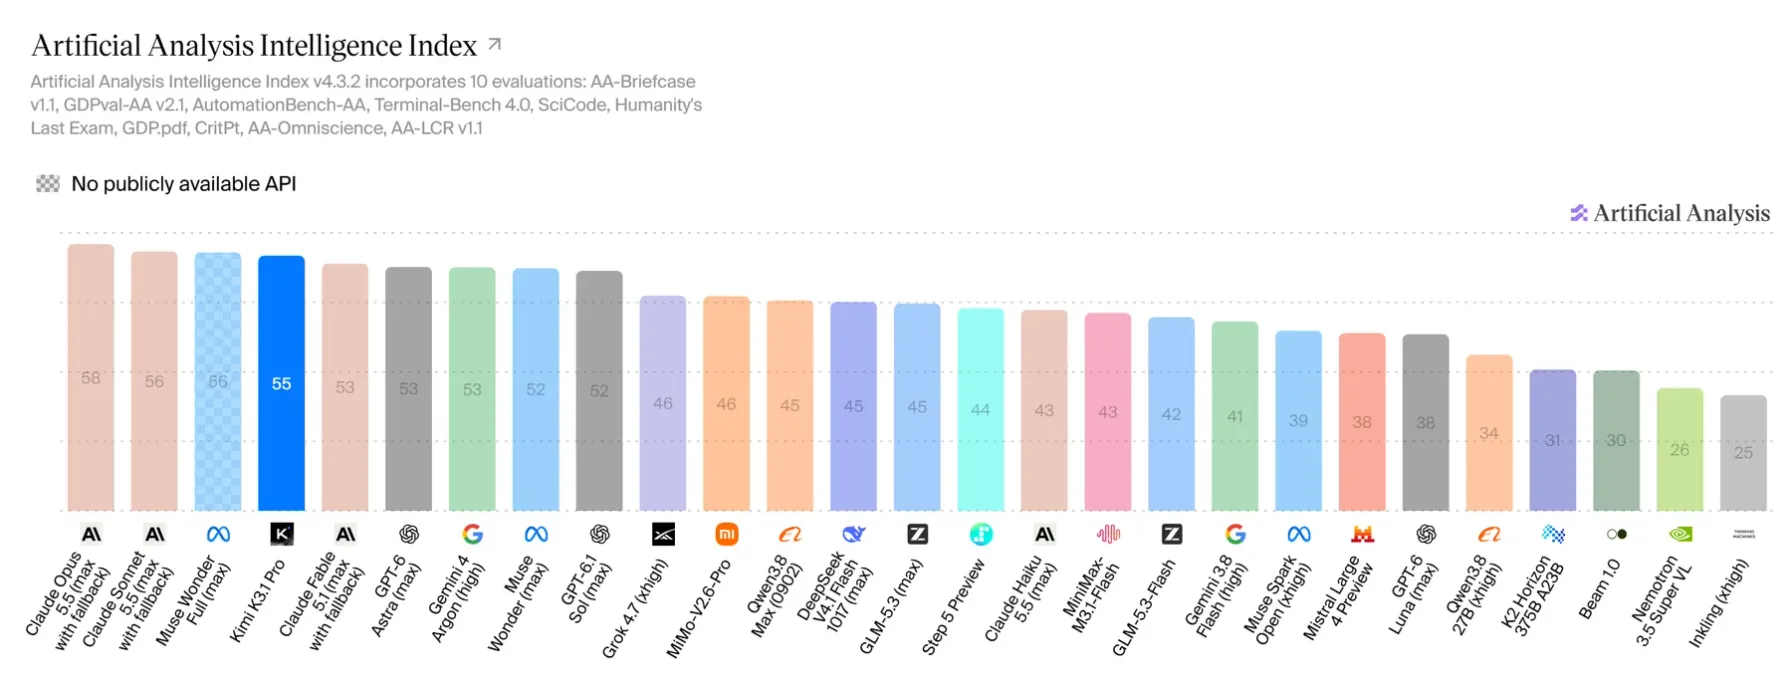
- Жалпы индекс - 55 балл, 215 модельдің ішінде 4-орын. Одан жоғары тек Claude Opus 5.5 (58), Claude Sonnet 5.5 (56) және Muse Wonder Full (56). Kimi K3-те 44 болған, яғни өсім - 11 балл.
- Жылдамдық - секундына 77 токен. K3-те 36,9 болған, яғни жаңа модель шамамен екі есе жылдам. Бірақ бұл әлі де нарықтың ортасы: 186-ның ішінде 102-орын. Алғашқы токен 2,89 секундтан кейін келеді.
- Модель сөзшең. Индексті өткізуге ол 87 млн медианаға қарсы 150 млн шығыс токен жұмсады. Индекстің бір тапсырмасы $2,11 тұрды.
Opus 5.5 алты индекстің бәрінде бірінші, Kimi-ден айырмашылығы - 3-тен 7 баллға дейін. K3.1 Pro қаржыда ең жақын келеді: 61-ге қарсы 57, Sonnet 5.5-пен бірге екінші-үшінші орын. Ең алыс - құқықта: 63-ке қарсы 56, мұнда Kimi тек алтыншы-жетінші, одан Fable 5.1, Gemini 4 Argon, GPT-6 Astra және GPT-6.1 Sol озады.
Muse Wonder Full-да әзірге ашық API жоқ, сондықтан жұмысқа алуға болатын модельдердің ішінде K3.1 Pro жалпы индекс бойынша үшінші.
Arena-дағы орын
Релизден 26 минуттан кейін Arena жаңа Kimi қай орынға тұрғанын көрсетті. Arena-да модельдерді тірі пайдаланушылар салыстырады: соқыр түрде екі жауап алып, жақсысын таңдайды.
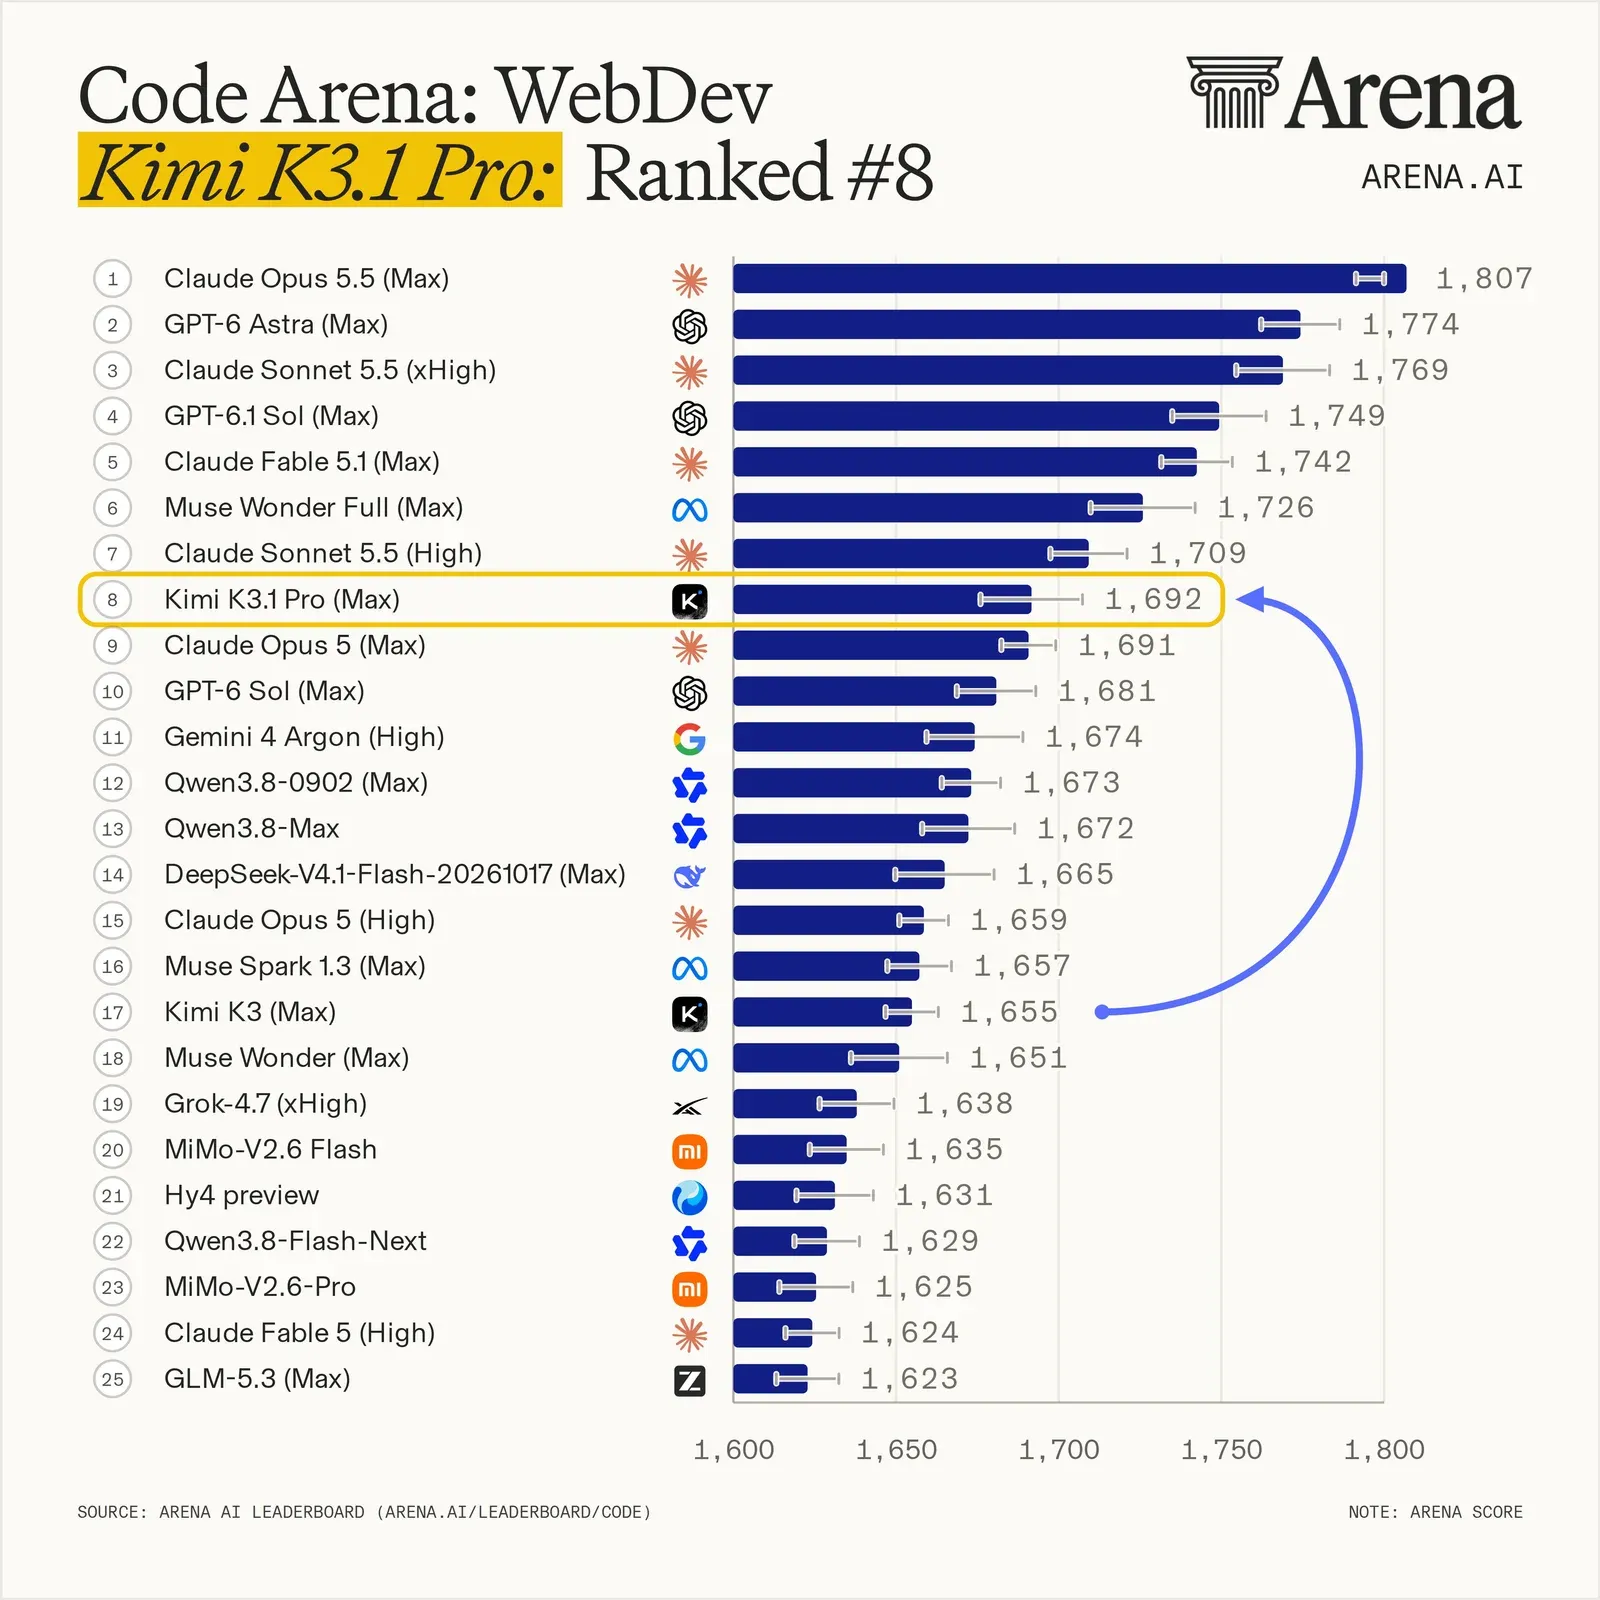
Сайттар мен веб-қосымшалар жасауды бағалайтын Code Arena: WebDev-те Kimi K3.1 Pro 1692 ұпаймен 8-орынға тұрды - 1691 ұпайы бар Claude Opus 5 (Max)-тың дәл қасында. Kimi K3 (Max)-пен салыстырғанда бұл плюс 9 орын және 37 ұпай. Arena салмақтар шыққаннан кейін K3.1 Pro осы рейтингтегі бірінші ашық модель болатынын бөлек атап өтеді.
Дереккөз: Arena X-те, 2026 жылғы 23 қазан.
Arena-да тапсырма түрлері бойынша бөлімдер де, агенттердің жеке рейтингі де бар - Agent Arena, онда модельді нақты сессиялар бойынша бағалайды: тапсырманы соңына дейін жеткізді ме, пайдаланушы риза ма, модель түзетулерге құлақ асады ма.
| Arena рейтингі | Kimi K3.1 Pro орны | Kimi нәтижесі | Көшбасшы |
|---|---|---|---|
| Code Arena: WebDev, жалпы | 8 | 1692 | Claude Opus 5.5 (Max), 1807 |
| WebDev: бренд және маркетинг | 7 | 1704 | Claude Opus 5.5 (Max), 1804 |
| WebDev: деректер және талдау | 11 | 1606 | GPT-6 Astra (Max), 1683 |
| Agent Arena, жалпы | 11 | +7,61% | Claude Opus 5.5 (Max), +20,77% |
Жаңа Kimi бренд және маркетинг тапсырмаларында ең жақсы көрінеді: онда ол жетінші және Kimi K3-тен 26 ұпайға озады. Деректер мен талдауда ол тек он бірінші, ал Agent Arena-да ең көп қалады: қорытынды көрсеткіші Opus 5.5-тен дерлік үш есе төмен.
Барлық орындар әзірге алдын ала. Бөлімдерде Kimi-де 282-ден 515-ке дейін дауыс бар, сондықтан ауытқу үлкен: талдауда модель 3-тен 29-орынға дейін кез келген жерде болуы мүмкін. Бөлімдер сандары - arena.ai-дың 22-23 қазандағы деректері бойынша.
Бірінші кемшілік: Bug Hunt Bench
Bug Hunt Bench - The Product Compass рассылкасының авторы Павел Хурынның тәуелсіз тесті. Екі нақты жұмыс жобасына 105 қате жасырылған: TypeScript-тегі VS Code кеңейтімінде 45 (шамамен 28 мың жол) және React пен Supabase-тегі оқу платформасында 60 (шамамен 60 мың жол). Қателердің көбі - жобалардың өз тарихынан алынып, қайта енгізілген нақты регрессиялар. Тесттер бұл ретте жасыл болып қалады, сондықтан ешқандай нұсқау жоқ.
Әр модель бірдей промпт пен әр жобаға бір әрекет алады, өзінің агенттік құралында жұмыс істейді. Нәтижені тәуелсіз төреші жасырын жауаптар тізімі бойынша тексереді және кімнің жұмысы екенін білмейді. Тек жасырылған қателер есептеледі. Ең үздік модельдердің өзі бәрін таппайды: 105 қатенің 25-ін әзірге ешкім түзетпеді.
Kimi K3.1 Pro релиз шыққан күні, ойлаудың ең жоғары деңгейінде және Moonshot-тың өз API-і арқылы тексерілді. Обвязка (харнесс) Kimi Code емес, Anthropic-тің Claude Code-ы болды - және бұл кездейсоқ емес: Moonshot K3.1 Pro-ның код бойынша тесттерін өзі Claude Code-та өткізді, сондықтан автор сол құралды алды. Шарттар вендор сандары алынған шарттармен сәйкес келеді.
Нәтиже - 105-тен 36, үш іске қосудың орташасы. Бұл басқа топ модельдердің ең жақсы іске қосуларынан айтарлықтай төмен, бірақ алдыңғы Kimi K3-тен жоғары.
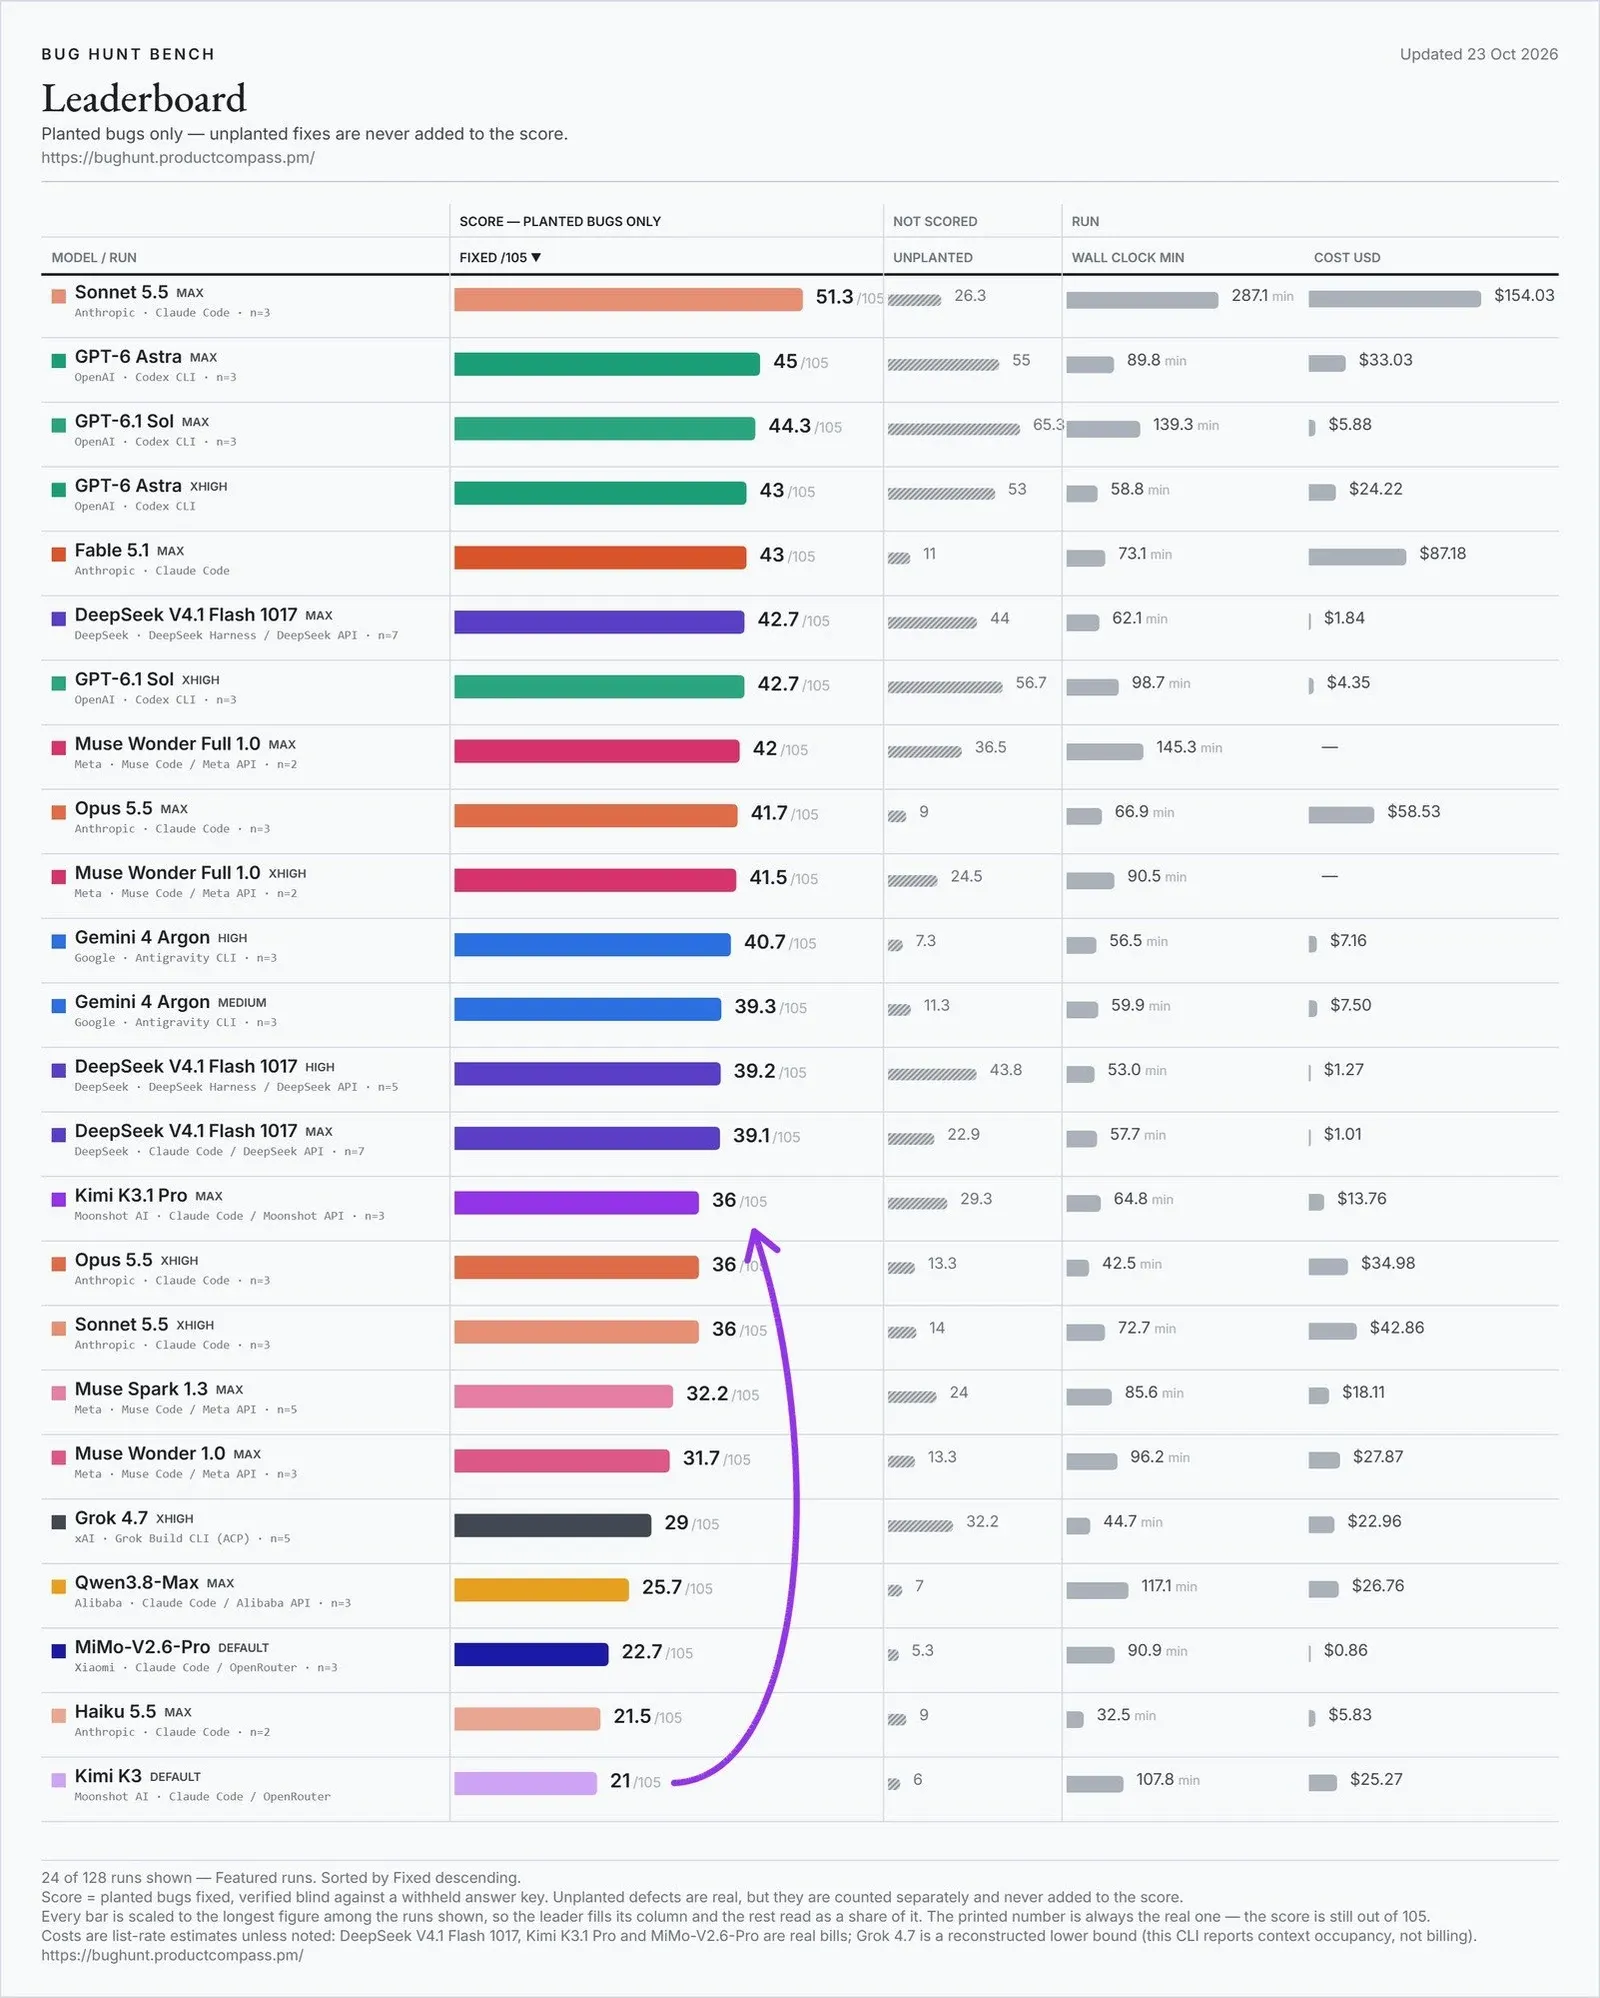
Дереккөз: Bug Hunt Bench, 2026 жылғы 23 қазандағы жаңарту.
Кесте деректерін көрсету
| Модель, деңгей | 105-тен түзетілді | Уақыт, мин | Іске қосу құны |
|---|---|---|---|
| Claude Sonnet 5.5, max | 51,3 | 287,1 | $154,03 |
| GPT-6 Astra, max | 45 | 89,8 | $33,03 |
| GPT-6.1 Sol, max | 44,3 | 139,3 | $5,88 |
| Claude Fable 5.1, max | 43 | 73,1 | $87,18 |
| DeepSeek V4.1 Flash, max | 42,7 | 62,1 | $1,84 |
| Muse Wonder Full, max | 42 | 145,3 | - |
| Claude Opus 5.5, max | 41,7 | 66,9 | $58,53 |
| Gemini 4 Argon, high | 40,7 | 56,5 | $7,16 |
| Kimi K3.1 Pro, max | 36 | 64,8 | $13,76 |
| Claude Opus 5.5, xhigh | 36 | 42,5 | $34,98 |
Ащы деталь: DeepSeek V4.1 Flash, ол да ашық модель, дерлік 7 қатені көбірек түзетті және 7,5 есе арзанға түсті. Тест авторы бұдан қатаң қорытынды жасады:
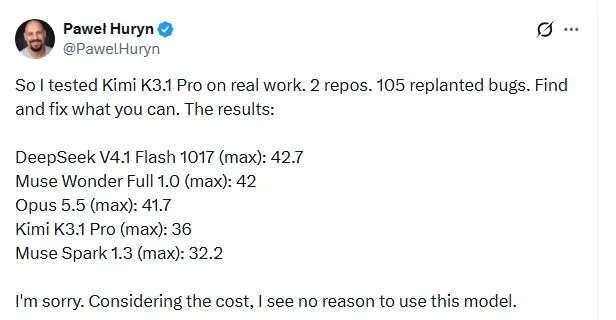
«Кешіріңіз, бірақ құнын ескергенде бұл модельді пайдалануға ешқандай себеп көрмеймін».
Дереккөз: Павел Хурын X-те, 2026 жылғы 23 қазан.
Kimi нәтижесі тұрақсыз да. Үш іске қосу 36, 42 және 30 қате берді - ауытқу 12 ұпай. Үшінші іске қосуда екінші жобада модель шамамен 128 мың токен контекст белгісінде ойлауында да, қорытынды жауабында да мағынасыз мәтін шығара бастады, ал 3,9 минуттан кейін есепсіз және бірде-бір түзетусіз жұмысын аяқтады. API бұл ретте ешқандай қате қайтармады. Бұл әрекет қайта іске қосылды. Егер оны нөл деп есептесе, орташа 32 болар еді.
Салыстыру үшін, алдыңғы Kimi K3 105-тен 21-ін түзетті. Бірақ оны үшінші тарап провайдері арқылы және әдепкі ойлау деңгейінде іске қосқан, сондықтан өсімді толығымен жаңа модельге жатқызуға болмайды.
StealthMark: тағы бір түпнұсқа бенчмарк
Stealth Models-тің StealthMark-ы - модельдер дайындала алмаған түпнұсқа тапсырмалардағы тағы бір тәуелсіз тест: нақты нұсқаулар құпия сақталады, нәтижелер соқыр түрде бағаланады және әр сәтсіздік есептеледі. Физикалық және кеңістіктік ойлауды, көп қадам алға жоспарлауды және идеяны дәл суретке айналдыру қабілетін тексереді. Ағымдағы 1.8.5 нұсқасында - 8 тест және 52 модель.
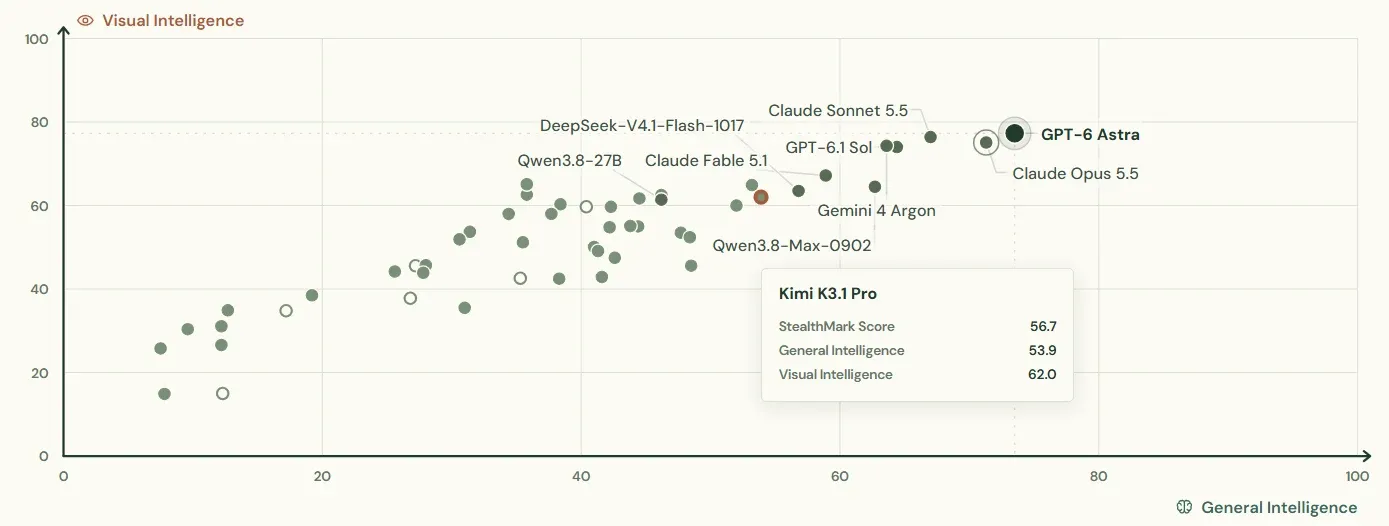
Дереккөз: StealthMark, 2026 жылғы 23 қазан.
Kimi K3.1 Pro мұнда 52-нің ішінде 56,7 баллмен 11-орында: жалпы интеллект үшін 53,9 және визуалды үшін 62,0. Алда GPT-6 Astra (74,8), Claude Opus 5.5 (72,7) және Claude Sonnet 5.5 (70,3) - және тағы да 59,2 балы бар DeepSeek V4.1 Flash. Алдыңғы Kimi K3 50,7 жинап, 15-орында тұр.
Релизді қалай қабылдады және екінші кемшілік
Релизден кейінгі алғашқы тәулікте модельді Reddit-тегі r/singularity қауымдастығында белсенді талқылады. Талқылаудың негізгісін жинадым:
- Лимиттер мен кезектер. $100-лық жазылым қалыпты жұмыстың шамамен бір сағатына ғана жетеді, ал Kimi Code-тағы бес сағаттық терезе 10 минутта бітеді деп жазады. Тағы бір шағым - жаңа Kimi модельдерінде тәуліктің кез келген уақытында «қарбалас сағат» және кезек.
- Moonshot сандарына күмән. Ең жиі реакция - модельді тесттерге «жаттықтырды» деген күдік. Нақты дәлел: Moonshot қате тапсырмалары көп Humanity's Last Exam-ның ескі нұсқасына сүйенеді. Тазартылған HLE-Diamond нұсқасында Moonshot-тың өз кестесі бойынша K3.1 Pro-да 39,4, ал Opus 5.5-те 60,9. Bug Hunt Bench өлшемдері күмәннің негізді екенін көрсетеді: жұмыс жобаларындағы нақты қателерде модель 105-тен 36-ын түзетті - Opus 5.5-тен, Fable 5.1-ден және тіпті DeepSeek V4.1 Flash-тен аз, дегенмен Moonshot тесттерінде ол Opus-пен дерлік тең жүрді.
- «Біркелкі емес» модель. Қауымдастықтың бір бөлігі қытай модельдері демо жақсы көрінетін жерде - фронтенд пен 3D-да - күшті, ал қалғанында әлсіз деп санайды. Бұл сандармен сәйкес келеді: Terminal-Bench Science-та K3.1 Pro-да 38,1, ал GPT-6 Astra-да 68,1.
- Жақсы пікірлер де бар. Бағдарламалау бойынша өз бенчмаркының авторы K3.1 Pro Claude Fable 5.1-мен бірдей жинайтынын, ал басты айырмашылық жылдамдықта екенін жазады. Талқылауда салмақтар шыққаннан кейін бұл ашық модельдер үшін жаңа межеге айналатыны туралы да көп айтылады.
Kimi K3.1 Pro релизінің мәліметтері
Екі маңызды деталь. Біріншісі: K3.1 Pro - жаңа модель емес, қосымша оқытылған K3, сондықтан өсім сол негізде алынған. Екіншісі: Moonshot бірден жылдам нұсқасын шығарды. Kimi K3 тегін режимде ұзақ кезектер мен баяу жауаптарға байланысты іс жүзінде қолдануға келмейтін, ал Highspeed мұны түзетсе, пайдаланушы үшін айырмашылық тесттердегі кез келген өсімнен байқалатынырақ болады.
Moonshot K3.1 Pro-ны K3.1 сериясының алғашқы моделі және ашық салмақтары бар ең күшті моделі деп атайды. Компанияның сөзінше, бұл постоқытуға едәуір көп есептеу қуаты жұмсалып, қосымша оқытылған Kimi K3.
| Параметр | Kimi K3.1 Pro | Kimi K3 |
|---|---|---|
| Негізі | қосымша оқытудан кейінгі Kimi K3 | Kimi K2.6-дан кейінгі жаңа буын |
| Архитектура | Mixture of Experts, 2,8 трлн параметр, оның 104 млрд-ы белсенді | Mixture of Experts, 2,8 трлн параметр, оның 104 млрд-ы белсенді |
| Контекст | 1 048 576 токен | 1 048 576 токен |
| Жауап | әдепкі бойынша 131 072 токенге дейін | әдепкі бойынша 131 072 токенге дейін |
| Не қабылдайды | мәтін, сурет, бейне | мәтін, сурет, бейне |
| Ойлау режимі | әрдайым қосулы, low, high және max деңгейлері, әдепкі бойынша max | әрдайым қосулы, low, high және max деңгейлері, әдепкі бойынша max |
| Нұсқалар | Pro және Pro Highspeed, екіншісі 2-3 есе жылдам | бір нұсқа, жылдам нұсқасы жоқ |
| Ашық салмақтар | 2026 жылғы 4 қарашаға дейін уәде етілген, лицензия әлі аталмаған | Hugging Face-те жарияланған, лицензия коммерциялық пайдалануға шектеулермен |
Mixture of Experts - әр сұранысқа параметрлердің бір бөлігі ғана жұмыс істейтін модель құрылымы. Сондықтан 2,8 трлн параметрлі модельде жауапқа шамамен 104 млрд-ы қатысады.
Ойлауды өшіру мүмкін емес: онсыз жіберілген сұранысты API қатемен қайтарады. Жауап тезірек керек болса, Moonshot low деңгейін қоюға кеңес береді.
Модель Kimi.ai-да, iOS, Android және HarmonyOS-қа арналған Kimi қосымшаларында, Kimi Work жұмыс үстелі қосымшасында, Kimi Code-та және API арқылы қолжетімді. Kimi Code-та K3.1 Pro Plus тарифінен ашық, ал 1 млн токендік контекст пен Highspeed нұсқасы Pro тарифінен басталады. Highspeed лимитті шамамен екі есе көп жұмсайды.
Жаңа Kimi-дің күшті жақтары: ойындар, 3D және ұзақ тапсырмалар
Moonshot үш бағытқа басымдық береді.
Ойындар тұтас жоба ретінде. Компанияның сөзінше, K3.1 Pro Unity, Unreal Engine және Godot ойын қозғалтқыштарымен сенімді жұмыс істейді - жеке скрипттермен емес, жобамен тұтастай.
Бейне көзі: Kimi K3.1 Pro техблогы, 2026 жылғы 23 қазан.
Параметрлік 3D-модельдеу. Бұл модель қолмен емес, параметрлері бар кодпен құрылатын тәсіл: санды өзгерттің - бөлшек өзгерді. K3.1 Pro Blender мен CAD-бағдарламаларға арналған скрипттерді MCP-коннекторларсыз өзі жазып, іске қосады - MCP-коннекторлар әдетте модельді бөгде бағдарламаларға қосатын дайын модульдер.
Бейне көзі: Kimi K3.1 Pro техблогы, 2026 жылғы 23 қазан.
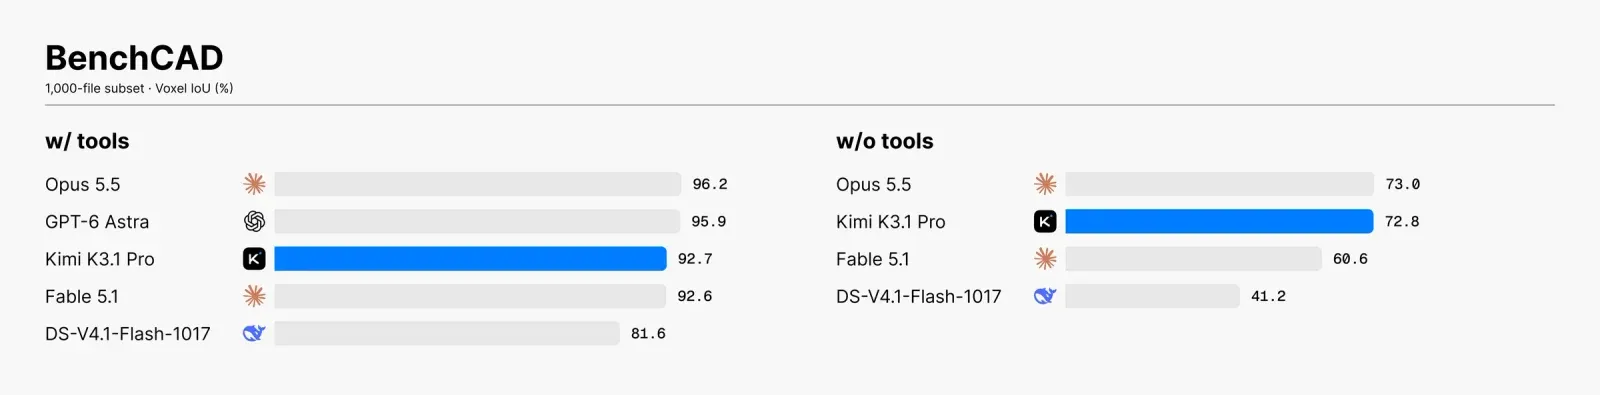
BenchCAD тестінде модель бірнеше қырынан түсірілген суреттер бойынша 3D-бөлшекті қалпына келтіреді, ал нәтиже түпнұсқамен салыстырылады. Құралдармен K3.1 Pro үшінші, ал құралдарсыз Claude Opus 5.5-тен небәрі 0,2 ұпайға қалады және Claude Fable 5.1-ден 12 ұпайға озады.
Модельмен бірге kimi.ai-да және Kimi қосымшасында 3D Make функциясы іске қосылды: 3D-модельді тікелей браузерде қарап, өңдеуге, содан кейін 3D-басып шығаруға дайын түрде жүктеп алуға болады.
Ұзақ тапсырмалар. Мысал ретінде Moonshot модельге human-atlas негізінде жүру симуляторын жасатты - бұл шеміршектерді қоса алғанда 296 қаңқа элементі мен 402 бұлшықеттен тұратын адам денесінің ашық анатомиялық моделі. 167 тапсырма мен 420 тәуелсіз тексеру барысында K3.1 Pro симуляторды 11,2 секунд бойы қадамдарды алмастырып үздіксіз жүруге дейін жеткізді, ал иық бұлшықеттерінің есептеулерінде 36 қатені тауып, түзетті.
Бейне көзі: Kimi K3.1 Pro техблогы, 2026 жылғы 23 қазан.
Moonshot тесттері не көрсетеді
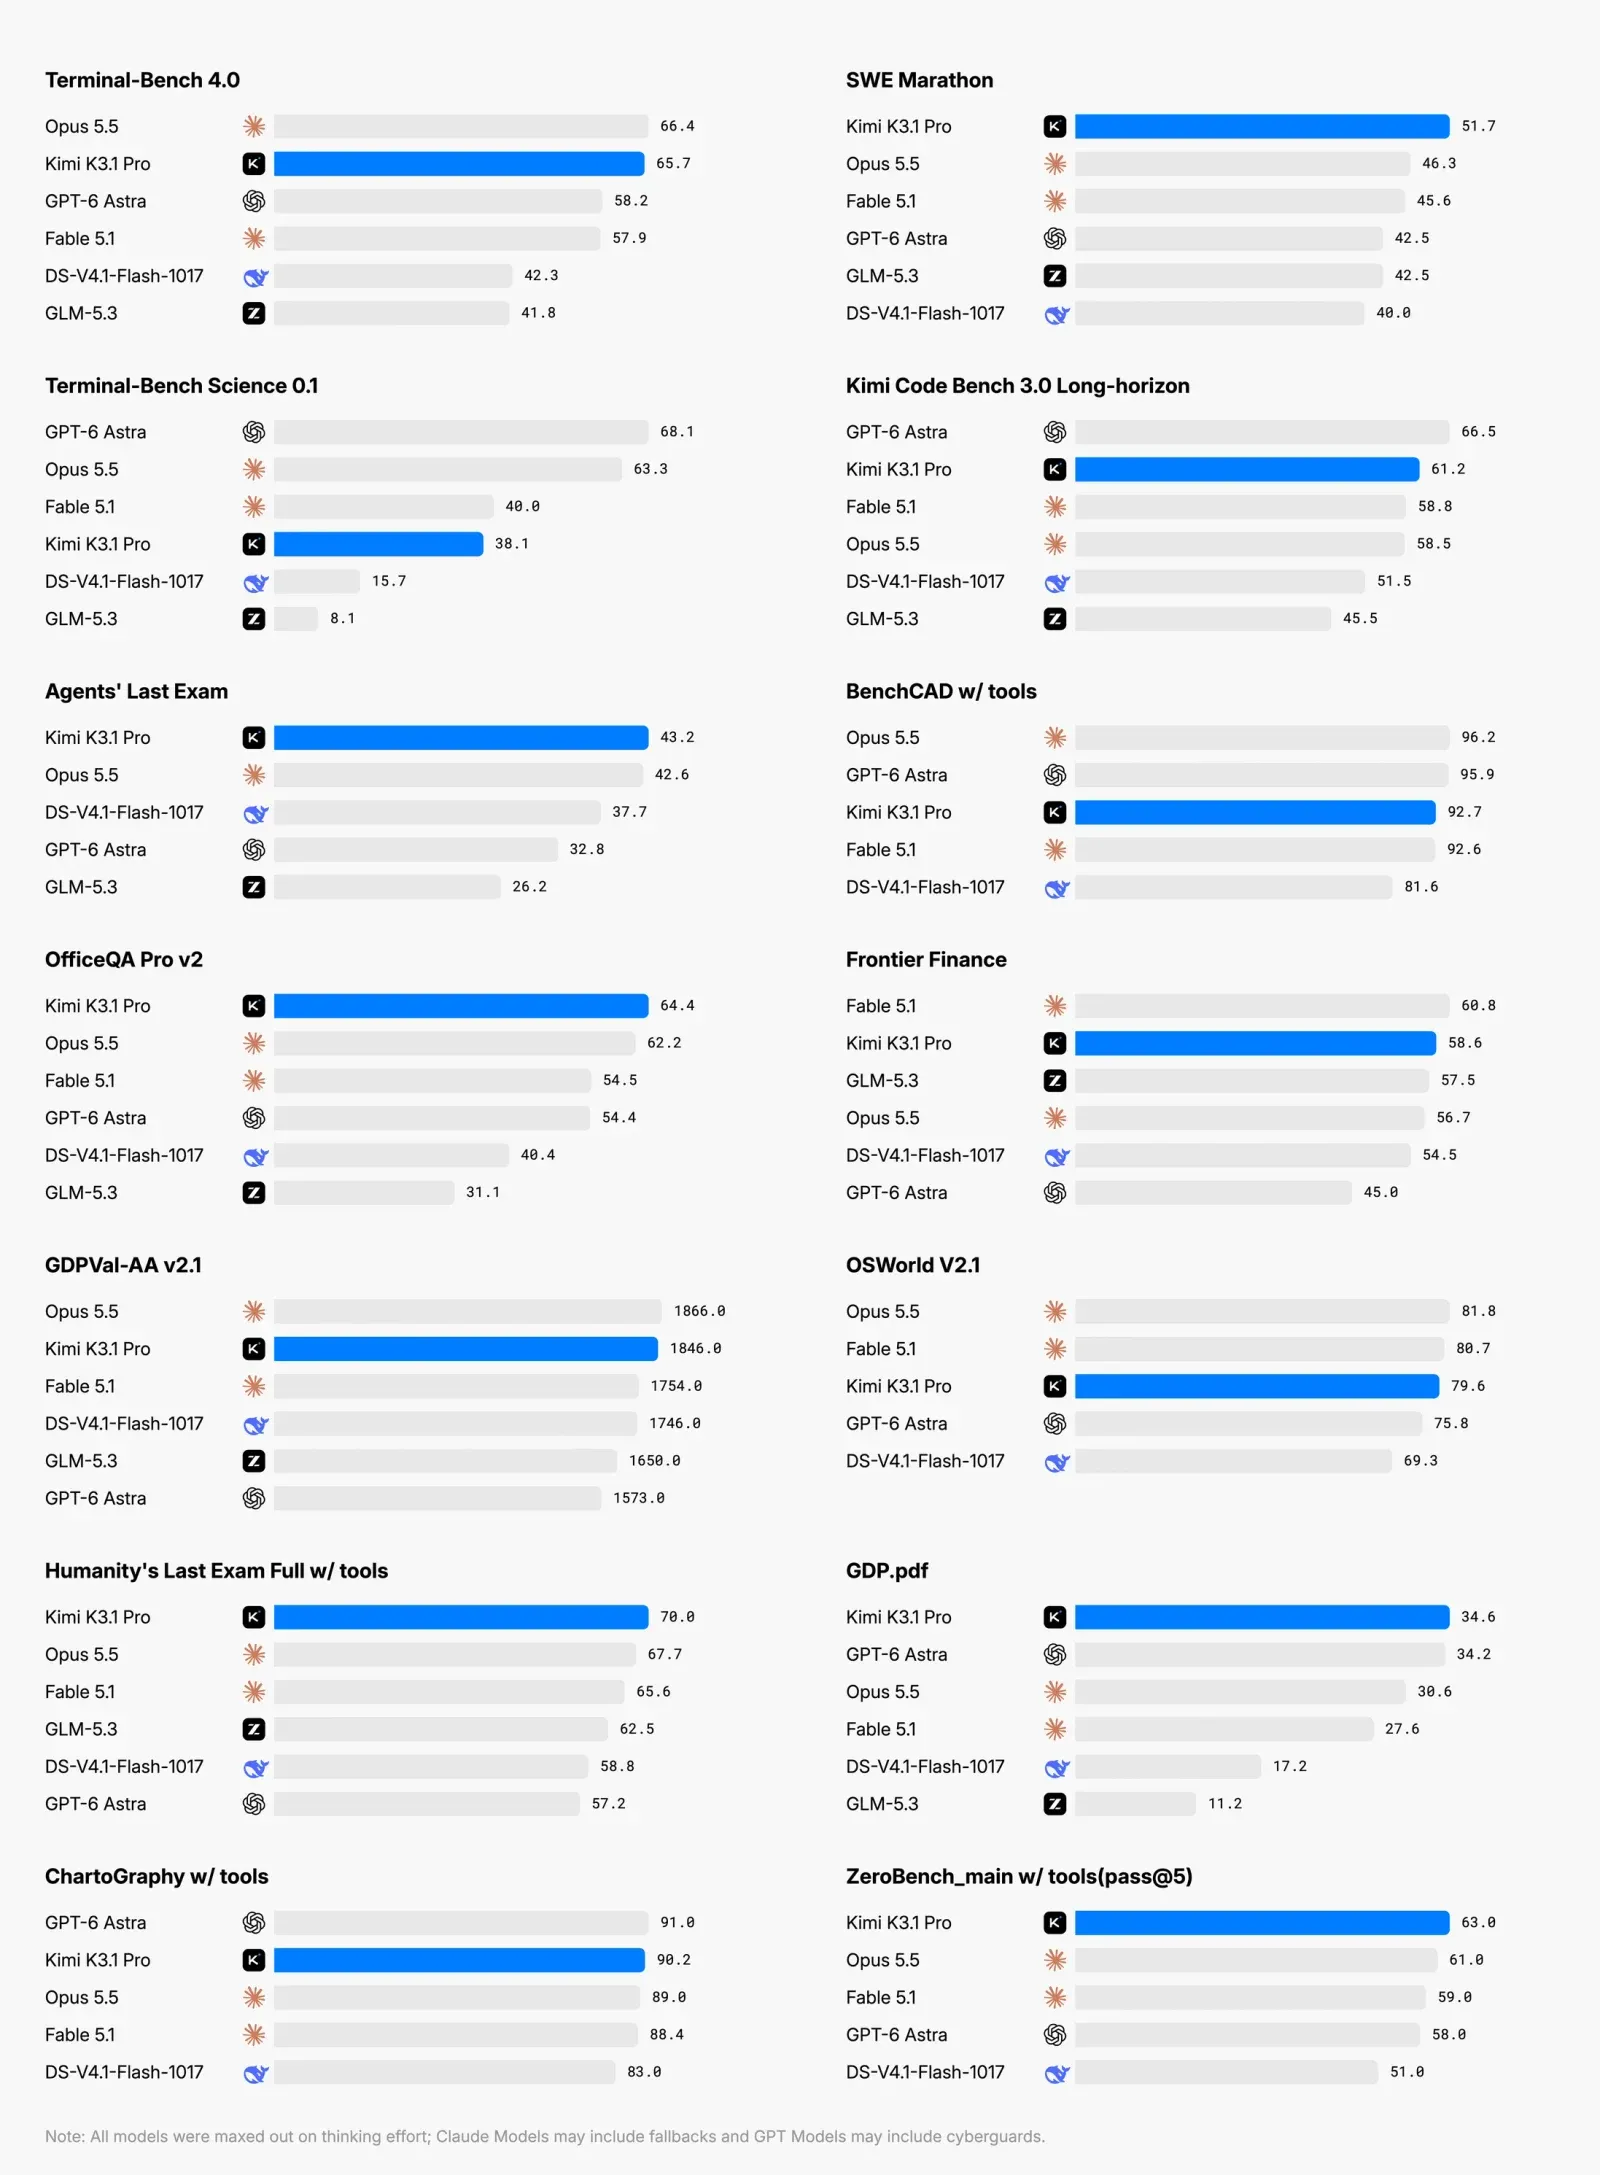
График көзі: Kimi K3.1 Pro техблогы, 2026 жылғы 23 қазан.
Moonshot K3.1 Pro-ны 14 тестте Claude Opus 5.5, GPT-6 Astra, Claude Fable 5.1, DeepSeek V4.1 Flash және GLM-5.3-пен салыстырды. Барлық модельге ойлаудың ең жоғары деңгейі қойылды. Үш жақын бәсекелеске қарсы 14 нәтиженің бәрі - төмендегі кестеде.
Кесте деректерін көрсету
| Тест | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65,7 | 66,4 | 58,2 | 57,9 |
| SWE Marathon | 51,7 | 46,3 | 42,5 | 45,6 |
| Kimi Code Bench 3.0 Long-horizon | 61,2 | 58,5 | 66,5 | 58,8 |
| Terminal-Bench Science 0.1 | 38,1 | 63,3 | 68,1 | 40,0 |
| Humanity's Last Exam құралдармен | 70,0 | 67,7 | 57,2 | 65,6 |
| Agents' Last Exam | 43,2 | 42,6 | 32,8 | - |
| OSWorld V2.1 | 79,6 | 81,8 | 75,8 | 80,7 |
| OfficeQA Pro v2 | 64,4 | 62,2 | 54,4 | 54,5 |
| Frontier Finance | 58,6 | 56,7 | 45,0 | 60,8 |
| GDPval-AA v2.1, рейтинг | 1846 | 1866 | 1573 | 1754 |
| BenchCAD құралдармен | 92,7 | 96,2 | 95,9 | 92,6 |
| BenchCAD құралдарсыз | 72,8 | 73,0 | - | 60,6 |
| ChartoGraphy құралдармен | 90,2 | 89,0 | 91,0 | 88,4 |
| GDP.pdf | 34,6 | 30,6 | 34,2 | 27,6 |
| ZeroBench құралдармен, pass@5 | 63,0 | 61,0 | 58,0 | 59,0 |
K3.1 Pro алты тестте бірінші: SWE Marathon, Humanity's Last Exam, Agents' Last Exam, OfficeQA Pro v2, GDP.pdf және ZeroBench. Terminal-Bench 4.0 (командалық жолдағы тапсырмалар), OSWorld (интерфейс арқылы компьютерде жұмыс) және GDPval (әртүрлі мамандықтардың жұмыс тапсырмалары) тесттерінде ол Opus 5.5-тен 0,7-2,2 ұпайға немесе рейтингтің 20 ұпайына қалады.
Қаржы және кеңсе жұмысы
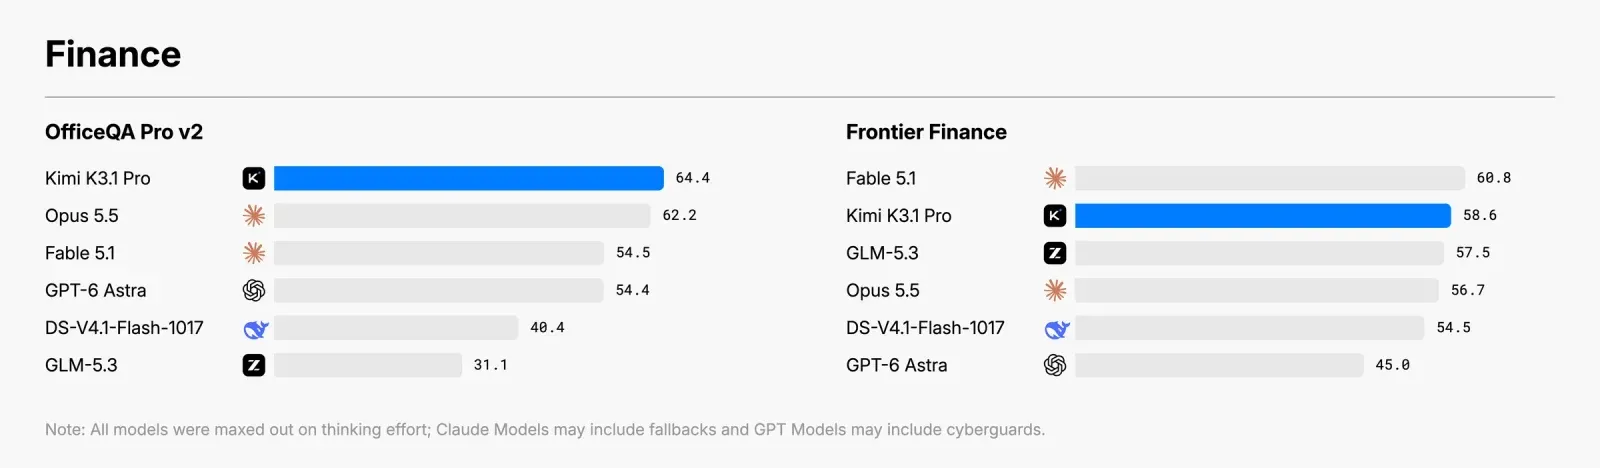
Ашық OfficeQA Pro v2 тестінде (кеңсе құжаттары бойынша сұрақтар) K3.1 Pro 64,4-пен бірінші, Frontier Finance-те Claude Fable 5.1-ден кейін 58,6-мен екінші.
Ойдан шығарылған фактілер азайды
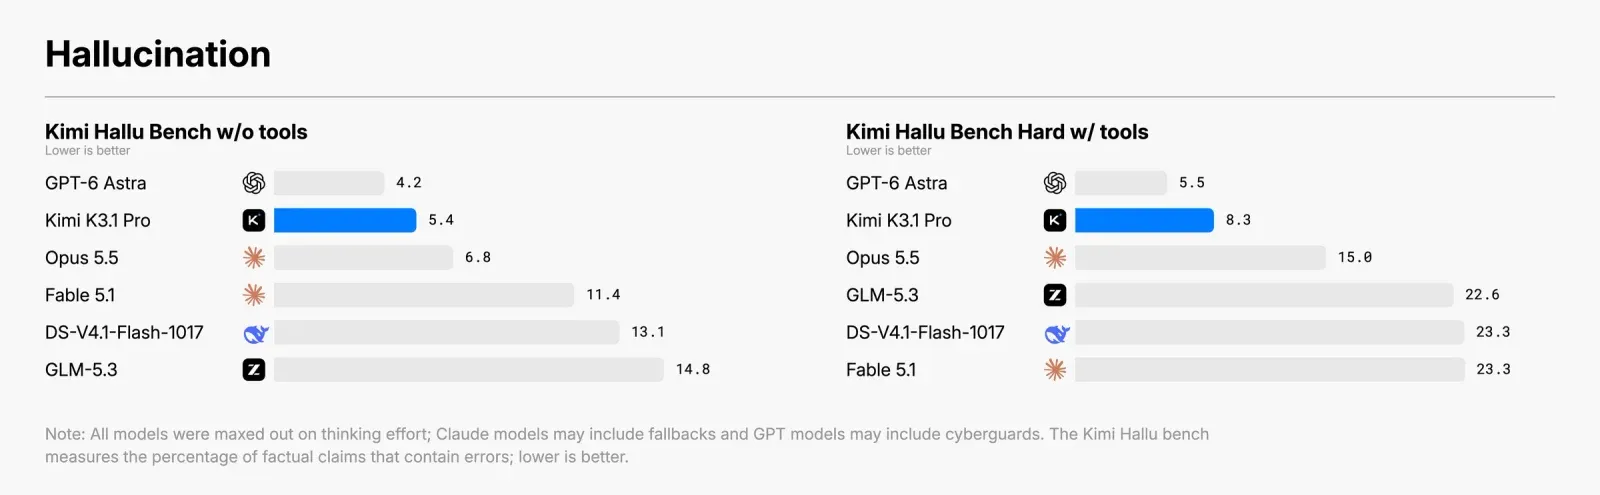
Kimi Hallu Bench Hard стресс-тестінде Moonshot жауаптардағы тұжырымдардың қанша үлесі жалған болып шыққанын есептеді. K3-те мұндай 23,4% болған, K3.1 Pro-да - 8,3%. Салыстыру үшін, сол тестте Claude Opus 5.5-те 15,0%, GPT-6 Astra-да 5,5%.
Moonshot-тың өзі тест әдейі қиын мысалдардан жиналғанын және бұл пайыздар күнделікті жұмыстағы қателер жиілігіне тең емес екенін ескертеді.
Киберқауіпсіздік әдейі қысқартылды
Ашық нұсқаны оқытудан Moonshot киберқауіпсіздік деректерін алып тастады: компанияның сөзінше, ашық салмақтар модельдердің бұзу саласындағы мүмкіндіктерінің шекарасын жылжытпауы керек. xdev-bench-hard тестінде мұндай тазартусыз нұсқа 90,5 жинады, ал соңғы K3.1 Pro - 81,0, бұл 100 жинаған GPT-5.6 Sol сияқты жабық модельдерден төмен.
Бір тапсырма қанша тұрады
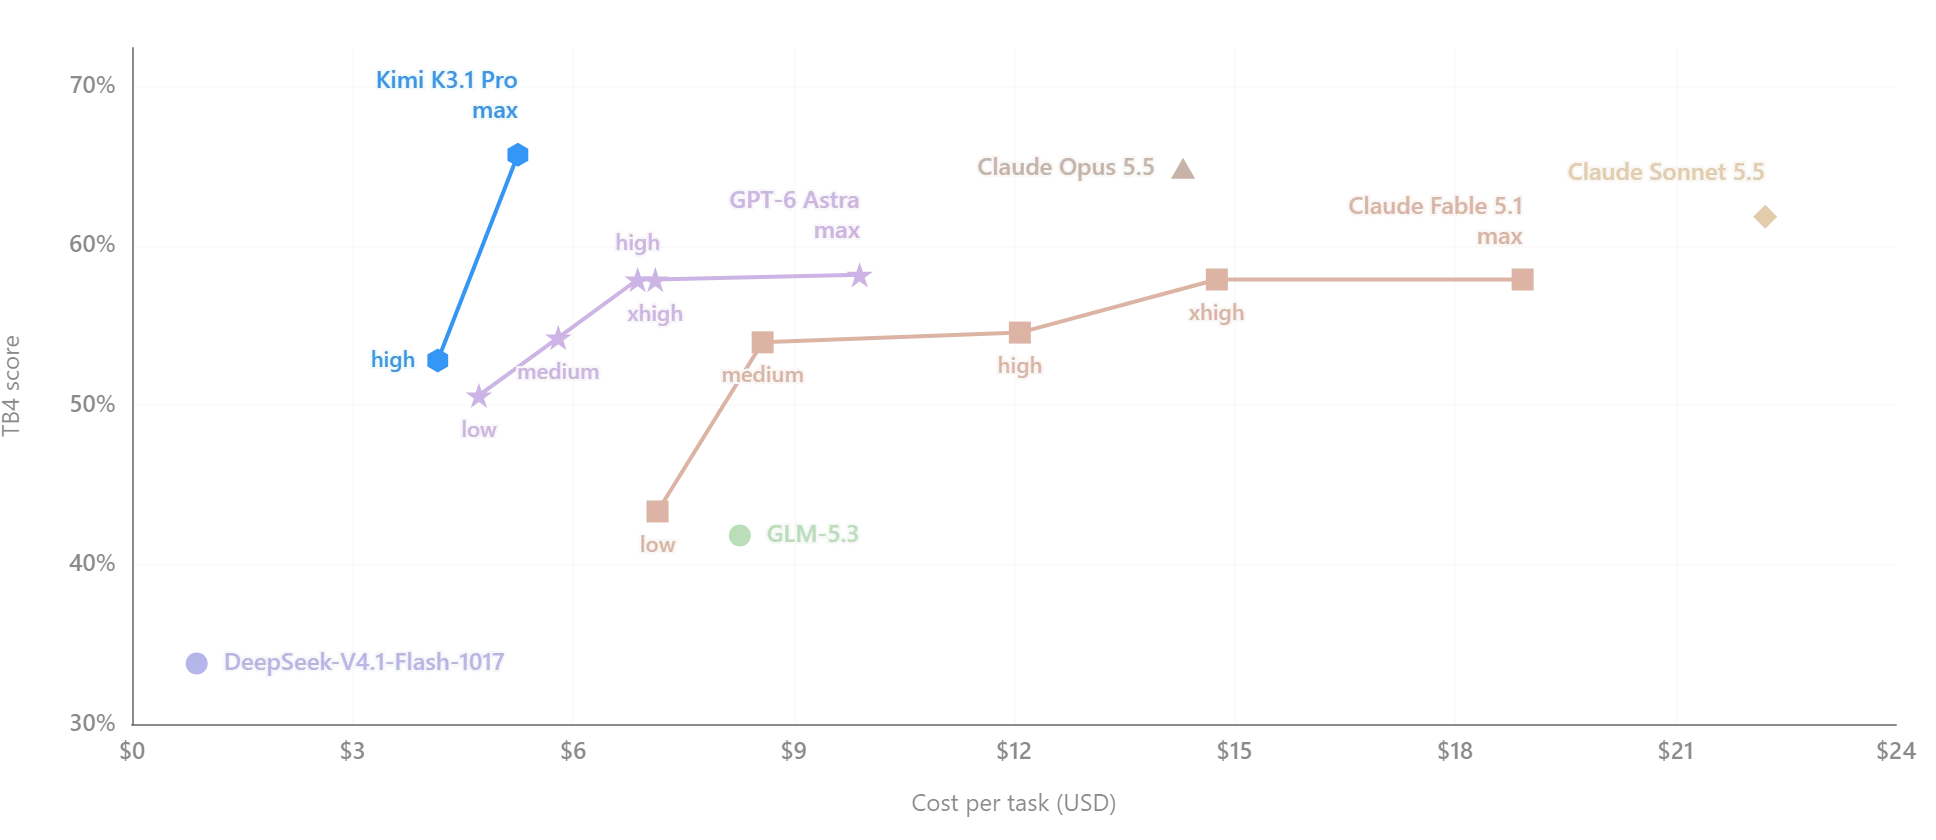
Модель таңдау үшін Moonshot-тың ең пайдалы графигі - Terminal-Bench 4.0 нәтижесі бір тапсырманың орташа құнына қарсы. DeepSeek-тен басқа барлық модельдердің нәтижелері мен құны тесттің өз сайты tbench.ai-дан, ал DeepSeek үшін Artificial Analysis-тен алынған.
Кесте деректерін көрсету
| Модель | Ойлау деңгейі | Нәтиже | Тапсырма құны |
|---|---|---|---|
| Kimi K3.1 Pro | max | 65,7% | $5,25 |
| Kimi K3.1 Pro | high | 52,8% | $4,16 |
| Claude Opus 5.5 | max | 64,85% | $14,30 |
| Claude Sonnet 5.5 | max | 61,82% | $22,22 |
| GPT-6 Astra | max | 58,18% | $9,90 |
| GPT-6 Astra | high | 57,88% | $6,88 |
| GPT-6 Astra | low | 50,61% | $4,72 |
| Claude Fable 5.1 | xhigh | 57,88% | $14,76 |
| Claude Fable 5.1 | max | 57,88% | $18,92 |
| GLM-5.3 | - | 41,82% | $8,27 |
| DeepSeek V4.1 Flash | - | 33,8% | $0,88 |
Ең жоғары деңгейде K3.1 Pro Claude Opus 5.5-тен сәл көбірек жинайды - 64,85%-ке қарсы 65,7%, ал тапсырма 2,7 есе арзан түседі: $14,30-ға қарсы $5,25. Ең жоғары деңгейдегі GPT-6 Astra дерлік екі есе қымбат және 7,5 ұпай аз жинайды.
Мұнда ойлау деңгейін үнемдеу тиімсіз. High деңгейінде тапсырма небәрі $1,09-ға арзандайды, ал нәтиже 65,7%-тен 52,8%-ке түседі - high деңгейіндегі GPT-6 Astra-дан төмен.
Жиынтық графикте Opus 5.5-те 66,4%, ал мұнда 64,85%: Moonshot жиынтығындағы және tbench.ai-дағы мәндер сәйкес келмейді.
Әзірге не жоқ
- Ашық салмақтар. Оларды 4 қарашаға дейін уәде етеді, лицензия аталмаған. Kimi K3 салмақтары коммерциялық пайдалануға шектеулермен шықты.
- Kibitz туралы растау. Arena-дағы анонимді модельді қауымдастық K3.1 деп санады, бірақ мұны Moonshot та, Arena да растаған жоқ.
Қорытынды: Kimi K3.1 Pro релизі қарапайым пайдаланушылар үшін нені білдіреді
Қысқаша айтқанда: K3.1 Pro - күшті модель және Kimi үшін үлкен қадам, бірақ Opus 5.5-тің орнын баспайды. Moonshot тесттерінде ол Opus-пен дерлік тең жүреді, ал тәуелсіз өлшемдерде қалып қояды: Artificial Analysis индексінде 58-ге қарсы 55, Bug Hunt Bench-те түзетілген қателер бойынша 41,7-ге қарсы 36. Әрі қарай - тапсырмалар бойынша.
Kimi K3.1 Pro бірде-бір тәуелсіз бенчмаркта көшбасшы болмады, ал бірқатар тесттерде әлдеқайда арзан DeepSeek V4.1 Flash-тен де ұтылды. Жақсы нәтижелерге қарамастан, лимиттердің тез «жұмсалуына» және тапсырма құнының жалпы төмен еместігіне (әсіресе қытай моделі үшін) байланысты көпшілік Kimi-ді өз тапсырмаларында пайдалануға күмәнмен қарайды.
- Нақты жобалардағы агенттік бағдарламалау. Мұнда мен әзірге Opus 5.5 немесе Sonnet 5.5-те қалар едім. Bug Hunt Bench-те K3.1 Pro барлық топ модельдерден аз қате түзетті, ал Agent Arena-да ол тек он бірінші. Код үшін арзан ашық модель керек болса, DeepSeek V4.1 Flash сол Bug Hunt-та жақсырақ және 7,5 есе арзанға жұмыс істеді.
- Сайттар, лендингтер және 3D. Бұл жаңа Kimi-дің күшті жағы, оны байқап көрген жөн. Arena-дағы WebDev-те ол сегізінші, Claude Opus 5 деңгейінде, ал бренд және маркетинг тапсырмаларында - жетінші. Құралдарсыз 3D-модельдеуде ол Opus 5.5-тен 0,2 ұпайға қалады.
- Қаржы және кеңсе құжаттары. Бұл да жұмыс істейтін нұсқа: Artificial Analysis-тің қаржы индексінде K3.1 Pro Sonnet 5.5-пен екінші-үшінші орынды бөліседі, ал Moonshot-тың кеңсе құжаттары тестінде бірінші тұр.
- Ғылыми тапсырмалар. Ең жақсы таңдау емес: Terminal-Bench Science-та ол GPT-6 Astra-дан дерлік екі есе аз жинайды.
Жылдамдық пен ақша туралы бөлек. K3.1 Pro K3-тен екі есе жылдам, бірақ нарық бойынша бұл әлі де орта деңгей, және ол сөзшең жауап береді - Artificial Analysis индексін өткізуге орташа модельден 1,7 есе көп токен кетті. Сонымен бірге Terminal-Bench 4.0-дегі тапсырма Opus 5.5-пен салыстырғанда 2,7 есе арзан.
Мен екі кемшілікті көремін. Біріншісі - лимиттер мен кезектер: жазылым тез бітеді, ал тегін нұсқада модельді қазір күтіп отыру мүмкін емес. Екіншісі - ұзақ тапсырмалардағы тұрақтылық: Bug Hunt Bench-те модель 128 мың токен контекстте мағынасыз мәтін шығара бастады, дегенмен мәлімделген контекст - 1 млн.
Менің ойымша, ең қызығы 4 қарашада, салмақтар шыққанда болады. Егер Moonshot уәдесін орындаса, бұл өз жабдығыңызда іске қосуға болатын ең күшті ашық модель болады, және дәл сонда баға мен сапа арақатынасы шынымен тиімді болуы мүмкін. Ал Arena-дағы орындар әзірге алдын ала, сондықтан түпкілікті қорытындыны бір-екі аптадан кейін және өз тапсырмаларыңыздағы тесттерден кейін жасар едім.
K3.1 релизге дейін қалай білінді
K3.1 атауы бірнеше апта бойы ағып кетулерде көрініп жүрді, ал релиз күні Moonshot оны бейнеде өзі көрсетті.
- 19 қыркүйек. Kimi-дің Zhihu-дағы расталған аккаунтында (қытайлық сұрақ-жауап платформасы) қолтаңбасыз жазба шықты: «3.1»-ден кейінгі π санының цифрларының ұзын тізбегі. Қауымдастық мұны 3.1 нұсқасына ишара деп оқыды.
- Қыркүйектің соңы. Хабарларға қарағанда, Moonshot API-нда «kimi-k3-1» идентификаторы байқалған.
- 21 қазан. X-тегі жаңалықтар мен бенчмарктар авторы LuminaBench Kimi Code-тан «k3.1» мекенжайы бар модельді ауыстыру ережесін тапты.
- 22 қазан. Пайдаланушы қандай модель алатынын білмейтін Code Arena шайқастарында Kibitz деген анонимді модель пайда болды. Қауымдастық оны Kimi-мен байланыстырды: AGTP деректері бойынша, ол Moonshot-тың қызметтік токендерін басқа Kimi модельдері сияқты бұрмалады, ал бұрынғы Kimi модельдері Arena-да ұқсас атаулармен жүрді - Kiwido, Kiwire, Kivine.
- 23 қазан, 01:41 UTC. Kimi-дің ресми аккаунты 24 секундтық бейне жариялады, онда Kimi Code терминалында «Model: Kimi K3.1» жолы көрінеді.
- 23 қазан, 04:46 UTC. Arena Moonshot-тың жаңа моделі жақында шығатынын жазды.
- 23 қазан, 17:15 UTC. K3.1 Pro релизі.
Релизге дейін LuminaBench бірнеше бейне жариялады, олар, оның сөзінше, Kibitz атауымен K3.1-де жасалған. Ең көрнектісі - басқа модельдердің жұмыстарымен қатар тұрған воксельді пагода. Бұл бір промпт және бір әрекет, сондықтан бейнені модельдерді салыстыру деп қабылдамаған жөн.
Бейне көзі: @LuminaBench X-те, 2026 жылғы 22 қазан.
Дереккөздер
- Kimi K3.1 Pro Tech Blog: Advancing Open Intelligence, 23.10.2026 - ресми хабарландыру, 14 тест, галлюцинациялар, киберқауіпсіздік.
- Kimi.ai X-те: K3.1 Pro релизі, 23.10.2026 - 2,8 трлн параметр, 104 млрд белсенді, контекст.
- Kimi K3.1 Pro quickstart - ойлау режимі, жауап ұзындығы, сурет пен бейне енгізу.
- Kimi K3 quickstart - салыстыру үшін K3 сипаттамалары: жауап ұзындығы, ойлау режимі, енгізу.
- Kimi API бағалары - K3.1 Pro және Highspeed тарифтері.
- Kimi Code-тағы модельдер - тарифтер, контекст және лимит шығыны.
- Kimi.ai X-те: «Model: Kimi K3.1» бар бейне, 23.10.2026.
- Arena.ai X-те: Kimi K3.1 Pro Code Arena: WebDev-те 8-орында, 23.10.2026 - 1692 ұпай, Claude Opus 5 (Max) деңгейі.
- Arena.ai X-те, 23.10.2026 - «A new model from @Kimi_Moonshot is coming».
- ChainCatcher: Kimi бейнесі және K3.1 алдыңғы тарихы, 23.10.2026 - API-дағы «kimi-k3-1» идентификаторы.
- LuminaBench: Kimi K3.1 looks to be getting close, 21.10.2026 - Kimi Code-та K3.1 аталуы.
- AGTP X-те: Arena-дағы жұмбақ Kibitz моделі, 22.10.2026 - токенизатор және кодтық атаулар.
- Artificial Analysis-тегі Kimi K3.1 Pro - жалпы және салалық индекстер, жылдамдық, тапсырма құны.
- Bug Hunt Bench, 23.10.2026 - екі жобадағы 105 жасырын қате, Kimi K3.1 Pro-ның үш іске қосылуы; әдістеме және бастапқы деректер.
- StealthMark, 23.10.2026 - физикалық және кеңістіктік ойлау, жоспарлау және визуалды дағдылар бойынша түпнұсқа тапсырмалар.
- Artificial Analysis-тегі Kimi K3 - K3 жылдамдығы мен лицензиясы.