
GPTunneL шолуы. Бенчмарк деректері 2026 жылғы 13 қараша бойынша өзекті.
Google соңғы уақытта ЖИ нарығын жоғары орындар үшін нақты күресе алатын модельдермен таңғалдырып келеді. Жуырда шыққан Gemini 4 Carbon интеллект пен тапсырма құнының арақатынасы бойынша ең үздік фронтир-модельдердің біріне айналды. Ал Gemini 4 Hydrogen туралы не айтуға болады?
Алғашқы қарағанда ол таңғалдыруы мүмкін: бенчмарктер бойынша ол Argon моделінен кем түспейді, сонымен бірге арзанырақ әрі жылдамырақ. Hydrogen-нің модельдер арасындағы орнын анықтап көрейік.
Google Gemini 4 Hydrogen моделін 2026 жылғы 12 қарашада шығарды. Компания оны бағдарламалауға, құжаттармен жұмыс істеуге және ЖИ-агенттерге — файлдарды өз бетінше ашып, құралдарды іске қосып, әрекеттер тізбегін орындай алатын жүйелерге арналған жылдам орындаушы модель ретінде ұсынады.
Бастысы: GPTunneL рейтингінде Hydrogen интеллект индексі бойынша 8-орынға ие болды. Ол аналитикалық тапсырмаларды жылдам өңдейді, пайдаланушының ескертулеріне жақсы жауап береді және бағдарламаларды бір тілден екіншісіне таза ауыстырады. Дегенмен белгісіз қателерді өз бетінше іздеуде рейтингтегі кейбір көршілерінен айтарлықтай артта қалады.
Оны таныс баламалармен салыстыру модельдің орнын түсінуге көмектеседі. Мысалы, GPT-6.1 Sol жоғарырақ жалпы ұпай жинады және сынақ тапсырмаларын орындауда орта есеппен 38%-ға арзанырақ. Сонымен бірге Hydrogen Artificial Analysis тестінде жауапты генерациялауға шамамен 40%-ға аз уақыт жұмсайды. Неғұрлым қуатты Gemini 4 Carbon-мен салыстырғанда Hydrogen шамамен 23%-ға арзан және екі есеге жуық жылдам. Шығындар бірдей тәуелсіз сынақтар топтамасына негізделген; жазылымдар үшін басқа ережелер қолданылады, олар туралы бөлек айтамыз.
Gemini 4 Hydrogen деген не және оны Google не үшін шығарды
Gemini тобындағы жылдам орындаушы модель
Google желісінде Hydrogen Carbon және Argon модельдерін толықтырады. Carbon аса күрделі пайымдаулар мен жоспарлауға, Argon да жоғары күрделіліктегі тапсырмаларға бағытталған, ал Hydrogen — орындау жылдамдығы, нұсқауларды дәл сақтау және құралдарды шақыру маңызды болатын күнделікті жұмысқа арналған. Google DeepMind сипаттамасына сәйкес, Hydrogen Carbon архитектурасы негізінде жасалған; дегенмен Google өзгерістердің егжей-тегжейін ашпаған.
Мысал: қосымша әзірлеу кезінде бір модель жүйе архитектурасын құра алады, ал Hydrogen жеке функцияларды жазып, файлдарды өңдеп, тестілеуді іске қосады. Google бұл тәсілді модельдер арасында тапсырмаларды бөлетін Antigravity Orchestrator жүйесінде дамытып келеді. Google-дің Terminal-Bench 4.0 сынағында бұл байланыс тапсырмаларды 19%-ға жылдам орындап, Carbon-ды жеке пайдаланғанға қарағанда 24%-ға аз квота жұмсаған. Google ресми хабарландыруы.
Негізгі сипаттамалары
| Параметр | Пайдаланушы үшін нені білдіреді |
|---|---|
| Қолдау көрсетілетін материалдар | Мәтін, кескіндер, аудио, видео және құжаттар. Модель осы функцияларды қолдайтын қолданбаларда файлдарды, кестелерді және бағдарламалық кодты талдай алады. |
| 1 млн токенге дейінгі контекст | Бір сұранысқа үлкен көлемдегі деректерді, мысалы, ірі репозиторий бөлшектерін беруге болады. Нақты шектеулер сервиске және жауап шығынына байланысты. |
| Пайымдау режимдері | low, medium, high, xhigh: жылдам әрі қарапайым жауаптардан бастап токен шығыны жоғары тереңдетілген талдауға дейін. |
| Стандартты шығару шегі | Бір жауап сегменті үшін 65 536 токенге дейін; API ұзақ тапсырмаларды жалғастыруды қолдайды. |
| Google API бағасы | 1 млн кіріс токені үшін $1,50 және 1 млн шығыс токені үшін $7,50, соның ішінде пайымдау токендері. |
| Оқыту деректері | Білім шегі: 2026 жылғы наурыз. Өзекті деректер қосылған іздеу құралдарынан алынады. |
xhigh режимі не береді? Модель сұранысты ұзағырақ талдап, пайымдауға көбірек токен жұмсай алады. Бұл күрделі мәселелерді шешуді жақсартуы мүмкін, бірақ уақыт пен шығынды арттырады. Мысалы, Artificial Analysis сынағында Hydrogen xhigh режимінде 54 балл алды.
Hydrogen барлық модельдер рейтингінде қалай көрінеді
Біз алты тәуелсіз бенчмарк нәтижелерін жинақтадық — бұл модельдер бірдей тапсырмаларды шешетін тестілеу жиынтықтары. Жалпы рейтинг модельдерді бірнеше бағыт бойынша салыстыруға көмектеседі, сонымен бірге әрбір өлшемді төмендегі кесте бойынша жеке тексеруге болады.
GPTunneL дерекқорында 85 модель мен олардың конфигурациялары бар. Қорытынды рейтингке таңдалған алты тестің кемінде бесеуінің нәтижесі бар 23 модель енді. Hydrogen барлық алты тесттен өтіп, сегізінші орынға ие болды.
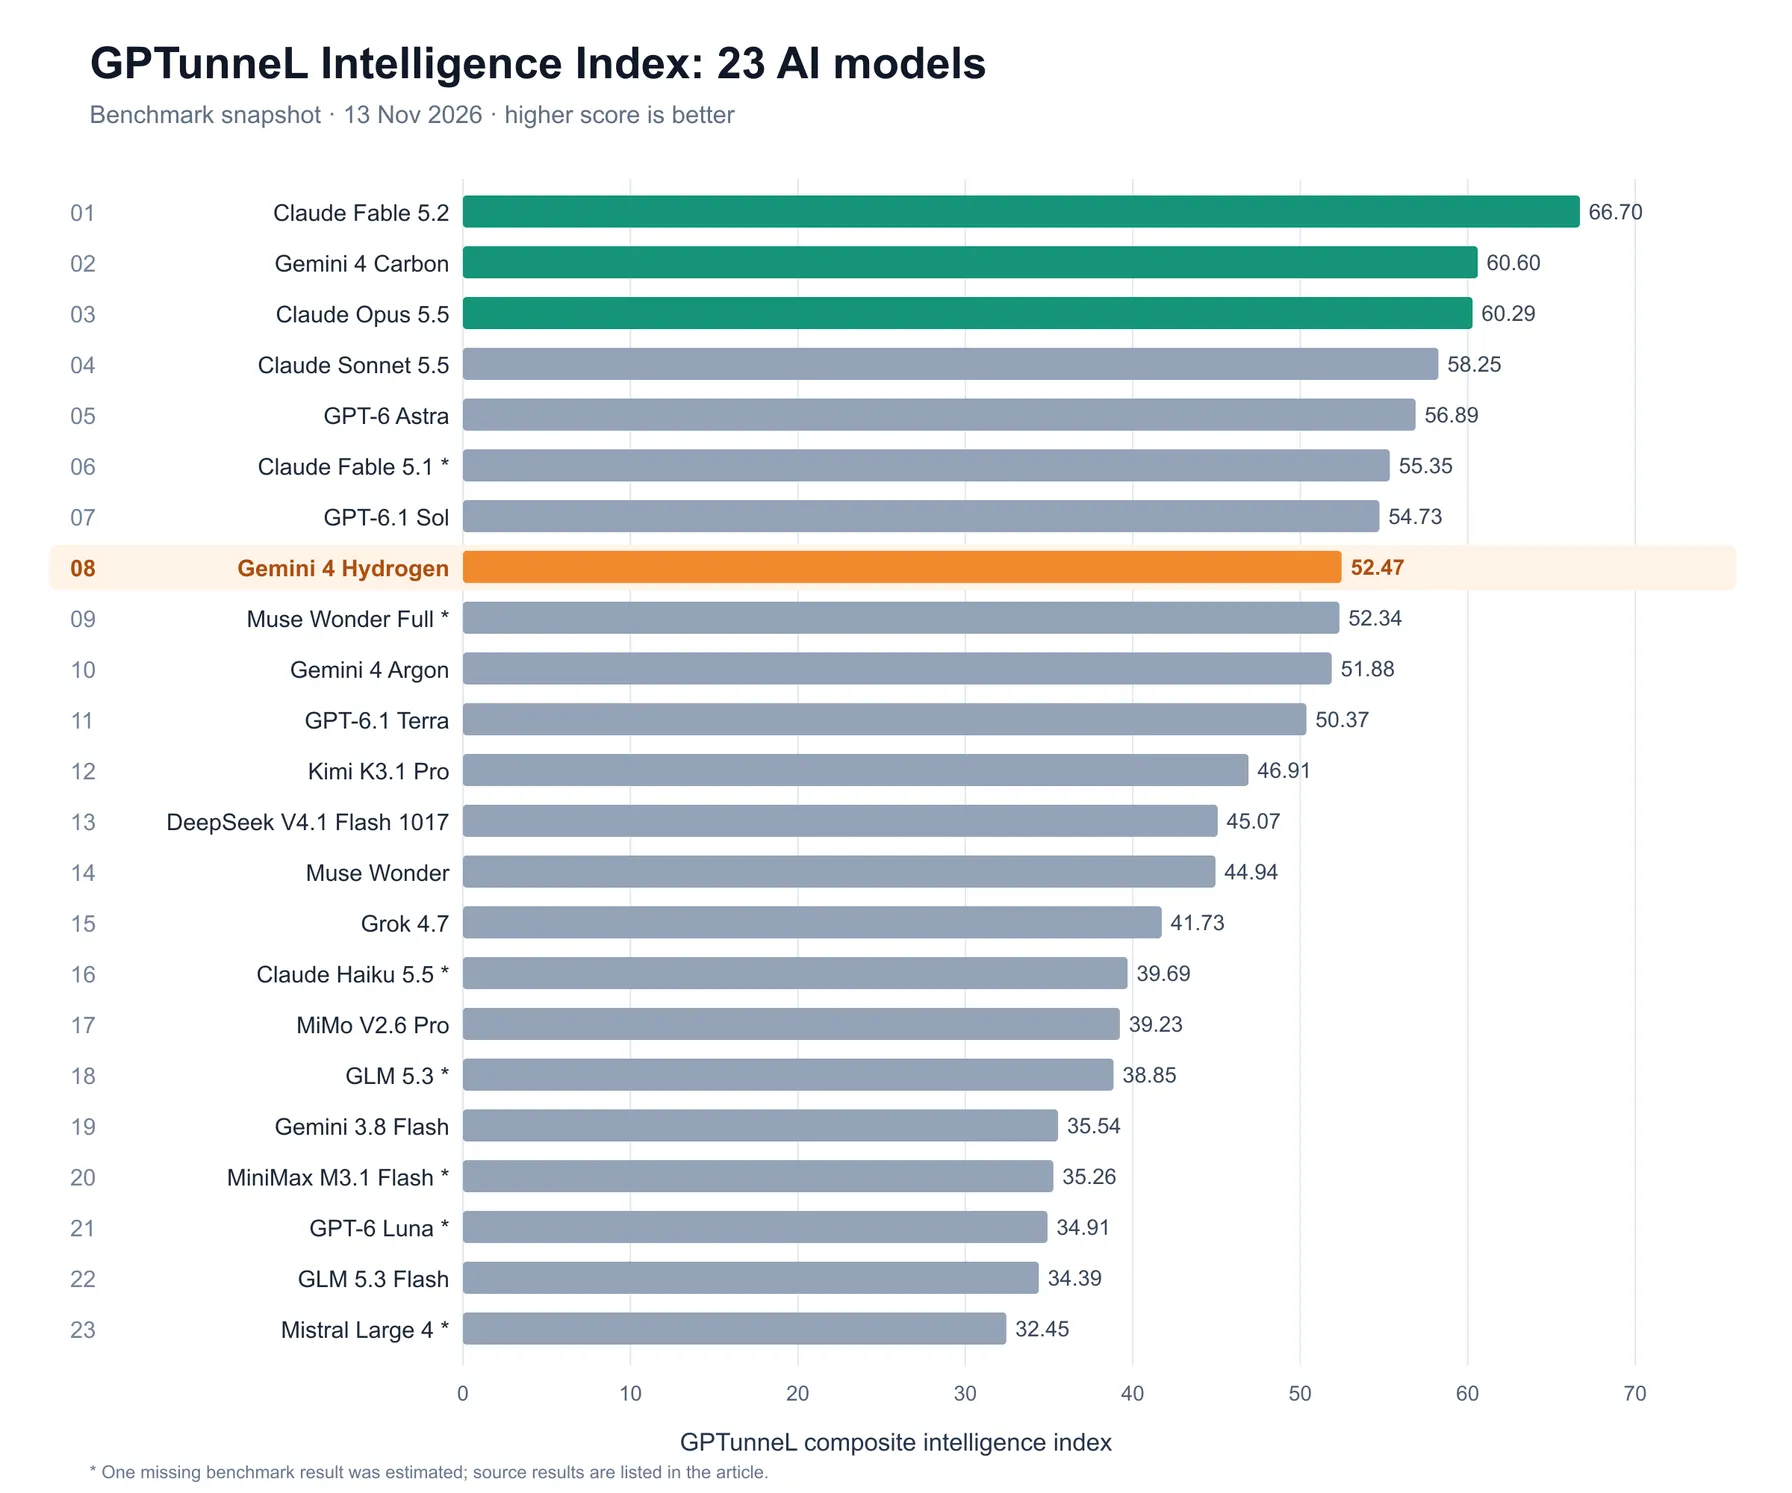
Толық кесте: қорытынды рейтинг, құн және бастапқы нәтижелер
Кестедегі алғашқы екі сандық көрсеткіш — GPTunneL есептеулері: интеллект индексі және құн индексі. Қалған алты баған — интеллект индексі есептелген жарияланған бастапқы бенчмарк нәтижелері.
- AA (Artificial Analysis), Vals және LiveBench — пайымдау, бағдарламалау және басқа да зияткерлік қабілеттерге арналған үш түрлі сынақ жиынтығы.
- WebDev веб-интерфейстерді құруды тексереді; Elo — шахматшылардың рейтингіне ұқсас салыстырмалы жүйе.
- Agent Arena агенттің құралдармен және кері байланыспен жұмыс істеу кезіндегі нәтижесін көрсетеді; теріс мән бастапқы нұсқамен салыстырғанда нашарлауды білдіреді.
- Bug Hunt жасырын 105 қатенің орта есеппен қаншасы түзетілгенін көрсетеді.
Барлық алты тестте жоғары балл жақсы нәтижені білдіреді. Интеллект индексінде де жоғары мән жақсы, ал құн индексінде төмен мән тиімдірек. Құн мен оның шартты шкаласы келесі бөлімде толық түсіндіріледі.
| № | Модель | Интеллект индексі | Құн индексі | AA | Vals | LiveBench | WebDev, Elo | Agent Arena, % | Bug Hunt, /105 |
|---|---|---|---|---|---|---|---|---|---|
| 1 | Claude Fable 5.2 | 66,70 | 5,837 | 65 | 71,31 | 84,9 | 1838 | 30,48 | 58,0 |
| 2 | Gemini 4 Carbon | 60,60 | 1,073 | 60 | 70,45 | 83,5 | 1768 | 16,90 | 57,3 |
| 3 | Claude Opus 5.5 | 60,29 | 3,482 | 59 | 70,14 | 83,4 | 1815 | 19,51 | 41,7 |
| 4 | Claude Sonnet 5.5 | 58,25 | 2,297 | 55 | 70,85 | 77,0 | 1772 | 16,07 | 51,3 |
| 5 | GPT-6 Astra | 56,89 | 2,787 | 57 | 65,02 | 84,5 | 1764 | 14,56 | 45,0 |
| 6 | Claude Fable 5.1 | 55,35* | 4,418 | 49 | ж/ж | 84,0 | 1742 | 14,62 | 43,0 |
| 7 | GPT-6.1 Sol | 54,73 | 0,513 | 55 | 63,94 | 81,4 | 1743 | 12,40 | 44,3 |
| 8 | Gemini 4 Hydrogen | 52,47 | 0,828 | 54 | 68,49 | 77,0 | 1704 | 14,80 | 32,7 |
| 9 | Muse Wonder Full | 52,34* | ж/ж | 50 | 66,79 | ж/ж | 1723 | 8,89 | 42,0 |
| 10 | Gemini 4 Argon | 51,88 | 0,902 | 50 | 69,39 | 77,7 | 1681 | 10,72 | 40,7 |
| 11 | GPT-6.1 Terra | 50,37 | 0,308 | 51 | 60,54 | 78,8 | 1678 | 11,96 | 40,7 |
| 12 | Kimi K3.1 Pro | 46,91 | 0,629 | 46 | 62,52 | 68,7 | 1687 | 4,83 | 36,0 |
| 13 | DeepSeek V4.1 Flash 1017 | 45,07 | 0,099 | 33 | 61,26 | 70,3 | 1664 | 2,01 | 42,7 |
| 14 | Muse Wonder | 44,94 | 1,237 | 44 | 64,88 | 70,7 | 1647 | 1,67 | 31,7 |
| 15 | Grok 4.7 | 41,73 | 2,031 | 35 | 58,62 | 67,9 | 1641 | 2,49 | 29,0 |
| 16 | Claude Haiku 5.5 | 39,69* | 0,158 | 36 | 58,73 | 68,9 | 1593 | 0,42 | ж/ж |
| 17 | MiMo V2.6 Pro | 39,23 | 0,068 | 30 | 57,81 | 66,1 | 1625 | 2,16 | 22,7 |
| 18 | GLM 5.3 | 38,85* | 0,998† | 32 | 59,85 | ж/ж | 1622 | 0,93 | 19,0 |
| 19 | Gemini 3.8 Flash | 35,54 | 0,829 | 31 | 55,95 | 57,3 | 1583 | 2,34 | 18,0 |
| 20 | MiniMax M3.1 Flash | 35,26* | 0.094 | 29 | 53,78 | 63,7 | 1584 | -2,76 | ж/ж |
| 21 | GPT-6 Luna | 34,91* | 0,043 | 28 | 52,32 | 60,4 | 1577 | 1,52 | ж/ж |
| 22 | GLM 5.3 Flash | 34,39 | 0,102 | 28 | 50,86 | 60,7 | 1609 | -2,94 | 17,7 |
| 23 | Mistral Large 4 | 32,45* | 0,387 | 26 | 56,53 | 40,9 | 1564 | 5,64 | ж/ж |
Белгілер: ж/ж — тест нәтижесі жарияланбаған. Интеллект индексі жанындағы жұлдызша * жетіспейтін бір нәтиженің статистикалық тұрғыдан бағаланғанын білдіреді; бастапқы бағанда біз нақты деректі болжамнан ажырату үшін ж/ж қалдырдық. Құн индексі жанындағы † белгісі жетіспейтін бір бағаның бағаланғанын көрсетеді. Hydrogen үшін алты интеллект көрсеткіші де, барлық үш баға да толық өлшенген.
Индекс ұпайлары нені білдіреді
GPTunneL интеллект индексі барлық алты сынақтың нәтижесі бар 16 модельден тұратын бекітілген топқа қатысты салыстырмалы көрсеткішті білдіреді. Осы топтың орташа деңгейі 50 балл деп қабылданған.
Осылайша, Hydrogen-нің 52,47 ұпайы бастапқы деңгейден сәл жоғары; Sol-дың 54,73 ұпайы 2,26 балға жоғары, ал Carbon-ның 60,60 ұпайы 8,13 балға алда. Бұл салыстырмалы шәкілдің ұпайлары, дұрыс жауаптардың пайызы емес: 2,26 балл айырмашылық "2,26%-ға ақылдырақ" дегенді білдірмейді. Жаңа модель қосылғанда да бекітілген базалық нүкте өзгеріссіз қалады.
Индекс қалай есептеледі
Әрбір тестің бастапқы нәтижелері зәкірлік Z-нормалау арқылы ортақ шкалаға келтіріледі — бұл 16 тірек модельдің орташа мәнінен ауытқуды олардың стандартты ауытқуына бөлу. Содан кейін олар салмақтар бойынша біріктіріледі: 40% Artificial Analysis, Vals және LiveBench үлесіне, 25% Arena WebDev-ке және 35% Agent Arena мен Bug Hunt-қа беріледі. Толық формула мен дереккөздер мақала соңында келтірілген.
Құны: Hydrogen мен бәсекелестерін тапсырма құны бойынша салыстыру
Маңызды нақтылау: ЖИ құнын салыстыру API арқылы пайдалануға қатысты, ал провайдерлердің жазылым лимиттері әртүрлі көлем береді. Sol 6.1 моделінің API арқылы Hydrogen-ге қарағанда тиімдірек болуы OpenAI жазылымы Google немесе Claude жазылымына қарағанда тиімдірек дегенді білдірмейді.
Біздің құн индексі 3 бенчмарк деректеріне негізделген — Artificial Analysis, LiveBench және Arena WebDev. Орташа алғанда, таңдалған тапсырмалар бойынша Hydrogen GPT-6.1 Sol-дан 62%-ға қымбатқа түседі, Gemini 4 Carbon-нан 23%-ға арзан және GPT-6.1 Terra-дан шамамен 2,7 есе қымбат. DeepSeek V4.1 Flash сияқты үнемді модельмен салыстырғанда, Hydrogen шамамен 8,4 есе қымбат.
Құн индексін қалай есептейміз
Бұл сандар қайдан алынды? Біз тапсырмалардың нақты құнын үш алаңда салыстырдық: Artificial Analysis, LiveBench және Arena WebDev. Әр алаңда тапсырма құны бірыңғай салыстырмалы шкалаға келтіріледі; содан кейін үш қатынас геометриялық орташа мәнмен біріктіріледі. Құн индексі салыстырмалы қымбаттықты көрсетеді. Hydrogen-нің 0,828 көрсеткіші — сұраныс үшін $0,828 емес, шартты сан. Мысалы, 0,828 / 0,513 = 1,62: бұл тапсырмалар себетінде Hydrogen Sol-дан 1,62 есе қымбат.
Индекс есептелген бастапқы бағалар:
| Модель | Artificial Analysis, $/тапсырма | LiveBench, $/сәтті тапсырма | Arena WebDev, $/тапсырма | Құн индексі |
|---|---|---|---|---|
| GPT-6.1 Terra | $0,96 | $0,673 | $0,65 | 0,308 |
| GPT-6.1 Sol | $1,27 | $0,823 | $1,86 | 0,513 |
| Gemini 4 Hydrogen | $3,16 | $1,924 | $1,35 | 0,828 |
| Gemini 4 Argon | $4,97 | $1,822 | $1,17 | 0,902 |
| Gemini 4 Carbon | $5,48 | $2,024 | $1,61 | 1,073 |
| DeepSeek V4.1 Flash | $0,60 | $0,195 | $0,12 | 0,099 |
Неліктен сандар әртүрлі? Әр алаң әртүрлі тапсырмаларды тексереді. Мысалы, WebDev-те Hydrogen Sol-дан арзан ($1,35 пен $1,86), бірақ Artificial Analysis-те ол қымбатырақ ($3,16 мен $1,27).
Парето шекарасы: әрі күшті, әрі арзан модельдер бар ма?
Парето шекарасы — бір уақытта интеллект индексі жоғары және шығыны азырақ бәсекелесі жоқ модельдер жиынтығы. Графикте әрбір нүкте бір модельді білдіреді. Нүкте неғұрлым жоғары болса, оның жалпы нәтижесі соғұрлым мықты; неғұрлым солға қарай орналасса, сынақ тапсырмаларын орындау соғұрлым арзан.
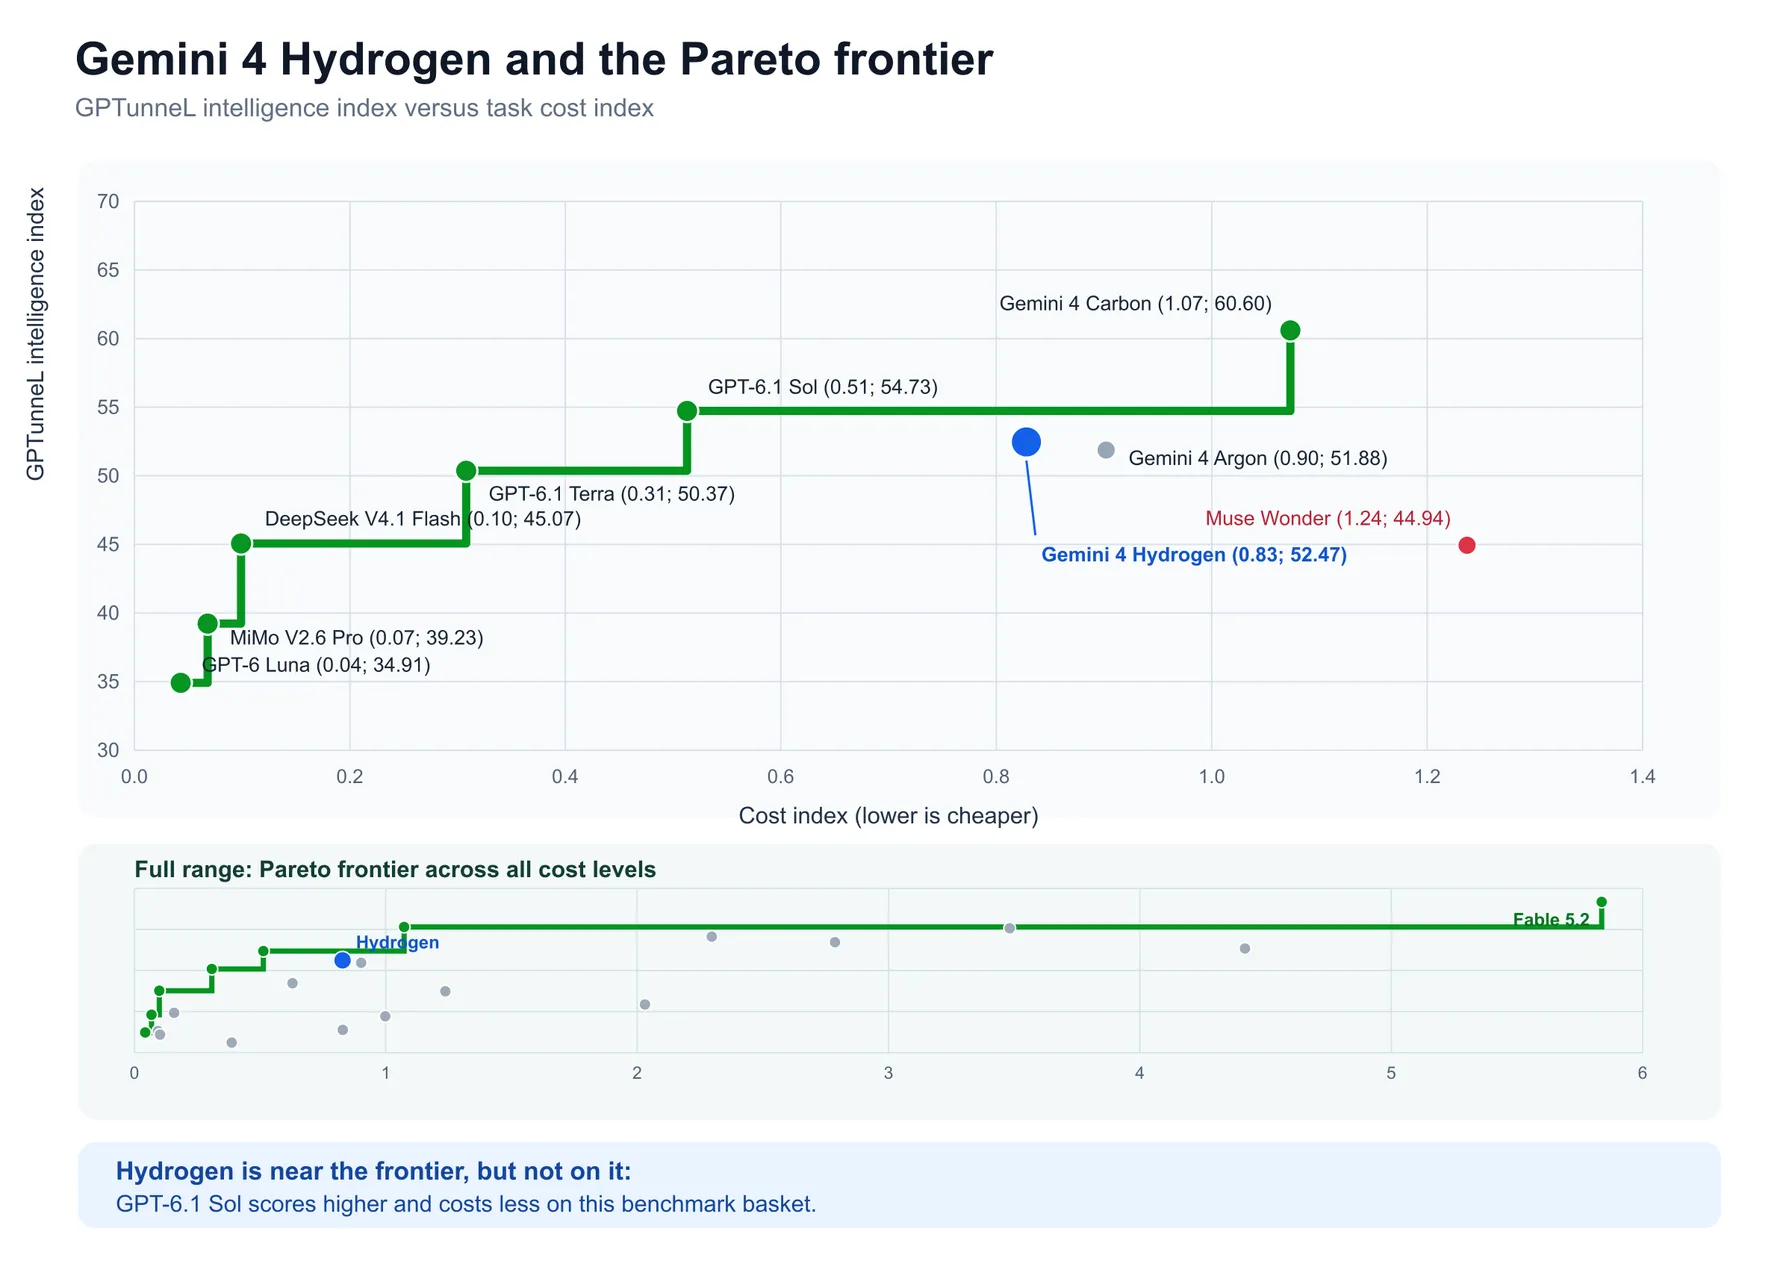
Бұл салыстыруда Hydrogen қатаң Парето шекарасына кірмейді: Sol 52,47-ге қарсы 54,73 балл жинап, 38%-ға арзан тұрады.
Тәжірибелік тест: 5000 жолдық есепті талдау шығындарын бағалау
Жаңа модельдің жұмысын тексеру үшін біз Gemini 4 Hydrogen, GPT-6.1 Sol және DeepSeek V4.1 Flash модельдеріне 5000 жолдан тұратын нақты жарнамалық есепті бердік. Деректерде алдын ала үш тұзақ жасырылды: қате деректері бар бір жалған жол, кірісі әдейі өсірілген жол және әріп регистрімен ғана ерекшеленетін қайталанатын жол.
Барлық үш модель де үш тұзақты толық тапты.
Бұдан бөлек, есепте табиғи күмәнді 18 жағдай кездесті. Claude Fable 5.2 модельдердің осы 18 жағдайды қалай өңдегенін және олардың қорытындыларындағы қателерді тәуелсіз сарапшы ретінде бағалады.
Әр прогонның салыстырмалы шығыны DeepSeek-пен салыстырылып, оның мәні 1× деп алынды. Sol үшін шығын қолданыстағы 50% жеңілдікпен көрсетілген.
| Модель | DeepSeek-ке қатысты шығын | Біздің тұзақтар | Fable 5.2 тұзақтары | Fable 5.2 бойынша қателер | Fable 5.2 қорытындысы |
|---|---|---|---|---|---|
| DeepSeek V4.1 Flash | 1× | 3-тен 3 | 18-ден 14 | 5 | 9 |
| GPT-6.1 Sol | 40,95× | 3-тен 3 | 18-ден 18 | 0 | 18 |
| Gemini 4 Hydrogen | 47,36× | 3-тен 3 | 18-ден 11 | 1 | 10 |
Hydrogen есебі ең қымбат болып шықты және салыстырмалы түрде құрғақ әрі толық емес болды.
Маған Sol 6.1 есебі көбірек ұнады. Ол ең егжей-тегжейлі болып шықты. DeepSeek жаман болған жоқ, бірақ қайталанған жолдың конверсиясын қос есептеуде бір қателік жіберді. Fable бағалауында да Sol ең жоғары нәтижеге қол жеткізді: Hydrogen-нің 10 және DeepSeek-тің 9 ұпайына қарсы 18 балл.
Hydrogen қаншалықты жылдам жұмыс істейді
Жылдамдықты салыстыру үшін біз Artificial Analysis бойынша бірыңғай есептелген уақыт көрсеткішін қолданамыз.
Қарапайым әрі жиі орындалатын тапсырмалар үшін модельдің жылдамдығы өте маңызды. Нәтижені 1 минутта алуға үйренген соң, 5 минут күту қиынға соғады. Интеллект бойынша жақын модельдер арасындағы сурет Hydrogen пайдасына өзгереді, егер тапсырманы орындау уақытын қоссақ:
| Модель | Интеллект индексі | Салыстырмалы құны | AA уақыты, мин |
|---|---|---|---|
| GPT-6.1 Terra | 50,37 | 0,308 | 14,7 |
| GPT-6.1 Sol | 54,73 | 0,513 | 23,2 |
| Gemini 4 Hydrogen | 52,47 | 0,828 | 13,9 |
| Gemini 4 Argon | 51,88 | 0,902 | ж/ж |
| Gemini 4 Carbon | 60,60 | 1,073 | 28,6 |
Hydrogen-нің есептік AA уақыты Sol-дың 23,2 минутымен салыстырғанда 13,9 минутты құрайды, яғни шамамен 40%-ға аз. Жауапты күту уақыты қымбатқа түсетін сервистер үшін бұл баға айырмашылығын толық ақтай алады.
Рейтингтегі басқа жылдам модельдерге қатысты:
| Модель | Artificial Analysis тапсырма уақыты |
|---|---|
| GPT-6 Luna | 11,8 мин |
| Mistral Large 4 | 12,3 мин |
| Gemini 4 Hydrogen | 13,9 мин |
| GPT-6.1 Terra | 14,7 мин |
| Gemini 3.8 Flash | 14,9 мин |
| GPT-6.1 Sol | 23,2 мин |
| Gemini 4 Carbon | 28,6 мин |
| Claude Fable 5.2 | 46,1 мин |
Hydrogen осы өлшемі бар 20 модельдің ішінде жылдамдығы бойынша 3-орында тұр.
Тәуелсіз әзірлеуші Саймон Уиллисон Hydrogen, Argon және Carbon-нан велосипедтегі пеликанның SVG-суретін жасауды сұраған. Hydrogen тапсырманы 19 секундта, Argon — 2 минут 29 секундта, Carbon — 4 минут 11 секундта орындады. Бірақ Hydrogen айтарлықтай қарапайым сурет құрып, аз токен пайдаланды. Уиллисонның салыстыруы.
Сондықтан нақты жұмыста бірден үш шаманы бағалаған дұрыс: нәтиже сапасы, толық уақыт және сәтті орындау құны. Қайта өңдеуді қажет ететін жылдам жауап баяу, бірақ дайын жауаптан қымбатырақ болып шығуы мүмкін.
Ал жазылым арқылы пайдаланса ше?
API бойынша әдетте кіріс және шығыс токендерінің көлемі үшін төлейді. Шотқа пайымдау көлемі, құралдарды шақыру және қайталау әрекеттері әсер етеді. Жазылым бойынша баға бекітілген, бірақ қолжетімді есептеулерге шектеулер бар. Сондықтан API арқылы қымбатырақ модель төленген жазылым ішінде тиімдірек болуы мүмкін.
Техникалық ерекшелік те бар: кэштеу. Сервис сұраныстың өңделген бөліктерін қайта пайдаланғанда, кіріс токендердің бір бөлігі арзанырақ болады. Hacker News пікірталасында Artificial Analysis қызметкері ретінде танысқан маман кэштелген токендердің үлесі жеке сынақтардың құнындағы күтпеген айырмашылықты түсіндіруге көмектесетінін айтқан.
Hydrogen және оның ең жақын бәсекелестері
Жалпы рейтинг әрқашан мамандандырылған тапсырмаларға сәйкес келе бермейді. Жалпы рейтингте көршілес орналасқан модельдердің бейінді мүмкіндіктері, бағасы мен өңдеу уақыты айтарлықтай ерекшеленеді.
| Модель | Интеллект индексі | Hydrogen-ге қатысты құны | AA уақыты |
|---|---|---|---|
| Claude Fable 5.1 | 55,35* | 5,3 есе қымбат | 22,3 мин |
| GPT-6.1 Sol | 54,73 | 38%-ға арзан | 23,2 мин |
| Gemini 4 Hydrogen | 52,47 | салыстыру нүктесі | 13,9 мин |
| Muse Wonder Full | 52,34* | деректер жеткіліксіз | ж/ж |
| Gemini 4 Argon | 51,88 | 9%-ға қымбат | ж/ж |
| GPT-6.1 Terra | 50,37 | шамамен 2,7 есе арзан | 14,7 мин |
Жұлдызша жалпы индекстегі бір болжанған бенчмаркті білдіреді.
Hydrogen мен GPT-6.1 Sol:
Sol жалпы индекс бойынша 52,47-ге қарсы 54,73 ұпайға ие және 38%-ға арзан. Hydrogen AA уақыты бойынша жылдамырақ: 23,2-ге қарсы 13,9 минут. Жеке тапсырмаларда Hydrogen Sol-ды басып озады: Vals индексінде 63,94-ке қарсы 68,49 және Agent Arena-да +12,40%-ға қарсы +14,80%. Есесіне Sol Bug Hunt сынағында көбірек белгісіз қателерді түзетеді: 105-тен 32,7-ге қарсы 44,3.
Hydrogen мен Gemini 4 Argon:
Жалпы бағалау дерлік сәйкес келеді: Hydrogen-де 52,47, Argon-да 51,88. Hydrogen шамамен 8%-ға арзан. LiveBench-те Argon күрделі пайымдау бойынша күштірек (88,6-ға қарсы 95,1), ал Bug Hunt-та көбірек қателерді түзетеді (32,7-ге қарсы 40,7). Hydrogen Agent Arena (10,72%-ға қарсы 14,80%) және Vals Code Migration бойынша алда (74,4%-ға қарсы 82,7%).
Hydrogen мен GPT-6.1 Terra:
Индекстегі айырмашылық шамалы: 50,37-ге қарсы 52,47. Бірақ Terra AA бойынша дерлік бірдей жылдам (13,9-ға қарсы 14,7 минут) және шамамен 2,7 есе арзан. Егер бюджет маңызды болса, алдымен Terra-ны тексерген жөн.
Hydrogen мен Claude Fable 5.1:
Fable 5.1 интеллект бойынша 55,35 балл жинады, бірақ 5,3 есе қымбат және AA бойынша 22,3 минут қажет етеді. Күнделікті жұмыс үшін Hydrogen анағұрлым тиімді таңдау болып табылады.
Ал арзан модельдер мен алдыңғы Gemini Flash туралы не деуге болады?
DeepSeek V4.1 Flash 1017 Hydrogen-нің 52,47 ұпайына қарсы 45,07 балл алды, бірақ шамамен 8,4 есе арзан. Код жасау тапсырмаларында нәтижелері жақын, ал Bug Hunt бойынша DeepSeek тіпті алда: түзетілген 32,7-ге қарсы 42,7 қате. MiMo V2.6 Pro Hydrogen-нен шамамен 12,2 есе арзан, бірақ жалпы рейтингте айтарлықтай әлсіз: 39,23 балл.
Hydrogen-ді Gemini 3.8 Flash-пен салыстыру алдыңғы буынмен салыстырғандағы өсімді көрсетеді:
| Көрсеткіш | Gemini 3.8 Flash | Gemini 4 Hydrogen |
|---|---|---|
| Интеллект индексі | 35,54 | 52,47 |
| Үш тесттегі орташа салыстырмалы шығын | 0,829 | 0,828 |
| AA уақыты | 14,9 мин | 13,9 мин |
| LiveBench: жалпы нәтиже | 57,3 | 77,0 |
| LiveBench: деректерді талдау | 54,0 | 83,2 |
| Bug Hunt: 105-тен түзетілген қателер | 18,0 | 32,7 |
| Agent Arena: сапаның өзгеруі | +2,34% | +14,80% |
Осы себет бойынша екі буынның шығыны іс жүзінде бірдей, ал Hydrogen-нің жиынтық нәтижелері әлдеқайда жоғары.
Мықты тұстары мен әлсіздіктері
Деректерді талдау: ең мықты бағыттардың бірі
LiveBench Data Analysis бөлімінде Hydrogen 83,2 балл жинап, 35 модельдің ішінде 3-орынға ие болды. Оның алдында тек Carbon (86,5) мен Argon (85,2) тұр; Astra (83,0), Sol (82,7) және Claude Fable 5.2 (81,5) артта қалды.
Деректерді визуализациялау құралдарын жасаушы Plotly компаниясының жеке сынағында DataAnalyticsBench бойынша модельдер 43 аналитикалық тапсырманы орындады. Hydrogen және Sol 43 тапсырманың 43-ін де орындады, Carbon — 42, Argon — 41. Бірдей максималды нәтижеде Sol жылдамырақ әрі арзанырақ болып шықты: әр тапсырмаға медиана 32 секундқа қарсы 18 секунд, ал толық прогон Hydrogen-нің $6,36 құнына қарсы $2,61 тұрды. Plotly зерттеуі.
Hydrogen кестелерді өңдеуде, деректерді түрлендіруде және есептер дайындауда өте мықты.
Агенттік жұмыс: ескертулерге өте жақсы жауап береді
Agent Arena сынағында құралдармен жұмыс істейтін ЖИ-агенттер өлшенеді. Hydrogen Net Improvement бойынша +14,80% жинап, 5-орынға ие болды. Әсіресе Steerability көрсеткіші — 20,53%, 2-орын. Бұл көрсеткіш агенттің пайдаланушының ескертуінен кейін жұмысты түзете алу қабілетін сипаттайды. Carbon-да ол 19,06%, Opus 5.5-те — 18,41%, Sol-да — 13,25%; тек Fable 5.2 32,91% көрсеткішпен жоғары тұр.
Пайдаланушы үшін бұл "бірінші нұсқаны жасау — ескерту алу — түзету" циклінде тамаша жұмысты білдіреді.
Бағдарламалау: сәтті код миграциясы және әлсіздеу Bug Hunt
| Сынақ | Hydrogen | Салыстыру үшін |
|---|---|---|
| Vals Code Migration: бағдарламаны басқа тілге көшіру | 82,7% | Carbon 80,1%; Argon 74,4%; Sonnet 87,4% |
| Arena WebDev: веб-интерфейстерді құру | 1704 Elo | Argon 1681; Sol 1743; Carbon 1768 |
| Bug Hunt: белгісіз қателерді өз бетінше іздеу және түзету | 105-тен 32,7 | Argon 40,7; Sol 44,3; Carbon 57,3 |
Бұл айырмашылық маңызды: Code Migration-де дайын бағдарлама бар, модель оны басқа тілге ауыстыруы керек. Bug Hunt-та белгісіз қателері бар репозиторий беріледі; агентке мәселенің қайда екенін өзі табуға тура келеді. Hydrogen біріншісін өте жақсы орындайды, ал екіншісінде көршілерінен артта қалады.
Үш Bug Hunt прогонында Hydrogen 43, 27 және 28 қатені түзетті. Бұл нәтиженің прогоннан прогонға айтарлықтай өзгеруі мүмкін екенін көрсетеді. Дегенмен модель күрделі қателерді табуға қабілетті: мысалы, MindStudio тестінде ол жапон иенасы мен корей вонындағы бағалардың жүз есе аз көрсетілуіне әкелген серверлік қатені өз бетінше анықтаған.
Ғылыми тапсырмалар
Күрделі сараптамалық сұрақтар бойынша HLE-Diamond тестінде Hydrogen Sol сияқты 58,8% жинады. Бағдарламалар мен құралдарды қолданатын көпсатылы зерттеулер жүргізілетін Terminal-Bench-Science сынағында оның нәтижесі 49,5% құрады. Sol 58,1%, Terra — 57,6%, Argon — 52,9% алды.
Қысқа ғылыми сұрақтарға жақсы жауап бергенімен, бірнеше кезеңнен тұратын ұзақ зерттеулерде қателіктер көбейеді.
Салық, қаржы және заң құжаттары
Vals Tax Agent сынағында Hydrogen 52,30% алып, Carbon (51,78%) мен Argon-ды (49,22%) басып озды. Vals Finance Index-те оның нәтижесі — 66,14%, ал Legal Research-те — 53,85%. Құрылымдалған құжаттарда нәтиже жақсы, дегенмен салықтық тексеруде Carbon-нан басымдық небары 0,52 пайыздық тармақты құрайды.
Көрнекі құжаттар мен күрделі пайымдаулар
Кестелерді мықты талдау күрделі сызбаларды немесе ерекше беттеуі бар PDF файлдарын дәл тануды білдірмейді. Көрнекі құжаттармен жұмыс істеу бойынша MKA тәуелсіз бағалауында Hydrogen 49,52% алды. Күрделі пайымдауларды тексеретін LiveBench Reasoning сынағында оның ұпайы 88,6 құрады, ал Argon-да бұл көрсеткіш 95,1.
Жалпы нәтижесі бірдей, бірақ бағыттары әртүрлі екі модель
Hydrogen мен Claude Sonnet 5.5 мысалы жақсы көрсеткіш бола алады. Жалпы LiveBench бойынша екеуі де бірдей 77,0 балл алды, бірақ тест ішіндегі нәтижелері мүлдем бөлек:
| LiveBench санаты | Hydrogen | Sonnet 5.5 |
|---|---|---|
| Деректерді талдау | 83,2 | 59,5 |
| Бағдарламалау | 78,5 | 77,2 |
| Браузерді қолдану | 77,1 | 89,3 |
| Күрделі пайымдау | 88,6 | 91,6 |
Hydrogen Sonnet-тен деректерді талдау бойынша 23,7 балға алда, бірақ браузермен жұмыс бойынша 12,2 балға қалыс қалады. Сонымен қатар Hydrogen Sonnet-тен шамамен 2,8 есе арзан.
Әзірлеушілер мен қауымдастық не дейді
Hacker News және Reddit талқылаулары негізінен оң пікірде. Пайдаланушылар Gemini 3.8 Flash-пен салыстырғандағы айтарлықтай өсімді, жылдам жауапты, құжаттарды өңдеу мен интерфейстер генерациясын атап өтуде.
Компаниялардың алғашқы сынақтары
Google анонсында Hydrogen-ге ерте қол жеткізген серіктестердің кейстері келтірілген:
| Компания | Не тексерілді | Нәтиже |
|---|---|---|
| Box | Ірі корпоративтік құжаттар мен кестелерді өңдеу | 3.8 Flash-тен шамамен екі есе жылдам, 12% аз токен |
| Pixelcut | Дизайн жасау бойынша 276 тапсырма | Барлық тапсырмалар орындалды, 1,8 есе жылдамдау |
| Cartwheel | Басқа модельдермен шешілмеген күрделі техникалық мәселе | Hydrogen екі проблеманы тауып, түзету ұсынды |
| LatchBio | Антиденелер қауіпсіздігі мен токсикологиясы | Өз тестінде Gemini-ден тыс ең үздік модельге (37%) қарсы 67% сәтті әрекет |
| STAN | Жауап пішімін дәл сақтау және жылдамдық | Кідіріс 28%-ға, токен шығыны 23%-ға қысқарды |
Google анонсындағы серіктестердің пікірлері.
Тәуелсіз эксперименттер
Puter фактілерді ойдан шығару бейімділігін тексерді. Зерттеушілер қате ақпараты бар 16 сұрақ құрастырып, әрқайсысын үш рет Hydrogen мен Gemini 3.8 Flash-ке берді. Әр модельдің 48 жауабының ішінде Hydrogen-де жалған дерегі бар бір ғана жауап болды, ал алдыңғы Flash-те — алтау. Жауаптың медианалық уақыты 4,7 секундқа қарсы 3,2 секунд болды, бірақ Hydrogen үшін 48 сұраныс $0,047-ге қарсы $0,232 тұрды. Puter зерттеуі.
MindStudio қателерді іздеу мен несиелік өтінімді талдауды сынады. Бір кейсте Hydrogen валюта бағасының дұрыс көрсетілмеу себебін тапты. Екіншісінде төрт субагенттің жұмысын үйлестіріп, несиелік құжаттардағы тәуекелдерді анықтады. MindStudio сараптамасы.
Reddit: сәтті тапсырмалар мен нақты кемшіліктер
Баспа платаларын тексеруде r/google_antigravity пайдаланушысы бірнеше модельді қолданып, Hydrogen-нің сигнал тұтастығы мәселелерін байқағанын хабарлады.
Қаржылық PDF өңдеуде r/Bard қатысушысы бірнеше құжатты Hydrogen Medium 3-4 секундта талдағанын жазды.
Ойын ЖИ-індегі сәтсіздік бойынша r/GeminiAI әзірлеушісі ойын қозғалтқышының логикасын кеңейту кезінде модельдің көптеген қателіктер жібергенін, оларды кейін Carbon жөндегенін хабарлады.
Hacker News: тәжірибелі әзірлеушілер неге назар аударады
Жылдамдық әрқашан үнемдеуді білдірмейді: data-ottawa қатысушысы өз тапсырмаларында Hydrogen-нің орындалу уақыты 3.8 Flash-ке қарағанда 40-60%-ға қысқарғанын, бірақ бір тапсырманың құны 37%-ға жоғары болғанын есептеді.
Жылдам модель орындаушы рөлінде: мамандар күштірек модель жоспар құрып, ал Hydrogen файлдармен және кодпен операцияларды орындайтын жүйелерді талқылауда.
Агенттің сирек қателері қымбатқа түсуі мүмкін: автономды жұмыста агенттің артық әрекеттер жасауы немесе сұралмаған файлдарды өзгертуі орын алуы мүмкін.
Қай тапсырмалар үшін Hydrogen-ді таңдаған жөн, ал қашан тиімдірек баламалар бар
| Сценарий | Hydrogen-ді таңдау керек пе | Не ескеру қажет |
|---|---|---|
| Кестелерді талдау және есептер дайындау | Ең үздік үміткерлердің бірі | LiveBench Data Analysis-те 83,2, Plotly-де 43/43; Sol арзанырақ болуы мүмкін |
| Код пен құжаттарды қайталап түзету | Жақсы таңдау | Steerability бойынша 2-орын, кері байланысқа тез жауап береді |
| Бағдарламаны басқа тілге көшіру | Жақсы таңдау | Code Migration-де 82,7%; бағдарлама сынақтары бәрібір қажет |
| Интерфейс прототипін жылдам жасау | Жарайды | WebDev Elo жоғары; визуалды түзетулер қажет болуы мүмкін |
| Жаппай арзан API тапсырмалары | Алдымен Terra, DeepSeek, MiMo-ны салыстыру | Олар біздің себетте айтарлықтай арзан |
| Үлкен жобада белгісіз қателерді өз бетінше іздеу | Sol немесе Carbon-ды тексеру | Bug Hunt-та Hydrogen азырақ қате түзетті |
| Құралдар мен есептеулермен ұзақ зерттеу | Неғұрлым терең модельдерді көру | Terminal-Bench-Science нәтижесі төменірек |
| Салық және заң материалдары | Көмекші ретінде қолдануға болады | Мықты профильдік сынақтар, маманның тексеруі қажет |
| Жазылым шеңберіндегі жұмыс | Өнім лимиттеріне қарау | API құн индексі тариф бойынша қанша тапсырма орындалатынын көрсетпейді |
Қорытынды
Gemini 4 Hydrogen — айқын мамандануы бар жылдам әрі жоғары сыныпты модель. Ол GPTunneL интеллект индексі бойынша 23 модельдің ішінде 8-орынды иеленді, деректерді талдау бойынша LiveBench-тің үздік үштігіне кірді және Artificial Analysis уақыты бойынша ең жылдамдардың бірі болды.
Оның мықты тұстары — кестелерді өңдеу, қолданыстағы кодты көшіру, құралдармен жұмыс істеу және кері байланыс бойынша жылдам түзету. Bug Hunt және ғылыми сынақтардағы қарапайым нәтижелер күрделі автономды әзірлеу үшін басқа модельдер қолайлырақ болуы мүмкін екенін көрсетеді.
Пайдаланушы үшін басты таңдау: Sol жалпы интеллект бойынша жоғарырақ және арзанға түседі, Hydrogen айтарлықтай жылдамырақ; Terra шамамен бірдей жылдамдықта айтарлықтай арзанырақ; Carbon мықтырақ, бірақ баяуырақ және қымбатырақ. Таңдау кезінде модельдің нақты нені орындауы керектігін, сәтті нәтиженің құнын және күтуге болатын уақытты бағалаған жөн.
Дереккөздер мен әдістеме егжей-тегжейі
Алты негізгі сынақ топтамасы: Artificial Analysis, Vals Index, LiveBench, Arena WebDev, Agent Arena, Bug Hunt Bench. Барлық сандық нәтижелер GPTunneL-дің 2026 жылғы 13 қарашадағы біріктірілген кесіндісінен алынған.
Интеллект индексі: Әрбір сынақ үшін модель нәтижесі мен 16 анықтамалық модельдің орташа мәні арасындағы айырмашылық осы топтың стандартты ауытқуына бөлінеді. Қорытынды балл: 50 + 10 × нормаланған нәтижелердің орташа салмағы. Салмақтар: AA, Vals және LiveBench үшін 13,33%-дан, WebDev үшін 25%, Agent Arena мен Bug Hunt үшін 17,5%-дан. Бес нәтижесі бар модельдер үшін тек бір жетіспейтін тест статистикалық түрде бағаланады.
Құн индексі: AA, LiveBench және WebDev тапсырмаларының құны әр тестің бекітілген тірек бағасына бөлінеді: $5,225 (AA), $1,873 (LiveBench), $1,475 (WebDev). Формула: C = [(AA/R_AA) × (LiveBench/R_LB) × (WebDev/R_WD)]^(1/3).