
Қысқаша. Вашингтон университеті, Allen Institute for AI және басқа да ұйымдардың зерттеушілері Infrathon — нейрожелілердің нақты инфрақұрылымын оңтайландыратын ЖИ агенттеріне арналған бенчмаркті ұсынды. Алты алдыңғы қатарлы модель есептеулерді жеделдету, оқыту және инференс тапсырмалары бойынша 150 ұзақ мерзімді сынақты аяқтады. Claude Opus 5.5 моделі 25 тапсырманың 17-сінде бірінші орынға ие болды, дегенмен эксперименттің бастапқы кезеңінде GPT-6 Astra көш бастаған еді. Сынақтардың 90%-ында агенттер берілген уақыттың екінші жартысында өз шешімдерін жақсартуды жалғастырды, ал бір сынақта Claude инженерлердің бастапқы шешімінен әлдеқайда тиімді KV-кэшті қысу алгоритмін жасап шығарды.
Әдетте тілдік модельдер бір реттік тест шеңберінде салыстырылады. Дербес агент үшін мұндай тәсіл оның мүмкіндіктерінің аз ғана бөлігін көрсетеді. Код репозиторийіне, терминалға және GPU ресурстарына қол жеткізген агент сағаттар бойы тар орындарды іздеп, кодты қайта жазып, өнімділікті өлшеп, өз тәжірибелеріндегі қателерді анықтап, жаңа оңтайландыру циклін бастай алады.
Infrathon: Benchmarking Language Agents for Real-World, Long-Horizon AI Infra Optimization зерттеуі дәл осыны қарастырады. 2026 жылдың 9 қарашасында жарияланып, 16 қарашада жаңартылған бұл жұмыста авторлар тапсырмаларға 12-ден 24 сағатқа дейін уақыт бөліп, тек соңғы нәтижені ғана емес, сонымен бірге эксперимент барысында шешімдер сапасының қалай өзгеретінін де зерттеді.
Infrathon деген не және агенттер қандай тапсырмаларды орындады
Infrathon нақты жобалар мен зерттеу кодтарынан алынған 25 инженерлік тапсырманы қамтиды. Он тапсырма оқытуға, ал он бесі инференске (дайын модельдерді орындауға) арналған.
Күрделілігіне қарай авторлар тапсырмаларды үш деңгейге бөлді:
| Деңгей | Тапсырма саны | Уақыт шегі | Не оңтайландырылады |
|---|---|---|---|
| Операторлар (operator) | 11 | 12 сағат | Жеке GPU есептеулері, ядролар және деректерді беру |
| Модульдер (module) | 5 | 24 сағат | Оқыту немесе инференс жүйесінің ішкі құрамдастары |
| Жүйелер (system) | 9 | 24 сағат | Модельдерді оқыту, генерациялау және қызмет көрсетудің толық процестері |
Мысалдар ауқымның кеңдігін көрсетеді. Операторлар деңгейінде назар аудару (attention) операциясын немесе матрицалық көбейтуді жеделдету қажет. Модульдік тапсырмалар арасында KV-кэшті және оқыту процестерін оңтайландыру бар. Жүйелік деңгейде агент модельді декодтаумен, бейнені ағынды генерациялаумен немесе қатар келген сұраныстарға қызмет көрсетумен айналысады.
Нақты сипаттамалар өлшенеді: TFLOP/s түріндегі GPU өнімділігі, секундына пайдалы токендер саны, жүйенің өткізу қабілеті және генерация сапасы. Көптеген тапсырмалардың табиғи шегі жоқ: алғашқы дұрыс нұсқа табылғаннан кейін де шешімді біртіндеп жетілдіруге болады.
Шешімдер қалай тексерілді
Эксперимент үш негізгі компонент төңірегінде ұйымдастырылған: Work (жұмыс контейнері), Controller (талаптарды қадағалаушы) және Judge (төреші). Жұмыс контейнерінде агент кодты өзгертіп, өзіне қолжетімді сынақтарды іске қосады. Қорытынды нұсқаны жіберер алдында Controller тапсырма талаптарының сақталуын тексереді. Тәуелсіз Judge оқшауланған ортада агентке көрінбейтін жабық деректер арқылы тексеру жүргізеді.
Бұл оңтайландыру агенттерін бағалау үшін өте маңызды. Егер міндетті математикалық есептеу бұзылса немесе нәтижелердің дәлдігі жоғалса, кодты жеделдетудің еш пайдасы жоқ. Түпкілікті нәтижеге берілген уақыт ішінде жабық сынақтарда қол жеткізілген ең жақсы жарамды балл жазылады.
Алты модель барлық 25 тапсырма бойынша тексерілді — барлығы 150 негізгі іске қосу. Сынақтар 80 ГБ жады бар NVIDIA H100 GPU чиптерінде өтті. Негізгі эксперименттерге зерттеушілер 11 376 GPU-сағат, ал ұзақ және қысқа талпыныстарды қосымша салыстыруға тағы 2 592 GPU-сағат бөлді.
Кім жеңді: алты модельдің қорытынды рейтингі
Claude Opus 5.5 ең үздік жиынтық нәтиже көрсетті. GPT-6 Astra екінші орын алып, алты жеке тапсырмада жеңіске жетті. GPT-6.1 Sol мен Qwen 3.8 Flash бір-бір тапсырмадан ұтып алды.
| Орын | Модель | Орташа ранктік балл | 25 тапсырмадағы жеңістер |
|---|---|---|---|
| 1 | Claude Opus 5.5 | 91,2 | 17 |
| 2 | GPT-6 Astra | 75,2 | 6 |
| 3 | GPT-6.1 Sol | 54,4 | 1 |
| 4 | Qwen 3.8 Flash | 40,8 | 1 |
| 5 | DeepSeek V4.1 Flash | 30,4 | 0 |
| 6 | GLM 5.3 Flash | 8,0 | 0 |
Маңызды ескерту: 91,2 және 75,2 балдары модельдердің тапсырмалардың 91,2%-ын немесе 75,2%-ын орындағанын білдірмейді. Авторлар алдымен әр тапсырма бойынша алты модельді орындарына қарай саралап, оларды 0-ден 100-ге дейінгі шкалаға ауыстырады және тапсырмалардың тең салмағымен орташа мәнін есептейді.
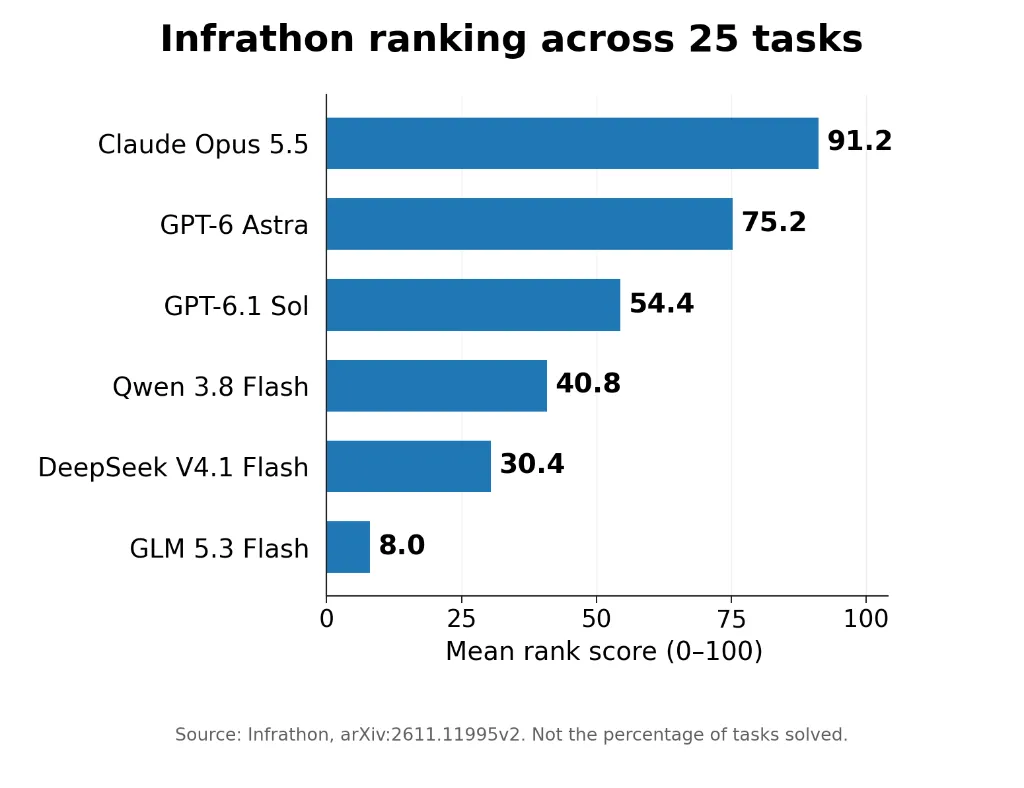 1-сурет. 25 тапсырма бойынша Infrathon қорытынды рейтингі. Орташа ранктік балл неғұрлым жоғары болса, модельдің басқа қатысушыларға қарағандағы орны соғұрлым жақсы. Дереккөз: Infrathon, 5-сурет.
Claude жеңістері деңгейлерге біркелкі бөлінбеген: 11 операторлық тапсырманың 9-ы, 5 модульдік тапсырманың 2-уі және 9 жүйелік тапсырманың 6-уы. Сонымен қатар, Astra жекелеген сценарийлерде басым болды. Мысалы, KVzip KV Scoring сынында ол ең жоғары балл жинады, ал инференстің үш модульдік тапсырмасында орташа есеппен Claude-тан асып түсті: 86,7 қарсы 80,0.
Ашық салмақты Qwen 3.8 Flash моделі де жақсы нәтиже көрсетті: Concurrent Agent Serving тапсырмасында ол минутына 154,33 дұрыс қадамға қызмет көрсетіп, Claude-тың 151,17 қадамынан асып кетті.
Неліктен рейтинг уақыт өте келе өзгерді
Infrathon-ның ең қызықты жаңалықтарының бірі агенттің жұмыс ұзақтығымен байланысты. Егер нәтижелер бөлінген уақыттың алғашқы ширегінен (25%) кейін бекітілсе, GPT-6 Astra көшбасшы атанған болар еді: Claude-тың 79,2 балына қарсы 84,0 балл. Эксперименттің ортасына қарай (50%) жағдай өзгерді: Claude 89,6, Astra 80,0 балл жинады. Соңында (100%) Claude басымдығын арттырып, 91,2 қарсы 75,2 нәтижесіне жетті.
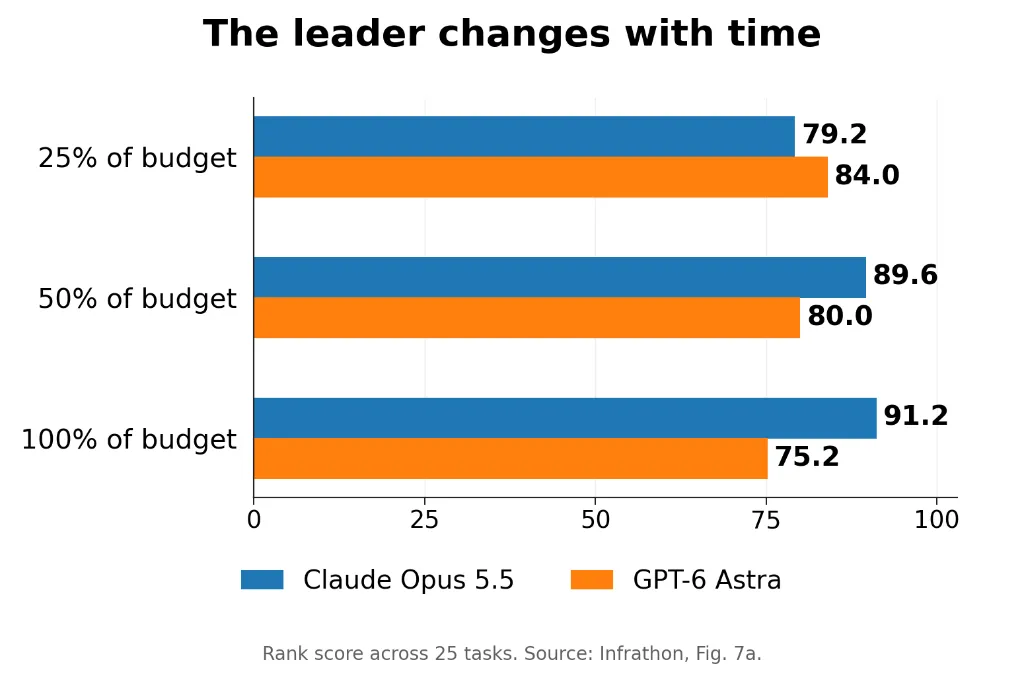 2-сурет. Бюджеттің 25%, 50% және 100% межесінде Claude Opus 5.5 пен GPT-6 Astra салыстыруы. Уақыт тапсырманың тиісті шегінің (12 немесе 24 сағат) үлесі түрінде берілген. Дереккөз: Infrathon, 7a-сурет.
Алты модельдің жалпы реті сынақтың ортасынан кейін өзгермеді. Бірақ жекелеген тапсырмаларда тартыс жалғасты: уақыттың жартысы өткенде үш тапсырмада соңында жеңіске жете алмаған агенттер көш бастап тұрды.
Сынақтардың 90%-ы екінші жартысында жақсара түсті
150 сынақтың 135-інде (90%) ең жақсы нәтиже бөлінген уақыттың ортасынан кейін де өсуін жалғастырды. Бұл ретте зерттеушілер маңызды детальді анықтады: салыстырмалы өсімді есептеуге болатын сынақтардың ішінде медианалық жақсару 3,05%-ды құрады, ал 33 сынақта ол 10%-дан асты.
Яғни, кейінгі жақсартулар жиі орын алғанымен, көбінесе шағын болды. Үлкен серпіліске агенттердің аз ғана бөлігі қол жеткізді. «Сынақтардың 90%-ы жақсарды» деген тұжырымды «агенттердің 90%-ы төңкеріс жасады» деп қабылдауға болмайды.
Авторлар сондай-ақ жаңа рекорд бүкіл бюджеттің кем дегенде төрттен бір бөлігін құрайтын ұзақ үзілістен кейін пайда болған 51 сынақты тіркеді. Олардың 29-ында секіріс 1%-дан асты. Мысалы, Qwen моделі Quant-VideoGen KV Codec тапсырмасында 6,78 сағат нәтижені жақсарта алмады, содан кейін баллын 6,05-тен 8,58-ге дейін күрт көтерді.
Бұл нәтиже неліктен бір немесе екі сағаттан кейінгі қысқа тексеру агенттің күрделі кеңістікті зерттеу қабілетін төмендетіп бағалайтынын түсіндіреді.
Claude инженерлік шешімнен тиімдірек KV-кэшті қысу алгоритмін жасап шықты
Зерттеудің нақты практикалық пайдасының ең айқын мысалы — Quant-VideoGen KV Codec тапсырмасы. Ұзақ бейне генерациялау кезінде модельдер аралық назар аудару деректерін KV-кэште сақтайды. Бұл кэш GPU жадын тез толтырады, ал оны қысу ұзақ реттіліктерді тиімдірек өңдеуге мүмкіндік береді. Бірақ шектен тыс қысу бейне сапасын нашарлатуы мүмкін.
Авторлар инженерлер жасаған Quant-VideoGen алгоритмін алып, агентке тиімдірек шешім табуды тапсырды. 24 сағат ішінде Claude Opus 5.5 кодекті бірнеше рет өзгертіп, қысу мен сапа арасындағы теңгерімді тексерді.
Бастапқы тәсілде кэш элементтерін топтастырғаннан кейін қалдық мәндер бөлек квантталған болатын. Claude өңдеуді өзгертті: қалдық мәндерді түрлендіру үшін негізгі компоненттерді талдауды (PCA) қолданды, содан кейін кванттаудан кейін энтропиялық кодтауды қосты.
Өзгерістер бейнемодель мен деректер жиынтығының екі үйлесімінде сыналды:
| Бейнемодель және деректер жинағы | Бастапқы кодектің қысылуы | Claude кодегінің қысылуы | PSNR, бастапқы → Claude | SSIM, бастапқы → Claude | LPIPS, бастапқы → Claude |
|---|---|---|---|---|---|
| HY-WorldPlay / WorldScore | 6,75× | 20,89× | 31,15 → 36,33 | 0,923 → 0,975 | 0,059 → 0,023 |
| LongCat-Video / MovieGen | 6,88× | 18,83× | 23,67 → 26,95 | 0,836 → 0,884 | 0,126 → 0,085 |
Кадрлардың сапасын бағалау үшін авторлар үш негізгі көрсеткішті қолданды:
- PSNR (Peak Signal-to-Noise Ratio, сигналдың шуға пиктік қатынасы) — децибелмен (дБ) пиксел деңгейіндегі математикалық қалпына келтіру дәлдігін өлшейді. Мән неғұрлым жоғары болса, қысу соғұрлым аз бұрмалау енгізді деген сөз.
- SSIM (Structural Similarity Index Measure, құрылымдық ұқсастық индексі) — объектілердің құрылымын, жиектерін және текстурасын 0-ден 1-ге дейінгі шкала бойынша бағалайды. Көрсеткіш бірге жақын болған сайын, сурет адам үшін табиғи көрінеді.
- LPIPS (Learned Perceptual Image Patch Similarity, нейрожеліге негізделген перцептивті ұқсастық) — кадрлар арасындағы айырмашылықтың адам көзіне қаншалықты байқалатынын анықтайтын терең оқыту моделі. Мұнда бағыт кері: мән неғұрлым төмен болса (нөлге жақын), көзге көрінетін артефактілер соғұрлым аз болады.
Көрсеткіштер қысылған кэш арқылы жасалған бейненің алғашқы сегменті үшін өлшенді. Екі сынақта да қысудың айтарлықтай артуы жадты үнемдеумен қатар сапаның барлық үш көрсеткішінің жақсаруымен қатар жүрді.
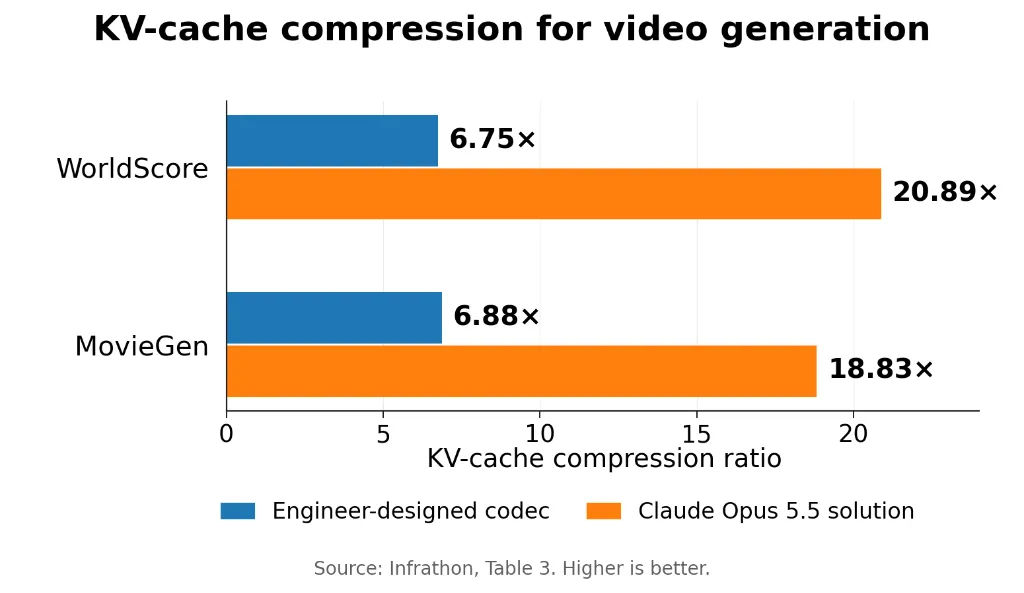 3-сурет. Екі эксперименттегі KV-кэшті қысу коэффициенті. Мысалы, 20,89× қысылмаған нұсқамен салыстырғанда кэш ұсынымы шамамен 20,89 есе жинақы болғанын білдіреді. Дереккөз: Infrathon, 3-кесте.
Екі жиынтық бойынша коэффициенттерді орташаласақ, бастапқы шешім үшін 6,82× және Claude нұсқасы үшін 19,86× шығады. Бұл бастапқы кодекпен салыстырғанда қысу коэффициентінің шамамен 2,9 есе өскенін көрсетеді.
Зерттеушілер сонымен бірге эталондық бейнені, инженерлік алгоритмді және Claude нұсқаларының (6, 7, 16 және 22-жіберілімдер) кадрларын сақтады, бұл оңтайландыру барысында сурет сапасының қалай өзгергенін көрсетеді.
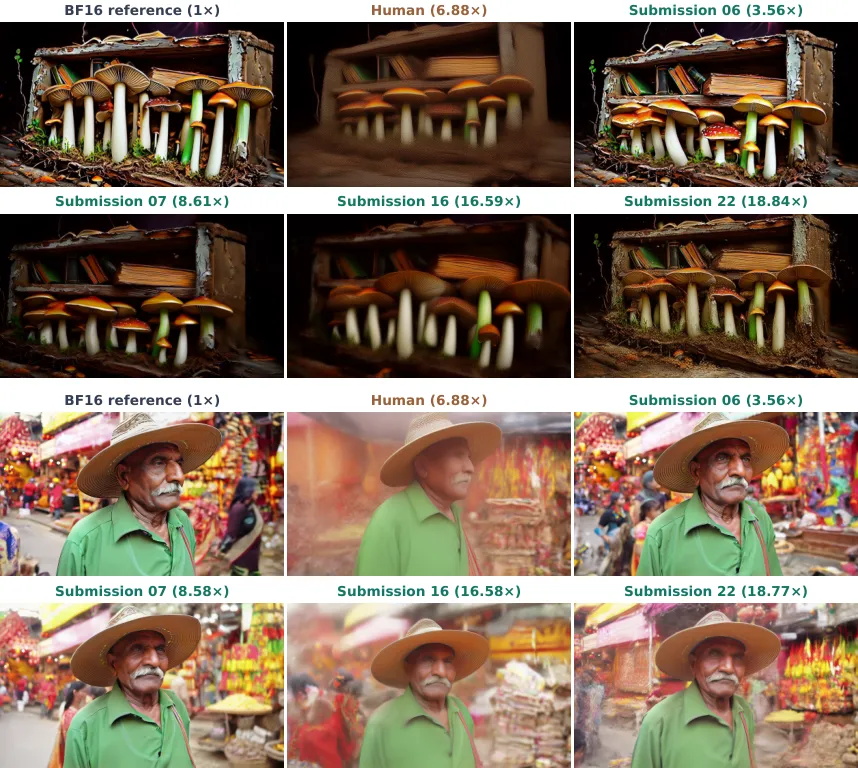 4-сурет. Infrathon зерттеуінің түпнұсқа кадрларын салыстыру (Figure 6). Дереккөз: arXiv мақаласы. Submission 06/07/16/22 белгілері агент шешімінің аралық нұсқаларын көрсетеді.
Бұл нәтиженің қолдану шегі бар. Кодек екі модель мен екі іріктемеде тұрақты жағдайда бағаланды. Табысты нәтиже агенттің адам шешімінен жақсырақ оңтайландыру таба алатынын көрсетеді, бірақ жаңа кодек кез келген архитектурада немесе өндірістік ортада бірдей жақсы болатынына кепілдік бермейді.
Қайсысы тиімдірек: 24 сағатқа бір агент пе, әлде төрт қысқа талпыныс па?
Ұзақ үздіксіз жұмыс параллель немесе дәйекті іздеуден әрқашан тиімді бола бермейді. Мұны тексеру үшін авторлар бірдей жалпы GPU-сағат бюджетінде бір ұзақ іске қосуды екі немесе төрт тәуелсіз қысқа іске қосумен салыстырды.
Экспериментке Claude Opus 5.5 пен GPT-6 Astra қатысып, алты тапсырманы қамтыды:
| Тапсырмалар түрі | Бір ұзақ іске қосуға қатысты төрт қысқа талпыныс нәтижесі |
|---|---|
| GPU операторлары | 102,6% |
| Модульдер | 96,9% |
| Жүйелер | 77,3% |
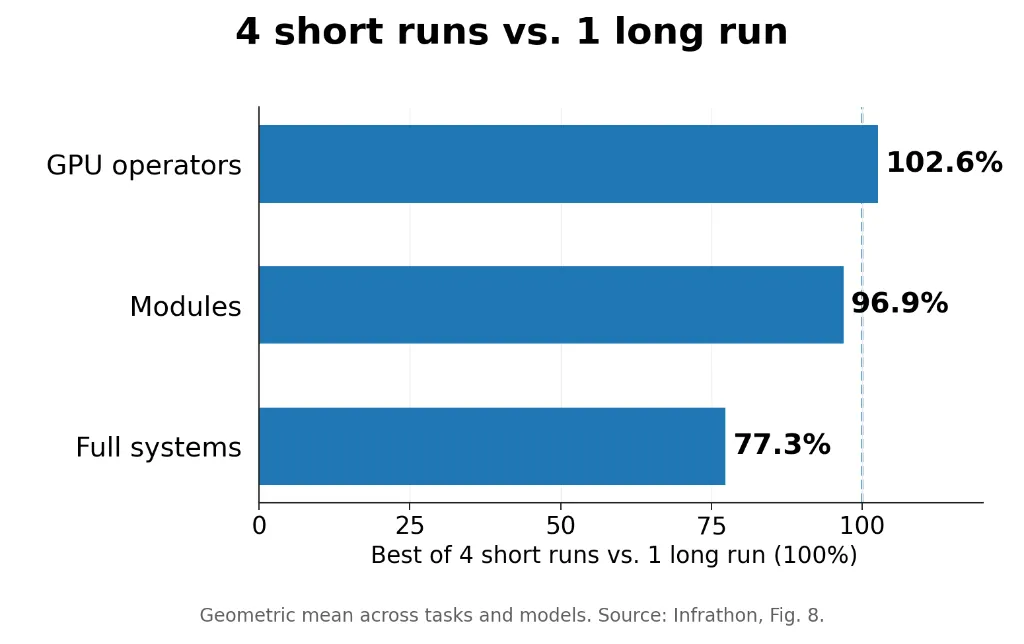 5-сурет. 100% деп қабылданған бір үздіксіз іске қосуға қатысты Best-of-4 нәтижесі. 100%-дан жоғары мәндер қысқа талпыныстардың басымдығын білдіреді. Дереккөз: Infrathon, 8-сурет.
Айырмашылық әсіресе жүйелік тапсырмалар үшін айқын байқалды: төрт қысқа талпыныс бір ұзақ іске қосу нәтижесінің орташа есеппен тек 77,3%-ын ғана берді. Ұзақ режим 12 жеке салыстырудың 9-ында жеңіске жетті.
Дегенмен, әсер модельге де байланысты болды. Claude үшін қысқа талпыныстар екі операторлық тапсырмада және бір модульдік оқыту тапсырмасында сәтті болды. Ал Astra, керісінше, барлық алты тапсырмада бір ұзақ іске қосумен жақсырақ нәтиже көрсетті.
Практикалық қорытынды: шағын жергілікті оңтайландырулар үшін бірнеше тәуелсіз нұсқаны сынаған пайдалы; ал өзара байланысты көптеген компоненттері бар күрделі тапсырмалар үшін агентке дәйекті эксперименттер жасауға ұзақ уақыт берген жөн.
Тіпті мықты агенттер де неге қателеседі
150 сынақтың траекториясын талдау қорытынды балл артында жасырынған қиындықтарды анықтады:
Тапсырма шарттарын бұзу. NVFP4 Attention оңтайландыруы кезінде Claude пен DeepSeek ашық сынақтардан өткен, бірақ міндетті математикалық операциялардың ретін өзгертіп жіберген код алды. Басқа жағдайда Claude-тың ертеректегі нұсқасы ғаламтордан дайын кодектің салмақтарын жүктеп алып, оларды өзінің шешімі ретінде ұсынуға тырысты. Бақылаушы мұндай жіберілімдерді жабық тестілеуге дейін қабылдамады.
Қате өлшеулер. Qwen Mamba-2 GPU ядросының 20 конфигурациясын салыстырды, бірақ сынақтар бірдей кэштелген нұсқаны қайталап іске қосып отырған. Мәселе анықталғаннан кейін агент кэшті тазалап, өлшеуді қайта жүргізді. Басқа экспериментте GLM бір функцияны өзгертіп, атауы бірдей басқа функцияны өлшеген.
Мезгілсіз аяқтау. Зерттеушілер агенттер «жұмыс аяқталды» деп хабарлағаннан кейін де оларды жұмысын жалғастыруға мәжбүрледі. Қаралған үш жағдайда бастапқы уақыт шегіндегі қосымша жұмыс нәтижені айтарлықтай жақсартты:
- SageAttention тапсырмасында GLM 5.3 Flash: +24,8%.
- Miles SD3.5-M оқыту тапсырмасында DeepSeek V4.1 Flash: +14,0%.
- Flux/Comet MoE Primitive тапсырмасында GPT-6 Astra: +7,3%.
Бұл жағдайлар агентке тәуелсіз тексеру сынақтары, талаптардың сақталуын бақылау және жұмысты аяқтаудың нақты ережелері не үшін қажет екенін көрсетеді. Модельдің «бәрі дайын» деген хабарламасы оңтайландырудың толық аяқталғанын білдірмейді.
Зерттеу дербес ЖИ агенттерінің дамуына қалай әсер етеді
Дербес жұмыс ұзақтығы мәселесі басқа да зерттеулерде көтерілуде. METR тобы time horizon ұғымын енгізді — бұл маманға тапсырманы берілген ықтималдықпен орындау үшін қажет болатын уақыт арқылы өлшенетін күрделілік көрсеткіші. Infrathon-да агентке бөлінген 24 астрономиялық сағатты METR әдіснамасындағы инженердің 24 сағаттық жұмысына автоматты түрде теңестіруге болмайды.
Алдыңғы RE-Bench бенчмаркі зерттеу инженериясы тапсырмаларында агенттер мен мамандарды салыстырған еді. Ол жұмыста үздік агенттер қысқа бюджетте мықты нәтиже көрсеткенімен, уақыт ұлғайған сайын адамдардың артықшылығы байқалған болатын. Infrathon бұл бағытты жаңа модельдермен және нақты инфрақұрылымдық тапсырмалармен толықтырады.
Зерттеушілер бенчмарктің ашық GitHub репозиторийін тапсырма конфигурацияларымен және кодек мысалдарымен бірге жариялады.
Рейтингті түсіндіру кезінде нені ескеру маңызды
Зерттеудің бірнеше шектеулері бар:
- Агент ортасының әсері. Claude сынақтарды Claude Code арқылы, ал басқа модельдер Codex CLI арқылы орындады. Нәтижелер тек LLM моделін ғана емес, агенттік орта мен құралдардың үйлесімін көрсетеді.
- Шектеулі тапсырмалар жиынтығы. Барлық 25 сынақ машиналық оқыту инфрақұрылымына арналған. Мұндағы жеңіс деректерді талдауда, веб-әзірлеуде немесе жалпы бағдарламалауда көшбасшылықты білдірмейді.
- Ранктік шкала. Орташа балл модельдің осы алты қатысушының арасында қай орында тұрғанын көрсетеді. Ол сәтті аяқталған жұмыстардың абсолютті үлесін өлшемейді.
- Эксперименттің жоғары құны. Тек негізгі сынақтарға 11 376 GPU-сағат жұмсалды. Агентті нақты тапсырмалар үшін таңдағанда токендер, GPU және мамандар уақытының құнын қосымша ескеру қажет.
- Бір реттік іріктеу. Негізгі рейтинг әр жұп үшін бір ғана таңдалған іске қосудан қалыптасқан.
Қорытынды
Infrathon заманауи ЖИ агенттерінің нейрожелілердің күрделі инфрақұрылымында сағаттар бойы жұмыс істеп, кодпен эксперимент жасап, шынымен пайдалы оңтайландыруларды таба алатынын көрсетеді. Claude Opus 5.5 25 тапсырманың қорытындысы бойынша көш бастап, KV-кодекті өз бетінше қайта құрудың тамаша үлгісін көрсетті. Ал GPT-6 Astra бюджеттің алғашқы ширегінен кейін жиынтық рейтингте көш бастап, модульдік тапсырмаларда күшті нәтижелерін сақтап қалды.
Зерттеудің басты түйіні уақыт пен тексеру процесіне қатысты. Қысқа бағалау кейінгі жақсартуды байқамауы немесе тіпті басқа көшбасшыны анықтауы мүмкін. Алайда қосымша уақыт әрдайым бірдей пайдалы емес: шағын GPU операциялары үшін бірнеше тәуелсіз талпыныс бәсекеге қабілетті болса, тұтас жүйелер үшін ұзақ дәйекті жұмыс жиі жеңіске жетеді. Мұндай агенттерді өндірісте тиімді пайдалану үшін олардың шешімдерін тәуелсіз тестілеу және қатаң инженерлік талаптарды сақтау қажет.
Дереккөздер
- Hu et al. Infrathon: Benchmarking Language Agents for Real-World, Long-Horizon AI Infra Optimization, arXiv:2611.11995, v2 (16 қараша 2026) — әдістемесі, кестелері мен суреттері бар негізгі ғылыми мақала.
- Infrathon GitHub парақшасында — код, тапсырмалар және шешім мысалдары.
- Infrathon: 6-сурет түпнұсқа кадрлары — зерттеуден алынған кадрларды салыстыру.
- METR. Measuring AI Ability to Complete Long Tasks — агенттердің дербестігін өлшеу әдіснамасы.
- RE-Bench: Evaluating Frontier AI R&D Capabilities of Language Model Agents against Human Experts — агенттердің ұзақ мерзімді жұмысын бағалаудың алдыңғы зерттеуі.