
Қысқаша. MathArena тәуелсіз математикалық рейтингінің 13 қарашадағы жаңартуында Gemini 4 Carbon 85,4% күтілетін тиімділікпен бірінші орынға шықты. Одан кейінгі орындарда Claude Fable 5.2 (82,8%) және GPT-6.1 Sol (80,6%) тұр. Бірақ модельдердің бір есепті шешуге жұмсайтын орташа шығыны айтарлықтай ерекшеленеді: сәйкесінше $15,70, $40,20 және $1,07. Carbon жалпы бағалау бойынша Sol-дан 4,8 пайыздық тармаққа озып кеткенімен, оның құны 14,7 есе жоғары. Бұл сапа бойынша бірінші орын мен ең тиімді экономикалық нәтиже мүлдем басқа модельдерге тиесілі болатын жарқын мысал.
Google Gemini 4 Carbon моделін пайдаланушылар мен әзірлеушілердің кең ауқымына 2026 жылғы 10 қарашада ұсынды. Компания оны күрделі ғылыми, инженерлік және көпсатылы агенттік міндеттерге арналған ең қуатты моделі ретінде таныстырды. Үш күннен кейін тәуелсіз MathArena жобасы Carbon мен Claude Fable 5.2 нәтижелерін математикалық көшбасшылар тақтасына қосты. Бұл тек шешімдердің сапасын ғана емес, сонымен бірге модельдердің жауапқа қол жеткізуі үшін қажет есептеу шығындарын да салыстыруға мүмкіндік берді.
Рейтинг: үш жетекші модель және баға айырмашылығы
16 қарашадағы MathArena жария кестесіне сәйкес, алғашқы орындар келесідей бөлінді:
| Модель және режим | Орын | Күтілетін нәтиже (Expected performance) | Бір есепке шығын (Expected cost) | GPT-6.1 Sol-дан қымбат |
|---|---|---|---|---|
| Gemini 4 Carbon (high) | 1 | 85,4% ± 3,0 п. т. | $15,70 ± $1,33 | 14,7 есе |
| Claude Fable 5.2 (max) | 2 | 82,8% ± 5,3 п. т. | $40,20 ± $2,59 | 37,6 есе |
| GPT-6.1 Sol (max) | 3 | 80,6% ± 2,7 п. т. | $1,07 ± $0,018 | 1 есе (Базалық) |
Дереккөз: MathArena, Model performance. Барлық мәндер кез келген пайдаланушы сұрауының әмбебап бағасына емес, көрсетілген параметрлер мен MathArena әдістемесіне қатысты.
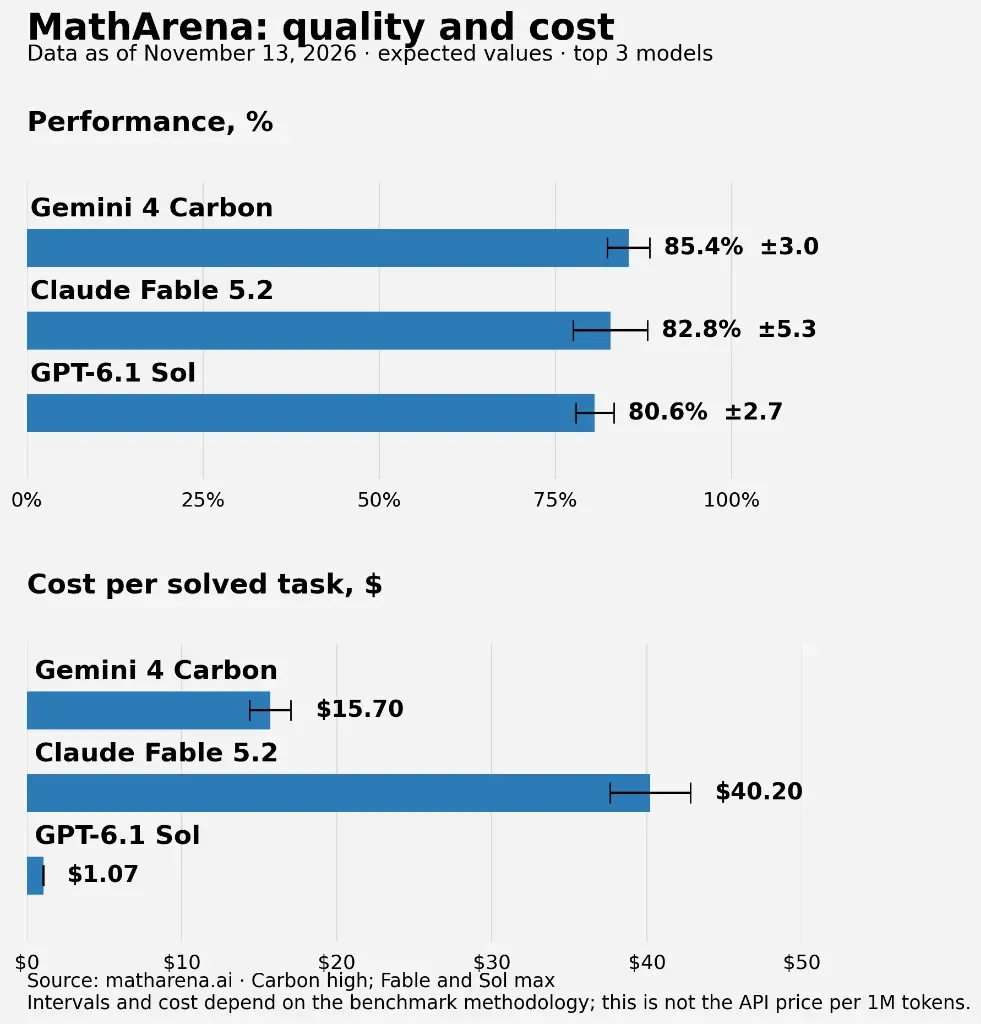
MathArena деректері бойынша инфографика (2026 жылғы 16 қараша). Жоғарғы панель сенімділік аралықтарымен күтілетін нәтижені көрсетеді, төменгі панель — бір тапсырмаға шаққандағы шығынды АҚШ долларымен көрсетеді.
Бірінші және үшінші модельдер арасындағы нәтижелер айырмашылығы 4,8 пайыздық тармақты құрайды. Кейбір жарыстарда және бірнеше рет қайта іске қосу кезінде қосымша пайыздар маңызды рөл атқарады. Бірақ егер тапсырма қайта іске қосуға және жауапты автоматты түрде тексеруге мүмкіндік берсе, экономикалық тиімділік бір конфигурацияның шамалы артықшылығынан маңыздырақ болуы мүмкін.
Claude Fable 5.2-нің екінші орны да назар аудартады. Орталық бағалау бойынша ол Carbon-нан 2,6 тармаққа артта қалғанымен, оның шешімі Carbon-нан 2,5 еседен астам және Sol-дан шамамен 37,6 есе қымбатқа түседі. Бұл сынақта жоғары есептеу қарқындылығы Anthropic-ке абсолютті нәтиже бойынша да, тиімділік бойынша да көшбасшылықты қамтамасыз ете алмады.
MathArena нақты нені өлшейді
Expected performance көрсеткішінің мәнін дұрыс түсінбеу оңай. 85,4% көрсеткіші Carbon барлық салыстырылатын модельдер үшін толық сәйкес келетін бір ортақ есептер жиынтығының 85,4%-ын тікелей шешті дегенді білдірмейді. MathArena әртүрлі форматтағы және модельдер бойынша әртүрлі қамтылуы бар бірнеше математикалық жарыстардың нәтижелерін біріктіреді.
Жоба математикалық олимпиадалар мен зерттеу сайыстарының жаңа есептерін пайдаланады. Бұл модельдің оқыту кезінде шешімді көріп қою қаупін азайту үшін маңызды. Қолжетімді әрбір тапсырма үшін модель төрт рет іске қосылады. Кейбір тапсырмалар ішінара балл қоюға мүмкіндік береді; есептеу кезінде тапсырма бойынша орташа байқалған нәтиже мұндай бөлшек бағаларды сақтайды.
Модель тапсырмалардың бір бөлігінде сыналмаған кезде, MathArena жетіспейтін нәтижелерді екі параметрлі Item Response Theory (IRT) көмегімен бағалайды. Қарапайым тілмен айтқанда, бұл нейрожелінің жалпы күшін және нақты сұрақтың күрделілігін ескеретін модель. Қорытынды expected performance — барлық өзекті тапсырмалар бойынша орташа баға, онда бақыланатын деректер бағалау мәндерімен біріктірілген. Белгісіздік интервалдары нәтижелерді модельдеу және параметрлерді қайта сәйкестендіру арқылы алынады.
Шығындар да осыған ұқсас есептеледі: бұл бір тапсырманы бір рет орындауға жұмсалатын күтілетін долларлар. Тікелей шығыны белгісіз жарыстар үшін жоба оны белгілі шығындар негізінде жасалған модель бойынша бағалайды. Демек, $15,70 немесе $1,07 барлық пайдаланушыларға қойылатын тұрақты төлем емес, нақты сынақ жүктемесінің орташа бағасы.
Бұл ескертпелер іс жүзінде маңызды. 85,4% ± 3,0, 82,8% ± 5,3 және 80,6% ± 2,7 аралықтары бір-бірімен қиылысады. Сондықтан ағымдағы кесте бойынша Carbon кез келген математикалық есепте Fable немесе Sol-дан статистикалық тұрғыдан асып түседі деп сенімді түрде айту мүмкін емес. Дұрысы: Carbon MathArena-ның қабылданған әдістемесі мен орталық бағалауы бойынша бірінші орынды иеленеді.
Жеке жарыстар ішінде не болып жатыр
Жалпы саннан гөрі кейде тапсырмалардың бейіні маңыздырақ болады. MathArena кестелерінде ArXivMath және BrokenArXiv, сондай-ақ формалды дәлелдеулерге бағытталған ArXivLean жарыстары бойынша нәтижелер қолжетімді.
| Жарыс | Gemini 4 Carbon (high) | Claude Fable 5.2 (max) | GPT-6.1 Sol (max) |
|---|---|---|---|
| ArXivMath, қазан 2026 | 93,62% | 93,62% | 90,43% |
| BrokenArXiv, қазан 2026 | 82,72% | 73,46% | 80,25% |
| BrokenArXiv, қыркүйек 2026 | 82,39% | 80,50% | 82,70% |
| ArXivLean, қыркүйек 2026 | 62,26% | Деректер жоқ | 35,85% |
Дереккөздер: MathArena-дағы Gemini 4 Carbon, Claude Fable 5.2 және GPT-6.1 Sol парақшалары. «Деректер жоқ» нөлдік баллды емес, осы жарыс бойынша сынақтардың болмағанын білдіреді.
Бұл егжей-тегжей көшбасшылықты қабылдауды өзгертеді. Қазан айындағы ArXivMath-та Carbon мен Fable бірдей 93,62% бағаға ие, ал Sol небәрі үш тармақтан сәл көбірек артта қалады. Қазандағы BrokenArXiv-те Carbon Sol-дан 2,5 тармаққа озады, ал Fable айтарлықтай қалып келеді. Бірақ қыркүйектегі BrokenArXiv-те Sol-дың нәтижесі тіпті Carbon-нан сәл жоғары — 82,39%-ға қарсы 82,70%. Бір ғана жарыс бойынша тұрақты жеңімпазды жариялау мүмкін емес.
Ең байқалатын алшақтық қыркүйектегі ArXivLean-де байқалады: Carbon-да 62,26% және Sol-да 35,85%. Бұл формалды дәлелдеуге байланысты тест; ол математикалық жұмыстың жекелеген түрлерінде Carbon-ның артықшылығы шынымен үлкен болуы мүмкін екенін көрсетеді. Бірақ бұл артықшылықты қосымша сынақтарсыз барлық тапсырмалар сыныбына таратуға болмайды.
Токендер бағасы жақын болғанда, Carbon неге 15 есе қымбатқа түседі
Ең күтпеген тұс — миллион токен үшін тариф пен шешілген есептің бағасы арасындағы айырмашылық. Жарияланым кезінде Google Carbon үшін миллион кіріс токеніне $2 және миллион шығыс токеніне $10 болатын бастапқы бағаны белгіледі. GPT-6.1 Sol-дың ресми стандартты бағасы да осындай: сәйкесінше $2 және $10. Егер тек прайс-парақтарға қарасақ, модельдер бірдей көлемдегі токендерді өңдеу құны бойынша ұқсас болып көрінеді.
Бірақ нақты агенттік сессияда модельдің нәтиже алғанға дейін орындайтын жұмыс көлемі шешуші рөл атқарады. Ұзақ пайымдаулар, құралдарды жиі шақыру, қайта есептеулер, аралық тексерулер және сәтсіз әрекеттер жалпы шығынды арттырады. Максималды табандылығы бар модельде тамаша қорытынды нәтиже болуы мүмкін, бірақ оған апаратын жол өте қымбатқа түседі.
MathArena жариялаған BrokenArXiv-тегі шығыс токендерінің шығыны осыны дәлелдейді: Carbon-да жиынтықта шамамен 540 мың, ал Fable-де қазан айындағы сынақта 600 мыңнан астам токен жұмсалған. Бұл көлемдер күрделі математикалық есептің құны неге ондаған доллармен өлшенетінін түсіндіреді.
MathArena зерттеушісі Яспер Деконинк (Jasper Dekoninck) Carbon-ның сипатты сәтсіздіктеріне назар аударды. Оның бақылауынша, модель көбінесе уақыт лимитіне тіреліп, шешім іздеуді өз еркімен сирек тоқтататын. Бір эпизодта ол орындалу барысын тексерместен сценарийді 11 сағаттан астам уақытқа іске қосқан. Табандылық есеп ұзақ зерттеуді талап еткен кезде пайдалы, бірақ уақыт пен бюджетті бақылаусыз ол кемшілікке айналады. Бұл эпизод туралы The Decoder зерттеушінің жазбасына сілтеме жасай отырып хабарлады.
Тағы бір салыстыру шектеуі: модельдердің құралдарды пайдалану шарттары әртүрлі. MathArena карточкаларында Carbon үшін Google Antigravity ортасы арқылы іске қосу, Fable үшін — Claude Code, ал Sol үшін — Codex көрсетілген. Біз тек стерильді ортадағы базалық модельдерді емес, нақты жұмыс конфигурацияларын салыстырамыз.
Google Carbon-ның жоғары шығындарын қалай түсіндіреді
Google-дың ресми позициясы айырмашылықты түсінуге көмектеседі. Компания Gemini 4 Argon-ды күнделікті инженерлік және интеллектуалдық жұмыстарға, ал Carbon-ды мақсатты ұзақ ұстап тұруға, құралдарды үйлестіруге және кеңейтілген тексеру циклдерін жүргізуге тура келетін міндеттерге жатқызады. Қараша айындағы хабарландыруда Google ғылыми зерттеулерге, күрделі бағдарламалық жасақтаманы әзірлеуге, құжаттарды талдауға және ақпараттық жүйелерді қорғауға баса назар аударады.
Вендордың мәлімдемелері бойынша, Carbon тек математикада ғана емес, сонымен қатар CursorBench 4.0, WANDR және AutomationBench бойынша да мықты нәтижелер көрсетеді. Бұл нәтижелер модельдер жұмысының басқа қырларын өлшейді. Мұнда қызықты сәйкессіздік туындайды: Google бірқатар агенттік сценарийлерде Carbon жоғары нәтижені жақсы экономикамен біріктіреді деп мәлімдесе, MathArena жүктемесінде Sol әлдеқайда арзан болып шығады.
Google сонымен қатар кіріспе API бағалары кезеңінің аяқталатынын хабарлады: 2026 жылғы 1 желтоқсаннан бастап Carbon тарифі миллион кіріс токені үшін $4 және миллион шығыс токені үшін $20-ға дейін өсуі керек. Егер сессияның қалған параметрлері өзгеріссіз қалса, бұл тарифтердің екі есе өсуі шығындардың шамамен екі есеге артуына әкеледі. Бірақ MathArena бағасын $15,70-тен $31,40-қа автоматты түрде қайта жазуға болмайды: рейтинг болашақ төлемнің болжамын емес, нақты қолданылған тарифтерді, кэштеуді және есептеу құрылымын көрсетеді.
Carbon, Fable немесе Sol-ды қалай таңдау керек
Практикалық қолдану үшін нәтижелер бір модельді екіншісімен әмбебап ауыстыруды емес, міндеттерді күрделілігіне қарай бөлу стратегиясын ұсынады.
- GPT-6.1 Sol жаппай математикалық және талдамалық сұрақтар легі үшін оңтайлы үміткер болып көрінеді, мұнда құн, жылдамдық және жауапты қайта тексеру мүмкіндігі маңызды. Тестте ол күтілетін нәтиже бойынша көшбасшыдан бес тармақтан аз қалып келеді, бірақ дерлік 15 есе арзанға түседі.
- Gemini 4 Carbon күрделі тапсырмалар үшін қызықты, мұнда сәтті шешімнің қосымша мүмкіндіктері ұзақ ізденісті ақтай алады. Әсіресе оны формалды дәлелдеулер мен көпсатылы есептеулерде тексерген жөн. Агенттер арқылы жұмыс істегенде уақыт, құралдарды шақыру саны және бюджет бойынша қатаң шектеулер қажет.
- Claude Fable 5.2 бұл рейтинг бойынша математика үшін үнемді таңдау ретінде көрінбейді. Бірақ MathArena модельдің барлық мүмкіндіктерін өлшемейді. Егер код, инженерлік жұмыс, басқа Claude құралдары маңызды болса, оны бөлек бағалаған жөн.
Биік жүктемелі өндірістік жүйелерде каскадты құруға болады: әдеттегі тапсырмаларды үнемді модельге жіберу, нәтижені есептеулермен немесе екінші тәуелсіз әдіспен тексеру, ал Carbon-ның қымбат режиміне сәтсіздік немесе қателік құны өте жоғары болған жағдайда ғана жүгіну.
Қорытынды: бірінші орын мен тиімділік — екі бөлек көрсеткіш
13 қарашадағы жаңартудан кейін Gemini 4 Carbon шынымен MathArena-да көш бастады. Бірақ көшбасшылық нақты бағалау жүйесіндегі күтілетін тиімділікке қатысты. Дәл осы жүйеде Carbon бір тапсырмаға $15,70, ал GPT-6.1 Sol $1,07 тұрады. Claude Fable 5.2 сапа бойынша екінші орынды үштіктің ішіндегі ең жоғары бағамен алады.
Sol «барлық жағынан Carbon-нан жақсы» немесе Carbon «әрқашан 15 есе қымбат» деген қорытынды жасауға болмайды. Есесіне модельді таңдаудың пайдалы ережесін тұжырымдауға болады: тек рейтингтегі орынға және миллион токен бағасына қарамай, сапаны, токендерді тұтынуды, агенттің әрекетін және бір аяқталған тапсырмаға жұмсалған шығындарды салыстыру. Жаңа MathArena деректерінің практикалық құндылығы дәл осында.
Дереккөздер
- MathArena, expected performance / expected cost есептеудің ресми рейтингі мен әдістемесі
- MathArena, Gemini 4 Carbon толық нәтижелері
- MathArena, Claude Fable 5.2 толық нәтижелері
- MathArena, GPT-6.1 Sol толық нәтижелері
- Google, «Gemini 4 Carbon is now available», 10 қараша 2026
- Google, «Introducing Gemini 4 Carbon», тарифтер мен модель анонсы
- OpenAI, GPT-6.1 Sol ресми бағалары
- The Decoder, Яспер Деконинктың Carbon шектеулері туралы түсініктемесі