
Жасанды интеллект жасақтаушылары мәнмәтін терезесінің өлшемі бойынша жарысып келеді: модель бір уақытта қаншалықты көп ақпаратты өңдей алса, соншалықты жақсы деп есептеледі. Алайда NVIDIA зерттеушілері бұл логикаға күмән келтірді. Олардың эксперименттерінде нейрожелілер әр әрекеттен кейін диалог тарихы қысқартылып отырса да, күрделі тапсырмаларды сәтті орындап шықты. Бұл қалай мүмкін болғанын, өзге зерттеулердің не көрсететінін және нақты өмірде ЖИ қанша мәнмәтін жұмсайтынын талдаймыз.
Неліктен нейрожелілердің мәнмәтіні үнемі ұлғайтылады
ChatGPT арқылы күрделі бір жобамен бірнеше сағат қатарынан жұмыс істеп жатырсыз деп елестетіңіз. Архитектураны талқылайсыз, қателерді түзейсіз, құжаттар жүктейсіз, талаптарды өзгертіп, біртіндеп нәтижеге жақындайсыз.
Кезекті сұраққа жауап беру үшін нейрожеліге алдыңғы хабарламалардағы деректер қажет болуы мүмкін. Сұхбат ұзарған сайын, назарға алынатын мәліметтер көлемі де ұлғая береді.
Бұл — мәнмәтін (контекст), яғни тілдік модель кезекті сұранысты өңдеген сәтте қолжетімді болатын ақпарат. Мәнмәтін терезесі токендермен — мәтіннің шағын бөлшектерімен өлшенеді. Мәнмәтінге хабарламалар, нұсқаулықтар, құжаттар, құралдардың жауаптары және ЖИ-агенттің бұрынғы әрекеттерінің тарихы кіреді.
Үлкен терезе көлемді материалдарды алдын ала қысқартпай тұтас өңдеуге мүмкіндік береді. Сондықтан оның өлшемін ұлғайту маңызды технологиялық артықшылық ретінде қабылданады. Бірақ нейрожеліге үнемі барлық тарихты көз алдында ұстау шынымен қажет пе?
2026 жылдың қарашасында NVIDIA зерттеушілері осы сұраққа эксперименттік жолмен жауап іздеген You Don't Need Long Context атты ғылыми жұмысын жариялады.
NVIDIA зерттеуі: нейрожелілер қысқа мәнмәтінмен де жұмыс істей алады
Зерттеу авторлары мәнмәтінді қысқарту ұзақ әрі күрделі тапсырмалардың орындалуына қалай әсер ететінін тексерді. Тестілер арасында SWE-bench Verified және Terminal-Bench 2.1 бенчмарктері бар. Оларда агенттерге бағдарламалық жобаларды зерттеу, қателерді түзету, пәрмендерді іске қосу және алдыңғы әрекеттердің нәтижелерін пайдалану қажет болды.
Үш режим салыстырылды:
- Толық тарих. Модель жинақталған барлық хат-хабарлар мен алдыңғы қадамдардың нәтижесін толық алады.
- Мезгіл-мезгіл қысу. Белгілі бір шекке жеткенде тарих маңызды фактілер мен тапсырманың ағымдағы күйіне дейін ықшамдалады.
- Әр әрекеттен кейін қысу (SAC). Әр қадамнан кейін агент күйдің қысқаша сипаттамасын сақтап, әрі қарай таза тарихпен жұмысын жалғастырады.
Үшінші режим — single-action compaction (SAC) — өте қызықты нәтиже көрсетті. Өсе беретін хабарламалар тізбегінің орнына агентке қысқаша жұмыс жадын сақтау жеткілікті: не жасалды, қандай қорытынды шығарылды және келесі қадам қандай.
Нәтижелер: орасан зор тарихтың орнына 7–9 мың токен
| Модель және тест | Толық тарих | Әр әрекеттен кейін қысу | SAC медианалық шыңғы мәнмәтіні |
|---|---|---|---|
| Claude Opus 4.5, SWE-bench Verified | 70,0% | 70,2% | 8 мың |
| Claude Opus 4.5, Terminal-Bench 2.1 | 47,2% | 51,8% | 9 мың |
| GPT-5.6 Sol, SWE-bench Verified | 84,4% | 82,4% | 7 мың |
| GPT-5.6 Sol, Terminal-Bench 2.1 | 87,6% | 84,3% | 8 мың |
Дереккөз: NVIDIA, 2-кесте. SAC мәнмәтіні — сессиядағы токендердің жалпы шығыны емес, бір тапсырмаға шаққандағы белсенді мәнмәтіннің медианалық ең жоғары өлшемі.
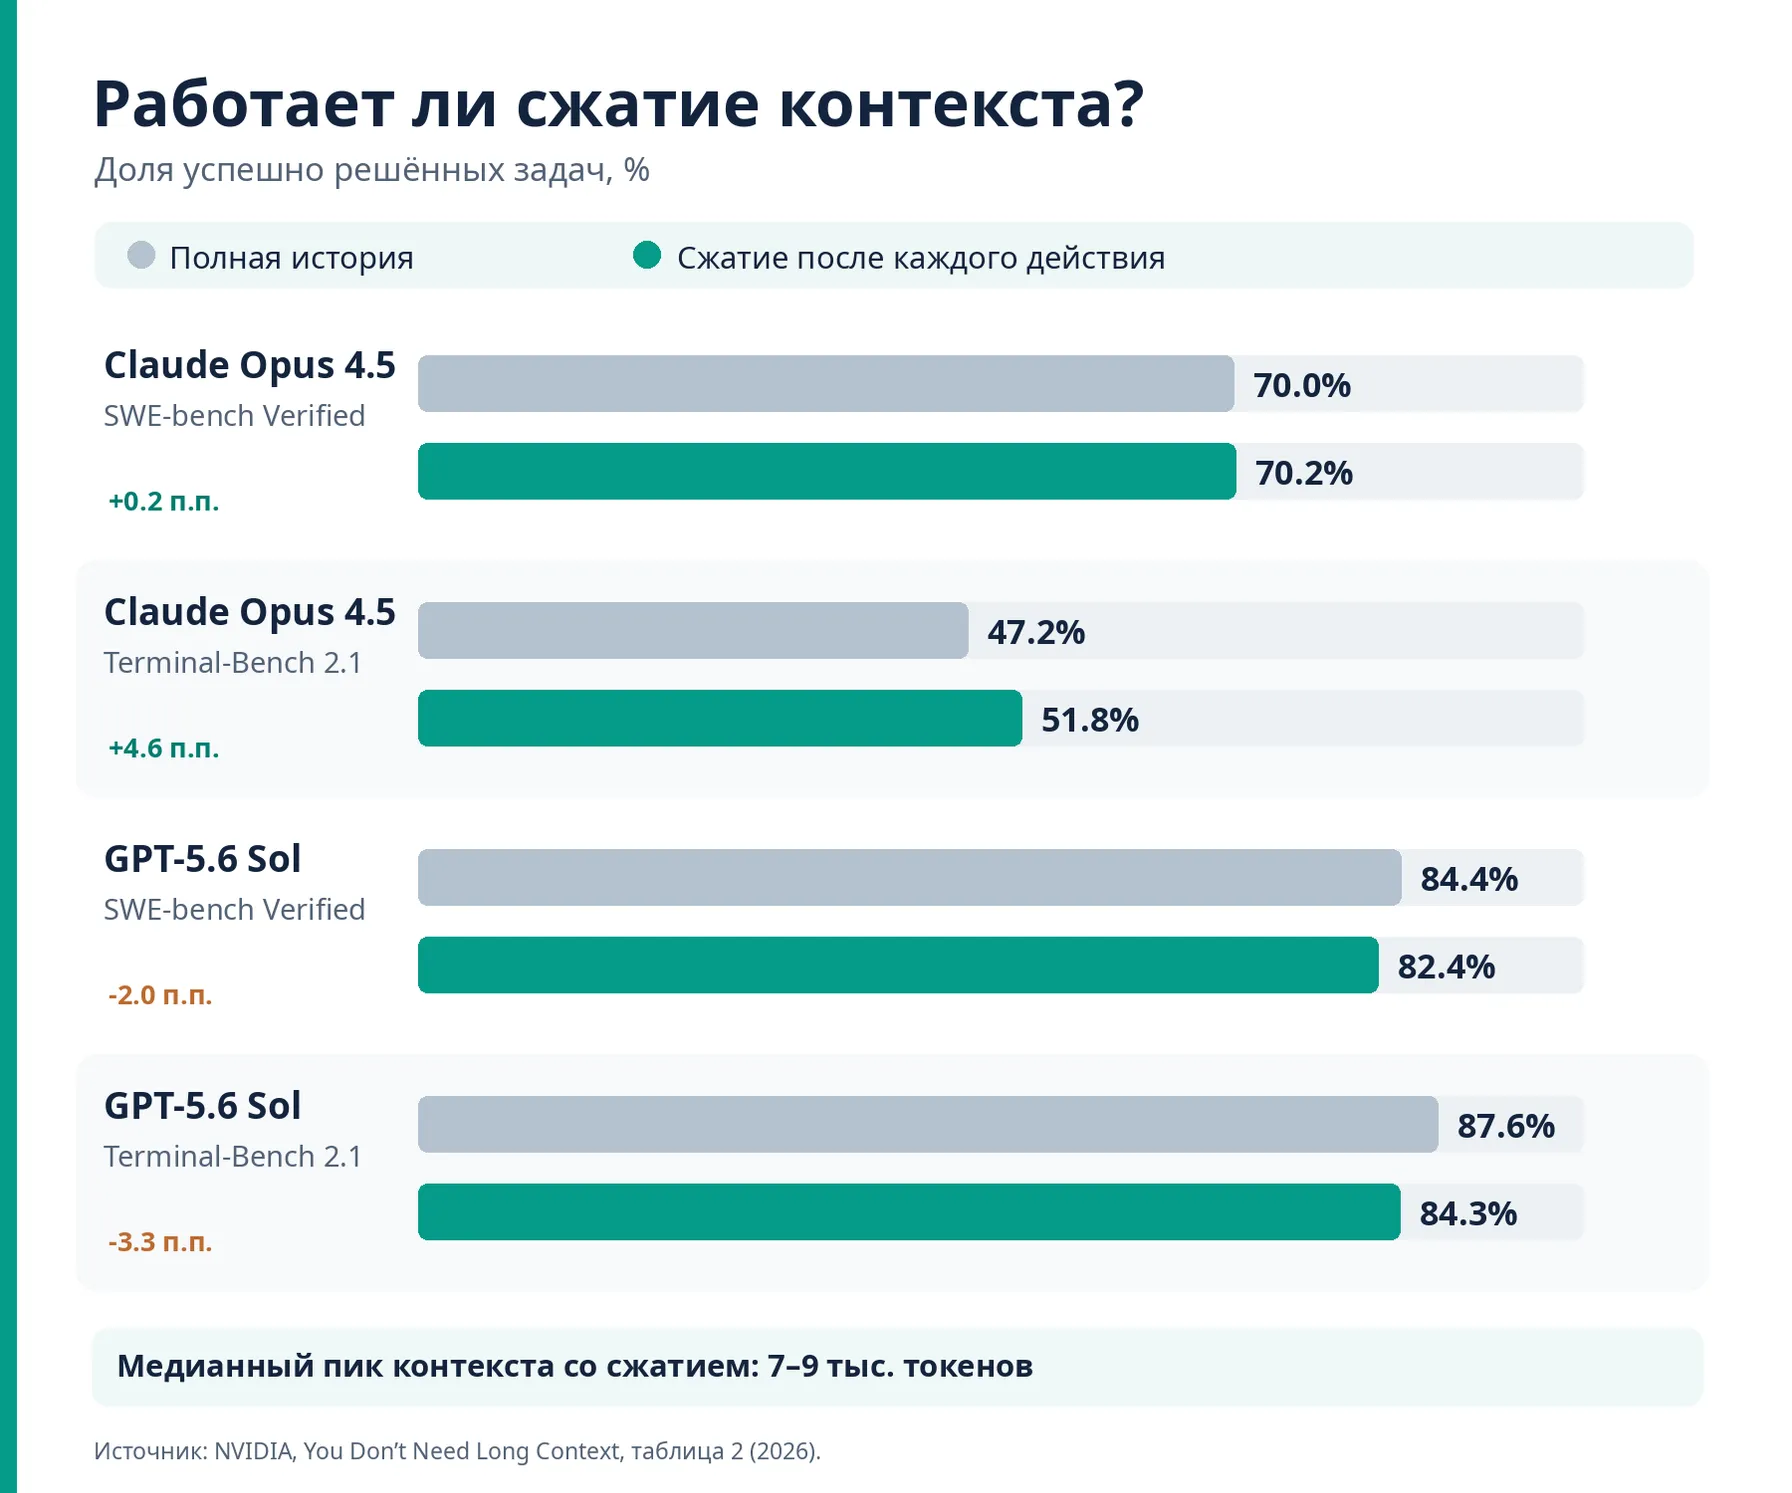
1-сурет. NVIDIA эксперименттерінде әр әрекеттен кейін қысу Claude Opus 4.5 нәтижесін өзгертпеді, ал GPT-5.6 Sol көрсеткіштерін 2,0–3,3 пайыздық тармаққа төмендетті. Мәліметтер көзі: NVIDIA, 2-кесте.
Claude Opus 4.5 үлгісі SWE-bench Verified бойынша өз нәтижесін сақтап қалса, Terminal-Bench бойынша көрсеткішін 4,6 пайыздық тармаққа жақсартты. GPT-5.6 Sol сәл сезімтал болып шықты: бағалау сәйкесінше 2,0 және 3,3 тармаққа төмендеді.
Бұл эксперименттерде қысу тәсілі қолданылғанда белсенді мәнмәтіннің медианалық ең жоғары өлшемі небәрі 7–9 мың токенді құрады, ал бастапқы режимде жекелеген тапсырмалар әлдеқайда ұзын тарихты жинаған еді. SAC кезіндегі максималды мәнмәтін көлемі толық тарихтағы 130–200 мың токеннен 15–37 мың токенге дейін азайды.
Бұл барлық тапсырманы 8 мың токендік терезеде шешуге болады дегенді білдірмейді. Бірақ ол агент жұмысын дұрыс ұйымдастырған жағдайда, өз әрекеттерінің бүкіл тізбегін үнемі көз алдында ұстау міндетті емес екенін көрсетеді.
Нейрожелі бүкіл диалогты есте сақтамай қалай жұмыс істей алады
Интернет-дүкенде тапсырыс рәсімдеу қатесін түзеп жатқан ЖИ-агентті елестетейік. Жұмыс барысында ол файлдарды оқыды, журналдарды (логтарды) қарады, тестілерді қосты және кодты бірнеше рет өзгертті. Толық тарихта сәтті шешімдермен қатар қате әрекеттер, құралдардың аралық жауаптары және ұзақ техникалық логтар да жинақталады.
Келесі әрекетті орындау үшін агентке небәрі қысқа жазба жеткілікті болуы мүмкін:
- Мақсат: тапсырыс рәсімдеу қатесін түзету.
- Себеп: жеткізу құны дұрыс есептелмеген.
- Түзету: қажетті модульде есептеу тәсілі өзгертілді.
- Тексеру: негізгі тестілер сәтті өтті.
- Келесі қадам: промокодпен берілген тапсырысты тексеру.
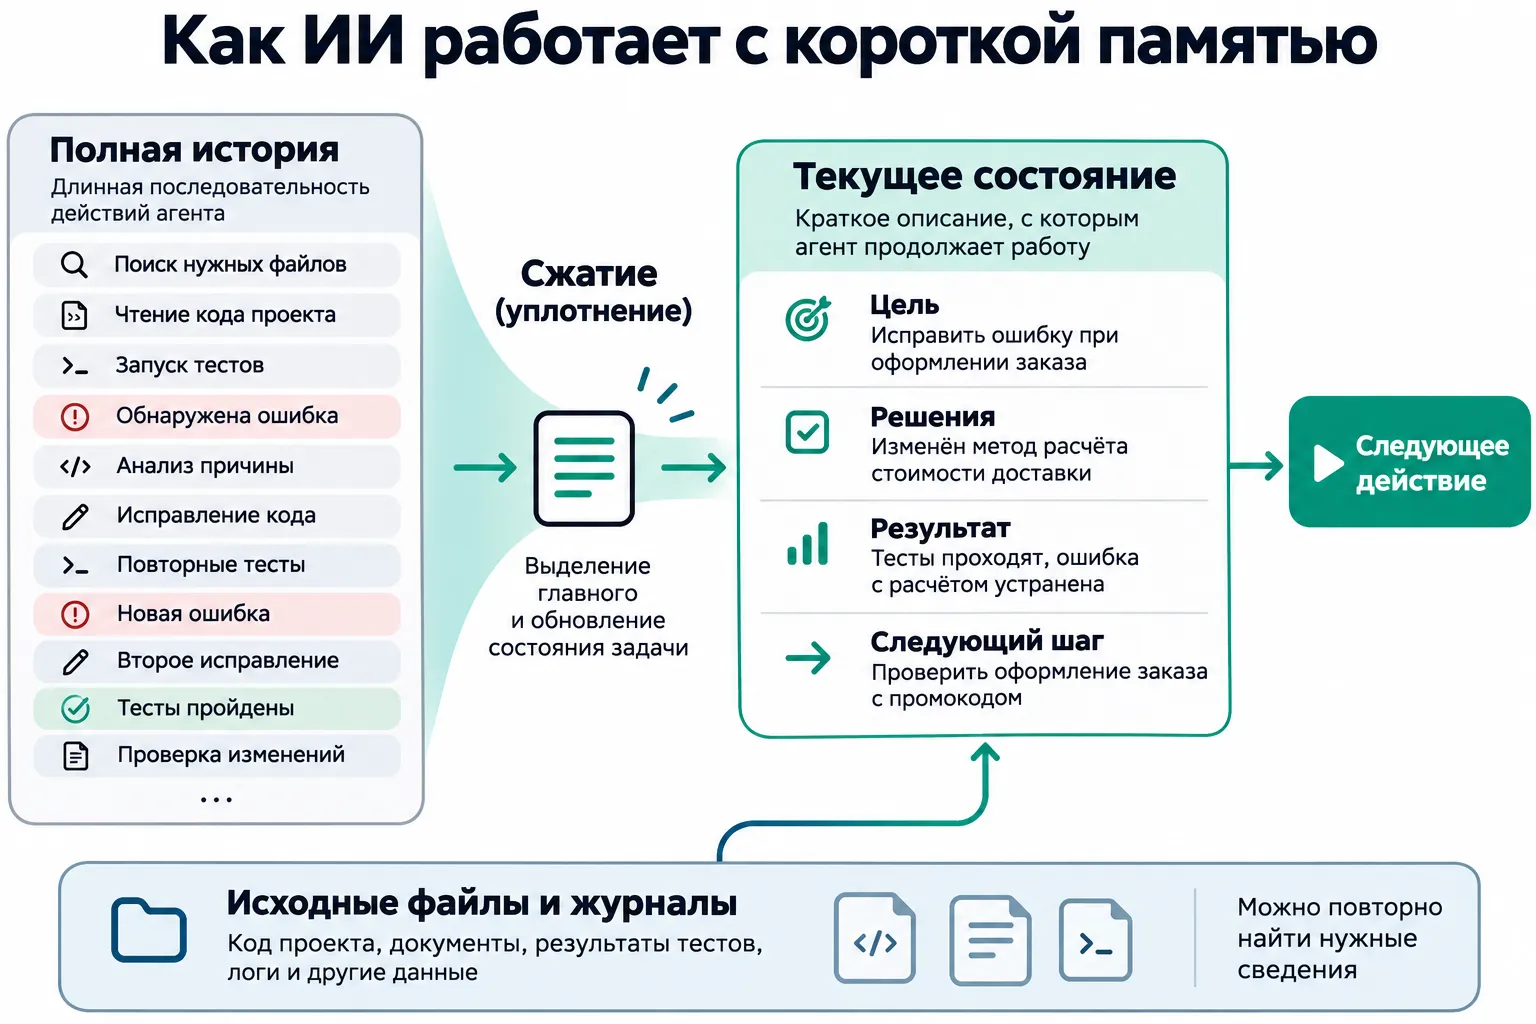
2-сурет. Мәнмәтінді қысу қағидасы: агент тапсырманың ағымдағы күйі мен келесі әрекетін сақтайды, ал бастапқы файлдар, құжаттар мен логтар қажет болғанда қайта оқу үшін сақталып қалады. Схема NVIDIA тәсілі негізінде дайындалған.
Мұнда маңызды бір жайт бар: бастапқы мәліметтер жойылмайды. Код, құжаттар және тест нәтижелері сыртқы ортада сақталады, қажет болған жағдайда модель кез келген файлды қайта аша алады.
Бұл адамның жұмыс дәптері сияқты: біз басты мәселелерді түртіп аламыз, ал толық мәліметтер қажет болғанда ғана негізгі құжаттарға жүгінеміз.
Құжатты тұтас жүктеу неліктен үнемі ең жақсы әдіс бола бермейді
Диалогты қысу — зерттеудің бір бөлігі ғана. NVIDIA авторлары сонымен бірге үлкен құжаттарды іріктеп оқу тәсілін тексерді. Мыңдаған бетті тікелей мәнмәтінге тықпалағанның орнына, агент іздеу және оқу құралдары арқылы бастапқы файлдарды қажетінше қарай алды.
Компанияның бес жылдық кірісі туралы сұрақты алайық. Модельге барлық қаржылық есептерді бірден беруге болады. Немесе алдымен қажетті құжаттарды тауып, содан кейін кіріс кестелерін ашып, тек содан соң ғана сандарды салыстыруға болады.
LOONG тестіндегі эксперименттік конфигурациялардың бірінде іріктеп оқу мен мәнмәтінді басқаруды қолданған кезде Claude Opus 4.5 үлгісінің орташа бағасы 70,1-ден 79,8-ге, ал GPT-5.6 Sol көрсеткіші 79,3-тен 84,6-ға дейін өсті.
Бұл нәтиже іріктеп оқу әрдайым артық дегенді білдірмейді: іздеу алгоритмі маңызды үзіндіні өткізіп алуы мүмкін. Дегенмен, ол бастапқы ақпараттың көлемі мен бір мезетте мәнмәтінде ұстап тұруды талап ететін ақпарат көлемі мүлдем екі түрлі шама екенін айқын көрсетеді.
Ұзын мәнмәтін жауап сапасын төмендетуі мүмкін
Lost in the Middle: ақпарат ортада жоғалады
Lost in the Middle (2024) зерттеуінде авторлар тілдік модельдердің көлемді құжаттарды қалай қолданатынын қарастырды. Көптеген тексерілген модельдер үшін жауаптың дәлдігі қажетті ақпараттың орналасуына байланысты болды: олар сұраққа жауап мәтіннің басына немесе соңына жақын орналасқанда жақсырақ шешім тапты, ал мәліметтер мәтіннің ортасында қалғанда жиі қателесті.
Демек, үлкен мәнмәтінді қабылдау мүмкіндігі оның барлық бөлігі бірдей сапалы пайдаланылады дегенге кепілдік бермейді.
NoLiMa: тікелей сәйкестіктер болмаса, ұзын мәнмәтін күрделене түседі
NoLiMa (2025) жұмысы сұрақпен бірдей сөздерді құжаттан жай ғана таба салуға болмайтын тапсырмаларды тексереді. Мұнда мағыналық байланыстар қажет. 32 мың токен көлемінде тексерілген он екі модельдің оны қысқа мәнмәтіндегі нәтижесінің жартысына да жете алмады. GPT-4o бағасы бұл экспериментте 99,3%-дан 69,7%-ға дейін құлдырады.
Бұл сынақ нақты модель нұсқаларына қатысты болғанымен, ол техникалық кіріс ұзындығы мен ақпаратты тиімді синтездеу арасындағы айырмашылықты көрсетеді.
Context Rot: бөтен мәтін көбейген сайын, басты нәрсені табу қиындайды
Context Rot (Chroma, 2025) зерттеуінде 18 модельде кіріс мәтіні өскен сайын жауап сапасының нашарлауы зерттелді. Әсіресе алаңдататын бөтен ақпарат пен мағыналық байланыстар маңызды болған тапсырмаларда қиындықтар айқын байқалды.
Үш зерттеудің ортақ түйіні: ақпараттың өзектілігі, құрылымы және орналасуы түпкілікті жауапқа зор әсер етеді.
Ал нақты сұраныстарда қанша мәнмәтін пайдаланылады? OpenRouter деректері
Зертханалық сынақтар модельдердің мүмкіндігін көрсетеді. Нақты жүктемені түсіну үшін API провайдерлерінің статистикасы маңызды.
2025 жылдың желтоқсанында OpenRouter компаниясы a16z қорымен бірлесіп 100 триллионнан астам токеннің метадеректеріне негізделген State of AI зерттеуін жариялады. Авторлар бір сұранысқа шаққандағы орташа кіріс токендерінің саны 2024 жылдың басындағы шамамен 1,5 мыңнан 2025 жылдың соңына қарай 6 мыңнан асқанын көрсетті. Бағдарламалауға қатысты сұраныстар жиі 20 мың кіріс токенінен асып түскен.
Сонымен қатар зерттеушілер input + output тізбегінің орташа ұзындығын өлшеді: 2025 жылдың соңында ол 5,4 мың токеннен асты. Бұл көрсеткіштер мағынасы жағынан ерекшеленеді, сондықтан оларды шатастырмау қажет.
OpenRouter Rankings бетінде бағдарламалық агенттердің сессия құны мен мәнмәтін өлшемдеріне арналған бөлімдер бар. Дегенмен, ашық жиынтық деректер барлық пайдаланушы сессияларының 90%-ы дәл қандай мәнмәтін шегіне сиятынын анықтауға мүмкіндік бермейді.
Сессиялардың 90-процентилін бағалау үшін жеке API сұраныстары ғана емес, аяқталған диалогтар деңгейіндегі деректер қажет. Бір диалог алдыңғы тарихты қайта-қайта жіберетін жүздеген сұраныстан тұруы мүмкін.
Harvard: нақты бағдарламалық агенттер әлдеқайда үлкен мәнмәтін қолданады
Алғашқы қарағанда OpenRouter деректері ұзын мәнмәтін аса қажет емес сияқты әсер қалдыруы мүмкін. Бірақ нақты мамандандырылған зерттеу басқа көріністі алға тартады.
2026 жылдың қарашасында Harvard Systems Group зерттеушілері шамамен 12 мың нақты бағдарламалық агент сессиясын қамтыған From Requests to Sessions жұмысын жариялады. Бұл сессиялар 1,2 миллион шақыруды және 209 миллиард кіріс токенін құраған.
Бұл деректерде медианалық сұраныс 129,1 мың кіріс токенінен тұрды. Ал кэштен алынбаған жаңа кіріс токендерінің медианасы небәрі 491 токенді, ал медианалық жауап көлемі 227 токенді құраған.
Бұл кэштеу механизмдерімен түсіндіріледі: ЖИ-агент бұрынғы мәнмәтінді қайта-қайта жібереді, бірақ оның басым бөлігі өңделіп қойған префиксті қайта пайдаланады. Кэштеу мәліметтері бар сұраныстар ішінде кэштелген токендер кіріс көлемінің 97,4%-ын және есептелген API шығынының 72,9%-ын құраған.
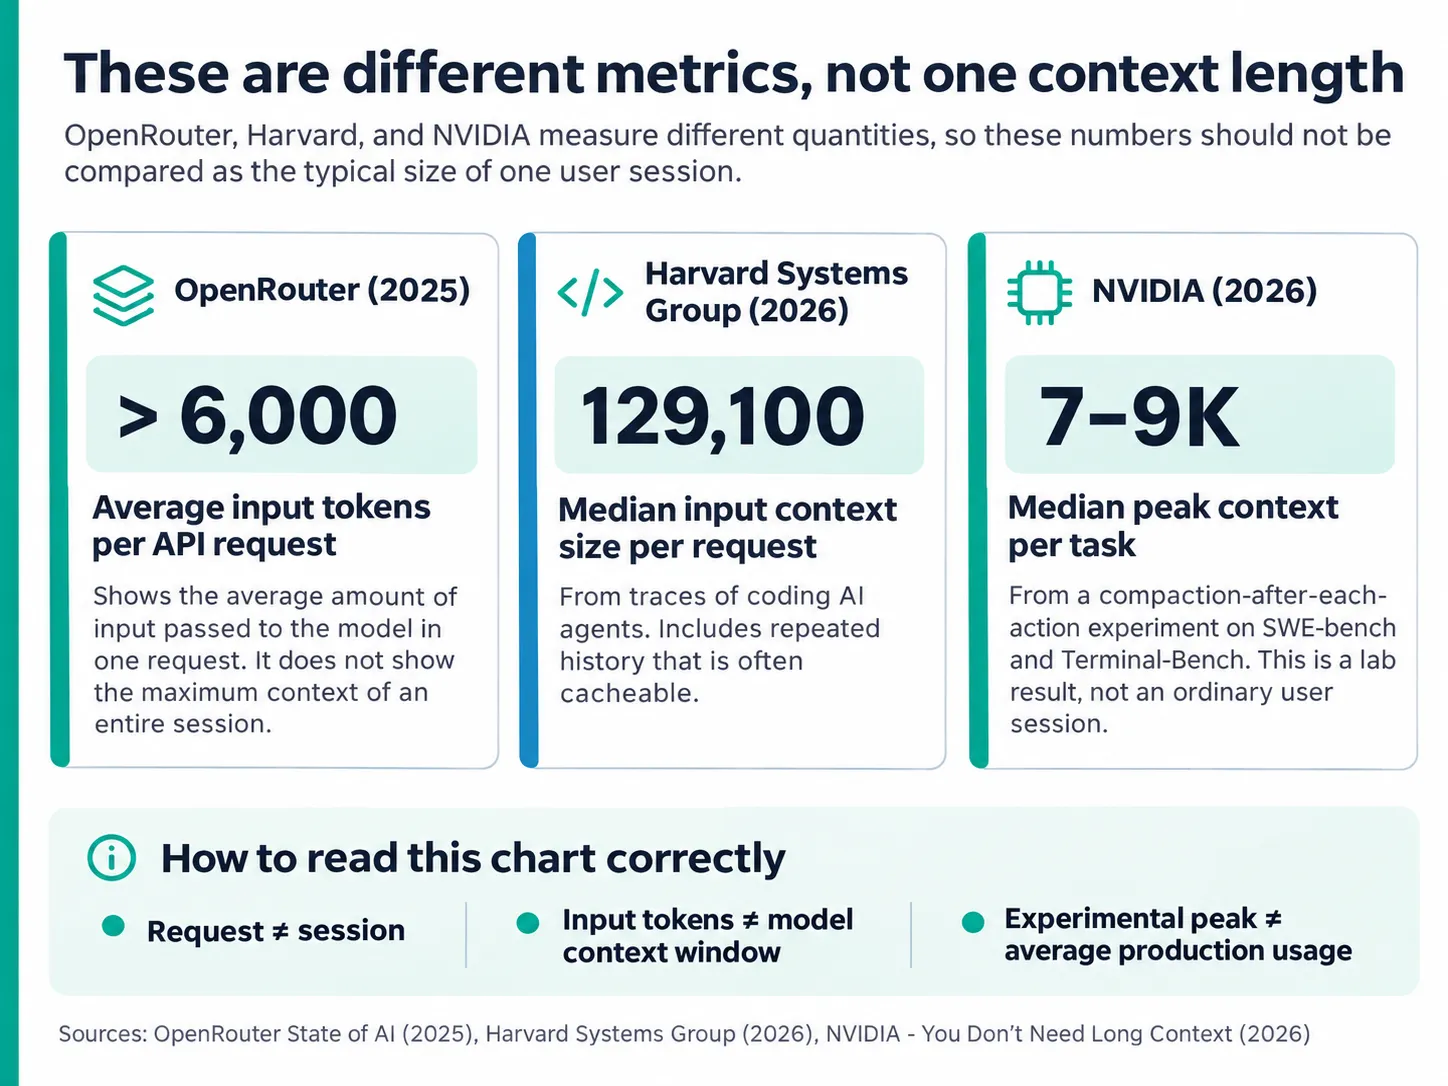
3-сурет. OpenRouter мәліметінше, 2025 жылдың аяғында орташа кіріс сұранысы 6 мың токеннен асқан. Harvard агенттер таңдауында кіріс сұранысының медианасы 129,1 мың болды. Ал NVIDIA экспериментінде қысу арқылы медианалық шыңғы белсенді мәнмәтін 7–9 мың токен болды. Бұл түрлі көрсеткіштер мен іріктемелер; график сессия өлшемдерінің үлестірімін көрсетпейді.
Бір қарағанда қарама-қайшылық туындайды: NVIDIA айтарлықтай қысқа белсенді мәнмәтінмен жұмыс істеу мүмкіндігін көрсетсе, нақты бағдарламалық агенттер орасан зор тарихты жіберіп отырады.
Іс жүзінде бұл сапа мәселесі ғана емес, сонымен бірге есептеу архитектурасының таңдауы. Кэштелген префиксті қайта пайдалану арзан болуы мүмкін, ал жиі қысу кэштеуді бұзып, қосымша есептеулерді талап етеді. Барлық модельдер мен тапсырмалар үшін әмбебап оңтайлы тәсіл әлі жоқ.
Harvard нақты сұраныстарындағы 129,1 мың токендік медиана мен NVIDIA экспериментіндегі 7–9 мыңдық шыңғы медиананы бір қатарда тікелей салыстыруға болмайды.
Неліктен ұзын мәнмәтін қымбатқа түседі
Мәнмәтін кідіріске (latency), есептеу жүктемесіне және жад талаптарына тікелей әсер етеді. Жаңа токендерді жасау кезінде модель алдыңғыларын назарда ұстауды жалғастырады, ал мұндай есептеудің бағасы мәнмәтіннің тереңдігіне және архитектураға байланысты.
NVIDIA зерттеуінде H100 үдеткіштерінде бірқатар ашық модельдердің өнімділігі өлшенді. Терезені 16K-дан 256K-ға кеңейткен кезде шығыс токенін жасаудың есептік өзіндік құны бірнеше есе өсті:
| Модель | 16K-мен салыстырғанда 256K кезіндегі есептеу шығынының өсуі |
|---|---|
| GLM 5.2 | 3,6 есе |
| Kimi K2.6 | 5,6 есе |
| Qwen 3 Coder Next | 7 есе |
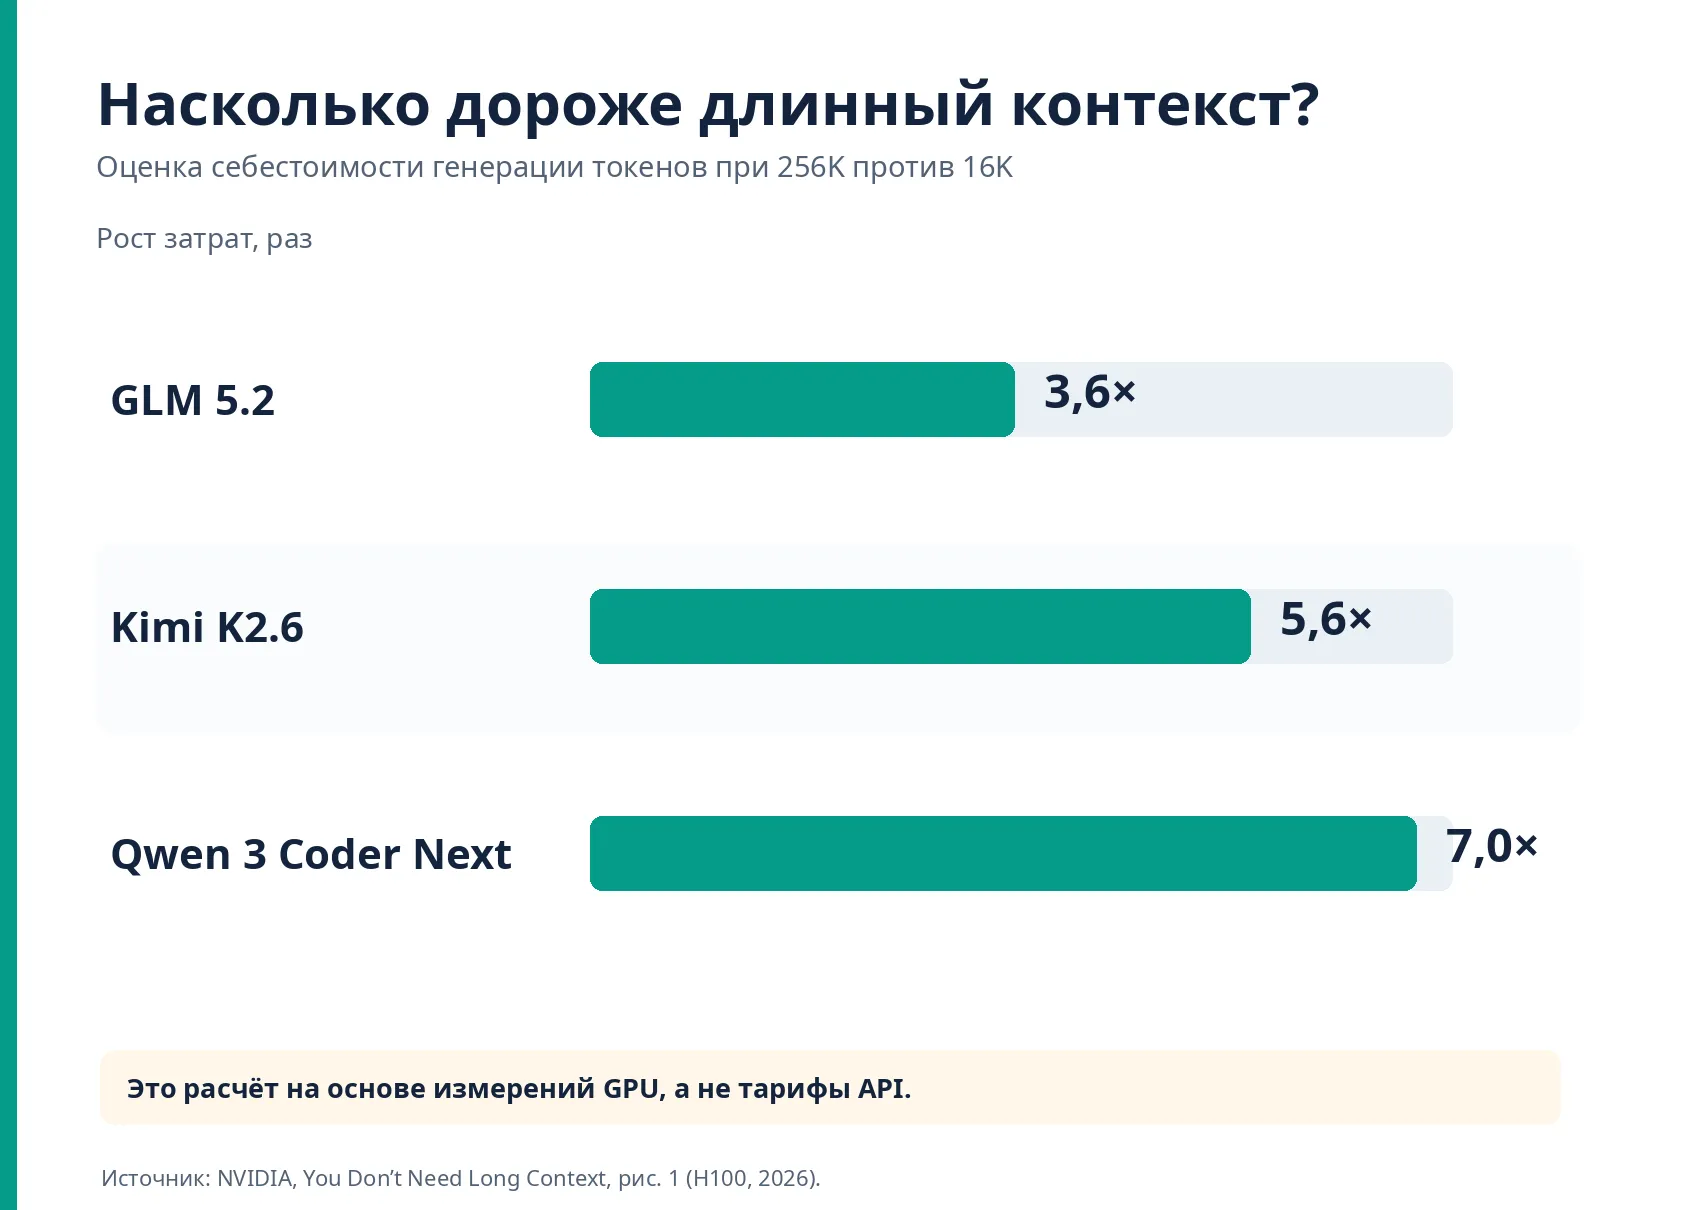
4-сурет. NVIDIA бағалауы H100 GPU өткізу қабілеті мен GPU-сағат құнына негізделген. Мұнда 16K-ға қарағанда 256K мәнмәтініндегі токендерді жасауға кететін салыстырмалы шығын көрсетілген, пайдаланушыларға арналған API тарифтері емес. Дереккөз: NVIDIA, 1-сурет.
Бұл сандарды жазылым бағасының төмендеу уәдесі немесе нақты API сұранысының құны ретінде қабылдауға болмайды. Түпкілікті төлем кіріс және шығыс токендеріне, кэштеуге, тарифке, жабдыққа және агенттің қосымша әрекеттерінің санына байланысты.
Дегенмен, нейрожелі провайдерлері үшін бұл әсер анық байқалады: қысқа белсенді мәнмәтінді дұрыс басқару арқылы есептеу шығындарын азайтуға немесе дәл сол инфрақұрылымда көбірек сұранысқа қызмет көрсетуге болады.
Қысқа мәнмәтін қай кезде ұтылады
NVIDIA зерттеуінде кері мысалдар да бар. SWE-bench Verified тестінде Qwen 3 Coder Next моделі толық тарихпен 53,0% нәтиже көрсетсе, 16K шегі мен 12K межесі бар мезгіл-мезгіл қысудың қатаң режимінде небәрі 3,6% көрсетті. Бұл Claude және GPT салыстырмалы кестесінде қолданылған SAC режимі емес, бөлек EoCC режимі болатын.
Авторлар сапаның төмендеуін модель әрекеттерінің ұзақ траекториясымен байланыстырады: келесі қысу кезеңіне дейін ол пайдалы нәтижеге қол жеткізіп үлгермеген. Бұл көрсеткіш мәнмәтінді басқару тәсілі нақты модельге сәйкес келуі керектігін дәлелдейді.
Сонымен қатар бір мезгілде көптеген нақты үзінділер мен бөлшектерді салыстыру қажет болған жерде де үлкен мәнмәтіннің маңызы сақталады. Кез келген қысқаша мазмұндама кейін өте маңызды болатын фактіні назардан тыс қалдыруы мүмкін. Ал іріктеп іздеу қажетті құжатты таппай қалуы ықтимал.
Болашақ нейрожелілері: шексіз тарихтың орнына жаңартылатын күй
NVIDIA зерттеушілері Semantic State Space Models (SSSM) тұжырымдамасын ұсынды. Негізгі идея: модель тапсырма күйінің қысқаша сипаттамасын алады, шешім қабылдайды, әрекет жасайды, нәтижені бекітеді және келесі қадам үшін семантикалық күйді жаңартып отырады.
Схема түрінде: ағымдағы күй → шешім → әрекет → нәтиже → жаңартылған күй.
Бұл әзірге сәулеттік гипотеза және модельдерді болашақта оқытуға арналған ұсыныс. Жұмыста кәдімгі ұзын мәнмәтінді модельдерден әмбебап басымдығын дәлелдеген толық оқытылған жеке SSSM ұсынылмаған.
Көпдеңгейлі жад идеялары бұған дейін де дамыған болатын. Мысалы, MemGPT (2023) зерттеуінде белсенді мәнмәтін мен сыртқы жадты ажыратып, мәліметтерді қажетіне қарай алу ұсынылған еді.
Бұл ChatGPT және басқа нейрожелі пайдаланушылары үшін нені білдіреді
Тәжірибелік түйін: ұзақ диалогты шексіз жалғастыру міндетті емес. Бір жобамен бірнеше сағат немесе бірнеше күн жұмыс істегенде аралық күйді бекітіп отыру көмектеседі.
Мысалы, бір кезең аяқталғаннан кейін нейрожеліден былай сұрауға болады:
Жұмысымыздың құрылымдалған түйінін жаса: мақсатымыз, қабылданған шешімдер, маңызды фактілер, шектеулер, анықталған мәселелер және келесі қадамдар. Жоғалтпау керек мәліметтер мен әлі шешілмеген сұрақтарды бөлек көрсет.
Мұндай түйінді жаңа чатта жұмысты жалғастыру үшін пайдалану өте ыңғайлы. Бірақ қысқаша мазмұндама түпнұсқаны алмастырмайды: файлдарды, құжаттарды, бастапқы есептеулер мен толық тест нәтижелерін әрдайым бөлек сақтаған жөн.
ЖИ-қосымшаларын әзірлеушілер үшін бұл қорытынды одан да маңызды. Тек мәнмәтін өлшемі мен кіріс токендерінің құнына ғана емес, сонымен бірге ақпаратты таңдау сапасына, бастапқы файлдарға қайта жүгіну жиілігіне, кэштеу тиімділігіне және тапсырманы толық орындау бағасына назар аударған жөн.
Қорытынды: нейрожеліге ең үлкен жад емес, ең пайдалы жад қажет
NVIDIA зерттеуі ұзын мәнмәтінді модельдердің артықшылықтарын жоққа шығармайды. Ол күрделі тапсырмалар кезінде сапаны күрт төмендетпей-ақ модельге қолжетімді ақпарат көлемін едәуір азайтуға болатынын көрсетеді.
Басқа зерттеулер үлкен мәнмәтін оның барлық бөлігінің бірдей сенімді пайдаланылуына кепілдік бермейтінін растайды. Ал Harvard нақты өндірістік деректері бағдарламалық агенттердің бүгінде әлі де бір сұранысқа жүздеген мың токен жөнелтетінін көрсетеді.
Ең болашағы зор бағыт — бірнеше механизмнің үйлесімі: шағын ағымдағы күй, толық материалдарға қолжетімділік, дәл іздеу және тиімді кэштеу.
Болашақта ЖИ жүйелерінің басты сипаттамасы бір мезетте өңдей алатын токендер саны ғана емес, дәл қазір нені есте сақтау керектігін таңдай білу қабілеті болуы әбден мүмкін.