
OpenAI ұйымы жасанды интеллект агенттерінің келесі буын нейрожелілерін әзірлеуге қалай қатысатыны туралы Research acceleration: The jagged frontier атты зерттеуін жариялады. Компанияның ішкі деректеріне сәйкес, 2026 жылдың наурызы мен қазаны аралығында мамандардың екі-төрт сағат уақытын алатын тапсырмалар санатында агенттердің адамның араласуынсыз дербес орындаған жұмыстарының үлесі 23%-дан 46%-ға дейін өсті. Төрт-сегіз сағаттық тапсырмалар үшін бұл көрсеткіш 13%-дан 35%-ға жетті.
Маңызды нақтылау: бұл жалпы ғылыми зерттеулер емес, OpenAI зерттеу топтарының ішкі инженерлік жұмыстары. Мұнда бағдарламалау, инфрақұрылым, нәтижелерді талдау және эксперименттерді іске қосу қарастырылған. Тақырыптағы уақыт — агенттің орындау жылдамдығы емес, адам-маманның осы тапсырмаға жұмсайтын уақыты. Ал 46% көрсеткіші ИИ-дің барлық ғылыми зерттеулерді толық дербес жүргізу қабілетін емес, делегацияланған жұмыстардың нақты тобын білдіреді.
Дербестік қалай өсуде
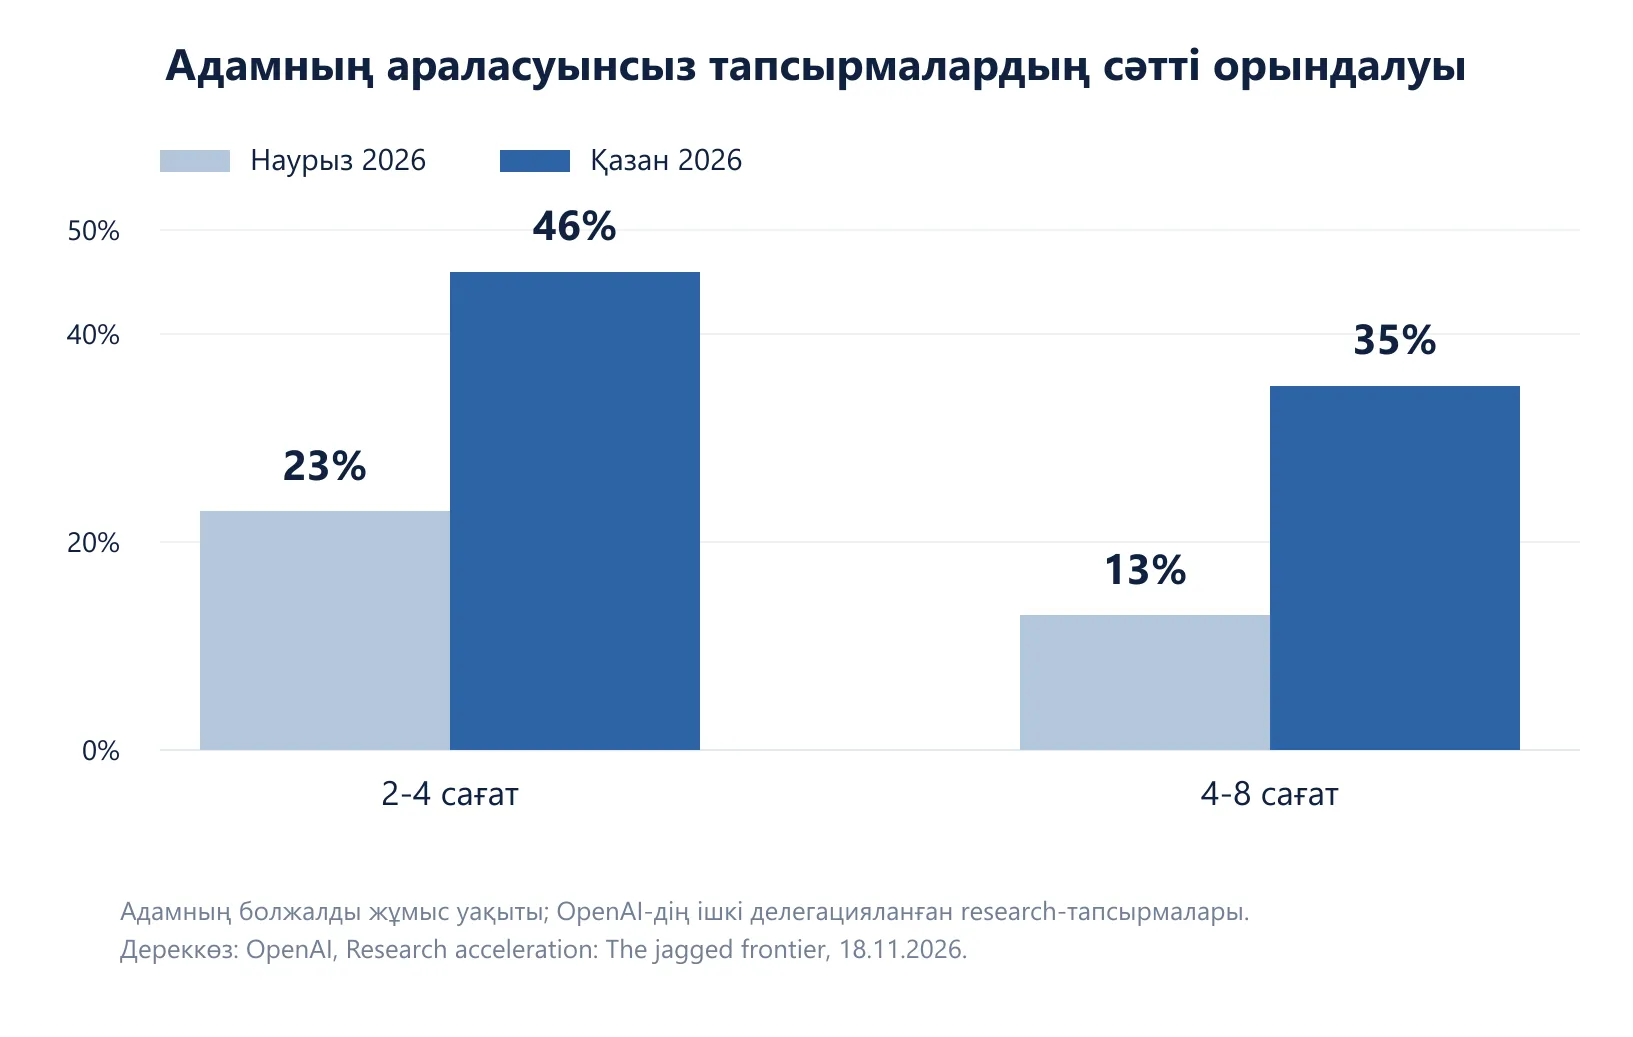
1-сурет. Адамның араласуынсыз аяқталған делегацияланған тапсырмалардың үлесі. Ұзақтық маманның жұмыс уақытына сәйкес келеді. Дереккөз: OpenAI.
Жеті айдың ішінде екі-төрт сағаттық тапсырмалар тобындағы сәттілік екі есеге өсті — 23%-дан 46%-ға жетіп, 23 пайыздық тармақ қосты. Төрт-сегіз сағаттық күрделірек тапсырмалар бойынша өсім 22 пайыздық тармақты құрап, 35%-ға жетті. Бұл динамика ИИ-ге бұрын әзірлеушінің жеке жұмыс сессиясын талап ететін дербес инженерлік тапсырмалардың көбірек жүктеліп жатқанын көрсетеді.
Алайда бұл статистиканың шектеулері бар. OpenAI уақыт өте келе зерттеушілердің тапсырмалар сипатын өзгертетінін атап өтеді (мысалы, агенттерге күрделірек немесе оларға қолайлы тапсырмалар беру). Демек, өсім технологияның дамуын да, оны қолдану тәжірибесінің өзгеруін де көрсетеді.
Агенттер қай бағытта жақсы, ал қайда қателеседі
Есептің ең мазмұнды бөлігі — жұмыс түрлері бойынша бөлініс. Инфрақұрылымға арналған код жазу мен оқыту процесін мониторингтеу арасында айырмашылық зор.
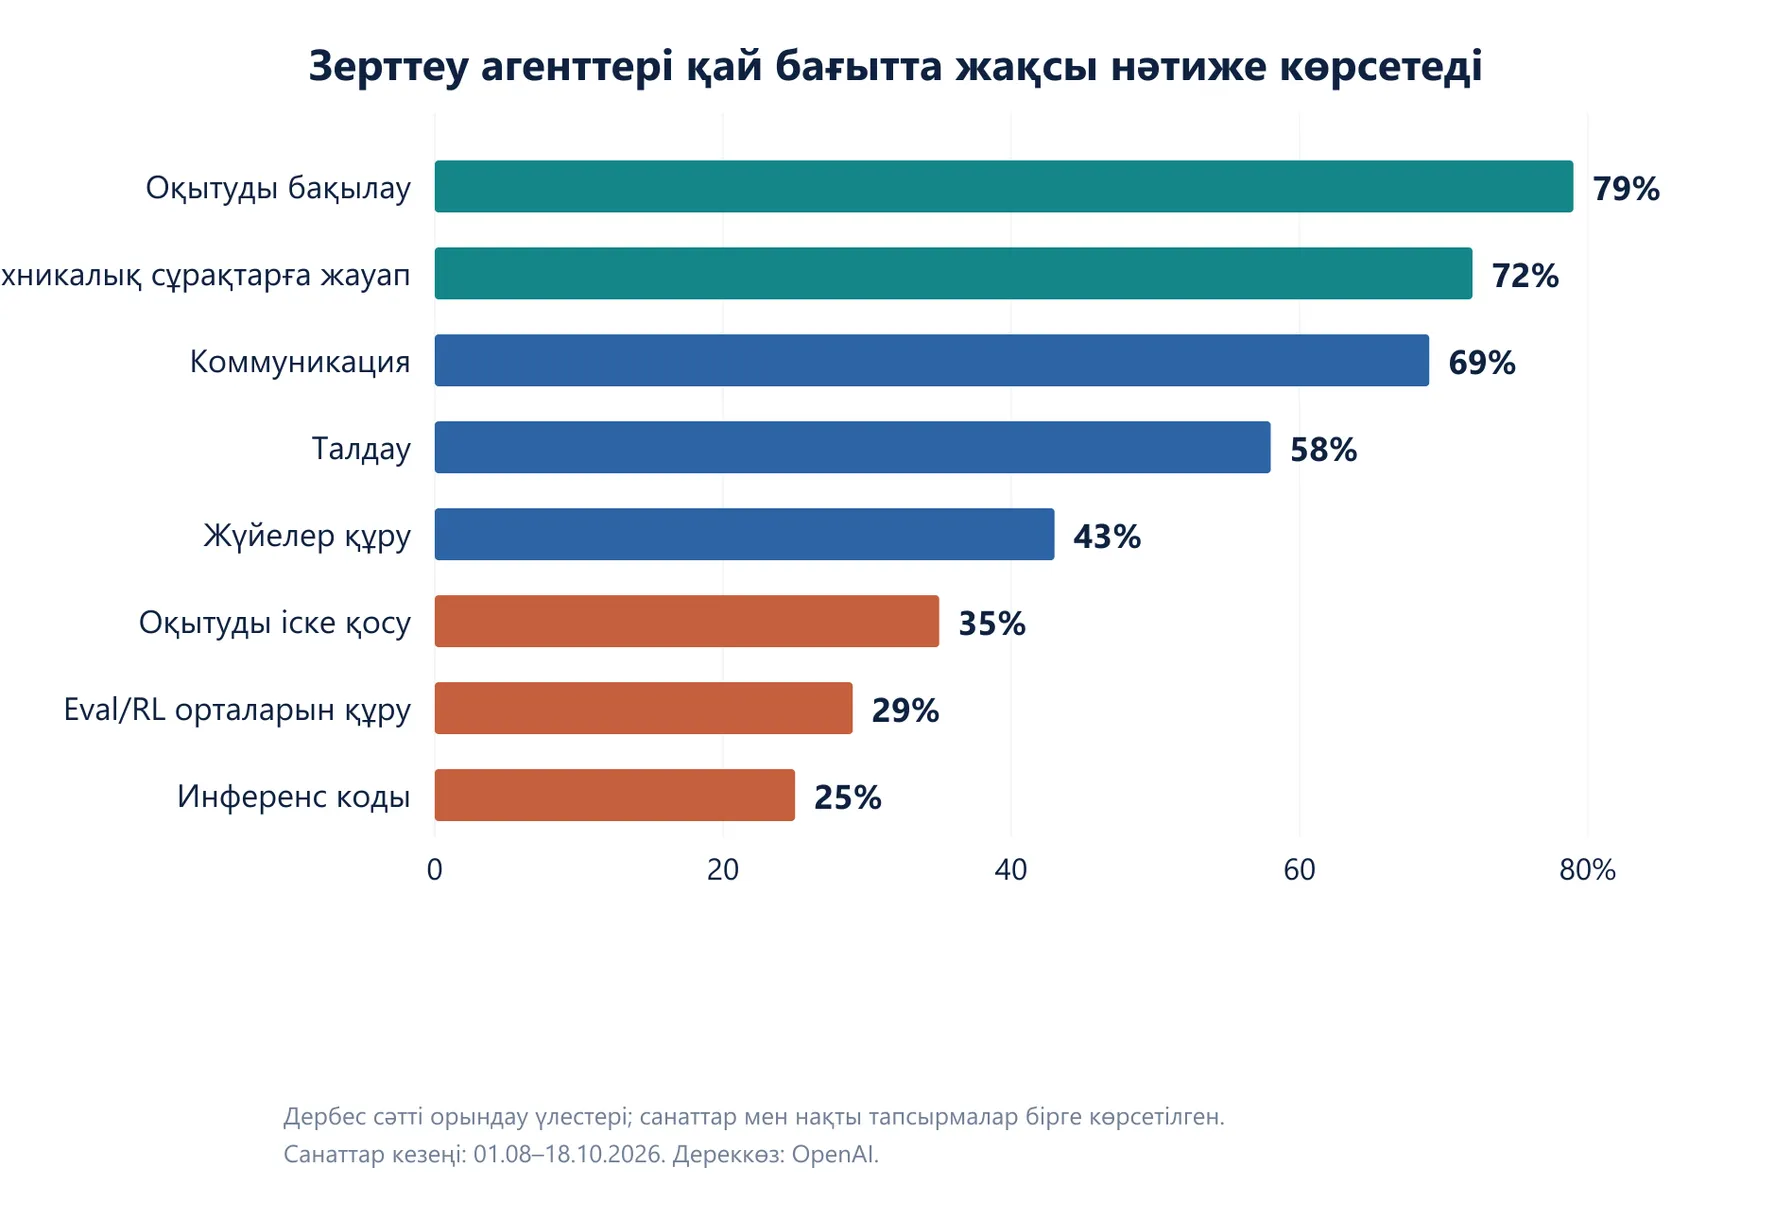
2-сурет. Жекелеген санаттар мен тапсырмалар бойынша дербес орындау көрсеткіші. Дереккөз: OpenAI.
1 тамыз бен 18 қазан аралығындағы санаттар бойынша агенттер коммуникациялық тапсырмаларды (69%) және талдауды (58%) жақсырақ орындаған, ал жүйелер мен компоненттерді құру (43%) күрделірек болған. Нақты тапсырмалар бойынша айырмашылықтар одан да айқын: оқыту барысын бақылау — 79%, техникалық сұрақтарға жауап беру — 72%, оқытуды бастау — 35%, бағалау немесе reinforcement learning ортасын жасау — 29%, ал инференс/қызмет көрсету компоненттерін жазу — 25%.
Агент мыңдаған эксперименттердің нәтижелерін өз бетінше талдап, ақаулар туралы ескерте алады. Бірақ төменгі деңгейдегі инфрақұрылымды өзгерту, ортаны баптау немесе экспериментті дұрыс ұйымдастыру қажет болғанда, толық дербес сәттілік ықтималдығы айтарлықтай төмендейді.
Зерттеулердің өзі жеделдеді ме?
OpenAI бірнеше жанама көрсеткіштерді ұсынады. 18 қазанға дейінгі төрт апта ішінде бір белсенді эксперимент жүргізушіге шаққандағы тіркелген эксперименттер саны 2025 жылғы базалық деңгейден 1,68 есеге өсті. Өзгертілген код жолдарының саны да артқан. Алайда авторлар эксперименттер мен код көлемін ғылыми прогресспен автоматты түрде теңестіруге болмайтынын ескертеді.
Бұған қоса, OpenAI ішкі және сыртқы бенчмарктерден құралған OpenAI Epoch Capabilities Index (OECI) көрсеткішін ұсынды. Үздік модельдер үшін өсім жылына шамамен 16,4 тармақты құрайды. Дегенмен жеке индекстің жоғары жылдамдығы дәл осы ИИ-агенттердің әсерінен болғанын толық дәлелдемейді.
OpenAI қызметкерлері ИИ-ге қанша ресурс жұмсайды
Зерттеушілердің күнделікті агенттік тұтынуы да назар аудартады. Қазанда зерттеушілер арасындағы медианалық пайдалану ашық API бағалары бойынша күніне $2400-ға жетті (қыркүйекте $1500). Ал 90-пайыздық деңгейде көрсеткіш $11 000-нан күніне $23 000-ға дейін өсті. Бұл — қызметкерге ұсынылған нақты шот емес, API прайс-парағы бойынша пайдаланудың шартты бағалауы.
Тәжірибелі пайдаланушылар көптеген параллель тапсырмаларды іске қосады, бірақ өнімділік адамның тапсырманы қаншалықты дұрыс қойып, нәтижені қалай тексеретініне байланысты. Токендерді көп пайдалану ғылыми жаңалықтардың бірдей көлемде өсуіне кепілдік бермейді.
Зерттеушілер пікірі: жоғары пайда және әлсіз «зерттеу талғамы»
OpenAI зерттеу бөлімшелерінің 101 қызметкеріне сауалнама жүргізді. Агенттерге қолжетімділікті үш айға шектеу сценарийінде қатысушылар оларды сақтап қалу үшін команданың есептеу ресурстарының 30%-ын немесе оның штат санының 40%-ын беруге дайын екенін білдірген. Бұл — құралдардың маңыздылығының субъективті бағасы.
Оон зерттеушімен өткізілген сұхбат агенттердің сынақ жиынтықтарын тасымалдауды, нәтижелерді тексеруді және деректер массивтерін жүйелеуді жеделдететінін көрсетеді. Сонымен бірге қызметкерлер зерттеу идеяларының әлсіздігін, үстірт шешімдерді және қайта жасауды қажет ететін қате кодтарды атайды. Тиімді тәжірибелердің бірі — алдымен агенттен бір үлгіні жасауды сұрау, оны қолмен тексеру және содан кейін ғана процесті кеңейту.
Қауіпсіздік және Recursive Self-Improvement
Қуатты модель келесі модельді жасауға көмектесіп, жаңа модель келесі циклді жеделдететін кері байланыс пайда болады. Бұл процесс индустрияда recursive self-improvement (RSI) деп аталады. OpenAI әлі де модельдерді әзірлеудің толық автономды тұйық цикліне жетпегенін айтады.
Есеп бойынша, Safety & Alignment бағытындағы құжатталған еңбек көлемі 2026 жылдың қаңтарынан қыркүйегіне дейін 77%-ға өскен. Бұл қауіпсіздікті күшейту инциденттердің азаюымен емес, бөлінген инженерлік еңбекпен өлшенеді.
Қорытынды
46% — айтарлықтай прогресс көрсеткіші, бірақ оның мағынасы нақты шектелген. OpenAI агенттері екі-төрт сағаттық ішкі research-тапсырмалардың жартысына жуығын өз бетінше аяқтайды, ал күрделі инфрақұрылымдық компоненттерді құру әлі де шектеулі. Әзірге ИИ-дің мықты тұсы — тексерілетін техникалық операцияларды орындау, ал адамның басты рөлі — мәселелерді қою, сапаны бақылау және зерттеу шешімдерін қабылдау болып қала береді.