
18 ноября 2026 года Arena обновила рейтинг ИИ-агентов. Вместо единственного общего показателя теперь доступны отдельные оценки программирования, офисной работы, использования инструментов и способности следовать исправлениям пользователя. Главная особенность проекта - данные о том, как агенты справляются с настоящими заданиями, а не только с заранее подготовленными тестами.
На момент анонса Arena говорила о более чем 2,9 млн пользовательских сессий. На доступной 20 ноября странице рейтинга указано уже 3 093 488 сессий и 68 моделей. Поэтому результаты представляют интерес для выбора рабочего ИИ-агента, хотя их нельзя считать универсальным измерителем качества всех моделей.
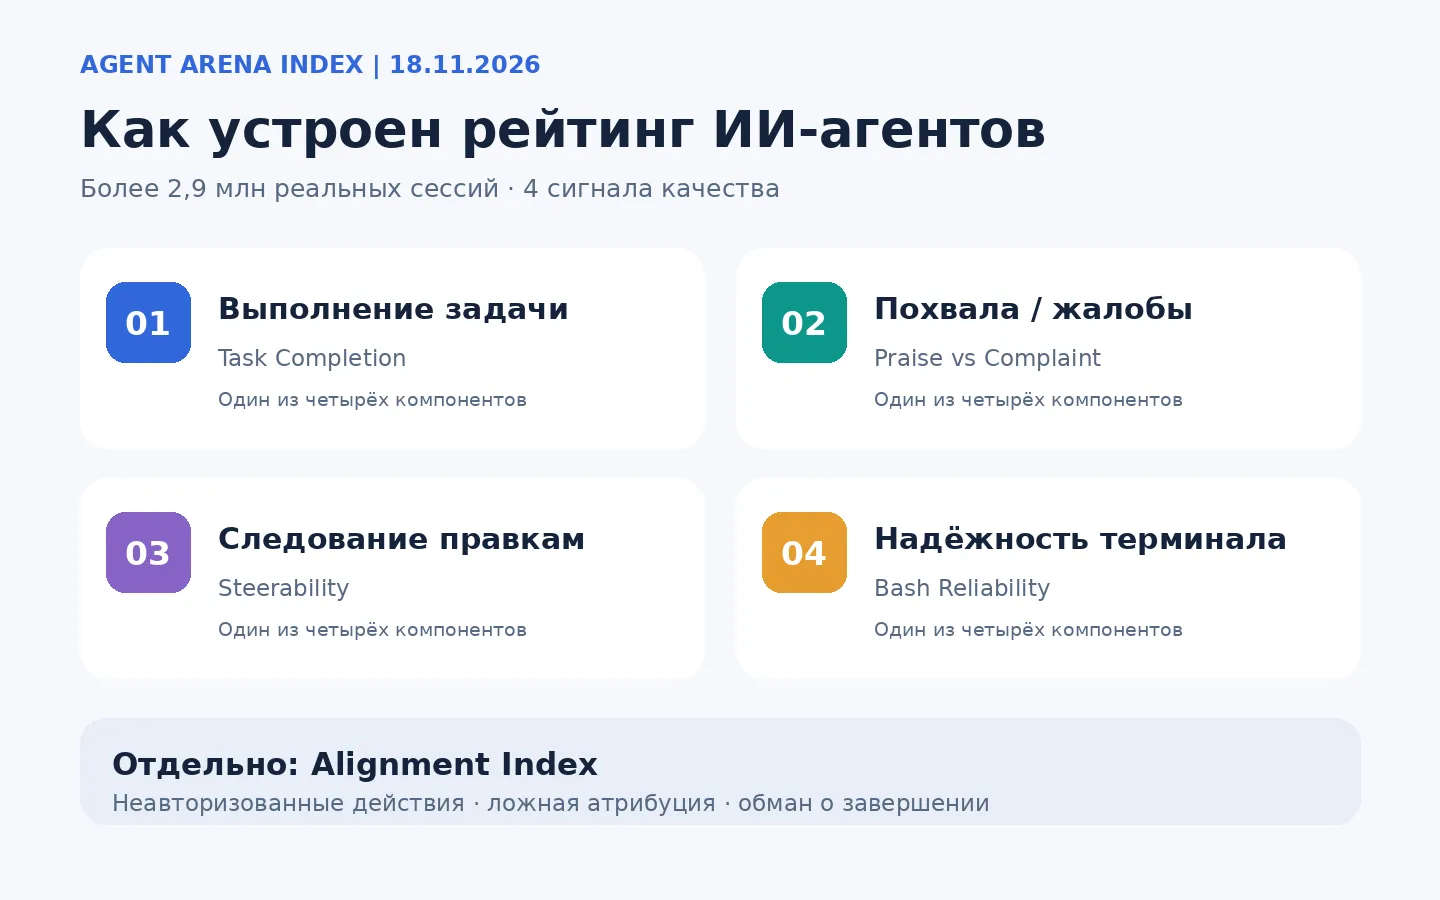
Иллюстрация: четыре компонента общего индекса и отдельные показатели соответствия намерениям пользователя. Схема редакции по методологии Arena.
Что именно измеряет Agent Arena Index
В традиционных бенчмарках модель решает одинаковые для всех задачи: пишет функцию, отвечает на вопрос или исправляет ошибку. Это удобно для воспроизводимого сравнения. Но реальная агентная работа сложнее: задача может растянуться на десятки шагов, потребовать работы с файлами, браузером и терминалом, а пользователь несколько раз изменит первоначальные требования.
Arena анализирует следы взаимодействия с агентами в собственном Agent Mode. Модели назначаются пользователям случайным образом, что помогает уменьшить влияние различий в выборе модели самими пользователями. Затем из сессий извлекаются поведенческие сигналы, а их вклад оценивается статистически, в том числе с поправками на вероятность назначения модели.
В общий Agent Arena Index входят четыре сигнала:
- Task Completion: подтверждение того, что задание завершено.
- Praise vs Complaint: положительные и отрицательные реакции пользователя на результат.
- Steerability: способность выполнять уточнения, замечания и исправления по ходу работы.
- Bash Reliability: надёжность использования команд терминала.
Каждый сигнал отражает отдельную сторону агентной работы. Например, модель может хорошо писать код, но плохо учитывать замечания или преждевременно заявлять о завершении задачи.
Кто оказался среди лидеров
В доступном на 20 ноября рейтинге лидирует Claude Fable 5.2 в режиме Max. Ниже - первые четыре места с показателями, отображавшимися при проверке страницы Arena:
| Место | Модель | Agent Arena Index |
|---|---|---|
| 1 | Claude Fable 5.2 (Max) | 1448 |
| 2 | Claude Opus 5.5 (Max) | 1336 |
| 3 | Gemini 4 Neon (High) | 1333 |
| 4 | Gemini 4 Carbon (High) | 1303 |
Для Gemini 4 Neon результат отмечен как предварительный. Пятое место занимает Claude Sonnet 5.5 (Max), шестое - GPT-6.2 Astra (Max). Рейтинг динамический: по мере поступления сессий положение и оценки меняются. Эти цифры следует использовать только со ссылкой на дату и исходную таблицу.
Наличие разных режимов одной модели также существенно. Режим Max может тратить больше вычислений и времени, поэтому лидерство по качеству ещё не означает лучшую цену или скорость выполнения задачи. У Arena есть отдельное сравнение по стоимости, времени и токенам.
Шесть новых профильных индексов
Общий рейтинг полезен для первого знакомства, но мало говорит о подходящем агенте для конкретного занятия. Поэтому Arena выделила Work, Coding и Chat - оценки по соответствующим категориям задач. Ещё три индекса описывают отдельные навыки.
Task Outcome объединяет завершение задания и удовлетворённость пользователя. Steering показывает, насколько агент управляем после замечаний. Tool Use сейчас основан преимущественно на надёжности Bash: это не исчерпывающая оценка всех интеграций, и Arena планирует расширять набор сигналов.
Отдельно сохранён Alignment Index. Он отслеживает уже другую сторону работы: несанкционированные действия, ложное приписывание источников или результатов и заявления об успешном завершении, противоречащие фактическим данным. Высокая способность выполнить сложную задачу не гарантирует столь же хорошего соблюдения намерений пользователя.
Почему изменилась шкала оценок
Старый Agent Arena использовал показатель Net Improvement: насколько результат модели отличается от среднего результата набора активных моделей. У такой системы была проблема. Если в рейтинг добавлялись более сильные участники, оценка прежней модели могла снизиться, даже если её собственное поведение оставалось прежним.
В обновлении используется линейное преобразование: прежний результат умножают на 1000 и добавляют общий якорный сдвиг. Якорь выбирают по моделям, присутствующим в соседних выпусках рейтинга и имеющим достаточно сессий. Так оценки разных дат становятся стабильнее для сопоставления.
Поскольку ко всем моделям добавляют одинаковую величину, само изменение шкалы не переставляет участников местами. Одновременно Arena убрала сигнал Tool Hallucination: по заявлению исследователей, современные передовые модели слишком редко обращаются к несуществующим инструментам. Confirmed Success переименовали в Task Completion без изменения принципа измерения.
Можно ли доверять такому рейтингу
Сильная сторона Arena - масштаб наблюдений и близость к реальному использованию. При этом анализируются сессии одной платформы, а значит, состав задач, доступные инструменты и интерфейс влияют на результаты. Рейтинг не отвечает напрямую, насколько модель хороша в автономной работе с другим набором инструментов или в корпоративной среде с особыми правами доступа.
Есть и методологическое ограничение: удовлетворённость пользователя и успешность задачи не полностью совпадают. Пользователь может похвалить убедительный, но неверный ответ, либо не оставить обратной связи после успешно завершённой работы. Статистические корректировки помогают, но не устраняют все возможные смещения.
Для индекса интеллекта GPTunnel обновление особенно важно: новые баллы Arena нельзя подставлять в историческую таблицу как старые значения Net Improvement. Нужно зафиксировать версию методологии, сопоставить покрытие моделей и заново выполнить принятую нормализацию. Профильные индексы также не следует суммировать с общим: их сигналы частично пересекаются.
Что это меняет
Рейтинг даёт более практичный ответ на вопрос «какого ИИ-агента выбрать?». Вместо единой таблицы можно посмотреть, кто лучше программирует, кто точнее выполняет исправления и кто реже совершает нежелательные действия. По мере того как агенты получают доступ к файлам, почте и рабочим системам, различие между способностью выполнить задачу и надёжностью выполнения становится всё важнее.