
28 октября 2026 года Google представила Gemini 4 Carbon - новую модель для сложного программирования, длительных задач и киберзащиты. Доступ будут открывать поэтапно: на неделе анонса её начнёт получать небольшая группа специалистов по киберзащите, затем Google расширит круг пользователей через программу Fairwind.
Разработчикам, компаниям и обычным пользователям модель обещают предоставить как можно скорее, но даты общего запуска пока нет. Для сравнения: Argon анонсировали 30 сентября, а общий доступ открыли 13 октября - через 13 дней, почти две недели. Повторится ли такой срок у Carbon, Google не уточняет.
В этом материале мы добавили доступные на данный момент бенчмарки и ключевые детали новой модели Google.
Глава Google Сундар Пичаи в сообщении о Carbon напомнил о намерении выпускать модели периодически и подчеркнул скорость обновления: Carbon анонсирована через 15 дней после широкого запуска Argon. Конкретного графика следующих релизов он не назвал.
Что умеет Gemini 4 Carbon
Carbon построена на основе Gemini 4 Argon. В анонсе Google главный акцент - на защите программных систем и работе над сложными задачами, которые требуют множества действий. Вот что именно компания заявляет о новой модели.
Киберзащита: от поиска уязвимости до исправления
Google проверяет Carbon на трёх этапах работы специалиста по безопасности: найти уязвимость в коде, проверить, действительно ли её можно использовать, и подготовить исправление. Второй этап помогает оценить опасность находки и решить, какие проблемы исправлять в первую очередь.
В тестах, приведённых Google, Carbon получила 88,2% на поиск уязвимостей в SEC-bench Pro, 54,8% на проверку эксплуатации в ExploitGym и 71% на исправление в CWE-bench. Эти испытания проводились без защитных ограничений модели; результаты и условия подробнее разберём ниже.
Компания также сообщает, что в её внутренних тестах Carbon более чем вдвое чаще Argon успешно создавала безопасный код. Команда Chrome, по данным Google, получила с Carbon более качественные исправления, чем с одной из крупных моделей другой лаборатории. Название модели и подробности этого сравнения в анонсе не приведены, поэтому оценить его самостоятельно пока нельзя.
Длительная работа над сложным кодом
Carbon рассчитана на задачи, где агенту нужно последовательно изучать файлы, искать причину ошибки, пробовать исправления и продолжать работу, если первый подход не помог. Google приводит пример поиска и исправления трудноуловимых ошибок в больших кодовых базах и низкоуровневых системах.
По словам компании, её команды наблюдали, как Carbon работала над такими многошаговыми задачами в течение нескольких дней. Это внутренний опыт Google, а не гарантия, что публичная версия сможет автономно вести любой проект столько же времени: итог зависит и от инструментов агента, и от ограничений рабочего окружения.
Меньше выдуманных результатов и выходов за рамки задачи
Google отдельно обучала Carbon поведению в сложных ситуациях: если данных не хватает или действие заблокировано, модель должна сообщать об этом, а не выдавать непроверенный результат за выполненную работу. В своих внутренних тестах компания зафиксировала примерно вдвое меньше неподтверждённых утверждений, чем у Argon.
Компания также сообщает, что в её оценках Carbon на 26% реже выходила за пределы поручения и на 29% реже недовыполняла его. Это результаты конкретных тестов Google, а не гарантия отсутствия ошибок; самостоятельно проверить их на собственном проекте пока нельзя без доступа к модели.
Чем Carbon отличается от Argon
Argon уже можно подключить к приложению через публичный API. Carbon пока находится на этапе ограниченного запуска: Google описала улучшения модели, но подробную спецификацию для разработчиков ещё не представила. Поэтому часть технических характеристик новой модели пока остаётся неизвестной.
| Что сравниваем | Gemini 4 Argon | Gemini 4 Carbon на момент анонса |
|---|---|---|
| Доступ | Общий доступ с 13 октября: платный API, AI Studio и продукты Google | Поэтапный доступ специалистам по киберзащите и доверенным партнёрам Fairwind; дата общего запуска не названа |
| Идентификатор в API | Стабильная модель gemini-4-argon | Публичный идентификатор пока не опубликован |
| Контекст | 1 048 576 токенов, общий лимит для входа и выхода | Размер контекста пока не указан |
| Длина ответа | По умолчанию до 65 536 токенов; с long decode - до 1 048 576 в пределах общего окна | Лимит ответа и наличие long decode пока не указаны |
| Вход и выход | На входе текст, изображения, видео, аудио и PDF; на выходе текст | Google заявляет улучшение мультимодального понимания, но полный список входных и выходных форматов пока не приводит |
| Инструменты и режимы | Вызов функций, исполнение кода, поиск, структурированный вывод; уровни рассуждения low, medium и high | Состав инструментов и настройки рассуждения в будущем публичном API пока не описаны |
| Кэширование | Поддерживается неявное кэширование; явное недоступно | Объявлена скидка 95% на кэшированный вход; способ работы с кэшем пока не уточнён |
Характеристики Argon - из документации Gemini API, сведения о Carbon - из анонса Google. «Пока не указано» означает, что данных нет в опубликованной спецификации, а не что функция отсутствует. Переносить на Carbon контекст, форматы и инструменты Argon без подтверждения нельзя.
Главное заявленное изменение Carbon касается длительной работы агента. Google сообщает, что модель лучше справляется со сложными инженерными задачами, реже выдаёт неподтверждённые утверждения и точнее соблюдает границы поручения. Это улучшения по внутренним наблюдениям компании; как они проявятся в публичной версии, предстоит проверить.
По объявленному вводному тарифу API Google Carbon будет стоить $2 за миллион входных токенов и $10 за миллион выходных. После вводного периода цены вырастут до $4 за миллион входных и $20 за миллион выходных токенов. Кэшированные входные токены во вводном тарифе будут на 95% дешевле обычных входных. Это те же ставки, что Google объявила для Argon; дату окончания вводного периода Carbon компания не назвала.
Результаты независимых тестов: Arena и Artificial Analysis
WebDev Arena
WebDev Arena сравнивает модели на задачах веб-разработки по оценкам пользователей. На срезе рейтинга от 27 октября Gemini 4 Carbon в режиме High занимает четвёртое место с 1768 баллами.
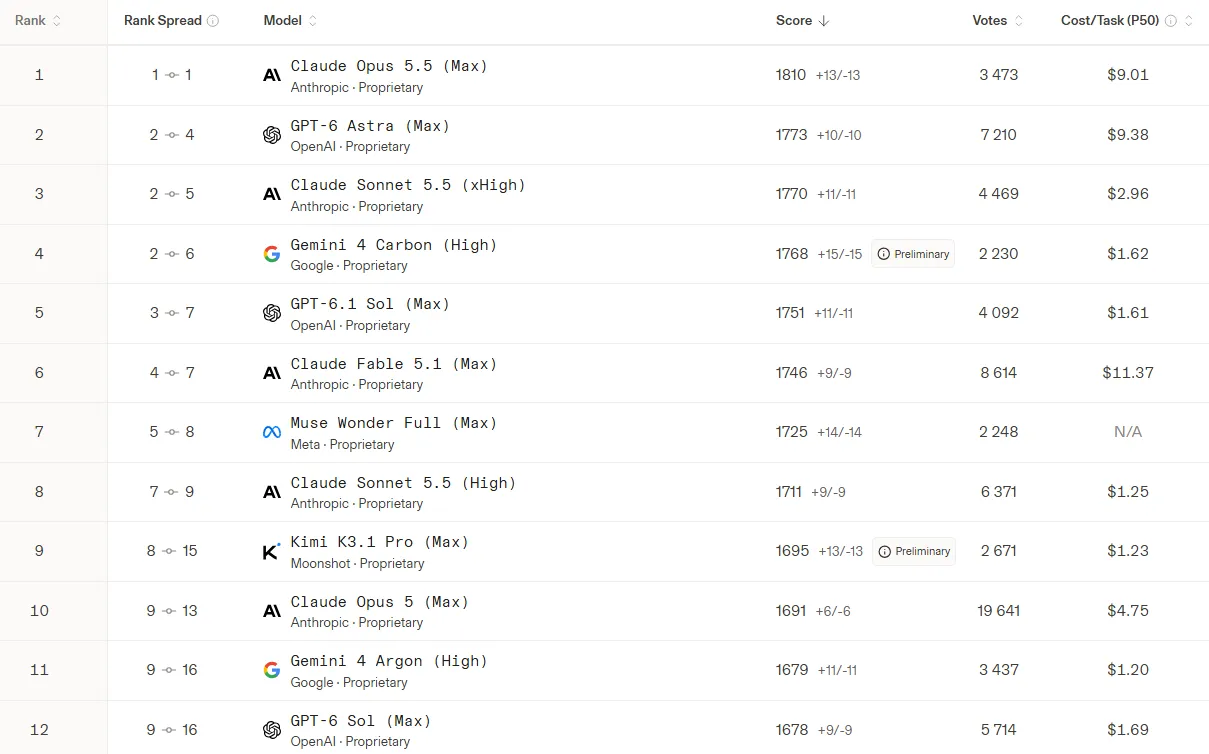
Впереди Carbon - Claude Opus 5.5 Max с 1810 баллами, GPT-6 Astra Max с 1773 и Claude Sonnet 5.5 xHigh с 1770. Позади неё идут GPT-6.1 Sol Max с 1751 и Claude Fable 5.1 Max с 1746. Предшественница Gemini 4 Argon High занимает 11-е место с 1679 баллами.
Результат Carbon предварительный: на скриншоте учтено 2230 голосов, а диапазон возможной позиции в рейтинге - со второго по шестое место. Баллы и места меняются по мере поступления новых оценок; Google в анонсе приводит 1769 баллов для Carbon.
В попарном сравнении Claude Opus 5.5 Max выигрывает у Gemini 4 Carbon High в 69% дуэлей на приведённом срезе WebDev Arena. В матрице ниже показаны и другие пары: значение в строке модели отражает её результат против модели в соответствующем столбце.
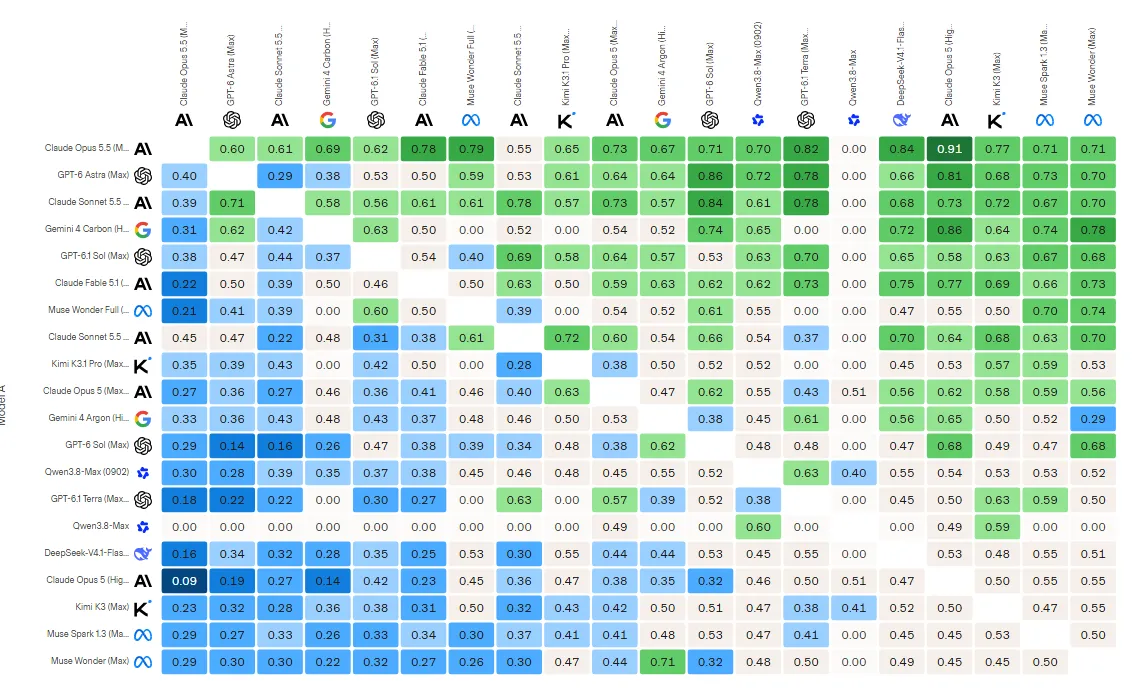
Таблица рейтинга выше также показывает оценку медианной стоимости задачи: $1,62 для Carbon, $9,01 для Opus 5.5 Max и $9,38 для GPT-6 Astra Max. Это показатель Arena, а не цена задачи в GPTunneL; собственную стоимость стоит проверять после появления доступа к Carbon.
Индекс Artificial Analysis и бенчмарки Google
В Artificial Analysis Intelligence Index v5.0 Carbon в режиме High получила 59 баллов и заняла первое место среди оценённых моделей. Далее идут Claude Opus 5.5 с 58 и GPT-6 Astra с 57 баллами, а Argon набрала 50. Это срез результатов, приведённый Google в сравнительной таблице ниже.
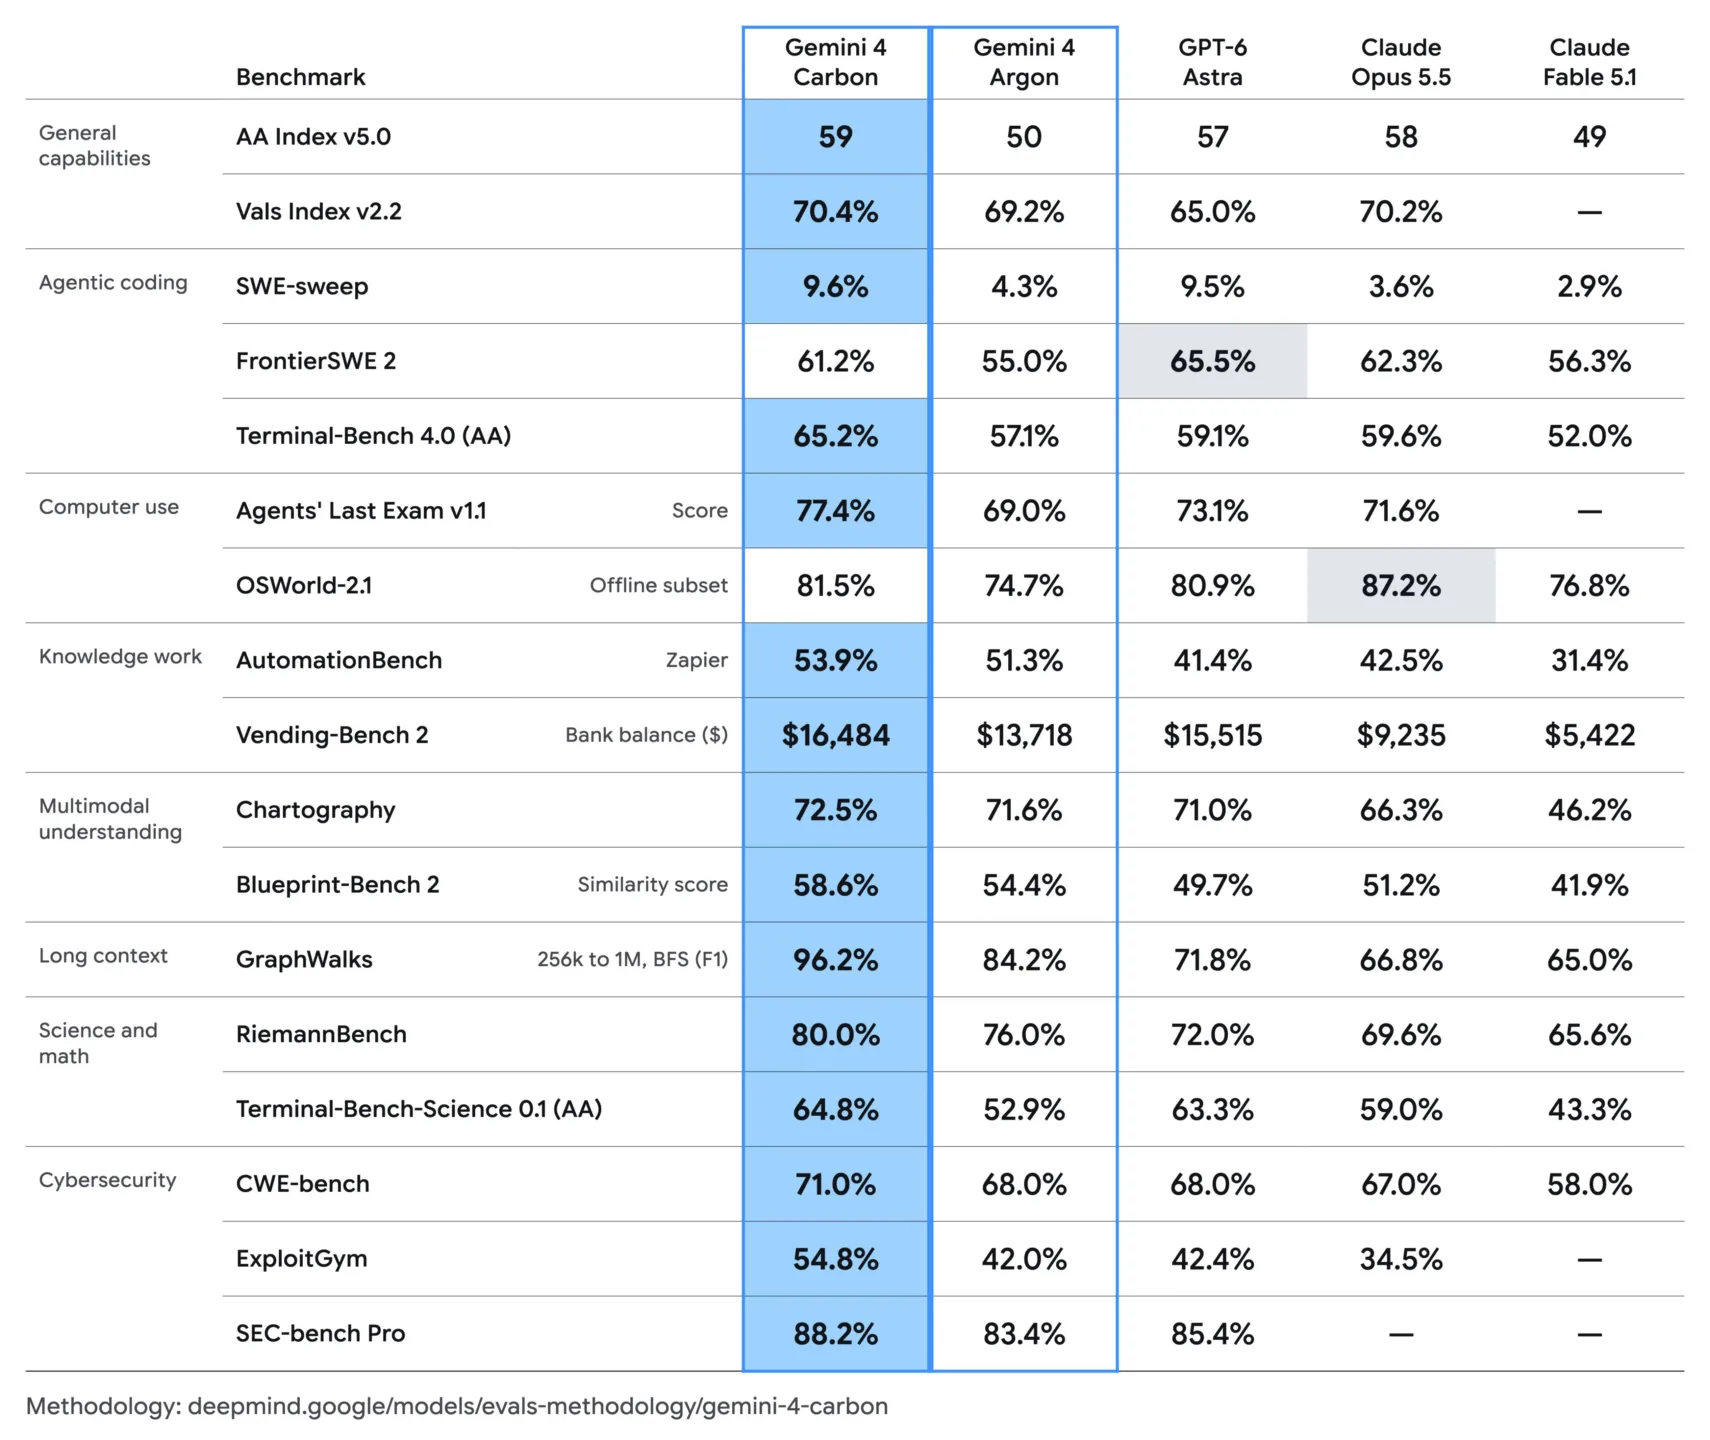
На таблице, которой поделился Пичаи, собраны разные бенчмарки, а не разбивка одного индекса Artificial Analysis. Сравнение подготовлено Google DeepMind; результаты Terminal-Bench 4.0 и Terminal-Bench-Science 0.1 отмечены как оценки AA. Например, в Terminal-Bench 4.0 от AA Carbon получила 65,2% против 57,1% у Argon и 59,6% у Claude Opus 5.5. В FrontierSWE 2 Carbon набрала 61,2% и уступила GPT-6 Astra с 65,5% и Opus 5.5 с 62,3%.
Индекс объединяет девять проверок, включая программирование, рассуждения, математику и научные задачи. Artificial Analysis пишет, что проводит оценки самостоятельно. Это полезный общий ориентир, но он не заменяет тест на вашей задаче: вес отдельных проверок и настройки модели влияют на итог.
Ещё одна ловушка - сравнить новые 59 баллов с числами из старой версии индекса и объявить точный прирост. Версия v5.0 использует обновлённую методику, поэтому сравнивать стоит результаты, полученные в одной версии рейтинга.
Сколько стоит результат. На предоставленном срезе Artificial Analysis оценивает средневзвешенную стоимость одной задачи индекса в $7,76 для Carbon High. Для сравнения: GPT-6 Astra Max - $6,24, Claude Opus 5.5 Max с резервной моделью - $10,04. Получается, в этом наборе проверок Carbon набрала больше баллов, чем эти две модели, при стоимости между ними.
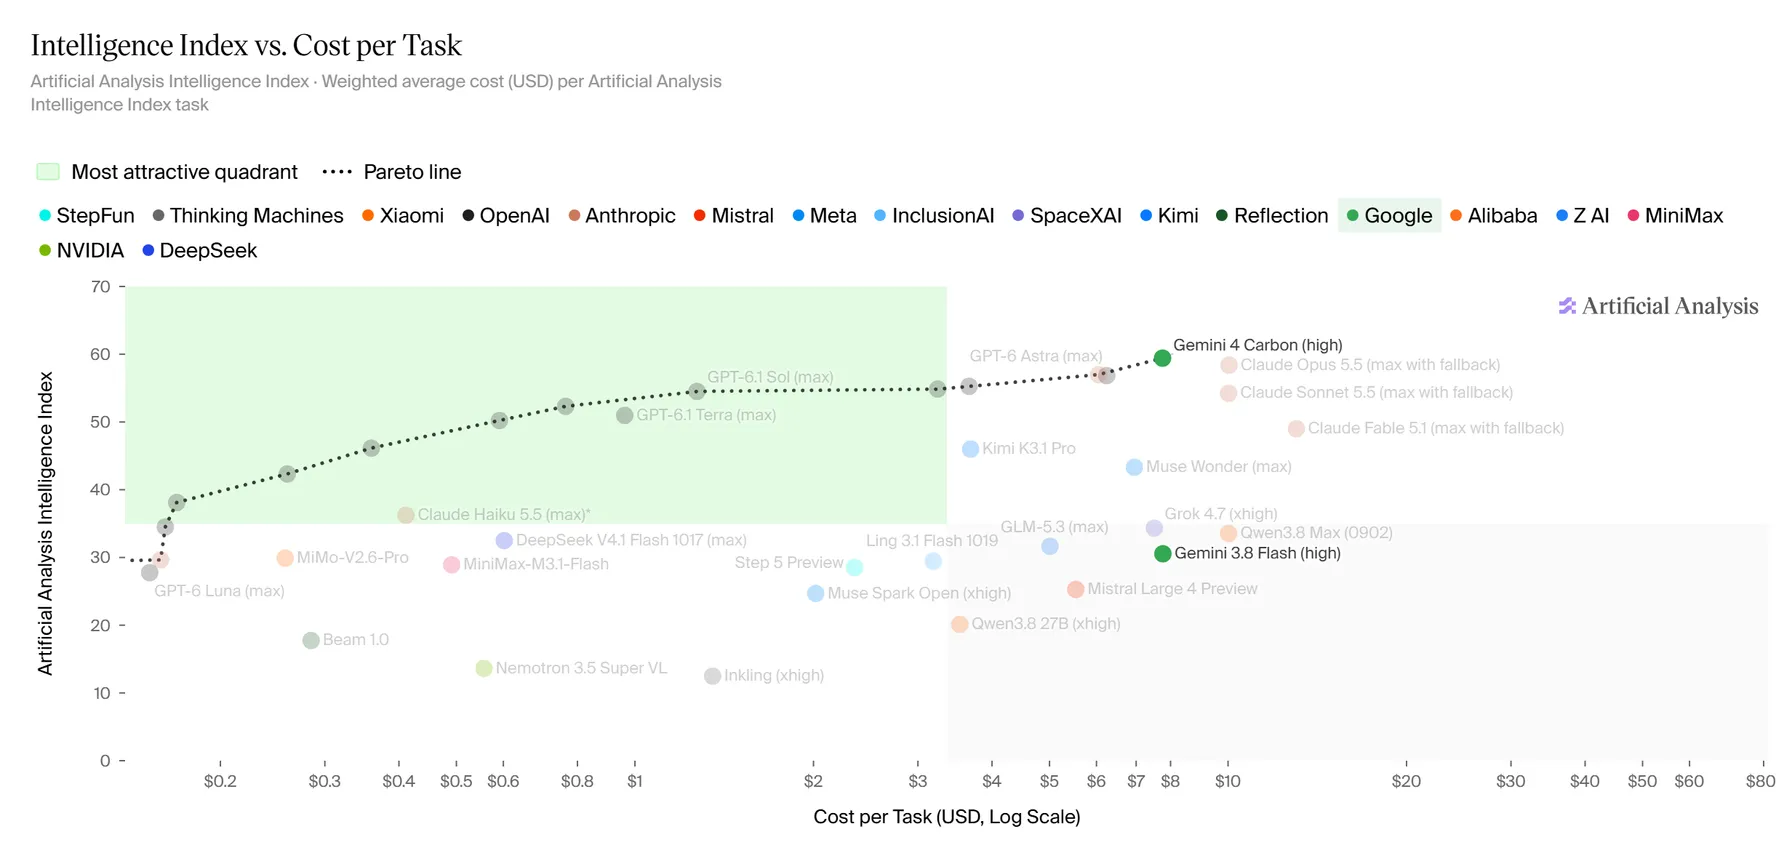
По горизонтали графика - стоимость задачи в долларах, причём шкала логарифмическая; по вертикали - балл индекса. Чем выше и левее точка, тем выше результат при меньших затратах. Artificial Analysis рассчитывает стоимость по расходу токенов в отдельных тестах и учитывает вес каждого теста в индексе.
Это расчёт для задач бенчмарка, а не цена обычного сообщения или тариф GPTunneL. У Carbon на момент среза публичного API ещё не было, поэтому её стоимость здесь стоит воспринимать как оценку, которую нужно перепроверить после открытия доступа.
Как модель ищет и исправляет уязвимости
Кибербезопасность - главный акцент анонса Google. Компания приводит результаты трёх внешних тестов:
| Проверка | Что измеряют | Результат Carbon по данным Google |
|---|---|---|
| SEC-bench Pro | поиск уязвимостей в программном обеспечении | 88,2% |
| ExploitGym | проверка возможности эксплуатации уязвимостей | 54,8% |
| CWE-bench | поиск и исправление проблем в коде | 71,0% |
Важная оговорка Google: эти кибертесты проводились без защитных ограничений модели. Результаты таких проверок нельзя автоматически переносить на будущую версию для всех пользователей.
В таблице CWE-bench Carbon тоже указана с результатом 71% по автоматической проверке pass@1; Argon - с 68%. В тесте 120 задач, для каждой модели предусмотрены четыре попытки, а на одну попытку дают до часа. Обе модели Google в этой таблице работали через Antigravity; другие участники могли использовать другие агентные инструменты.
Практический смысл разницы в три процентных пункта понятен только вместе с условиями проверки. И даже высокий результат не означает, что модель найдёт все уязвимости в вашем приложении или что её исправление можно принимать без ревью.
Стала ли модель надёжнее
Google отдельно пишет о поведении агента во время работы. В собственных тестах компании Carbon примерно вдвое сократила количество неподтверждённых утверждений по сравнению с Argon, а в рабочих средах команд Google число серьёзных сигналов несоответствия поведения снизилось почти на 80%.
Защита от косвенных промпт-инъекций
В тесте Gray Swan IPI Google сообщает о 0% успешных атак на Carbon при показателе для 15 попыток. Здесь меньше - лучше: для сравнения, на графике у Argon 0,7%, у Claude Opus 5.5 - 1%. Результат относится к конкретным проверенным атакам и условиям теста.
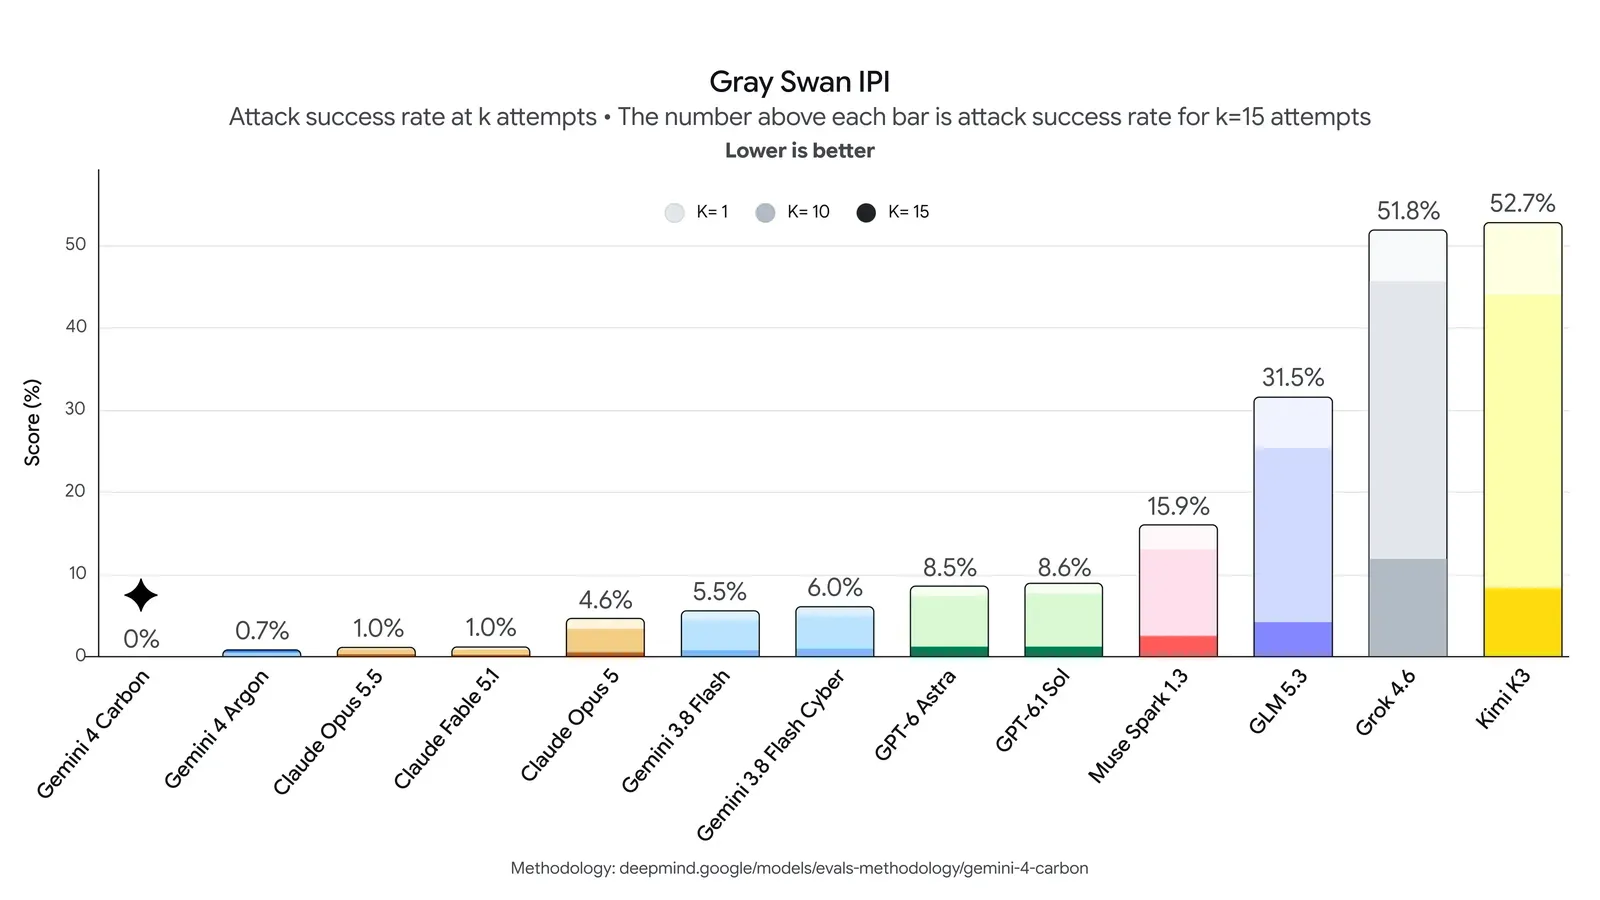
Косвенная промпт-инъекция - это инструкция, которую злоумышленник прячет во внешнем материале: например, на странице, в документе или в письме, которое читает агент. Она может пытаться заставить модель проигнорировать задачу пользователя и выполнить чужое указание.
Особенно важна защита для ИИ-агентов, которые одновременно читают неподконтрольный пользователю контент и могут действовать: запускать инструменты, менять файлы или отправлять данные. Без устойчивости к таким инструкциям злоумышленник может попытаться управлять агентом через материал, который тот открыл для работы.
Ноль на этом тесте - сильный результат, но не гарантия защиты от всех будущих атак. В публичной версии результат ещё предстоит проверить на практике.
Поэтому для работы с кодом я бы сохранял обычные проверки: ограничить доступ агента нужной папкой, посмотреть изменения, запустить тесты и отдельно проверить чувствительные участки. Модель может ускорить поиск и подготовить исправление, но ответственность за применение изменений остаётся у команды.
Что пока неизвестно
Google не указала в анонсе точную дату массового доступа, размер контекстного окна Carbon и публичный идентификатор модели для API. Их нельзя автоматически брать из характеристик Argon. Реальную скорость, цену типичной задачи и качество работы на собственном коде тоже ещё предстоит проверить.
Пока Carbon стоит воспринимать как перспективную модель с сильными первыми результатами и ограниченным доступом. Если вы уже работаете с Argon, сохраните одну показательную задачу и её результат: после открытия Carbon можно будет сравнить модели на одинаковом промпте, с теми же инструментами и тестами.
Если вам нужна доступная модель семейства сейчас, можно посмотреть Gemini 4 Argon и наш разбор её запуска.