
Обновлено 24 октября. Вышли независимые тесты Artificial Analysis, Arena AI, Bug Hunt Bench, и оригинальном StealthMark поэтому статью я начну с этих данных, а данные самой Moonshot будут ближе к концу материала. Собрал все доступные бенчмарки, отзывы сообщества и примеры работы модели с 3D, чтобы обзор получился максимально полным.
Если у вас, как и у меня, не получилось попробовать новую модель на сайте Kimi, K3.1 Pro уже доступна в GPTunneL без очередей.
Итак, действительно ли новая Kimi K3.1 Pro сравнялась с Claude Opus 5.5? Быстрый ответ - где-то близко, но всё еще нет, и есть 2 ложки дёгтя, о которых написал ниже, в том числе про "натасканность на бенчмарки" (benchmark-maxing).
Moonshot выпустила Kimi K3.1 Pro 23 октября - в тот же день, когда утром компания сама заспойлерила название модели в ролике. В тестах Moonshot новая Kimi идёт почти вровень с Claude Opus 5.5: 65,7% против 66,4% в Terminal-Bench 4.0, а в шести тестах из четырнадцати стоит первой. Вместе с ней вышла K3.1 Pro Highspeed - та же модель, но в 2-3 раза быстрее.
Предрелизные утечки собрал в отдельном блоке: хронологию и ролик с воксельной пагодой, которую, по словам LuminaBench, сделали на K3.1 ещё до выхода.
Замеры Artificial Analysis
В четырёх тестах, которые есть и у Moonshot, цифры Artificial Analysis расходятся с вендорскими не больше чем на 3,2 пункта, а в Terminal-Bench 4.0 у Artificial Analysis результат даже выше: 67,2 против 65,7.
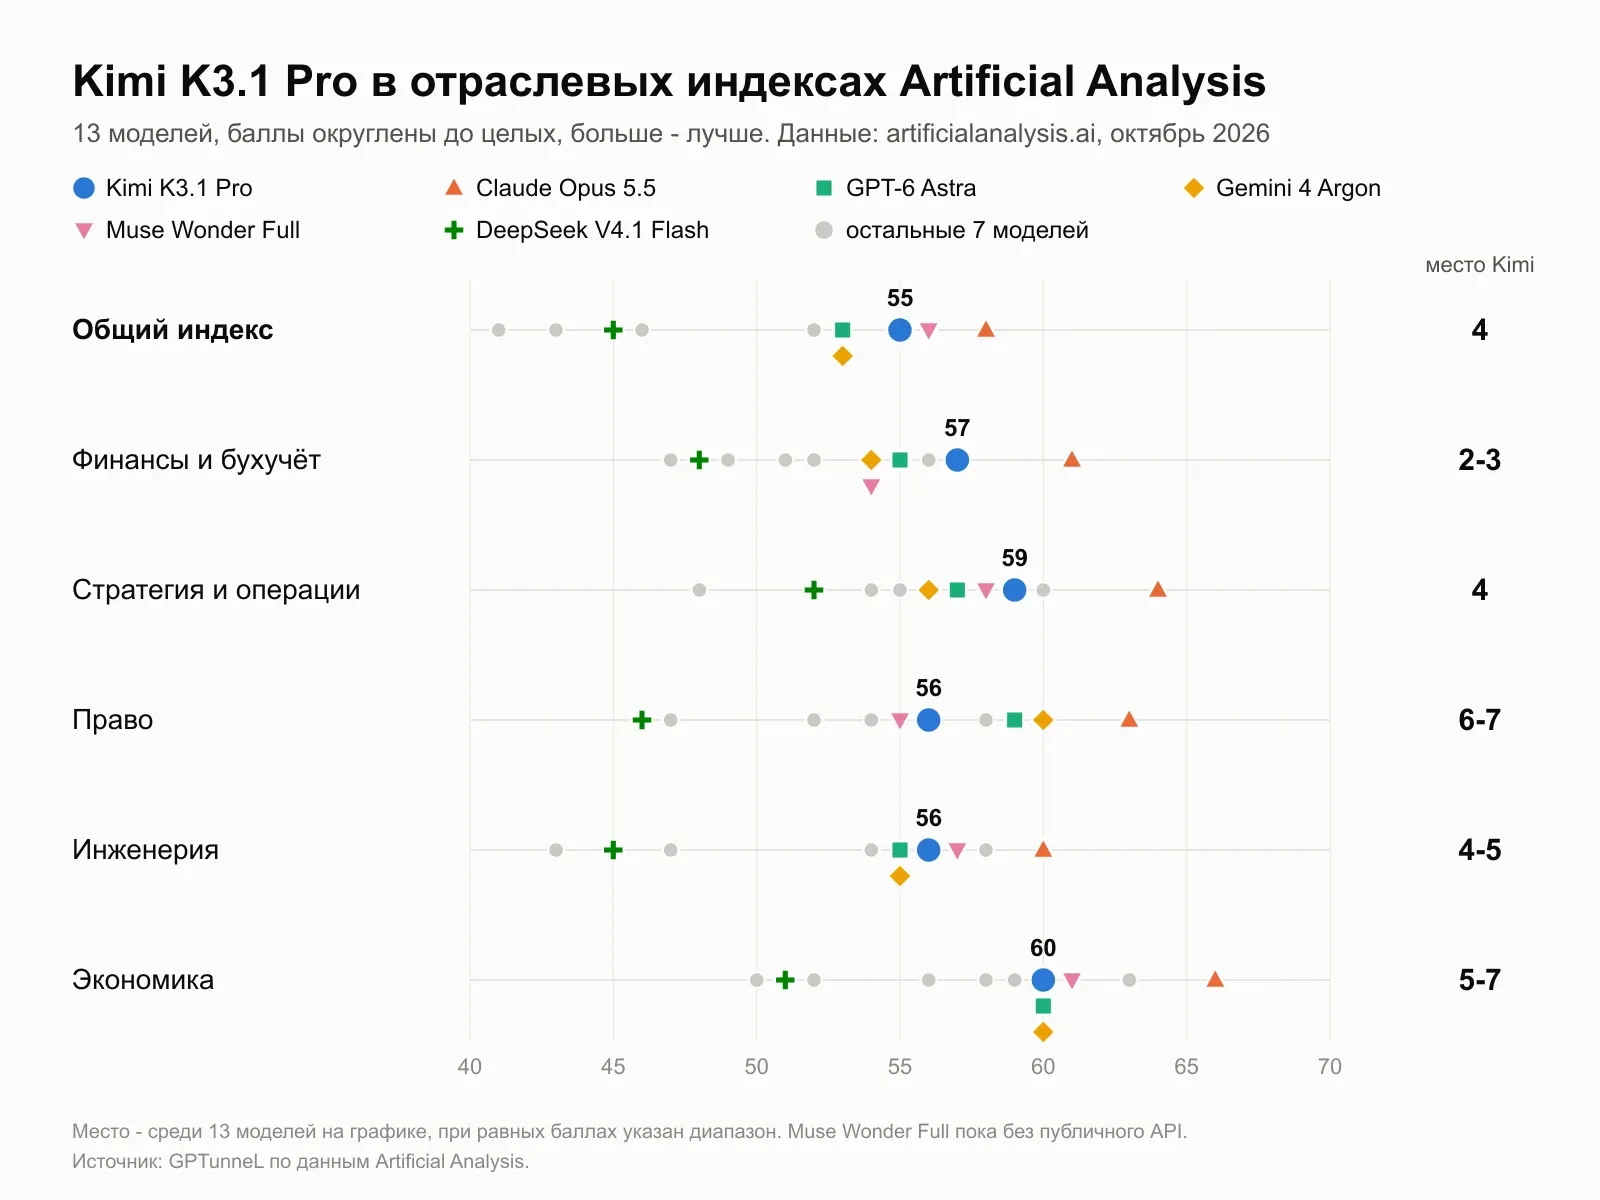
Artificial Analysis гоняет модели на своём наборе тестов и считает общий индекс и отраслевые - под финансы, право, инженерию и другие задачи. Я собрал их для 13 моделей из верхней части рейтинга.
Показать табличные данные
| Модель | Общий | Финансы и бухучёт | Стратегия и операции | Право | Инженерия | Экономика |
|---|---|---|---|---|---|---|
| Claude Opus 5.5 | 58 | 61 | 64 | 63 | 60 | 66 |
| Claude Sonnet 5.5 | 56 | 57 | 60 | 56 | 58 | 61 |
| Kimi K3.1 Pro | 55 | 57 | 59 | 56 | 56 | 60 |
| Muse Wonder Full | 56 | 54 | 58 | 55 | 57 | 61 |
| Claude Fable 5.1 | 53 | 56 | 60 | 60 | 56 | 63 |
| GPT-6 Astra | 53 | 55 | 57 | 59 | 55 | 60 |
| Gemini 4 Argon | 53 | 54 | 56 | 60 | 55 | 60 |
| GPT-6.1 Sol | 52 | 54 | 57 | 58 | 54 | 59 |
| Muse Wonder | 52 | 51 | 55 | 52 | 54 | 58 |
| Grok 4.7 | 46 | 52 | 54 | 54 | 47 | 56 |
| DeepSeek V4.1 Flash | 45 | 48 | 52 | 46 | 45 | 51 |
| MiniMax-M3.1-Flash | 43 | 49 | 55 | 47 | 43 | 50 |
| Gemini 3.8 Flash | 41 | 47 | 48 | 52 | 43 | 52 |
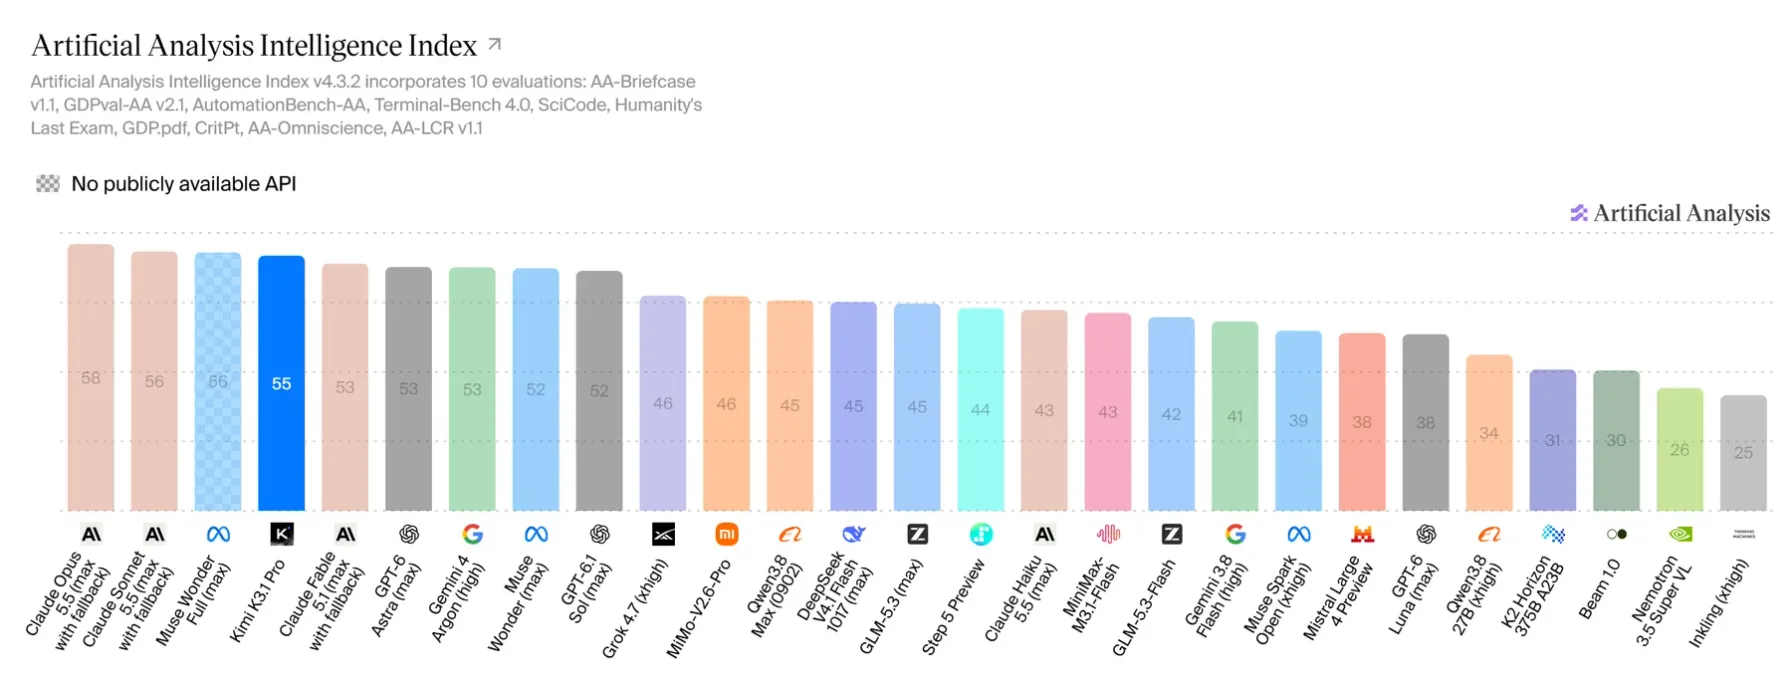
Источник: Artificial Analysis, 24 октября 2026.
- Общий индекс - 55 баллов, 4-е место из 215 моделей. Выше только Claude Opus 5.5 (58), Claude Sonnet 5.5 (56) и Muse Wonder Full (56). У Kimi K3 было 44, так что прирост - 11 баллов.
- Скорость - 77 токенов в секунду. У K3 было 36,9, то есть новая модель примерно вдвое быстрее. Но это всё ещё середина рынка: 102-е место из 186. Первый токен приходит через 2,89 секунды.
- Модель многословная. На прогон индекса она потратила 150 млн выходных токенов при медиане 87 млн. Одна задача индекса стоила $2,11.
Opus 5.5 первая во всех шести индексах, и разрыв с Kimi - от 3 до 7 баллов. Ближе всего K3.1 Pro подходит в финансах: 57 против 61, второе-третье место вместе с Sonnet 5.5. Дальше всего - в праве: 56 против 63, там Kimi только шестая-седьмая, её обходят Fable 5.1, Gemini 4 Argon, GPT-6 Astra и GPT-6.1 Sol.
Muse Wonder Full пока без публичного API, так что из моделей, которые можно взять в работу, K3.1 Pro по общему индексу третья.
Место K3.1 Pro на Arena
Через 26 минут после релиза Arena показала, на какое место встала новая Kimi. На Arena модели сравнивают живые пользователи: получают два ответа вслепую и выбирают лучший.
В Code Arena: WebDev, где оценивают создание сайтов и веб-приложений, Kimi K3.1 Pro заняла 8-е место с 1692 очками - вплотную к Claude Opus 5 (Max) с 1691. По сравнению с Kimi K3 (Max) это плюс 9 мест и 37 очков. Arena отдельно отмечает, что после выхода весов K3.1 Pro станет первой открытой моделью в этом рейтинге.
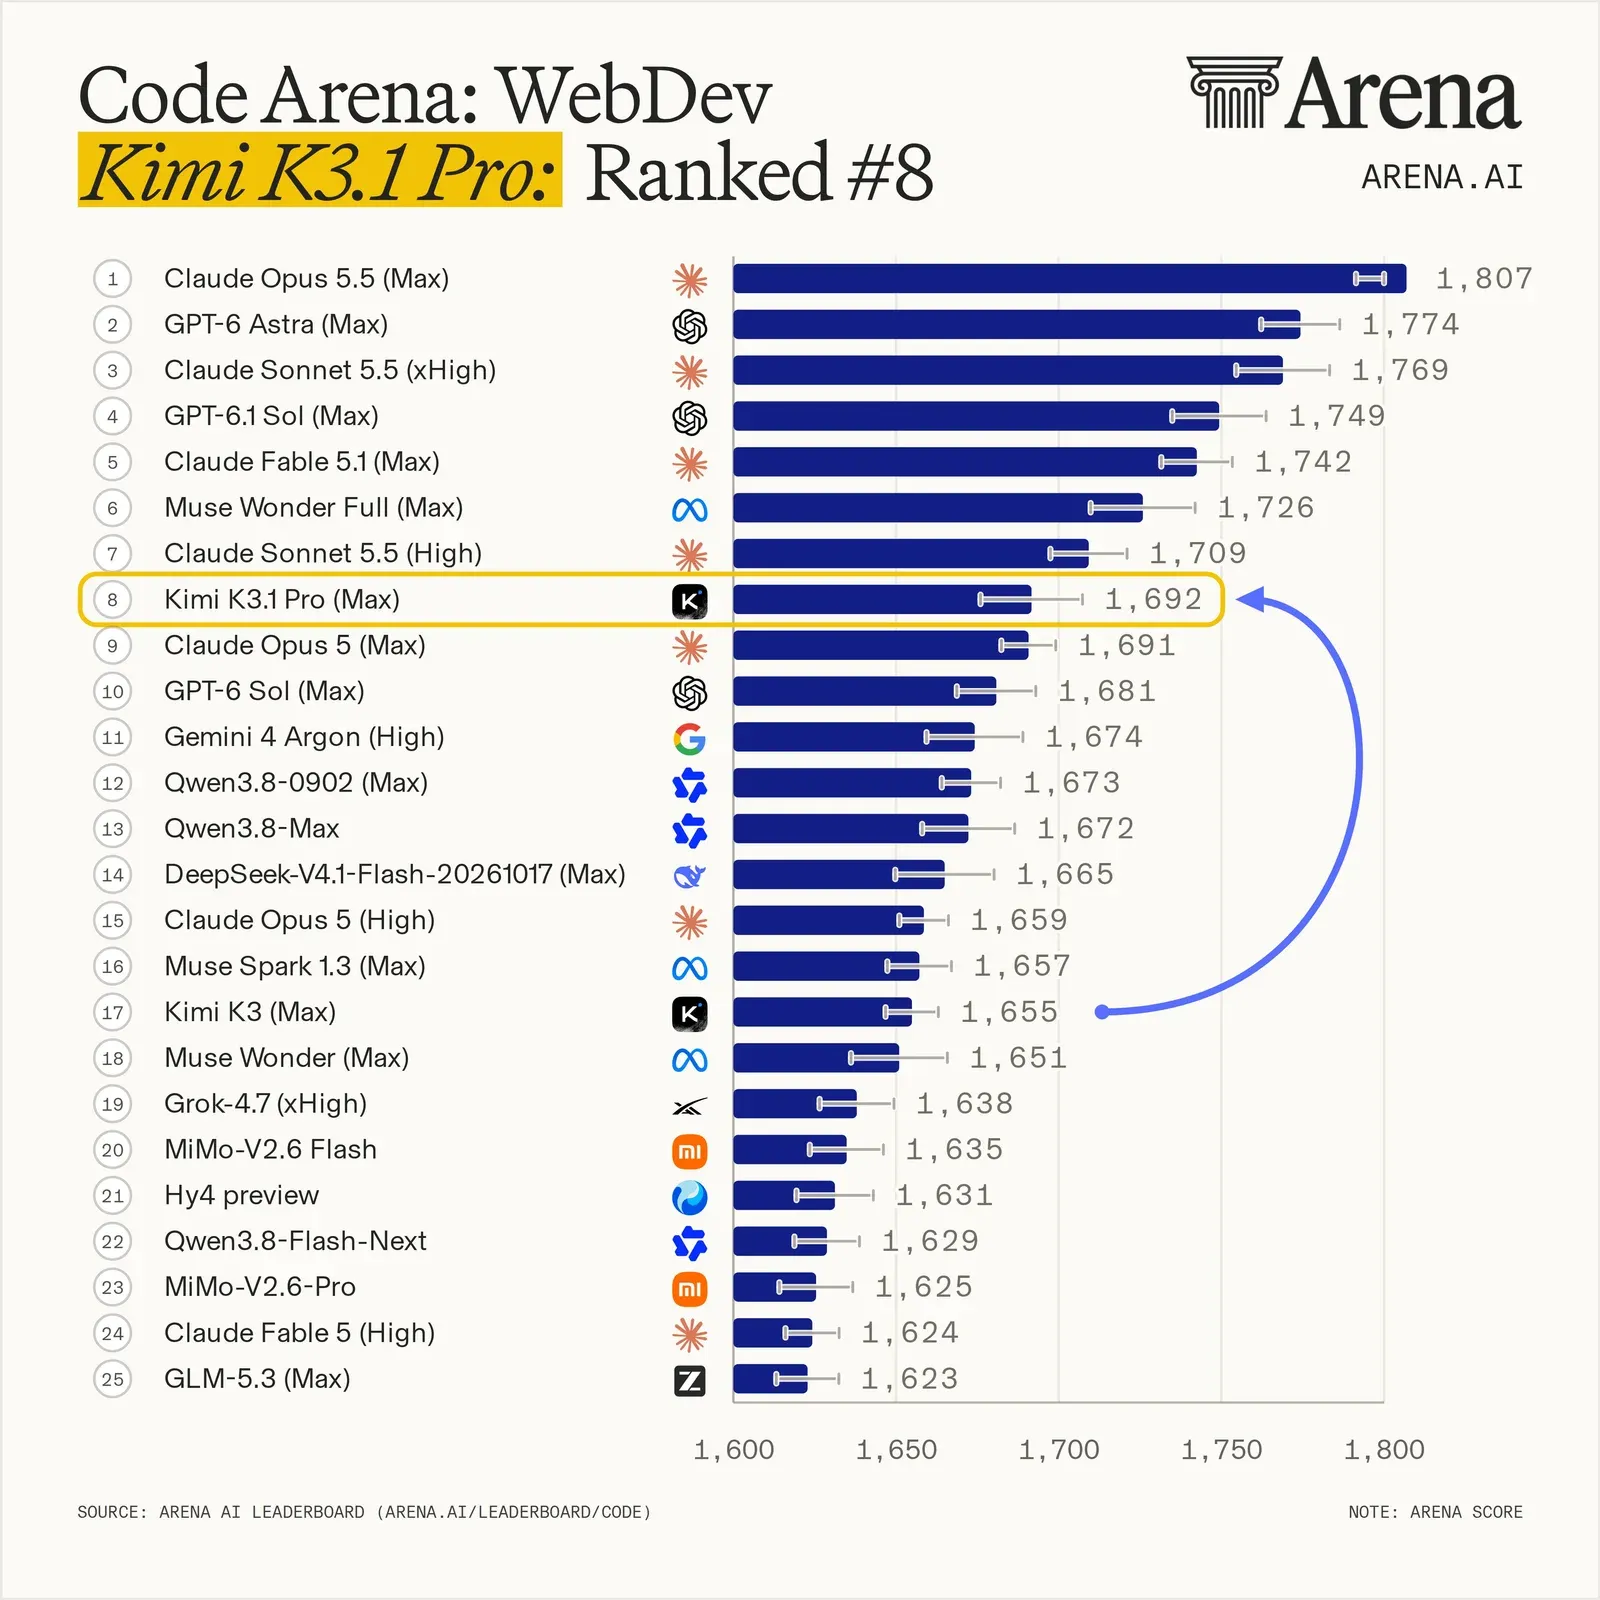
Источник: Arena в X, 23 октября 2026.
У Arena есть и срезы по типам задач, и отдельный рейтинг агентов - Agent Arena, где модель оценивают по реальным сессиям: довела ли задачу до конца, доволен ли пользователь, слушается ли модель уточнений.
| Рейтинг Arena | Место Kimi K3.1 Pro | Результат Kimi | Лидер |
|---|---|---|---|
| Code Arena: WebDev, общий | 8 | 1692 | Claude Opus 5.5 (Max), 1807 |
| WebDev: бренд и маркетинг | 7 | 1704 | Claude Opus 5.5 (Max), 1804 |
| WebDev: данные и аналитика | 11 | 1606 | GPT-6 Astra (Max), 1683 |
| Agent Arena, общий | 11 | +7,61% | Claude Opus 5.5 (Max), +20,77% |
Лучше всего новая Kimi выглядит в задачах по бренду и маркетингу: там она седьмая и обходит Kimi K3 на 26 очков. В данных и аналитике она только одиннадцатая, а в Agent Arena отстаёт заметнее всего: итоговый показатель почти втрое ниже, чем у Opus 5.5.
Все места пока предварительные. В срезах у Kimi от 282 до 515 голосов, поэтому разброс большой: в аналитике модель может оказаться где угодно между 3-м и 29-м местом. Цифры срезов - по данным arena.ai на 22-23 октября.
Первая ложка дёгтя - Bug Hunt Bench
Bug Hunt Bench - независимый тест Павла Хурына, автора рассылки The Product Compass. В два реальных рабочих проекта спрятаны 105 ошибок: 45 в расширении для VS Code на TypeScript (около 28 тысяч строк) и 60 в учебной платформе на React и Supabase (около 60 тысяч строк). Большинство ошибок - настоящие регрессии из истории самих проектов, которые откатили обратно. Тесты при этом остаются зелёными, так что подсказок нет.
Каждая модель получает одинаковый промпт и одну попытку на проект в своём агентном инструменте. Результат проверяет независимый судья по скрытому списку ответов и не знает, чья это работа. Засчитываются только спрятанные ошибки. Даже лучшие модели находят далеко не всё: 25 из 105 ошибок пока не исправил никто.
Kimi K3.1 Pro прогнали в тот же день, что и вышел релиз, на максимальном уровне размышлений и через API самой Moonshot. Обвязкой (харнессом) был не Kimi Code, а Claude Code от Anthropic - и это не случайность: Moonshot сама прогоняла свои тесты по коду для K3.1 Pro в Claude Code, поэтому автор взял тот же инструмент. Условия совпадают с теми, в которых получены вендорские цифры.
Результат - 36 из 105, в среднем по трём запускам. Это заметно ниже лучших запусков остальных топовых моделей, но выше прошлой Kimi K3.
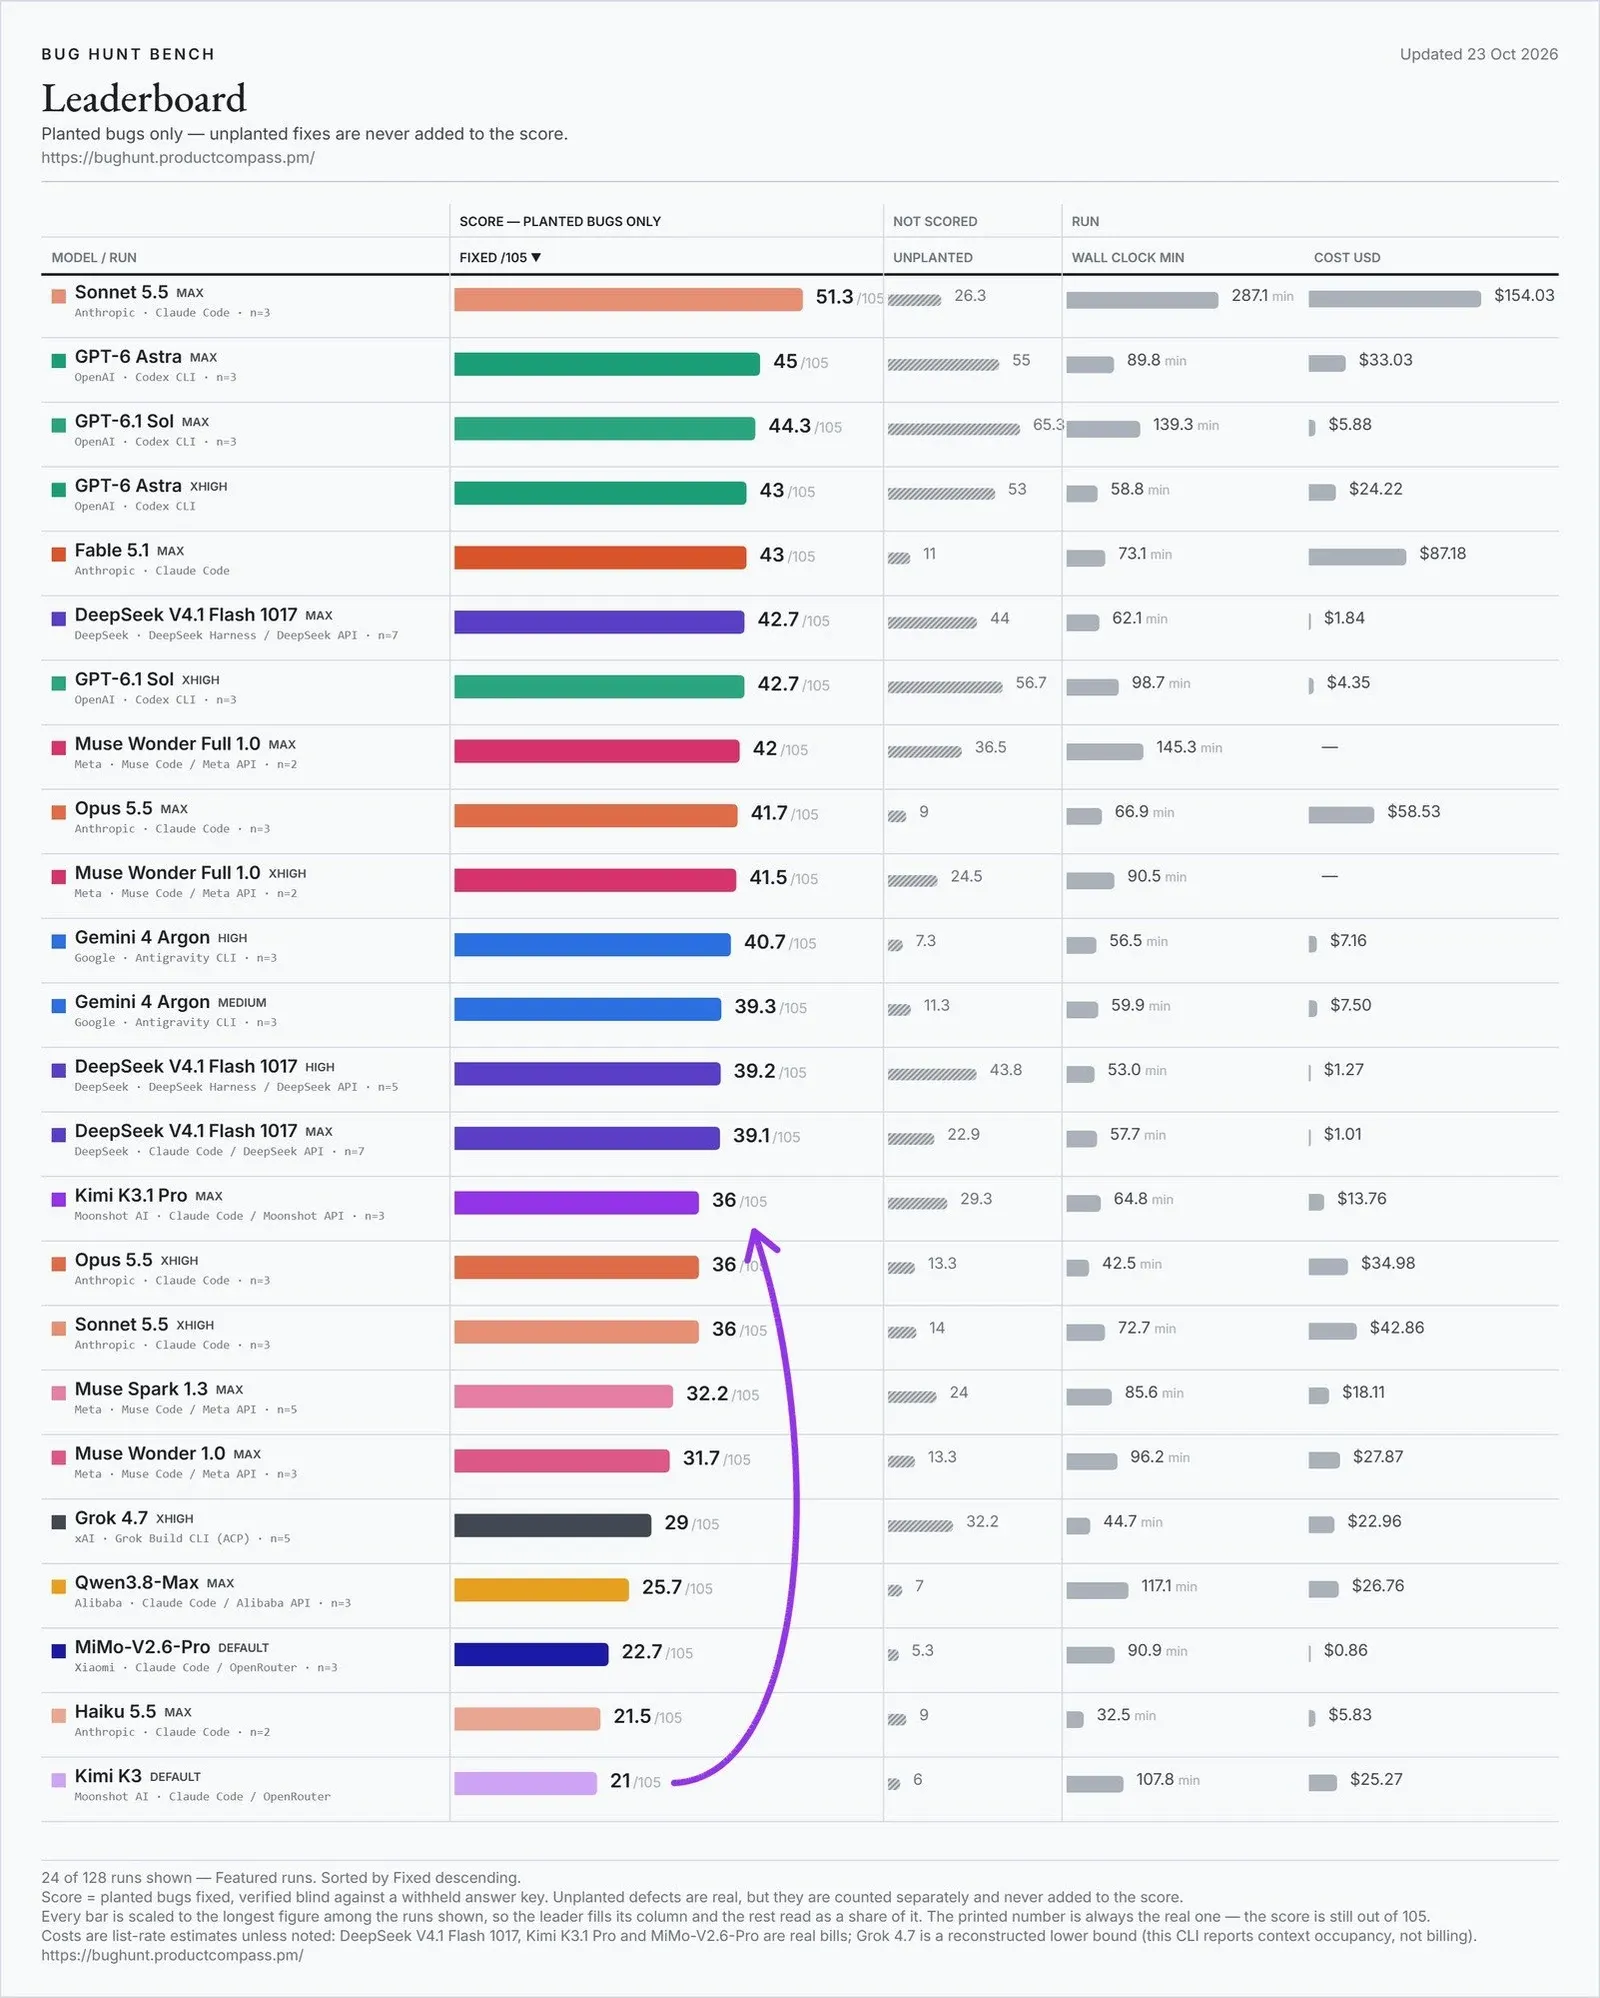
Источник: Bug Hunt Bench, обновление от 23 октября 2026.
Показать табличные данные
| Модель, уровень | Исправлено из 105 | Время, мин | Стоимость прогона |
|---|---|---|---|
| Claude Sonnet 5.5, max | 51,3 | 287,1 | $154,03 |
| GPT-6 Astra, max | 45 | 89,8 | $33,03 |
| GPT-6.1 Sol, max | 44,3 | 139,3 | $5,88 |
| Claude Fable 5.1, max | 43 | 73,1 | $87,18 |
| DeepSeek V4.1 Flash, max | 42,7 | 62,1 | $1,84 |
| Muse Wonder Full, max | 42 | 145,3 | - |
| Claude Opus 5.5, max | 41,7 | 66,9 | $58,53 |
| Gemini 4 Argon, high | 40,7 | 56,5 | $7,16 |
| Kimi K3.1 Pro, max | 36 | 64,8 | $13,76 |
| Claude Opus 5.5, xhigh | 36 | 42,5 | $34,98 |
Обидная деталь: DeepSeek V4.1 Flash, тоже открытая модель, исправила почти на 7 ошибок больше и обошлась в 7,5 раза дешевле. Автор теста сделал из этого жёсткий вывод:
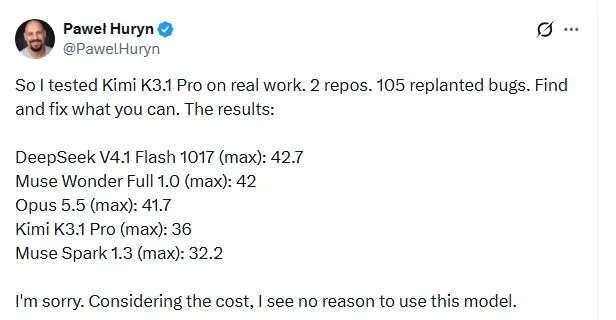
«Простите, но с учётом стоимости я не вижу причин использовать эту модель».
Источник: Павел Хурын в X, 23 октября 2026.
Результат у Kimi ещё и нестабильный. Три запуска дали 36, 42 и 30 ошибок - разброс 12 пунктов. В третьем запуске на втором проекте модель на отметке около 128 тысяч токенов контекста начала выдавать бессвязный текст и в размышлениях, и в итоговом ответе, а через 3,9 минуты закончила работу без отчёта и без единой правки. API при этом не вернул никакой ошибки. Эту попытку перезапустили. Если бы её засчитали как ноль, среднее было бы 32.
Для сравнения, прошлая Kimi K3 исправила 21 из 105. Но её запускали через стороннего провайдера и на уровне размышлений по умолчанию, поэтому прирост нельзя целиком приписать новой модели.
StealthMark - ещё один оригинальный бенчмарк
StealthMark от Stealth Models - ещё один независимый тест на оригинальных задачах, к которым модели не могли подготовиться: точные инструкции держат в секрете, результаты оценивают вслепую и засчитывают каждую неудачу. Проверяют физическое и пространственное мышление, планирование на много шагов вперёд и умение превращать идею в точное изображение. В текущей версии 1.8.5 - 8 тестов и 52 модели.
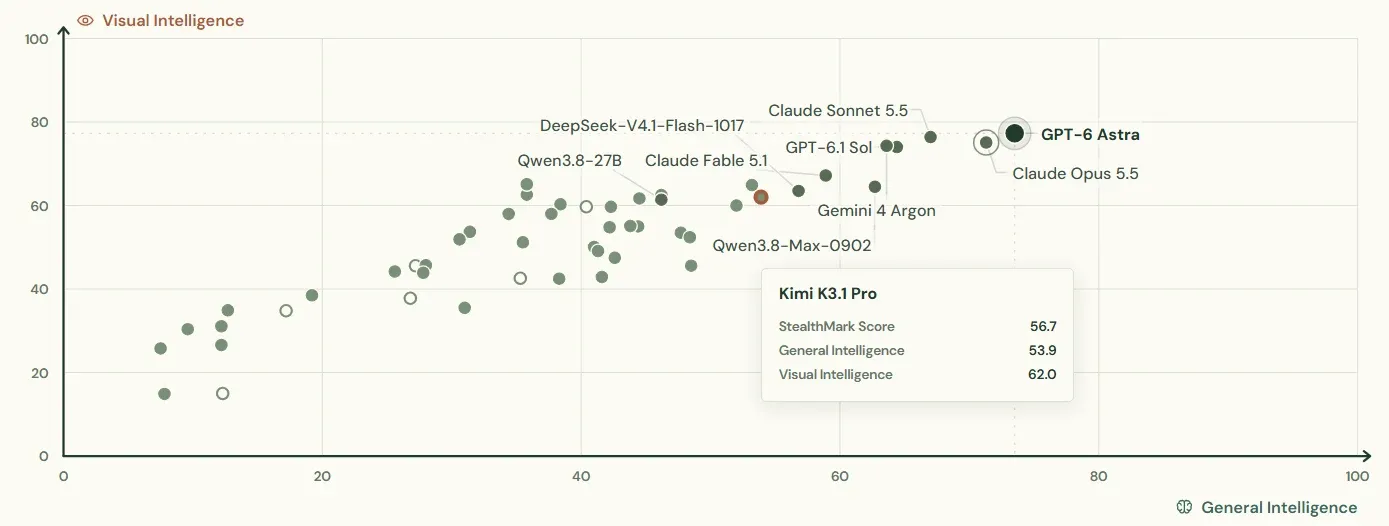
Источник: StealthMark, 23 октября 2026.
Kimi K3.1 Pro здесь 11-я из 52 с 56,7 балла: 53,9 за общий интеллект и 62,0 за визуальный. Впереди GPT-6 Astra (74,8), Claude Opus 5.5 (72,7) и Claude Sonnet 5.5 (70,3) - и снова DeepSeek V4.1 Flash, у которой 59,2. Прошлая Kimi K3 набрала 50,7 и стоит 15-й.
Как встретили релиз и вторая ложка дёгтя
Первые сутки после релиза модель активно обсуждали в профильных сообществах. Собрал главное из отзывов:
- Лимиты и очереди. Сообщают, что подписки на $100 хватает примерно на час обычной работы, а пятичасовое окно в Kimi Code заканчивается за 10 минут. Ещё одна жалоба - на новых моделях Kimi в любое время суток «час пик» и очередь. Даже не пытайтесь воспользоваться Кими на бесплатном тарифе - аналогичная проблема, что и с предыдщей версией, у меня так и не получилось ниразу вступить с ней в диалог, сервера перегружены.
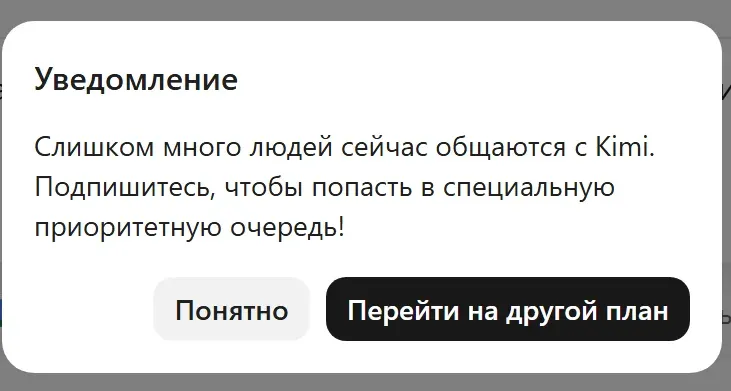
Автор статьи так и не смог попробовать Kimi K3.1 через веб-интерфейс.
-
Скепсис к цифрам Moonshot. Самая частая реакция - подозрение, что модель «натаскали на тесты». Конкретный довод: Moonshot опирается на старую версию Humanity's Last Exam, где много ошибочных заданий. В очищенной версии HLE-Diamond, по таблице самой Moonshot, у K3.1 Pro 39,4 против 60,9 у Opus 5.5. Замеры Bug Hunt Bench показывают, что скепсис оправдан: на настоящих ошибках в рабочих проектах модель исправила 36 из 105 - меньше, чем Opus 5.5, Fable 5.1 и даже DeepSeek V4.1 Flash, хотя в тестах Moonshot она шла почти вровень с Opus.
-
«Неровная» модель. Часть сообщества считает, что китайские модели сильны там, где хорошо смотрятся демо, - во фронтенде и 3D, - и проседают в остальном. Это совпадает с цифрами: в Terminal-Bench Science у K3.1 Pro 38,1 против 68,1 у GPT-6 Astra.
-
Есть и хорошие отзывы. Автор своего бенчмарка на программирование пишет, что K3.1 Pro набирает столько же, сколько Claude Fable 5.1, а главная разница - в скорости. В обсуждении много говорят и о том, что после выхода весов это станет новой планкой для открытых моделей.
Детали релиза Kimi K3.1 Pro
Две важные детали. Первая: K3.1 Pro - это дообученная K3, а не новая модель, так что прирост получен на той же основе. Вторая: Moonshot сразу выпустила быструю версию. Kimi K3 была практически неюзабельной в бесплатном режиме из-за больших очередей и медленных ответов, и если Highspeed это исправит, разница для пользователя будет заметнее любого прироста в тестах.
Moonshot называет K3.1 Pro первой моделью серии K3.1 и своей самой сильной моделью с открытыми весами. По словам компании, это Kimi K3, которую дообучили с заметно большими вычислительными затратами на постобучение.
| Параметр | Kimi K3.1 Pro | Kimi K3 |
|---|---|---|
| Основа | Kimi K3 после дополнительного обучения | новое поколение после Kimi K2.6 |
| Архитектура | Mixture of Experts, 2,8 трлн параметров, из них 104 млрд активных | Mixture of Experts, 2,8 трлн параметров, из них 104 млрд активных |
| Контекст | 1 048 576 токенов | 1 048 576 токенов |
| Ответ | по умолчанию до 131 072 токенов | по умолчанию до 131 072 токенов |
| Что принимает | текст, картинки, видео | текст, картинки, видео |
| Режим размышлений | включён всегда, уровни low, high и max, по умолчанию max | включён всегда, уровни low, high и max, по умолчанию max |
| Версии | Pro и Pro Highspeed, вторая в 2-3 раза быстрее | одна версия, без быстрой |
| Открытые веса | обещаны до 4 ноября 2026, лицензию пока не назвали | опубликованы на Hugging Face, лицензия с ограничениями для коммерческого использования |
Mixture of Experts - устройство модели, при котором на каждый запрос работает только часть параметров. Поэтому у модели на 2,8 трлн параметров в ответе участвует примерно 104 млрд.
Отключить размышления нельзя: запрос без них API вернёт с ошибкой. Если нужен ответ побыстрее, Moonshot советует ставить уровень low.
Модель уже доступна на Kimi.ai, в приложениях Kimi для iOS, Android и HarmonyOS, в настольном Kimi Work, в Kimi Code и через API. В Kimi Code K3.1 Pro открыта с тарифа Plus, а контекст в 1 млн токенов и версия Highspeed - с тарифа Pro. Highspeed при этом расходует примерно вдвое больше лимита.
Сильные стороны новой Kimi: игры, 3D и длинные задачи
Moonshot делает упор на три направления.
Игры целым проектом. По словам компании, K3.1 Pro уверенно работает с игровыми движками Unity, Unreal Engine и Godot - не отдельными скриптами, а проектом целиком.
Источник видео: техблог Kimi K3.1 Pro, 23 октября 2026.
Параметрическое 3D-моделирование. Это когда модель строится не руками, а кодом с параметрами: поменял число - изменилась деталь. K3.1 Pro пишет и запускает скрипты для Blender и CAD-программ сама, без MCP-коннекторов - готовых модулей, через которые модель обычно подключают к сторонним программам.
Источник видео: техблог Kimi K3.1 Pro, 23 октября 2026.
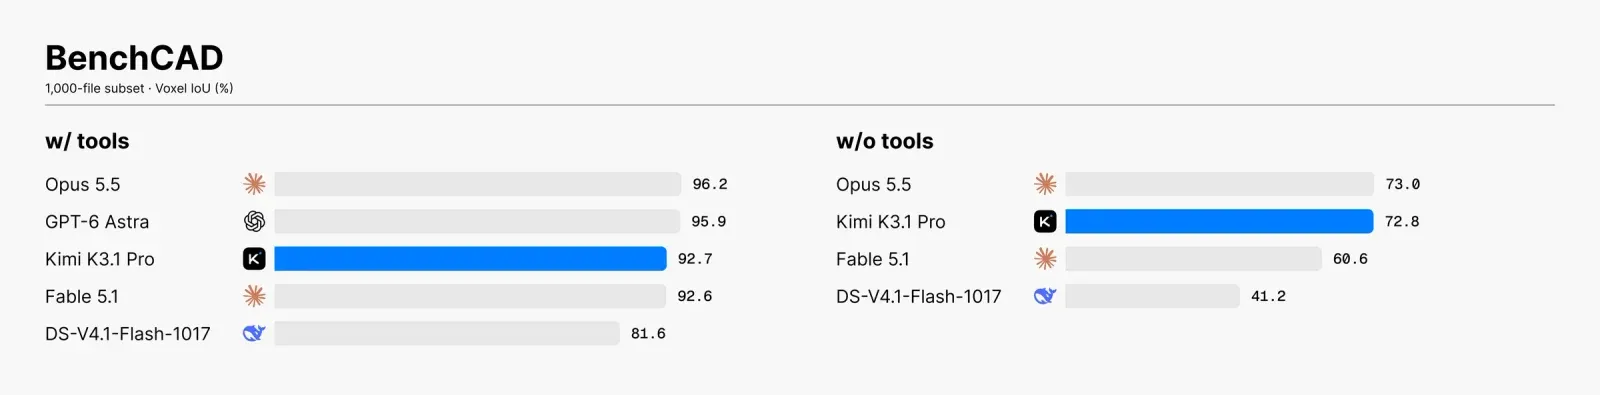
В тесте BenchCAD модель по картинкам с нескольких ракурсов восстанавливает 3D-деталь, а результат сравнивают с оригиналом. С инструментами K3.1 Pro третья, а без инструментов отстаёт от Claude Opus 5.5 всего на 0,2 пункта и обходит Claude Fable 5.1 на 12.
Вместе с моделью на kimi.ai и в приложении Kimi запустили функцию 3D Make: 3D-модель можно посмотреть и отредактировать прямо в браузере, а потом скачать в готовом для 3D-печати виде.
Длинные задачи. В качестве примера Moonshot дала модели собрать симулятор ходьбы на human-atlas - открытой анатомической модели человека из 296 элементов скелета, включая хрящи, и 402 мышц. За 167 заданий и 420 независимых проверок K3.1 Pro довела симулятор до непрерывной ходьбы со сменой шагов в течение 11,2 секунды, а в расчётах плечевых мышц нашла и исправила 36 ошибок.
Источник видео: техблог Kimi K3.1 Pro, 23 октября 2026.
Что показывают тесты Moonshot
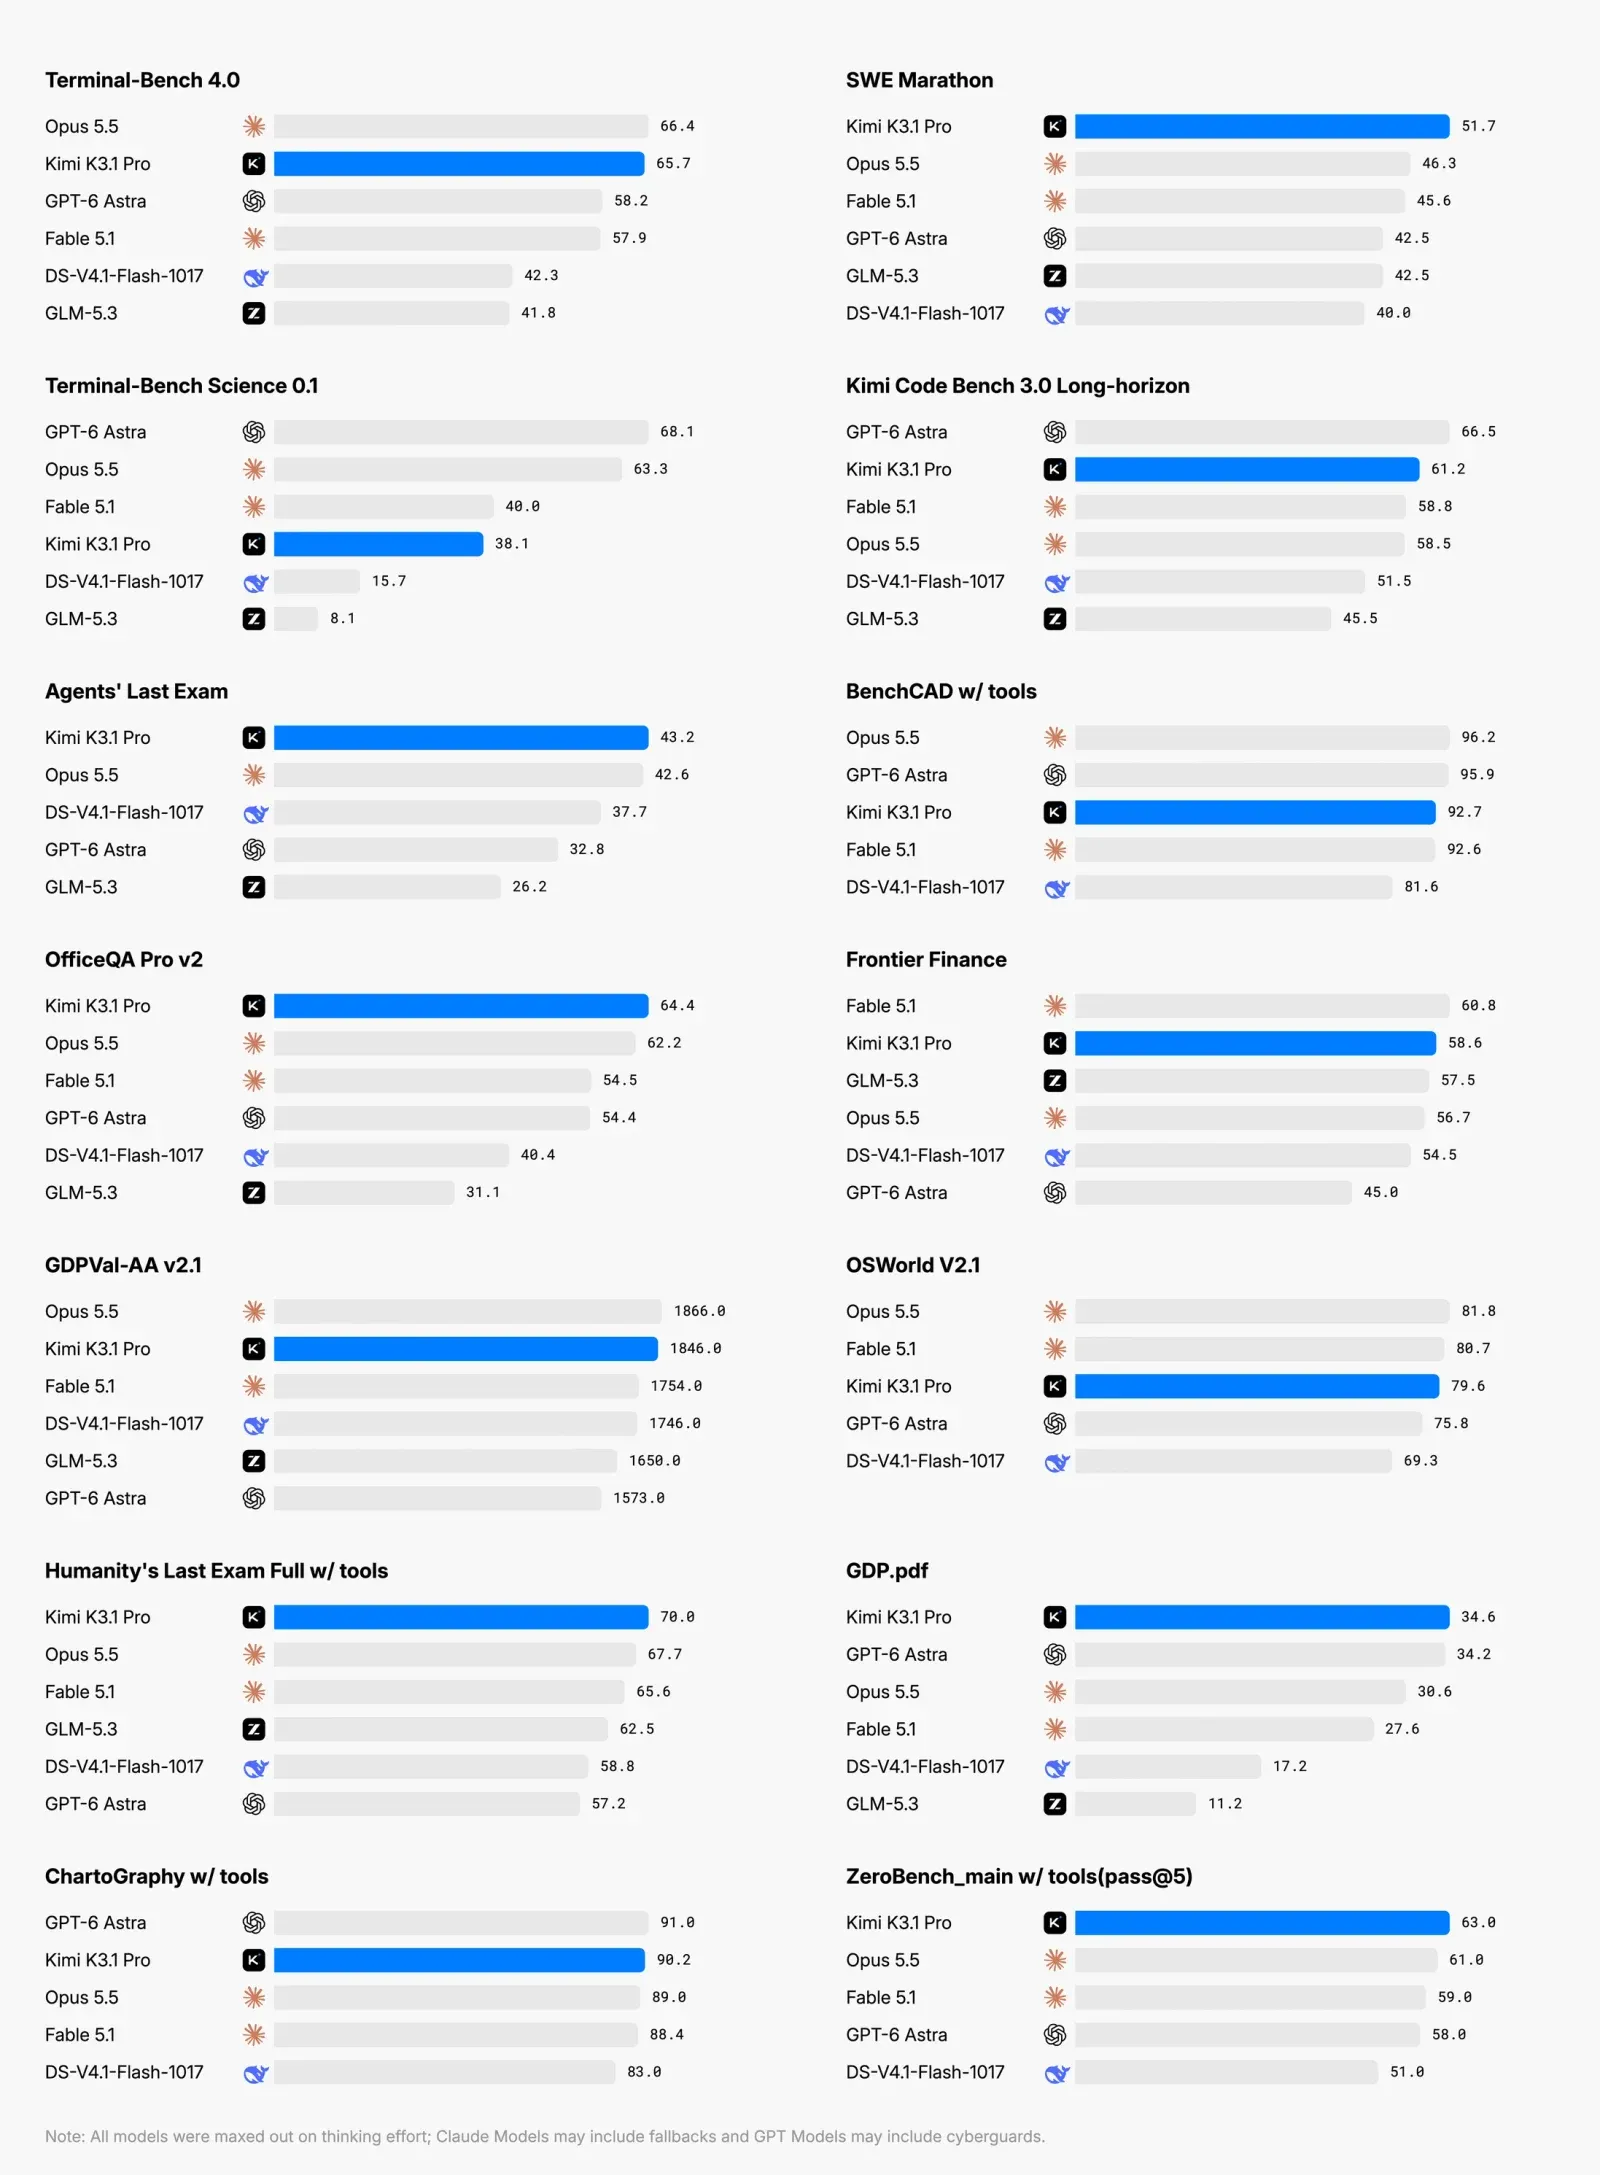
Источник графика: техблог Kimi K3.1 Pro, 23 октября 2026.
Moonshot сравнила K3.1 Pro с Claude Opus 5.5, GPT-6 Astra, Claude Fable 5.1, DeepSeek V4.1 Flash и GLM-5.3 на 14 тестах. Всем моделям выставили максимальный уровень размышлений. Все 14 результатов против трёх ближайших соперников - в таблице под катом.
Показать табличные данные
| Тест | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65,7 | 66,4 | 58,2 | 57,9 |
| SWE Marathon | 51,7 | 46,3 | 42,5 | 45,6 |
| Kimi Code Bench 3.0 Long-horizon | 61,2 | 58,5 | 66,5 | 58,8 |
| Terminal-Bench Science 0.1 | 38,1 | 63,3 | 68,1 | 40,0 |
| Humanity's Last Exam с инструментами | 70,0 | 67,7 | 57,2 | 65,6 |
| Agents' Last Exam | 43,2 | 42,6 | 32,8 | - |
| OSWorld V2.1 | 79,6 | 81,8 | 75,8 | 80,7 |
| OfficeQA Pro v2 | 64,4 | 62,2 | 54,4 | 54,5 |
| Frontier Finance | 58,6 | 56,7 | 45,0 | 60,8 |
| GDPval-AA v2.1, рейтинг | 1846 | 1866 | 1573 | 1754 |
| BenchCAD с инструментами | 92,7 | 96,2 | 95,9 | 92,6 |
| BenchCAD без инструментов | 72,8 | 73,0 | - | 60,6 |
| ChartoGraphy с инструментами | 90,2 | 89,0 | 91,0 | 88,4 |
| GDP.pdf | 34,6 | 30,6 | 34,2 | 27,6 |
| ZeroBench с инструментами, pass@5 | 63,0 | 61,0 | 58,0 | 59,0 |
Первой K3.1 Pro стоит в шести тестах: SWE Marathon, Humanity's Last Exam, Agents' Last Exam, OfficeQA Pro v2, GDP.pdf и ZeroBench. В Terminal-Bench 4.0 (задачи в командной строке), OSWorld (работа за компьютером через интерфейс) и GDPval (рабочие задачи разных профессий) она отстаёт от Opus 5.5 на 0,7-2,2 пункта или 20 очков рейтинга.
Финансы и офисная работа
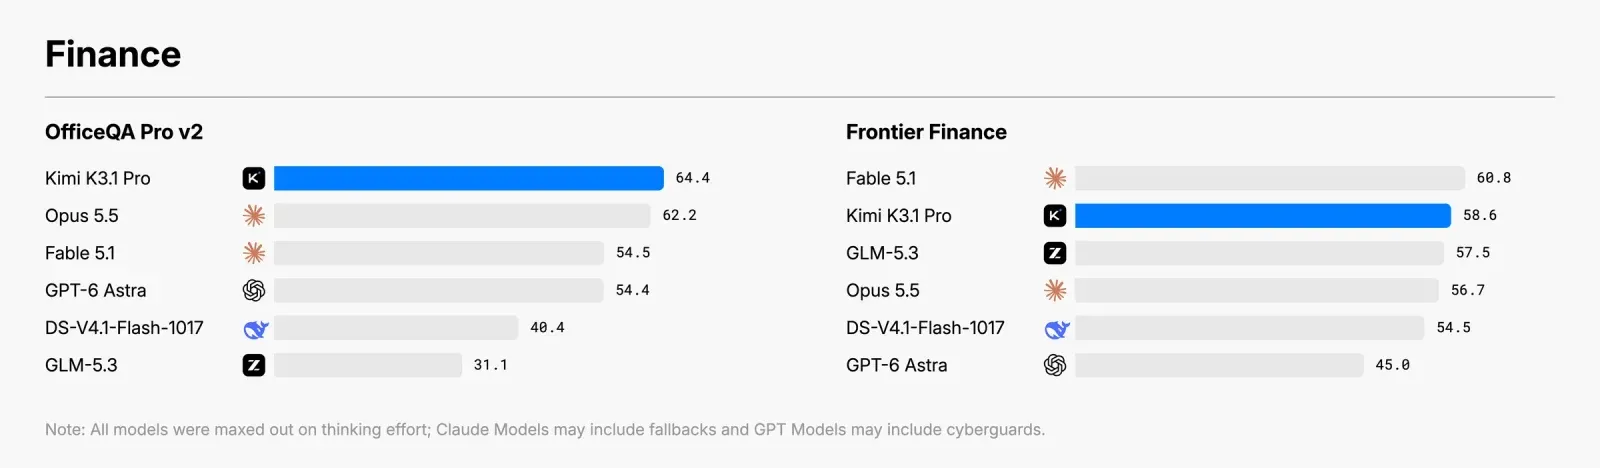
В открытом тесте OfficeQA Pro v2 (вопросы по офисным документам) K3.1 Pro первая с 64,4, в Frontier Finance - вторая с 58,6 после Claude Fable 5.1.
Меньше выдуманных фактов
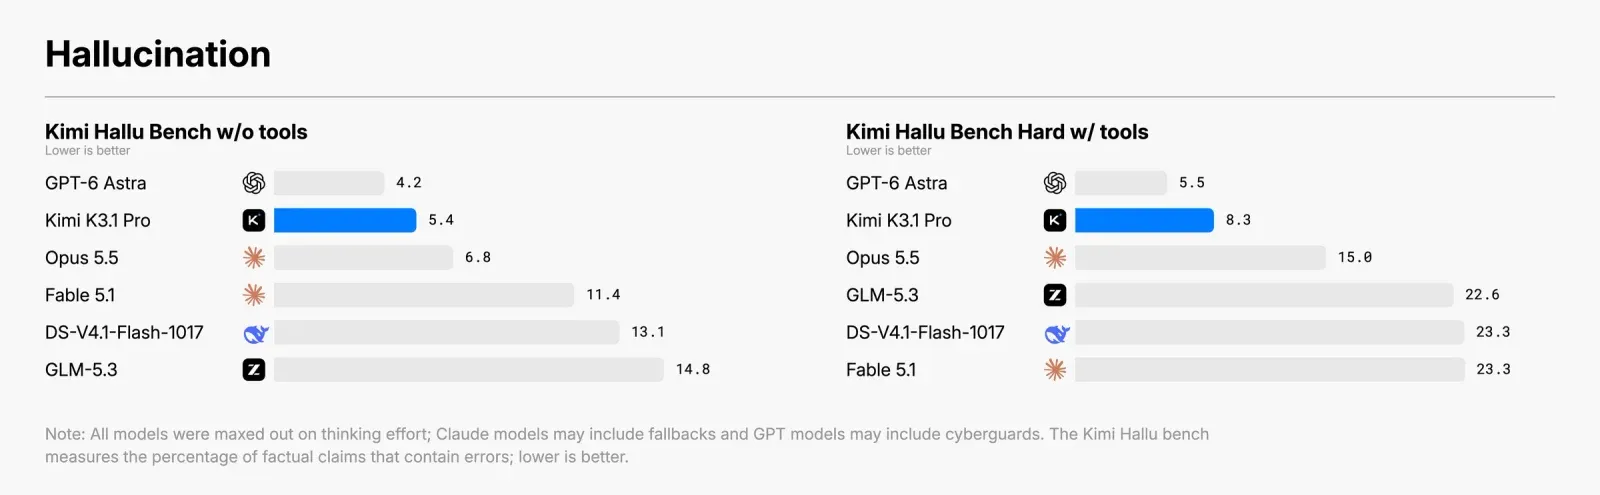
На своём стресс-тесте Kimi Hallu Bench Hard Moonshot считала, какая доля утверждений в ответах оказалась ложной. У K3 таких было 23,4%, у K3.1 Pro - 8,3%. Для сравнения, у Claude Opus 5.5 в том же тесте 15,0%, у GPT-6 Astra 5,5%.
Сама Moonshot оговаривается, что тест специально собран из трудных примеров и эти проценты не равны частоте ошибок в обычной работе.
Кибербезопасность урезали намеренно
Из обучения открытой версии Moonshot убрала данные по кибербезопасности: открытые веса, по словам компании, не должны сдвигать границу того, что модели умеют во взломе. В тесте xdev-bench-hard версия без такой чистки набирала 90,5, а финальная K3.1 Pro - 81,0, ниже закрытых моделей вроде GPT-5.6 Sol со 100.
Сколько стоит одна задача
Для выбора модели самый полезный график Moonshot - результат в Terminal-Bench 4.0 против средней стоимости одной задачи. Результаты и стоимость для всех моделей, кроме DeepSeek, взяты с tbench.ai, сайта самого теста, а для DeepSeek - с Artificial Analysis.
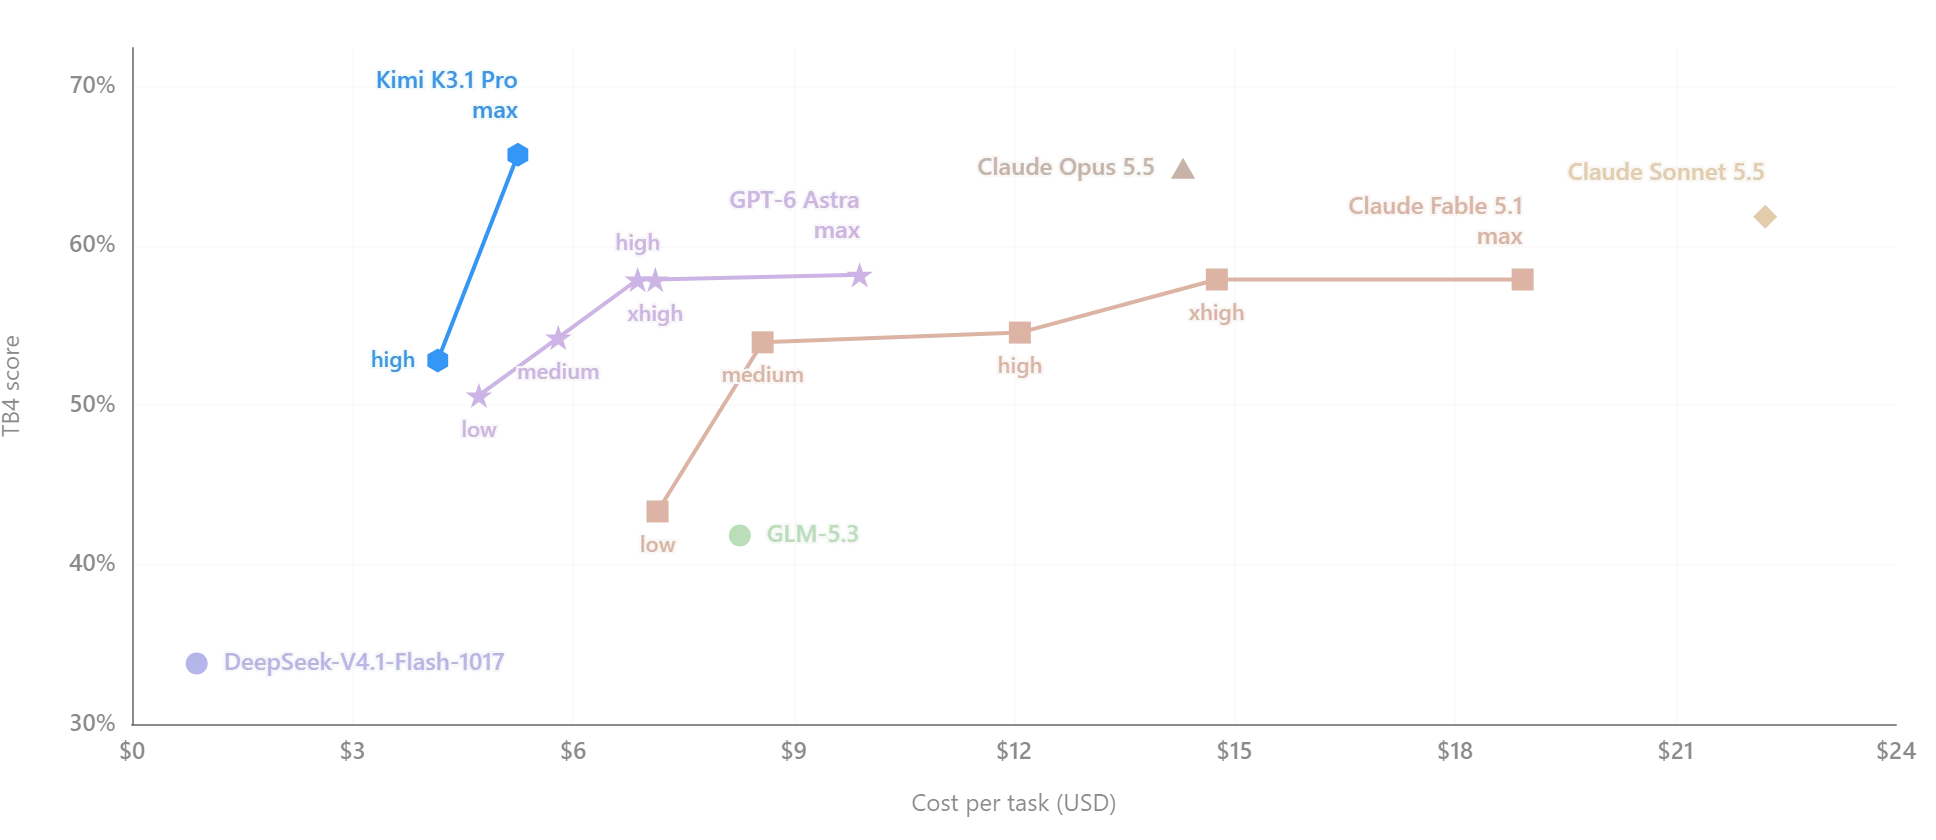
Показать табличные данные
| Модель | Уровень размышлений | Результат | Стоимость задачи |
|---|---|---|---|
| Kimi K3.1 Pro | max | 65,7% | $5,25 |
| Kimi K3.1 Pro | high | 52,8% | $4,16 |
| Claude Opus 5.5 | max | 64,85% | $14,30 |
| Claude Sonnet 5.5 | max | 61,82% | $22,22 |
| GPT-6 Astra | max | 58,18% | $9,90 |
| GPT-6 Astra | high | 57,88% | $6,88 |
| GPT-6 Astra | low | 50,61% | $4,72 |
| Claude Fable 5.1 | xhigh | 57,88% | $14,76 |
| Claude Fable 5.1 | max | 57,88% | $18,92 |
| GLM-5.3 | - | 41,82% | $8,27 |
| DeepSeek V4.1 Flash | - | 33,8% | $0,88 |
На максимальном уровне K3.1 Pro набирает даже чуть больше Claude Opus 5.5 - 65,7% против 64,85%, а задача обходится в 2,7 раза дешевле: $5,25 против $14,30. GPT-6 Astra на максимуме стоит почти вдвое дороже и набирает на 7,5 пункта меньше.
Экономить на уровне размышлений здесь невыгодно. На high задача дешевле всего на $1,09, а результат падает с 65,7% до 52,8% - ниже, чем у GPT-6 Astra на high.
В сводном графике у Opus 5.5 стоит 66,4%, а здесь 64,85%: значения из сводки Moonshot и с tbench.ai расходятся.
Чего пока нет
- Открытых весов. Их обещают до 4 ноября, лицензию не назвали. Веса Kimi K3 вышли с ограничениями для коммерческого использования.
- Подтверждения про Kibitz. Анонимную модель на Arena сообщество считало K3.1, но ни Moonshot, ни Arena этого не подтверждали.
Как итог - что релиз Kimi K3.1 Pro значит для обычных пользователей
Если коротко: K3.1 Pro - сильная модель и большой шаг вперёд для Kimi, но не замена Opus 5.5. В тестах Moonshot она идёт почти вровень с Opus, а в независимых замерах отстаёт: 55 против 58 в индексе Artificial Analysis, 36 против 41,7 исправленных ошибок в Bug Hunt Bench. Дальше - по задачам.
Kimi K3.1 Pro не стала лидером ни в одном из независимых бенчмарков, а в ряде тестов проиграла даже гораздо более дешевой DeepSeek V4.1 Flash. Несмотря на хорошие результаты, многие настроены скептически к использованию Kimi в своих задачах из-за быстрого "съедания" лимитов и в целом не низкой цены за задачу (особенно для китайских моделей).
- Агентное программирование на реальных проектах. Здесь я бы пока остался на Opus 5.5 или Sonnet 5.5. В Bug Hunt Bench K3.1 Pro исправила меньше ошибок, чем все топовые модели, а в Agent Arena она только одиннадцатая. Если нужна дешёвая открытая модель для кода, DeepSeek V4.1 Flash в том же Bug Hunt справилась лучше и в 7,5 раза дешевле.
- Сайты, лендинги и 3D. Это сильная сторона новой Kimi, и её стоит попробовать. В WebDev на Arena она восьмая, на уровне Claude Opus 5, а в задачах по бренду и маркетингу - седьмая. В 3D-моделировании без инструментов она отстаёт от Opus 5.5 на 0,2 пункта.
- Финансы и офисные документы. Тоже рабочий вариант: в финансовом индексе Artificial Analysis K3.1 Pro делит второе-третье место с Sonnet 5.5, а в тесте Moonshot по офисным документам стоит первой.
- Научные задачи. Не лучший выбор: в Terminal-Bench Science она набирает почти вдвое меньше GPT-6 Astra.
Отдельно о скорости и деньгах. K3.1 Pro вдвое быстрее K3, но по рынку это всё ещё середина, и отвечает она многословно - на прогон индекса Artificial Analysis ушло в 1,7 раза больше токенов, чем у средней модели. При этом задача в Terminal-Bench 4.0 у неё стоит в 2,7 раза меньше, чем у Opus 5.5.
Подвоха я вижу два. Первый - лимиты и очереди: подписка быстро заканчивается, а в бесплатной версии модель сейчас не дождаться. Второй - стабильность на длинных задачах: в Bug Hunt Bench модель на 128 тысячах токенов контекста начала выдавать бессвязный текст, хотя заявленный контекст - 1 млн.
Самое интересное, на мой взгляд, будет 4 ноября, когда выйдут веса. Если Moonshot выполнит обещание, это станет самой сильной открытой моделью, которую можно развернуть у себя, и вот тогда соотношение цены и качества может стать по-настоящему выгодным. А места на Arena пока предварительные, так что окончательные выводы я бы делал через неделю-две и после тестов на своих задачах.
Как K3.1 всплывала до релиза
Название K3.1 несколько недель всплывало в утечках, а в день релиза Moonshot сама его показала в ролике.
- 19 сентября. На подтверждённом аккаунте Kimi в Zhihu, китайской площадке вопросов и ответов, вышел пост без подписи: длинная цепочка цифр числа π после «3.1». Сообщество прочитало это как намёк на версию 3.1.
- Конец сентября. По сообщениям, в API Moonshot заметили идентификатор «kimi-k3-1».
- 21 октября. LuminaBench, автор новостей и бенчмарков в X, нашёл в Kimi Code правило переключения модели с адресом «k3.1».
- 22 октября. В батлах Code Arena, где пользователь не знает, какую модель получит, появилась анонимная модель Kibitz. Сообщество связало её с Kimi: по данным AGTP, она искажала служебные токены Moonshot так же, как другие модели Kimi, а прошлые Kimi шли на Arena под похожими именами - Kiwido, Kiwire, Kivine.
- 23 октября, 04:41 МСК. Официальный аккаунт Kimi выложил 24-секундный ролик, где в терминале Kimi Code видна строка «Model: Kimi K3.1».
- 23 октября, 07:46 МСК. Arena написала, что скоро выйдет новая модель Moonshot.
- 23 октября, 20:15 МСК. Релиз K3.1 Pro.
До релиза LuminaBench выложил несколько роликов, которые, по его словам, сделаны на K3.1 под именем Kibitz. Самый наглядный - воксельная пагода рядом с работами других моделей. Это один промпт и одна попытка, так что как сравнение моделей ролик не стоит воспринимать.
Источник видео: @LuminaBench в X, 22 октября 2026.
Источники
- Kimi K3.1 Pro Tech Blog: Advancing Open Intelligence, 23.10.2026 - официальный анонс, 14 тестов, галлюцинации, кибербезопасность.
- Kimi.ai в X: релиз K3.1 Pro, 23.10.2026 - 2,8 трлн параметров, 104 млрд активных, контекст.
- Kimi K3.1 Pro quickstart - режим размышлений, длина ответа, ввод картинок и видео.
- Kimi K3 quickstart - характеристики K3 для сравнения: длина ответа, режим размышлений, ввод.
- Цены Kimi API - тарифы K3.1 Pro и Highspeed.
- Модели в Kimi Code - тарифы, контекст и расход лимита.
- Kimi.ai в X: ролик с «Model: Kimi K3.1», 23.10.2026.
- Arena.ai в X: Kimi K3.1 Pro на 8-м месте в Code Arena: WebDev, 23.10.2026 - 1692 очка, уровень Claude Opus 5 (Max).
- Arena.ai в X, 23.10.2026 - «A new model from @Kimi_Moonshot is coming».
- ChainCatcher: ролик Kimi и предыстория K3.1, 23.10.2026 - идентификатор «kimi-k3-1» в API.
- LuminaBench: Kimi K3.1 looks to be getting close, 21.10.2026 - упоминание K3.1 в Kimi Code.
- AGTP в X: загадочная модель Kibitz на Arena, 22.10.2026 - токенизатор и кодовые имена.
- Kimi K3.1 Pro на Artificial Analysis - общий и отраслевые индексы, скорость, стоимость задачи.
- Bug Hunt Bench, 23.10.2026 - 105 спрятанных ошибок в двух проектах, три запуска Kimi K3.1 Pro; методика и сырые данные.
- StealthMark, 23.10.2026 - оригинальные задачи на физическое и пространственное мышление, планирование и визуальные навыки.
- Kimi K3 на Artificial Analysis - скорость и лицензия K3.