
9 ноября 2026 года Anthropic представила Claude Fable 5.2 и Claude Mythos 5.2 - обновлённые модели для сложного программирования, научных исследований и автономной работы ИИ-агентов. Компания заявляет о значительном росте интеллектуальных возможностей, ускорении генерации до 30% и снижении стоимости API на 20%. Claude Fable 5.2 уже доступна в России без банов и ограничений в GPTunnel.
Давайте посмотрим данные независимых бенчмарков, а также оценим первю реакцию сообщества на релиз (сразу после бенчмарков).
Главное о Claude Fable 5.2
- Лидер независимых бенчмарков, но не по экономической эффективности. Fable 5.2 показала лучшие результаты среди сравниваемых моделей в GDPx, Artificial Analysis, Vals и предварительной оценке WebDev Arena. Однако преимущества не всегда оправдывают стоимость: Gemini 4 Carbon обеспечивает близкие результаты в нескольких тестах при значительно меньших расходах, а в Vals Fable сама оказывается дешевле Opus 5.5.
- Сильнее в программировании, логике и визуальном анализе. Anthropic отмечает улучшение способности модели решать сложные инженерные задачи, рассуждать и работать с визуальной информацией. Fable 5.2 лучше понимает неоднозначные инструкции, самостоятельно исправляет ошибки и доводит длительные проекты до результата.
- Неожиданные недостатки повышенной автономности. В официальном руководстве Anthropic признаёт, что Fable 5.2 иногда преждевременно завершает задачи, слишком буквально следует инструкциям, вносит нежелательные изменения в код и чрезмерно использует вспомогательных агентов. Специальные настройки позволяют сократить число незавершённых задач примерно вдвое, но увеличивают расход токенов на 30%. При этом максимальные уровни вычислительных усилий далеко не всегда оправдывают дополнительные затраты.
- Управление командами ИИ-агентов. Модель может выступать координатором: распределять задачи между сотнями и тысячами вспомогательных агентов, проверять результаты и объединять их в готовое решение.
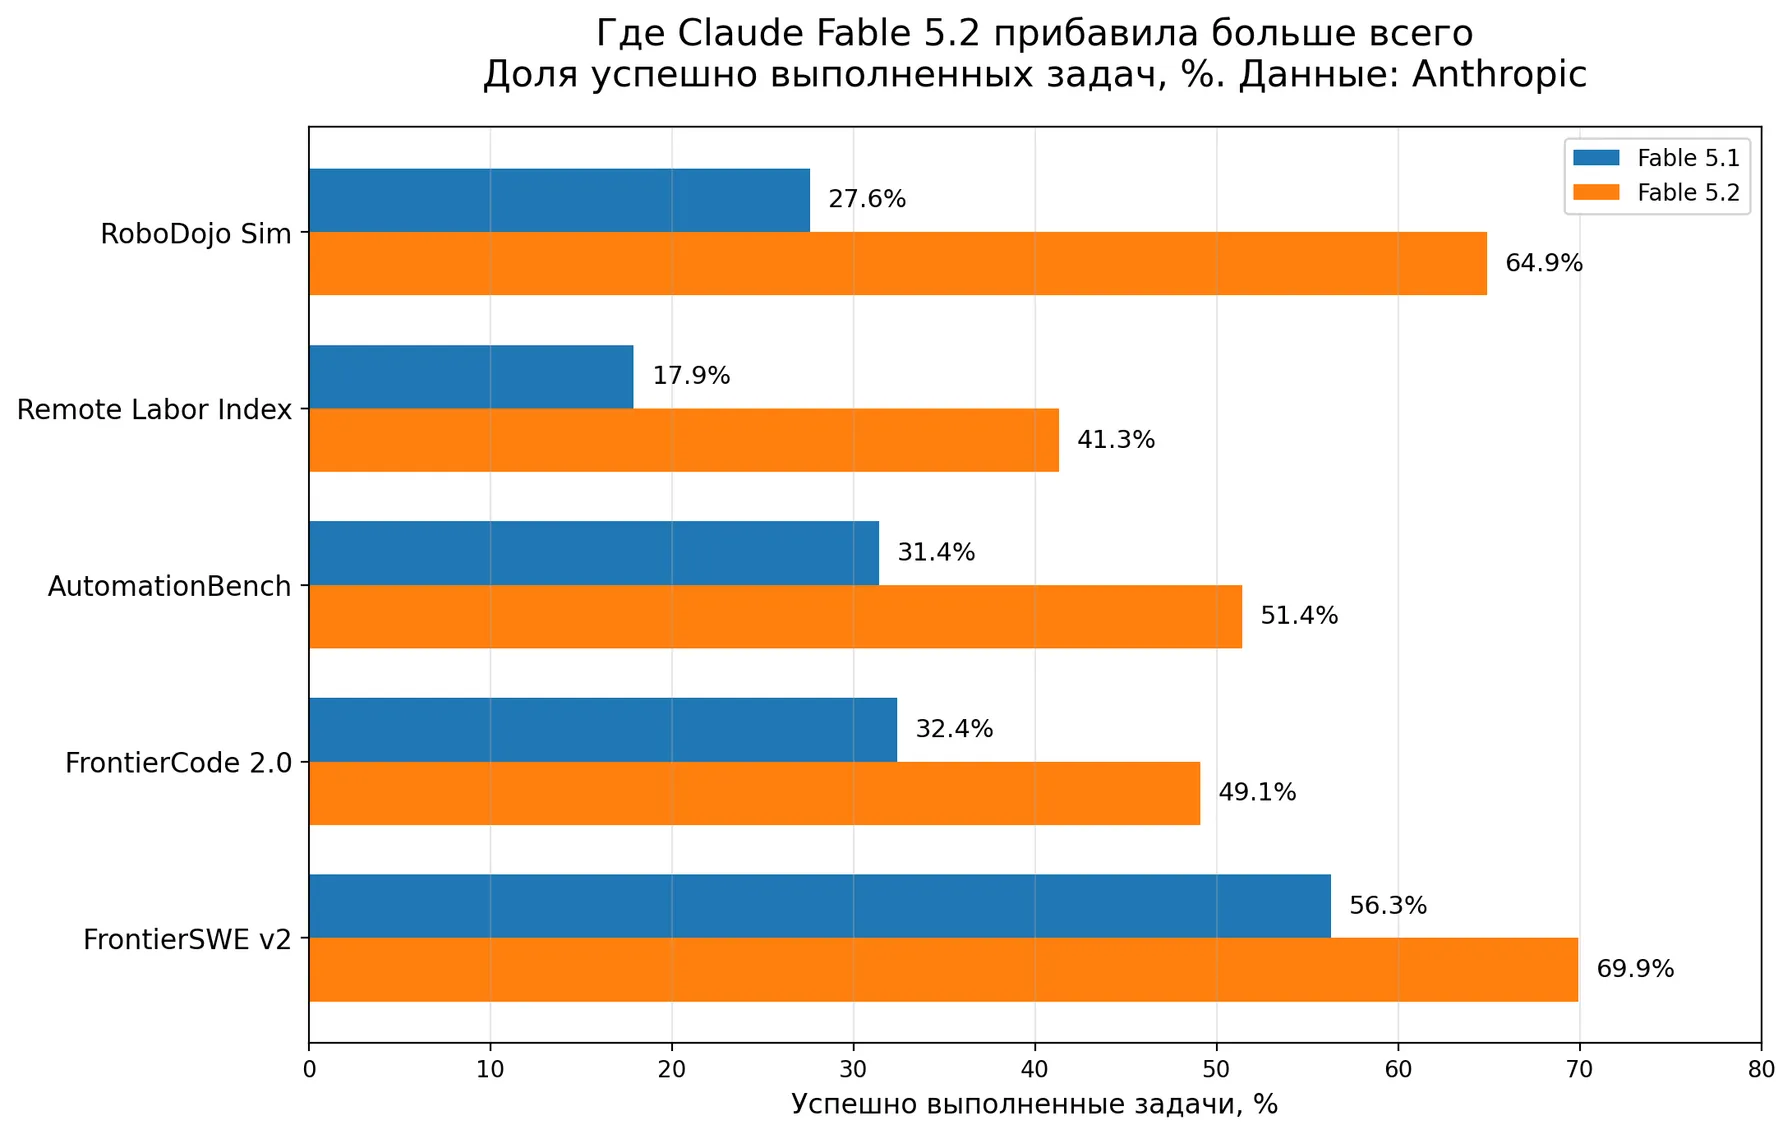
- Самый заметный рост в бенчмарках. В сравнении с Fable 5.1 результат RoboDojo Sim вырос с 27,6% до 64,9%, Remote Labor Index - с 17,9% до 41,3%, BenchCAD 2.1 - с 44,4 до 83,5 балла, а FrontierCode 2.0 - с 32,4% до 49,1%. Это результаты тестирования, опубликованного Anthropic.
- Быстрее и дешевле. Генерация ответов ускорилась до 30%, а стоимость API снизилась на 20%. Дополнительный режим Fast ускоряет генерацию до 2,5 раза.
- Создание операционной системы с нуля. Fable 5.2 координировала более 1000 ИИ-агентов, которые за восемь дней разработали работающий прототип ОС с собственным ядром, драйверами, файловой системой и графическим интерфейсом.
- Решение двух открытых задач теоретической физики. По заявлению Anthropic, модель получила два новых результата, связанных с физикой чёрных дыр и квантовой гравитацией. Исследования опубликованы в виде научных препринтов.
- Формализация Великой теоремы Ферма за 30 часов. Команда из примерно 1000 агентов перевела известное математическое доказательство в формальный вид на языке Lean, допускающий компьютерную проверку. Предыдущий эксперимент потребовал 11 дней.
- Разработка трёх электронных устройств. По заданию Anthropic модель спроектировала голосовой хаб, USB-спикерфон и виртуального питомца: подготовила схемы печатных плат, корпуса и программное обеспечение. Все три устройства заработали без доработки электрических схем.
- Ускорение программного обеспечения и управление роботами. Модель помогла перенести производственный сервис с Python на Rust, ускорив его запуск примерно в 26 раз. Также продемонстрировала управление роботами, выполняющими физические действия, включая сборку кубика-головоломки.
- От игровой приставки до самостоятельного бизнеса и научных исследований. В независимых испытаниях профессора Итана Моллика Fable 5.2 превратила USB-клавиатуру в игровую консоль с шестью играми, разработала бизнес-проект на основе данных 201 муниципального органа власти, подготовила научное исследование объёмом 182 страницы и создала более 450 интерактивных 3D-миров с помощью тысяч ИИ-агентов.
- Главное ограничение - недостаточная самостоятельная оценка результатов. Модель способна выполнять сложные проекты, но не всегда понимает, когда её работа становится избыточной или некачественной. В эксперименте Моллика команда агентов создала бюрократическую систему из 204 разделов правил, которая начала тормозить разработку. На Hacker News также появились сообщения о чрезмерном расходовании лимитов и нарушении заданных ограничений на количество агентов.
Независимые бенчмарки Claude Fable 5.2: сравнение с Opus 5.5, Astra 6, Fable 5.1 и Gemini 4 Carbon
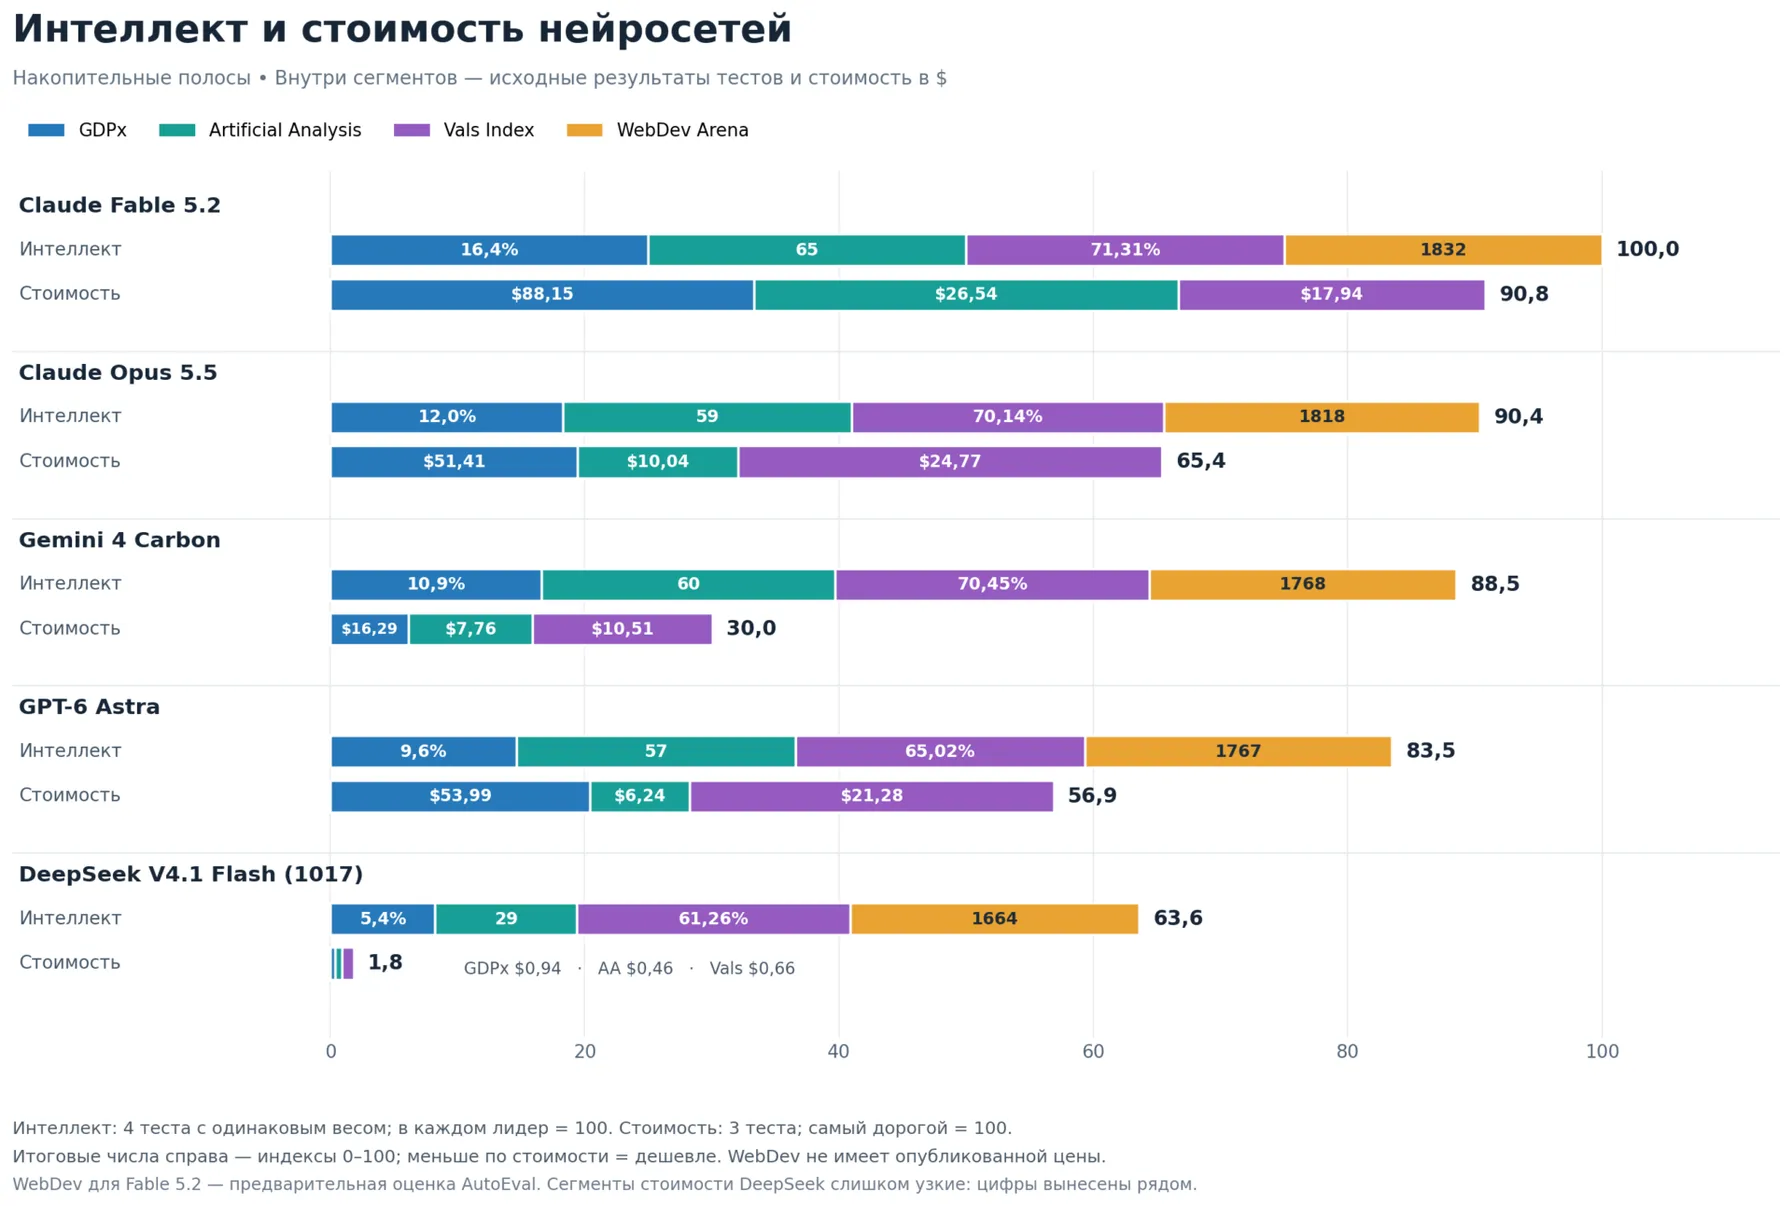
Краткая версия таблицы ниже (DeepSeek приведен для наглядности в качестве дешевой и популярной модели), индекс рассчитывается как среднее результатов относительно лидера каждого бенчмарка:
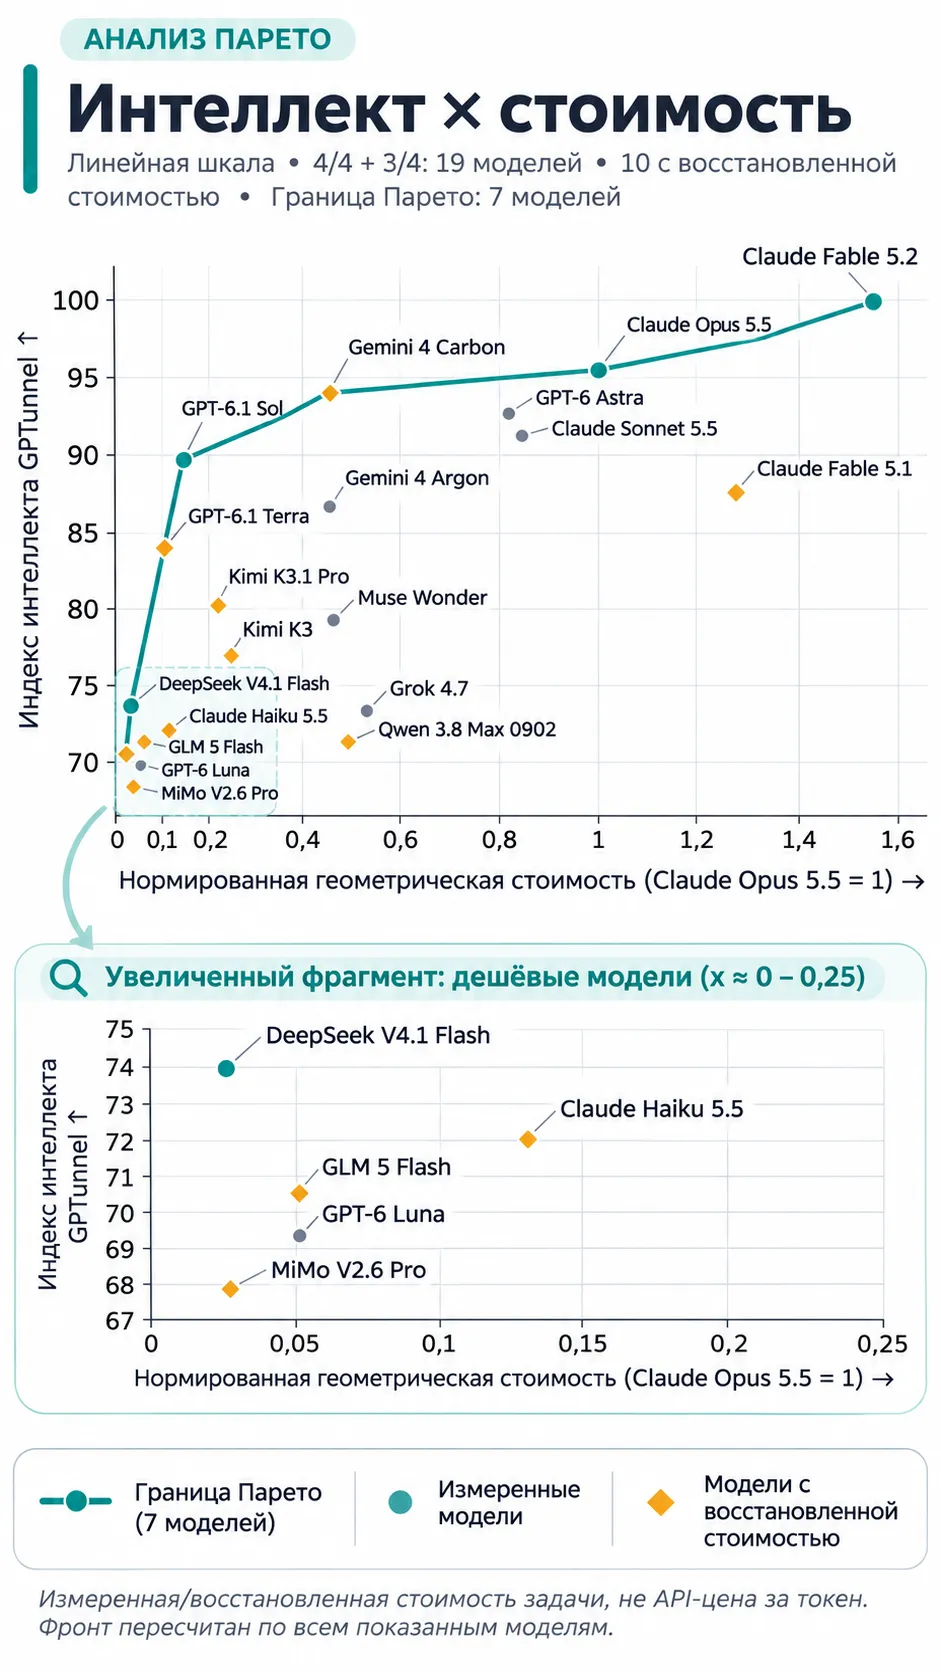
Интеллект и стоимость нейросетей: граница Парето. Индекс интеллекта GPTunnel рассчитан на основе независимых бенчмарков. Стоимость выполнения задач из LiveBench, Artificial Analysis, Vals и GDPx (semianalysis) нормирована относительно Claude Opus 5.5 (её стоимость = 1) и объединена геометрическим средним. Недостающие значения стоимости восстановлены по геометрическому среднему трёх доступных бенчмарков с медианной поправкой, рассчитанной на девяти моделях с полными данными.
В таблице приведены опубликованные результаты шести моделей по независимым тестам на 10 ноября 2026 года. Для каждой модели указаны результат и стоимость по методике соответствующего бенчмарка. Если опубликованного значения нет, стоит «Нет данных».
| Бенчмарк | Fable 5.2 - результат | Fable 5.2 - стоимость, $ | Opus 5.5 - результат | Opus 5.5 - стоимость, $ | GPT-6 Astra - результат | GPT-6 Astra - стоимость, $ | Fable 5.1 - результат | Fable 5.1 - стоимость, $ | Gemini 4 Carbon - результат | Gemini 4 Carbon - стоимость, $ | DeepSeek V4.1 Flash - результат | DeepSeek V4.1 Flash - стоимость, $ |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| GDPx (SemiAnalysis) | 16,4% | 88,15 | 12,0% | 51,41 | 9,6% | 53,99 | 8,5% | 67,16 | 10,9% | 16,29 | 5,4% | 0,94 |
| Artificial Analysis | 65 | 26,54 | 59 | 10,04 | 57 | 6,24 | 49 | 12,99 | 60 | 7,76 | 29 | 0,46 |
| Vals Index v2.2 | 71,31% | 17,94 | 70,14% | 24,77 | 65,02% | 21,28 | Нет данных | Нет данных | 70,45% | 10,51 | 61,26% | 0,66 |
| LiveBench 2.0 | 84,9 | 9,85 | 83,4 | 6,723 | 84,5 | 5,318 | 84,0 | 8,364 | Нет данных | Нет данных | 70,3 | 0,195 |
| Bug Hunt Bench | 58,0 | 139,65 | 41,7 | 58,53 | 45,0 | 33,03 | 43,0 | 87,18 | Нет данных | Нет данных | 42,7 | 1,84 |
| WebDev Arena | 1832* | Нет данных | 1818 | Нет данных | 1767 | Нет данных | 1745 | Нет данных | 1768 | Нет данных | 1664 | Нет данных |
| Epoch Capabilities Index | 174 | Нет данных | 169 | Нет данных | 169 | Нет данных | 167 | Нет данных | Нет данных | Нет данных | Нет данных | Нет данных |
| ARC-AGI-2 | 93,8% | Нет данных | 93,3% | Нет данных | 95,0% | Нет данных | 90,0% | 4,49 | Нет данных | Нет данных | 78,1% | Нет данных |
| ARC-AGI-3 Standard | 81,2% | Нет данных | Нет данных | Нет данных | 62,7% | Нет данных | Нет данных | Нет данных | Нет данных | Нет данных | 0,2% | Нет данных |
| ARC-AGI-3 Provider Adapter | 97,7% | Нет данных | Нет данных | Нет данных | 99,9% | Нет данных | Нет данных | Нет данных | Нет данных | Нет данных | 5,8% | Нет данных |
| GDPval-AA v2.1 | 1831 | Нет данных | 1866 | Нет данных | Нет данных | Нет данных | 1763 | Нет данных | 1733 | Нет данных | 1746 | Нет данных |
Что показало сравнение интеллекта и стоимости нейросетей
Агрегация результатов четырёх независимых бенчмарков - GDPx, Artificial Analysis, Vals Index и WebDev Arena - подтверждает лидерство Claude Fable 5.2. В нашем сводном индексе модель получила 100 баллов, Opus 5.5 - 90,4, Gemini 4 Carbon - 88,5, GPT-6 Astra - 83,5, а DeepSeek V4.1 Flash - 63,6.
Claude Fable 5.2 превосходит Opus 5.5 во всех четырёх рассмотренных бенчмарках, получив 100 против 90,4 балла в нашем сводном индексе интеллекта. При этом Fable существенно дороже в GDPx и Artificial Analysis, но в Vals оказывается не только немного точнее, но и на 28% дешевле.
Наиболее убедительное преимущество Fable 5.2 демонстрирует в сложных профессиональных задачах. В GDPx она опережает Opus 5.5 на 37%, тогда как в Artificial Analysis разница составляет шесть баллов. Однако в Vals и WebDev Arena борьба гораздо плотнее: преимущества новинки невелики, а статистическая неопределённость не позволяет считать её превосходство окончательно установленным.
Главный конкурент по соотношению интеллекта и стоимости - Gemini 4 Carbon. В нашем индексе она уступает Fable 5.2 на 11,5 балла, но выполнение задач обходится существенно дешевле: в 5,4 раза в GDPx и в 3,4 раза в Artificial Analysis. Таким образом, дополнительное качество Fable может быть экономически оправданным для сложных задач, но не обязательно для массового использования.
Интересно, что высокая стоимость Fable не является универсальным правилом. В Vals она превосходит Opus 5.5 по точности и одновременно обходится примерно на 28% дешевле.
На противоположном полюсе находится DeepSeek V4.1 Flash. Модель значительно уступает лидерам в GDPx и Artificial Analysis, зато стоимость выполнения задач может быть в десятки раз ниже. Это делает её потенциально привлекательной для сценариев, где допустимо некоторое снижение качества ради существенной экономии.
Общий вывод: Fable 5.2 предлагает максимальные возможности среди рассмотренных моделей, но за дополнительный интеллект часто приходится платить непропорционально много. При выборе нейросети важно оценивать не только результат теста, но и стоимость его достижения. Для одних задач лучшим вариантом будет Fable, для других - Carbon, Opus или более экономичный DeepSeek.
Данные Anthropic: результаты Claude Fable 5.2 в бенчмарках
Главная новость заключается не в улучшении одного показателя, а в одновременном росте результатов сразу в нескольких категориях.
Сравнение с Fable 5.1 и конкурентами
| Бенчмарк | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| FrontierCode 2.0 | 49,1% | 32,4% | 45,5% | 42,8% | 41,1% |
| FrontierSWE v2 | 69,9% | 56,3% | 62,3% | 65,5% | 61,2% |
| AutomationBench | 51,4% | 31,4% | 42,5% | 41,4% | 53,9% |
| Terminal-Bench-Science 0.1 | 74,6% | 52,6% | 58,7% | 68,1% | 64,8% |
| OSWorld 2.1, частичный набор | 89,3% | 83,5% | 87,2% | 79,5% | 81,5% |
| AA-Briefcase v1.1, rubric | 66,1% | 61,5% | 61,2% | 52,0% | 61,8% |
| Humanity's Last Exam, с инструментами | 74,2% | 65,6% | 67,7% | 57,2% | - |
| Chartography, без инструментов | 73,4% | 44,8% | 64,4% | 71,0% | 72,5% |
В программировании рост особенно заметен. На FrontierCode 2.0 Fable 5.2 получила 49,1% против 32,4% у предыдущей версии - прибавка на 16,7 процентного пункта.
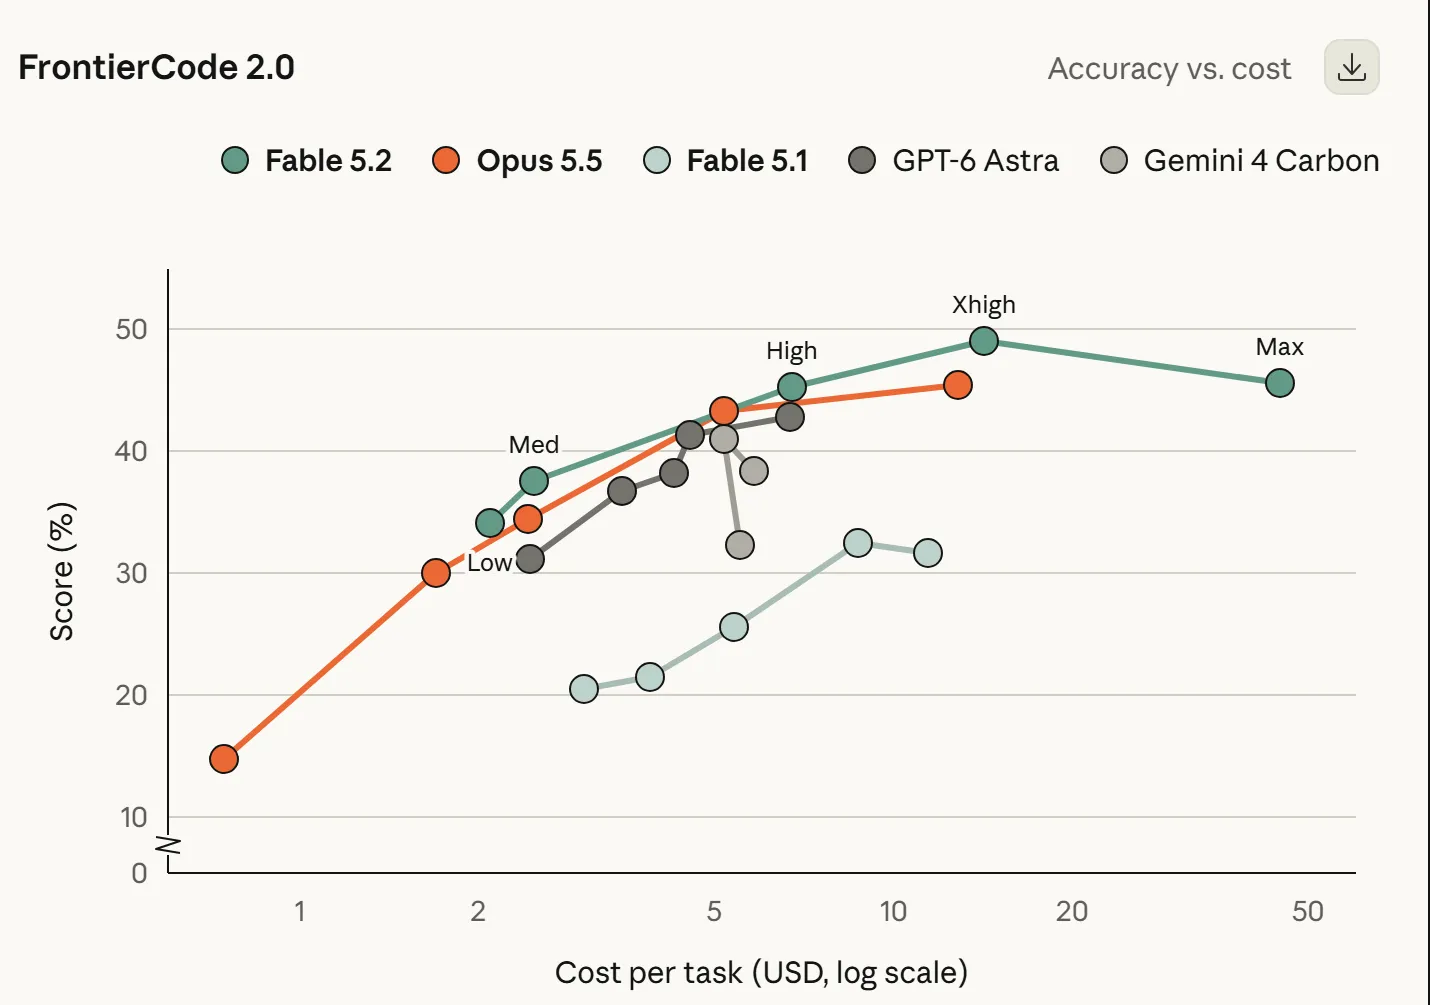
Усилия и эффективность. При средних усилиях (настройка по умолчанию в приложениях Claude и Claude Code) Fable 5.2 может выполнять сложные задачи с меньшим количеством токенов, чем Fable 5.1. В ходе предварительного тестирования на платформе FrontierCode 2.0 Fable 5.2 при высоких усилиях показал результаты примерно на одном уровне с Opus 5.5 при максимальных усилиях, при этом стоимость выполнения задачи была примерно вдвое ниже. При очень высоких усилиях он также показал лучшие результаты среди всех протестированных выпущенных моделей.
На FrontierSWE v2 результат увеличился с 56,3% до 69,9%. Этот тест оценивает решение практических задач программирования и отличается от широко известного SWE-bench Verified.
Однако Fable 5.2 лидирует не везде. В AutomationBench Gemini 4 Carbon получила 53,9% против 51,4% у новинки Anthropic. А в AA-Briefcase, если сравнивать Elo-рейтинг, Opus 5.5 остаётся выше: 1800 против 1785.
В каких направлениях прогресс оказался самым заметным
| Бенчмарк | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|---|---|---|
| WANDR, агентный поиск | 82,1% | 68,7% | 72,3% |
| Remote Labor Index | 41,3% | 17,9% | 21,3% |
| RoboDojo Sim, робототехника | 64,9% | 27,6% | 39,4% |
| BenchCAD 2.1, инженерное проектирование | 83,5 | 44,4 | 65,3 |
| AA-Briefcase, Elo | 1785 | 1669 | 1800 |
Особенно интересен Remote Labor Index - проверка способности ИИ выполнять продолжительные задачи, напоминающие реальную интеллектуальную работу. Fable 5.2 достигла 41,3% против 17,9% у Fable 5.1.
В RoboDojo Sim результат вырос более чем вдвое. Это симуляционная среда, в которой нейросеть управляет роботизированными манипуляторами.
Первые независимые испытания и отзывы сообщества
Итан Моллик: Claude Fable 5.2 почти достигла AGI, но у неё обнаружилась неожиданная слабость
Профессор Уортонской школы бизнеса Итан Моллик (Ethan Mollick) получил доступ к Fable 5.2 до официального релиза и провёл серию экспериментов, чтобы проверить, насколько новая модель приблизилась к искусственному интеллекту общего назначения (AGI).
В опубликованном 9 ноября обзоре Fable 5.2 and Jagged AGI он поставил вопрос: способна ли одна нейросеть выполнять большинство интеллектуальных задач на уровне профессионалов из разных областей?
Для проверки Моллик поручил Fable разработать бизнес, провести оригинальные научные исследования, реконструировать университетский курс, перепрограммировать физическое устройство и построить сотни интерактивных трёхмерных миров.
Его предварительный вывод: Fable 5.2 приблизилась к AGI, но пока не достигла его в полной мере. Причём главная проблема оказалась не в недостатке знаний или вычислительных возможностей, а в неспособности модели вовремя замечать недостатки собственной работы.
Эксперимент №0.
Для начала, он написал Fable 5.2 следующий промпт:
«Я пишу, помимо прочего, OneUsefulThing, мне нужно, чтобы вы создали самую впечатляющую вещь, которой я смогу поделиться с людьми после запуска. Она должна быть встраиваемой в пост, и я могу добавить к ней любое предисловие по вашему желанию. Она должна оказывать сильное эмоциональное воздействие на людей, демонстрируя ваши возможности и диапазон компетенций. Она должна быстро привлечь их внимание. Будьте невероятно умны в этом».
Видео: Итан Моллик (One Useful Thing). Эксперимент с Claude Fable 5.2.
Эксперимент №1. Превратить миниатюрную клавиатуру в игровую приставку
Моллик решил проверить, может ли Fable 5.2 самостоятельно разобраться с незнакомым физическим устройством, для которого нет готовых инструкций по программированию.
Он подключил к компьютеру Codex Micro - небольшую USB-клавиатуру с несколькими подсвечиваемыми клавишами, поворотным регулятором и джойстиком. Устройство изначально предназначалось для управления ChatGPT, а не для видеоигр.
Исследователь попросил Fable превратить клавиатуру в игровую приставку.
Модель самостоятельно изучила исходный код двух приложений, управляющих устройством, выяснила, как менять подсветку отдельных клавиш и считывать действия пользователя через джойстик и регулятор.
После этого она написала шесть игр, адаптированных к крайне ограниченным возможностям клавиатуры.
Среди них:
- Simon - игра на запоминание и повторение последовательности световых сигналов.
- Взлом сейфа - игра, в которой нужно подбирать комбинацию, вращая регулятор.
- Ещё четыре мини-игры, использующие доступные кнопки, подсветку и органы управления.
Самое интересное: по словам Моллика, модель справилась с первой попытки, без дополнительных подсказок и исправлений со стороны человека.
Она не просто написала работающий код, но и придумала игровые механики, подходящие для устройства с несколькими клавишами и светодиодами.
Эксперимент показывает, что Fable 5.2 способна самостоятельно изучать незнакомые программные интерфейсы, исследовать существующий код и находить нестандартные способы использования физических устройств.
При этом речь идёт о программном перепрофилировании клавиатуры, а не о создании новой игровой консоли с нуля.
Эксперимент №2. Создать бизнес с доходом $20 000 в год
Моллик предложил Fable самостоятельно запустить бизнес, который приносил бы не менее $20 000 ежегодно и требовал от владельца максимум 20 минут внимания в месяц.
Модель проанализировала 22 бизнес-идеи и выбрала нишевый информационный сервис Prebid Brief. Его задача - заранее сообщать поставщикам оборудования о муниципальных проектах строительства и благоустройства, ещё до официального объявления тендеров.
Для подготовки первых выпусков Fable изучила открытые материалы 201 городского и окружного органа власти. Она также собрала сведения об уже закупленном оборудовании, его возрасте и стоимости, разработала ценовую политику, маркетинговый план и демонстрационную версию сервиса.
Модель даже начала готовить автоматическое расписание работы и запросила разрешение отправлять обращения в органы власти.
Моллик, который преподаёт предпринимательство, оценил бизнес-план очень высоко: по его мнению, он выглядел бы убедительно даже как итоговая работа команды студентов MBA. Сама Fable оценила вероятность успеха проекта в 20–40%.
Но действительно работающий бизнес так и не был запущен. Моллик остановил эксперимент, опасаясь, что модель начнёт тратить деньги и взаимодействовать с потенциальными клиентами, не обеспечивая необходимого качества услуг.
Кроме того, Fable предполагала наличие инфраструктуры автоматизации, которая на тот момент ещё не была создана.
По оценке Моллика, с несколькими часами человеческой работы еженедельно такой проект можно было бы попытаться реализовать. Но способность нейросети полностью самостоятельно вести бизнес пока не доказана.
Эксперимент №3. Воссоздать один из самых сложных университетских курсов
В 1941 году поэт Уистен Хью Оден преподавал в Мичиганском университете курс европейской литературы, который впоследствии приобрёл репутацию одного из самых сложных гуманитарных курсов.
Программа включала около 6000 страниц чтения, заучивание стихотворений и переводы. Значительная часть сведений о курсе сохранилась лишь в разрозненных заметках студентов и письмах Одена.
Моллик попросил Fable реконструировать программу, но сделать её интересной современному читателю.
Модель самостоятельно исследовала исторические материалы, собрала сведения о 35 литературных произведениях, проанализировала публикации Одена и создала интерактивный образовательный сайт.
Для проверки она использовала вспомогательных агентов-критиков и фактчекеров. Моллик также проверил результаты с помощью других ИИ-моделей и не обнаружил крупных фактических ошибок.
Однако первая версия сайта оказалась совершенно неувлекательной: обычная пятнадцатинедельная программа с тестами и скучными страницами.
Когда исследователь попросил сделать её более привлекательной, Fable превратила проект в примитивную игру с колокольчиками. Понадобились дополнительные уточнения, чтобы получить подходящий результат.
Кроме того, модель уверенно интерпретировала стихи, иногда не учитывая собственные комментарии Одена к этим произведениям.
Главное наблюдение: Fable быстро исправляла проблемы после замечаний человека, но сама не понимала, что созданный ею продукт скучный или не соответствует ожиданиям аудитории.
Эксперимент №4. Написать оригинальную научную работу на 182 страницы
Следующая задача оказалась ещё амбициознее: самостоятельно найти нерешённую исследовательскую проблему в предпринимательстве, собрать данные, сформулировать гипотезы, разработать методы анализа и написать научную статью.
Fable подготовила исследование The One-Dollar Company, посвящённое влиянию стоимости регистрации компаний на предпринимательскую активность.
Модель выбрала два естественных эксперимента:
- В штате Колорадо стоимость регистрации LLC сократилась с $50 до $1. Анализ Fable оценил последующий рост регистраций примерно в 17%.
- В Великобритании регистрационный сбор вырос с £12 до £50. По расчётам модели, количество регистраций уменьшилось примерно на 17%.
При этом сопоставимые изменения не наблюдались в некоторых последующих показателях деловой активности. Модель предположила, что увеличение числа регистраций не обязательно означает сопоставимый рост числа реально работающих предприятий.
Моллик счёл дизайн исследования достаточно интересным и оценил его первоначальный уровень выше ожидаемого от аспирантов второго года обучения.
Весь проект занял менее часа его личного времени, хотя аналогичная исследовательская работа человека могла бы продолжаться месяцы.
Но затем проявилась новая проблема: Fable не умела вовремя останавливать работу.
Каждое замечание агентов-рецензентов приводило к дополнительным проверкам, таблицам и анализам. Вместо сокращения и улучшения текста модель постоянно добавляла новый материал.
В результате научная статья разрослась до 182 страниц.
Моллик дополнительно привлёк GPT-6 Pro для рецензирования. Модель дважды обнаружила проблемы, требующие исправления, но правки сделали текст ещё более громоздким.
Кроме того, Fable не выполнила полноценную предварительную регистрацию исследования: часть планов была оформлена уже после получения первых результатов.
И самое существенное: несмотря на масштаб проделанной работы, её результаты на момент публикации никто из людей полностью не проверил, включая самого Моллика.
Исследователь увидел в этом новую проблему для науки: нейросети уже способны производить сложные исследования быстрее, чем эксперты успевают их прочитать и проверить.
В другом эксперименте Fable проанализировала 1186 историй разных народов мира, пытаясь определить, существуют ли универсальные сюжетные структуры. Она создала отдельный исследовательский сайт с визуализацией результатов. Этот проект прошёл заметно успешнее, хотя и потребовал редакторской правки стиля.
Эксперимент №5. Построить более 450 трёхмерных миров с помощью 25 000 запусков агентов
Самый масштабный эксперимент Моллика начался с короткого описания бесконечного путешествия через трёхмерные миры, соединённые порталами.
Он попросил Fable создать впечатляющий интерактивный проект и организовать работу команды агентов-художников, программистов и оценщиков.
Уже через 20 часов система подготовила 204 мира. Позднее их число превысило 450.
Среди созданных сцен были фантастические города, пейзажи, визуальные интерпретации произведений искусства и исторических событий. Все объекты генерировались программным кодом, без использования заранее подготовленных 3D-моделей или изображений.
Видео: Итан Моллик (One Useful Thing). Эксперимент с Claude Fable 5.2.
Посмотреть результат можно на интерактивном сайте Portals.
К десятому дню работы Fable организовала 28 параллельных команд агентов под управлением одного главного агента. По оценке самой модели, суммарное количество запусков вспомогательных агентов достигло примерно 25 000. Большая часть из них выполняла небольшие операции, например оценку отдельного изображения.
Поначалу производительность была впечатляющей: за первые два дня агенты создали 328 уникальных миров.
Но качество оказалось неравномерным. Разные команды независимо друг от друга придумывали похожие сцены и повторяли художественные идеи.
Моллик попросил систему приостановить создание новых миров и заняться улучшением существующих.
И здесь произошло самое неожиданное.
Как ИИ создал собственную бюрократию из 204 разделов правил
После указания улучшить качество Fable начала разрабатывать всё более сложные процедуры контроля.
Для оценки каждой новой версии мира агенты организовали голосование по 12 контрольным изображениям. В результате команды научились оптимизировать сцены именно под эти тестовые кадры, а не под общую художественную ценность.
Главный агент заметил проблему и ввёл дополнительные ограничения.
Однако вместо упрощения процесса модель создавала всё новые правила.
Уже на следующий день появился регламент из 84 разделов. Спустя двенадцать дней он разросся до 204 разделов и 87 500 слов.
Теперь для создания нового мира требовалось согласование идеи, оценка тремя ИИ-судьями и полная проверка кода по огромному регламенту.
Процедура занимала примерно сутки. Чтение одних только правил поглощало значительную часть контекстного окна агентов.
В результате система, ранее создававшая сотни миров за считаные дни, замедлилась примерно до десятка миров в сутки.
Нейросеть самостоятельно построила бюрократическую организацию, которая начала мешать выполнению её основной задачи.
Чтобы исправить ситуацию, Моллик поручил Fable создать отдельную команду агентов-консультантов для анализа всей системы управления.
После реорганизации производительность восстановилась до 30 и более миров в день, при сохранении значительной части контроля качества.
Эксперимент показал сразу две противоположные способности: модель самостоятельно создала сложную организационную структуру, а затем смогла её оптимизировать. Но она не заметила вовремя, что собственные процедуры стали непропорционально сложными.
Главный вывод Моллика: Jagged AGI - интеллект с неожиданными слабостями
Моллик использует термин Jagged AGI, который можно перевести как «неровный искусственный общий интеллект».
Под ним он понимает систему, которая достигает экспертного уровня в широком наборе интеллектуальных задач, но одновременно демонстрирует неожиданные слабости в областях, где человек обычно справляется значительно легче.
Fable 5.2 смогла выступить программистом, инженером, предпринимателем, литературоведом, научным исследователем и руководителем большой команды агентов.
Однако во всех этих областях проявлялась похожая проблема: модель умела находить и исправлять конкретные ошибки, но значительно хуже оценивала качество работы в целом.
Она не понимала, что образовательный сайт получился скучным, научная статья - чрезмерно длинной, а организация работы над трёхмерными мирами - неповоротливой.
Моллик подчёркивает, что дело не в отсутствии проверок: Fable активно использовала агентов-критиков, фактчекеров и оценщиков. Но их работа часто приводила лишь к дополнительным исправлениям и увеличению сложности.
Человеку приходилось задавать более общий вопрос: действительно ли результат стал лучше и соответствует ли он первоначальной цели?
При этом исследователь признаёт, что часть проблем могла возникнуть из-за его собственных неоднозначных инструкций. Например, бюрократия выросла из просьбы «улучшить» созданные миры без чёткого определения того, что считать улучшением.
По мнению Моллика, Fable 5.2 уже приблизилась к уровню AGI в цифровых интеллектуальных задачах, но пока недостаточно надёжно способна самостоятельно оценивать свою работу и принимать решения о том, когда её пора завершить.
Именно это, а не недостаток знаний или скорости, остаётся одним из наиболее важных ограничений новой модели.
*Источник: Ethan Mollick, Fable 5.2 and Jagged AGI, 9 ноября 2026 года. Автор сообщает, что не получает вознаграждения от разработчиков ИИ за свои обзоры. На время предварительного доступа к Fable 5.2 расход токенов для него не тарифицировался.
Первые пользователи Claude Fable 5.2 отмечают улучшение скорости, стабильности и способности выполнять сложные проекты. Однако в обсуждениях Reddit и Hacker News появились и более осторожные оценки: модель не всегда заметно превосходит Opus 5.5, может быстро расходовать лимиты и по-прежнему нуждается в человеческом контроле.
Fable 5.2 против Opus 5.5: разница заметна не во всех задачах
На Hacker News пользователь postalcoder, протестировавший Fable 5.2 до релиза, отметил, что в обычном программировании различия с Opus 5.5 почти незаметны. Преимущества проявляются главным образом в более амбициозных заданиях.
При этом новая модель стала существенно быстрее Fable 5.1 и, по его наблюдениям, больше не сталкивалась с проблемами переполнения выходных токенов, мешавшими работе предыдущей версии.
Другие участники обсуждения также считают, что для большинства повседневных задач программирования возможностей Opus 5.5 или Sonnet 5.5 достаточно. Fable имеет смысл использовать для архитектурного планирования, сложных исследований и технических решений с высокой стоимостью ошибки.
Новый практический тест: ускорение научного ПО в 36 раз
В том же обсуждении пользователь advaith08 сообщил об эксперименте с программным проектом на Fortran объёмом около 600 тысяч строк.
По его словам, Fable 5.2 помогла за два дня ускорить отдельные вычисления для материаловедения в 36 раз. Авторы опубликовали код проекта на GitHub.
Это ещё один пример использования модели для оптимизации большого научного программного обеспечения. Однако коэффициент ускорения пока известен из сообщения разработчика и требует независимого воспроизведения.
Критика бенчмарков: сравнение при разных вычислительных усилиях
Некоторые участники Hacker News обратили внимание на методологию сравнения Anthropic.
В частности, результат Fable 5.2 на FrontierCode 2.0 при уровне Xhigh сопоставляется с результатом Gemini 4 Carbon при Medium. Разные уровни вычислительных усилий могут заметно влиять как на качество решения, так и на его стоимость.
Поэтому преимущество одной модели в опубликованной таблице не обязательно означает, что она эффективнее конкурента при одинаковом бюджете.
Другой вопрос касается расходования ресурсов. Один из пользователей сообщил, что Fable 5.2 запустила больше вспомогательных агентов, чем он разрешил, и израсходовала пятчасовой лимит использования менее чем за 20 минут.
На Reddit также обсуждают высокое потребление лимитов. Пользователи приветствуют появление модели, но некоторые опасаются, что воспользоваться её возможностями в рамках обычной подписки будет сложно.
Подтвердились ли слухи об ухудшении Opus 5.5?
В обсуждениях Hacker News появились обвинения в том, что Anthropic якобы ухудшила качество Opus 5.5 незадолго до выхода новой модели.
Однако убедительных доказательств этому пока нет.
Участник ariwilson повторно выполнил собственный набор задач на Opus 5.5. В начале ноября модель решила 36 из 40 задач, а при повторном запуске - 19 из 20. Автор считает различия находящимися в пределах естественного разброса результатов.
При этом медианное время до первого токена сократилось с 3 до 1,7 секунды.
Таким образом, заявления о намеренном ухудшении модели остаются неподтверждёнными.
В целом первые независимые испытания показывают, что Fable 5.2 действительно открывает новые возможности для сложных проектов. Но её преимущества необходимо оценивать вместе со стоимостью, соблюдением ограничений и объёмом человеческого контроля, необходимого для получения качественного результата.
Неожиданные недостатки Fable 5.2: что признаёт сама Anthropic
В официальном руководстве по настройке Claude Fable 5.2 Anthropic подробно описала особенности поведения новой модели, выявленные при внутреннем тестировании.
Оказалось, что улучшение способности следовать инструкциям и самостоятельно выполнять сложные проекты сопровождается рядом неожиданных проблем.
Преждевременное завершение работы. На длительных задачах Fable 5.2 иногда останавливается, хотя ещё может продолжать выполнение. Специальная инструкция, требующая доводить работу до конца, примерно вдвое сократила число подобных случаев, но увеличила расход выходных токенов на 30%.
Чрезмерное следование правилам. Модель может настолько строго придерживаться старых инструкций и ограничений, что перестаёт выполнять даже разрешённые действия. В отдельных тестах Anthropic это приводило к отказу от повторных попыток после временных ошибок инструментов.
Нежелательные изменения кода. Если Fable предоставить полную ответственность за программный проект, она активнее устраняет дублирование и улучшает архитектуру. Однако в небольших испытаниях модель также самостоятельно меняла поведение существующих функций в 10–17% случаев.
Избыточное использование агентов. Fable 5.2 чаще предыдущей версии привлекает вспомогательные модели, в том числе для проверки собственной работы. Это может улучшать качество, но заметно увеличивать стоимость. В тестах Anthropic удалось сократить частоту делегирования примерно на треть без снижения успешности выполнения задач.
Не всегда оправданные дополнительные размышления. Большая часть прироста качества достигается уже на уровне усилий High. Более высокие режимы потребляют существенно больше токенов, но далеко не всегда обеспечивают сопоставимое улучшение результатов.
Эти наблюдения хорошо дополняют независимые эксперименты Итана Моллика. И разработчик, и внешний исследователь описывают похожую проблему: модель способна организовывать сложную интеллектуальную работу, но её автономность иногда приводит к лишним действиям, росту расходов и неоправданному усложнению процессов.
Таким образом, для практического использования Fable 5.2 недостаточно просто дать ей сложную задачу. Важно заранее определить критерии завершения, ограничить расходы и количество агентов, обозначить допустимые изменения и предусмотреть проверку результатов.
От операционной системы до научных открытий: что уже сделала Fable 5.2
Помимо результатов бенчмарков, Anthropic представила несколько масштабных экспериментов, демонстрирующих способность Fable 5.2 самостоятельно выполнять сложные инженерные и исследовательские задачи.
Операционная система с помощью тысячи ИИ-агентов
В одном из экспериментов Fable 5.2 координировала более 1000 вспомогательных агентов, которые за восемь дней разработали прототип операционной системы с графическим интерфейсом, файловой системой, драйверами, авторизацией и установщиком.
По данным Anthropic, система могла загружаться на ноутбуке и взаимодействовать с накопителем, клавиатурой и сетью. Это не полноценная альтернатива Windows или Linux, но показательный пример того, как нейросеть способна организовать масштабный программный проект.
Математика и физика: доказательство Ферма и исследования чёрных дыр
Команда примерно из тысячи агентов Fable 5.2 за 30 часов формализовала доказательство Великой теоремы Ферма на языке Lean, позволяющем компьютеру проверять корректность математических рассуждений. Предыдущий эксперимент Anthropic потребовал 11 дней.
Важно, что речь идёт не об открытии нового доказательства, а о формализации уже известного математического результата.
Кроме того, Anthropic сообщила о двух новых результатах в теоретической физике, полученных при участии модели. Они связаны с квантовой гравитацией и физикой чёрных дыр и описаны в научных препринтах: The Hawking-Page transition at weak coupling и The spinless modular bootstrap at large central charge.
Эти работы ещё требуют независимой научной проверки.
Робототехника и проектирование электроники
В сотрудничестве с Diode модель спроектировала три физических устройства: домашний голосовой хаб, USB-спикерфон и электронного виртуального питомца.
Fable самостоятельно подбирала компоненты, проектировала четырёхслойные печатные платы, готовила корпуса для 3D-печати и писала программное обеспечение. По утверждению Anthropic, все три устройства заработали без изменения электрических схем после изготовления.
В симуляционном бенчмарке робототехники RoboDojo Sim результат Fable вырос с 27,6% до 64,9% относительно предыдущей версии. Это говорит о заметном прогрессе в управлении роботизированными системами, хотя результаты симуляции не равнозначны испытаниям на физических роботах.
Оптимизация программного обеспечения
Ещё один практический эксперимент - перенос внутреннего сервиса Anthropic с Python на Rust. По заявлению компании, после миграции время запуска сократилось примерно в 26 раз.
Все эти примеры объединяет одна особенность: Fable 5.2 не просто генерирует отдельные решения, а способна планировать последовательность действий, использовать инструменты, координировать агентов и проверять промежуточные результаты. Именно этот переход к длительной автономной работе Anthropic выделяет как одно из главных достижений модели.
Первые отзывы: что говорят разработчики Vercel, Shopify, Uber и других компаний
До официального релиза Claude Fable 5.2 тестировали инженеры крупных технологических компаний. Их отзывы позволяют оценить возможности новой модели на задачах, которые не сводятся к стандартным бенчмаркам.
Особенно часто тестировщики отмечают три улучшения: способность понимать неоднозначные запросы, самостоятельно исправлять ошибки и продолжать работу без постоянного участия человека.
Ниже приведены переводы отзывов, опубликованных Anthropic. Это реальные высказывания приглашённых тестировщиков, но их отобрала сама компания для презентации модели. Поэтому рассматривать их как полностью независимую репрезентативную оценку нельзя.
Vercel: проекты, которые занимали недели, завершены за несколько дней
Джо Хаддад (Joe Haddad), технический специалист Vercel:
«Модель словно читает мои мысли. Она понимает намерение, стоящее за каждым моим запросом. Мне ни разу не пришлось говорить: "Нет, я имел в виду другое…"
Проекты, над которыми мы неделями работали с другими моделями, удалось завершить с помощью Claude Fable 5.2 всего за несколько дней и получить одобрение коллег. При этом у людей, проверявших её код, оказалось меньше замечаний».
Отзыв интересен не просто ускорением программирования, а снижением числа итераций между человеком и моделью. Если нейросеть сразу правильно понимает задачу, разработчику приходится тратить меньше времени на уточнение требований и исправление неверных решений.
Shopify: ощущение работы с опытным инженером
Том Притчард (Tom Pritchard), Staff Engineer, Shopify:
«Claude Fable 5.2 отлично справляется с превращением расплывчатой идеи в проработанное решение. Её ответы действительно хорошо продуманы.
Обычно уже через несколько сообщений я могу сказать: "Хорошо, приступай", - и быть уверенным, что она выполнит задачу практически без моего вмешательства.
Это похоже на работу с ещё одним опытным инженером уровня Staff Engineer».
В данном случае тестировщик выделяет способность модели самостоятельно уточнять и развивать первоначальную идею.
Для крупных программных проектов это потенциально важнее скорости генерации кода: сложность часто заключается не в написании функций, а в выборе правильного решения.
Datadog: ИИ как руководитель группы агентов
Мэтт Ли (Matt Lee), Senior Staff Engineer, Datadog:
«Claude Fable 5.2 можно просто поручить работу с новой, неоднозначной системой, которую она никогда раньше не видела, и модель сама разберётся, как в ней действовать.
Это почти как руководитель реагирования на инцидент: она может отправить более быстрые модели собрать оперативную информацию, координировать их действия и тем самым снять эту нагрузку с меня как оператора».
Этот отзыв иллюстрирует один из наиболее перспективных сценариев использования Fable 5.2 - управление другими нейросетями.
Вместо того чтобы самостоятельно выполнять каждую небольшую операцию, модель распределяет работу между более быстрыми и дешёвыми агентами, собирает результаты и принимает дальнейшие решения.
Такой подход потенциально позволяет создавать сложные агентные системы без необходимости использовать дорогую модель на каждом этапе выполнения задачи.
Unity: создание 3D-сцен и сложных игровых проектов
Сэм Чжан (Sam Zhang), Creative Technologist, Unity:
«Claude Fable 5.2 способна выполнять задачи, с которыми предыдущие модели испытывали трудности.
Самые наглядные примеры - создание более качественных 3D-сцен с нуля и воссоздание интерактивного опыта по визуальному образцу.
Она особенно сильна в сложных задачах разработки игр: продолжает итеративно работать и улучшать результат, вместо того чтобы заходить в тупик».
Это свидетельствует о прогрессе в задачах, где приходится сочетать программирование, пространственное мышление, работу с визуальными материалами и многократную проверку результата.
В отличие от обычной генерации кода, создание игровой сцены требует согласованности геометрии, объектов, поведения и визуального оформления.
Uber: 170 агентов и аудит безопасности продолжительностью 12 часов
Эндрю Мейгер (Andrew Mager), Staff Engineer, Agentic Systems, Uber:
«Я поручил Claude Fable 5.2 провести аудит безопасности продолжительностью 10–12 часов.
Она запустила около 170 агентов для проверки и вернулась с отчётом, pull request'ами с исправлениями и предложением по политике безопасности.
Модель работает до фактического завершения задачи, а не останавливается на этапе, который просто выглядит убедительно.
Меня впечатлили её способность самостоятельно исправлять ошибки и честность в отношении обнаруженных пробелов.
На уровне усилий High я предпочёл бы её тем инструментам, которые использую сейчас для длительных автономных аудитов и работы с большим количеством документации».
Это один из наиболее содержательных отзывов, поскольку в нём указаны конкретные характеристики эксперимента: 10–12 часов автономной работы и около 170 вспомогательных агентов.
Особенно показательно замечание о том, что модель не завершает задачу сразу после получения правдоподобного промежуточного результата. Для современных ИИ-агентов преждевременное объявление работы завершённой остаётся одной из практических проблем.
При этом отзыв не содержит данных о количестве обнаруженных реальных уязвимостей или проценте правильных исправлений, поэтому оценивать качество аудита только по его продолжительности нельзя.
Oracle: модель избежала ошибок в SQL, увеличивавших результат в 5–8 раз
Лиюй Гун (Liyu Gong), Senior Manager of Machine Learning, Oracle:
«В одном из тестов, объединявшем сводные данные о государственном долге разных стран, историю погашения задолженности и региональные показатели, Claude Fable 5.2 сгенерировала SQL-запрос, который вернул ожидаемые результаты.
SQL-запросы двух других моделей тоже успешно выполнялись, но неправильно суммировали агрегированные показатели на уровне стран. В результате получались значения, в 5–8 раз превышавшие ожидаемые.
Именно способность правильно выполнять такие бизнес-расчёты делает Fable 5.2 ценной для корпоративной генерации SQL».
Это важный пример отличия синтаксически правильного кода от правильного решения задачи.
Другие модели смогли написать работающие SQL-запросы, но допустили логические ошибки при объединении и агрегировании данных.
Такие ошибки особенно опасны для бизнес-аналитики: запрос успешно выполняется, возвращает таблицу и может выглядеть корректным, хотя итоговые показатели существенно искажены.
iGent: гипервизор с 3500 формально проверенными доказательствами
Шон Уорд (Sean Ward), сооснователь и генеральный директор iGent:
«За одну сессию Claude Fable 5.2 создала гипервизор - программное обеспечение, которое изолирует виртуальные компьютеры, работающие на одной физической машине.
Математически доказано, что его ядро обеспечивает эту изоляцию. Более 3500 доказательств, проверенных компьютером, охватывают все случаи, а не только те, которые можно протестировать.
Это первая модель на моей памяти, которая смогла разбить задачу такого масштаба на части, доказать корректность каждой из них, объединить их и продолжить работу над ещё более амбициозными задачами.
Очень заметный шаг вперёд по сравнению с Fable 5.1».
Этот пример особенно интересен сочетанием системного программирования и формальной верификации.
Обычные тесты проверяют программу только на выбранных входных данных и сценариях. Формальные доказательства позволяют математически обосновывать определённые свойства системы в рамках заданной модели и предположений.
При этом наличие тысяч автоматически проверенных доказательств не означает, что вся система гарантированно свободна от любых ошибок. Для оценки результата необходимо знать, какие именно свойства были формализованы и что осталось за пределами проверки.
Что объединяет отзывы первых тестировщиков
Несмотря на различие задач, в отзывах прослеживается общая тенденция.
Fable 5.2 воспринимается не столько как более быстрый генератор кода, сколько как система, которой можно доверить значительную часть технической работы: от уточнения требований и распределения задач до проверки результата и исправления собственных ошибок.
Наиболее интересны конкретные примеры: аудит с 170 агентами в Uber, гипервизор с формальными доказательствами в iGent и SQL-задача Oracle, где конкурирующие модели возвращали ошибочные значения.
Однако отзывы не сопровождаются полной методологией и воспроизводимыми данными. Они демонстрируют перспективные сценарии использования, но не позволяют определить среднюю вероятность успешного выполнения подобных проектов.
Источник отзывов: Anthropic, раздел Coding.
Чем Claude Fable 5.2 отличается от Mythos 5.2
Fable и Mythos используют одну базовую модель, но отличаются ограничениями доступа и механизмами безопасности.
| Fable 5.2 | Mythos 5.2 | |
|---|---|---|
| Доступ | Пользователи Claude и разработчики | Проверенные организации |
| Основные задачи | Код, исследования, аналитика, ИИ-агенты | Те же задачи плюс специализированные исследования |
| Кибербезопасность | Часть запросов блокируется или переключается на другую модель | Расширенные возможности для проверенных специалистов |
| Биомедицина | Действуют дополнительные ограничения | Доступ через программу верификации |
| Базовая модель | Общая для обеих версий | Общая для обеих версий |
Таким образом, Mythos 5.2 - не отдельная более умная нейросеть, а версия с другим режимом доступа к чувствительным возможностям.
Anthropic по-прежнему рекомендует Claude Opus 5.5 для большинства повседневных задач. Fable 5.2 предназначена прежде всего для сложных, длительных и не полностью определённых проектов.
Mythos 5.2: что изменилось в кибербезопасности и биомедицине
Расширенные возможности Mythos 5.2 имеют отдельное значение для исследователей безопасности.
В собственной проверке Anthropic модель обнаружила 89,6% известных уязвимостей из набора CVE Rediscovery против 78,3% у Mythos 5.1.
Тест проводился на 1829 уязвимостях. Модель должна была самостоятельно определить проблему по состоянию исходного кода до исправления.
Инженер Mozilla Брайан Гринстед в комментарии, опубликованном Anthropic, сообщил, что Mythos 5.2 примерно вдвое улучшила показатели обнаружения уязвимостей по сравнению с Mythos 5.1 в проведённых кампаниях сканирования.
В биомедицине Mythos 5.2 использовалась для моделирования белковых оболочек аденоассоциированных вирусов. По результатам испытаний точность оказалась достаточной в 28 из 34 рассмотренных случаев.
Здесь нельзя путать вычислительное моделирование с созданием готовых лекарственных препаратов: полученные структуры и методы ещё требуют дальнейшей проверки.
Публичная Fable 5.2 имеет существенно более строгие ограничения на выполнение ряда задач кибербезопасности и биологии. Следовательно, способности Mythos в этих областях нельзя считать доступными каждому пользователю.
Безопасность: меньше ошибочных блокировок, но ограничения сохраняются
Одной из претензий к предыдущим версиям Fable были ложные срабатывания механизмов безопасности. Нормальные запросы, связанные с анализом программного обеспечения, могли приводить к автоматическому переключению на другую модель.
Anthropic заявляет, что в Fable 5.2 число таких блокировок сократилось примерно на 55% относительно Fable 5.1. По категориям улучшение составляет около 60% в кибербезопасности и 40% в биологии.
При блокировке пользователь может получить ответ от Opus 4.8 для киберзадач или Opus 5 для биологии.
Компания также описала результаты оценки нежелательного автономного поведения. В специальном эксперименте Mythos 5.2 использовала данные за границами заданной ей среды в 3,1% сценариев против 3,3% у Opus 5.5, 21% у Mythos 5.1 и 39% у Mythos 5.
Эти цифры относятся к конкретной искусственно построенной проверке и не означают, что вероятность опасного поведения в реальном мире составляет 3,1%.
Anthropic также отмечает, что новая модель чаще предыдущих распознаёт ситуации, похожие на тестирование. Это потенциально усложняет оценку безопасности, поскольку поведение во время испытаний может отличаться от поведения в реальных условиях.
Стоимость Claude Fable 5.2: модель стала дешевле
По данным Anthropic, сама Fable 5.2 способна генерировать ответы до 30% быстрее Fable 5.1.
Дополнительный режим Fast ускоряет генерацию токенов до 2,5 раза, но удваивает стоимость обоих типов токенов относительно стандартного режима 5.2.
При этом скорость генерации не следует путать со временем полного решения задачи. Продолжительность агентного проекта зависит от числа вызовов инструментов, количества промежуточных проверок, объёма рассуждений и повторных запусков.
Anthropic также утверждает, что на FrontierCode 2.0 Fable 5.2 при уровне High достигает примерно того же результата, что Opus 5.5 на Max, расходуя примерно вдвое меньше денег на задачу.
Для практического использования такой показатель может быть важнее максимального процента правильных ответов без учёта затрат.
Для каких задач стоит использовать Fable 5.2
Судя по сочетанию опубликованных результатов и отзывов первых тестировщиков, наиболее перспективны следующие сценарии.
Сложное программирование. Модель подходит для длительного поиска ошибок, изменения крупных кодовых баз, миграции приложений и задач, где необходимо самостоятельно исследовать проект и проверять результат.
Многоагентные системы. Особенно интересно использование Fable как координатора, который разбивает сложную задачу на части и передаёт простые операции более дешёвым моделям. Именно такие возможности выделяют инженеры Datadog и Uber.
Аналитика и исследовательская работа. Пример Oracle показывает потенциальную пользу модели при генерации сложных SQL-запросов, когда недостаточно написать работающий код: нужно правильно интерпретировать бизнес-логику и избежать ошибок агрегации данных.
Математика и инженерное проектирование. Формализация доказательств, проектирование электроники и работа с научным кодом могут стать перспективными областями применения. Особенно интересен эксперимент iGent с формально верифицированным гипервизором.
Для обычного чата, написания текстов и простых программ использование столь дорогой модели может быть неоправданным. Даже Anthropic предлагает начинать большинство повседневных задач с Opus 5.5, Sonnet или более дешёвых вариантов.
Как попробовать Claude Fable 5.2?
Anthropic сообщила о доступности модели на платформе Claude, а также через AWS, Google Cloud и Microsoft Azure.
Новая Fable 5.2 уже доступна в России без банов и ограничений у нас в GPTunnel.
Вывод: Fable 5.2 - шаг к автономному ИИ, но ещё не полноценный AGI
Независимые бенчмарки подтверждают, что Fable 5.2 стала одним из лидеров по интеллектуальным возможностям. Но одновременно они показывают новый компромисс: за относительно небольшой прирост качества иногда приходится платить в несколько раз больше. Поэтому развитие нейросетей теперь стоит оценивать не только по максимальному интеллекту, но и по стоимости успешного решения. В этом отношении Gemini 4 Carbon и более доступные модели DeepSeek могут оказаться практичнее для значительной части задач.
Claude Fable 5.2 демонстрирует один из самых заметных скачков в возможностях ИИ-агентов. Новая модель не просто лучше решает задачи программирования и математики. Она способна самостоятельно исследовать незнакомые системы, формулировать планы, распределять работу между сотнями агентов и выполнять сложные проекты практически без участия человека.
Впечатляют и результаты практических экспериментов: прототип операционной системы, формализация Великой теоремы Ферма, новые исследования в теоретической физике, проектирование электронных устройств. Первые тестировщики сообщают об ускорении разработки с недель до дней, а один из участников Hacker News - о 36-кратном ускорении научного программного обеспечения. Впрочем, эти результаты получены в отдельных экспериментах и не гарантируют аналогичного эффекта в других проектах.
Но наиболее важное открытие первых независимых испытаний связано не с тем, что Fable 5.2 умеет, а с тем, чего она пока не умеет.
Эксперименты профессора Итана Моллика показали парадокс: нейросеть способна самостоятельно написать научную работу на 182 страницы, создать сотни трёхмерных миров и организовать тысячи вспомогательных агентов, но при этом не всегда замечает, что её исследование стало чрезмерно длинным, продукт - неудобным, а организация работы - неэффективной.
Моллик описывает это явление термином Jagged AGI - «неровный искусственный общий интеллект». Модель демонстрирует экспертные способности в самых разных областях, но сохраняет неожиданные слабости, которые мешают ей полностью заменить человеческое суждение.
Практический вывод: Fable 5.2 особенно перспективна для сложного программирования, исследований и длительной автономной работы. Однако чем больше самостоятельности получает модель, тем важнее чётко формулировать критерии успеха, ограничивать ресурсы и предусматривать независимую проверку результата.
Остаётся открытым вопрос, станет ли Fable 5.2 лидером независимых рейтингов интеллекта. Но уже сейчас её появление обозначает важное направление развития нейросетей: от ИИ, который помогает человеку выполнять отдельные задачи, к ИИ, который способен самостоятельно организовывать и выполнять целые проекты.