
DeepSeek выпустила обновление V4.1 Flash 1017 и хоть сама назвала его малым (та же модель, только дообученная), у пользователей один вопрос: почему это всё ещё 4.1, а не 4.2 или 4.5 - настолько им понравилось обновление. В статье разберём официальные замеры самой компании, бенчмарки независимых команд (sference, Bug Hunt Bench, ChessBench) и отзывы пользователей - читайте наш обзор до конца.
Начнём с самой сути обновления - на графике цены и качества в агентном тесте DeepSWE она оказалась выше и левее всех конкурентов: решает 77% задач, а задача обходится ей в десятки раз дешевле, чем Claude Opus 5 или GPT-6 Astra, которые решают около 74%. Обновление вышло 17 октября, веса открыты, на сайте, в приложении и в API уже работает новая версия. Ниже - полная таблица тестов, график, первые независимые замеры и слабые места модели.
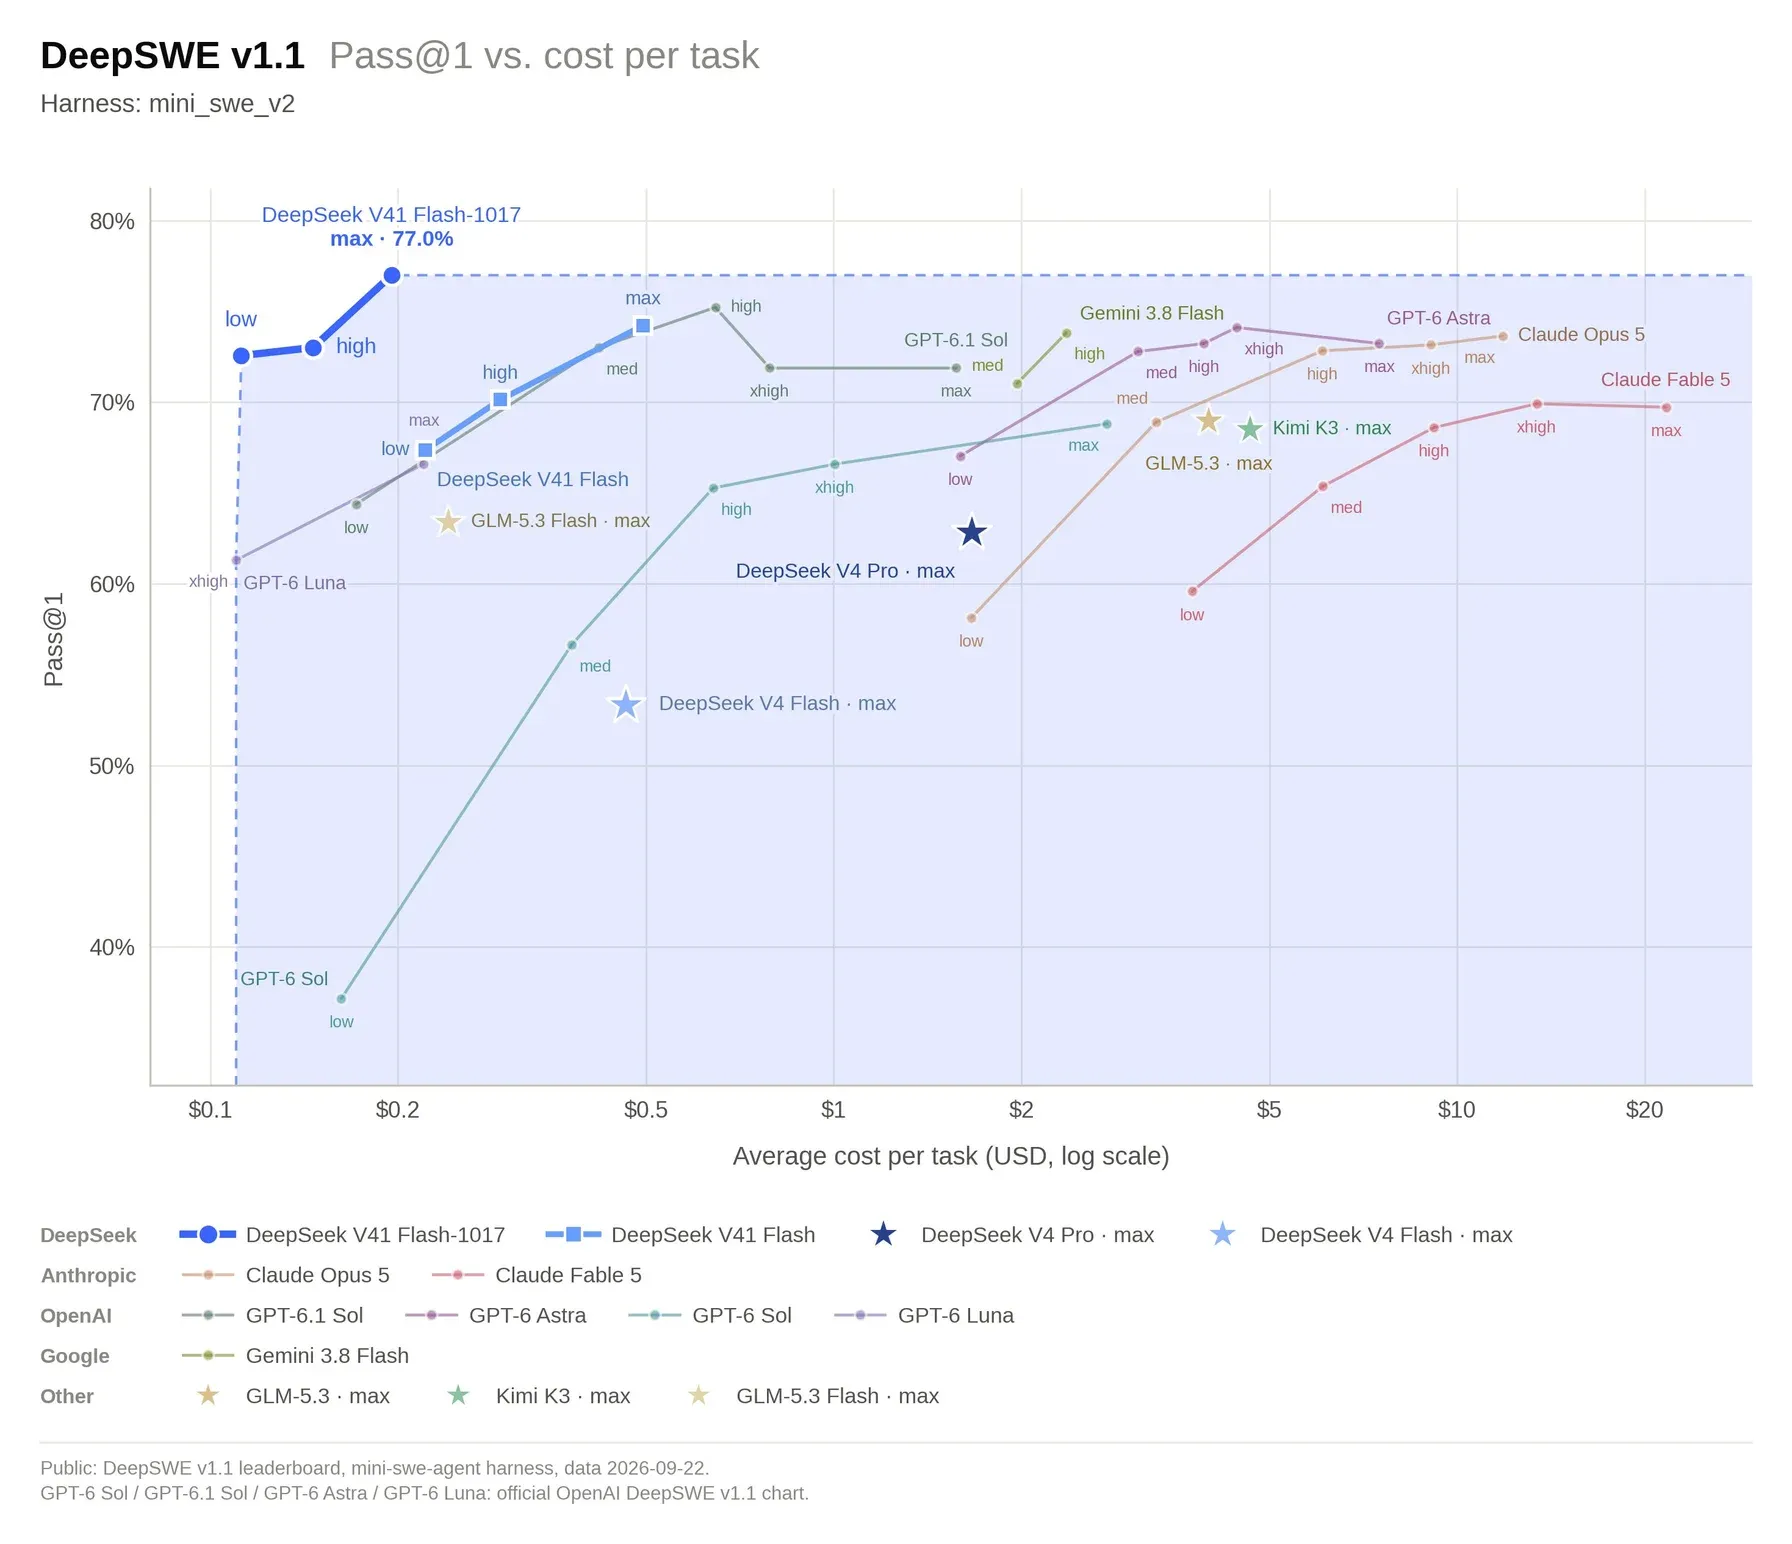
График DeepSeek. Данные конкурентов взяты из публичного рейтинга DeepSWE на 22.09.2026 и графиков OpenAI.
Что DeepSeek обещает
В анонсе DeepSeek три главных заявления:
- Парето-улучшение. Модель сильнее в тестах, быстрее заканчивает задачи и отвечает короче, чем сентябрьская версия. То есть лучше и дешевле одновременно, без размена одного на другое.
- Целые проекты, а не куски кода. DeepSeek пишет, что модель может сама сделать проект от начала до конца: например, написать игру или создать 3D-модель. Видео с примерами DeepSeek выложила в X. Чтобы этого добиться, модель во время обучения сама проверяла и оценивала свои результаты, а потом училась на этих оценках. Людей, которые проверяют ответы, и отдельной модели-проверяющего в этой схеме нет (The Decoder).
- Своя обвязка. Модель настроена под DeepSeek Harness (открытый агентный фреймворк компании), Tencent CodeBuddy и WorkBuddy. Для Harness советуют версию 0.2.1-rc.1 или новее.
Проверить «проекты с нуля» пока можно только по роликам DeepSeek и единичным отзывам. Например, один пользователь попросил модель собрать витрину Angular-компонентов через DeepSeek Harness и остался доволен результатом. Но это единичный отзыв.
Полная таблица: где 1017 впереди, а где нет
DeepSeek сравнила обновление с прошлой версией и четырьмя конкурентами. Жирным выделен лучший результат в строке.
| Тест | 1017 | Сентябрь | Kimi K3 | GLM 5.3 | GPT-5.6 Sol | Opus 5 |
|---|---|---|---|---|---|---|
| HLE (без инструментов) | 42,6 / 44,0* | 36,8 / 39,1* | 43,5 | 42,0* | 44,5 | 56,3 |
| Terminal-Bench 4.0 | 42,3 | 31,2 | 12,6 | 37,9 | 39,9 | 51,8 |
| DeepSWE v1.1 | 77,0 | 74,2 | 67,5 | 66,9 | 73,0 | 74,0 |
| ProgramBench | 29,1 | 20,3 | 17,5 | 19,0 | 23,0 | 37,0 |
| NL2Repo-Bench | 68,2 | 65,4 | 58,0 | 58,0 | 56,8 | 75,3 |
| Automation-Bench v1.0.6 | 60,5 | 54,8 | 46,7 | 48,8 | 45,8 | 50,3 |
| Agents' Last Exam | 35,4 | 31,8 | 27,6 | 28,5 | 26,7 | 28,6 |
| Apex Bench v1.1 | 72,1 | 64,6 | 47,8 | 56,6 | 54,3 | 65,8 |
| Chartography (с инструментами) | 83,0 | 78,9 | 68,1 | - | 79,9 | 84,0 |
| BabyVision (с инструментами) | 92,5 | 89,6 | 85,7 | - | 88,9 | 94,1 |
| ZeroBench-main (с инструментами) | 51,0 | 49,0 | 41,0 | - | 53,0 | 52,0 |
* текстовая часть HLE. Terminal-Bench 4.0 запускали в окружении Claude Code, DeepSWE - во фреймворке Mini-SWE-V2, ZeroBench считали по Pass@5.
Что здесь видно, если читать не только жирные цифры:
- Рост к сентябрю есть во всех 11 тестах. Сильнее всего выросли Terminal-Bench (+11,1), ProgramBench (+8,8) и Apex Bench (+7,5), слабее всего ZeroBench (+2,0).
- Kimi K3, GLM 5.3 и GPT-5.6 Sol 1017 обходит почти везде. Исключения - HLE, где K3 и Sol чуть выше, и ZeroBench, где выше Sol.
- С Opus 5 счёт 4:7. 1017 выигрывает агентные тесты (DeepSWE, Automation-Bench, Agents' Last Exam) и Apex Bench, а Opus 5 впереди в знаниях (HLE, разрыв почти 14 пунктов), работе в терминале, программировании (ProgramBench, NL2Repo) и тестах на зрение.
- Opus 5 - уже прошлое поколение. Opus 5.5 вышла 22 сентября и, по данным Anthropic, набирает на Terminal-Bench 4.0 66,4% (Opus 5 по тем же данным - 52,3%). В таблице DeepSeek её нет, поэтому сравнения с текущим флагманом Anthropic в этих цифрах не ищите.
На Reddit заметили и другое: список тестов в этот раз короче и агентнее, чем в карточке сентябрьской версии. Тесты стандартные, но подобраны так, что сильные стороны модели видны лучше слабых.
График цены задачи: как его читать
На графике в начале статьи по вертикали - доля решённых задач DeepSWE, по горизонтали - средняя стоимость одной задачи по ценам API вендоров. Шкала логарифмическая: каждое деление правее - примерно вдвое-втрое дороже. Точки low, high и max - уровни рассуждения: чем выше, тем дольше модель думает и тем дороже задача.
Вот что получается, если прикинуть по графику:
- 1017 в режиме max решает 77% задач, и задача стоит примерно в 2,5 раза дешевле, чем у сентябрьской версии в том же режиме (74,2%).
- 1017 в режиме low решает около 72,5% - чуть меньше сентябрьского max, но в 4-5 раз дешевле его.
- Ближайший по качеству конкурент - GPT-6.1 Sol в режиме high, около 75%, и задача у него примерно втрое дороже, чем у 1017 в max.
- Gemini 3.8 Flash, GPT-6 Astra и Claude Opus 5 держатся около 73-74%, но задача у них дороже в 12-60 раз.
- Claude Fable 5 не дотягивает до 70% даже в режиме max и оказывается самой дорогой точкой на графике.
- Модели в той же ценовой зоне - GPT-6 Luna, GLM 5.3 Flash и сентябрьская Flash в режиме low - решают около 61-67%.
У графика есть оговорки. Его нарисовала DeepSeek, а данные конкурентов взяты из рейтинга DeepSWE на 22 сентября - в тот день вышла Opus 5.5, поэтому на графике её нет. Это один тест, одна обвязка (mini-swe-v2) и цены API вендоров, а не наши.
Независимый замер: рассуждения на 20-30% короче, ответы те же
Самую подробную проверку в день релиза сделала компания sference, которая сама предоставляет доступ к открытым моделям. Она сравнила старые и новые веса V4.1 Flash, а всё остальное оставила прежним: те же задачи, то же оборудование, те же настройки генерации. Так разница в результатах получается только из-за обновления.
Проверяли на трёх наборах задач, у которых есть точный правильный ответ. Ответы сверяла программа, а не другая нейросеть в роли судьи, поэтому оценка не зависит от чьего-то вкуса:
- AIME 2024 - задачи американской олимпиады по математике (American Invitational Mathematics Examination). Взяли 10 задач, на которых модели рассуждают дольше всего.
- MATH-500 - набор из 500 математических задач разной сложности, от школьных до олимпиадных. Взяли 10 задач, по несколько с каждого уровня сложности.
- BFCL (Berkeley Function Calling Leaderboard) - тест на вызов инструментов, то есть функций, которые модель вызывает по ходу работы. 20 задач: вызвать одну функцию, выбрать нужную из нескольких, вызвать несколько функций сразу и отказаться от вызова, если ни одна функция не подходит.
Каждую задачу прогнали трижды. Старые веса запустили два раза подряд, чтобы измерить случайный разброс: любое различие меньше этого разброса не считается результатом. Всего - 1440 запросов.
Рассуждения короче, ответы те же
- На AIME медианный ответ сократился на 21%, с 1681 до 1124 токенов, а сам текст рассуждений - на 30%.
- Правильных ответов почти столько же: 101 из 120 у старой версии и 100 из 120 у новой. Разница в одну задачу укладывается в случайный разброс.
- На MATH-500 токенов стало меньше примерно на 27%.
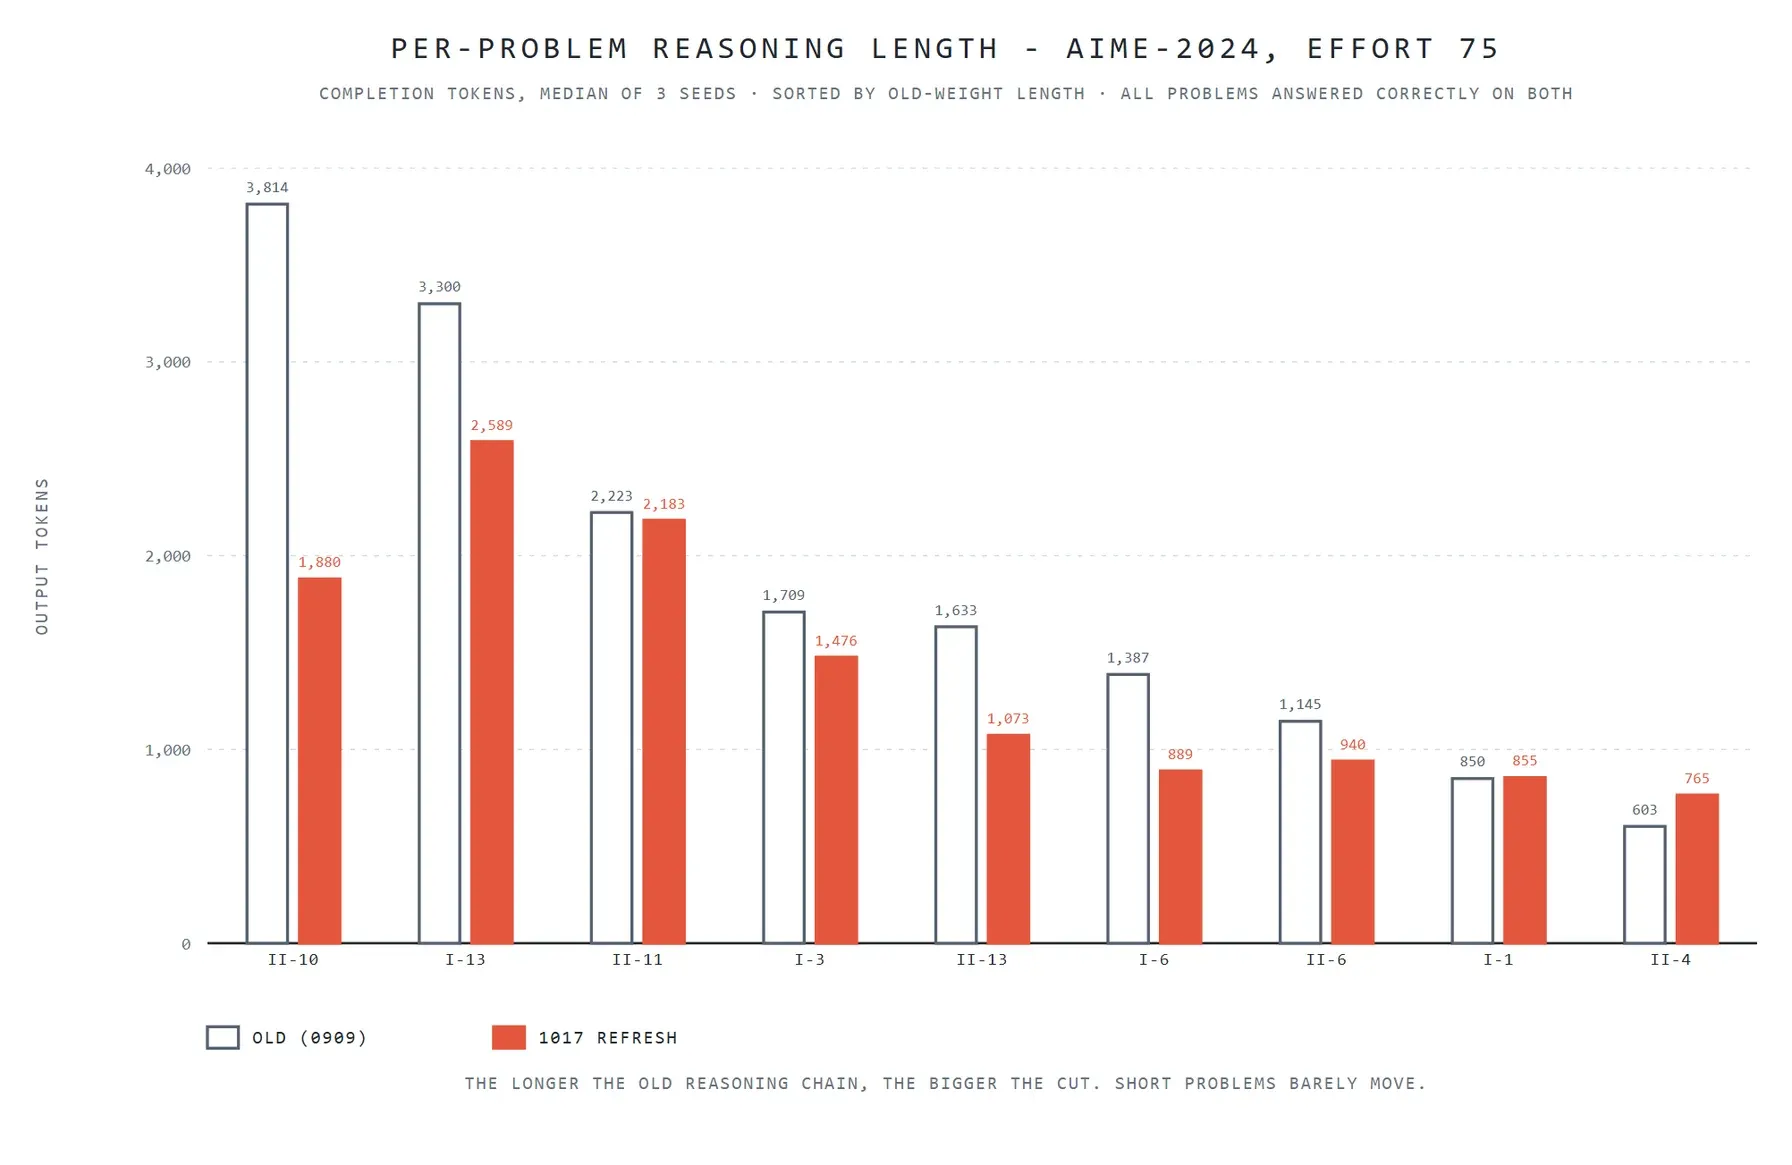
Длина рассуждения на задачах AIME 2024: белые столбцы - прошлая версия, красные - 1017, медиана трёх прогонов. Все задачи на графике обе версии решили правильно. Чем длиннее было рассуждение у старой версии, тем сильнее его сократила новая: самая длинная задача ужалась вдвое, с 3814 до 1880 токенов. Короткие задачи почти не изменились, а две самые короткие стали даже чуть длиннее. График: sference.
Заработала настройка длины рассуждения
В API у V4.1 Flash есть параметр reasoning_effort со значениями от 1 до 100: чем меньше число, тем короче модель должна думать. У старой версии он почти не работал ниже значения по умолчанию. Даже при 1 медиана на сложных задачах была 1974 токена, а при 10 рассуждения выходили ещё длиннее, 2202 токена.
У 1017 настройка работает:
- при значении 1 медиана упала до 790 токенов - на 60% меньше, чем у старой версии с той же настройкой;
- самая длинная цепочка рассуждений сократилась с 10 280 до 5940 токенов;
- точность, по словам автора, держалась на всех проверенных значениях: при 1 модель решила 29 сложных задач из 30;
- при значении 25 модель решила все задачи обоих математических наборов, а обошлось это примерно на 20% дешевле, чем с настройкой по умолчанию.
Для тех, кто платит за API, это главная новость обновления. Раньше понизить reasoning_effort, чтобы сэкономить, почти не получалось, теперь получается.
Вызов инструментов не изменился
В BFCL старая и новая версии ошиблись в одних и тех же задачах:
| Категория | Старая версия | 1017 |
|---|---|---|
| Вызвать одну функцию | 15 из 18 | 15 из 18 |
| Выбрать одну функцию из 2-4 | 9 из 12 | 9 из 12 |
| Вызвать одну функцию несколько раз параллельно | 12 из 12 | 12 из 12 |
| Вызвать параллельно разные функции | 3 из 12 | 3 из 12 |
| Отказаться, если подходящей функции нет | 2 из 6 | 2 из 6 |
Два слабых места видны сразу. Параллельный вызов разных функций модель почти не умеет, но это общая проблема: Kimi K3 и GLM 5.3 в том же тесте справились с 3-5 задачами из 12. И когда подходящей функции нет, модель чаще придумывает вызов, чем отвечает без него. Автор советует держать список инструментов коротким и прямо писать в инструкции, что отвечать без вызова функции можно.
Сравнение с Kimi K3 и GLM 5.3
sference прогнала те же задачи на двух других открытых моделях, все три - с настройками по умолчанию:
| Модель | AIME | MATH-500 | Вызов инструментов | Цена правильного ответа на сложную задачу |
|---|---|---|---|---|
| DeepSeek V4.1 Flash 1017 | 29 из 30 | 30 из 30 | 41 | точка отсчёта |
| Kimi K3 | 28 из 30 | 30 из 30 | 39 | дороже в 5,7 раза |
| GLM 5.3 | 26 из 30 | 29 из 30 | 40 | дороже в 3,4 раза |
Цена здесь посчитана по тарифам API, которые использует sference. GLM 5.3 рассуждает короче всех, примерно вдвое короче V4.1 Flash, но на сложных задачах ошибается чаще. У самой V4.1 Flash правильный ответ на сложную задачу после обновления подешевел примерно на 14%, а в целом на задачах с долгими рассуждениями автор оценивает экономию в 20-30%. Если поставить reasoning_effort на 25, можно сэкономить ещё около 20%.
Оговорки
- В математических наборах всего по 10 задач, поэтому точные баллы надо читать с погрешностью в одну задачу. Но направление изменений совпало на каждой задаче.
- AIME и MATH-500, скорее всего, есть в обучающих данных у всех крупных моделей, так что точность здесь может упираться в потолок. На вывод про длину рассуждений это не влияет.
- Вызовы функций сверяли с эталоном по названию и аргументам, но не выполняли.
- Длину ответа и время ответа - разные вещи: скорость sference не измеряла.
Bug Hunt Bench: поиск багов в реальных репозиториях
Как устроен тест и что получилось
Paweł Huryn (@PawelHuryn) проверил 1017 на своём бенчмарке Bug Hunt Bench: модели получают два репозитория со 105 скрытыми ошибками и должны найти и исправить всё, что смогут. По словам автора, это реальные баги, которые передовые модели пропустили в начале 2026 года. В зачёт идут только заложенные ошибки, исправления проверяются вслепую по закрытому списку ответов. Реальные проблемы, найденные сверх списка, считаются отдельно и в балл не входят: автор пояснил, что некоторые модели OpenAI сообщают много настоящих, но не относящихся к делу замечаний, чтобы завысить результат.
После первого прогона 1017 (режим max) исправила 34 бага из 105, а сентябрьская версия V4.1 Flash в том же режиме - 21,7. Автор назвал это большим улучшением и написал, что странно, что модель не назвали V4.2. Затем он провёл ещё два прогона и отметил, что результат у 1017 плавает сильнее обычного: отдельные прогоны дали 34, 37 и 45 багов, в среднем 38,7. До этого он ожидал, что после трёх прогонов оценка сдвинется примерно на 1,7 пункта.
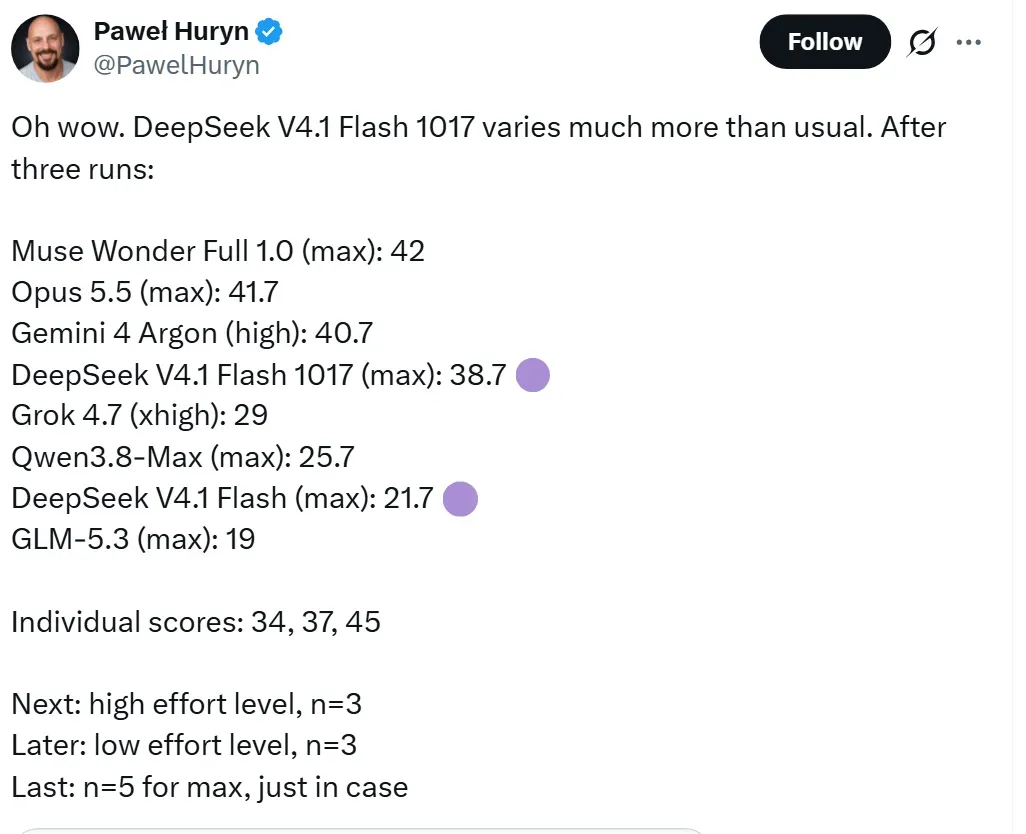
Скриншот поста в X: результаты после трёх прогонов.
Результаты из этого поста:
| Модель (режим) | Исправлено багов из 105 |
|---|---|
| Muse Wonder Full 1.0 (max) | 42 |
| Claude Opus 5.5 (max) | 41,7 |
| Gemini 4 Argon (high) | 40,7 |
| DeepSeek V4.1 Flash 1017 (max) | 38,7 |
| Grok 4.7 (xhigh) | 29 |
| Qwen3.8-Max (max) | 25,7 |
| DeepSeek V4.1 Flash, сентябрь (max) | 21,7 |
| GLM-5.3 (max) | 19 |
Средний результат 1017 ниже, чем у Muse Wonder Full 1.0, Opus 5.5 и Gemini 4 Argon, но заметно выше, чем у Grok 4.7, Qwen3.8-Max и GLM-5.3, и в 1,8 раза выше, чем у сентябрьской версии. Лучший прогон 1017 (45 багов) выше любого среднего значения в этой таблице. Из-за большого разброса по трём прогонам делать точные выводы рано.
На полной таблице бенчмарка (на ней 23 из 117 прогонов, обновлена 17 октября) выше всех стоит Sonnet 5.5 (max) с 51,3 бага, дальше идут GPT-6 Astra (max) с 45 и GPT-6.1 Sol (max) с 44,3. Автор отдельно уточнил, что результат Sonnet верный: он получен за счёт того, что модель делает в 7 раз больше ходов, чем GPT-6 Astra (max). На этой таблице у 1017 пока один прогон: 34 бага, 50,6 минуты и $0,90. Это реальный счёт за API, у большинства остальных моделей стоимость оценена по прайс-листу. Для сравнения, Opus 5.5 (max) набрал 41,7 бага за 66,9 минуты и $58,53, Gemini 4 Argon (high) - 40,7 за 56,5 минуты и $7,16, а Sonnet 5.5 (max) потратил 287,1 минуты и $154,03.
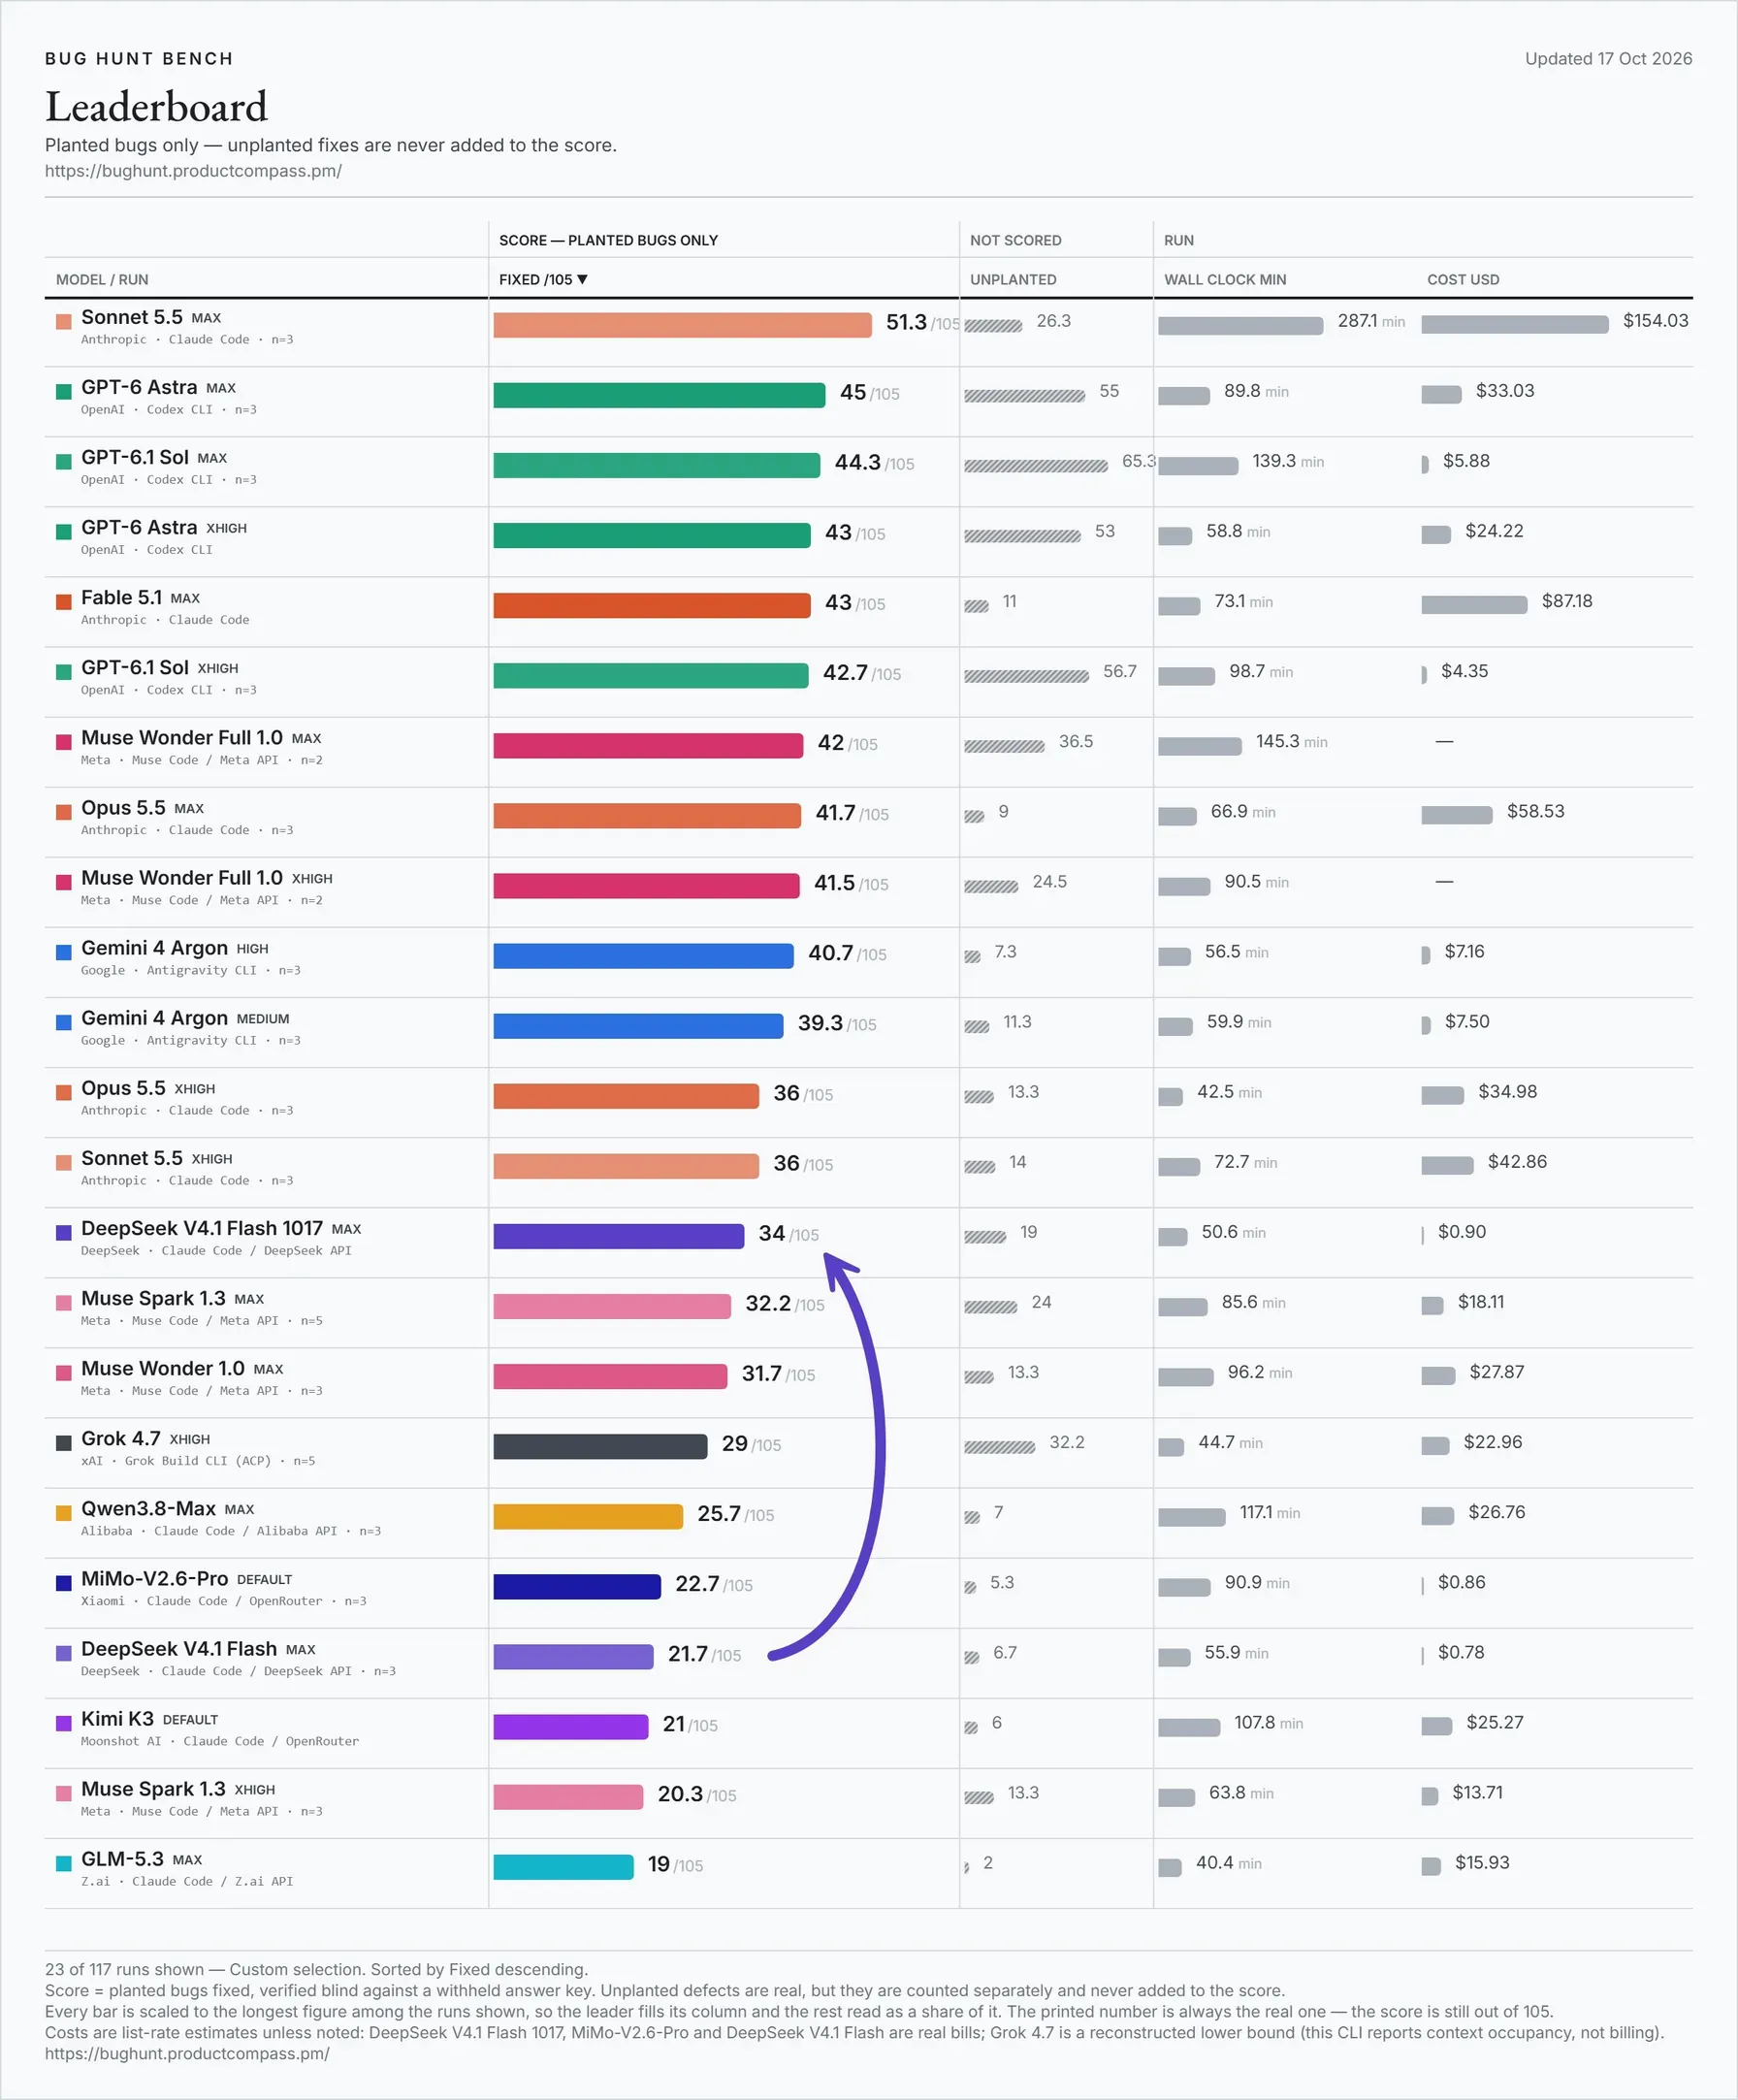
Таблица Bug Hunt Bench (Paweł Huryn): число исправленных багов, время и стоимость прогона. Стрелка отмечает переход от сентябрьской версии к 1017.
Цена и результат
Тот же автор построил диаграмму «результат против стоимости прогона». Ось стоимости логарифмическая, чем левее точка, тем дешевле прогон, чем выше - тем больше багов исправлено. На диаграмме 47 из 118 прогонов, и у 1017 их два: режим max (38,7 бага, около $1) и режим high (32 бага, около $0,8). Стоимость 1017 - реальный счёт, у остальных моделей это оценка по прайс-листу, поэтому сравнение приблизительное. Суммы без точной подписи (около $1, около $0,8, около $3,3, $1,3 и $1,8) считаны с логарифмической оси и приблизительны, баллы взяты из легенды диаграммы.
Что видно на диаграмме:
- Режим max. Среди прогонов с результатом выше 35 багов у 1017 (max) самая низкая стоимость. Ближе всего GPT-6.1 Sol (high) с 36,5 бага за около $3,3. GPT-6.1 Sol (xhigh) исправляет 42,7 бага и стоит $4,35, то есть примерно в 4 раза дороже 1017 при результате на 4 бага выше.
- Режим high. С 32 багами 1017 (high) обходит GPT-6.1 Sol (low) с 22,5 бага за $1,3 и GPT-6.1 Sol (medium) с 29 багами за $1,8, и при этом стоит дешевле обоих.
- Дорогая часть. Claude Opus 5.5 (max) с 41,7 бага стоит $58,53, а Fable 5.1 (max) с 43 багами - $87,18. Результат у них выше, чем у 1017, но цена выше в десятки раз.
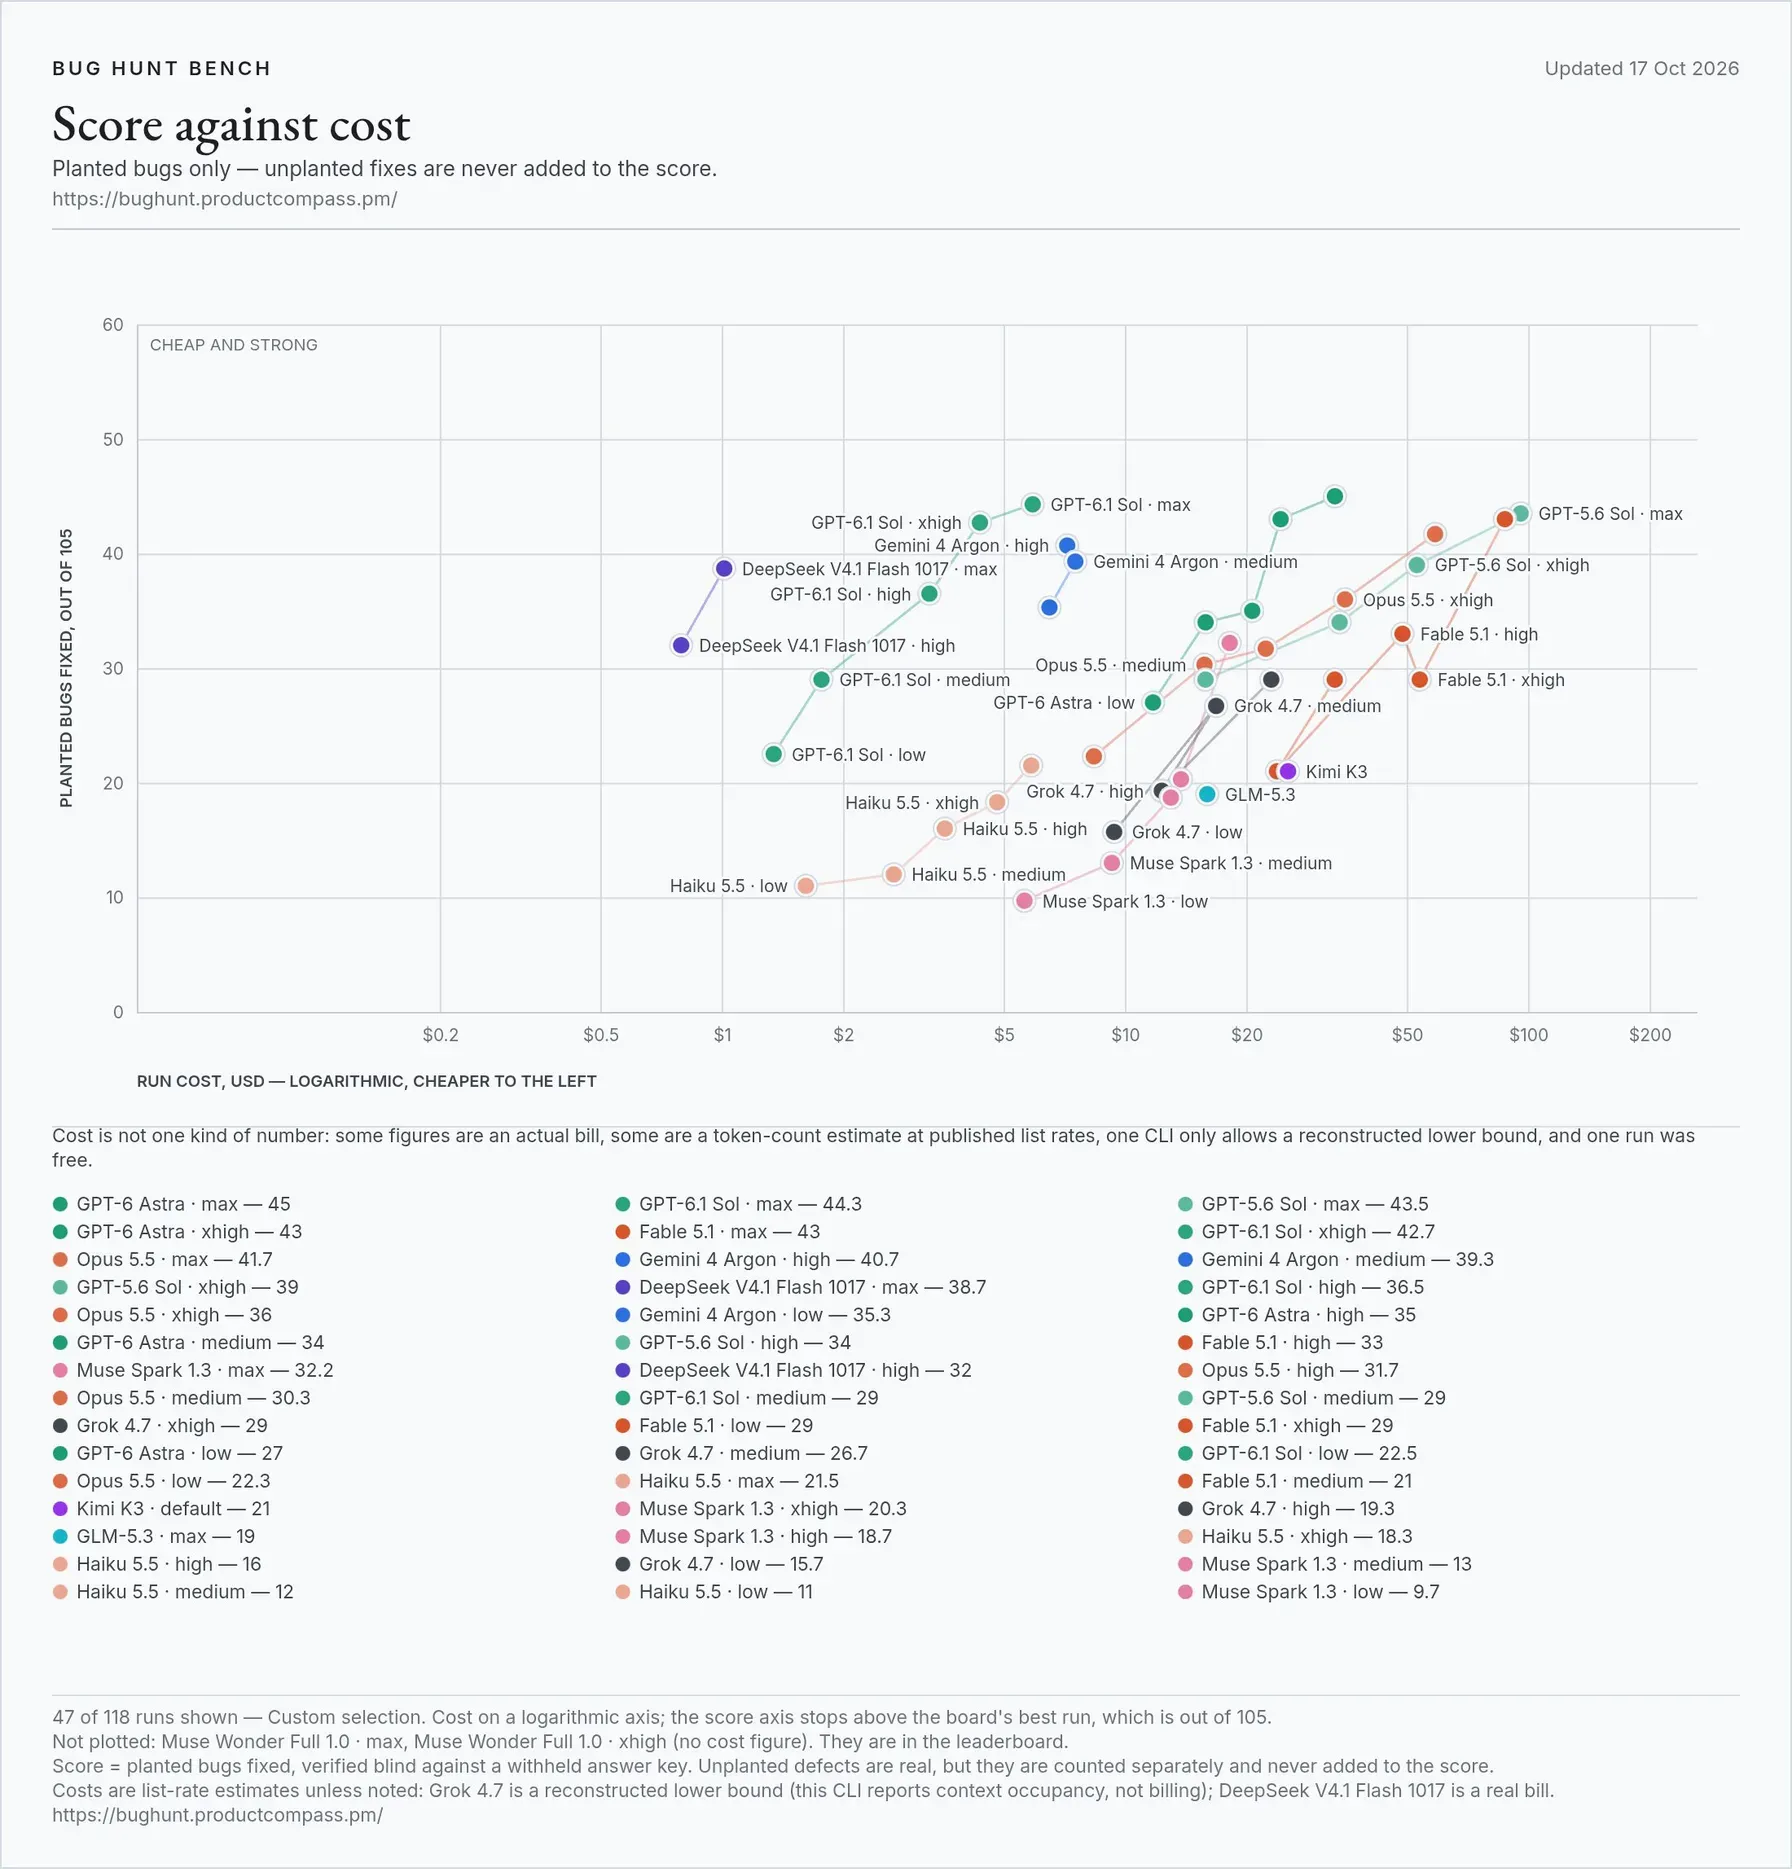
Диаграмма Bug Hunt Bench (Paweł Huryn): результат против стоимости прогона, 47 из 118 прогонов.
Отзывы и бенчмарки пользователей
В первые сутки пользователи выложили несколько своих тестов: на задачах с играми и 3D, в шахматном бенчмарке и в обычной разработке. Это единичные замеры на разных задачах, но их делали сторонние люди, а не DeepSeek.
Запуск ракеты: DeepSeek V4.1 Flash 1017 против GPT-6.1 Sol
Пользователь Bhavy (@Bhavani_00007) попросил DeepSeek V4.1 Flash 1017 и GPT-6.1 Sol сделать сцену запуска ракеты и сравнил результат на видео. По его данным, DeepSeek справился за 3 минуты и $0,78, GPT-6.1 Sol - за 5 минут и $6,10: почти в 8 раз дороже и в 1,7 раза дольше. Сцены получились разные: у DeepSeek ракета стоит у решётчатой башни на фоне зелёных холмов, у GPT-6.1 Sol ракета с боковыми ускорителями, деревья, море и облака. Автор остался очень доволен результатом DeepSeek.
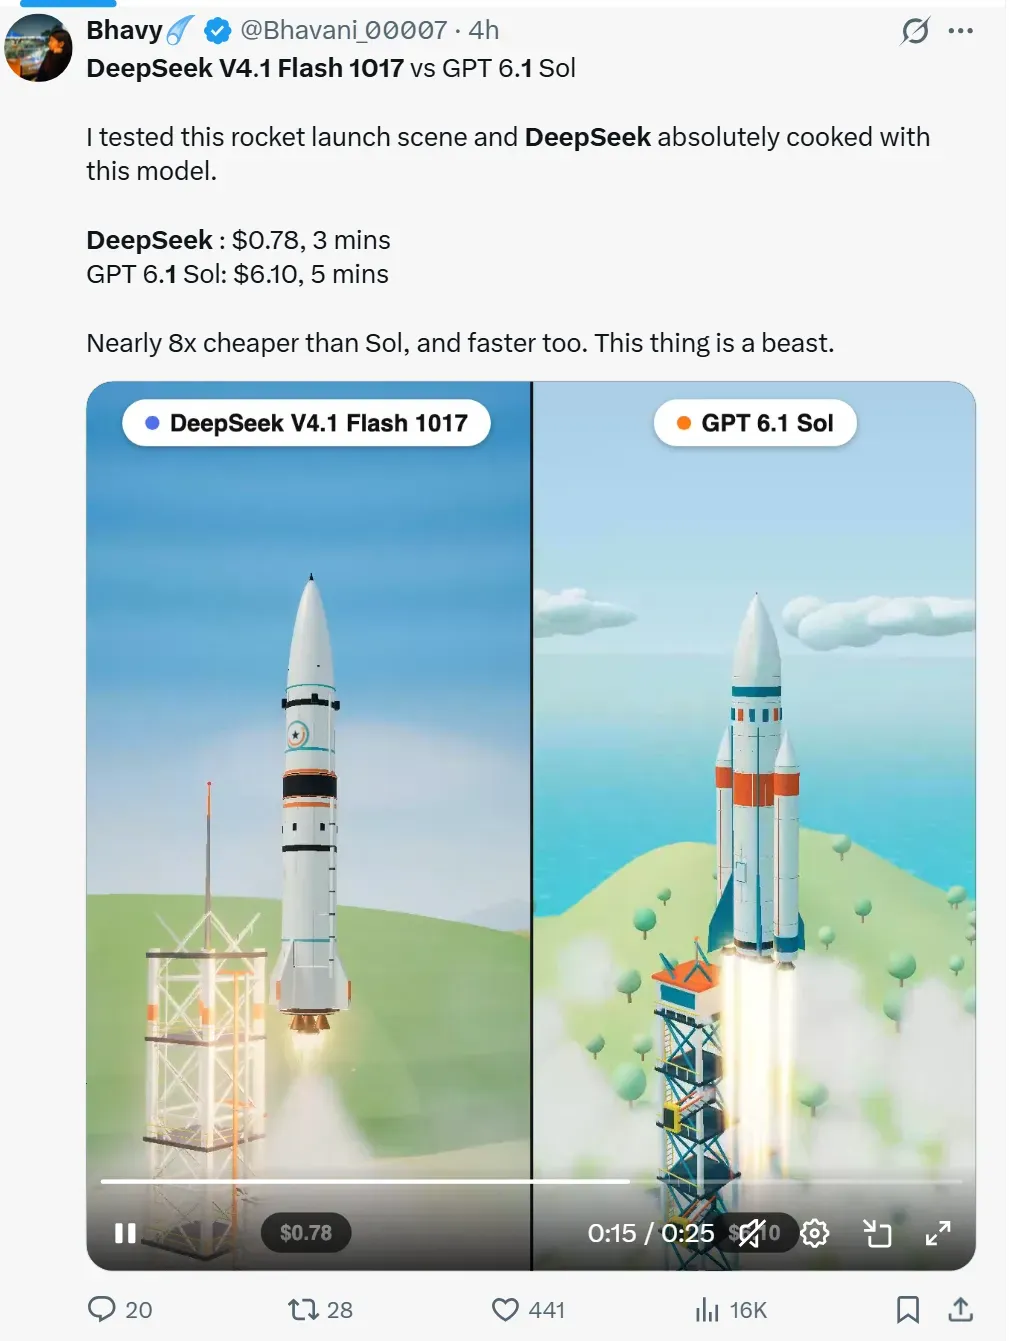
Скриншот поста в X: слева DeepSeek V4.1 Flash 1017, справа GPT-6.1 Sol.
Парящие города: DeepSeek V4.1 Flash 1017 против GPT-6.1 Sol Ultra
Пользователь Iam_ (@SPAC89) сравнил DeepSeek V4.1 Flash 1017 в режиме max и GPT-6.1 Sol Ultra на 3D-сцене: два парящих над облаками города, соединённых петлёй железной дороги с поездом. По его словам, он до сих пор не может поверить, что модель, которая на 90% дешевле, выдаёт такой результат. Время у обеих моделей было примерно одинаковым, потому что большая часть ушла на рендеринг. На скриншоте у DeepSeek ночное небо с луной, облака, круглые острова с башнями и подсвеченным кольцом посередине, у GPT-6.1 Sol Ultra - сетчатые рельсы в виде восьмёрки и башни в голубых и золотых тонах.
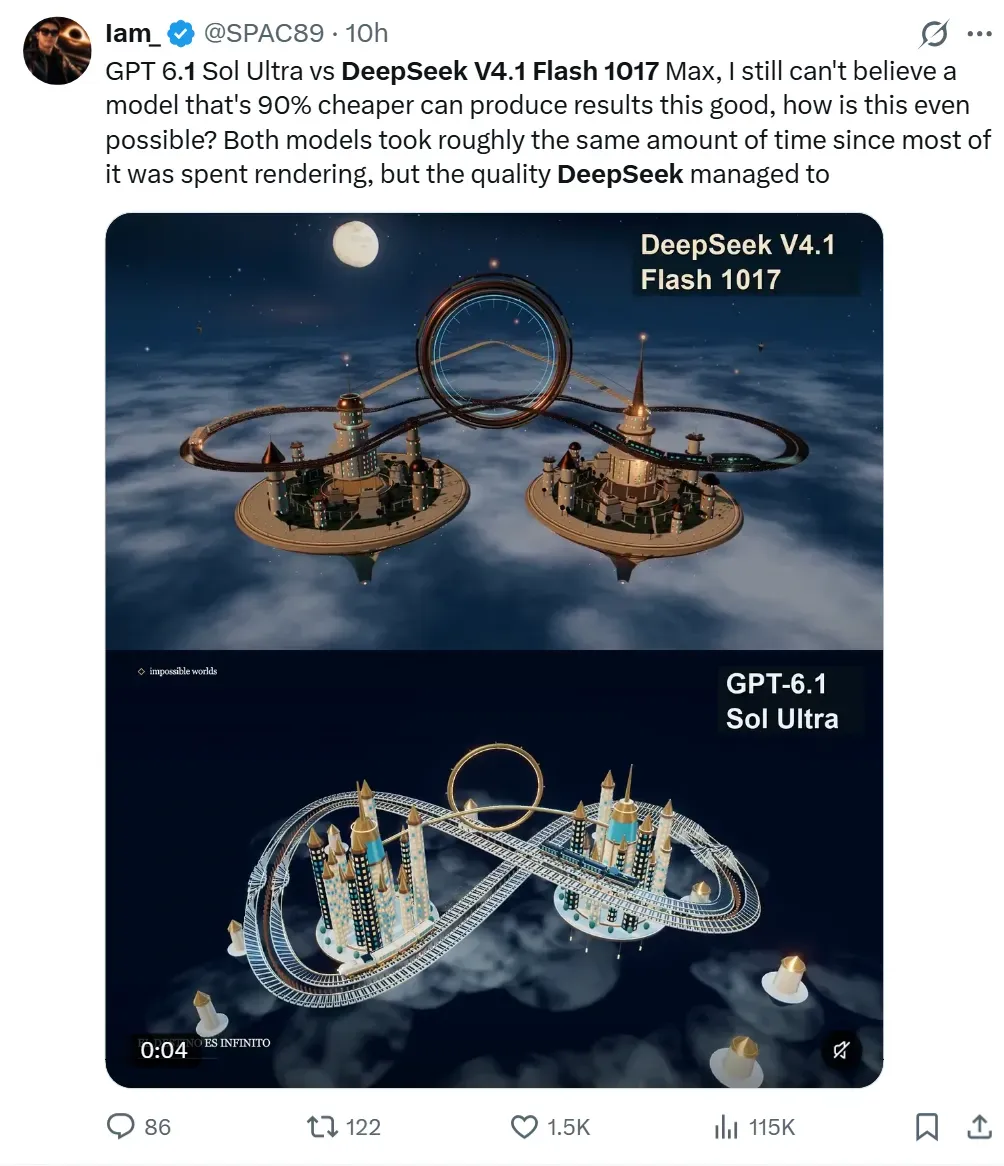
Скриншот поста в X: сверху DeepSeek V4.1 Flash 1017 (max), снизу GPT-6.1 Sol Ultra.
3D-модель Боузера: DeepSeek V4.1 Flash 1017 против Claude Opus 5.5
Пользователь Luckey Faraday (@luckeyfaraday) дал DeepSeek V4.1 Flash 1017 и Claude Opus 5.5 один и тот же запрос в одну строку: собрать 3D-модель Боузера. В карточке с результатами указано, что DeepSeek работал в режиме max, а Opus - в режиме xhigh. DeepSeek потратил 32 минуты 42 секунды, 8,05 млн токенов и $0,15, Opus - 23 минуты 42 секунды, 3,88 млн токенов и $3,85 (стоимость API оценочная). Выходит, что DeepSeek почти в 26 раз дешевле, но дольше на 9 минут и расходует вдвое больше токенов. Оба Боузера узнаваемы: у DeepSeek более тёмный и рельефный, с тёмно-зелёным панцирем и оранжевым животом, у Opus - светло-зелёный, более гладкий и мультяшный.
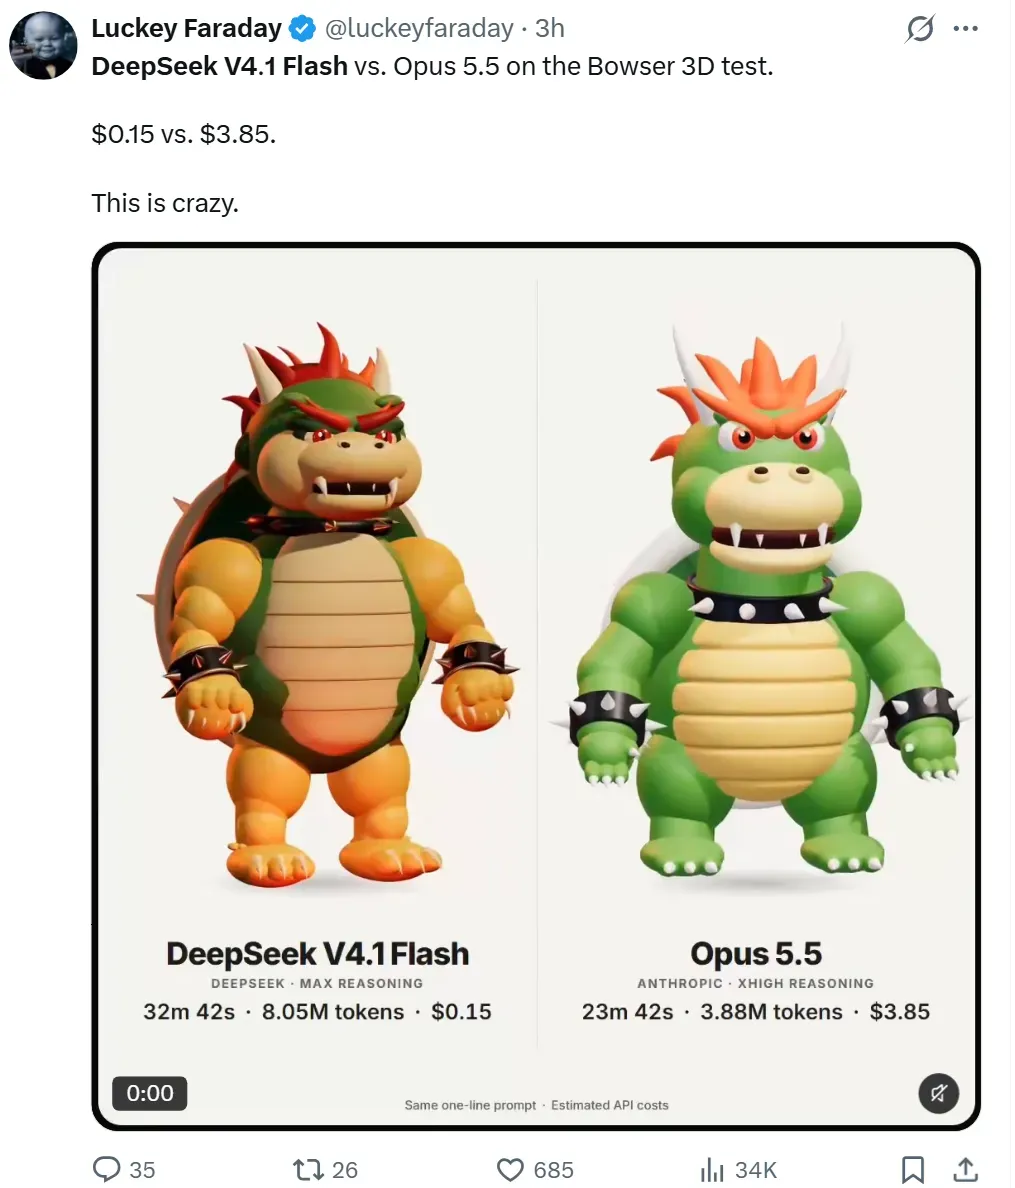
Скриншот поста в X: слева DeepSeek V4.1 Flash 1017, справа Claude Opus 5.5. Один запрос, стоимость оценочная.
Пчела на подсолнухе в 3D
Пользователь Loktar (@loktar00) написал, что 1017 хорошо справляется с 3D, и показал видео: в DeepSeek Harness за один ход модель собрала сцену с пчелой на подсолнухе. В подписи к видео указано 964 тыс. токенов. Это единичный пример без сравнения с другими моделями, поэтому он показывает, что результат возможен, а не насколько он лучше других.
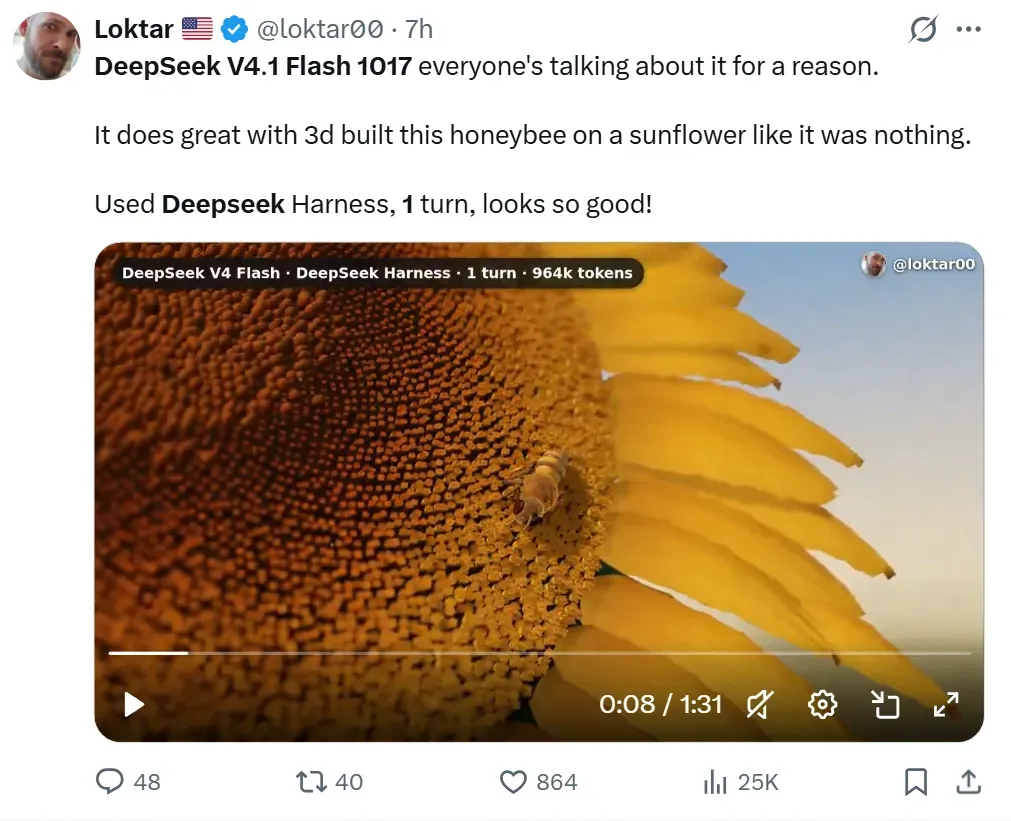
Скриншот поста в X: кадр из видео, подпись в углу - DeepSeek Harness, один ход, 964 тыс. токенов.
Паркур-забег: четыре модели, один запрос
Один из пользователей дал четырём «быстрым» моделям одинаковое задание: сделать паркур-забег от первого лица в одном HTML-файле, четыре этапа, один фиксированный раунд. По его словам, у DeepSeek получились лучшие эффекты из четырёх: город из тысяч светящихся окон. Вот что потратила каждая модель (данные из поста, видео с логотипом thehype):
| Модель | Токенов | Время | Цена прогона по сравнению с DeepSeek |
|---|---|---|---|
| DeepSeek V4.1 Flash 1017 | 298 тыс. | 1 ч 27 мин | точка отсчёта |
| Claude Haiku 5.5 | 62,3 тыс. | 23 мин 33 с | дешевле на 43% |
| GPT-6 Luna | 62,4 тыс. | 8 мин 7 с | дешевле в 3,9 раза |
| Qwen 3.8 Flash | 448 тыс. | 2 ч 4 мин | дороже на 61% |
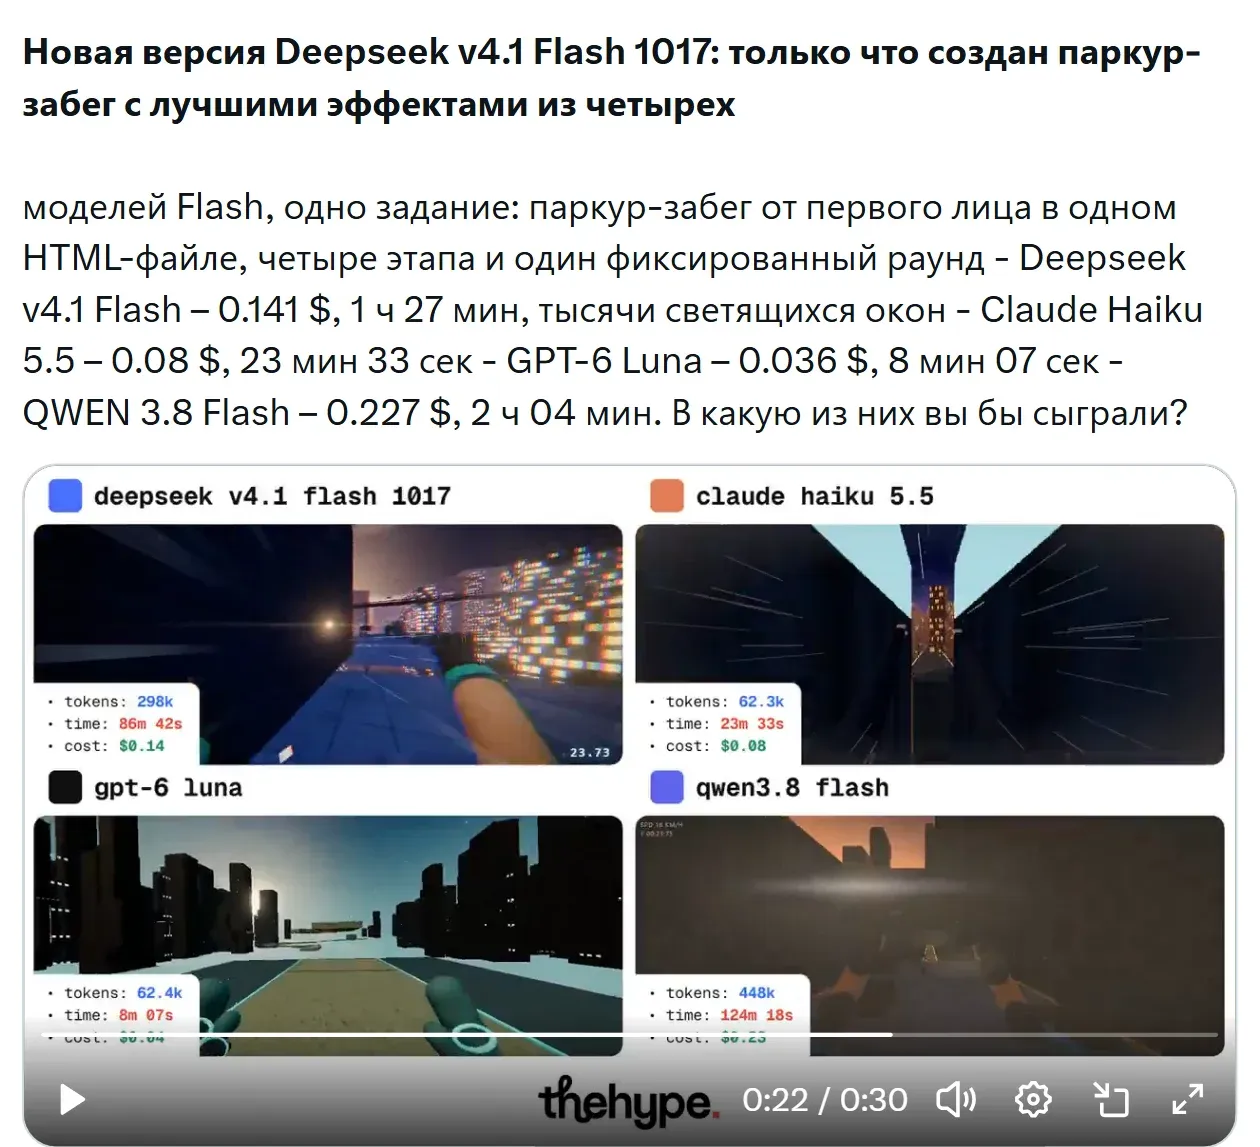
Скриншот поста в X (видео с логотипом thehype): сцены четырёх моделей и расход на каждую. Слева сверху DeepSeek V4.1 Flash 1017.
В комментариях под постом согласились, что у DeepSeek получилась лучшая версия среди GPT-6 Luna, Claude Haiku 5.5 и Qwen 3.8 Flash. Цена за это - расход: токенов у него в 4,8 раза больше, чем у GPT-6 Luna, а времени уходит в 10,7 раза больше. То есть заявление «ответы стали короче» относится к сравнению с прошлой версией DeepSeek, а не со всеми конкурентами. С прошлой версией в этом тесте никто не сравнивал.
Трасса с Tesla Roadster в вокселях
Другой пользователь (пост со ссылкой на сервис atomic.chat) попросил DeepSeek V4.1 Flash 1017 и GPT-6 Luna воссоздать в 3D-вокселях событие с Tesla Roadster. Прогон DeepSeek, по данным автора, обошёлся на 17% дешевле, чем у GPT-6 Luna. На скриншоте видно, что обе модели сделали рабочую сцену со счётчиками перегрузки и высоты. У GPT-6 Luna вокруг трассы более проработанная металлическая конструкция, у DeepSeek - проще, зато есть робот и прожекторы.
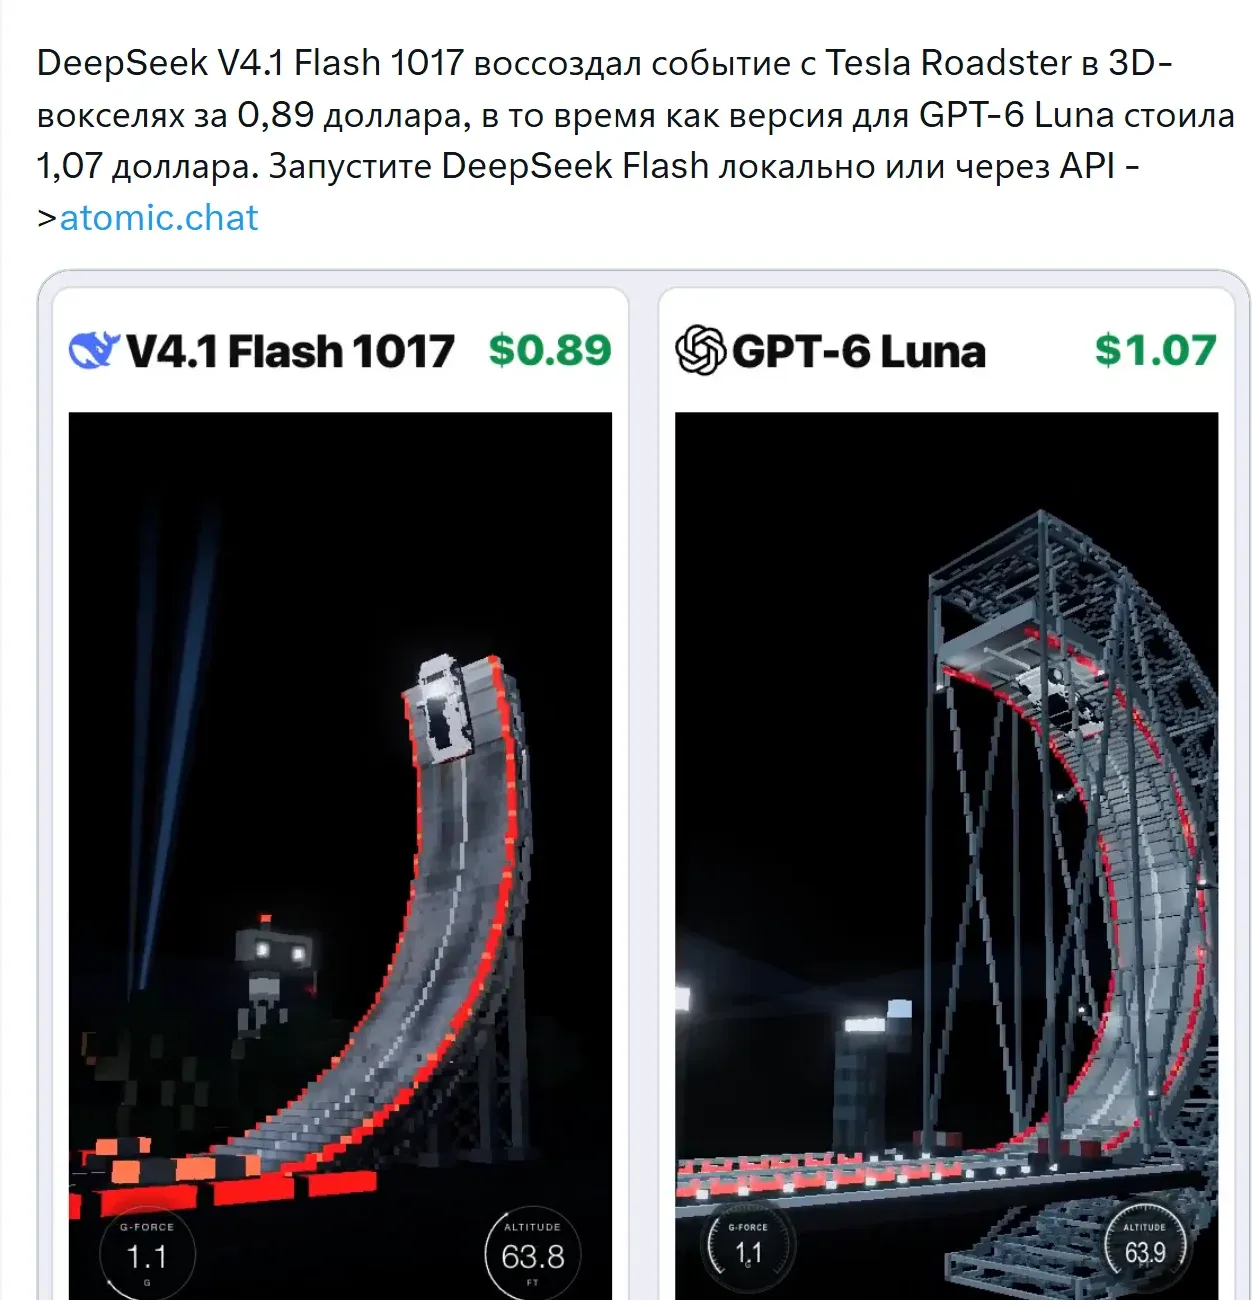
Скриншот поста в X: слева DeepSeek V4.1 Flash 1017, справа GPT-6 Luna.
Интерактивный персонаж: Claude Opus 5.5 против DeepSeek V4.1 Flash 1017
Пользователь @karanC_12 сравнил DeepSeek V4.1 Flash 1017 с флагманом Anthropic. Обе модели собирали 3D-площадку с мягким персонажем, которого можно хватать, сжимать, растягивать и тыкать, с переключателем настроения и выбором одежды (видео взято у автора @marcthecreatorr). Claude Opus 5.5 работал в режиме xhigh, DeepSeek - в режиме max. По данным автора, Opus справился за 20 минут и $6, DeepSeek - за час и $0,23. Автор считает, что Opus сделал лучше, но DeepSeek получился неожиданно близко при цене в 26 раз ниже.
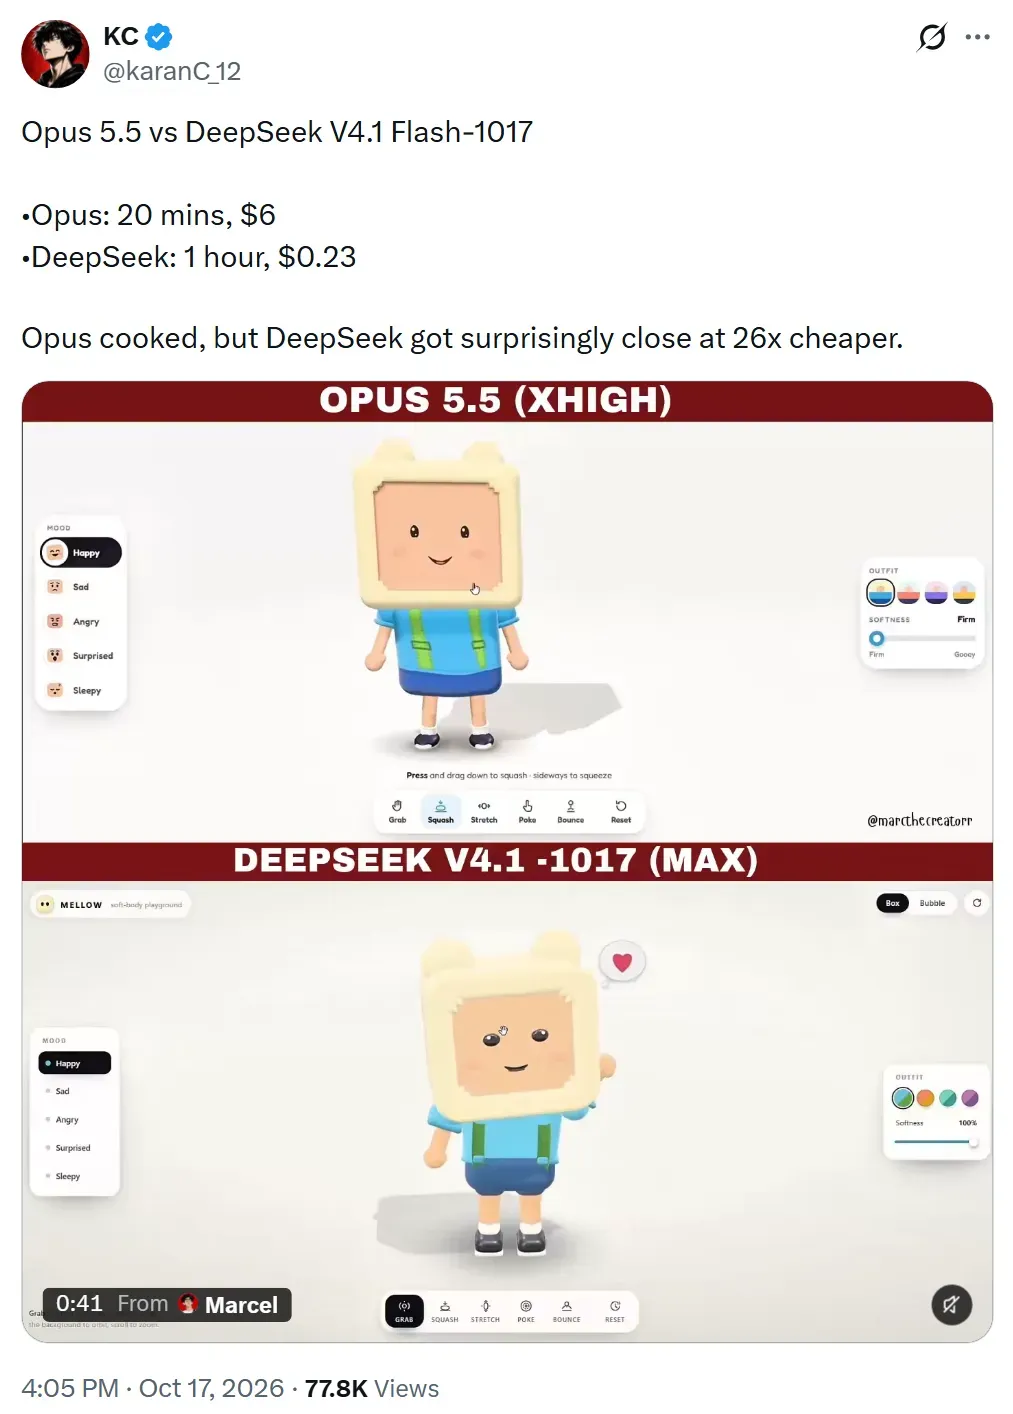
Скриншот поста в X: сверху Claude Opus 5.5 (xhigh), снизу DeepSeek V4.1 Flash 1017 (max).
Шахматы: ChessBench
На chessbench.org языковые модели играют в шахматы друг с другом и получают рейтинг Эло. Каждой модели в начале хода дают список разрешённых ходов, а нелегальный ход считается «жульничеством» и отклоняется. Рейтинг сравнивает модели только внутри этого теста и не равен рейтингу на шахматных сайтах. Вот таблица на 17 октября, 17:16 UTC (оттуда выбраны модели, которые есть в нашем каталоге или интересны для сравнения):
| Место | Модель | Рейтинг Эло | Побед | Нелегальных ходов |
|---|---|---|---|---|
| 1 | Gemini 4 Argon | 2159 | 92% | 0,17% |
| 2 | Claude Opus 5.5 | 2109 | 89% | 0,54% |
| 4 | GPT-6 Astra | 2033 | 85% | 0,02% |
| 6 | GPT-6.1 Sol | 1817 | 67% | 0,00% |
| 8 | DeepSeek V4.1 Flash 1017 | 1692 | 52% | 0,32% |
| 9 | Kimi K3 | 1609 | 45% | 1,15% |
| 10 | DeepSeek V4.1 Flash (сентябрь) | 1540 | 42% | 0,87% |
| 12 | GLM 5.3 | 1497 | 38% | 1,54% |
| 14 | GPT-6 Luna | 1400 | 20% | 0,42% |
Обновлённая версия поднялась на 152 пункта и на две строки: с 10-го места на 8-е. Она обошла Kimi K3, GLM 5.3 и GPT-6 Luna, но уступает Claude Opus 5.5, Gemini 4 Argon, GPT-6 Astra, GPT-6.1 Sol и ещё трём моделям Anthropic: Sonnet 5.5, Fable 5.1 и Haiku 5.5. Автор бенчмарка (@bylupu) отметил, что цена и расход токенов почти не изменились (218,7 тыс. токенов на партию вместо 228,9 тыс.), а доля нелегальных ходов заметно упала: с 0,87% до 0,32%. При этом время на ход выросло с 32,0 до 38,3 секунды. Это единственный замер в статье, где 1017 можно сравнить и с прошлой версией, и с флагманами на одной задаче, и картина согласуется с таблицей DeepSeek: заметно лучше предшественницы и конкурентов своего класса, но не на уровне флагманов.
Впечатления разработчиков
- Анимации. Пользователь 花叔 пишет в X (пост на китайском), что по уровню анимационных эффектов 1017 «невероятно впечатляет» и всего на ступеньку ниже Claude, а с GPT-6 ему не удалось получить таких результатов. Он оговаривается, что использовал собственный навык для анимаций, который только что сделал, и результат получен в сочетании с ним.
- Скорость. Пользователь 张晓宇 (@xiaoyu_agi) сравнил три 3D-сцены: Claude проработал их тщательнее, но на задачу ушло от 40 минут до часа, а у 1017 - чуть больше десяти минут.
- Проекты с нуля. Разработчик Деннис Мартин Херберс через DeepSeek Harness дал самый простой запрос: создать Angular-приложение для показа компонентов Angular Material и библиотеки CDK. Запрос опирался на официальные навыки Angular, которые были подключены заранее, и модель собрала демонстрацию сама, без дополнительных подсказок.
- Быстрее, но не в чате. Пользователь r/LocalLLaMA прогнал обе версии на своём наборе задач для чата и инструментов и привёл таблицу: медианное время ответа упало с 16,8 до 7,4 секунды, а его итоговая оценка качества выросла с 3,46 до 3,62. Как считается эта оценка, автор не написал, поэтому ориентируйтесь на время. Старую версию он гонял через другого провайдера, так что цифры приблизительные.
Чего пока нет
Artificial Analysis 1017 ещё не измерила. У них есть замер только сентябрьской версии: 39 баллов индекса и 9-е место из 120 на момент проверки. Поэтому сводного индекса качества от Artificial Analysis для 1017 пока нет, а независимых замеров качества два: Bug Hunt Bench и шахматный рейтинг ChessBench.
Вместе отзывы показывают четыре вещи. Во-первых, на визуальных задачах (анимации, игры, 3D) пользователи довольны результатом и часто сравнивают его с моделями Anthropic и OpenAI. Во-вторых, во всех сравнениях с флагманами прогон DeepSeek заметно дешевле: почти в 8 раз, чем у GPT-6.1 Sol, и в 26 раз, чем у Opus 5.5. В-третьих, по скорости данные неоднозначные: 1017 быстрее своей прошлой версии (7,4 секунды против 16,8), GPT-6.1 Sol в сцене с ракетой (3 минуты против 5) и Claude в трёх 3D-сценах (чуть больше 10 минут против 40-60), но Opus 5.5 в двух других сравнениях закончил раньше (23 минуты против 32 и 20 минут против часа), а в сравнении с GPT-6 Luna и Claude Haiku 5.5 всё зависит от задачи. В-четвёртых, экономия токенов подтверждена только на математике: в паркур-забеге модель потратила в 4,8 раза больше токенов, чем GPT-6 Luna, в сцене с Боузером - вдвое больше, чем Opus 5.5, а в шахматах расход почти не изменился.
Почему «Flash» весит 763 миллиарда параметров
По карточке модели у неё 763 млрд параметров: 552 млрд в основной части и 196 млрд в Engram - таблицах памяти на n-граммах, к которым модель обращается по токенам. На каждый токен работают только 8 млрд параметров при чтении запроса и 16 млрд при генерации. Поэтому «Flash» здесь про скорость, а не про размер.
Ещё одна деталь объясняет, почему DeepSeek может дёшево отдавать контекст в 1 млн токенов: KV-кэш занимает 890 байт на токен, примерно вчетверо меньше, чем у V4 Flash. Лицензия MIT, веса можно скачать, но это серверный класс: на домашнем компьютере такую модель не запустить.
Слабые места
- Галлюцинации. Самая частая жалоба на прошлые версии в обоих тредах Reddit. Исправило ли это обновление, пока никто не показал.
- Выдуманные вызовы инструментов. Замер sference выше: когда подходящей функции нет, модель охотнее придумывает вызов, чем говорит «не могу».
- Агент делает то, что запретили. Один пользователь пишет, что V4.1 Flash прочитала файлы с секретами вопреки запрету, и ключи пришлось перевыпускать. В ответах советуют вместо «не читай секреты» писать «читай только в этой папке», а секреты держать вне досягаемости агента: в отдельном контейнере, менеджере секретов или под тестовыми ключами.
- Привязка к своей обвязке. Модель отдельно настраивали под собственный DeepSeek Harness и два инструмента партнёра Tencent. Лицензия MIT позволяет запускать её где угодно, но в другом окружении результат может отличаться от того, что показывает DeepSeek.
- Модель обновляется под тем же именем. DeepSeek рекомендует обращаться к модели как
deepseek-flash. Старые именаdeepseek-v4-flashиdeepseek-v4-flash-vision-expещё принимаются, но отвечает по ним уже 1017. Если вы сравнивали модели по старым прогонам, повторите их.
Поиск для агентов: бесплатно до 31 октября
В тот же день DeepSeek открыла для всех Search и Fetch в API: поиск по собственному движку и загрузку страниц. Цена - 5 юаней за 1000 вызовов каждого (в прайсе указано 0,75 доллара). Вызовы, которые идут через DeepSeek Harness, Claude Code или Codex, пока не тарифицируются. Платными они станут с 00:00 по Пекину 1 ноября, то есть в 19:00 по Москве 31 октября.
Сколько это стоит в GPTunneL
Цена задачи складывается из цены токена и того, сколько токенов модель тратит. Первое у нас фиксировано, второе зависит от вашей задачи. Вот цены в нашем каталоге за 1000 токенов для моделей с графика:
| Модель | Ввод, ₽ | Вывод, ₽ | Вывод по сравнению с DeepSeek V4.1 Flash |
|---|---|---|---|
| DeepSeek V4.1 Flash | 0,06 | 0,24 | точка отсчёта |
| GLM 5.3 Flash | 0,03 | 0,1 | дешевле в 2,4 раза |
| GPT-6 Luna | 0,04 | 0,2 | дешевле на 17% |
| Gemini 3.8 Flash | 0,3 | 1,5 | дороже в 6,3 раза |
| Kimi K3 | 0,6 | 3 | дороже в 12,5 раза |
| GPT-6.1 Sol | 0,8 | 4 | дороже в 16,7 раза |
| Claude Opus 5.5 | 1,2 | 6 | дороже в 25 раз |
| GPT-6 Astra | 2 | 10 | дороже в 41,7 раза |
Запрос на 2000 токенов с ответом в 1000 токенов обойдётся в DeepSeek V4.1 Flash примерно в 0,36 ₽, в GPT-6.1 Sol - в 5,6 ₽, в Opus 5.5 - в 8,4 ₽. Это при одинаковой длине ответа. На деле модели тратят разное число токенов, а DeepSeek рассуждает долго: сентябрьская версия, по замеру Artificial Analysis, потратила на их индекс 250 млн выходных токенов. У 1017 ответы, по замеру sference, короче на 21-30%, но сравнивать всё равно лучше цену выполненной задачи.
Когда брать DeepSeek V4.1 Flash, а когда нет
Подходит:
- Агент разбирает тикеты в репозитории или автоматизирует рутину. Это сценарий, где 1017 сильнее всего и по качеству, и по цене задачи. Прогоните 10-20 своих задач и сравните цену выполненной задачи, а не цену токена.
- Вы уже работаете с V4.1 Flash через API. Попробуйте понизить
reasoning_effort, например до 25: в замере sference при этом значении модель решила все математические задачи, а обошлось это примерно на 20% дешевле, чем с настройкой по умолчанию. Проверьте на своих задачах, держится ли точность.
Лучше взять другую модель:
- Нужны точные ответы на сложные вопросы без инструментов. Здесь DeepSeek слабее: 42,6 против 56,3 у Opus 5 по HLE, а у Opus 5.5 цифры ещё выше. Если цена ошибки для вас выше разницы в цене запроса (0,36 ₽ против 8,4 ₽ в примере выше), берите Opus 5.5.
- Нужно очень много простых ответов за копейки. GPT-6 Luna и GLM 5.3 Flash дешевле за токен, но на графике DeepSWE у них около 61-64% против 77%. Если задачи простые, разница в качестве может и не проявиться.
Проверьте до переезда: сценарий с параллельным вызовом многих разных инструментов. 1017 в замере sference прошла его на 3 из 12. Kimi K3 и GLM 5.3 там же справились не лучше, так что переход на них эту проблему не решит.
Отдельно, для тех, кто следит за открытыми весами: 16 октября власти Китая опубликовали проект правил экспорта ИИ-технологий, где открытые релизы получают упрощённое заявительное оформление, а DeepSeek в документе не упоминается (разъяснение МОФКОМ, проект ещё обсуждается).
Где попробовать
DeepSeek V4.1 Flash есть в каталоге GPTunneL, все модели семейства собраны на странице DeepSeek. Удобнее всего сравнивать на одной и той же задаче: отправьте её в V4.1 Flash, GPT-6.1 Sol и Opus 5.5 и посмотрите, кто справится и сколько это будет стоить. Чем DeepSeek Flash отличается от Pro, мы разбирали отдельно, а как устроены агенты, которым эта модель предназначена, - в статье про ИИ-агентов.
Источники
- Анонс DeepSeek в X, 17.10.2026 - обещания релиза и демо
- Changelog DeepSeek API, запись 17.10.2026
- Карточка DeepSeek-V4.1-Flash-1017 - полная таблица тестов
- Карточка DeepSeek-V4.1-Flash и технический отчёт - устройство модели
- Документация DeepSeek: модели и Search & Fetch - названия моделей, срок бесплатного поиска
- sference: замер 1017 против прошлой версии, 17.10.2026
- ChessBench - рейтинг языковых моделей в шахматах, снимок от 17.10.2026, 17:16 UTC
- Bug Hunt Bench - рейтинг поиска багов (Paweł Huryn), таблица от 17.10.2026
- The Decoder: обзор релиза - про обучение на самооценке
- Обсуждения на r/DeepSeek и r/LocalLLaMA