
Baidu представила ERNIE 5.5 Flash Preview — нейросеть с 280 млрд параметров и контекстным окном до 1 млн токенов, ориентированную на программирование, автоматизацию и работу ИИ-агентов. В бенчмарках модель демонстрирует сильные результаты при работе с документами, таблицами и инструментами, в отдельных тестах опережая даже Claude Opus 5.5 и GPT-6.1 Sol, но заметно уступая им в сложных задачах рассуждения. Baidu также показала создание игр, 3D-моделей и аналитических отчётов с помощью автономных агентов. Главное преимущество новинки — сочетание развитых агентных возможностей и относительно низкой стоимости API, хотя её реальная экономическая эффективность ещё требует независимой проверки.
В демонстрации новинка за 11 часов собрала игру на Unreal Engine 5.8, работала в Blender и FreeCAD, создавала многостраничные исследования, финансовые таблицы и видеоролики. Это не значит, что один запрос к модели автоматически заменит разработчика, инженера или аналитика: примеры запускались в агентных средах, с инструментами и готовыми ресурсами. Но они показывают, на какой рынок Baidu нацелила новую модель: автономные ИИ-агенты, выполняющие проект от постановки задачи до файлов результата.
У ERNIE 280 млрд параметров, из которых на каждом токене активны около 14 млрд, контекст до миллиона токенов и заявленная скорость генерации свыше 200 токенов/с. Модель доступна через Baidu Qianfan. Весá Preview разработчик обещает опубликовать под Apache 2.0; в китайских материалах фигурирует ориентир до 25 ноября 2026 года, однако на дату этой статьи веса ещё не выпущены. [1], [2]
Главное по тестам: ERNIE лидирует среди всех семи моделей в опубликованной Baidu таблице по AutomationBench, SpreadsheetBench V2 и MCP-Atlas. Но на Terminal-Bench-Science она набрала 21,0% против 57,0% у GPT-6.1 Sol и 63,3% у Claude Opus 5.5. На AA-Omniscience-Public разрыв также велик: 25,2% против 52,8% и 62,0%. Поэтому её сильная сторона — не универсальный интеллект, а определённые типы работы с инструментами. [1]
Чем ERNIE 5.5 Flash Preview отличается от обычной Flash-модели
Baidu выпустила не просто новую версию модели для чата. Preview — первый этап дополнительного обучения (post-training) на базе ERNIE 5.5 Flash Base, опубликованной ранее. При этом Baidu прямо называет его промежуточной контрольной точкой: дообучение продолжается, а некоторые навыки могут работать нестабильно. [1]
| Параметр | Характеристика |
|---|---|
| Разработчик | Baidu |
| Дата анонса | 11 ноября 2026 года |
| Архитектура | MoE, в том числе multi-router MoE; гибридное разреженное внимание |
| Параметры | 280 млрд всего / около 14 млрд активны на токен |
| Контекст | До 1 млн токенов |
| Доступный вход | Текст; работа с другими форматами через внешние инструменты |
| Генерация | Свыше 200 токенов/с по заявлению Baidu, не гарантированная скорость каждого запроса |
| Доступ | API Baidu Qianfan, модель ernie-5.5-flash-preview |
| Статус | Preview, дополнительное обучение не завершено |
| Открытые веса | Анонсированы под Apache 2.0, но на 12.11.2026 не опубликованы |
280 млрд — не то же самое, что 280 млрд активных вычислительных параметров. Благодаря Mixture of Experts на генерации каждого токена участвует лишь часть блоков. Это снижает стоимость вычислений по сравнению с активацией всех весов, хотя развернуть полную модель всё равно нельзя на аппаратуре, рассчитанной только на 14 млрд параметров.
По сообщениям китайских технических изданий, в модели используются multi-router MoE, гибридное разреженное внимание, подход ECHO для предсказания нескольких токенов и оптимизация экспертных весов FP4. В материалах Baidu Qianfan отдельно упоминаются FP4 и механизмы ускорения генерации. Это технологические решения, объясняющие заявленную эффективность, но для проверки фактической скорости и цены успешной задачи нужны независимые замеры. [2], [3]
Почему фокус сместился на агентные системы
По данным Baidu, для усиления программирования использовано более 14 млн исполняемых кодовых задач и траектории работы разных агентных фреймворков. Для офисных и отраслевых задач компания подготовила 300 тыс. рабочих пространств, 10 млн справочных файлов и более 40 типов документов. Часть виртуальных пространств содержала десятки файлов, часть — тысячи. [1], [2]
Это важное отличие от обучения просто отвечать на вопросы. Агент должен составить план, вызвать программу, проверить промежуточный результат, заметить ошибку и исправить её. Именно такие навыки Baidu демонстрирует в проектах ниже.
11 часов в Unreal Engine: модель написала игру, не видя экран
Самая выразительная демонстрация — Yunxiu Xing, игра от третьего лица в жанре уся на Unreal Engine 5.8. В одном 11-часовом агентном запуске ERNIE интегрировала ресурсы, подготовленные под разные поколения Unreal Engine, и написала игровой код на C++. В сцене использовались сторонние модели горного ландшафта Чжанцзяцзе и героини. [1]
Особенно любопытно, как модель исправляла ошибки. ERNIE 5.5 Flash Preview — текстовая модель, она сама не видит изображение игрового экрана. Поэтому проблемы из тестирования — персонаж парит над землёй, направление бега не совпадает с управлением, камера стоит неправильно — переводились в проверяемые программные условия. По мере итераций накапливались тесты и менялись игровые механики.
Это гораздо интереснее обычного «ИИ написал код по промпту»: задача заключалась в длительной корректировке работающего проекта, а не в разовой генерации ответа. Вместе с тем опубликованное видео — демонстрация разработчика, а не контрольный эксперимент с независимой проверкой.
Вторая демонстрация — почти 100 мобильных мини-игр по готовым игровым дизайн-документам. Использовались Cocos, Unity, LayaAir, PixiJS и Canvas 2D; в публичном видео показаны 24 проекта. Среди жанров — tower defense, roguelike, гоночные игры, карточные RPG и головоломки. Во многих случаях правила отделялись от визуального представления: алгоритмы проверяли достижимость уровней и баланс.
Где это применимо: быстрые игровые прототипы, проверка механик, генерация вспомогательных систем, перенос проектов между версиями движков. Где осторожность: безопасность кода, качество игрового баланса и стабильность крупных репозиториев всё ещё требуют ручной проверки.
Blender и CAD: ИИ как координатор инженерного процесса
Baidu отдельно дообучала модель работе с Blender и CAD, включая пространственное мышление, процедурное моделирование и повторное использование готовых ресурсов. [1]
Аэропорт и авиалайнер. Два агента на базе ERNIE через Blender Python API строили разные части проекта: один — аэропорт, второй — самолёт. Система находила геоданные, подбирала внешние модели и текстуры, строила терминал, полосу, фюзеляж и интерьеры, после чего согласовывала масштабы и ракурсы. Для рендеринга использовались Cycles и OptiX, для сборки ролика — FFmpeg. Это пример не «магической генерации 3D из текста», а координации инструментов и последовательной сборки сцены.
Храм Хорю-дзи. Другой агент исследовал планировку японского храмового комплекса и собирал его в Blender по элементам: многоярусные крыши, колонны, мосты, сады, водоём и материалы. В работе были задействованы внешние открытые ассеты.
Двигатель W16. В FreeCAD модель создала редактируемую геометрию цилиндров, коленвала, поршней и шатунов. Демонстрация показывает движение механизма при вращении коленчатого вала. Ещё два CAD-примера — модели здания Baidu в Шэньчжэне и лунохода с качающейся подвеской и раскладными солнечными панелями.
Здесь принципиально, что результат — файлы и геометрия, пригодные для дальнейшего редактирования, а не только красивый рендер. При этом Baidu не приводит независимую оценку инженерной точности, допусков и соответствия промышленным стандартам.
Таблицы, финансовые модели и исследования: самый практичный сценарий
В офисных задачах Baidu показывает три разных вида результата:
- The AI Power Bill — исследовательская презентация на 20 слайдов о расходах электричества на ИИ-центры обработки данных в США. Модель синтезировала несколько групп публичных источников, сопоставила сценарии распределения затрат и добавила диаграммы и методику расчётов.
- LIFEWEALTH — Excel-файл с 10 листами для личного финансового планирования. Он объединяет доходы, расходы, активы, долги и пенсионные сценарии, а также использует 1000 случайных траекторий Монте-Карло, чтобы оценивать риск нехватки накоплений.
- Driverless, by the Numbers — 24-страничный аналитический отчёт о Waymo и Tesla FSD. По описанию Baidu, система обрабатывала 4169 федеральных сообщений об авариях, устраняла повторы и сопоставляла показатели разных источников.
Это хорошие примеры постановки задачи через итоговый рабочий артефакт: презентацию, электронную таблицу, отчёт. Но опубликованные примеры не доказывают, что данные и выводы в каждом файле безошибочны. Особенно это относится к финансовым моделям и анализу безопасности автомобилей.
Возможные прикладные сценарии — подготовка отчётности, создание таблиц по техническому заданию, анализ бухгалтерских и юридических документов, работа с корпоративными базами знаний и регулярные аналитические обзоры. Здесь результаты тестов SpreadsheetBench V2, OfficeQA Pro V2 и AutomationBench особенно показательны.
Видео, 2D-анимация и музыка — без собственной видеомодальности
Baidu утверждает, что для задач создания контента подготовила более 150 тыс. виртуальных творческих сред, охвативших более тысячи навыков и около 5300 минут готового видео. [1]
В примере The Pelican Test модель написала более 10 тыс. строк Python-кода для двухминутной (116 секунд) анимации. Пеликан проходит через 20 художественных стилей, а изображения строятся с помощью Pycairo и обрабатываются NumPy/Pillow. На отдельных этапах задействованы внешние генераторы изображений.
Есть и научно-популярный ролик о физике «летающего» автомобиля, где агент связывает сценарий, озвучку, визуальные эффекты и диаграммы сил. Baidu также демонстрирует оригинальную оркестровую композицию Beyond the Event Horizon продолжительностью 6 минут 34 секунды, выведенную в WAV.
Важно не перепутать роль модели: ERNIE 5.5 Flash Preview сама по себе не становится видеогенератором или мультимодальным редактором. Она управляет кодом, программами и специализированными генераторами. Это возможная архитектура будущего творческого ассистента, но стоимость и качество всего процесса зависят от подключённых инструментов.
Как ERNIE выглядит на фоне дорогих флагманов: шесть наглядных сравнений
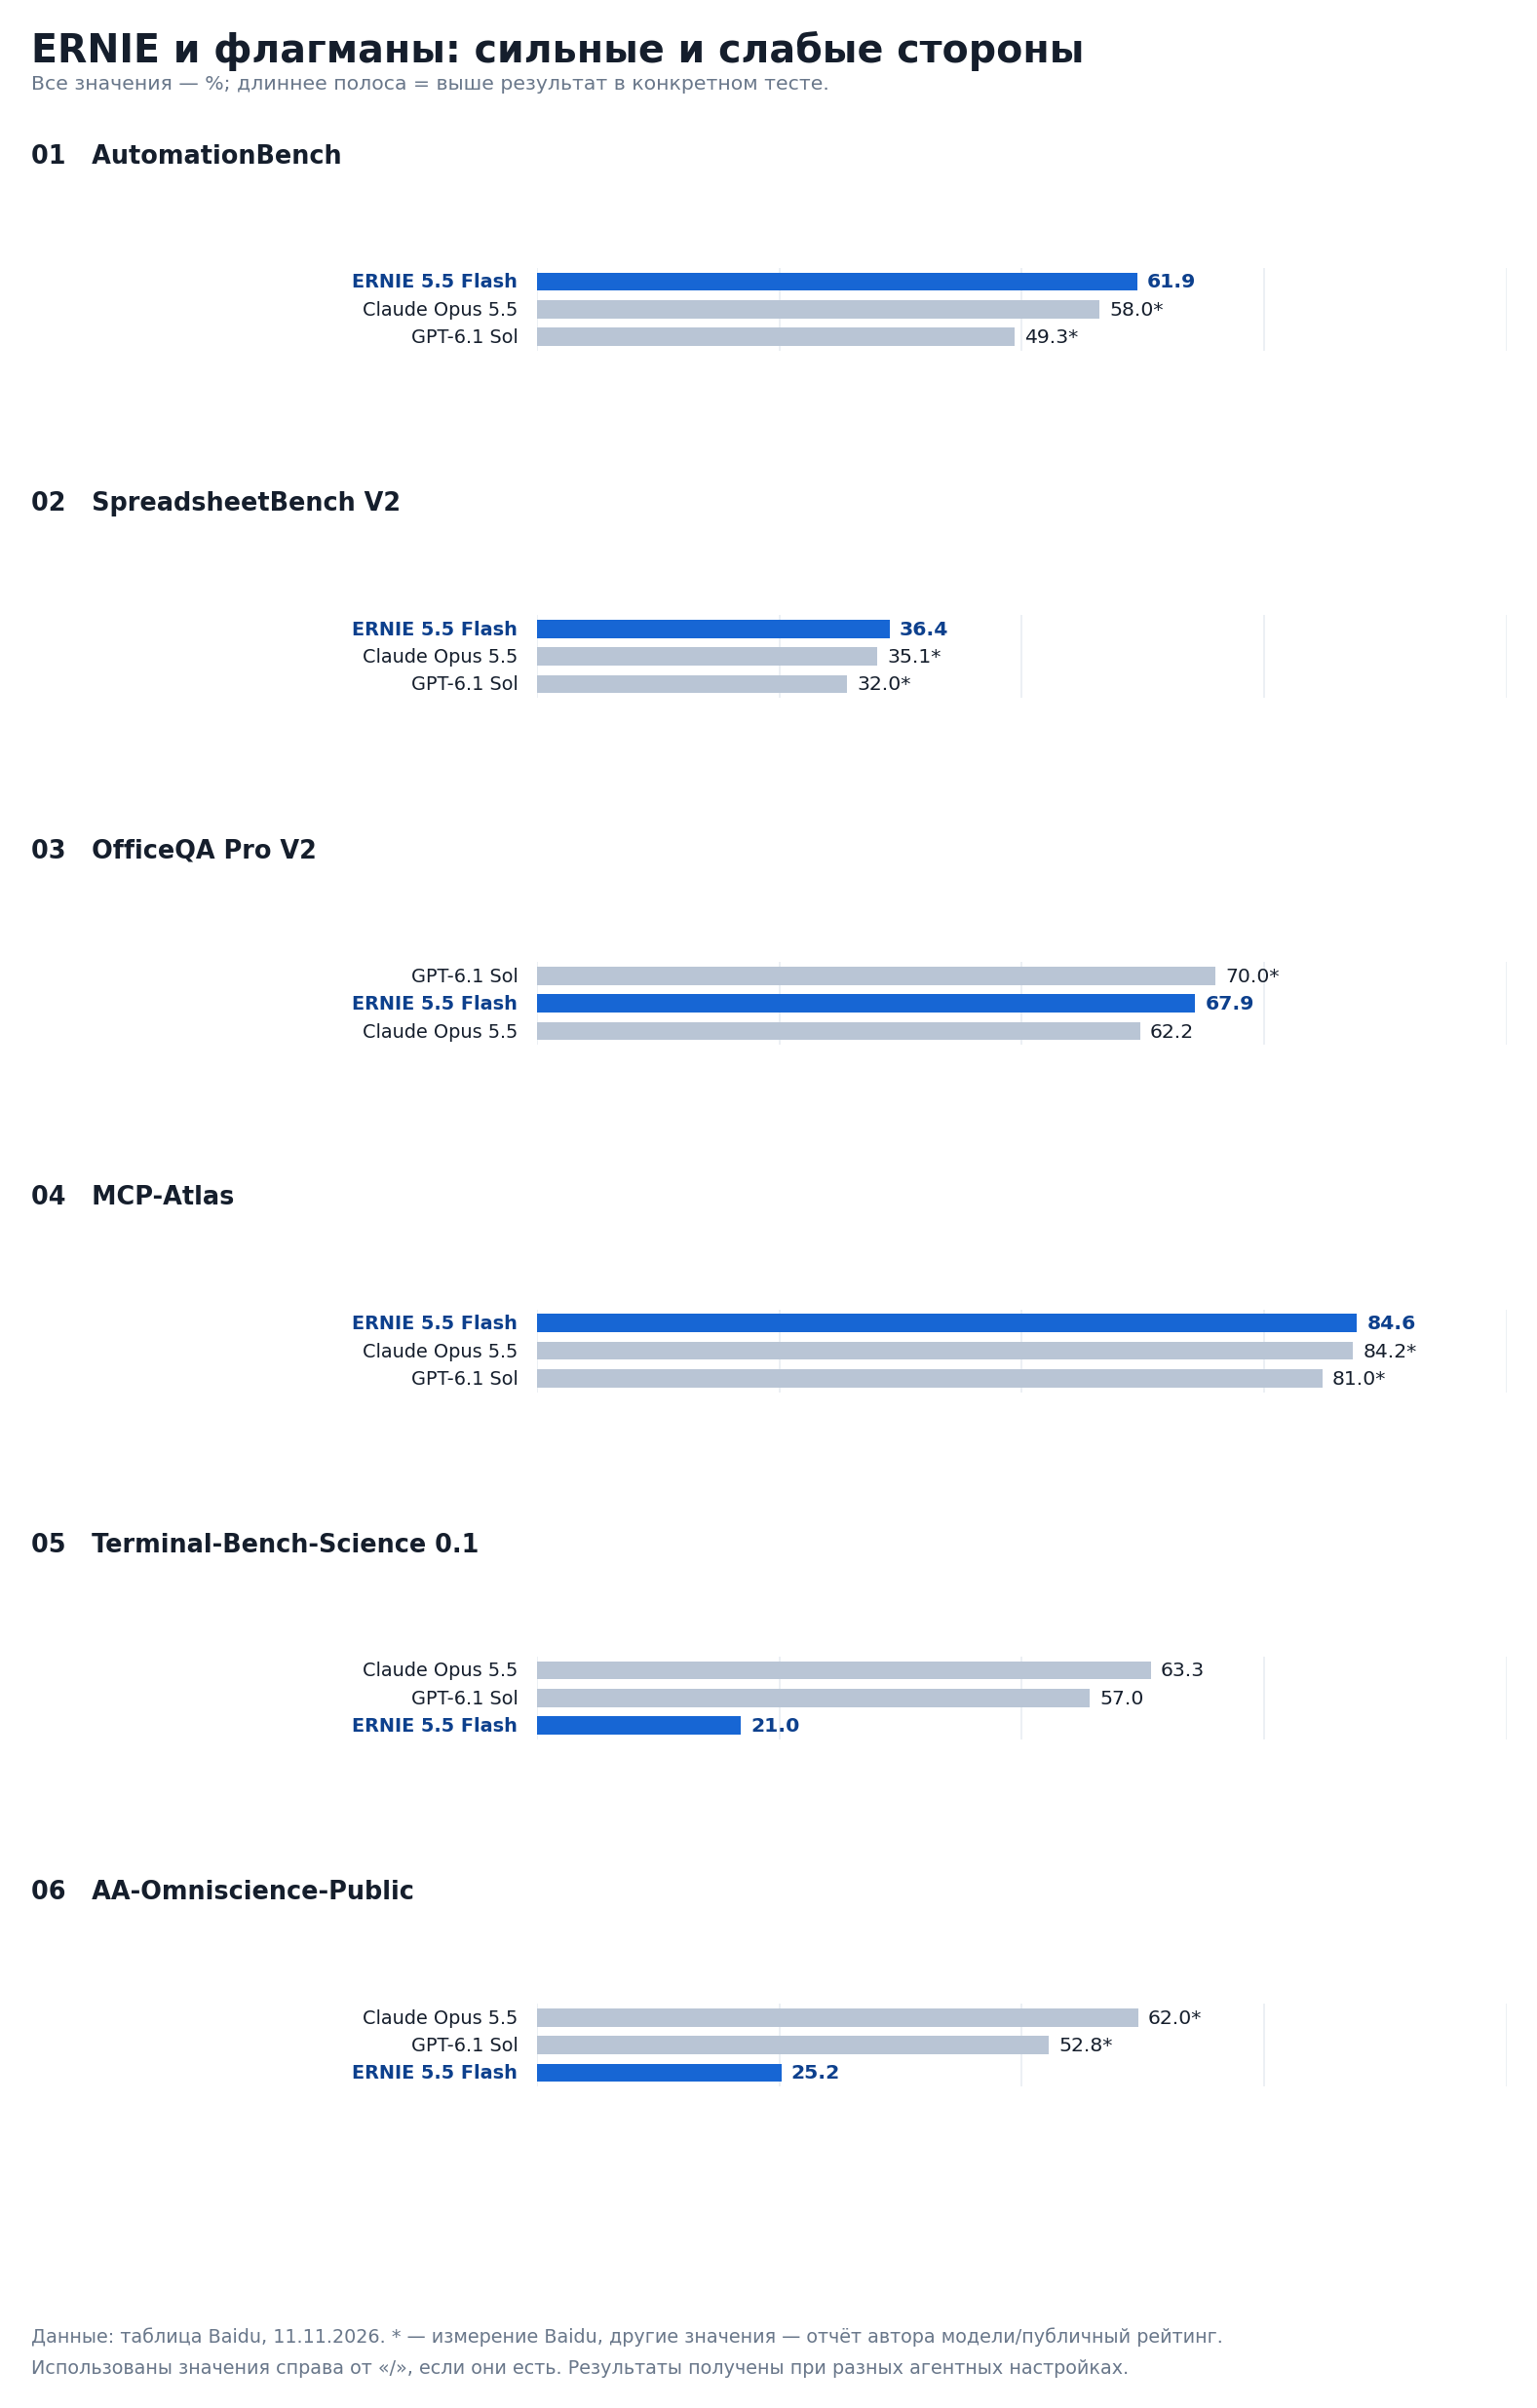
Диаграмма выявляет две противоположные картины. В прикладной автоматизации ERNIE выглядит неожиданно сильно: 61,9 на AutomationBench, 36,4 на SpreadsheetBench V2, 84,6 на MCP-Atlas — выше результатов обеих флагманских моделей в опубликованной таблице Baidu. На OfficeQA она уступает GPT-6.1 Sol (67,9 против 70,0), но опережает Opus 5.5 (62,2).
Напротив, на Terminal-Bench-Science ERNIE набирает 21,0, а GPT-6.1 Sol и Opus 5.5 — 57,0 и 63,3. На AA-Omniscience-Public разрыв ещё заметнее: 25,2 против 52,8 и 62,0. Это тесты, в которых важна глубина рассуждений и работа со сложными ограничениями. Следовательно, ERNIE нельзя считать универсальным заменителем флагманов, особенно для наиболее трудных исследовательских и научно-технических задач.
Оговорка: значения со звёздочкой означают измерение, выполненное Baidu, не независимую проверку. Разные модели могли использовать разные агентные обвязки, а в некоторых тестах разработчик сравнивал результаты из собственных запусков с результатами из внешних отчётов.
Программирование: хороша на терминальных задачах, слабее в исправлении кода
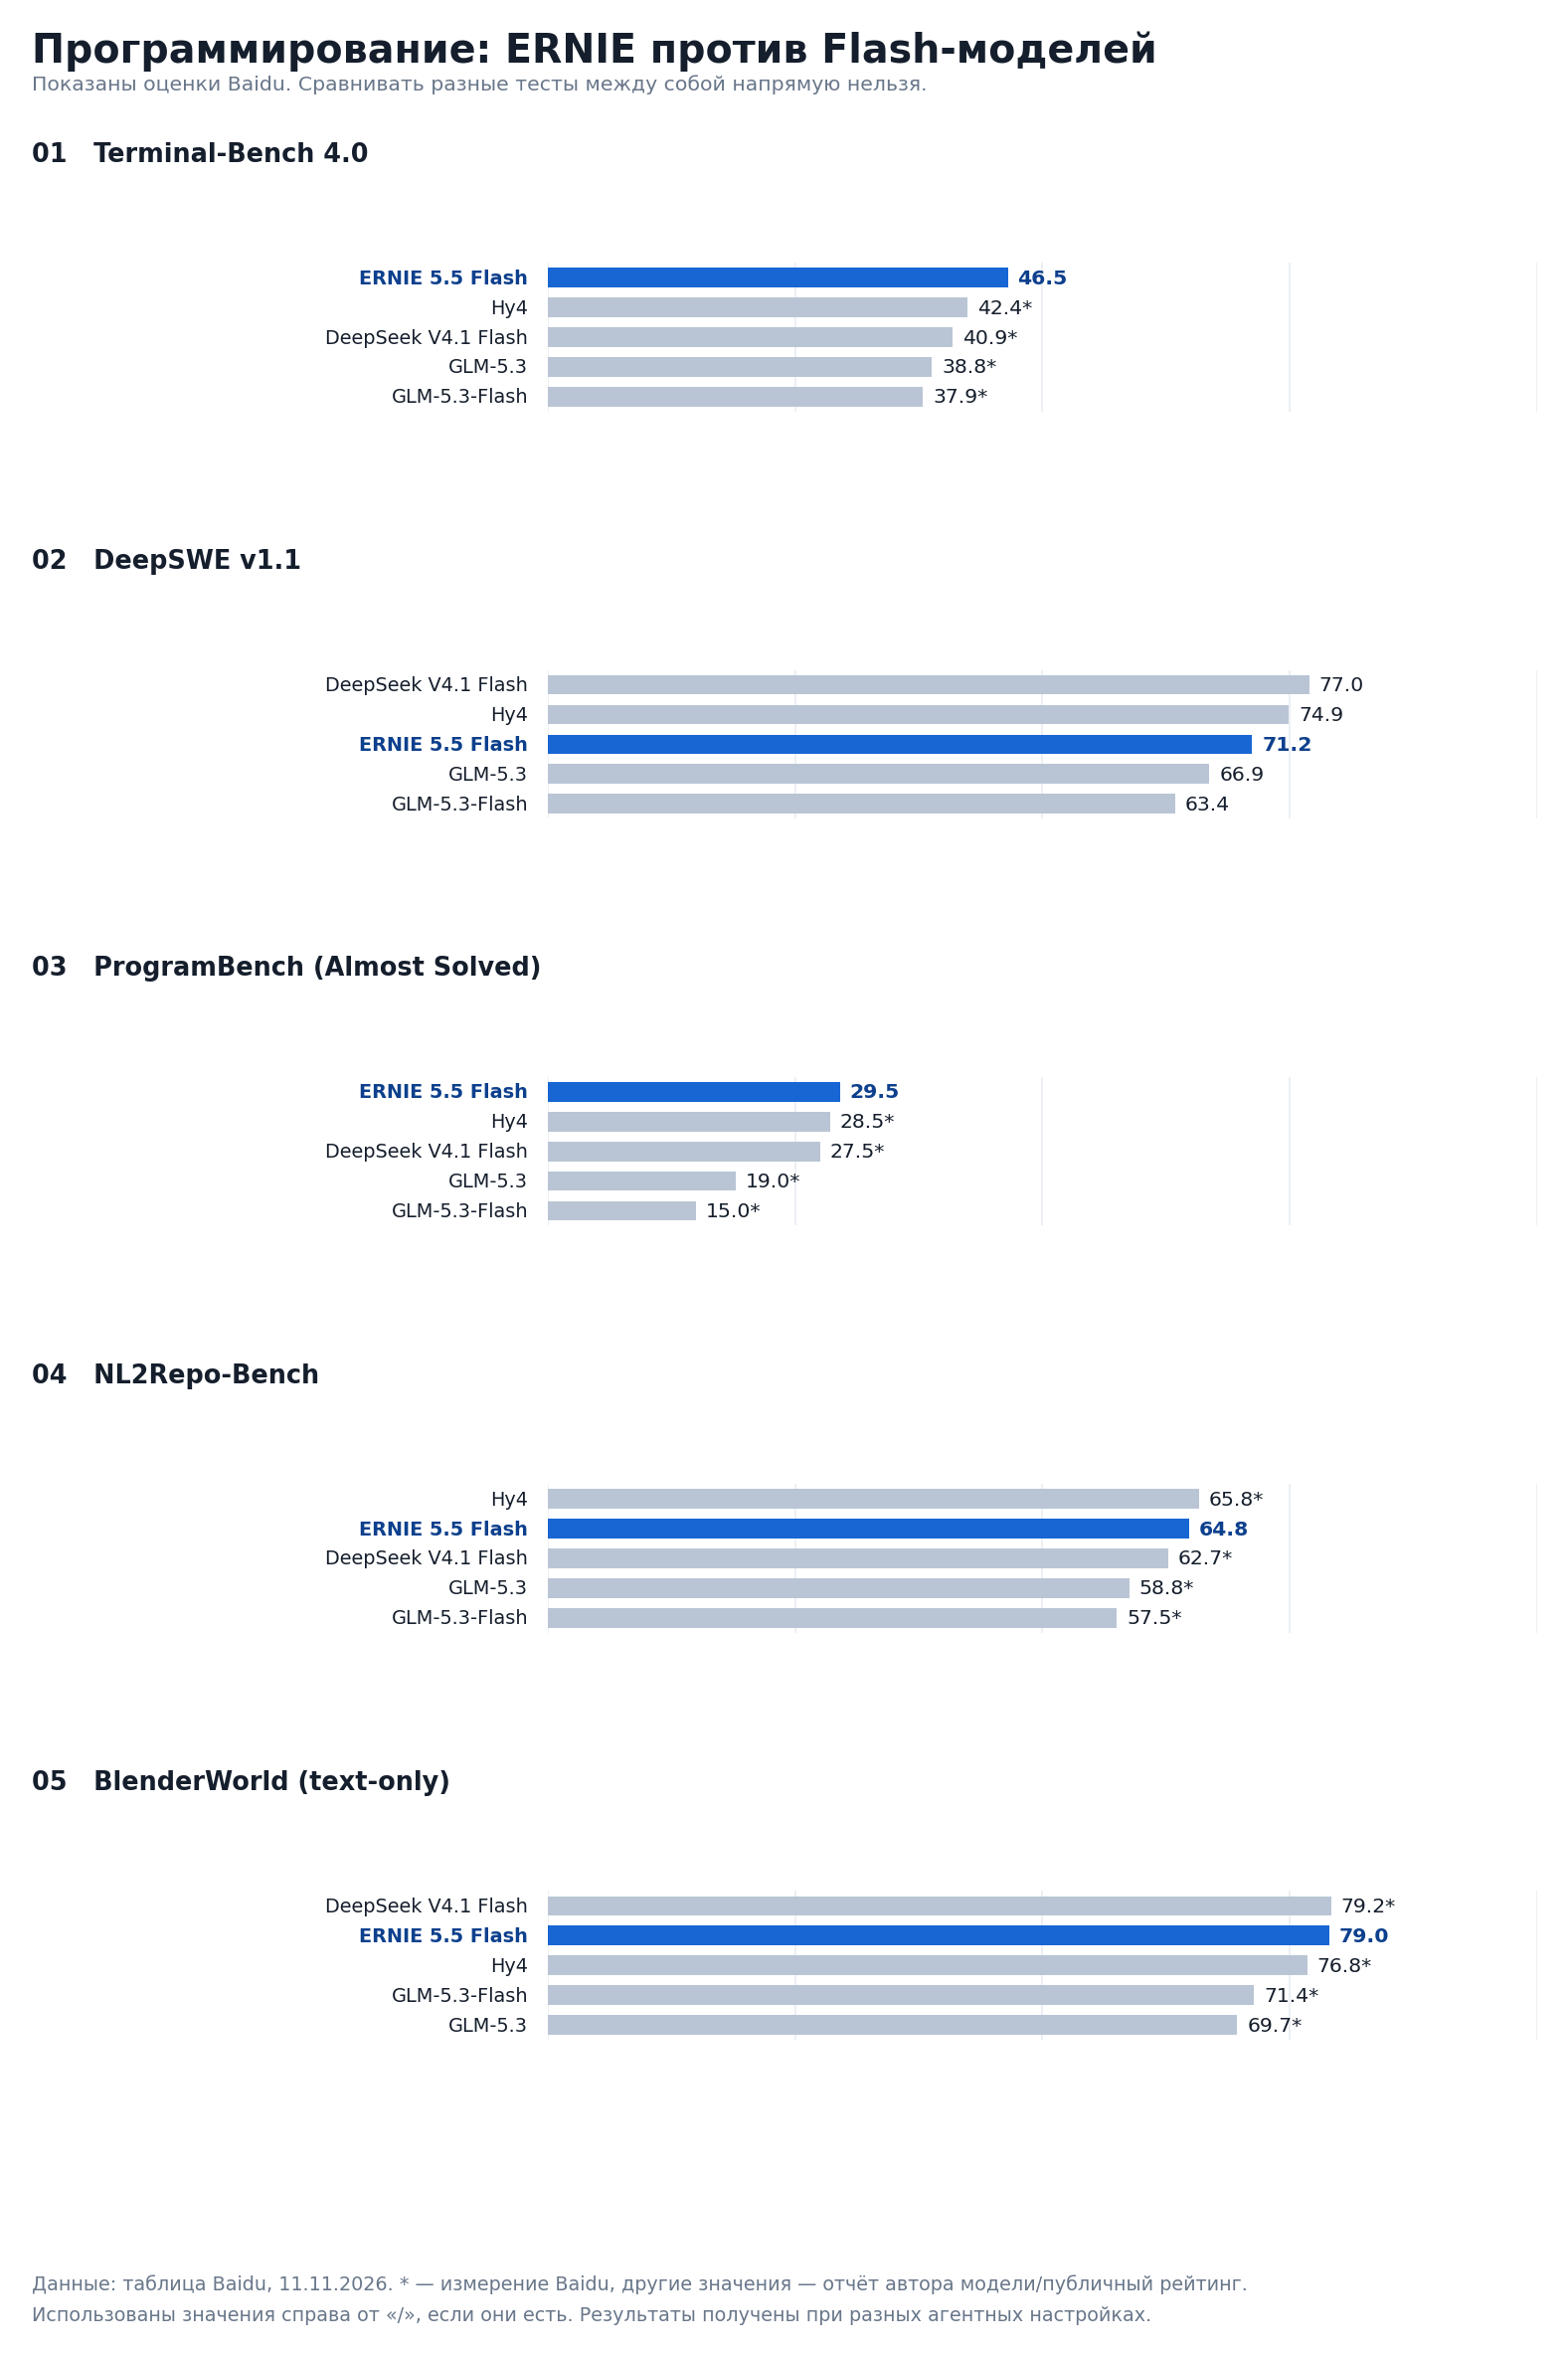
В сопоставлении с Hy4, DeepSeek V4.1 Flash 1017, GLM-5.3 Flash и GLM-5.3 новая модель показывает 46,5% на Terminal-Bench 4.0, выше четырёх перечисленных конкурентов по значениям, принятым в сравнении Baidu. На ProgramBench у неё 29,5%, также немного лучше ближайших соперников. На Terminal-Bench-Science её 21,0% выше показателей других Flash-моделей, но значительно ниже флагманов.
Зато DeepSWE v1.1 наглядно ограничивает этот успех: у ERNIE 71,2%, у DeepSeek 77,0%, у Hy4 74,9%, у GPT-6.1 Sol 75,2%. Этот тест важен именно для исправления существующего программного проекта. У NL2Repo ERNIE набирает 64,8, чуть ниже Hy4 (65,8) и выше DeepSeek в собственном тесте Baidu (62,7).
Вывод: ERNIE стоит пробовать для терминальных действий, генерации игровых прототипов и сборки отдельных компонентов; для работы с существующими репозиториями у DeepSeek и Hy4 остаются сильные аргументы. Демо игры не опровергает результат DeepSWE: один удачный длинный запуск и стабильность на массовом наборе задач — разные вещи.
Документы и офисная автоматизация: здесь ERNIE действительно выделяется
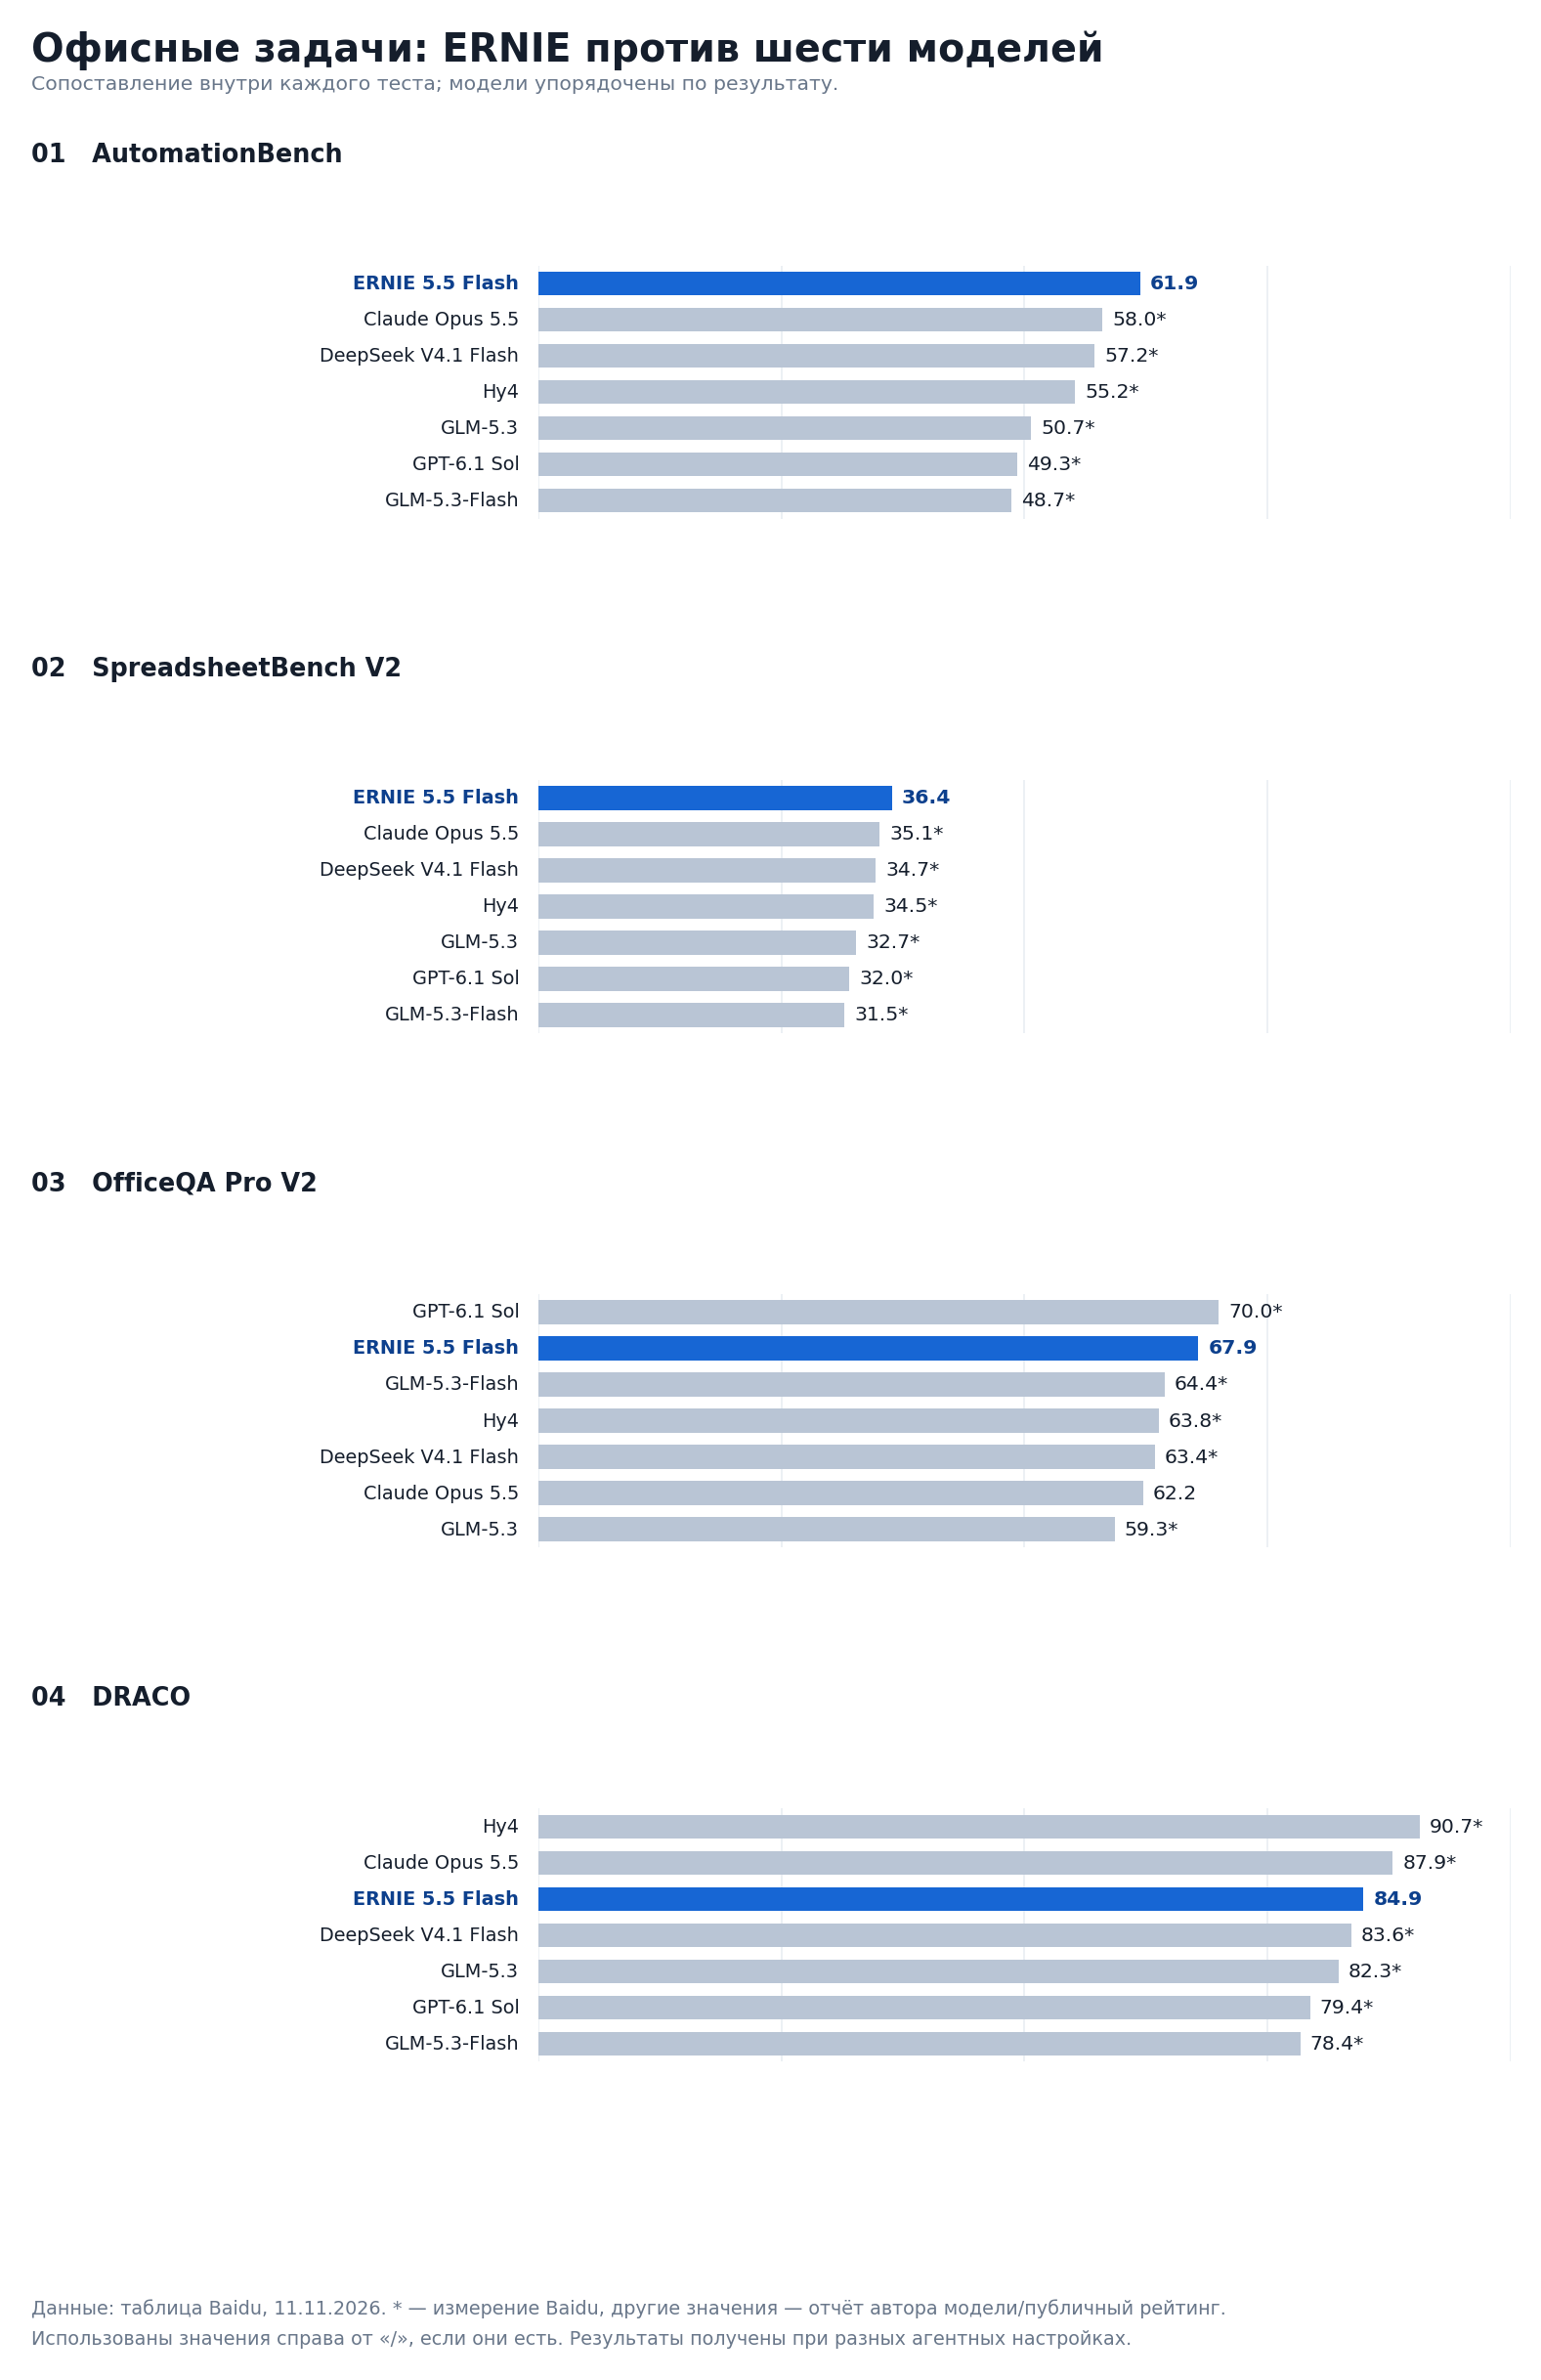
В AutomationBench ERNIE получает 61,9, у Opus 5.5 — 58,0, у DeepSeek — 57,2, у Hy4 — 55,2. В SpreadsheetBench V2 модель лидирует с 36,4 против 35,1 у Opus. В OfficeQA Pro V2 лидирует GPT-6.1 Sol с 70,0, а ERNIE занимает следующую позицию с 67,9.
Другой офисный тест, DRACO, показывает обратную сторону: Hy4 здесь выше (90,7), Opus также впереди (87,9), а ERNIE набирает 84,9. Значит, «сильна в документах» нельзя превращать в утверждение «лучше всех решает любую офисную задачу». Бенчмарки измеряют разные компоненты работы.
Агентные бенчмарки: многое зависит от инструментария
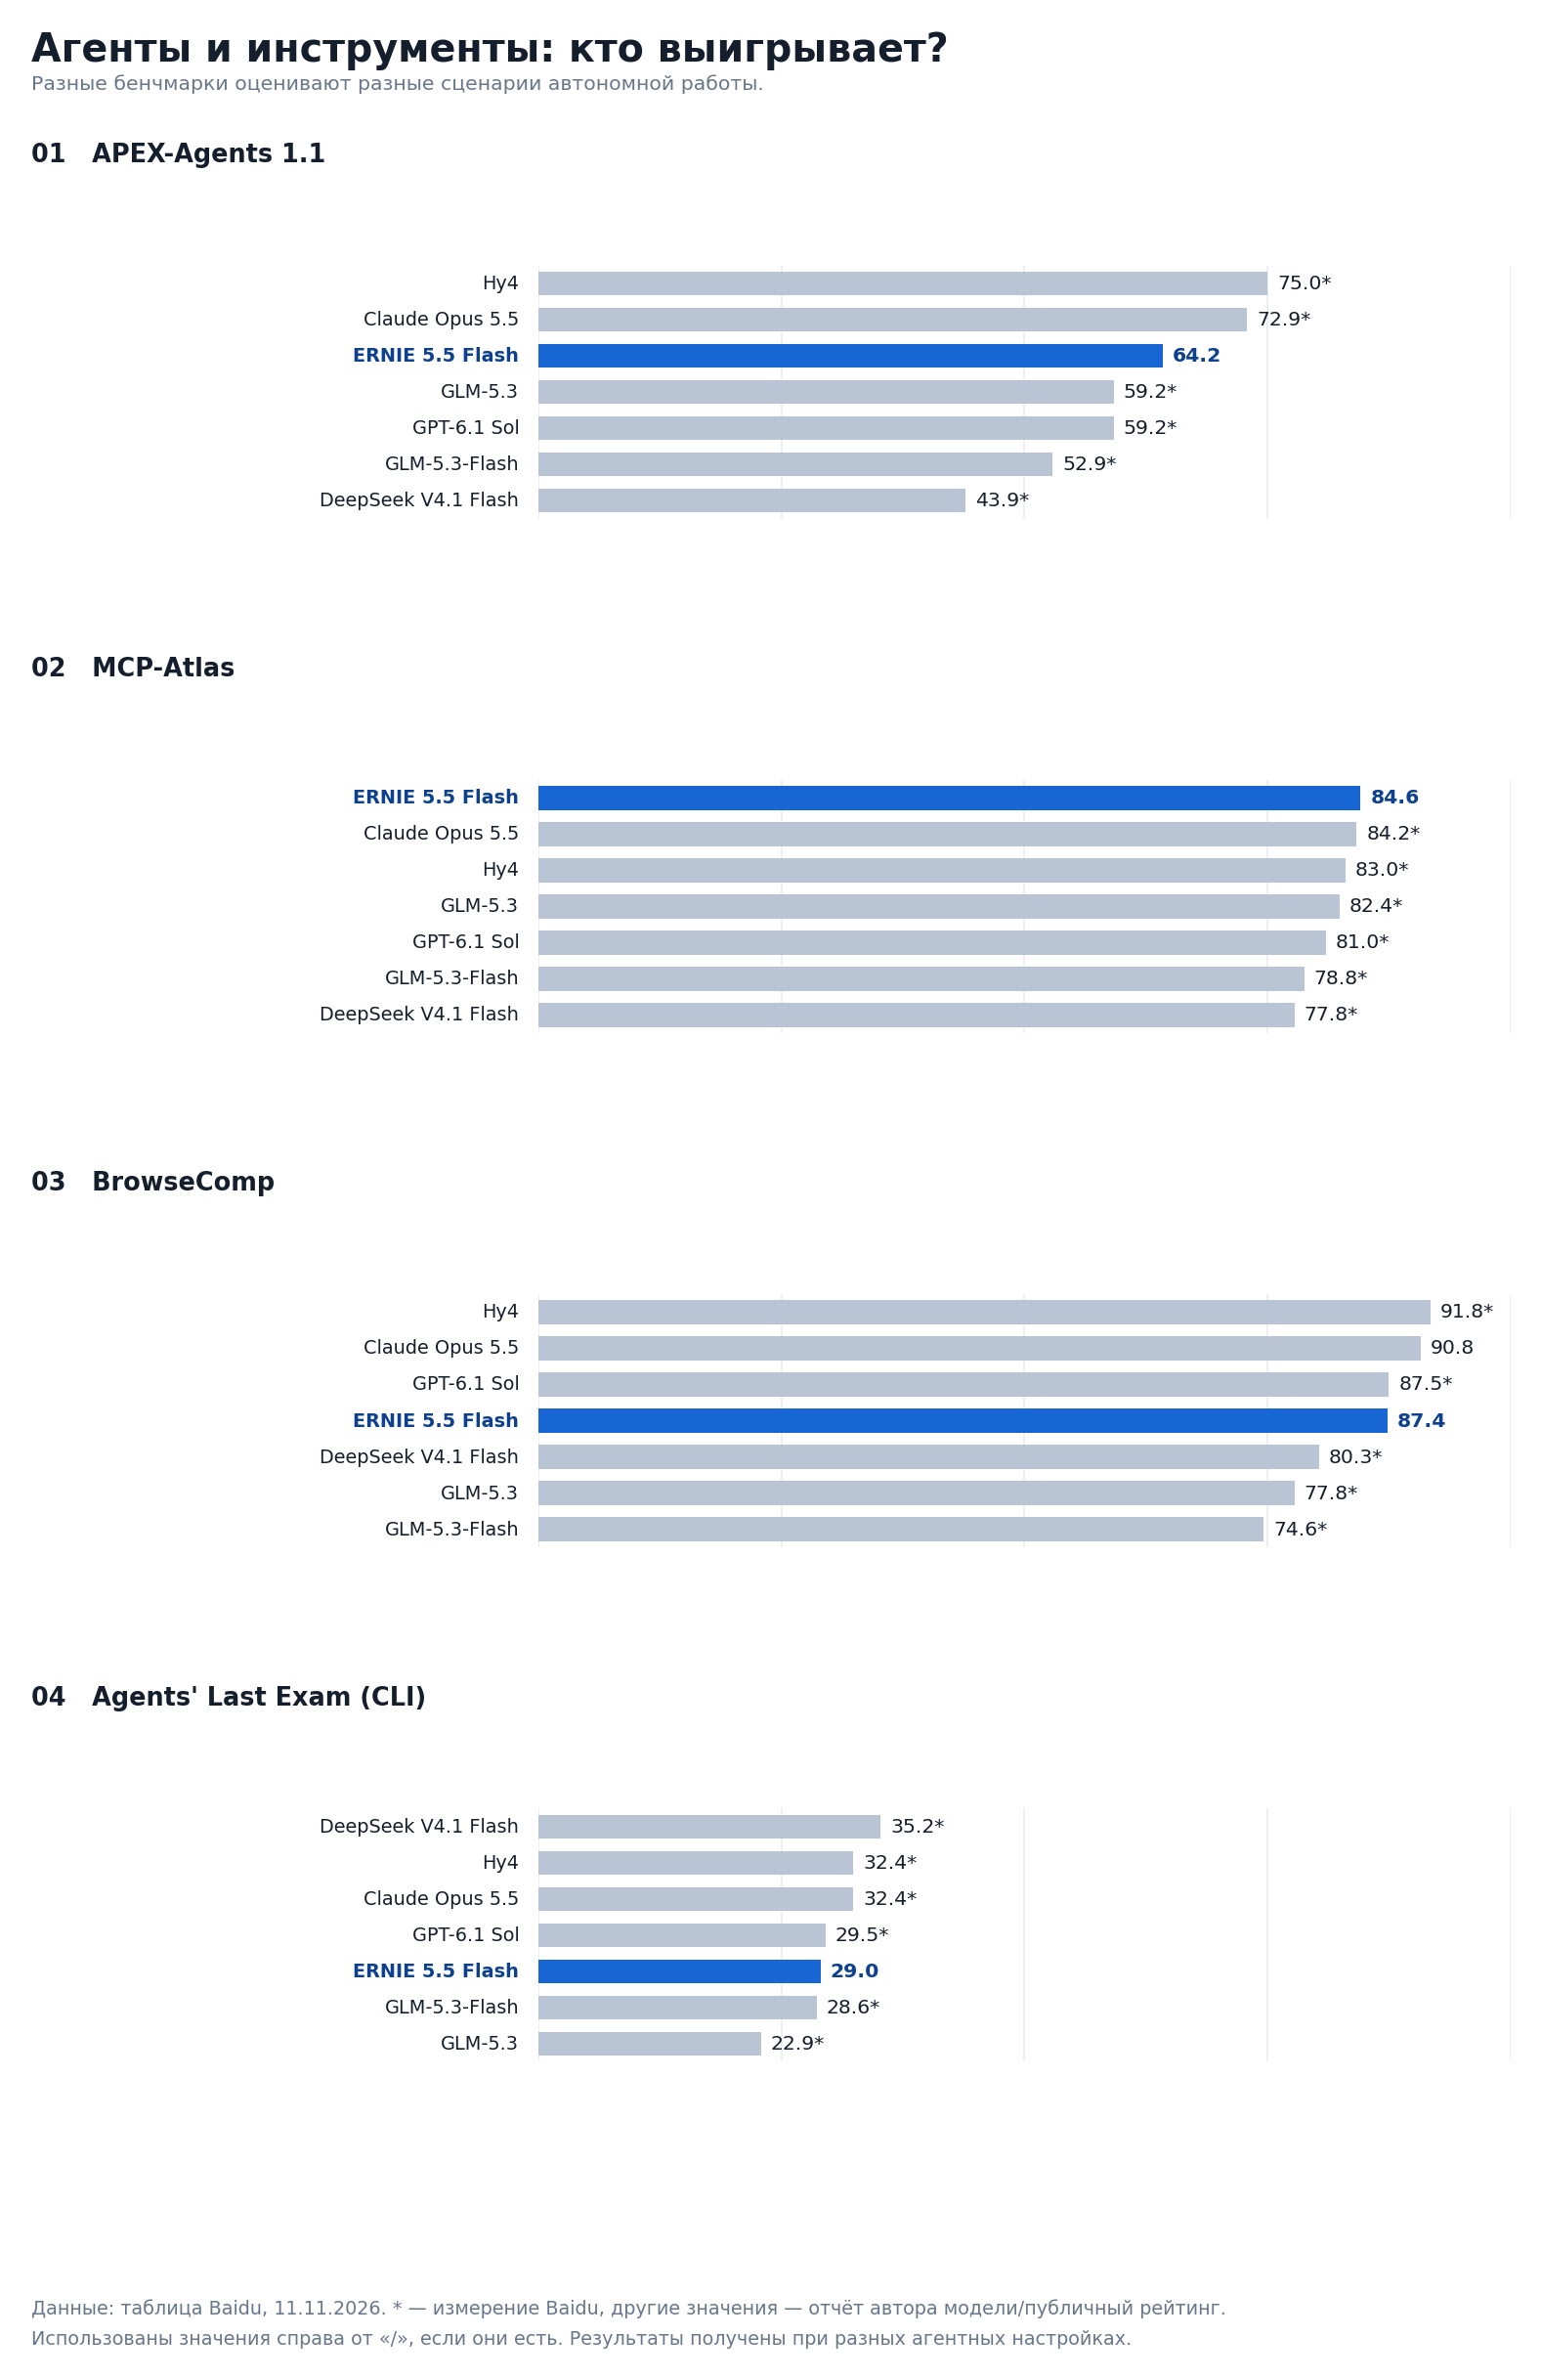
В MCP-Atlas ERNIE с 84,6 опережает Opus (84,2) и Hy4 (83,0). Это позитивный сигнал для систем, где агент обращается к внешним программам по MCP.
Но на APEX-Agents 1.1 Hy4 существенно впереди (75,0 против 64,2 у ERNIE), а на BrowseComp Hy4 тоже лидирует (91,8 против 87,4). В Agents’ Last Exam (CLI) DeepSeek получает 35,2 против 29,0 у ERNIE.
Кроме того, в APEX-Agents часть моделей оценивалась с заменой визуальных наблюдений текстовыми описаниями; в других тестах использовались разные версии Claude Code и Codex. Это не полностью стандартизированный турнир «семь моделей в идентичных условиях», поэтому результаты следует считать ориентирами, а не окончательным рейтингом.
Рассуждение: эффектный контраст с флагманами
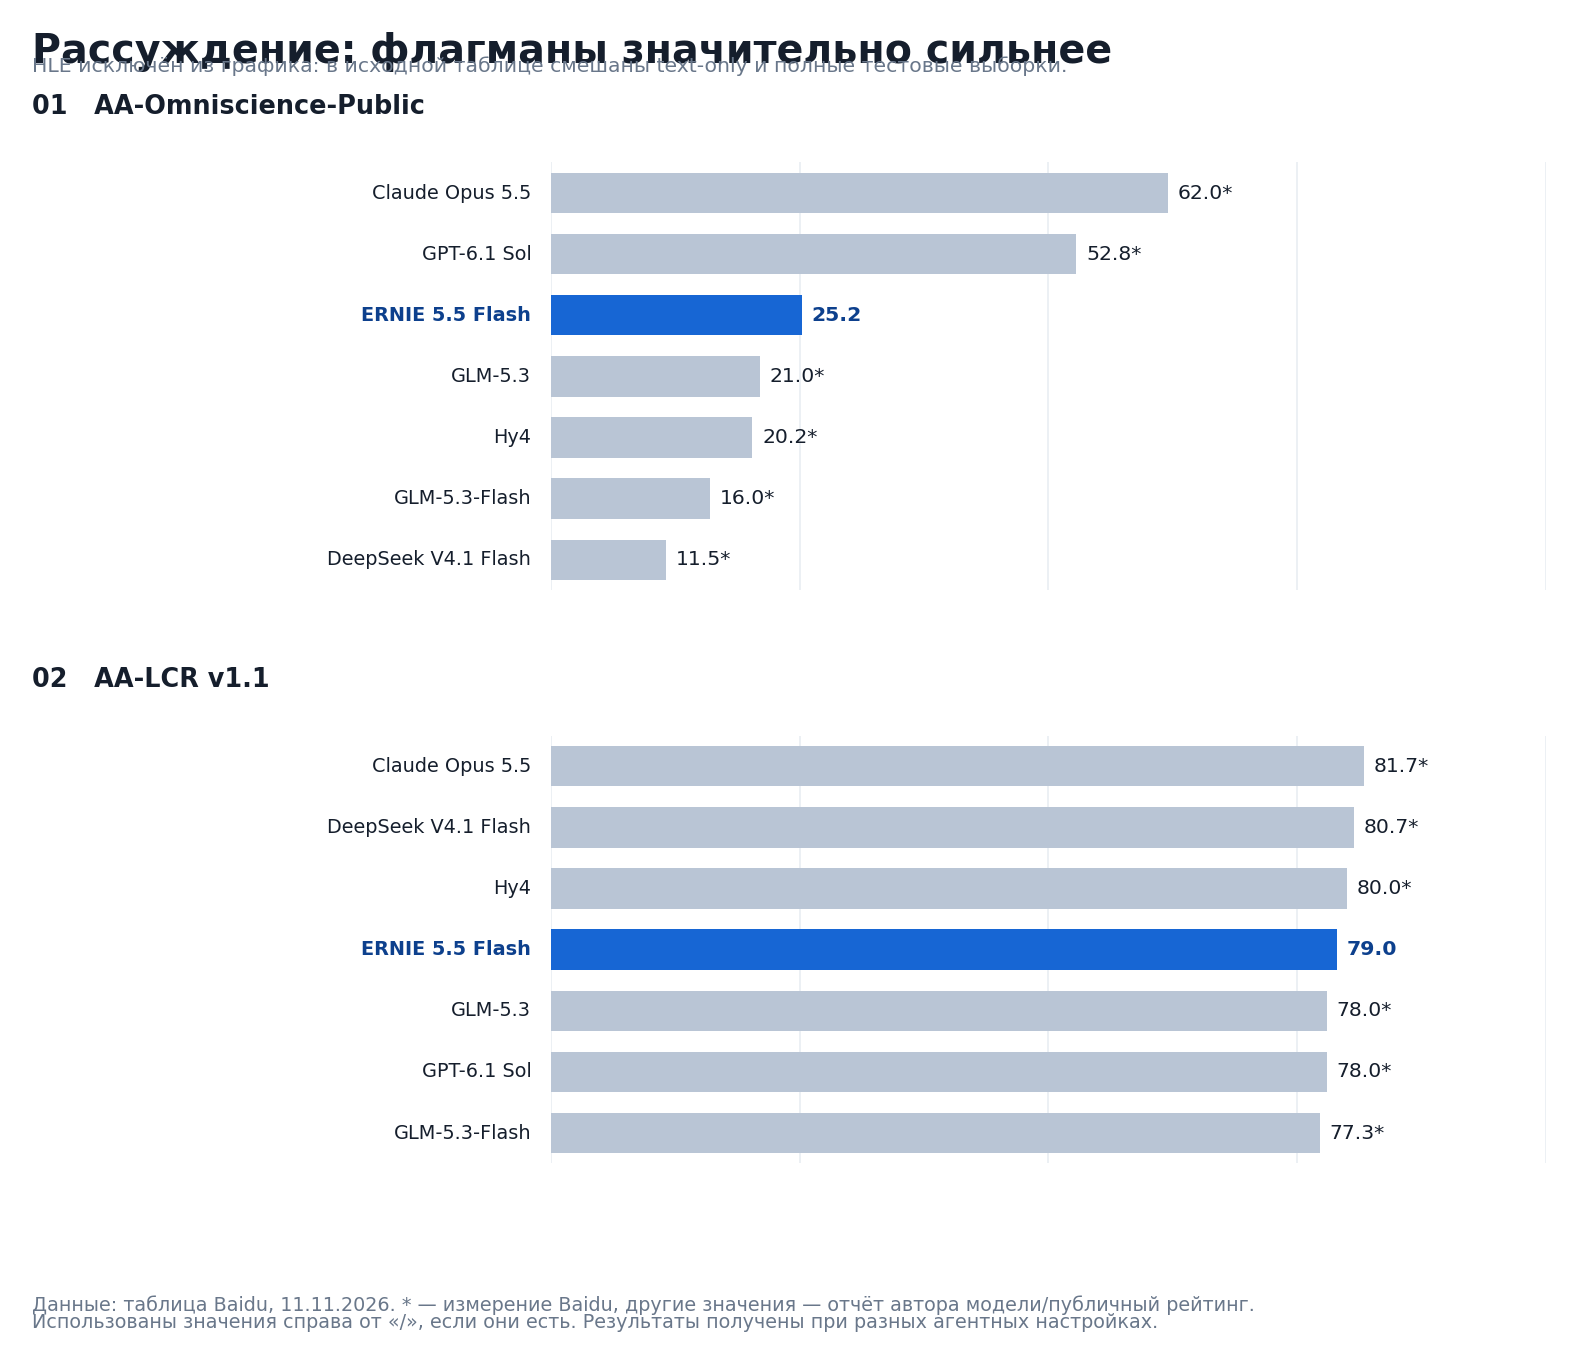
На AA-Omniscience-Public ERNIE опережает три ближайшие Flash-модели, но уступает Claude Opus 5.5 более чем вдвое по опубликованному баллу. AA-LCR v1.1 у ERNIE — 79,0; здесь флагманы ближе, а результаты конкурентов представлены и публичными оценками, и измерениями Baidu.
В строке HLE (without tools) часть результатов помечена символом †, означающим text-only подвыборку. Смешивать их с баллами по полной выборке HLE и ранжировать как единый тест некорректно. Поэтому HLE сохранён полностью в таблице, но не превращён в вводящий в заблуждение сравнительный график.
Полная таблица Baidu: 20 тестов и 7 моделей
Это не сокращённая выборка. Все строки и числовые значения воспроизведены со скриншота официального приложения; сохранены *, † и пары вида 44.4 / 42.4*.
Обозначения: * — результат собственного измерения Baidu; без пометки — показатель из отчёта разработчика модели или публичного рейтинга; † — текстовая подвыборка HLE. В паре через / слева показатель внешнего отчёта, справа — результат повторного измерения Baidu. Все модели тестировались с максимально доступным уровнем рассуждений, но фреймворки и тестовые условия не во всех случаях совпадали.
| Бенчмарк | ERNIE | Hy4 | DeepSeek V4.1 Flash | GLM-5.3 Flash | GLM-5.3 | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|---|---|---|---|---|
| АГЕНТНОЕ ПРОГРАММИРОВАНИЕ | |||||||
| Terminal-Bench 4.0 | 46.5 | 44.4 / 42.4* | 42.3 / 40.9* | 35.8 / 37.9* | 41.8 / 38.8* | 56.1 | 66.4 / 63.6* |
| DeepSWE v1.1 | 71.2 | 74.9 | 77.0 | 63.4 | 66.9 | 75.2 | 74.2 |
| ProgramBench (Almost Solved) | 29.5 | 30.0 / 28.5* | 29.1 / 27.5* | 15.0* | 19.0 / 19.0* | — | 65.0 |
| NL2Repo-Bench | 64.8 | 65.8* | 68.1 / 62.7* | 56.3 / 57.5* | 58.0 / 58.8* | — | — |
| Terminal-Bench-Science 0.1 | 21.0 | 19.8 / 17.1* | 15.7 / 14.3* | 5.7* | 8.1 | 57.0 | 63.3 |
| CookieBench | 88.2 | 88.8* | 87.9* | 76.9* | 80.4* | 89.7* | 91.5* |
| BlenderWorld (text-only) | 79.0 | 76.8* | 79.2* | 71.4* | 69.7* | 85.3* | 86.1* |
| РАБОТА С ДОКУМЕНТАМИ | |||||||
| AutomationBench | 61.9 | 56.2 / 55.2* | 60.5 / 57.2* | 48.8 / 48.7* | 48.2 / 50.7* | 49.3* | 58.0* |
| APEX-Agents 1.1 | 64.2 | 77.6 / 75.0* | 69.8 / 43.9* | 52.8 / 52.9* | 56.6 / 59.2* | 60.0 / 59.2* | 73.5 / 72.9* |
| DRACO | 84.9 | 90.7* | 83.6* | 78.4* | 82.3* | 79.4* | 87.4 / 87.9* |
| SpreadsheetBench V2 | 36.4 | 34.5* | 34.7* | 31.5* | 32.7* | 32.0* | 35.1* |
| OfficeQA Pro V2 | 67.9 | 63.8* | 63.4* | 64.4* | 59.3* | 70.0* | 62.2 |
| ОБЩИЕ АГЕНТНЫЕ ЗАДАЧИ | |||||||
| Agents' Last Exam (CLI) | 29.0 | 32.4* | 35.2* | 28.6* | 22.9* | 29.5* | 34.3 / 32.4* |
| SkillsBench 1.1 (text-only) | 73.5 | 77.4* | 67.5* | 65.4* | 62.0* | 72.6* | 71.8* |
| Toolathlon-Verified | 75.0 | 73.1* | 71.2* | 78.5 / 76.8* | 73.0 / 72.2* | 67.8* | 80.1* |
| MCP-Atlas | 84.6 | 83.0* | 77.8* | 78.8* | 82.4* | 81.0* | 84.2* |
| BrowseComp | 87.4 | 91.8* | 80.3* | 74.6* | 77.8* | 87.5* | 90.8 |
| РАССУЖДЕНИЕ | |||||||
| HLE (w/o tools) | 46.4† | 46.7*† | 44.0† | 39.9 | 42.0† | 52.9 | 61.4 |
| AA-Omniscience-Public | 25.2 | 20.2* | 11.5* | 16.0* | 21.0* | 52.8* | 62.0* |
| AA-LCR v1.1 | 79.0 | 80.0* | 82.7 / 80.7* | 77.3* | 79.7 / 78.0* | 83.0 / 78.0* | 84.7 / 81.7* |
Оригинальная таблица Baidu (PNG): полный исходный скриншот. У него же есть пояснения к каждому тесту, включая версии окружений, способы оценки и особенности использования инструментов.

Важные технические оговорки из оригинального приложения
Это не единый стенд для всех строк: использовались разные системы запуска, лимиты шагов и модели-судьи. Ниже кратко сохранены все 20 методологических пояснений Baidu в порядке таблицы.
- Terminal-Bench 4.0: показатель GPT-6.1 Sol приведён из Artificial Analysis; остальные модели тестировали с Claude Code 2.1.246.
- DeepSWE v1.1: mini-swe-agent 2.4.6 с правилами против манипуляций; песочница на 8 CPU и 16 ГБ памяти.
- ProgramBench: используется Almost Solved; агентная среда Claude Code 2.1.246, но у других моделей иногда применялись среды из их собственных отчётов.
- NL2Repo: Claude Code 2.1.226; подозрительные вызовы инструментов блокировались правилами и LLM-судьёй.
- Terminal-Bench-Science 0.1: Claude Code 2.1.246.
- CookieBench: 1000 React-задач, scaffold Cookie (13 инструментов, максимум 80 шагов), официальный проверяющий модуль и оценивание Qwen3.8-Max.
- BlenderWorld: лишь 78 текстовых задач; Blender 4.2.10, до 24 часов на задачу, Claude Code 2.1.220 и Qwen3.8-Max в роли судьи. Для текстовых моделей изображения описывал внешний инструмент на Claude Opus 5.5.
- AutomationBench: открытая подвыборка версии 1.0.6, официальный стенд с настройками по умолчанию.
- APEX-Agents 1.1: максимум 100 шагов и 10 800 секунд на агент; текстовым моделям визуальные результаты подменялись текстовыми заглушками. DeepSeek при лимите 100 шагов получил 43,9, а при ослаблении ограничения до 500 шагов — 71,7; поэтому конфигурация особенно влияет на оценку.
- DRACO: GPT-модели запускались в Codex 0.162.1, остальные — в Claude Code 2.1.296; максимум 4 часа и 1000 шагов агента, судьёй был Claude Opus 5.
- SpreadsheetBench V2: для GPT использован Codex, для DeepSeek — DSH, для других — Claude Code 2.1.138; веб-поиск отключён, оценка визуализаций через Qwen3.8-Max.
- OfficeQA Pro V2: аналогичные разные агентные среды; веб-поиск отключён, WebFetch ограничен разрешёнными доменами; балл Opus взят из отчёта Kimi K3.1 Pro.
- Agents' Last Exam (CLI): только CLI-подвыборка, по 5 часов на задачу; GPT в Codex, Opus и другие модели — в разных версиях Claude Code.
- SkillsBench 1.1: 78 текстовых заданий без 9 мультимодальных, до 6 часов на задачу; у GPT и остальных использовались разные среды запуска.
- Toolathlon-Verified: максимум 200 шагов и 7200 секунд, защита от поиска ответов в GitHub и выхода за пределы контейнера.
- MCP-Atlas: публичная выборка официального релиза, 500 задач, стандартные настройки.
- BrowseComp: разные среды у GPT, DeepSeek и остальных; до 4 часов и 1000 шагов, судья — DeepSeek V4.1 Flash 1017.
- HLE:
†обозначает текстовую подвыборку, судья Gemini 3.1 Flash-Lite. Сравнение с баллами по полной выборке ограниченно. - AA-Omniscience-Public: публичная выборка из 600 заданий, судья Gemini 3.1 Flash-Lite.
- AA-LCR v1.1: судья DeepSeek V4 Flash.
Почему не стоит механически усреднять все 20 бенчмарков
Некоторые тесты оценивают программирование, другие — поиск по вебу, третьи — таблицы или научное рассуждение. Их сложность и шкалы различаются, а часть значений для конкурентов получена не в идентичных условиях. Нельзя сложить все 20 процентов и получить доказанный «индекс интеллекта». Для сводного рейтинга понадобились бы нормализация по тестам, заранее определённые веса, контроль одинаковых инструментов и независимые прогоны.
Даже без единого индекса таблица даёт понятную картину. ERNIE занимает первое место среди перечисленных моделей на AutomationBench, SpreadsheetBench V2 и MCP-Atlas. В то же время на DeepSWE сильнее DeepSeek, на APEX-Agents и BrowseComp — Hy4, на сложном научном рассуждении — флагманские GPT и Claude.
Сколько стоит ERNIE: официальные тарифы Baidu в юанях и долларах
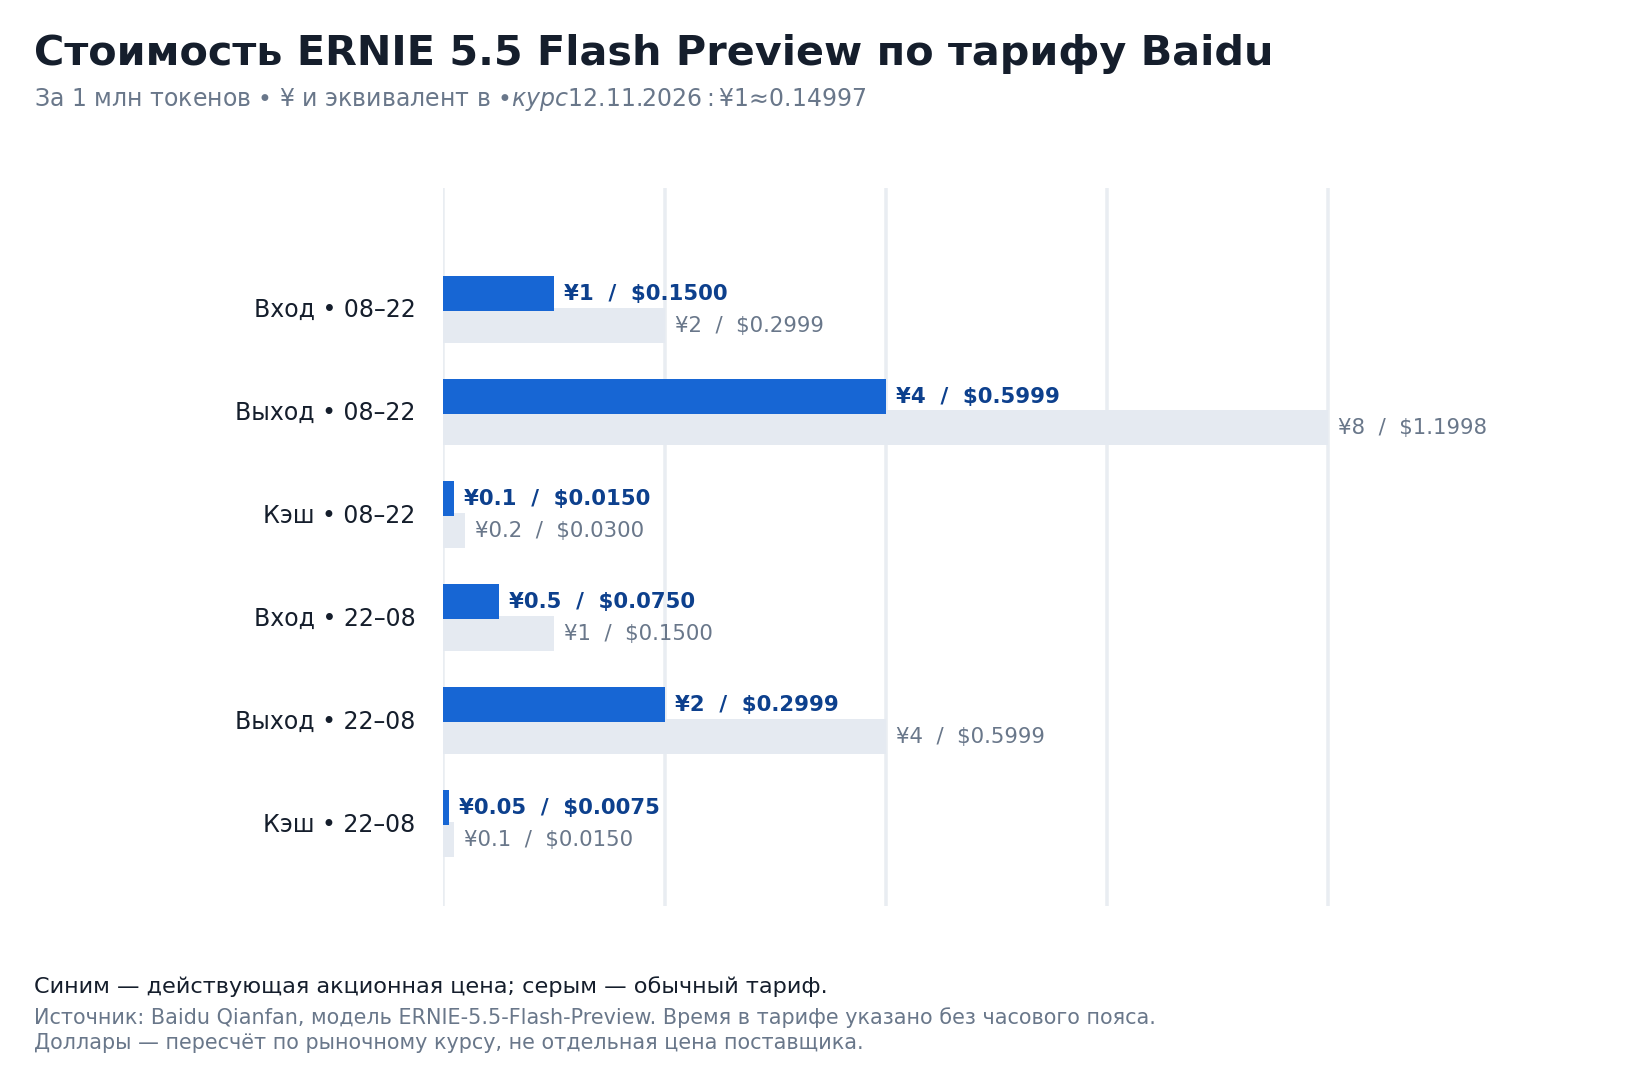
В Baidu Qianfan указаны акционные и стандартные цены за миллион токенов, отдельно для дневных (08:00–22:00) и ночных (22:00–08:00) часов. На дату публикации действует акция со скидкой 50%; часовой пояс в самой таблице тарифа не обозначен. Поэтому не стоит автоматически переводить часы на московское или европейское время. [4]
| Токены | Акция, день | Акция, ночь | Обычный тариф, день | Обычный тариф, ночь |
|---|---|---|---|---|
| Вход | ¥1 / $0,150 | ¥0,50 / $0,075 | ¥2 / $0,300 | ¥1 / $0,150 |
| Выход | ¥4 / $0,600 | ¥2 / $0,300 | ¥8 / $1,200 | ¥4 / $0,600 |
| Попадание в кэш | ¥0,10 / $0,015 | ¥0,05 / $0,0075 | ¥0,20 / $0,030 | ¥0,10 / $0,015 |
Курс: 12 ноября 2026 года, около ¥1 = $0,14997. Значения в долларах — ориентировочный валютный пересчёт, а не отдельный долларовый тариф Baidu. [5]
Для примера, один агентный запуск, израсходовавший 200 тыс. новых входных и 50 тыс. выходных токенов, обойдётся по акционной дневной ставке в ¥0,40 ≈ $0,060 (0,2 × ¥1 + 0,05 × ¥4). По ночной ставке — ¥0,20 ≈ $0,030. В расчёте нет дополнительных инструментов, рендеринга, повторных запусков и других затрат.
Промоакция может закончиться, а тарифы измениться.
Сколько стоит ERNIE 5.5 Flash Preview по сравнению с DeepSeek и GLM
Срез цен: 12 ноября 2026 года. Сравниваются тарифы API непосредственно от разработчиков — Baidu Qianfan, DeepSeek и Z.ai. Все суммы указаны за 1 млн токенов. Пересчёт по курсу $1 = ¥6,67035 на 12.11.2026; суммы в скобках приблизительные.
| Модель и тариф | Входные токены | Входные из кэша | Выходные токены |
|---|---|---|---|
| ERNIE 5.5 Flash Preview, акция, пиковые часы | ¥1 ($0,150) | ¥0,10 ($0,015) | ¥4 ($0,600) |
| ERNIE 5.5 Flash Preview, акция, вне пика | ¥0,50 ($0,075) | ¥0,05 ($0,0075) | ¥2 ($0,300) |
| DeepSeek V4.1 Flash 1017, пиковые часы | $0,300 (¥2,00) | $0,006 (¥0,04) | $1,200 (¥8,00) |
| DeepSeek V4.1 Flash 1017, вне пика | $0,150 (¥1,00) | $0,003 (¥0,02) | $0,600 (¥4,00) |
| GLM-5.3-Flash | $0,150 (¥1,00) | $0,030 (¥0,20) | $0,500 (¥3,34) |
| GLM-5.3 (более дорогая модель из таблицы бенчмарков) | $1,400 (¥9,34) | $0,260 (¥1,73) | $4,400 (¥29,35) |
Условия: Baidu предоставляет скидку 50% до 30 ноября 2026 года, 23:59:59 по китайскому времени; пиковые часы — 08:00–22:00 (Пекин). После акции пиковые тарифы ERNIE составят ¥2 / ¥0,20 / ¥8 за 1 млн обычных входных / кэшированных входных / выходных токенов; вне пика — ¥1 / ¥0,10 / ¥4. У DeepSeek пиковые часы — 01:00–04:00 и 06:00–10:00 UTC по будням, кроме государственных праздников Китая; в остальное время действует тариф вне пика. Z.ai не выделяет дневные и ночные тарифы для перечисленных моделей.
| Модель и режим | Расчётная стоимость одного запуска |
|---|---|
| ERNIE 5.5 Flash Preview, вне пика, акция | $0,0030 |
| GLM-5.3-Flash | $0,0055 |
| ERNIE 5.5 Flash Preview, пиковые часы, акция | $0,0060 |
| DeepSeek V4.1 Flash 1017, вне пика | $0,0060 |
| DeepSeek V4.1 Flash 1017, пиковые часы | $0,0120 |
| GLM-5.3 | $0,0500 |
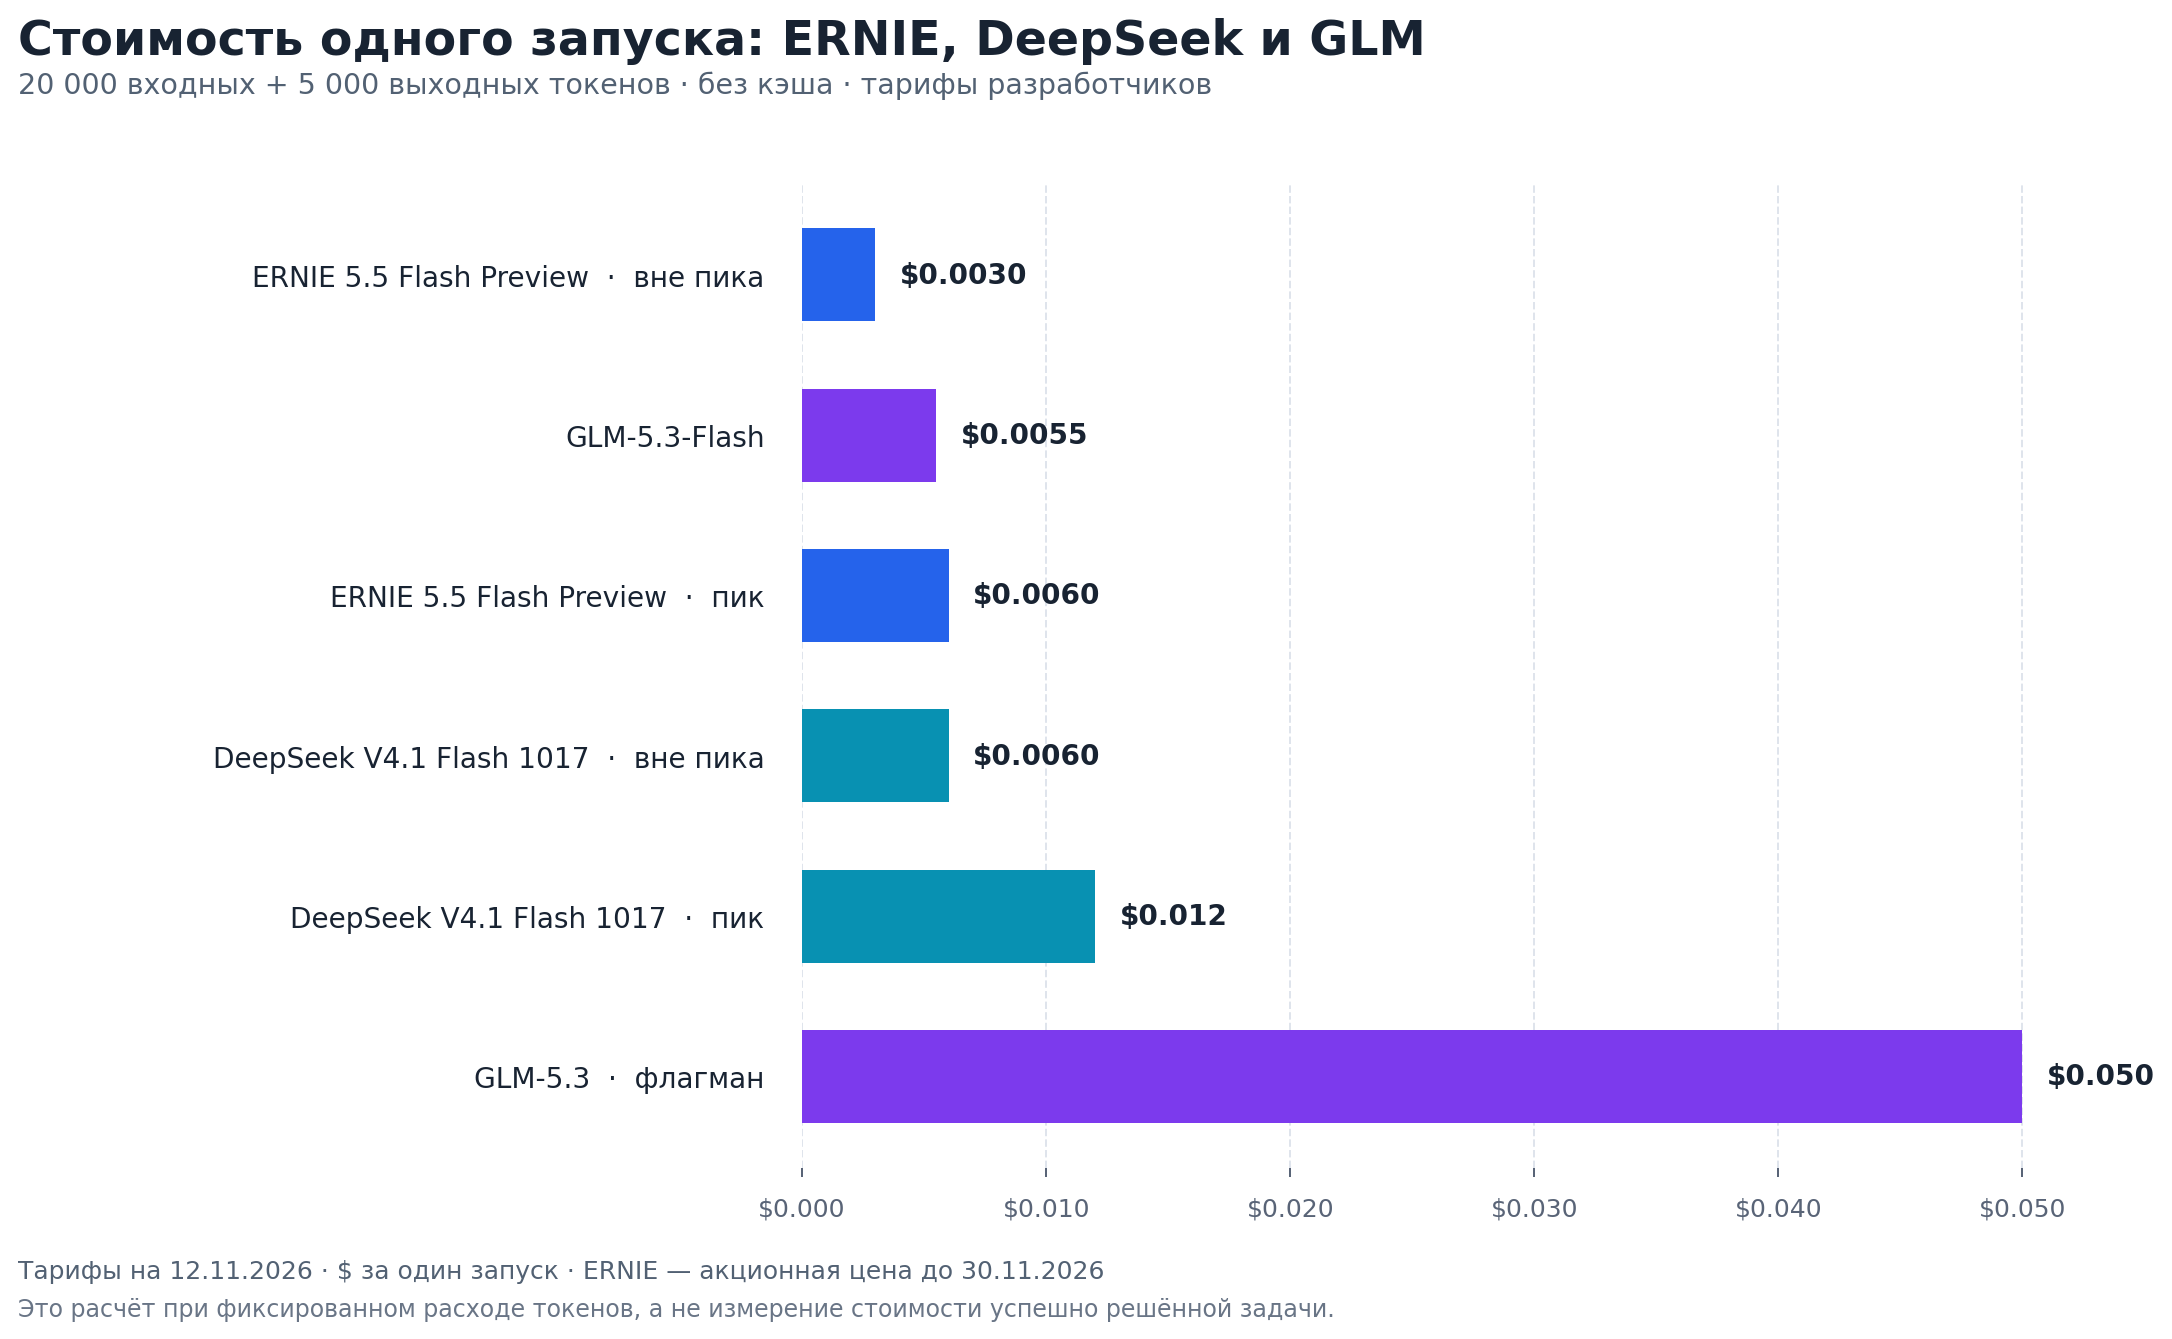
Вывод. Во время акции Baidu ERNIE оказывается дешевле DeepSeek V4.1 Flash 1017 при одинаковом расходе некэшированных токенов и сравнении соответствующих тарифных периодов. При этом у DeepSeek существенно дешевле кэшированный вход, а GLM-5.3-Flash дешевле ERNIE по выходным токенам в пиковые часы. По окончании скидки ценовое преимущество ERNIE перед DeepSeek по некэшированным токенам исчезнет.
Важно: эта диаграмма сравнивает стоимость одного запуска при фиксированном расходе, а не реальную стоимость успешного решения задачи. В агентных сценариях модели могут различаться расходом токенов, числом вызовов инструментов и повторных попыток. Чтобы сравнить экономическую эффективность,
Пока нет сопоставимого независимого исследования, которое поставило бы ERNIE 5.5 Flash Preview и прямых конкурентов в одинаковые агентные условия и оценило стоимость успешного выполнения задачи.
Где новая модель действительно может найти применение
| Задача | Оценка перспективности | Почему |
|---|---|---|
| Отчёты, таблицы, подготовка презентаций | Высокая — стоит тестировать в первую очередь | Сильные AutomationBench и SpreadsheetBench; соответствующие демонстрации с готовыми файлами |
| Агенты, управляющие MCP-инструментами | Высокая | Лидерство на MCP-Atlas, опыт работы с длительными цепочками инструментов |
| Игровое прототипирование | Высокая для экспериментов | Unreal Engine, почти 100 мини-игр, специализированные обучающие задачи |
| Процедурное 3D и CAD | Перспективная, требуется инженерная проверка | Blender Python API, FreeCAD, пространственные операции и редактируемые проекты |
| Поддержка больших кодовых баз | Сравнивать с DeepSeek и Hy4 | DeepSWE у конкурентов выше |
| Сложные математические и научные задачи | Не основная сильная сторона | Существенное отставание от GPT-6.1 Sol и Claude Opus 5.5 в научных тестах |
| Видеопроизводство и анимация | Как агент-оркестратор | Управляет кодом и генераторами, а не генерирует видеоряд собственной видеомодальностью |
Что пока неизвестно и на что обратить внимание
- Нет независимого комплексного сравнения. Опубликованные Baidu тесты полезны, но это данные заинтересованной стороны.
- Preview — не завершённая модель. Baidu прямо предупреждает о возможных недостатках дообучения.
- Текстовая модель может пользоваться визуальными помощниками. Когда она строит 3D-сцену или ролик, визуальное восприятие может обеспечиваться отдельным инструментом, а не самой ERNIE.
- Миллион токенов — лимит, не гарантия идеальной памяти. Для длинных документов ещё нужно оценивать точность поиска, ссылок и объединения фактов.
- Веса ещё не опубликованы. Заявления об Apache 2.0 и намеченной дате следует подтвердить фактическим релизом репозитория и лицензии.
- Официальная скорость 200+ токенов/с — заявление разработчика. Реальную задержку и производительность нужно измерить на собственной нагрузке.
Вывод: Baidu пытается сделать Flash-модель не собеседником, а исполнителем
Главная интрига ERNIE 5.5 Flash Preview — не столько 280 млрд параметров или низкая цена токена, сколько ставка на автономные рабочие процессы. Модель должна писать и тестировать код, управлять Blender/FreeCAD, собирать отчёты и таблицы, координировать творческие инструменты и доводить задачи до файлового результата.
Опубликованные Baidu бенчмарки частично подтверждают эту специализацию: у ERNIE сильные результаты в автоматизации, таблицах и MCP-инструментах, иногда даже выше показателей дорогих флагманов. При этом она существенно уступает флагманам в ряде сложных научных и интеллектуальных тестов и проигрывает некоторым Flash-конкурентам в исправлении кода или поисковых агентах.
Поэтому новый релиз наиболее интересен как кандидат для дешёвых долгоживущих агентов, а не как «самая умная китайская нейросеть». Следующий важный этап — публикация весов, независимые испытания и измерение стоимости успешно выполненной работы в реальных проектах.
Источники и методология
- Baidu, 11.11.2026. Официальный анонс ERNIE 5.5 Flash Preview — архитектура, демонстрации, вся таблица из 20 бенчмарков и методологические примечания.
- Baidu Intelligent Cloud. Официальная продуктовая страница ERNIE 5.5 Flash Preview — обучающие данные, контекст, скорость, сценарии и параметры выпуска.
- IT Home, 11.11.2026. Описание технологий hybrid sparse attention, multi-router MoE, ECHO и ERNIE Evolve. Технические детали, не приведённые в открытой англоязычной заметке, атрибутированы источнику.
- Baidu Qianfan, официальная документация. Тарифы на модельную инференцию — цены в юанях за тысячу токенов, пересчитанные в статье на миллион.
- Twelve Data. Курс CNY/USD на 12.11.2026 — ¥1 ≈ $0,14997.
- Van Data Team. Мониторинг внешних бенчмарков ERNIE — отсутствие независимых оценок на момент подготовки статьи; данные разработчика отделены от внешних измерений.
Об исходных числах: в официальной таблице звёздочка отмечает замер самой Baidu; † — ограниченную text-only выборку HLE. При наличии двух чисел мы сохранили оба в таблице, а на графиках показываем правое, измеренное Baidu, значение с пометкой *. Это не делает все результаты полностью сопоставимыми: различия агентных фреймворков, подсказок, сред запуска и судей остаются.