
Исследование по состоянию на 9 ноября 2026 года
4 ноября Tencent представила HY4 - новую флагманскую нейросеть семейства Hunyuan. Разработчики заявляют о значительном прогрессе в программировании, мультимодальном анализе, управлении компьютером и автономном выполнении сложных задач.
Первые независимые тесты действительно впечатляют: HY4 обходит DeepSeek V4.1 в нескольких рейтингах, занимает третье место в Mercor APEX-Agents и даже опережает Claude Opus 5.5 в отдельных профессиональных сценариях.
Однако другие исследования дают противоположную картину. Vals AI ставит DeepSeek выше новой модели Tencent, а по стоимости выполнения задач HY4 нередко оказывается в несколько раз дороже конкурентов.
Мы сравнили 11 моделей по пяти независимым рейтингам - Vals AI, Artificial Analysis, Mercor APEX-Agents, Agent Arena и WebDev Arena. Дополнительно проанализировали результаты LiveBench, исследование Plotly и отзывы разработчиков.
Чтобы определить не только качество моделей, но и их экономическую эффективность, мы нормализовали показатели интеллекта и стоимость выполнения задач, а затем построили границу Парето.
Главный вопрос исследования: стоит ли переходить на Tencent HY4 или другие модели предлагают сопоставимый интеллект за меньшие деньги?
Если вкратце, то: Tencent HY4 — одна из сильнейших моделей для автономных ИИ-агентов, особенно в задачах, требующих работы с профессиональным программным обеспечением. Tencent делает ставку на управление компьютером, программирование, финансовую аналитику, 3D-моделирование в Blender, CAD-проектирование и разработку игр. По сводному индексу четырёх независимых бенчмарков HY4 превосходит DeepSeek V4.1 примерно на 8%, но её относительная стоимость выполнения задач в 2,6 раза выше. В Mercor APEX-Agents модель набрала 77,6% против 69,8% у DeepSeek, а в Agent Arena заняла 14-е место против 20-го. В специализированном тесте Tencent по 3D-моделированию HY4 также опередила DeepSeek и Kimi, хотя эти результаты пока не подтверждены независимыми исследователями. Особенно перспективна модель для сложных многошаговых процессов, автоматизации работы с программами и анализа данных: в исследовании Plotly она решила 42 из 43 заданий за $2,11, оказавшись дешевле других участников с сопоставимой точностью. При этом по общему интеллектуальному индексу HY4 уступает Kimi K3.1 Pro, GPT-6.1 Terra, Claude и Gemini, а её высокая стоимость и иногда длительное выполнение задач ограничивают применение в массовых API-запросах. Таким образом, HY4 интересна прежде всего как специализированный ИИ-агент для сложной профессиональной работы, тогда как DeepSeek V4.1 остаётся более экономичным универсальным решением.
Анализ бенчмарком и стоимости новой модели ниже.
Что такое Tencent HY4
HY4 - мультимодальная модель, разработанная Tencent Hunyuan для интеллектуальных агентов, программирования и профессиональных рабочих процессов.
По сравнению с HY4 Preview, выпущенной в августе 2026 года, новая версия получила несколько существенных улучшений.
Прежде всего, Tencent развивала способность модели самостоятельно выполнять длинные последовательности действий: изучать информацию, пользоваться инструментами, писать код, запускать программы, находить ошибки и проверять полученные результаты.
Другое важное направление - работа с изображениями и графическими интерфейсами. Компания отдельно развивала возможности HY4 взаимодействовать с профессиональным программным обеспечением, включая Blender, CAD-системы и игровые движки.
Контекстное окно достигает примерно одного миллиона токенов. Это позволяет обрабатывать большие документы, обширные кодовые базы и продолжительные диалоги.
Предыдущая HY4 Preview использовала архитектуру Mixture-of-Experts с 770 миллиардами параметров, около 49 миллиардов из которых активировались на каждом токене. Однако эти характеристики относятся именно к Preview, а не к подтверждённой конфигурации финальной версии.
Веса Preview уже опубликованы, тогда как публикацию весов полной HY4 Tencent на момент анонса только обещала.
В чём Tencent считает HY4 особенно сильной
Tencent позиционирует HY4 прежде всего как модель для решения сложных профессиональных задач (real-world productivity), а не просто универсальный чат-бот. Главный акцент разработчик делает на автономных ИИ-агентах, способных работать с инструментами, взаимодействовать с программами и выполнять длительные процессы с минимальным участием человека.
В официальном обзоре HY4 компания выделяет следующие направления:
| Направление | Заявленные возможности HY4 |
|---|---|
| Автономные ИИ-агенты | Планирование многошаговых действий, вызов инструментов, проверка результатов и исправление ошибок |
| Управление компьютером (Computer Use) | Работа с командной строкой и графическими интерфейсами, включая Blender и CAD-системы |
| Офисная работа | Анализ документов, таблиц, почты, календарей, координация проектов и совместное редактирование |
| Финансовая аналитика | Исследование инвестиционных фондов, анализ ценных бумаг, количественные стратегии и финансовые исследования |
| Программирование и разработка игр | Создание интерфейсов, реализация сложной бизнес-логики, работа с Unity, Unreal Engine и Godot |
| Научные исследования | Математическое и физическое моделирование, научное программирование и автоматизация исследовательских процессов |
Эти заявления частично подтверждаются независимыми исследованиями: HY4 показывает сильные результаты в APEX-Agents и Terminal-Bench, а в тестировании Plotly демонстрирует высокую точность анализа данных. Однако в обычном программировании, юридических и налоговых задачах её преимущество над конкурентами не столь однозначно.
Источник: официальный релиз Tencent HY4.
Общее сравнение интеллекта: HY4 против 10 конкурентов
Для оценки качества одной нейросети недостаточно единственного рейтинга. Разные бенчмарки проверяют разные способности: от интеллектуальных рассуждений до программирования, финансового анализа и самостоятельной работы с инструментами.
Поэтому мы объединили результаты пяти независимых источников.
Сводная таблица качества моделей
| Модель | Vals Index | Artificial Analysis | APEX-Agents | Agent Arena | WebDev Arena |
|---|---|---|---|---|---|
| Gemini 4 Carbon | 70,45% | 60 | 84,2% | +16,63% | 1768 |
| Claude Opus 5.5 | 70,18% | 59 | 73,5% | +19,96% | 1818 |
| Claude Sonnet 5.5 | 70,85% | 55 | 75,5% | +15,99% | 1773 |
| GPT-6.1 Sol | 63,94% | 55 | 60,0% | +12,53% | 1743 |
| Kimi K3.1 Pro | 62,52% | 46 | 65,5% | +5,24% | 1687 |
| DeepSeek V4.1 Flash | 61,26% | 33 | 69,8% | +2,07% | 1664 |
| GPT-6.1 Terra | 60,54% | 51 | 68,3% | +12,10% | 1678 |
| GLM 5.3 | 59,73% | 32 | 56,6% | +0,99% | 1622 |
| Tencent HY4 | 59,35% | 35 | 77,6% | +4,66% | Нет данных |
| Qwen 3.8 Max | 59,05% | 34 | 63,3% | +0,33% | 1677 |
| Xiaomi MiMo V2.6 Pro | 57,81% | 30 | 54,4% | +2,33% | 1624 |
Источники: Vals AI, Artificial Analysis, Mercor, Agent Arena, WebDev Arena.
Что измеряют показатели: Vals Index - долю успешных профессиональных заданий; Artificial Analysis - сводный индекс интеллекта; APEX-Agents - успешность длительных профессиональных процессов; Agent Arena - сравнительную полезность агентов в пользовательских сессиях; WebDev Arena - рейтинг результатов веб-разработки по пользовательским предпочтениям.
Важное ограничение: у финальной HY4 пока нет оценки WebDev Arena. Предыдущая HY4 Preview набрала 1632 балла и заняла 24-е место, но использовать этот показатель в качестве результата новой версии некорректно.
Что можно узнать из пяти рейтингов
HY4 действительно сильнее DeepSeek по некоторым критериям. Tencent опережает DeepSeek в Artificial Analysis, APEX-Agents и Agent Arena. Наиболее заметна разница в APEX: 77,6% против 69,8%.
Однако по Vals Index DeepSeek впереди, а в WebDev сравнить финальные версии пока нельзя.
Kimi K3.1 Pro выглядит более сильной универсальной моделью, опережая HY4 в Vals, Artificial Analysis и Agent Arena. Но в APEX-Agents Tencent показывает существенно более высокую результативность.
Claude и Gemini сохраняют лидерство по широким интеллектуальным оценкам. Они значительно сильнее в Artificial Analysis и WebDev, хотя HY4 способна конкурировать с Claude в отдельных сложных профессиональных заданиях.
Такое расхождение подтверждает, что единого объективного рейтинга интеллекта пока не существует: качество модели зависит от типа задач и условий тестирования.
Сколько стоит выполнение задач: сравнение четырёх источников
Цена миллиона токенов не всегда отражает реальные затраты. Модель может многократно вызывать инструменты, генерировать тысячи токенов рассуждений или требовать повторного запуска из-за ошибок.
Поэтому практичнее сравнивать стоимость выполнения полного задания, а не только тариф API.
Сводная таблица стоимости задач
Стоимость в долларах США.
| Модель | Vals $/тест | AA $/задача | Agent Arena $/задача | WebDev $/задача |
|---|---|---|---|---|
| Gemini 4 Carbon | $10,51 | $7,76 | $1,53 | $1,62 |
| Claude Opus 5.5 | $24,77 | $10,04 | $6,51 | $9,09 |
| Claude Sonnet 5.5 | $16,18 | $10,02 | $3,39 | $3,00 |
| GPT-6.1 Sol | $3,61 | $1,27 | $0,98 | $1,61 |
| Kimi K3.1 Pro | $6,44 | $3,68 | $1,29 | $1,27 |
| DeepSeek V4.1 | $0,66 | $0,60 | $0,15 | $0,12 |
| GPT-6.1 Terra | $2,94 | $0,96 | $0,80 | $0,63 |
| GLM 5.3 | $8,52 | $5,01 | $1,08 | - |
| Tencent HY4 | $1,72 | $1,03 | $0,60 | Нет данных |
| Qwen 3.8 Max | $8,73 | $10,02 | $1,22 | - |
| MiMo V2.6 Pro | $0,43 | $0,26 | $0,17 | - |
Источники: Vals, Artificial Analysis, Agent Arena Pareto, WebDev Arena Pareto. Vals и AA публикуют среднюю стоимость теста, Arena - медианную стоимость пользовательской задачи. Разные столбцы нельзя напрямую сравнивать между собой.
DeepSeek оказывается одним из самых экономичных решений сразу в нескольких независимых исследованиях.
В Vals его задача стоит $0,66 против $1,72 у HY4. В Artificial Analysis - $0,60 против $1,03. В Agent Arena - $0,15 против $0,60.
При этом по интеллектуальным результатам разница между моделями относительно невелика.
Однако означает ли это, что DeepSeek выгоднее вообще всех конкурентов? Чтобы ответить, необходимо учитывать одновременно качество и стоимость.
Нормализованный интеллект и стоимость: какие модели выгоднее
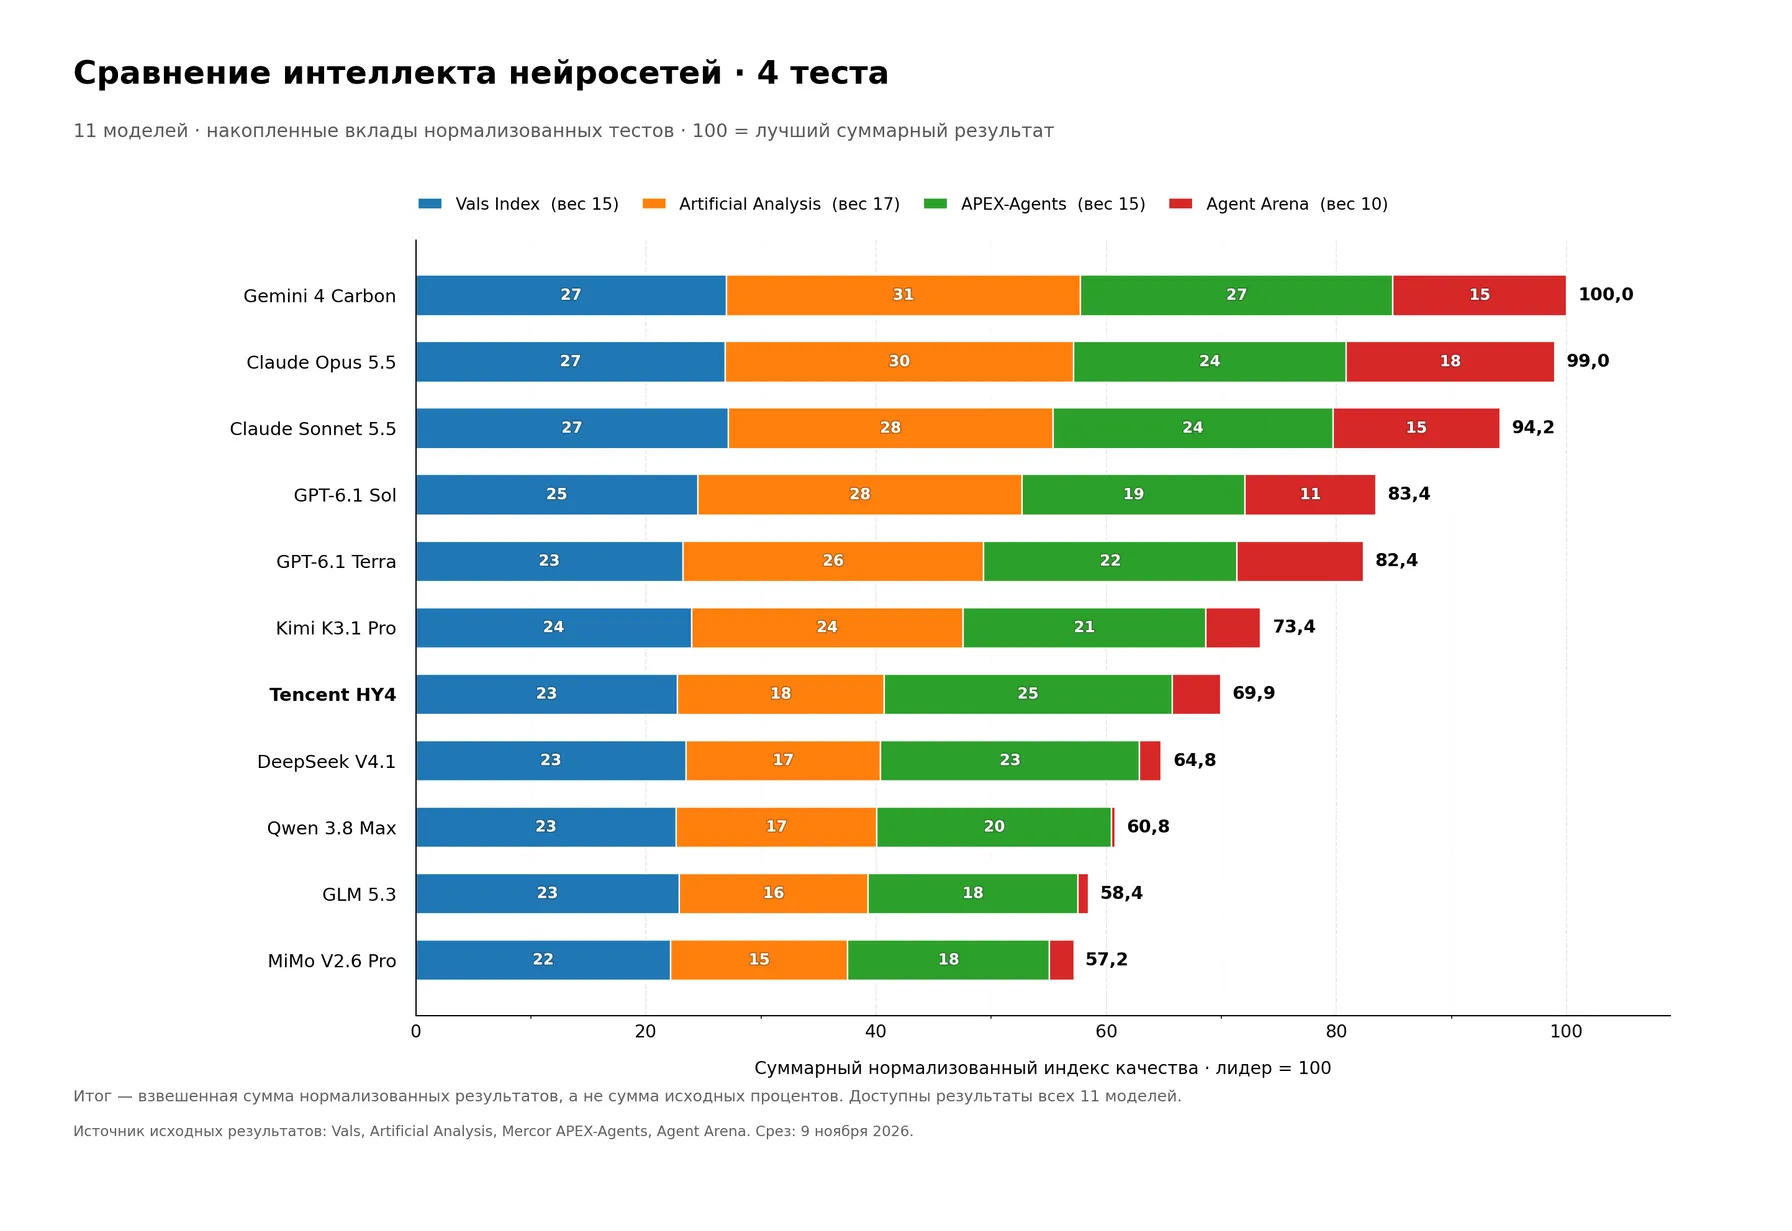
Мы привели результаты различных бенчмарков к сопоставимой шкале по принципу, использованному в исследовании самых умных нейросетей.
Методика кратко: показатели каждого интеллектуального теста нормализованы относительно лидера и объединены взвешенным средним. Стоимость нормализована относительно Claude Opus 5.5 в каждом источнике и объединена геометрическим средним. Для основного индекса использованы четыре теста интеллекта - Artificial Analysis (вес 17), Vals (15), APEX (15), Agent Arena (10) - и три источника стоимости. Наибольший итоговый интеллект принят за 100, относительная стоимость Claude Opus - за 1,00. Это сравнительный индекс выбранных тестов, а не измерение абсолютного IQ.
Общий рейтинг: интеллект и относительная стоимость
| Модель | Индекс интеллекта | Относительная стоимость | Парето |
|---|---|---|---|
| Gemini 4 Carbon | 100,0 | 0,426 | ✓ |
| Claude Opus 5.5 | 99,0 | 1,000 | - |
| Claude Sonnet 5.5 | 94,2 | 0,698 | - |
| GPT-6.1 Sol | 83,4 | 0,141 | ✓ |
| GPT-6.1 Terra | 82,4 | 0,112 | ✓ |
| Kimi K3.1 Pro | 73,4 | 0,266 | - |
| Tencent HY4 | 69,9 | 0,087 | ✓ |
| DeepSeek V4.1 | 64,8 | 0,033 | ✓ |
| Qwen 3.8 Max | 60,8 | 0,404 | - |
| GLM 5.3 | 58,4 | 0,305 | - |
| MiMo V2.6 Pro | 57,2 | 0,023 | ✓ |
Чем выше индекс интеллекта, тем лучше; чем ниже относительная стоимость, тем дешевле. Значения рассчитаны из опубликованных бенчмарков на 9 ноября 2026 года. Условные единицы стоимости не являются долларами.
Диаграмма Парето: интеллект против стоимости
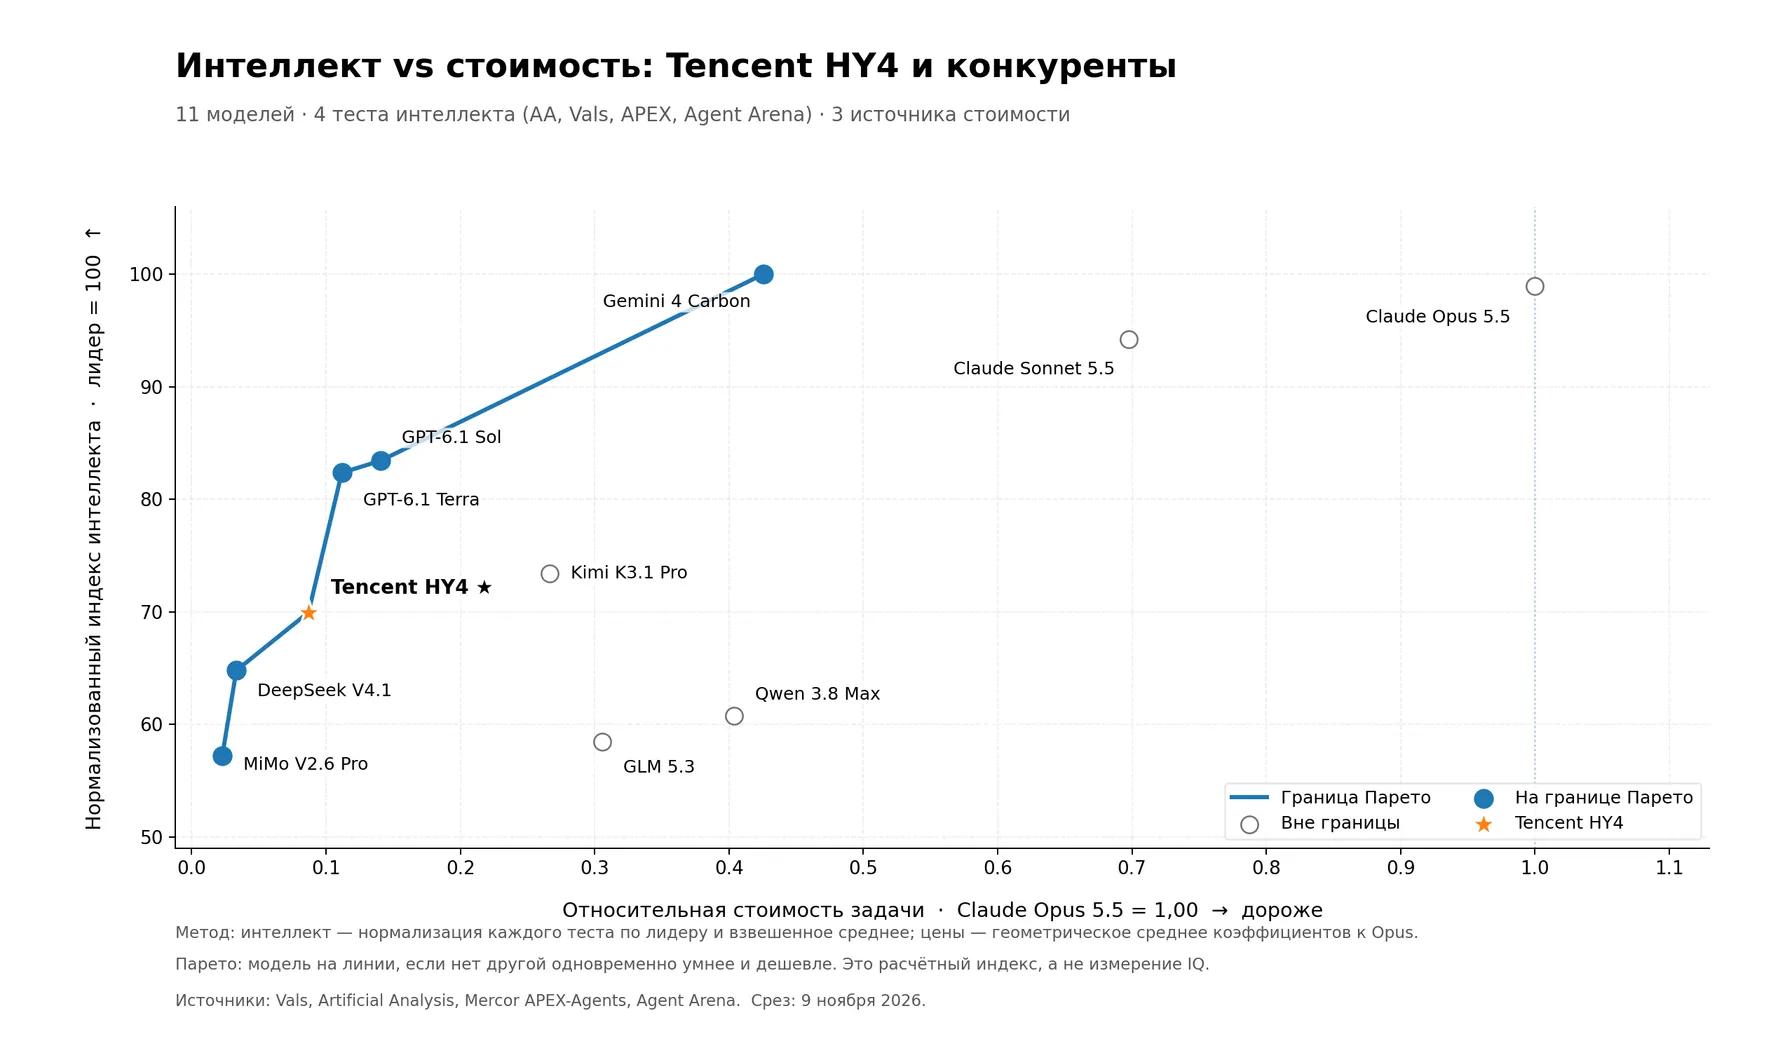
Подпись: Граница Парето для 11 нейросетей по четырём интеллектуальным тестам и трём источникам стоимости. Синяя линия объединяет модели, для которых в выборке нет альтернативы одновременно умнее и дешевле.
Главный результат: Tencent HY4 попадает на границу Парето. Это означает, что среди сравниваемых моделей нет другой, которая одновременно превосходила бы её по рассчитанному индексу интеллекта и обходилась дешевле.
Однако положение на границе не означает, что модель является оптимальной для любой задачи.
HY4 против DeepSeek. По сводному индексу Tencent набирает 69,9 балла против 64,8 у DeepSeek - преимущество примерно на 8%. Но её относительная стоимость в 2,6 раза выше.
HY4 против GPT-6.1 Terra. Terra предлагает 82,4 балла против 69,9 у HY4 при увеличении относительной стоимости с 0,087 до 0,112, то есть примерно на 29%. Это делает Terra интересным компромиссом между качеством и затратами.
Kimi K3.1 Pro не попадает на границу Парето. По выбранной методике GPT-6.1 Terra и Sol одновременно обладают более высоким сводным интеллектом и меньшей стоимостью. Но в отдельных профессиональных тестах Kimi может показывать иные результаты.
Gemini 4 Carbon доминирует над Claude Opus 5.5 в основном индексе: её оценка немного выше, а относительная стоимость существенно ниже. Однако этот вывод меняется при добавлении WebDev.
Как меняется рейтинг с учётом Arena WebDev
Для проверки устойчивости результатов мы построили вторую диаграмму, включив WebDev Arena в качестве пятого интеллектуального теста и четвёртого источника стоимости.
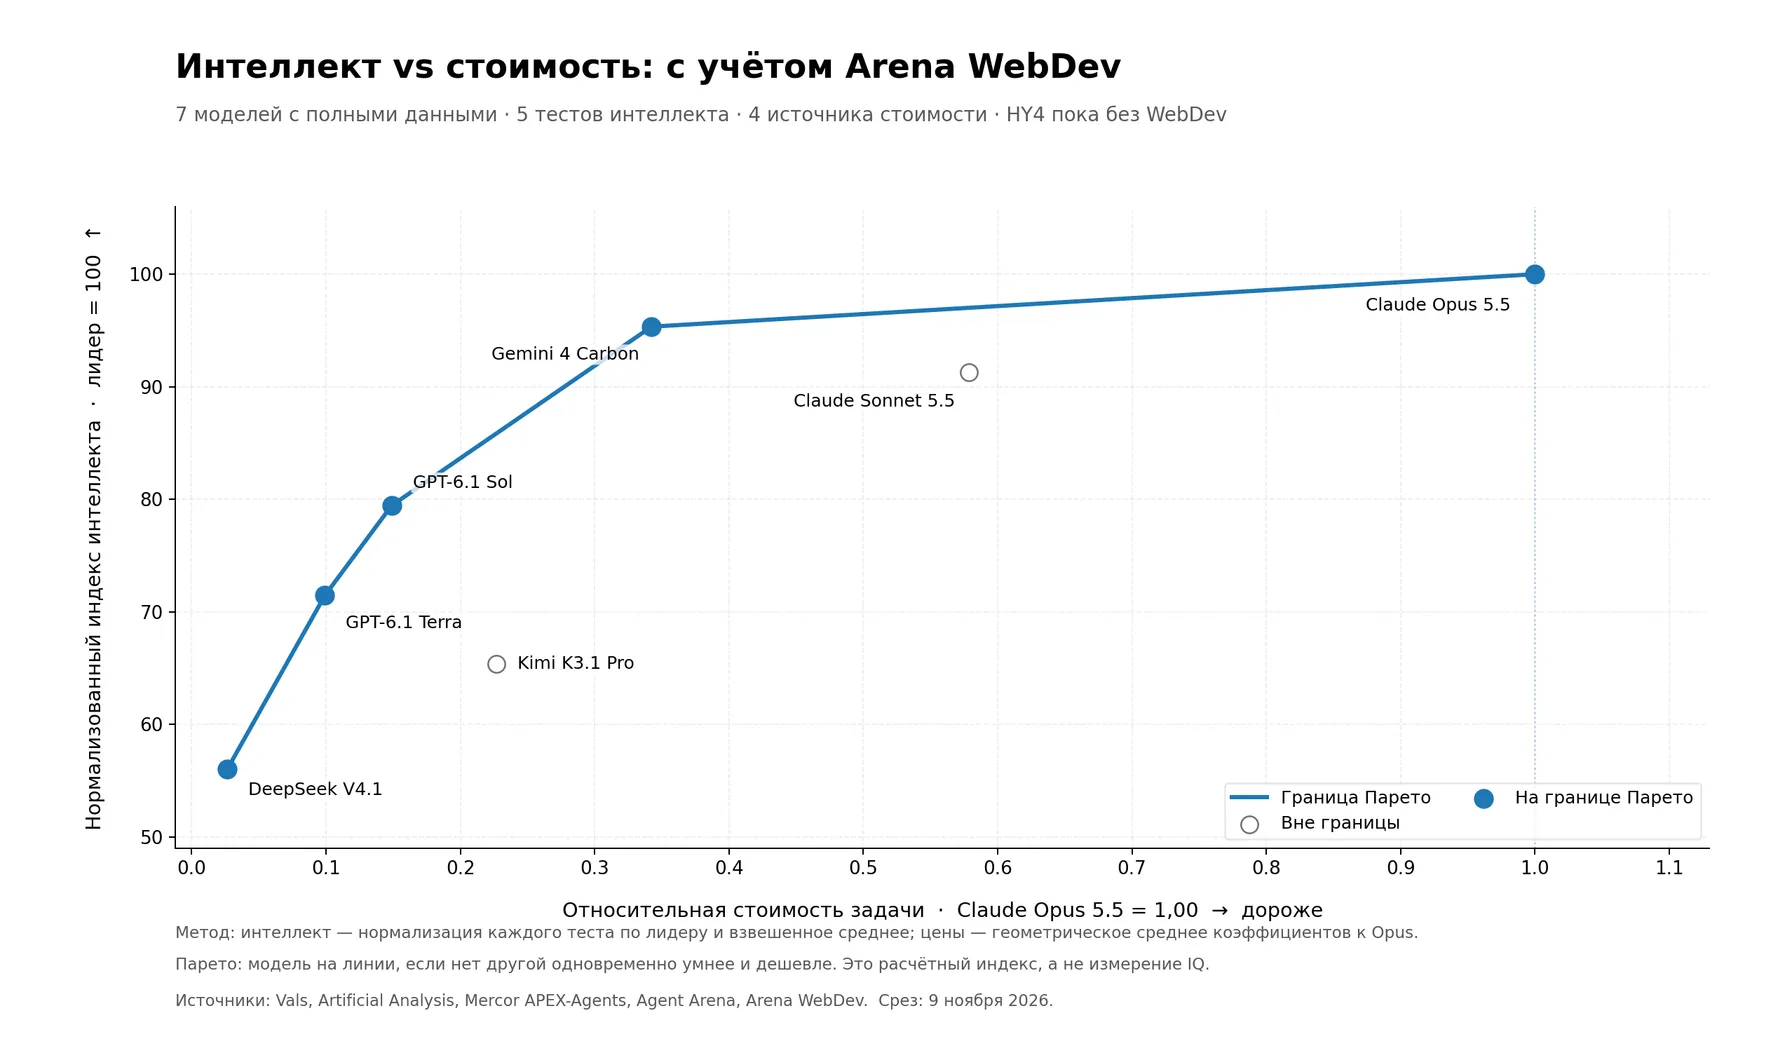
Подпись: Граница Парето с учётом WebDev Arena. В выборку вошли только семь моделей с полным набором опубликованных показателей. Финальная Tencent HY4 исключена из этой диаграммы из-за отсутствия данных WebDev. Для рейтинговой шкалы WebDev использована min-max-нормализация.
При добавлении WebDev Claude Opus 5.5 возвращается на границу Парето. Её преимущество в веб-разработке повышает общий индекс до 100, хотя Gemini 4 Carbon остаётся заметно дешевле.
GPT-6.1 Sol и Terra сохраняют сильные позиции по сочетанию качества и стоимости. DeepSeek остаётся самой дешёвой моделью среди семи участников с полными данными.
Этот результат показывает, насколько состав тестов влияет на итоговый рейтинг. Поэтому основной график с HY4 и дополнительный график с WebDev лучше рассматривать вместе, не сравнивая их индексы напрямую: наборы моделей и бенчмарков различаются.
Где HY4 сильнее DeepSeek: программирование и профессиональные задачи
Общие индексы полезны для оценки положения модели среди конкурентов, но скрывают различия в отдельных дисциплинах.
Сравним результаты HY4 и DeepSeek V4.1 Flash 1017 в специализированных тестах Vals.
| Тест | HY4 | DeepSeek |
|---|---|---|
| Terminal-Bench 4.0 | 39,39% | 31,82% |
| Vibe Code Bench | 81,01% | 87,73% |
| Finance Agent v2.1 | 64,70% | 62,93% |
| Tax Agent Bench | 34,40% | 44,35% |
| Legal Research Bench | 41,35% | 45,19% |
| Excel Modeling Bench | 66,18% | 69,17% |
| Harvey Legal Agent Bench | 12,50% | 14,17% |
В Terminal-Bench модель должна самостоятельно решать технические задачи в терминале: работать с файлами, выполнять команды, устанавливать зависимости и исправлять ошибки.
Здесь HY4 показывает заметное преимущество - 39,39% против 31,82%.
Но в Vibe Code Bench, который оценивает разработку приложений, сильнее DeepSeek: 87,73% против 81,01%.
В финансовых агентных задачах HY4 немного впереди, однако в налоговых заданиях, юридическом поиске и работе с электронными таблицами лидерство остаётся за DeepSeek.
Это демонстрирует различие между созданием программного кода и автономной работой с инструментами. HY4 особенно интересна для многошаговых технических процессов, но не является безусловным лидером программирования.
Blender и CAD: отдельная специализация Tencent HY4
Одной из необычных особенностей HY4 стала специализированная подготовка к работе с профессиональными программами для 3D-моделирования и проектирования. Tencent обучала модель взаимодействовать с Blender и CAD-системами, используя возможности Computer Use: нейросеть может анализировать графический интерфейс, управлять приложениями, выполнять команды и проверять результаты своей работы.
В отличие от обычных генераторов 3D-объектов по текстовому запросу, HY4 ориентирована на выполнение последовательности операций непосредственно в профессиональном ПО — от создания и изменения объектов до подготовки сцены и проверки результата.
В специализированном бенчмарке 3DArena-Modeling Tencent представила следующие результаты:
| Модель | Результат |
|---|---|
| Claude Opus 5.5 | 43,4 |
| GPT-6.1 Sol | 41,8 |
| Tencent HY4 | 37,1 |
| Kimi K3.1 Pro | 36,1 |
| DeepSeek V4.1 | 32,3 |
| HY4 Preview | 23,4 |
| GLM 5.3 | 23,0 |
Источник: результаты 3DArena-Modeling из материалов Tencent. Бенчмарк является внутренним тестом разработчика и пока не имеет независимого подтверждения.
Новая HY4 существенно улучшила результат Preview и опередила DeepSeek V4.1 и Kimi K3.1 Pro, хотя уступила GPT-6.1 Sol и Claude Opus 5.5.
Это делает модель перспективной для автоматизации создания 3D-сцен, подготовки визуализаций и работы с профессиональными графическими инструментами. Однако успешное 3D-моделирование не равнозначно надёжному инженерному CAD-проектированию. Независимых данных о точности размеров, соблюдении допусков и корректности сложных инженерных моделей пока недостаточно. Поэтому возможности HY4 в CAD следует рассматривать как перспективное направление, а не как доказанную замену специализированным инженерным инструментам.
Mercor APEX-Agents: HY4 неожиданно обходит Claude
Один из наиболее впечатляющих результатов Tencent - третье место в APEX-Agents, независимом тесте компании Mercor.
В нём используются 240 профессиональных заданий, объединённых в 31 рабочий сценарий. Модели выполняют задачи инвестиционных аналитиков, управленческих консультантов и корпоративных юристов.
Вместо коротких вопросов необходимо изучать документы, работать с несколькими приложениями, находить информацию и выполнять последовательность действий до получения готового результата.
Результаты APEX-Agents
| Модель | Pass@1 |
|---|---|
| Gemini 4 Carbon High | 84,2% |
| Gemini 4 Argon High | 82,4% |
| Tencent HY4 High | 77,6% |
| Claude Sonnet 5.5 Max | 75,5% |
| Claude Opus 5.5 Max | 73,5% |
| DeepSeek V4.1 Flash | 69,8% |
| Kimi K3.1 Pro | 65,5% |
| Qwen 3.8 Max | 63,3% |
Источник: Mercor APEX-Agents.
HY4 опережает DeepSeek на 7,8 процентного пункта и показывает более высокий результат, чем Claude Opus 5.5.
При этом интервалы неопределённости нескольких соседних моделей пересекаются, поэтому нельзя уверенно утверждать, что Tencent статистически превосходит Claude.
Тем не менее результаты подтверждают сильную сторону HY4 - способность выполнять длительные профессиональные задачи с использованием инструментов.
Это также объясняет расхождение с Vals: платформы оценивают разные наборы задач, поэтому результаты одной модели могут существенно отличаться.
WebDev Arena: сравнение моделей при создании сайтов
WebDev Arena оценивает, насколько хорошо нейросети создают сайты и веб-приложения. Рейтинг основан на сравнительных предпочтениях пользователей и учитывает не только программный код, но и качество полученного интерфейса.
По состоянию на 8 ноября 2026 года в рейтинге участвовали 154 модели, а общее число голосов достигло почти 986 тысяч.
Лидером выступает Claude Opus 5.5 с рейтингом 1818. Следом идут Claude Sonnet 5.5 (1773) и Gemini 4 Carbon (1768).
DeepSeek V4.1 занимает 16-е место с рейтингом 1664, но отличается исключительно низкой медианной стоимостью веб-задачи - $0,12.
Для сравнения, GPT-6.1 Terra получает 1678 баллов при стоимости $0,63, а Kimi K3.1 Pro - 1687 баллов при $1,27.
Claude Opus 5.5 обходится уже в $9,09 за медианную веб-задачу - примерно в 76 раз дороже DeepSeek.
Разумеется, разница в качестве может оправдывать такую цену в сложных коммерческих проектах. Но для массовой разработки прототипов, небольших сайтов и интерфейсов DeepSeek выглядит очень конкурентоспособно.
Для финальной HY4 результат WebDev пока отсутствует. Поэтому говорить о её превосходстве или отставании в веб-разработке на основании данного рейтинга нельзя.
Источник: Arena WebDev.
Plotly: когда HY4 оказывается одной из самых выгодных моделей
В большинстве рассмотренных тестов DeepSeek выполняет задачи дешевле HY4. Но исследование компании Plotly демонстрирует важное исключение.
Разработчик инструментов визуализации проверил модель Tencent на DataAnalyticsBench - наборе из 43 задач анализа данных с использованием SQL, графиков и последовательных вызовов инструментов.
Модели анализировали данные из хранилища примерно на 20 миллионов строк, находили закономерности, проверяли расчёты и избегали статистических ошибок.
HY4 решила 42 из 43 заданий.
| Модель | Решено | Стоимость полного теста |
|---|---|---|
| GPT-6.1 Sol | 43/43 | $2,61 |
| Tencent HY4 | 42/43 | $2,11 |
| Grok 4.7 | 42/43 | $7,85 |
| Kimi K3.1 Pro | 42/43 | $13,47 |
Источник: Plotly - Tencent HY4 Benchmark Results. DeepSeek V4.1 в этом сравнении не участвовал.
HY4 оказалась самой дешёвой среди проверенных моделей, решивших не менее 42 заданий.
Но была и проблема: медианное время ответа составило 117 секунд против 18 секунд у GPT-6.1 Sol.
Исследователи обнаружили, что HY4 склонна многократно перепроверять результаты. Она выполняла большое количество запросов и операций с графиками, пытаясь убедиться в правильности выводов.
Такая тщательность помогала избежать ошибок, но серьёзно увеличивала время выполнения.
Для сложной аналитики, где качество важнее скорости, подобное поведение может быть преимуществом. Для интерактивного чата - недостатком.
LiveBench: пока недостаточно данных для прямого сравнения
LiveBench регулярно обновляет задания, чтобы снизить риск попадания тестовых вопросов в обучающие данные нейросетей.
В нём оцениваются программирование, логические рассуждения, анализ информации, работа с браузером и другие способности.
У DeepSeek V4.1 Flash 1017 уже есть опубликованные результаты в LiveBench 2.0. Однако для финальной HY4 на дату исследования не удалось подтвердить полный сопоставимый набор оценок.
Поэтому мы не включали LiveBench в нормализованный рейтинг и не использовали данные HY4 Preview в качестве замены.
Источник: LiveBench.
Что обсуждают разработчики на Reddit, Hacker News и в X
Реакция сообщества на HY4 оказалась неоднозначной.
В r/LocalLLaMA обсуждают возможности модели в 3D, работе с графическими инструментами и игровыми движками. Одновременно пользователей интересуют стоимость API, возможности локального запуска и сроки публикации весов.
На Hacker News заметное внимание уделили экономике агентных процессов и чрезмерной обстоятельности HY4. Представитель Plotly подтвердил высокую точность модели в аналитике, но отметил, что она часто выполняет слишком много проверок и из-за этого работает медленно.
В X интерес вызвали результаты Mercor APEX-Agents, где HY4 получила одну из самых высоких оценок среди моделей с заявленной публикацией весов.
При этом полноценной статистики пользовательских A/B-тестов финальной HY4 пока немного. Отзывы о Preview нельзя автоматически распространять на новую версию.
Почему разные бенчмарки дают противоречивые результаты
На первый взгляд результаты выглядят странно.
В Vals DeepSeek сильнее Tencent. В Artificial Analysis небольшое преимущество получает HY4. В Mercor превосходство HY4 значительно больше, а в Agent Arena она выше по пользовательским сигналам качества, но заметно дороже.
На самом деле эти исследования проверяют разные способности.
Успешное решение задач программирования не тождественно управлению компьютером. Интеллектуальные рассуждения не гарантируют успешной работы агента. А более высокий процент правильных ответов не обязательно означает меньшую стоимость решения.
Кроме того, результаты зависят от настроек рассуждения, числа доступных инструментов, ограничений времени и особенностей агентной инфраструктуры.
Наконец, важны статистические погрешности. Небольшая разница в рейтинге не всегда означает устойчивое превосходство одной модели над другой.
Именно поэтому в нашем исследовании использованы сразу несколько независимых оценок, а нормализованный индекс дополнен анализом отдельных дисциплин и стоимости.
Какую нейросеть выбрать для разных задач
| Сценарий | Интересные модели | Почему |
|---|---|---|
| Универсальные запросы и API | DeepSeek V4.1, GPT-6.1 Terra | Сильное соотношение качества и цены |
| Максимальный общий интеллект | Gemini 4 Carbon, Claude Opus 5.5 | Лидерство по широким оценкам |
| Создание сайтов и интерфейсов | Claude Opus 5.5, Gemini 4 Carbon | Высокий рейтинг WebDev |
| Недорогая веб-разработка | DeepSeek V4.1 | Рейтинг 1664 при $0,12 за задачу |
| Работа с терминалом | HY4 | Преимущество над DeepSeek в Terminal-Bench |
| Профессиональные агенты | HY4, Gemini 4 Carbon | Высокие результаты APEX-Agents |
| Сложный анализ данных | HY4, GPT-6.1 Sol | Сильные результаты Plotly |
| Массовая дешёвая автоматизация | DeepSeek V4.1, MiMo V2.6 Pro | Низкая стоимость выполнения задач |
Это кандидаты для тестирования, а не гарантированные победители во всех задачах соответствующей категории.
Итог: HY4 на границе Парето, но DeepSeek остаётся значительно дешевле
Исследование показывает, что Tencent HY4 стала серьёзным конкурентом ведущих нейросетей, особенно в задачах автономных агентов, программирования с использованием инструментов и анализа данных.
Модель демонстрирует высокие результаты в APEX-Agents и Terminal-Bench, а в отдельных профессиональных сценариях способна конкурировать даже с Claude.
Но объявлять её универсальным лидером пока преждевременно. По Vals Index впереди остаются DeepSeek, Kimi и GLM, а широкие интеллектуальные рейтинги отдают преимущество наиболее сильным коммерческим моделям.
Нормализованное сравнение четырёх независимых тестов даёт HY4 69,9 балла против 64,8 у DeepSeek. При этом относительная стоимость Tencent в 2,6 раза выше.
Обе модели находятся на границе Парето, но занимают разные её участки: DeepSeek делает ставку на экономичность, а HY4 предлагает более высокий сводный интеллектуальный показатель за дополнительные расходы.
Важным конкурентом оказывается GPT-6.1 Terra. Её нормализованный интеллект достигает 82,4 балла при стоимости всего на 29% выше HY4 по выбранной методике.
Дополнительная диаграмма с WebDev показывает, что состав тестов заметно меняет итоговые позиции моделей. Claude Opus 5.5 возвращается на границу Парето благодаря сильным результатам веб-разработки.
Для финальной HY4 WebDev пока не опубликовала оценку, поэтому её положение в таком пятикомпонентном сравнении остаётся неизвестным.
Наконец, нельзя игнорировать специализацию. Хотя в большинстве общих агентных тестов HY4 дороже DeepSeek, исследование Plotly показывает, что в сложной аналитике Tencent может оказаться исключительно выгодной по стоимости качественного результата.
Главный вывод исследования: HY4 стоит рассматривать не как универсальную замену DeepSeek, а как сильную альтернативу для сложных агентных задач.
А оценивать современные нейросети следует не только по интеллектуальным бенчмаркам, но и по двум другим показателям - стоимости успешно выполненной задачи и времени, необходимому для получения результата.
Именно их сочетание определяет практическую ценность модели.
Источники исследования
- Tencent - официальный исследовательский релиз HY4
- Vals AI - Vals Index
- Artificial Analysis - рейтинг языковых моделей
- Mercor - APEX-Agents
- Agent Arena - общий рейтинг
- Agent Arena - Pareto Frontier
- WebDev Arena - общий рейтинг
- WebDev Arena - Pareto Frontier
- Plotly - результаты HY4 в анализе данных
- LiveBench - официальный рейтинг
- Reddit - обсуждение HY4
- Hacker News - обсуждение Tencent HY4