
Исследование GPTunnel, данные актуальны на 5 ноября 2026 года. Что вы получите из этой статьи: рейтинг самых умных моделей ии, рейтинг по отраслям (программирование, финансы и тд), топ самых эффективных по цене (дешевизна за задачу), топ самых эффективных моделей - с учетом уровня интеллекта, дешевизны и быстродействия модели. При выходе новых моделей рейтинг будет обновляться.
Мы сравнили 20 моделей нейросетей по восьми бенчмаркам, которые оценивают разные способности: рассуждения, профессиональные задачи, программирование, агентную работу и предпочтения пользователей, и объединили данные в один общий рейтинг. Так же, посчитали свои агрегированные данные по стоимости и быстродействию каждой модели.
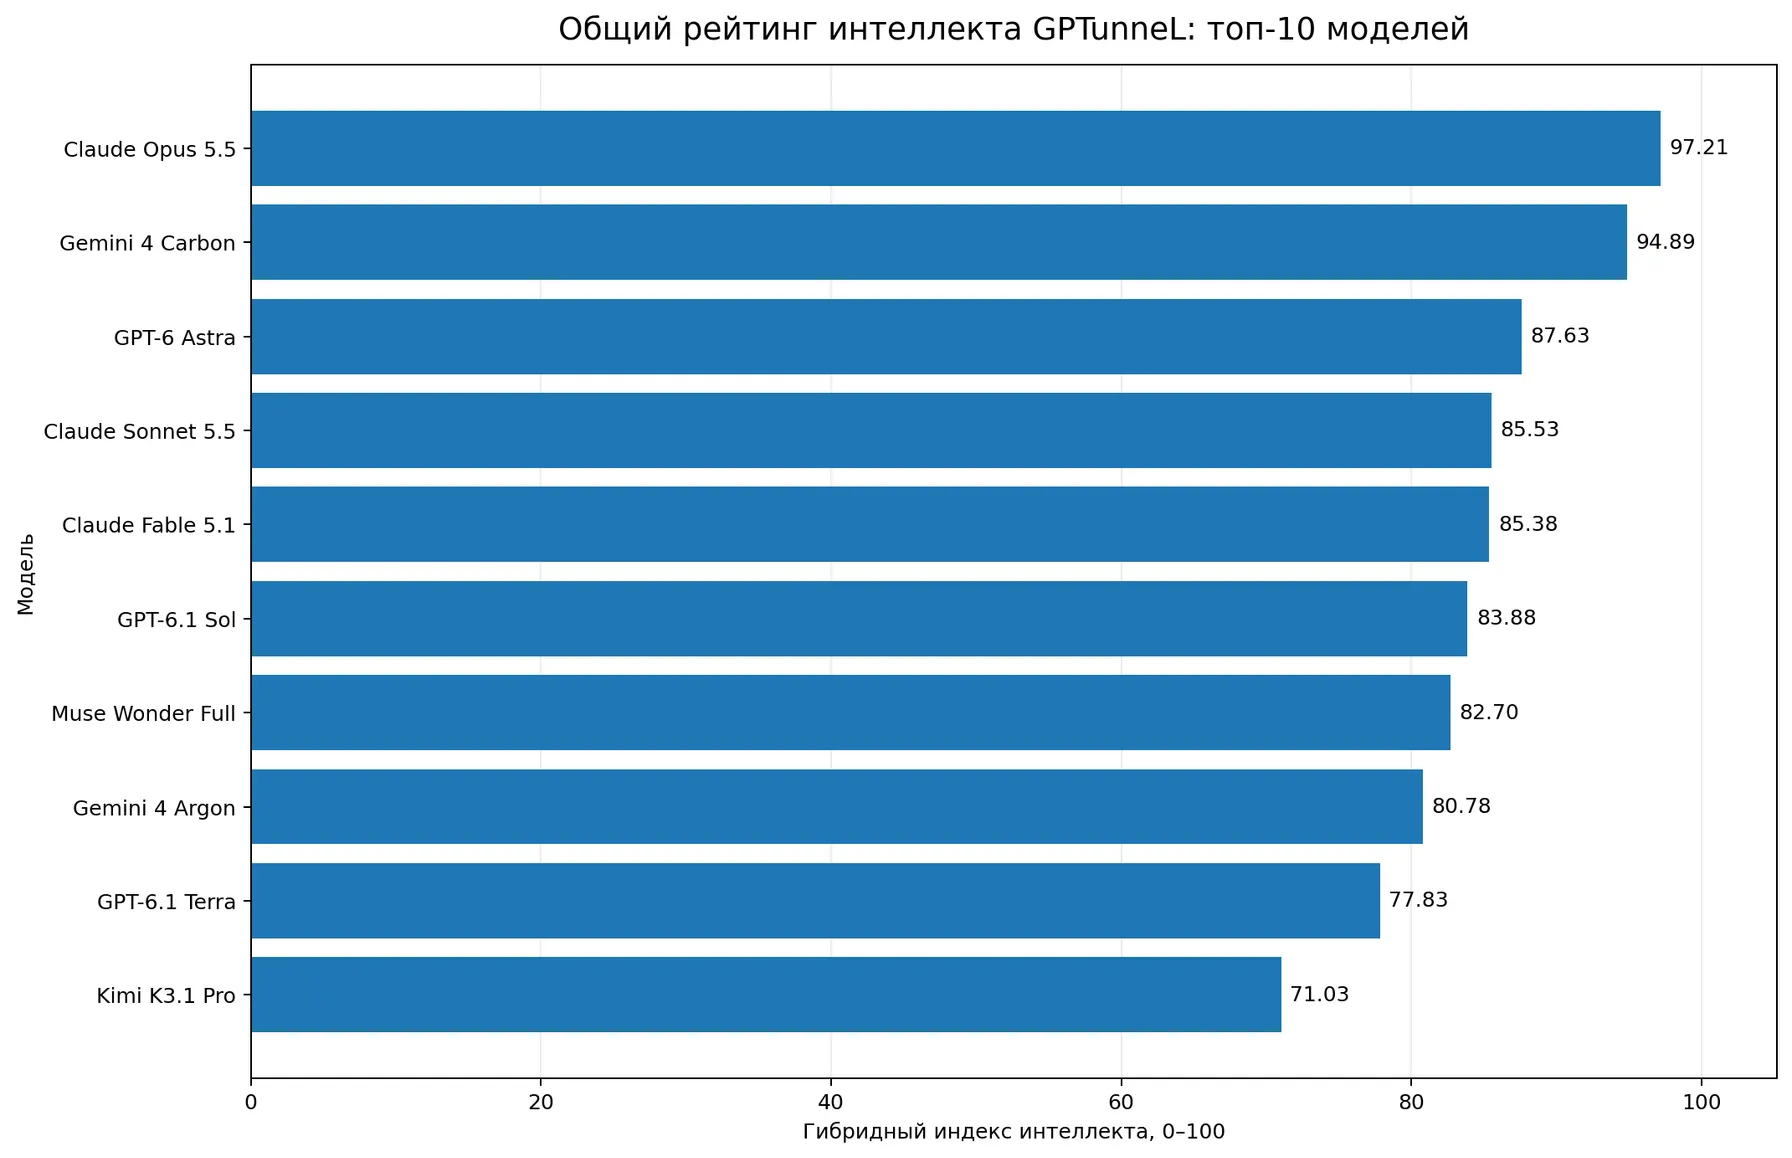
Главный вывод: самый умный ИИ на данный момент - Claude Opus 5.5, но Gemini 4 Carbon подобрался к нему вплотную (97,21 и 94,89 балла в рейтинге). При этом, Gemini 4 Carbon значимо дешевле и немного быстрее. Ложка дёгтя - на данный момент модель еще не выложена в общий доступ , это скорее всего это случиться в ближайшее время.
Коротко: какие модели лидируют и кому что выбрать
| Задача читателя | Наш ориентир | Почему |
|---|---|---|
| Максимум общего интеллекта | Claude Opus 5.5 | Первый по GPTunneL Intelligence Index — 97,21; Carbon близка — 94,89 |
| Качественная альтернатива Opus | Gemini 4 Carbon | Сопоставимый интеллект, но быстрее и дешевле |
| Сложное программирование | Opus, Sonnet, Carbon, Astra | Профильный индекс AA + Vals + Arena: 97,74 / 91,56 / 90,43 / 89,46 |
| Универсальный баланс | GPT-6.1 Sol /GPT-6.1 Terra / DeepSeek V4.1 Flash 1017 | Sol сильнее по интеллекту, Terra лидирует по эффективности |
| Много недорогих повторяемых задач | Terra / DeepSeek | Высокая экономическая эффективность; качество обязательно проверять |
Первая диаграмма нашей статье - общий рейтинг интеллекта. Данные по эффективности с учетом скорости и быстродействия представлены ниже по тексту.
10 интересных выводов из нашего исследования нейросетей
Мы сравнили 20 моделей искусственного интеллекта по восьми бенчмаркам, изучили их стоимость, скорость, способности в отдельных областях и экономическую эффективность. Вот что показали результаты.
-
Универсального лидера по всем специализациям не существует. Opus лидирует в объединённом рейтинге программирования, GPT-6 Astra — в комбинированном рейтинге рассуждений. Однако, существует группа универсальных лидеров: Opus 5.5, Gemini 4 Carbon и GPT-6 Astra (как неожиданно - все фронтир модели) особенно часто занимают первые места или входят в ближайшую группу преследователей. Sonnet тоже очень конкурентоспособна в программировании, финансах и дизайне.
-
Выбор лучшей нейросети по соотношению интеллекта, цены и быстродействия зависит от предпочтений пользователя. Далеко не для всех задач нужна самая умная модель - средние модели способны выполнять большой объем задач, и если вы готовы согласиться немного понизить свои требования к "интеллекту" модели, то можете сильно (или очень сильно - до десятков раз) выиграть в стоимости за выполненную задачу. При умеренном приоритете интеллекта (то есть, нам не нужна сильная модель) по индексу эффективности лидирует DeepSeek V4.1 Flash. При сбалансированном варианте (нужна модель немного умнее) побеждает GPT-6.1 Terra. А если сильнее учитывать интеллектуальные способности (более умная, но не топ), первое место получает GPT-6.1 Sol.
После выхода свежей Terra 6.1 лично я использую её для многих задач - мне нравится ее быстродействие и она достаточно умна. Зачем ждать 2 минуты там, где можно получить результат за 20 секунд?
-
Самая умная нейросеть оказалась далеко не самой эффективной (стоимость и скорость за условную единицу интеллекта). Claude Opus 5.5 возглавила рейтинг интеллекта с результатом 97,21 балла, но заняла только седьмое место по эффективности. GPT-6.1 Terra уступает ей по интеллекту, зато получила 234 балла эффективности против 100 у Opus. По нашей формуле Terra оказалась в 2,34 раза эффективнее.
-
Самые умные нейросети вовсе не обязательно самые медленные. Можно предположить, что более интеллектуальные модели требуют больше вычислений и времени. Однако корреляция между индексом интеллекта и временем выполнения задач составила всего 0,16. В нашей выборке высокий интеллект практически не связан с увеличением времени ожидания ответа.
-
Gemini 4 Carbon почти догнала Opus по интеллекту, но оказалась значительно выгоднее. Carbon набрала 94,89 балла интеллекта против 97,21 у Opus. При этом её индекс эффективности составляет 141,5 против 100. Получается, относительно небольшая разница в интеллектуальных возможностях сопровождается существенным преимуществом по сочетанию цены и скорости.
-
Нейросеть, которая нравится пользователям в режиме простого чата, не обязательно самая интеллектуальная. Корреляция рейтинга Arena Text с результатами LiveBench составляет лишь 0,438, а со StealthMark — 0,431. Это говорит о том, что пользовательские предпочтения и результаты формальных интеллектуальных испытаний отражают разные стороны качества ИИ.
-
Стоимость нейросети предсказать значительно проще, чем скорость её работы. Показатели расходов в Vals и LiveBench демонстрируют корреляцию 0,987 на 12 моделях. А корреляции времени выполнения задач между исследованными источниками находятся примерно в диапазоне 0,48–0,68. Следовательно, модель, быстрая в одном бенчмарке, не обязательно окажется столь же быстрой в другом.
-
Даже победитель общего рейтинга зависит от выбранных бенчмарков. Claude Opus 5.5 сохраняет лидерство в 7 из 8 проверок, когда мы последовательно исключаем один бенчмарк и пересчитываем веса. Но если убрать Arena WebDev, на первое место выходит Gemini 4 Carbon. Это показывает, насколько важно учитывать состав испытаний при определении самой умной модели.
-
В программировании нет одного безоговорочного победителя для любых задач. В объединённом рейтинге Artificial Analysis, Vals и Arena лидирует Claude Opus 5.5 (97,74), за ней следуют Sonnet (91,56), Carbon (90,43) и Astra (89,46). Между Carbon и Astra меньше одного балла, а при исключении Terminal-Bench они меняются местами. Выбор лучшей модели зависит от того, что именно нужно программировать.
-
Стоимость успешного решения может различаться почти в 30 раз. По данным LiveBench, успешная задача для MiniMax M3.1 Flash обходилась примерно в $0,153, а для Claude Opus 5.5 — в $4,291. Разница составляет около 28 раз. Но, следует помнить, что дешевая модель не всегда способна выполнить те задачи, которые решает более дорогая.
Главный вывод: самая интеллектуальная, самая быстрая, самая дешёвая и самая эффективная нейросеть — не одна и та же модель. Для осознанного выбора нужно учитывать не только общий рейтинг, но и специализацию, сложность задачи, стоимость ошибки и затраты на получение правильного результата.
*Все результаты относятся к исследовательскому срезу ноября 2026 года.
Навигация по исследованию
Общий рейтинг · Корреляции бенчмарков · Стоимость моделей · Скорость · Эффективность p = 3 · Лучшие по специализациям · Выбор под задачи · FAQ · Методология и источники
Общий рейтинг: сравнение 20 нейросетей по восьми источникам
Чтобы сравнение было проверяемым, ниже указаны все исходные рейтинги, а наш индекс расположен сразу после названия модели. Далее приведены результаты: Artificial Analysis (AA), Vals, LiveBench, три рейтинга Arena Text, Arena WebDev, Agent Arena, ARC-AGI-2 и StealthMark General.
| № | Модель | Индекс GPTunneL | AA v5 | Vals % | LiveBench | Arena Text | Arena WebDev | Agent Arena % | ARC-AGI-2 % | Stealth General |
|---|---|---|---|---|---|---|---|---|---|---|
| 1 | Claude Opus 5.5 | 97,21 | 58 | 70,18 | 85,1 | 1509 | 1810 | 20,04 | 93,30 | 71,3 |
| 2 | Gemini 4 Carbon | 94,89 | 59 | 70,45 | Нет данных | 1528 | 1768 | 16,56 | Нет данных | Нет данных |
| 3 | GPT-6 Astra | 87,63 | 57 | 65,02 | 85,6 | 1476 | 1773 | 13,68 | 95,00 | 73,4 |
| 4 | Claude Sonnet 5.5 | 85,53 | 54 | 70,85 | 80,0 | 1477 | 1770 | 14,62 | 83,90 | 67,0 |
| 5 | Claude Fable 5.1 | 85,38 | 50 | Нет данных¹ | 85,7 | 1504 | 1746 | 13,15 | 90,00 | 60,6 |
| 6 | GPT-6.1 Sol | 83,88 | 55 | 63,94 | 84,1 | 1481 | 1751 | 12,24 | 94,20 | 64,4 |
| 7 | Muse Wonder Full | 82,70 | 50 | 66,79 | Нет данных | Нет данных | 1725 | 9,63 | Нет данных | Нет данных |
| 8 | Gemini 4 Argon | 80,78 | 50 | 69,24 | 79,3 | 1520 | 1679 | 10,61 | 91,30 | 63,6 |
| 9 | GPT-6.1 Terra | 77,83 | 51 | 60,54 | 77,8 | Нет данных | 1673 | 10,19 | Нет данных | 58,0 |
| 10 | Kimi K3.1 Pro | 71,03 | 46 | 62,52 | 71,3 | Нет данных | 1695 | 4,70 | Нет данных | 53,9 |
| 11 | Muse Wonder | 67,41 | 43 | 64,88 | 74,2 | 1507 | 1652 | 2,51 | Нет данных | 53,1 |
| 12 | Qwen 3.8 Max 0902 | 65,31 | 34 | 59,05 | Нет данных | Нет данных | 1676 | Нет данных | Нет данных | 62,7 |
| 13 | DeepSeek V4.1 Flash 1017 | 64,28 | 32 | 61,26 | 72,9 | Нет данных | 1665 | 2,13 | 78,10 | 56,8 |
| 14 | GLM 5.3 | 55,34 | 32 | 59,73 | Нет данных | 1481 | 1623 | 1,17 | Нет данных | 37,6 |
| 15 | MiMo V2.6 Pro | 55,25 | 30 | 57,81 | 68,5 | 1480 | 1625 | 2,44 | Нет данных | 44,3 |
| 16 | Gemini 3.8 Flash | 54,24 | 31 | 55,95 | 59,2 | 1496 | 1583 | 2,56 | 89,20 | 43,9 |
| 17 | Grok 4.7 | 53,50 | 35 | 58,56 | 70,1 | 1441 | 1637 | 2,64 | 61,40 | 48,4 |
| 18 | Claude Haiku 5.5 | 48,12 | 36 | 58,73 | 69,8 | 1425 | 1589 | 0,65 | 61,30 | 47,6 |
| 19 | MiniMax M3.1 Flash | 47,74 | 29 | 53,78 | 66,9 | Нет данных | 1582 | 3,22 | Нет данных | 35,8 |
| 20 | Step 5 Preview | 45,32 | 29 | 54,76 | 58,6 | 1448 | 1571 | 2,53 | Нет данных | 37,1 |
Как читать таблицу:
- AA v5 — собственные баллы Artificial Analysis; Vals — доля успешных профессиональных заданий; LiveBench — баллы комплексного набора тестов.
- Arena Text и WebDev — рейтинговые очки сравнительных испытаний, в которых больше — лучше; Agent Arena — показатель Net Improvement, а не точность ответов.
- ARC-AGI-2 — доля решённых задач на абстрактные закономерности; Stealth General — показатель пространственного и последовательного рассуждения.
- «Нет данных» — измеренная оценка отсутствует в нашем срезе. В таблице представлены только опубликованные измерения, без прогнозных чисел. Для расчёта индекса GPTunneL при наличии сопоставимых исторических версий применяется экстраполяция (как для Vals Fable), в остальных случаях — прогноз ближайших моделей (kNN) и восстановление в исходную шкалу. Поэтому итоговый индекс может включать прогнозные компоненты, хотя исходные ячейки остаются «Нет данных».
- Результаты в разных источниках иногда относятся к разным режимам рассуждения одного семейства моделей. Важно сравнивать точный вариант, а не только торговое название.
¹ Claude Fable 5.1 и Vals: на официальной странице модели опубликован результат 67,87% по более ранней версии Vals Index (1 сентября 2026 года). Однако модель отсутствует в таблице Vals Index v2.2 от 30 октября 2026 года. Поэтому в соответствующей колонке указано «Нет данных» именно для версии v2.2; архивный результат не сравнивается напрямую с оценками v2.2 и не подставляется как факт. Для расчёта индекса GPTunneL используется прогноз 69,34% для v2.2, полученный исторической экстраполяцией: к результату Fable v2.1 (65,83%) добавлена средняя поправка Sonnet 5.5 и Opus 5.5 при переходе с v2.1 на v2.2 (+3,51 п. п.). 67,87% — отдельное архивное измерение, 65,83% — базовое значение для экстраполяции v2.1; это не две противоречащие друг другу оценки одного и того же среза.
Кто лидирует — и почему рейтинги расходятся?
Gemini 4 Carbon лидирует в текстовом сравнении Arena и опережает конкурентов по общему баллу AA. Claude Opus 5.5 сильнее в Arena WebDev и Agent Arena. Claude Sonnet 5.5 возглавляет Vals по профессиональным заданиям. GPT-6 Astra показывает максимальный результат среди рассматриваемых моделей по ARC-AGI-2.
Это не взаимоисключающие выводы. Тест «пользователю больше понравился ответ» не эквивалентен проверке правильности математического решения. Разработка интерфейса не равна анализу финансовой отчётности. Поэтому в этой публикации исходные восемь оценок важнее нашего сводного места.
Как рассчитывается сводный индекс GPTunneL
| Источник | Вес |
|---|---|
| Artificial Analysis v5 | 17% |
| Vals Index v2.2 | 15% |
| LiveBench 2.0 | 15% |
| Arena WebDev | 15% |
| Arena Text | 10% |
| Agent Arena | 10% |
| ARC-AGI-2 | 10% |
| StealthMark General | 8% |
| Всего | 100% |
Почему такие веса?
Это редакционная, заранее выбранная эвристика, а не веса, полученные оптимизацией по независимой контрольной выборке. Несколько более высокий вес AA (17%) и меньший вес StealthMark (8%) отражают наш выбор охвата и роли этих источников в сводном индексе; это не доказательство, что AA на 9 процентных пунктов более достоверен или информативен. Остальные источники получают 10–15%. Корреляции и частичное пересечение задач не позволяют интерпретировать веса как независимые доли информации. Ниже отдельно проверена чувствительность рейтинга к исключению источников и равным весам.
Теперь используется гибридная нормализация. Для Artificial Analysis, Vals, LiveBench, Agent Arena, ARC-AGI-2 и StealthMark General берём результат модели относительно лидера в нашей выборке: 100 × результат / максимум. Для Arena Text и Arena WebDev используем Min-Max: 100 × (результат − минимум) / (максимум − минимум), поскольку рейтинговые очки Arena не имеют содержательного абсолютного нуля. После этого применяется средневзвешенная сумма с весами из таблицы выше.
Если первичного значения нет, для вычисления индекса используется прогноз: историческая экстраполяция при наличии старой сопоставимой версии (Vals Fable 5.1 — 69,34%) либо оценка по соседним моделям. Для некоторых старых прогнозов исходная шкала восстановлена приблизительно из ранговых оценок, что дополнительно снижает точность. В публичных колонках бенчмарков при этом написано «Нет данных». Нормализация определяется по этим 20 моделям, включая оценки для расчёта. Индекс GPTunneL — редакционный расчёт, а не измеренный IQ или официальная оценка организаторов тестов.
Ограничения: часть исходных индексов построена на перекрывающихся заданиях, в частности Terminal-Bench встречается в AA и Vals; модели представлены неодинаковыми режимами рассуждения; место зависит от состава двадцатки. Разницу 97,21 и 94,89 также не следует трактовать как статистически доказанное превосходство: неопределённость прогнозов и различия протоколов тестирования пока не оценены. Для строгих сравнений полезнее учитывать конкретные бенчмарки; формальных доверительных интервалов сводного индекса мы не рассчитывали, и разница в несколько баллов не является доказательством статистической значимости.
Насколько согласуются восемь бенчмарков интеллекта
Для проверки надёжности сводного рейтинга GPTunneL мы сопоставили результаты 20 моделей в восьми источниках и рассчитали корреляции для каждой из 28 пар бенчмарков. В расчёт вошли только фактические результаты, без оценок, восстановленных для итогового индекса. Если модель отсутствует в одном из двух тестов, она не участвует в корреляции этой пары. Поэтому число наблюдений различается.
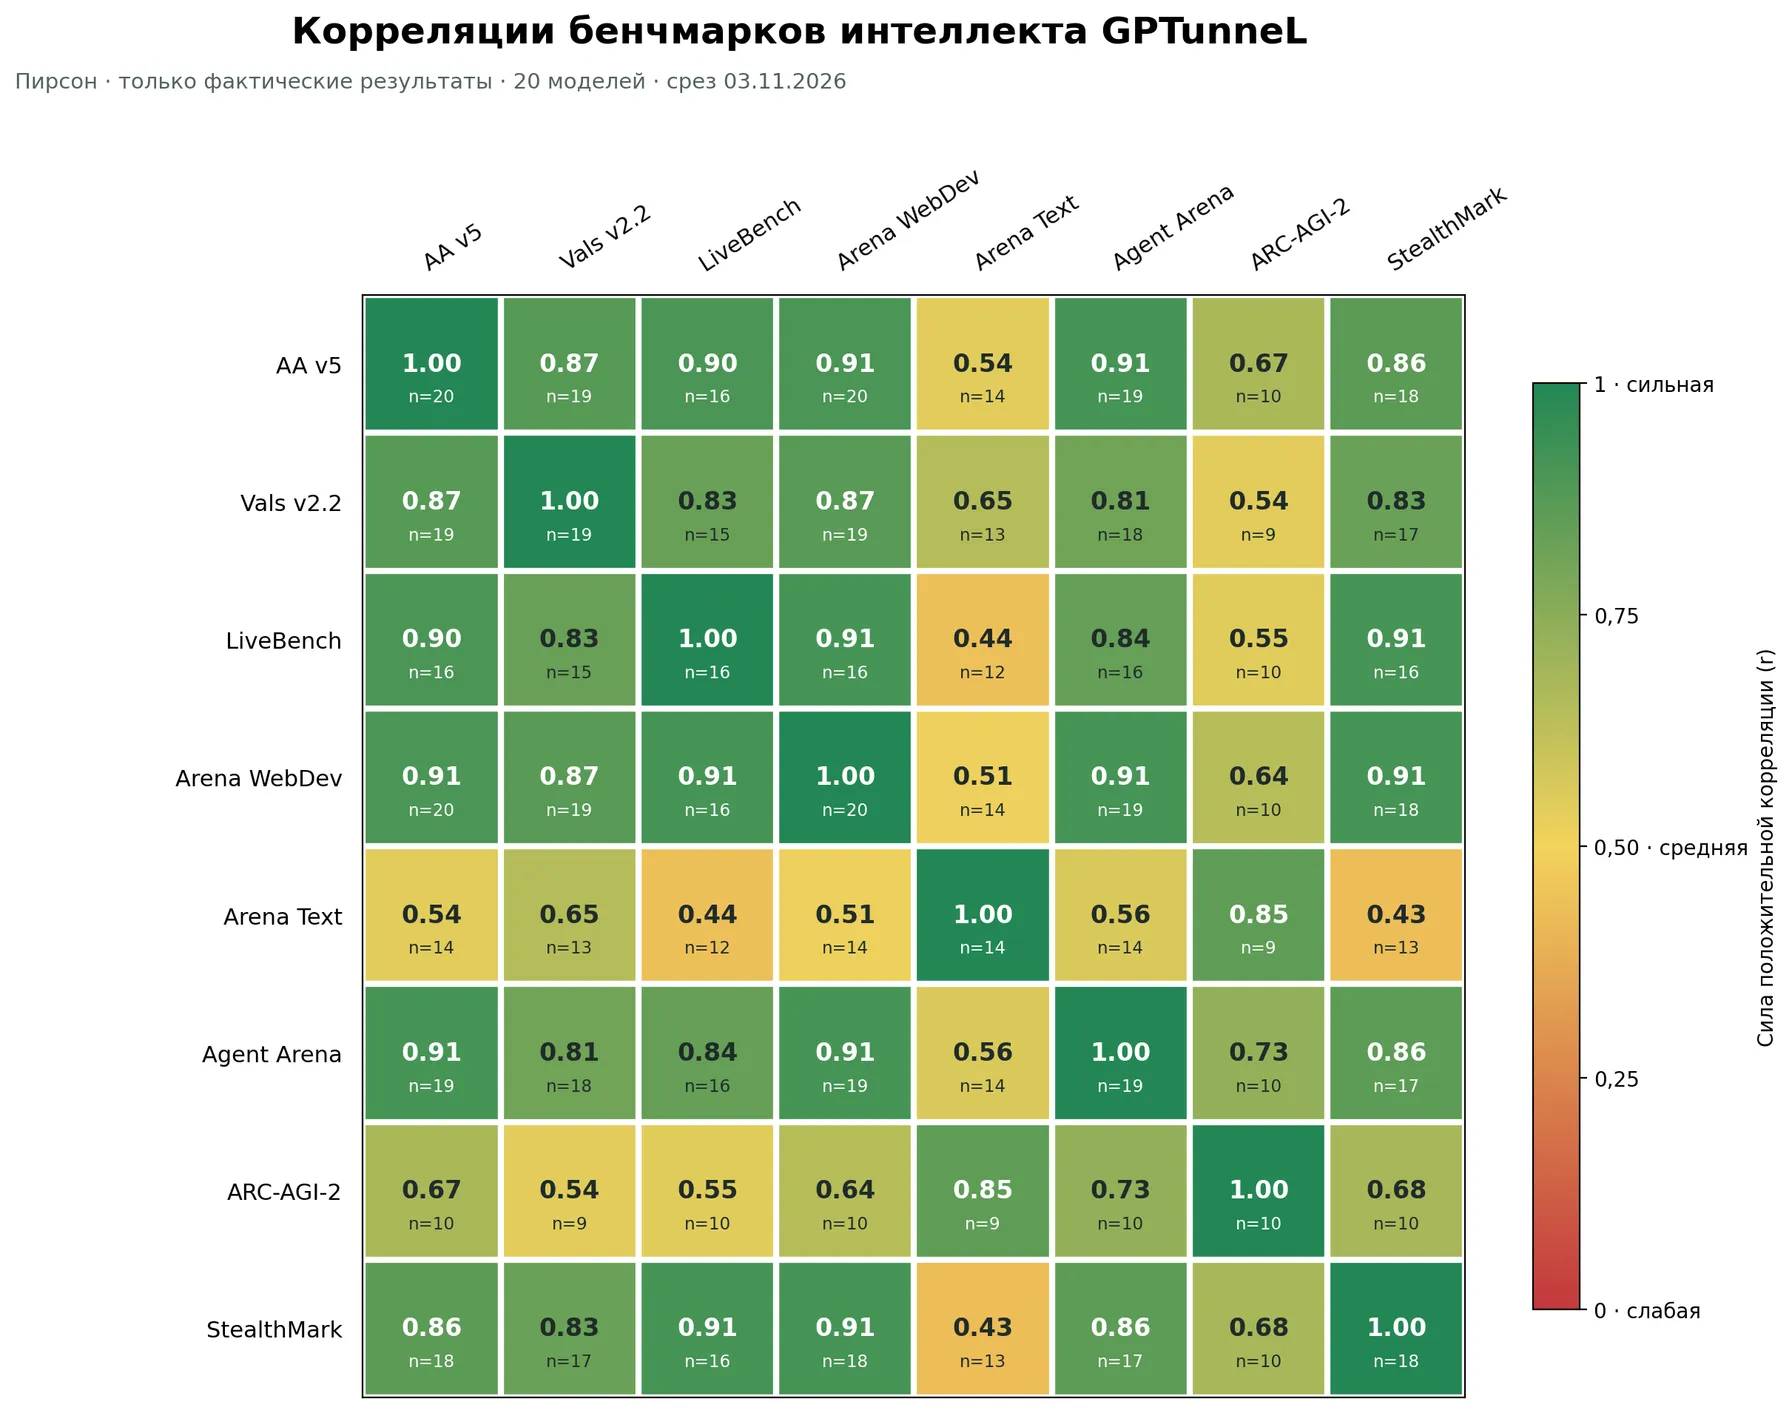
Коэффициент Пирсона: от красного (слабая положительная связь) через жёлтый (умеренная) к зелёному (сильная). n — количество моделей с обоими измерениями. На диагонали значение 1, поскольку тест сравнивается сам с собой. Цвет характеризует корреляцию, а не качество бенчмарка.
Какие бенчмарки сильнее всего согласуются
| Пара источников | Пирсон r | Моделей | r после исключения четырёх крайних результатов |
|---|---|---|---|
| AA ↔ Agent Arena | 0,914 | 19 | 0,917 |
| Arena WebDev ↔ Agent Arena | 0,913 | 19 | 0,901 |
| LiveBench ↔ Arena WebDev | 0,912 | 16 | 0,892 |
| Arena WebDev ↔ StealthMark | 0,911 | 18 | 0,834 |
| LiveBench ↔ StealthMark | 0,911 | 16 | 0,939 |
| AA ↔ Arena WebDev | 0,906 | 20 | 0,854 |
Вывод: AA, Arena WebDev, Agent Arena, LiveBench и StealthMark в целом согласованно отличают сильные модели от слабых. Связи в большинстве случаев сохраняются и после удаления двух наиболее низких и двух наиболее высоких результатов по первому источнику. Это дополнительный аргумент в пользу использования нескольких независимых измерений, но не гарантия, что они измеряют одно и то же.
Где бенчмарки расходятся
| Пара источников | Пирсон r | Спирмен ρ | Как интерпретировать |
|---|---|---|---|
| Arena Text ↔ StealthMark | 0,431 | 0,270 | Пользовательские предпочтения и структурные задачи слабо согласованы |
| Arena Text ↔ LiveBench | 0,438 | 0,371 | Хороший диалог не гарантирует высокий результат формальных тестов |
| Arena Text ↔ Arena WebDev | 0,513 | 0,389 | Предпочтения в тексте и разработка интерфейса — разные задачи |
| Arena Text ↔ AA | 0,540 | 0,465 | Общий интеллектуальный индекс не полностью объясняет предпочтения пользователей |
| ARC-AGI-2 ↔ Vals | 0,541 | 0,450 | Абстрактные закономерности и профессиональные задания различаются |
Arena Text отличается от остальных источников. Низкая корреляция не делает его бесполезным: возможно, он измеряет ту сторону взаимодействия с моделью, которую тесты на правильность ответа отражают слабее. Но это гипотеза об интерпретации различий, а не доказательство уникальности измеряемого навыка.
ARC-AGI-2 стоит рассматривать отдельно. Для него доступно сравнительно мало моделей (всего 10 с собственным измерением), поэтому корреляции менее устойчивы. Особенно показателен пример Arena Text ↔ ARC-AGI-2: Пирсон 0,854, а Спирмен лишь 0,467 на 9 моделях. После исключения четырёх крайних наблюдений линейная корреляция становится отрицательной. Такое расхождение предупреждает: высокий Пирсон на малой выборке может зависеть от нескольких крайних точек и плохо отражать порядок остальных моделей.
Можно ли восстановить пропущенные результаты одного теста по другому?
Мы проверили однофакторную линейную регрессию методом leave-one-out: поочерёдно скрывали измеренный результат одной модели, обучались на остальных и сравнивали прогноз с фактом. Ошибку также сравнивали с базовым прогнозом среднего результата теста.
| Прогнозируемый тест по источнику | MAE при leave-one-out | Снижение ошибки против прогноза среднего |
|---|---|---|
| AA по Arena WebDev | 3,91 балла AA | 63% |
| Agent Arena по AA | 2,15 пункта | 63% |
| LiveBench по StealthMark | 3,13 пункта | 59% |
| StealthMark по LiveBench | 4,43 пункта | 56% |
| Vals по Arena WebDev | 2,31 пункта | 52% |
Это результаты проверки на небольших пересекающихся выборках, а не гарантированная точность для новых моделей. Корреляция и точность прогноза — разные показатели: высокая связь не исключает существенную ошибку в баллах или изменение позиции модели в рейтинге.
Что корреляции говорят о достоверности GPTunneL Intelligence Index
- В индексе есть общий устойчивый сигнал. Несколько источников независимо показывают похожую иерархию моделей. Это снижает риск того, что рейтинг определяется одним необычным тестом.
- Есть риск двойного учёта похожих компетенций. Высококоррелирующие AA, WebDev, Agent Arena и LiveBench могут частично отражать один общий фактор. Кроме того, агрегаты способны включать пересекающиеся наборы заданий. Поэтому веса нельзя считать статистически независимыми долями информации.
- Arena Text и ARC-AGI-2 добавляют иную перспективу, но требуют осторожности. Слабая корреляция сама по себе не означает ни плохого качества теста, ни его высокой полезности: ценность дополнительного источника нужно проверять по содержанию заданий и устойчивости итоговых мест.
- Прогнозы пропусков необходимо отделять от фактов. Для тесно связанных тестов перенос возможен как приблизительная оценка; для нестабильных пар, особенно с ARC-AGI-2, автоматическое заполнение может создать ложную определённость.
- Проверка устойчивости уже выполнена. В восьми экспериментах исключали по одному бенчмарку и перенормировали оставшиеся веса до 100%. Opus сохранила первое место в семи из восьми; при исключении Arena WebDev на первое место вышла Carbon, а Opus переместилась на второе. Astra сохранила третье место во всех восьми вариантах. При равных весах всех восьми источников первая тройка остаётся Opus → Carbon → Astra, но Sonnet уступает четвёртое место Fable. Такие проверки показывают чувствительность к конструкции индекса, не заменяя доверительные интервалы, потому что прогнозные значения и сами нормированные баллы при исключении теста оставались фиксированными.
Что это означает для надёжности. Лидерство Opus по выбранным весам относительно устойчиво, но не абсолютно; различие с Carbon зависит от WebDev. Разницу в 2,32 пункта общего индекса нельзя превращать в вероятность превосходства. Полные позиции всех 20 моделей в каждом эксперименте приведены в Excel с проверкой устойчивости весов.
Ограничения: корреляции вычислены на исходных шкалах, где больше — лучше; парные выборки неодинаковы, могут иметь общие семейства моделей и отличающиеся протоколы испытаний. Корреляция не доказывает независимость источников, отсутствие утечек между тестами или причинную связь. Полная матрица 28 пар, корреляции Спирмена, проверки на крайних наблюдениях и ошибки leave-one-out приведены в Excel с расчётами.
Стоимость и скорость: сравнение всех 20 моделей
Стоимость выполнения задачи и стоимость успешного решения — разные показатели. В Artificial Analysis Cost per Task — расход на выполнение тестовой задачи, независимо от правильности результата. В LiveBench Cost per Successful Task — расчётная стоимость в пересчёте на успешное решение: стоимость всех выполненных заданий делится на их количество и затем на долю успешных решений. Таким образом, высокая доля ошибок увеличивает цену успеха. Это не обязательно цена конкретного фактически успешного запуска и не доказательство, что повторная попытка даст правильный ответ.
В Vals Cost / Test — стоимость проведения теста по методике Vals, а Agent Arena показывает медианные Cost/Task (P50) и Time/Task (P50) по агентным сессиям. Это четыре разные нагрузки, поэтому четыре стоимости нельзя усреднять в долларах или считать, что разница между ними — результат качества одной и той же задачи.
Общая экономическая таблица — 20 моделей и четыре источника
| № | Модель | AA: стоимость задачи, $ | AA: время задачи, мин | Vals: стоимость теста, $ | Vals: время, мин | Vals: токены/тест, млн | Agent Arena: стоимость P50, $ | Agent Arena: время P50, мин | Agent: выходные токены P50, тыс. | LiveBench: $/успешную задачу |
|---|---|---|---|---|---|---|---|---|---|---|
| 1 | Claude Opus 5.5 | $10.04 | 25,8 | $28.12 | 85,0 | 59,46 | $6.79 | 18,8 | 129,5 | $4.291 |
| 2 | Gemini 4 Carbon | $7.76 | 29,6 | $10.51 | 47,8 | 18,29 | $1.7 | 11,1 | 55,0 | Нет данных |
| 3 | GPT-6 Astra | $6.24 | 18,4 | $21.28 | 33,6 | 8,15 | $6.2 | 12,7 | 42,9 | $4.548 |
| 4 | Claude Sonnet 5.5 | $10.02 | 30,5 | $18.7 | 86,0 | 78,59 | $3.8 | 16,4 | 155,4 | $3.718 |
| 5 | Claude Fable 5.1 | $10.85 | 19,3 | Нет данных | Нет данных | Нет данных | $6.49 | 10,9 | 54,7 | $6.904 |
| 6 | GPT-6.1 Sol | $1.27 | 20,4 | $3.61 | 44,4 | 9,40 | $0.98 | 10,3 | 34,6 | $0.761 |
| 7 | Muse Wonder Full | Нет данных | Нет данных | $6.81 | 59,3 | 18,37 | Нет данных | 10,4 | 35,9 | Нет данных |
| 8 | Gemini 4 Argon | $7.68 | 34,4 | $13.37 | 45,0 | 23,31 | $0.98 | 7,4 | 33,3 | $2.073 |
| 9 | GPT-6.1 Terra | $0.96 | 12,8 | $2.94 | 39,7 | 17,59 | $0.79 | 8,8 | 43,8 | $0.67 |
| 10 | Kimi K3.1 Pro | $3.68 | 37,4 | $6.44 | 64,0 | 20,14 | $1.47 | 6,8 | 41,4 | $1.044 |
| 11 | Muse Wonder | $6.95 | 11,9 | $10.65 | 35,4 | 33,19 | $1.38 | 3,9 | 24,7 | Нет данных |
| 12 | Qwen 3.8 Max 0902 | $10.02 | 62,5 | $8.73 | 106,0 | 26,59 | Нет данных | Нет данных | Нет данных | Нет данных |
| 13 | DeepSeek V4.1 Flash 1017 | $0.6 | 13,7 | $0.66 | 39,9 | 43,90 | $0.17 | 8,1 | 86,8 | $0.181 |
| 14 | GLM 5.3 | $5.01 | 29,3 | $8.52 | 64,0 | 28,15 | $1.13 | 15,3 | 65,1 | Нет данных |
| 15 | MiMo V2.6 Pro | $0.26 | 47,8 | $0.43 | 73,0 | 17,77 | $0.17 | 16,1 | 49,6 | $0.183 |
| 16 | Gemini 3.8 Flash | $7.77 | 14,6 | $5.03 | 36,0 | 25,06 | $0.75 | 9,3 | 52,4 | Нет данных |
| 17 | Grok 4.7 | $7.77 | 24,2 | $11.63 | 33,6 | 11,39 | $2.63 | 15,4 | 76,0 | $2.913 |
| 18 | Claude Haiku 5.5 | $0.41 | 14,7 | $3.17 | 50,0 | 38,15 | Нет данных | Нет данных | Нет данных | $0.905 |
| 19 | MiniMax M3.1 Flash | $0.49 | 21,5 | $0.66 | 43,3 | 31,77 | Нет данных | Нет данных | Нет данных | $0.153 |
| 20 | Step 5 Preview | $2.35 | 14,4 | $2.73 | 65,0 | 33,65 | Нет данных | Нет данных | Нет данных | Нет данных |
Источники: Artificial Analysis, Vals Index v2.2, Agent Arena, LiveBench 2.0. Токены Vals — миллионы токенов на тест; Agent Arena — медиана выходных токенов за сессию, тысячи. Это разные базы подсчёта. AA: время полного выполнения задачи в минутах, а не «время до первого токена».
Какие модели самые дешевые
- MiniMax M3.1 Flash — около $0,153 за успешную задачу LiveBench, при стоимости теста Vals $0,66.
- DeepSeek V4.1 Flash 1017 — около $0,181 за успешную задачу LiveBench, Vals $0,66, AA $0,60.
- MiMo V2.6 Pro — около $0,183 за успешную задачу LiveBench, Vals $0,43, AA $0,26.
- GPT-6.1 Terra — около $0,670 за успешную задачу LiveBench; по AA её задача стоит $0,96.
- GPT-6.1 Sol — около $0,761 за успешную задачу LiveBench и высокий общий индекс GPTunneL: это особенно интересный баланс интеллекта и экономичности.
Сравнивать стоимость успешного решения следует внутри LiveBench, а не с долларами на задачу AA или агентную сессию. Кроме того, стоимость за успешную задачу не означает, что модель сможет решить за эту сумму любую конкретную задачу.
Насколько связана стоимость задач в разных бенчмарках
Мы сравнили фактическую стоимость работы одних и тех же моделей в Artificial Analysis, Vals Index, Agent Arena и LiveBench. Стоимости отличаются по определению: LiveBench показывает стоимость успешной задачи, Agent Arena — медианную стоимость агентной сессии, AA и Vals — затраты на их собственные тестовые задания. Поэтому мы анализируем согласованность расходов между источниками, а не считаем эти суммы равнозначными.
Для моделей с результатами в обоих сравниваемых источниках вычислили корреляцию Пирсона между логарифмами расходов и корреляцию Спирмена. Получились следующие результаты:
| Пара источников | Моделей | Пирсон (логарифмы стоимости) | Спирмен | Пирсон без четырёх ценовых крайностей |
|---|---|---|---|---|
| Vals — LiveBench | 12 | 0,987 | 0,956 | 0,982 |
| Agent Arena — LiveBench | 11 | 0,970 | 0,954 | 0,882 |
| Vals — Agent Arena | 14 | 0,938 | 0,883 | 0,742 |
| AA — LiveBench | 13 | 0,912 | 0,863 | 0,948 |
| AA — Vals | 18 | 0,897 | 0,828 | 0,919 |
| AA — Agent Arena | 15 | 0,815 | 0,741 | 0,458 |
Главный результат: расходы Vals и LiveBench хорошо согласуются даже после удаления самых дешёвых и самых дорогих моделей. Это говорит о том, что связь не объясняется только крайними наблюдениями. Напротив, AA и Agent Arena гораздо хуже взаимно предсказывают расходы на сложную агентную работу.
Чтобы проверить переносимость стоимости, мы по очереди скрывали известный результат каждой модели и восстанавливали его лог-линейной регрессией по другому источнику (leave-one-out). Для Vals → LiveBench медианная мультипликативная ошибка составила 1,25 раза (90-й процентиль — 1,37 раза). Для AA → Agent Arena — 1,81 раза (90-й процентиль — 3,07 раза). Высокая корреляция сама по себе не означает, что стоимость можно предсказать без ошибки.
Мы также исключали по очереди модели разработчиков Anthropic, OpenAI и Google: корреляция Vals — LiveBench оставалась в диапазоне 0,985–0,988. Это дополнительная проверка устойчивости, хотя 12 исходных наблюдений всё ещё слишком мало для универсальных гарантий.
Граница Парето: интеллект против стоимости
Для сравнения эффективности мы построили две диаграммы на линейной оси стоимости. На обеих Claude Opus 5.5 — эталон с коэффициентом 1,00, а по вертикали используется GPTunneL Intelligence Index. Оранжевая линия связывает модели, которые не уступают другой модели одновременно по цене и интеллекту.
График 1 — только измеренные расходы (18 моделей). Здесь у каждой модели есть данные и AA, и Vals. Относительная стоимость — геометрическое среднее двух отношений к Opus. Все точки основаны на фактической стоимости, без экономических прогнозов.
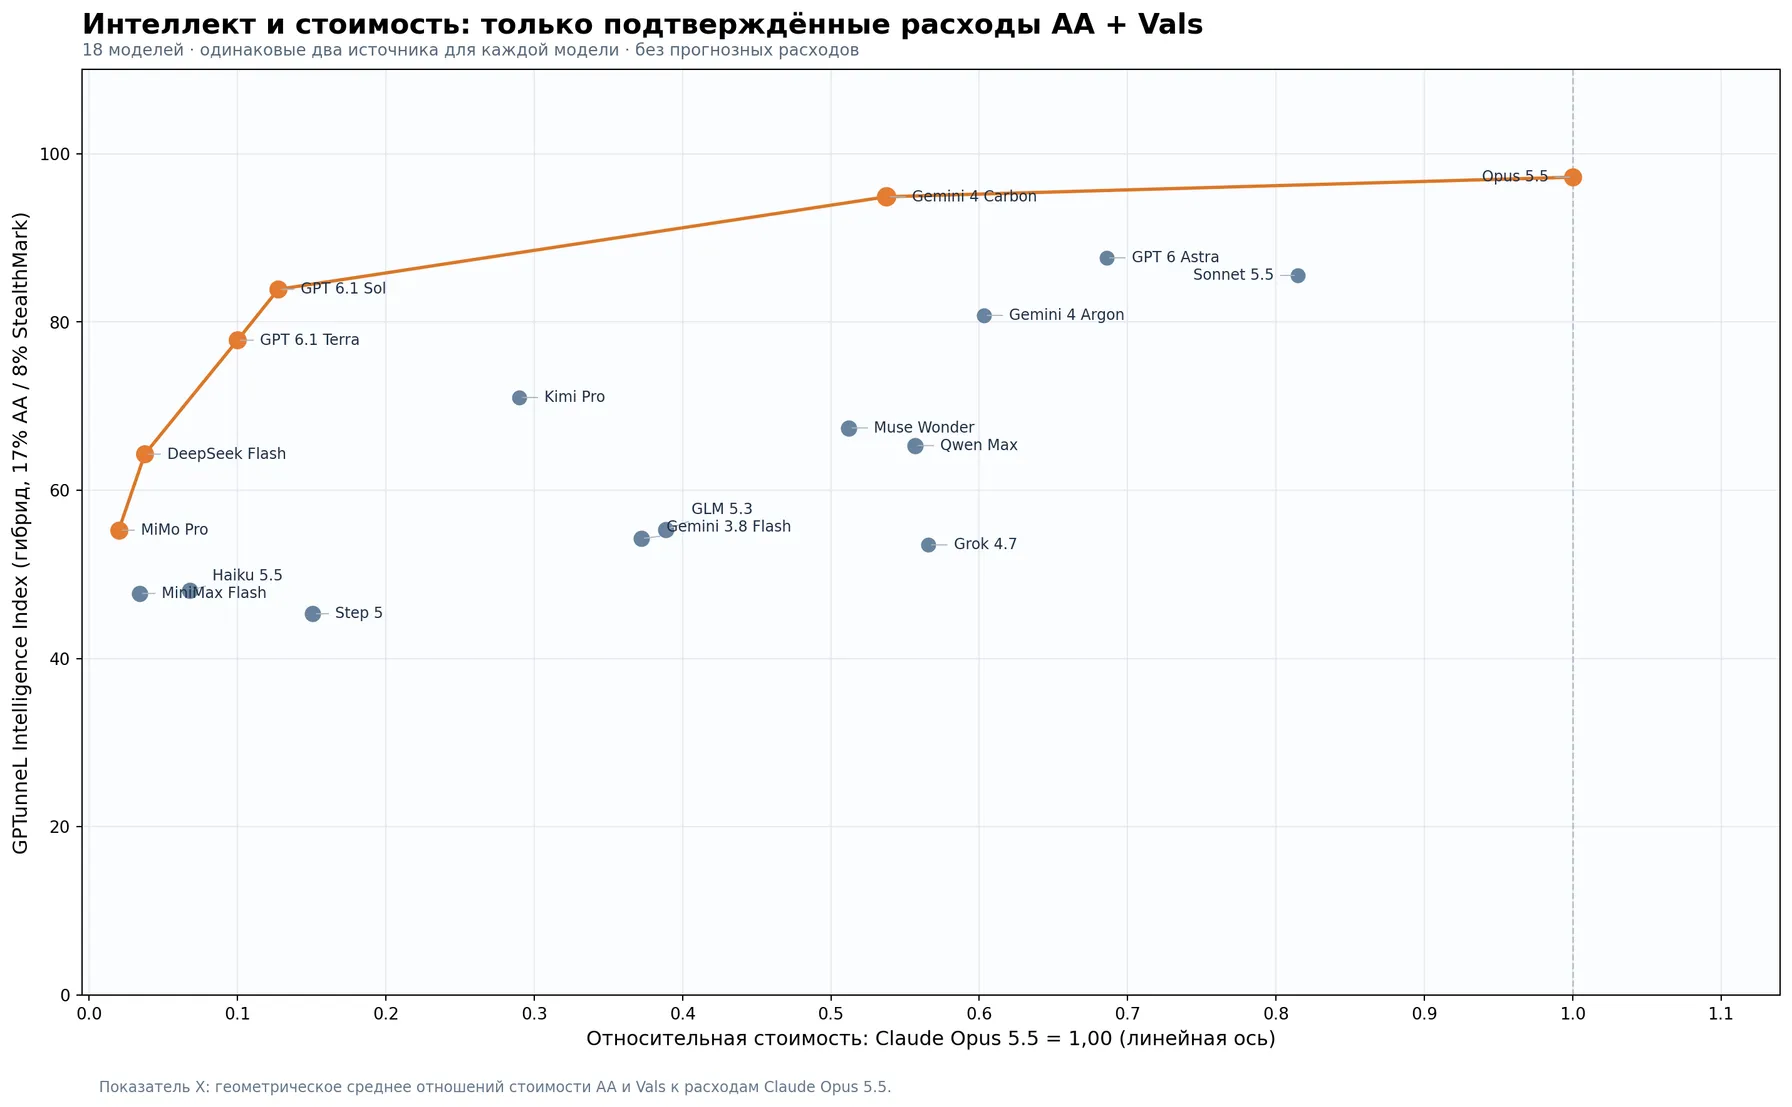
График 2 — с прогнозом пропущенных расходов (20 моделей). Здесь используются четыре источника — AA, Vals, Agent Arena и LiveBench, с равным весом при геометрическом усреднении коэффициентов стоимости к Opus. Прогнозы получены из измеренных стоимостей других источников по регрессии логарифмов; они обозначены звёздочкой и пустыми маркерами.
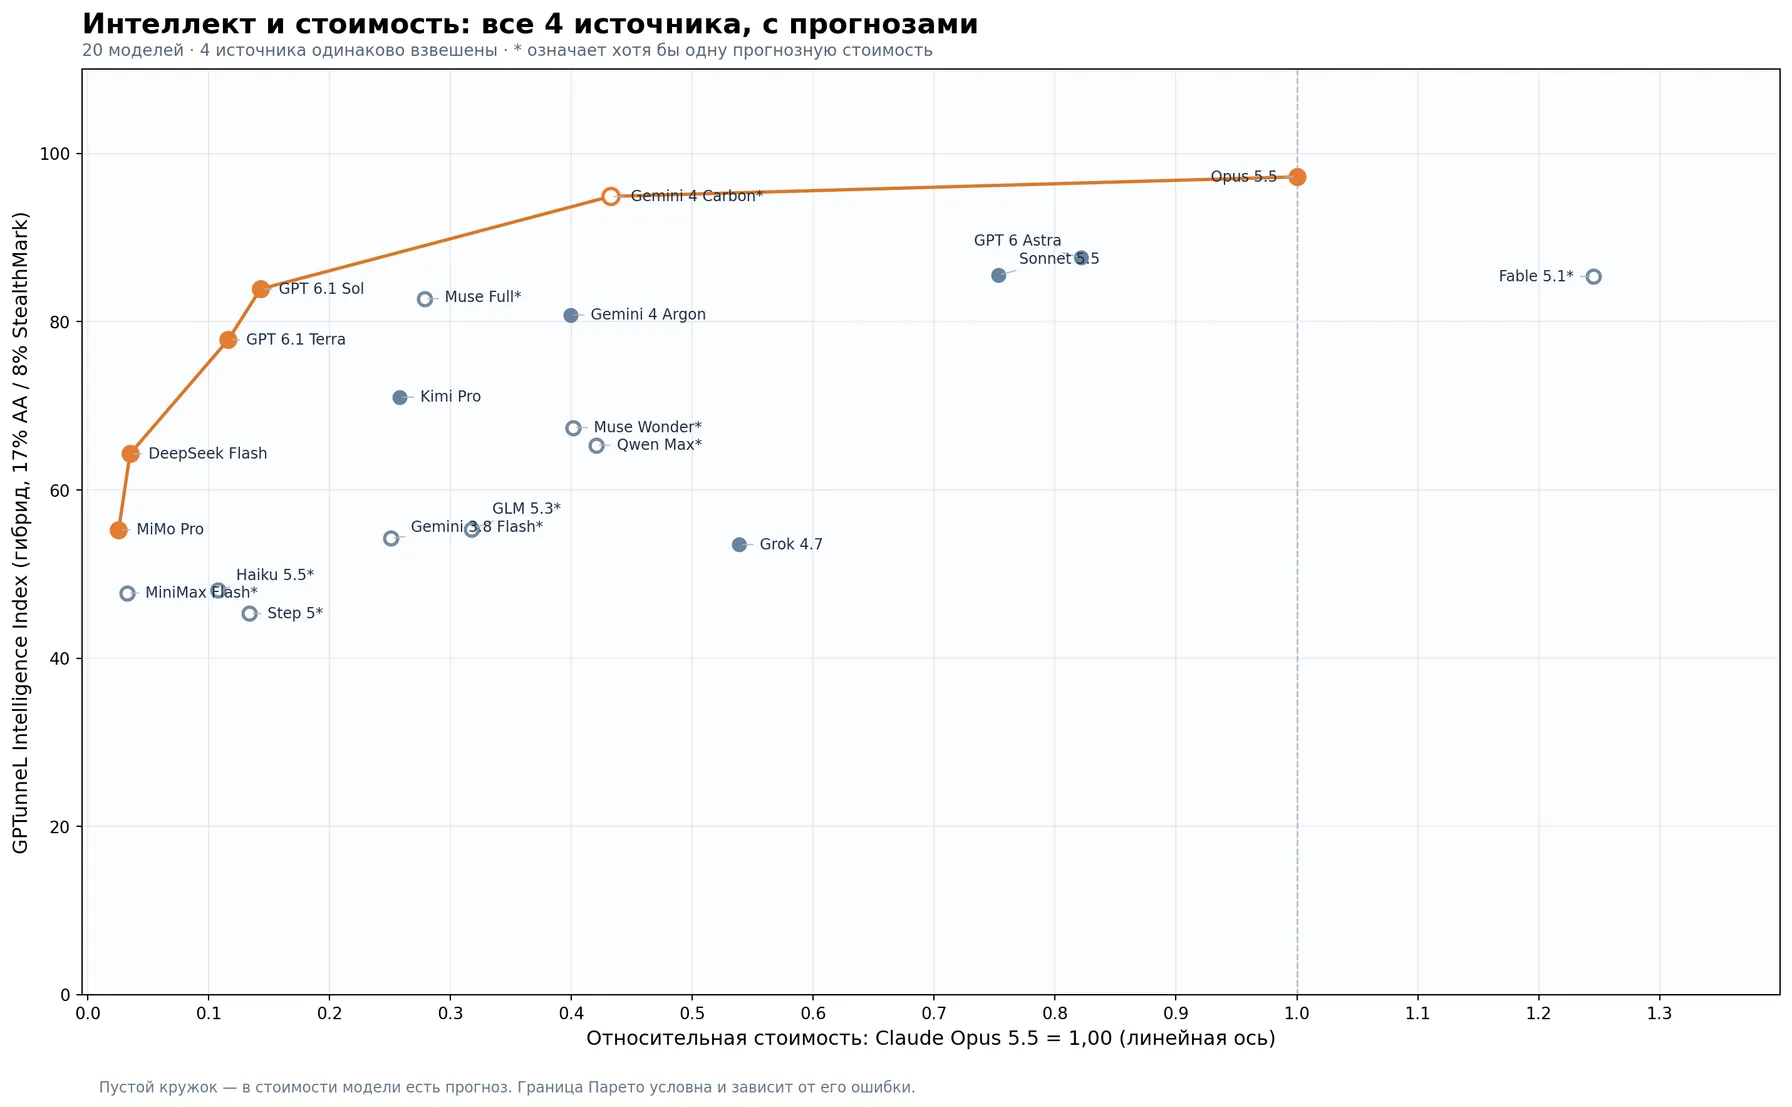
Эти две диаграммы нельзя сравнивать как «до» и «после» одного и того же показателя стоимости: первая строится на двух источниках, вторая — на четырёх, включая стоимость успешного решения. Они отвечают на разные вопросы: первая показывает надёжно измеренные сравнительные расходы для широкого круга моделей, вторая — предварительную оценку экономичности по более разнообразным задачам.
Прогнозные расходы не следует выдавать за измеренные. Особенно осторожно нужно относиться к моделям с одним измеренным источником и несколькими восстановленными значениями: ошибки прогнозов могут изменить их место относительно границы Парето. Подробные расчёты, исходные затраты, размеры выборок, регрессионные коэффициенты и ошибки перекрёстной проверки доступны в Excel с анализом стоимости и Парето.
Время, токены и производительность
Время выполнения — важнее скорости печати для сложных задач, но только при сравнении внутри одного тестового окружения. AA фиксирует время выполнения своего задания, Vals — продолжительность своего теста, Agent Arena — медианное время агентной сессии. Входные и выходные токены, скрытые reasoning-токены и задержку до первого токена лучше учитывать отдельно. Нельзя сравнивать 20 млн токенов Vals с 30 тыс. выходных токенов Agent Arena как эквивалентную нагрузку.
Дополнительный взгляд на экономику даёт сравнение общего интеллекта и стоимости успешной задачи LiveBench. Здесь использованы 13 моделей с измеренным LiveBench Cost per Successful Task. Модели без подтверждённой цены исключены из графика, а не представлены с нулевой стоимостью.
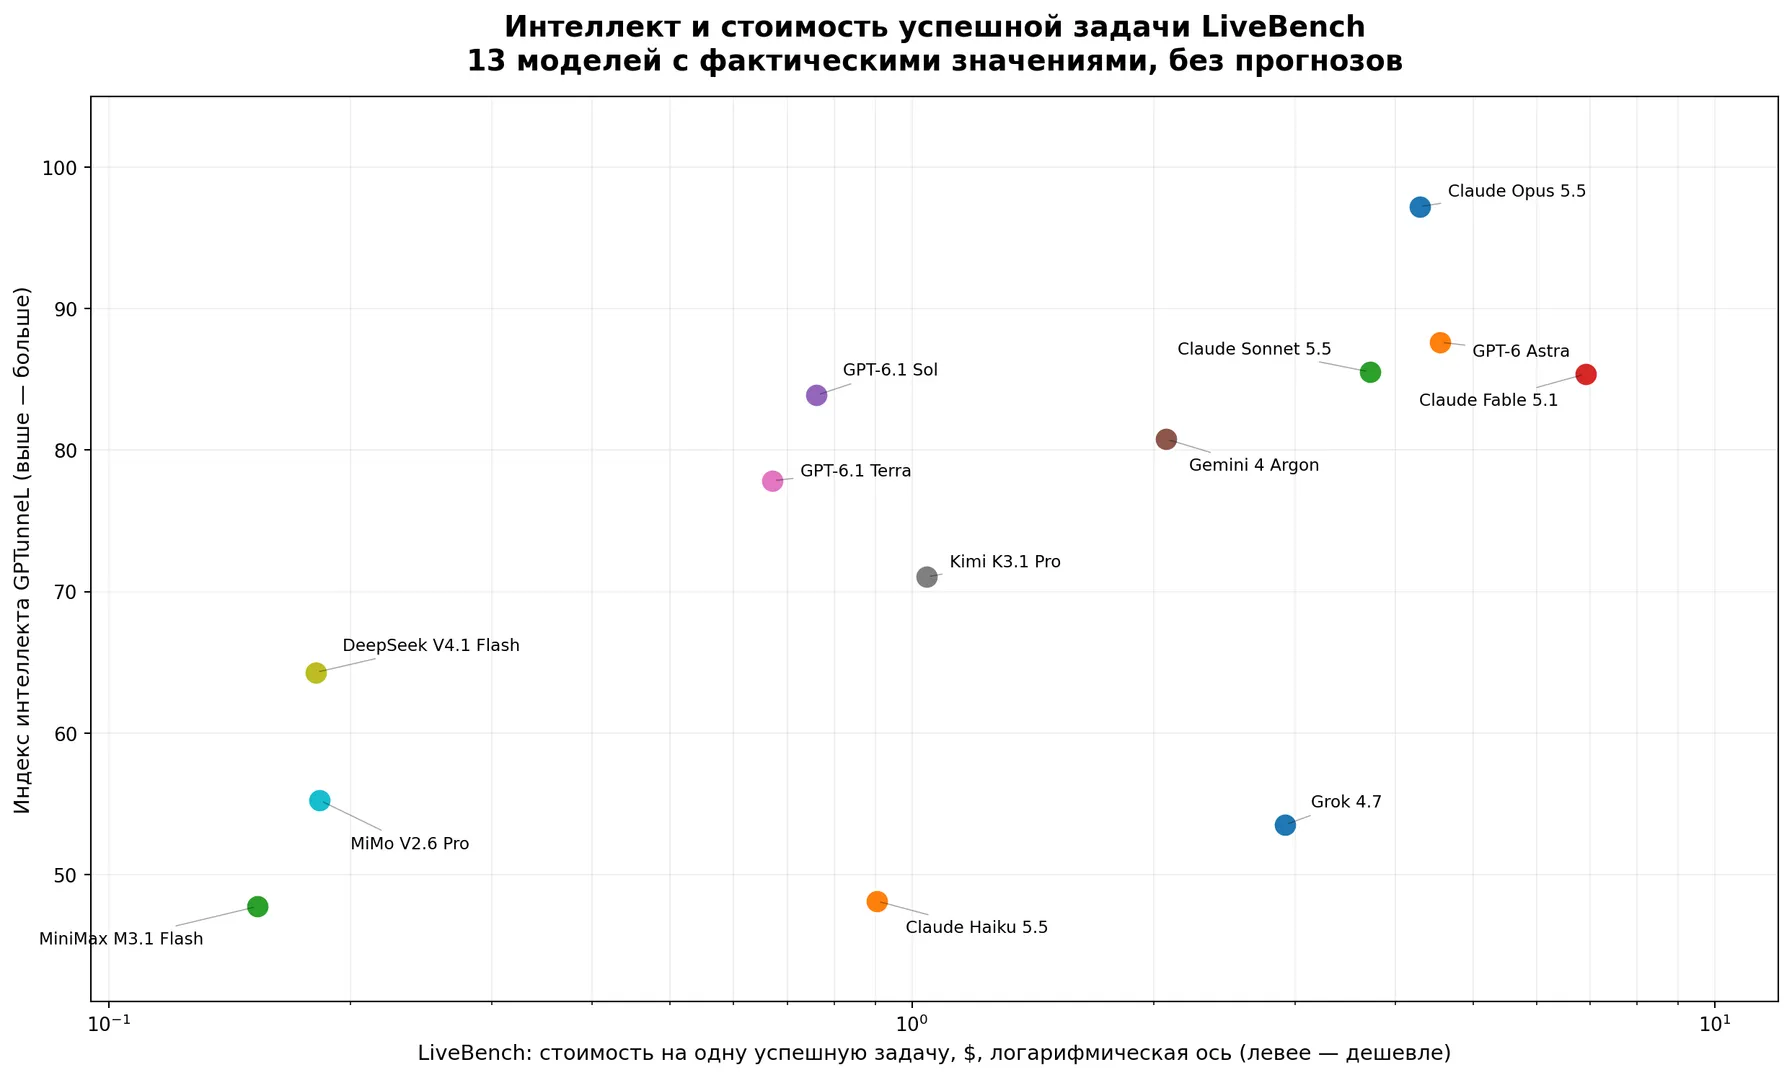
Диаграмма позволяет увидеть, какие модели при сопоставимом общем индексе обходятся дешевле в конкретной нагрузке LiveBench. Горизонтальная шкала логарифмическая: одинаковый сдвиг вправо означает сопоставимое относительное удорожание. Это не API-прайс-лист и не цена гарантированно успешного решения любого пользовательского запроса.
Скорость выполнения задач: относительное время GPTunneL
Помимо интеллектуальных баллов и стоимости, мы сравнили время выполнения задач. Источники: Artificial Analysis (минуты на задачу), Vals (минуты на тест), Agent Arena (медианные минуты на агентную сессию, P50). Это разные задачи и разные единицы нагрузки, поэтому время каждой модели сначала делится на время Claude Opus 5.5 в том же источнике, а коэффициенты объединяются геометрическим средним. Меньше 1 означает быстрее Opus, больше 1 — медленнее. Индекс времени не является скоростью генерации токенов и не показывает, сколько заняло бы прохождение полного набора всех тестов.
Для сравнения без допущений основной индекс рассчитан по AA + Vals для 18 моделей, имеющих фактические данные в обеих системах. Дополнительно 14 моделей имеют измеренное время во всех трёх источниках.
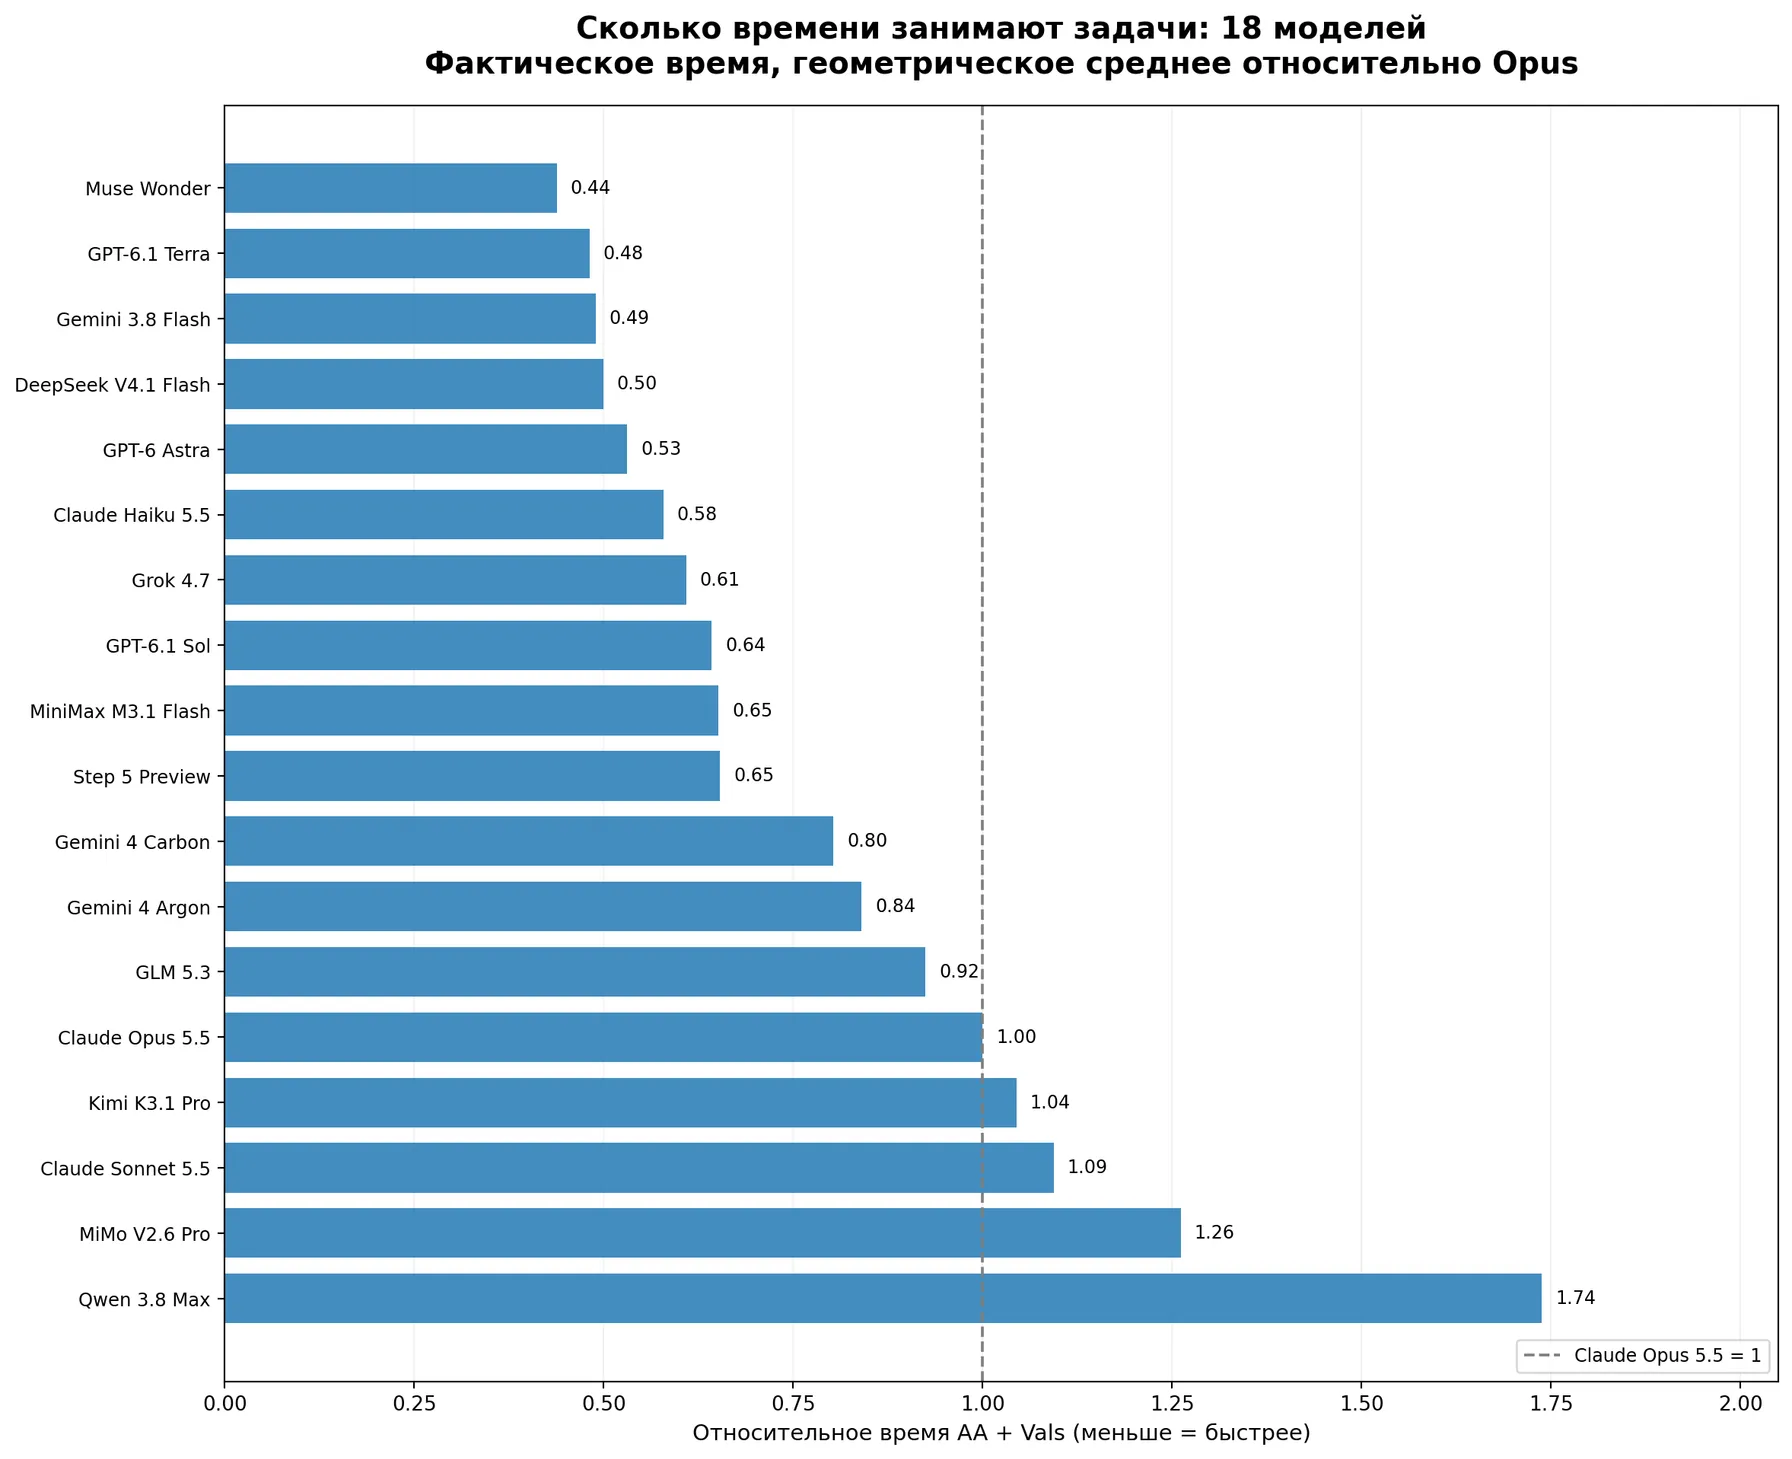
Как читать: один цвет у всех полос — без дополнительных нерасшифрованных категорий. Пунктир 1,00 означает время Opus; 0,50 — примерно вдвое быстрее, 1,50 — примерно в полтора раза медленнее на агрегированной нагрузке AA + Vals. Это не скорость вывода токенов.
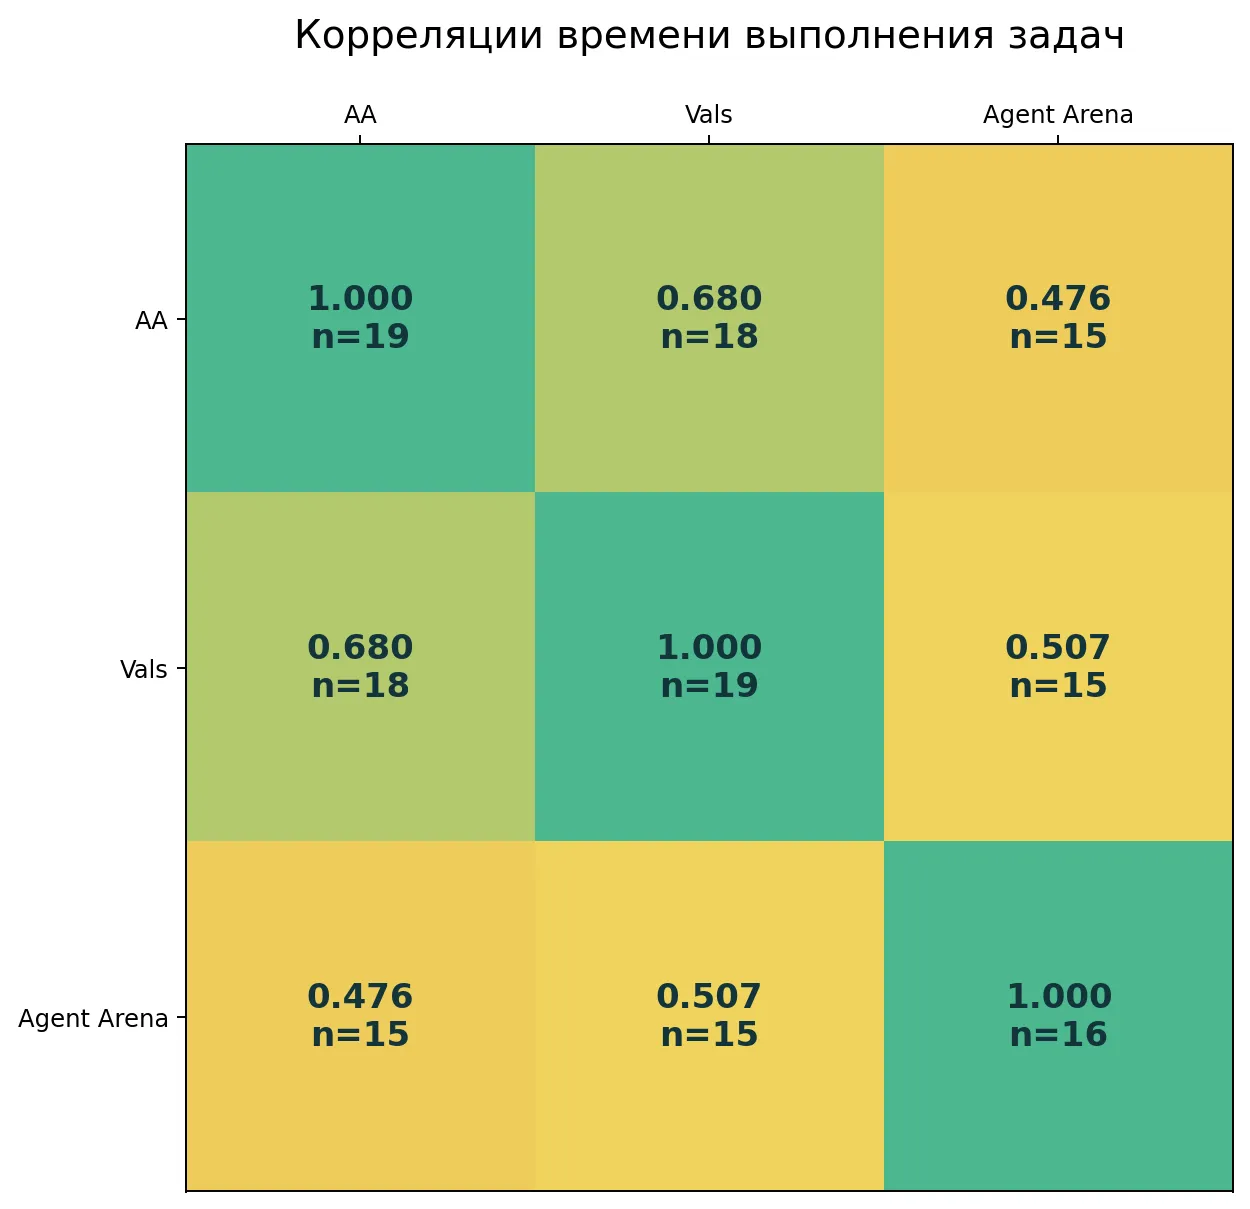
Корреляции времени: можно ли предсказать скорость одного теста по другому?
| Пара бенчмарков | N | Пирсон на логарифмах | Спирмен | Без 2 крайних | Без 4 крайних |
|---|---|---|---|---|---|
| AA ↔ Vals | 18 | 0.680 | 0.638 | 0.520 | 0.407 |
| AA ↔ Agent Arena | 15 | 0.476 | 0.371 | 0.163 | 0.362 |
| Vals ↔ Agent Arena | 15 | 0.507 | 0.435 | 0.525 | 0.621 |
Главный результат: корреляции скорости заметно слабее, чем корреляции стоимости: для времени Пирсон составляет примерно 0,48–0,68, тогда как для стоимости в исходном исследовании он был 0,82–0,99. Поэтому высокая экономичность модели не означает быстрого решения задач, а быстрый результат в одном бенчмарке не гарантирует столь же быстрого результата в другом. Особенно слабо связаны время AA и Agent Arena: это согласуется с различием характера задач, но не доказывает причинной зависимости.
Прогнозы пропусков рассчитаны однофакторной лог-линейной регрессией на общих моделях; направление прогноза выбиралось по ошибке leave-one-out. Ошибка ниже приведена в разах: 1,5× означает, что фактическое время может быть в 1,5 раза выше или ниже прогноза (приблизительно +50% либо −33%). Для контроля — ошибка простого прогноза типичного времени (геометрическое среднее обучающей выборки).
| Перенос времени | N | Медианная ошибка LOO | 90-й процентиль ошибки | База: медианная ошибка |
|---|---|---|---|---|
| AA → Vals | 18 | 1.20× | 1.60× | 1.32× |
| AA → Agent Arena | 15 | 1.31× | 2.11× | 1.47× |
| Vals → AA | 18 | 1.42× | 1.70× | 1.57× |
| Vals → Agent Arena | 15 | 1.23× | 2.06× | 1.47× |
| Agent Arena → AA | 15 | 1.37× | 1.92× | 1.37× |
| Agent Arena → Vals | 15 | 1.22× | 1.66× | 1.31× |
Прогнозы времени слабее прогнозов стоимости; для модели с отсутствующим измерением они должны рассматриваться как исследовательские оценки, а не как достоверные показатели быстродействия. Для Arena WebDev в исследуемых данных есть оценка качества веб-разработки, но нет подтверждённой метрики продолжительности выполнения задачи, поэтому её нельзя подставлять вместо времени. https://arena.ai/leaderboard?category=webdev
Три характеристики одновременно: интеллект, стоимость, время
Объединённая диаграмма помогает сопоставить три свойства каждой модели, не смешивая их в единый балл. Здесь представлены 20 моделей: стоимость — по четырём источникам, время — по трём, с прогнозным восстановлением отсутствующих экономических показателей. Для наглядности у точек с восстановленными значениями добавлена оранжевая пунктирная обводка; тёмная обводка обозначает полный набор измерений. Это расширенная оценка, а не исключительно фактический график.
- Ось X — относительное время выполнения задачи: чем правее точка, тем модель медленнее.
- Ось Y — относительная стоимость задачи: чем выше точка, тем модель дороже.
- Размер точки — интеллект модели: чем больше круг, тем выше интеллект.
- Для топ-5 моделей по интеллекту значение индекса указано прямо внутри круга.
- Подпись «Claude Opus 5.5 = 1 по стоимости и времени» показывает эталонную точку, относительно которой нормированы скорость и цена.
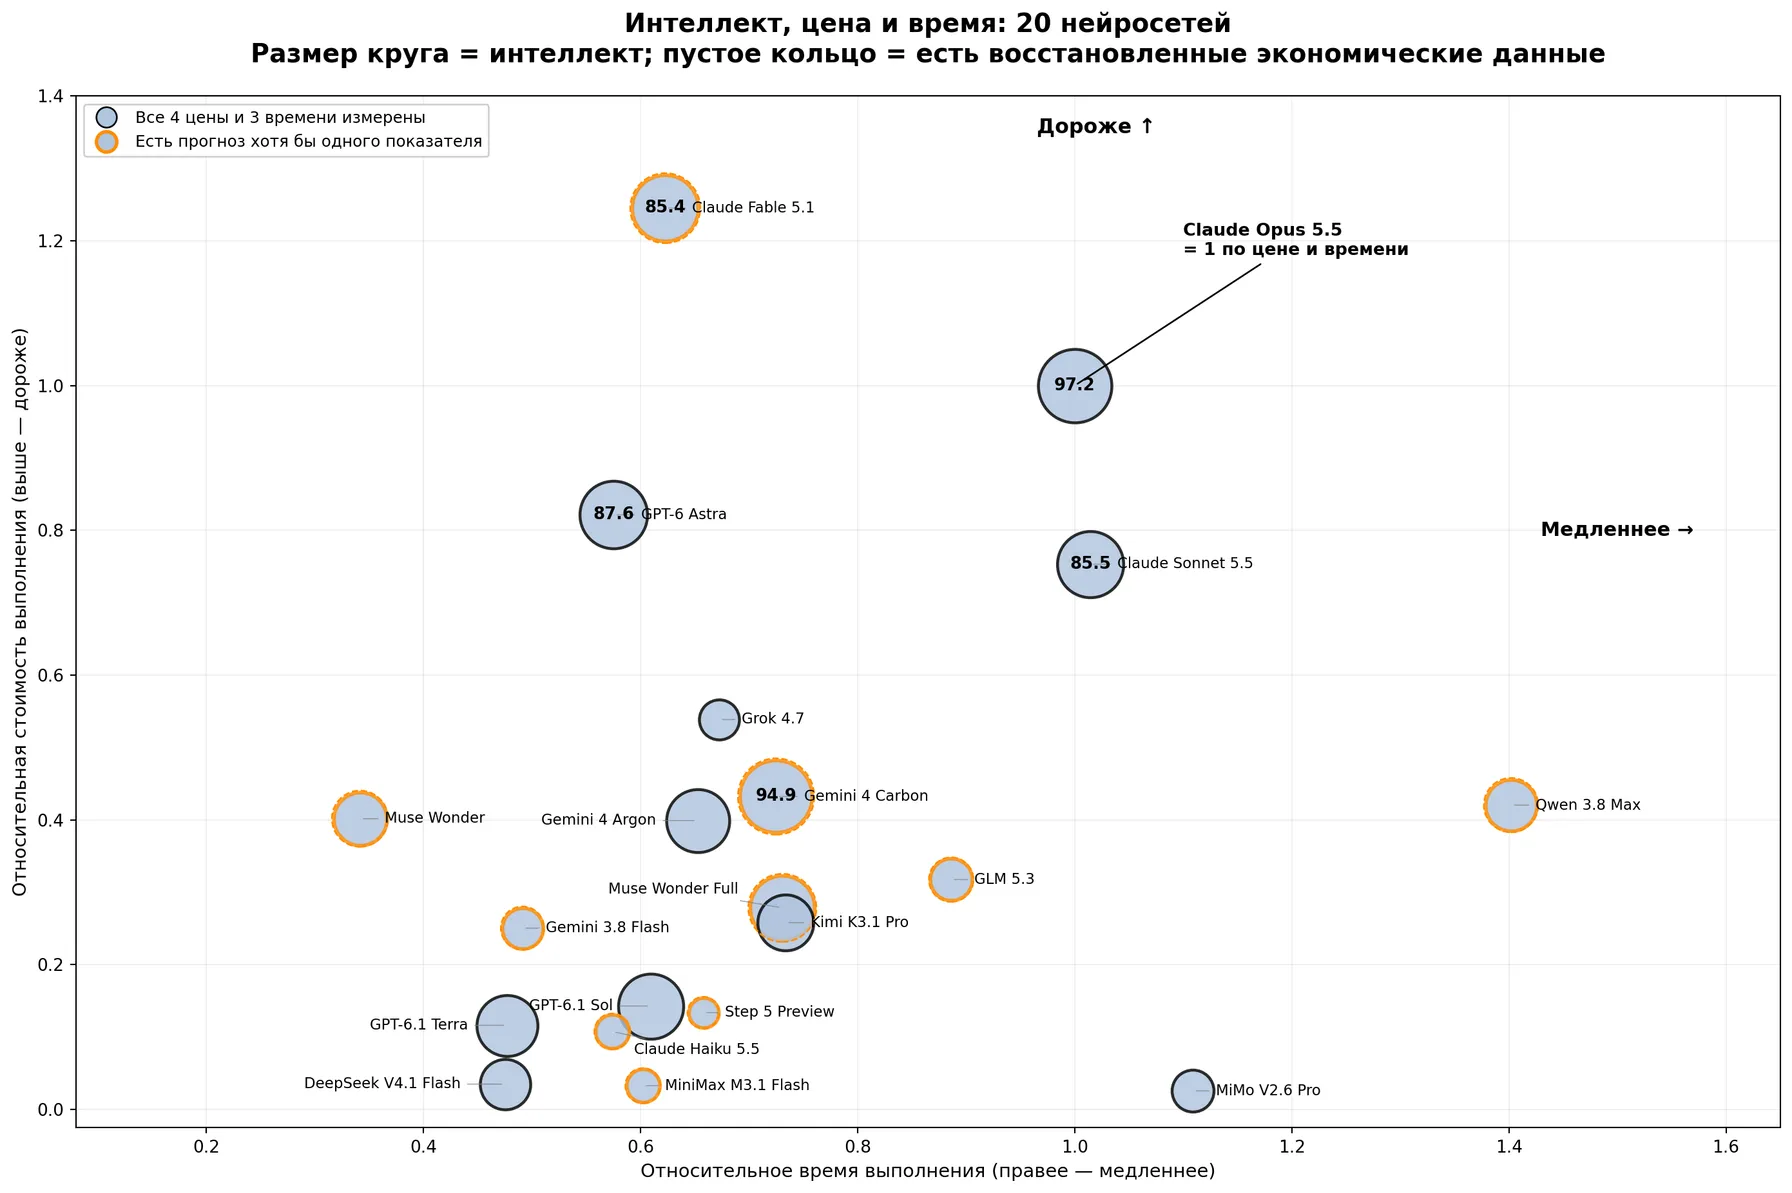
Эта визуализация удобна тем, что позволяет увидеть компромисс сразу в одной плоскости. Например, две модели могут быть сопоставимы по интеллекту, но одна окажется заметно дешевле или быстрее. В то же время очень дешёвая и быстрая модель может быть ощутимо слабее по интеллекту — это видно по меньшему размеру её точки.
На этом графике хорошо заметны несколько групп:
- Claude Opus 5.5, Gemini 4 Carbon и GPT-6 Astra — верхний сегмент по интеллекту, но с разным балансом стоимости и скорости.
- GPT-6.1 Terra и GPT-6.1 Sol — сильный компромисс между качеством, ценой и скоростью.
- DeepSeek V4.1 Flash — очень конкурентен по стоимости и времени, хотя уступает лидерам по интеллекту.
Отдельная проверка только на фактах: следующий расчёт корреляций относится не ко всем 20 точкам диаграммы, а только к 18 моделям с измеренными данными AA + Vals. Корреляция Спирмена между относительной стоимостью и временем составляет 0,228, между индексом интеллекта и временем 0,160, между интеллектом и стоимостью 0,604. Поэтому более высокая стоимость умеренно связана с интеллектом, но почти не объясняет скорость выполнения задач в этой выборке. Малые выборки и смешение различных заданий не позволяют считать эти зависимости универсальными.
Рейтинг эффективности нейросетей: интеллект, стоимость и скорость (p = 3)
Одного рейтинга интеллекта недостаточно, чтобы выбрать модель для реальных задач: более качественный ответ может стоить дороже и занимать больше времени. Поэтому мы рассчитали индекс совокупной эффективности GPTunneL, который поощряет низкую стоимость и высокую скорость, но дополнительно штрафует слабые модели за недостаток интеллекта.
Формула индекса:
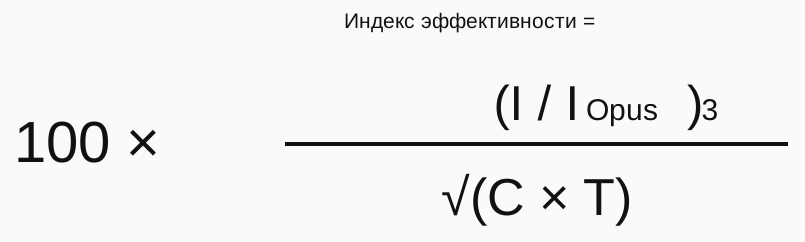
Здесь I — GPTunneL Intelligence Index, I Opus — индекс Claude Opus 5.5; C — стоимость относительно Opus, T — относительная длительность выполнения задач. Для C и T применяется геометрическое объединение показателей бенчмарков. Claude Opus 5.5 = 100: значения выше 100 означают более высокую эффективность по нашей формуле, а не более высокий абсолютный интеллект.
Мы выбрали степень p = 3 после сравнения вариантов 2, 3 и 4. Штраф остаётся нелинейным: модель с интеллектом в 80% от уровня Opus сохраняет лишь 51,2% коэффициента качества (0,8³), до учёта цены и времени. Вариант p = 2 сильнее поощряет дешёвые модели, а p = 4 отдаёт большее преимущество очень интеллектуальным моделям. Выбор степени отражает приоритеты исследовательской методики, а не универсальный закон качества.
Рейтинг эффективности: 18 моделей с фактическими данными
Для основного рейтинга использованы фактические стоимость и время AA + Vals. Для полноты сравнения рядом показаны также показатели по максимально доступному набору источников.
| Место | Модель | Эффективность (p = 3) | Индекс интеллекта | Стоимость (4 источника) | Время (3 источника) |
|---|---|---|---|---|---|
| 1 | GPT-6.1 Terra | 234,0 | 77,8 | 0,116 | 0,477 |
| 2 | GPT-6.1 Sol | 224,5 | 83,9 | 0,143 | 0,609 |
| 3 | DeepSeek V4.1 Flash | 211,5 | 64,3 | 0,035 | 0,475 |
| 4 | Gemini 4 Carbon | 141,5 | 94,9 | 0,432 | 0,725 |
| 5 | GPT-6 Astra | 121,4 | 87,6 | 0,821 | 0,575 |
| 6 | MiMo V2.6 Pro | 115,9 | 55,2 | 0,026 | 1,109 |
| 7 | Claude Opus 5.5 | 100,0 | 97,2 | 1,000 | 1,000 |
| 8 | Gemini 4 Argon | 80,6 | 80,8 | 0,399 | 0,653 |
| 9 | MiniMax M3.1 Flash | 79,7 | 47,7 | 0,033 | 0,602 |
| 10 | Claude Sonnet 5.5 | 72,2 | 85,5 | 0,753 | 1,014 |
| 11 | Kimi K3.1 Pro | 70,9 | 71,0 | 0,258 | 0,734 |
| 12 | Muse Wonder | 70,4 | 67,4 | 0,402 | 0,342 |
| 13 | Claude Haiku 5.5 | 61,2 | 48,1 | 0,108 | 0,574 |
| 14 | Gemini 3.8 Flash | 40,7 | 54,2 | 0,250 | 0,491 |
| 15 | Step 5 Preview | 32,3 | 45,3 | 0,134 | 0,658 |
| 16 | Qwen 3.8 Max 0902 | 30,8 | 65,3 | 0,420 | 1,402 |
| 17 | GLM 5.3 | 30,8 | 55,3 | 0,317 | 0,886 |
| 18 | Grok 4.7 | 28,4 | 53,5 | 0,539 | 0,672 |
Как читать столбцы: эффективность p = 3 рассчитана строго по фактическим расходам и времени AA + Vals, поэтому порядок 18 моделей не меняется. Стоимость — отдельный объединённый коэффициент по 4 источникам (AA, Vals, Agent Arena, LiveBench), время — коэффициент по 3 источникам (AA, Vals, Agent Arena); оба показателя получены геометрическим усреднением относительно Claude Opus 5.5 = 1. Важно: в двух последних столбцах для ряда моделей использованы прогнозные значения пропусков. Из-за разного состава источников эти коэффициенты не являются прямыми входными данными приведённого индекса эффективности. Для единой формулы со всеми источниками рейтинг p = 3 надо пересчитывать отдельно, и его места могут измениться.
Что показывает рейтинг. При p = 3 лидирует GPT-6.1 Terra (234,0), затем GPT-6.1 Sol (224,5) и DeepSeek V4.1 Flash (211,5). Преимущество Terra над Sol по итоговому коэффициенту составляет около 4,2%, поэтому назвать его безоговорочным победителем нельзя. Gemini 4 Carbon (141,5) занимает четвёртое место: при очень высоком интеллекте он заметно эффективнее базового Opus за счёт цены и времени. GPT-6 Astra (121,4) тоже превышает базовый уровень Opus, а Claude Opus 5.5 (100,0) остаётся лидером по интеллекту, но не по экономической эффективности.
Чувствительность к штрафу. При p = 2 лидирует DeepSeek, при p = 3 — Terra, при p = 4 — Sol. Изменение победителя показывает, что универсального «лучшего» соотношения цены, скорости и интеллекта не существует: оно зависит от требований к качеству. Для сложных задач разумно дополнительно вводить минимальный порог интеллекта, иначе низкая цена может компенсировать недостаточную пригодность модели.
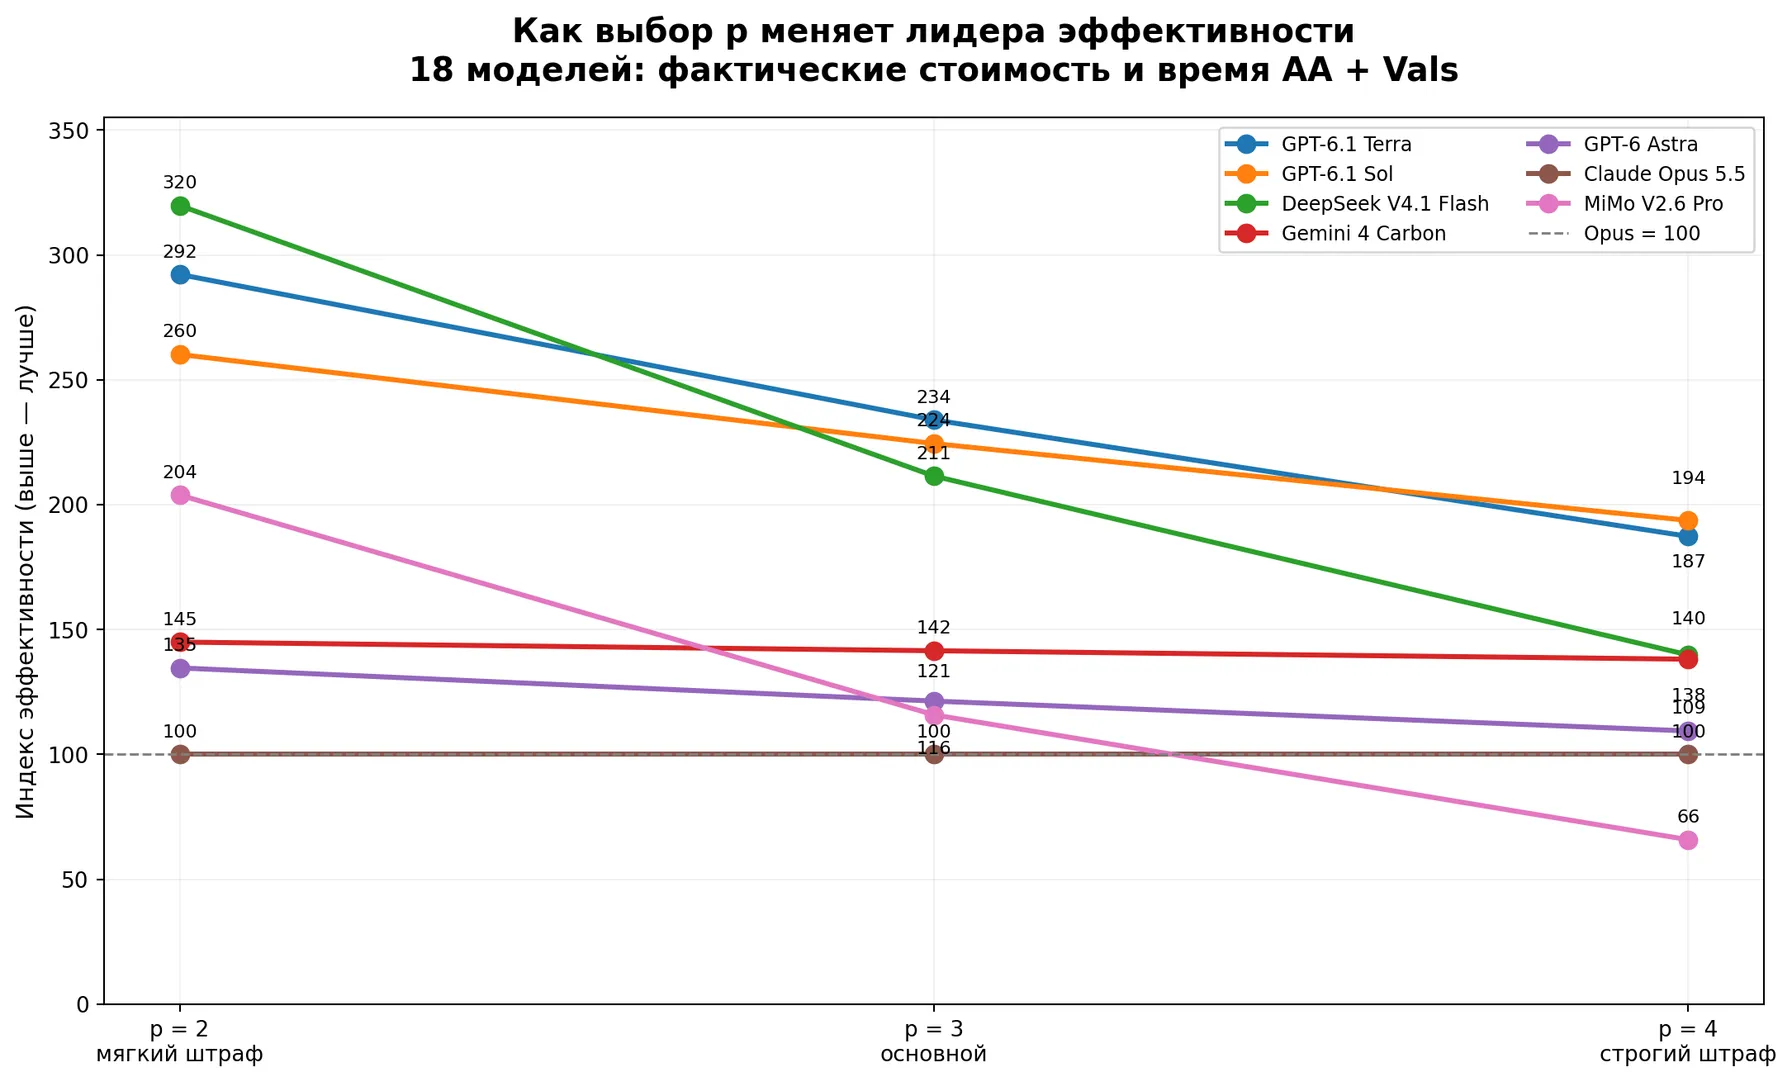
Что означает смена лидера: при p = 2 DeepSeek набирает около 319,8, Terra — 292,2, Sol — 260,2. При p = 3 Terra набирает 234,0, Sol — 224,5, DeepSeek — 211,5. При p = 4 лидирует Sol (193,7) перед Terra (187,3). Индекс чувствителен не только к данным, но и к редакционному выбору штрафа за меньший интеллект. Результаты рассчитаны на той же выборке из 18 моделей и не означают, что одна степень p универсально правильнее другой.
Ограничения. Индекс — аналитическая условная метрика, а не вероятность правильного ответа и не стоимость одного гарантированно успешно решённого задания. Время и цена получены на разных наборах задач и нормализованы относительно одного эталона; при другом составе бенчмарков результаты могут измениться. Для расширенной двадцатки в рабочем Excel есть отдельные значения с прогнозами пропусков: они не смешиваются с приведённым выше фактическим рейтингом.
Эффективность и интеллект: где разумный баланс?
На диаграмме ниже по горизонтали — индекс интеллекта, по вертикали — индекс эффективности p = 3. Модель в правом верхнем углу сочетает высокое качество с хорошим соотношением затрат и времени. Цветом обозначено семейство модели, все 18 моделей подписаны. Пунктирная линия 100 соответствует эффективности Claude Opus 5.5.
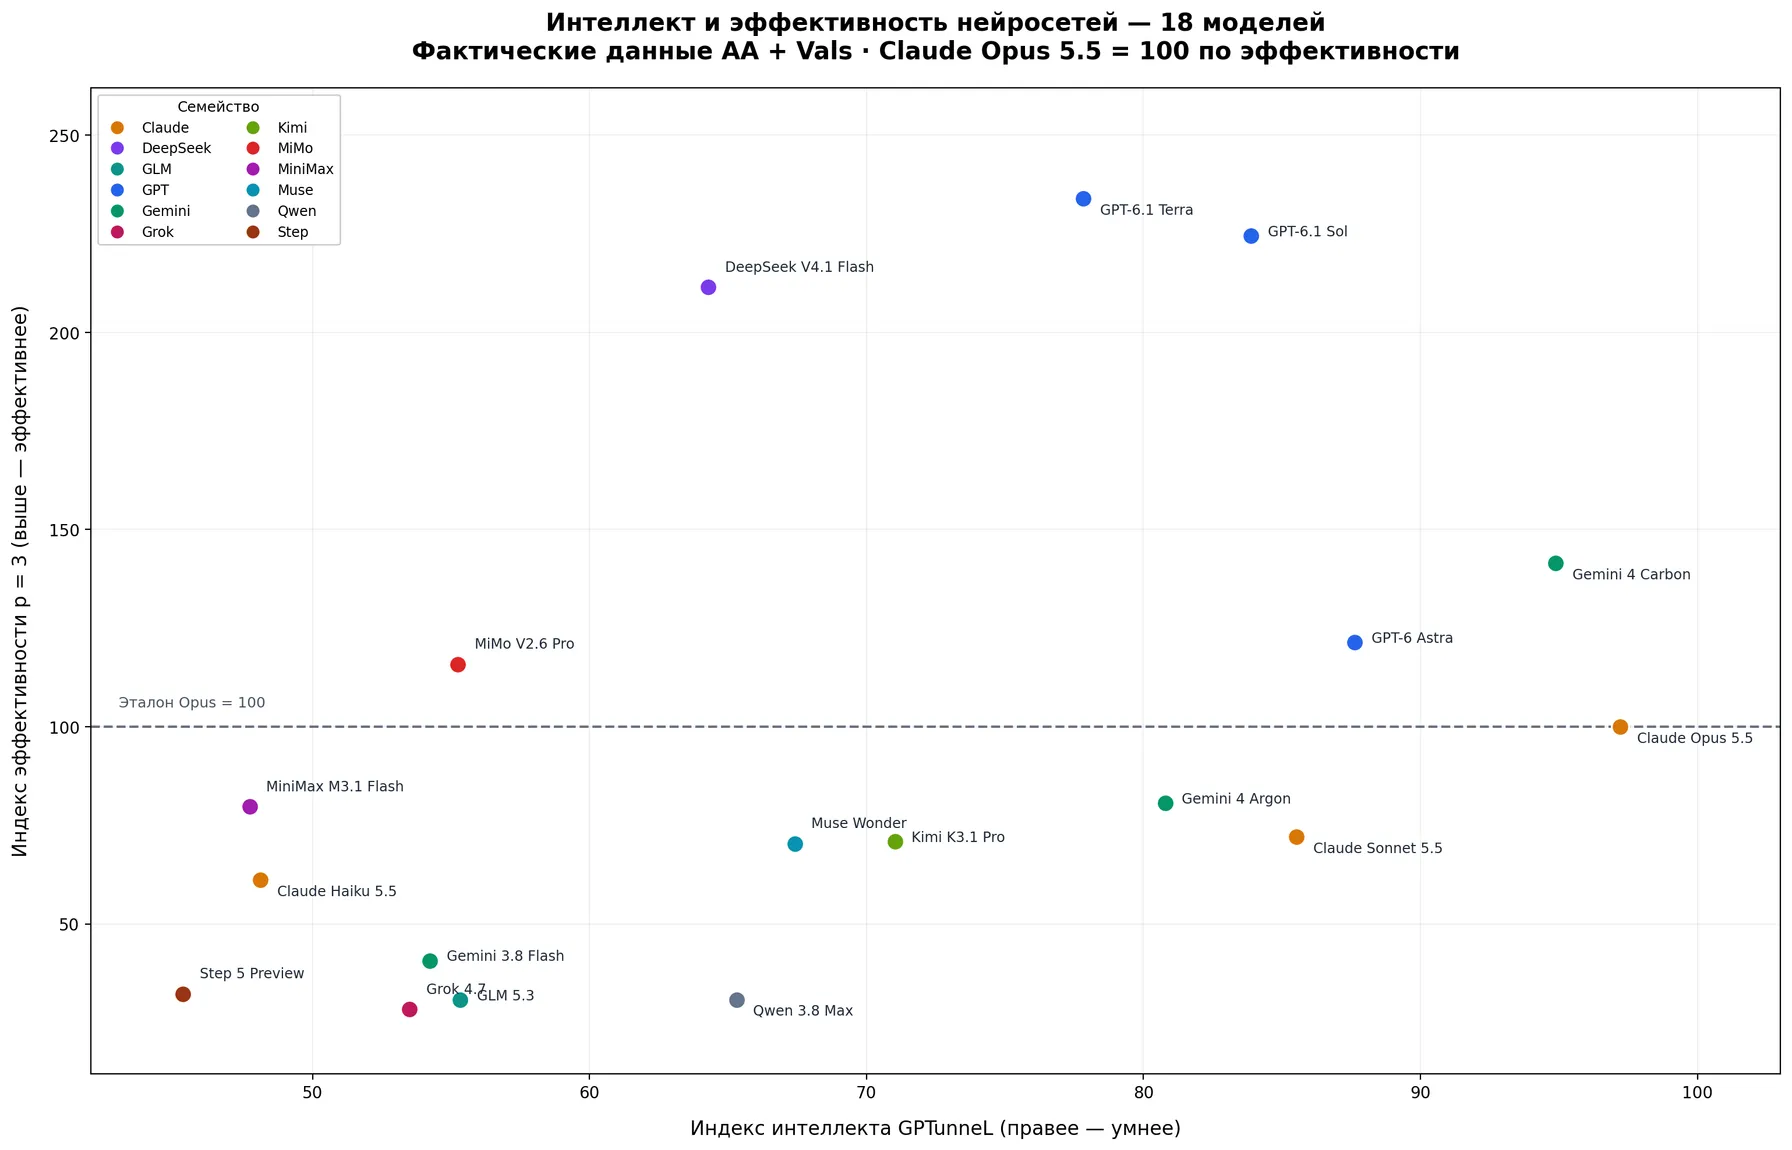
Что видно: Claude Opus 5.5 находится правее остальных — по нашему индексу она наиболее интеллектуальна, но её эффективность равна эталонным 100. Gemini 4 Carbon (94,9 по интеллекту; 141,5 по эффективности) располагается близко к Opus по качеству и выше по эффективности. GPT-6.1 Terra (77,8; 234,0) и GPT-6.1 Sol (83,9; 224,5) образуют группу моделей с наиболее выгодным сочетанием трёх параметров. DeepSeek V4.1 Flash (64,3; 211,5) показывает, как низкие расходы позволяют набрать высокий показатель эффективности даже при заметно меньшем интеллекте.
Важно: эффективность сама включает интеллект в формуле, поэтому этот график не демонстрирует статистически независимую связь двух характеристик. Он нужен для визуального выбора компромисса.
Рейтинг эффективности на одной диаграмме
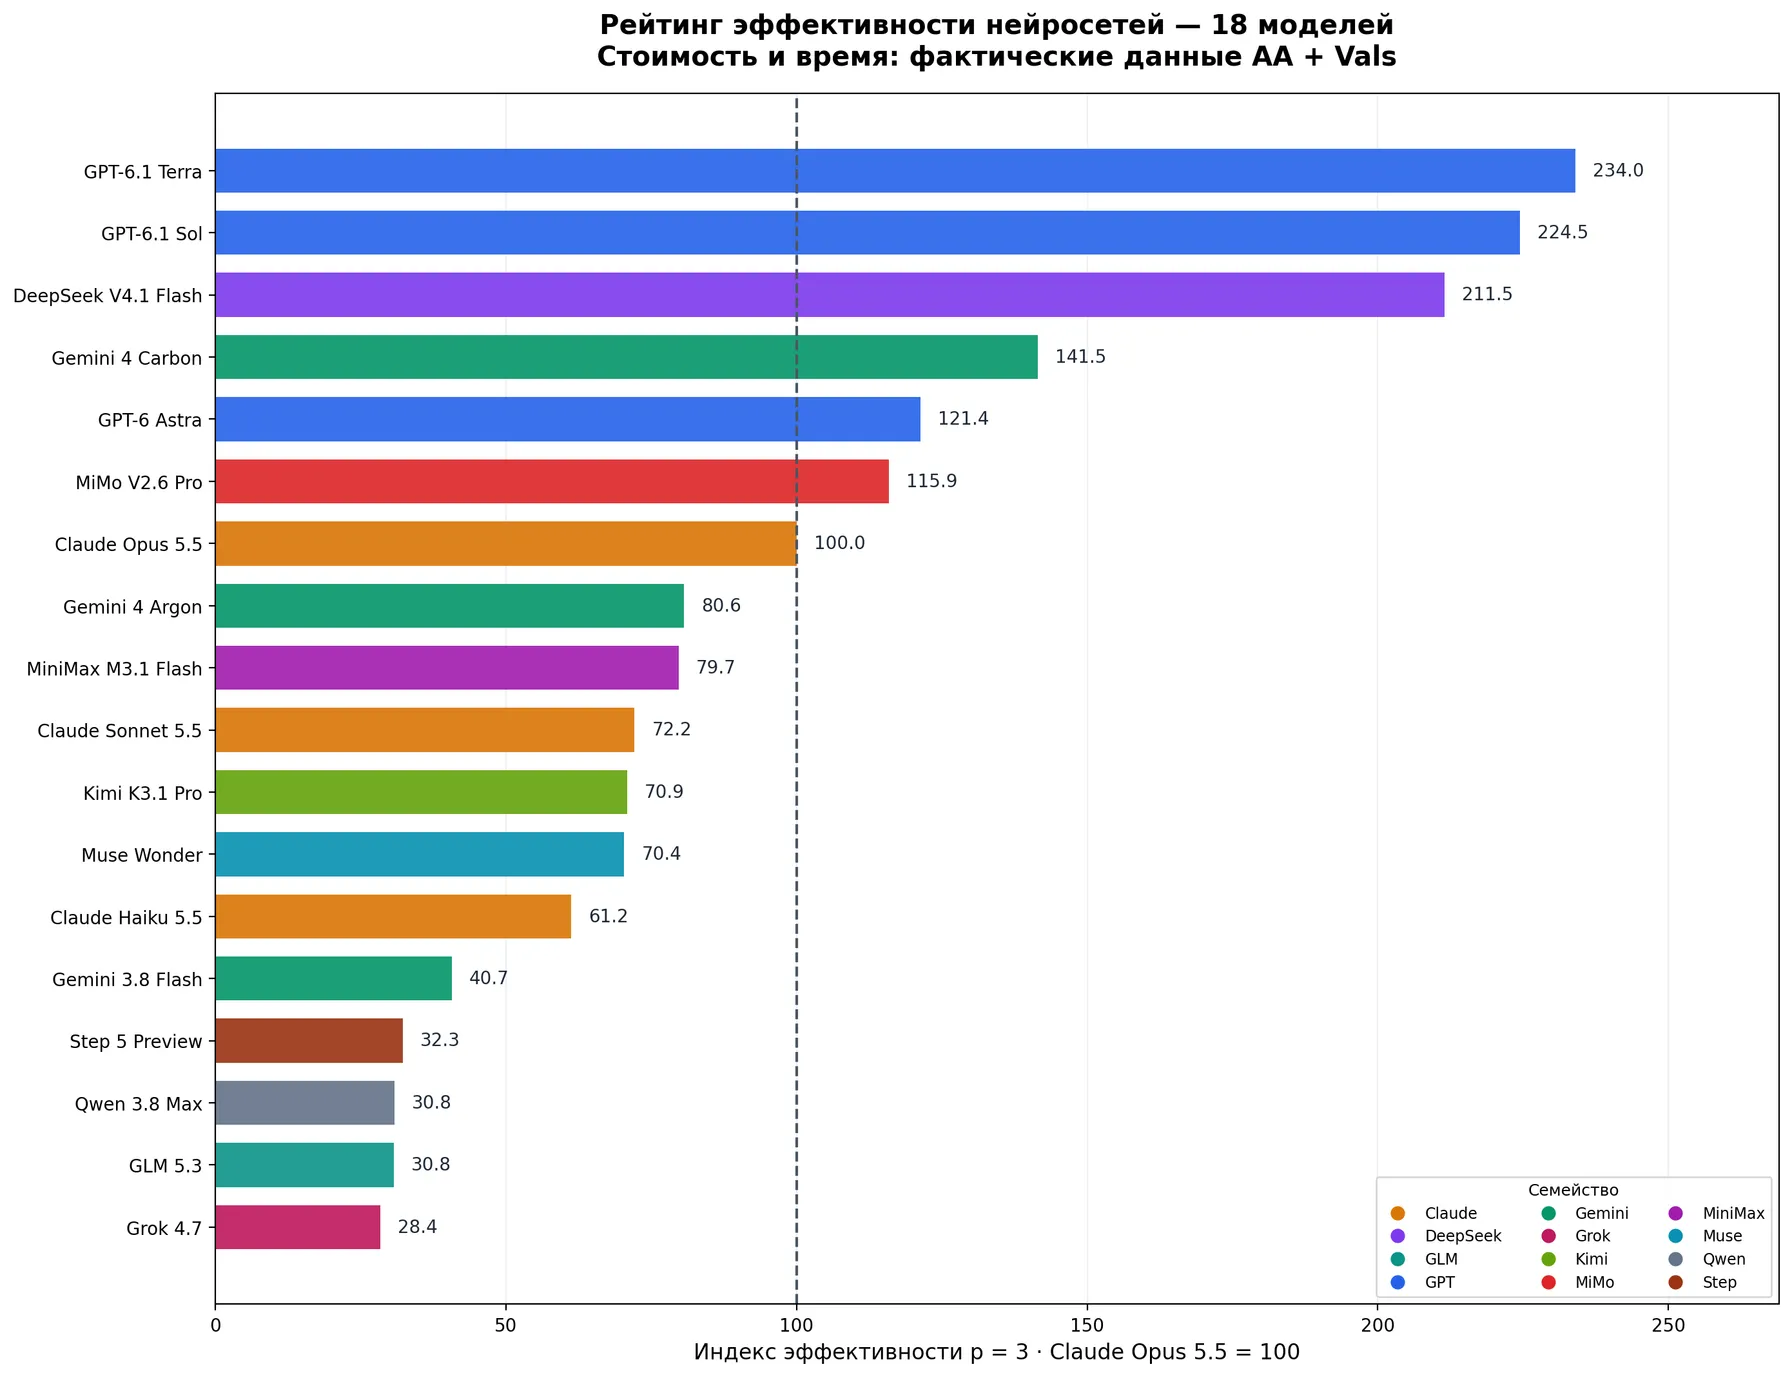
Горизонтальные столбцы показывают все 18 моделей с фактическими исходными экономическими данными AA + Vals в порядке убывания эффективности. Цвета семейств совпадают с предыдущим графиком. Terra — 234,0; Sol — 224,5; DeepSeek — 211,5; Carbon — 141,5; Astra — 121,4. Это не рейтинг абсолютного интеллекта и не оценка стоимости успешного ответа в конкретной пользовательской задаче.
Сравнение моделей на радарных диаграммах
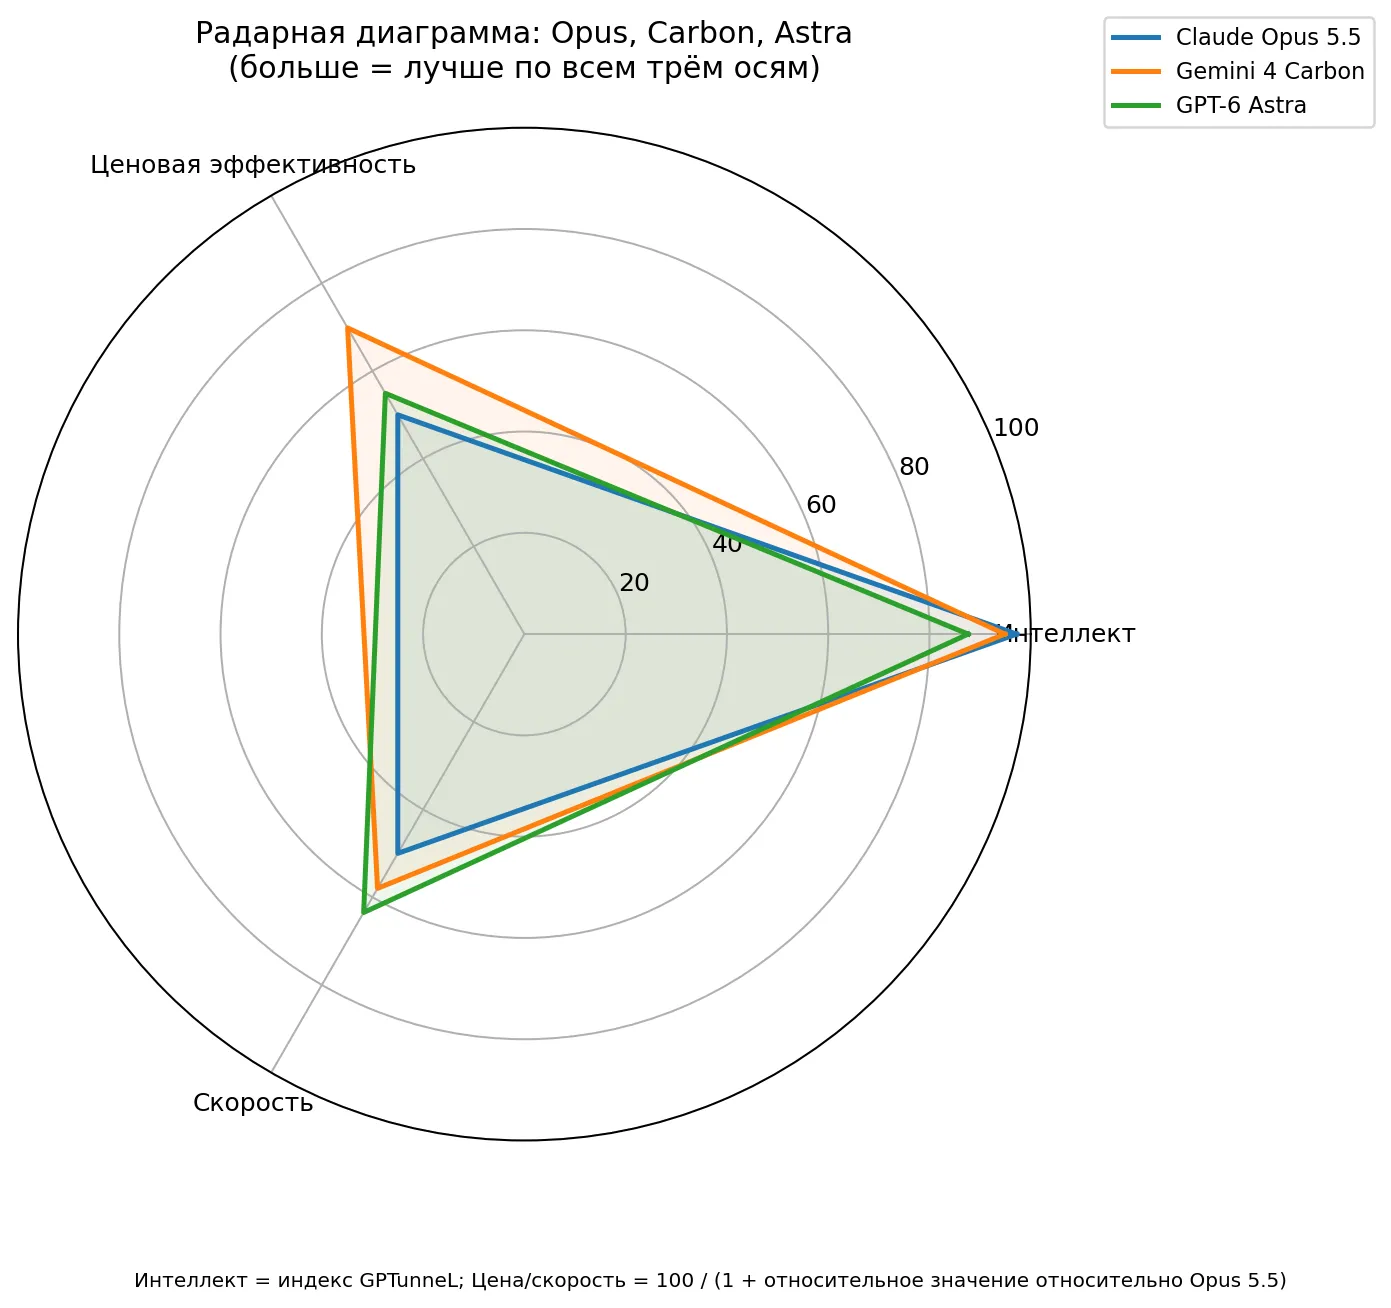
Радар позволяет увидеть соотношение трёх характеристик в компактном виде. Чем дальше вершина от центра, тем лучше характеристика. Интеллект показан индексом GPTunneL (0–100), ценовая эффективность и скорость приведены к общей шкале по формуле 100 / (1 + относительная стоимость или время). Таким образом, у Claude Opus 5.5 значение по цене и времени равно 50. Это визуальные шкалы, а не новые рейтинги: исходные коэффициенты стоимости и длительности сохраняются. В радарных диаграммах ниже используется расширенная оценка: стоимость по четырём источникам и время по трём, включая прогнозные значения при отсутствии измерений.
Claude Opus 5.5, Gemini 4 Carbon и GPT-6 Astra. Сравнение лидеров по интеллекту: Opus занимает первое место по качеству, Carbon существенно дешевле, а Astra быстрее при несколько меньшем рейтинге интеллекта.
GPT-6.1 Terra, DeepSeek V4.1 Flash, Claude Sonnet 5.5 и GPT-6.1 Sol. Sonnet сильнее по индексу интеллекта (85,5), следом идёт Sol (83,9), тогда как Terra (77,8) и DeepSeek (64,3) заметно доступнее. По индексу времени Terra и DeepSeek быстрее Sol и Sonnet. Sol предлагает промежуточный баланс интеллекта, стоимости и времени.
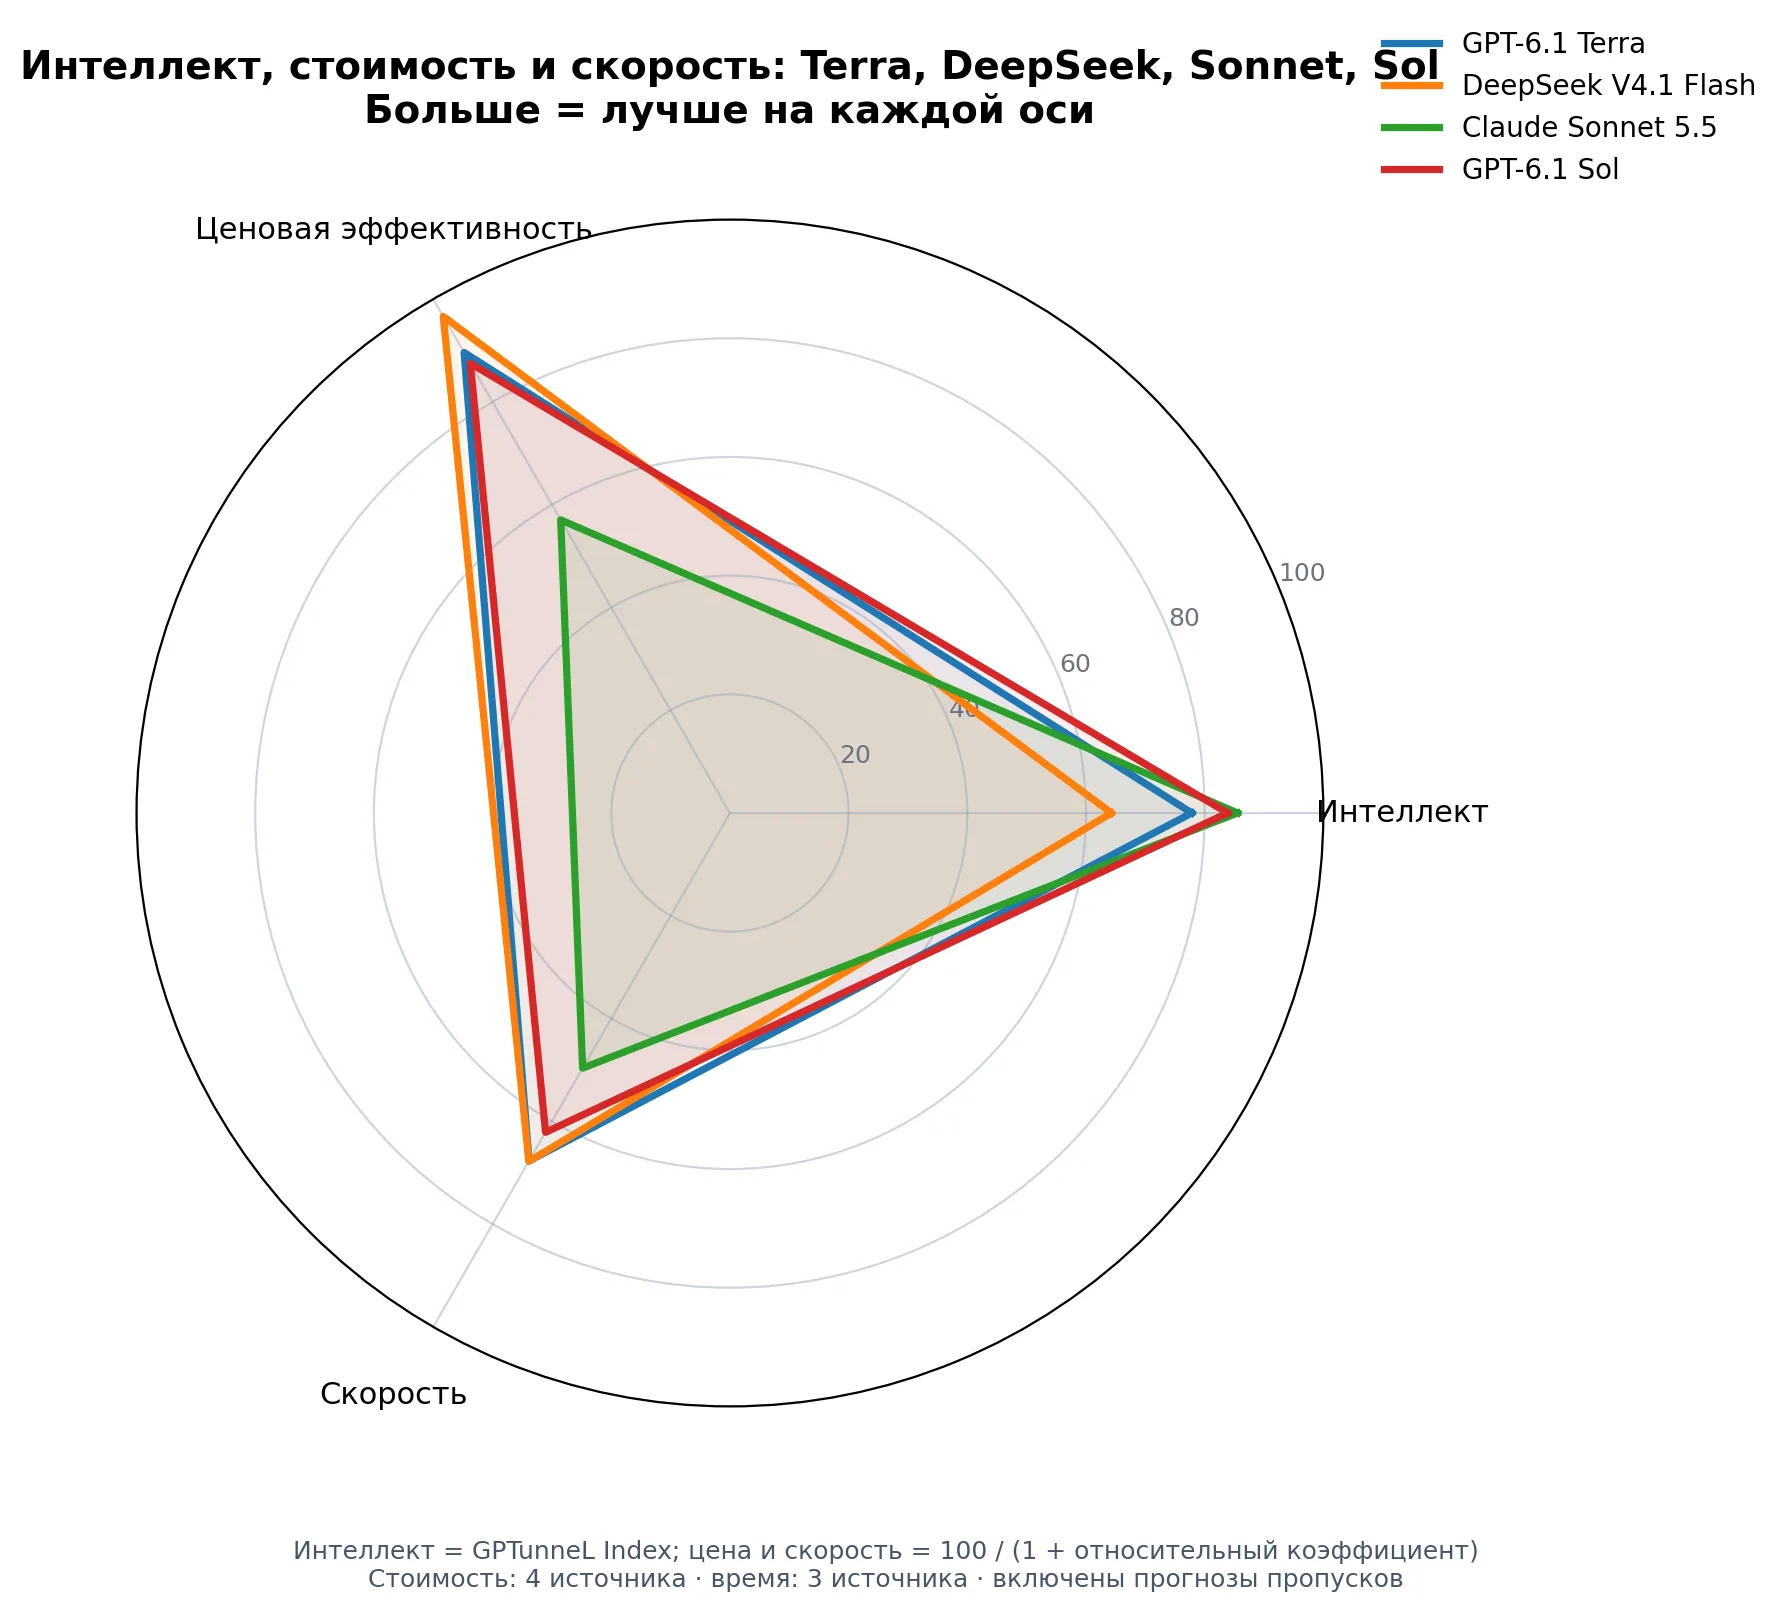
Внимание: форма многоугольника зависит от выбранного преобразования относительных коэффициентов. Сравнивайте вершины одной характеристики; площадь многоугольника не является итоговым интегральным рейтингом.
Практический вывод: при массовой автоматизации задача выбора модели становится трёхмерной. Низкая цена API не гарантирует низкую задержку, а небольшое преимущество в интеллектуальном индексе может сопровождаться большим увеличением и расходов, и времени ожидания. Оптимальное решение зависит от того, какие ограничения важнее для конкретной рабочей нагрузки.
Лучшие нейросети по специализациям
Общий GPTunneL Intelligence Index оценивает широкую совокупность способностей, но он не означает, что лидер лучше всех программирует, анализирует данные или работает с документами. Поэтому мы отдельно рассчитали профильные рейтинги на основе исходной исследовательской матрицы 20 моделей × 37 заявленных показателей (срез 3 ноября 2026 года) и последующих дополнений для программирования.
Покрытие данных и методика:
7 из 37 столбцов исходной матрицы были полностью пусты; отсутствие значения не означает нулевую способность модели. Позднее результаты AA FrontierCode 2.0 и Terminal-Bench 4.0 были собраны в отдельной дополненной таблице программирования, поэтому исходную матрицу и актуальный кодовый рейтинг не стоит считать одной и той же версией набора данных. Основной кодовый рейтинг теперь охватывает все 20 моделей с одинаковыми пятью фактическими показателями; охват других направлений меньше.
Методика: для каждого направления выбираем 1–3 сопоставимых профильных теста и оставляем лишь модели, у которых есть все фактические результаты выбранного набора. Каждый балл делится на результат лидера теста внутри общей выборки, после чего нормированные компоненты усредняются с одинаковыми весами. Для программирования используются три источника: нормированные на лидера показатели AA и Vals и Min-Max для Arena WebDev Elo. После объединения двух тестов внутри AA и Vals три источника усредняются с равными весами по 1/3. Процентильные ранги в итоговом индексе больше не применяются.
Важно: профильный индекс 0–100 — относительная оценка внутри конкретной группы, а не процент правильно решённых заданий. Баллы между разными специализациями сопоставлять нельзя. Прогнозные значения и модели без полного набора измерений в рейтинг не включались. Показатели одних источников не являются независимыми подтверждениями, даже когда включают несколько задач.
Основные специализированные рейтинги
| Специализация / срез | Лидер (индекс) | №2 (индекс) | Основа расчёта |
|---|---|---|---|
| Программирование — AA + Vals + Arena | Claude Opus 5.5, 97,74 | Claude Sonnet 5.5, 91,56 | 20 моделей, 5 профильных тестов; нормированные результаты |
| Финансы — Vals | Gemini 4 Carbon, 99,6 | Claude Opus 5.5, 99,5 | 15; Finance Agent, Excel Modeling |
| Право и налоги — Vals | Gemini 4 Argon, 94,8 | Muse Wonder Full, 88,2 | 15; Legal Research, HLAB, Tax Agent |
| Агенты — LiveBench | GPT-6 Astra, 98,7 | Claude Fable 5.1, 98,1 | 13; Agentic, Browser Use |
| Агенты — OSWorld/Zapier | Gemini 4 Carbon, 96,7 | Gemini 4 Argon, 90,4 | 5; OSWorld, AutomationBench |
| Наука и математика | Gemini 4 Carbon, 100,0 | GPT-6 Astra, 93,8 | 5; Terminal-Bench-Science, RiemannBench |
| Рассуждение — ARC + LiveBench | GPT-6 Astra, 98,7 | GPT-6.1 Sol, 98,3 | 9; оба результата измерены |
| Визуальные задачи | Gemini 4 Carbon, 100,0 | Gemini 4 Argon, 95,8 | 5; Chartography, Blueprint-Bench |
| Кибербезопасность | Gemini 4 Carbon, 100,0 | GPT-6 Astra, 86,6 | 4; CWE-bench, ExploitGym |
| Исследования — LiveBench | Muse Wonder, 100,0 | Grok 4.7, 98,2 | 13; один тест |
| Анализ данных — LiveBench | Gemini 4 Argon, 100,0 | GPT-6 Astra, 97,4 | 13; один тест |
| Дизайн — LiveBench | Claude Opus 5.5, 100,0 | Claude Sonnet 5.5, 97,8 | 13; один тест |
| Длинный контекст — GraphWalks | Gemini 4 Carbon, 100,0 | Gemini 4 Argon, 87,5 | 5; один тест |
| ARC-AGI-2 | GPT-6 Astra, 100,0 | GPT-6.1 Sol, 99,2 | 10; только факты |
Полные рейтинги всех доступных моделей, исходные баллы каждого теста, число участников и проверка устойчивости к исключению одного бенчмарка находятся в Excel с профильными рейтингами; пересчитанный единый рейтинг программирования по нормированным результатам — в новом Excel.
Программирование: итоговый рейтинг всех 20 моделей по AA, Vals и Arena
Для каждой из 20 моделей имеется одинаковый набор из пяти фактических результатов:
- Artificial Analysis (вес 1/3): Terminal-Bench 4.0 и FrontierCode 2.0.
- Vals AI (вес 1/3): Terminal-Bench 4.0 и Vibe Code Bench v1.1.
- Arena (вес 1/3): WebDev Elo.
Единая методика нормализации: все четыре процентных теста AA и Vals делятся на результат лидера этого теста среди всех 20 моделей и умножаются на 100. Затем два нормированных показателя AA усредняются, как и два показателя Vals. Для Arena используем Min-Max на фактическом диапазоне 1571–1810 Elo:
Arena_norm = 100 × (Elo - 1571) / (1810 - 1571).
Итог: Индекс программирования = (AA_norm + Vals_norm + Arena_norm) / 3. Сохраняются реальные величины различий между моделями и равное влияние трёх источников. Это не процент решённых заданий, а относительный составной индекс на шкале 0–100.
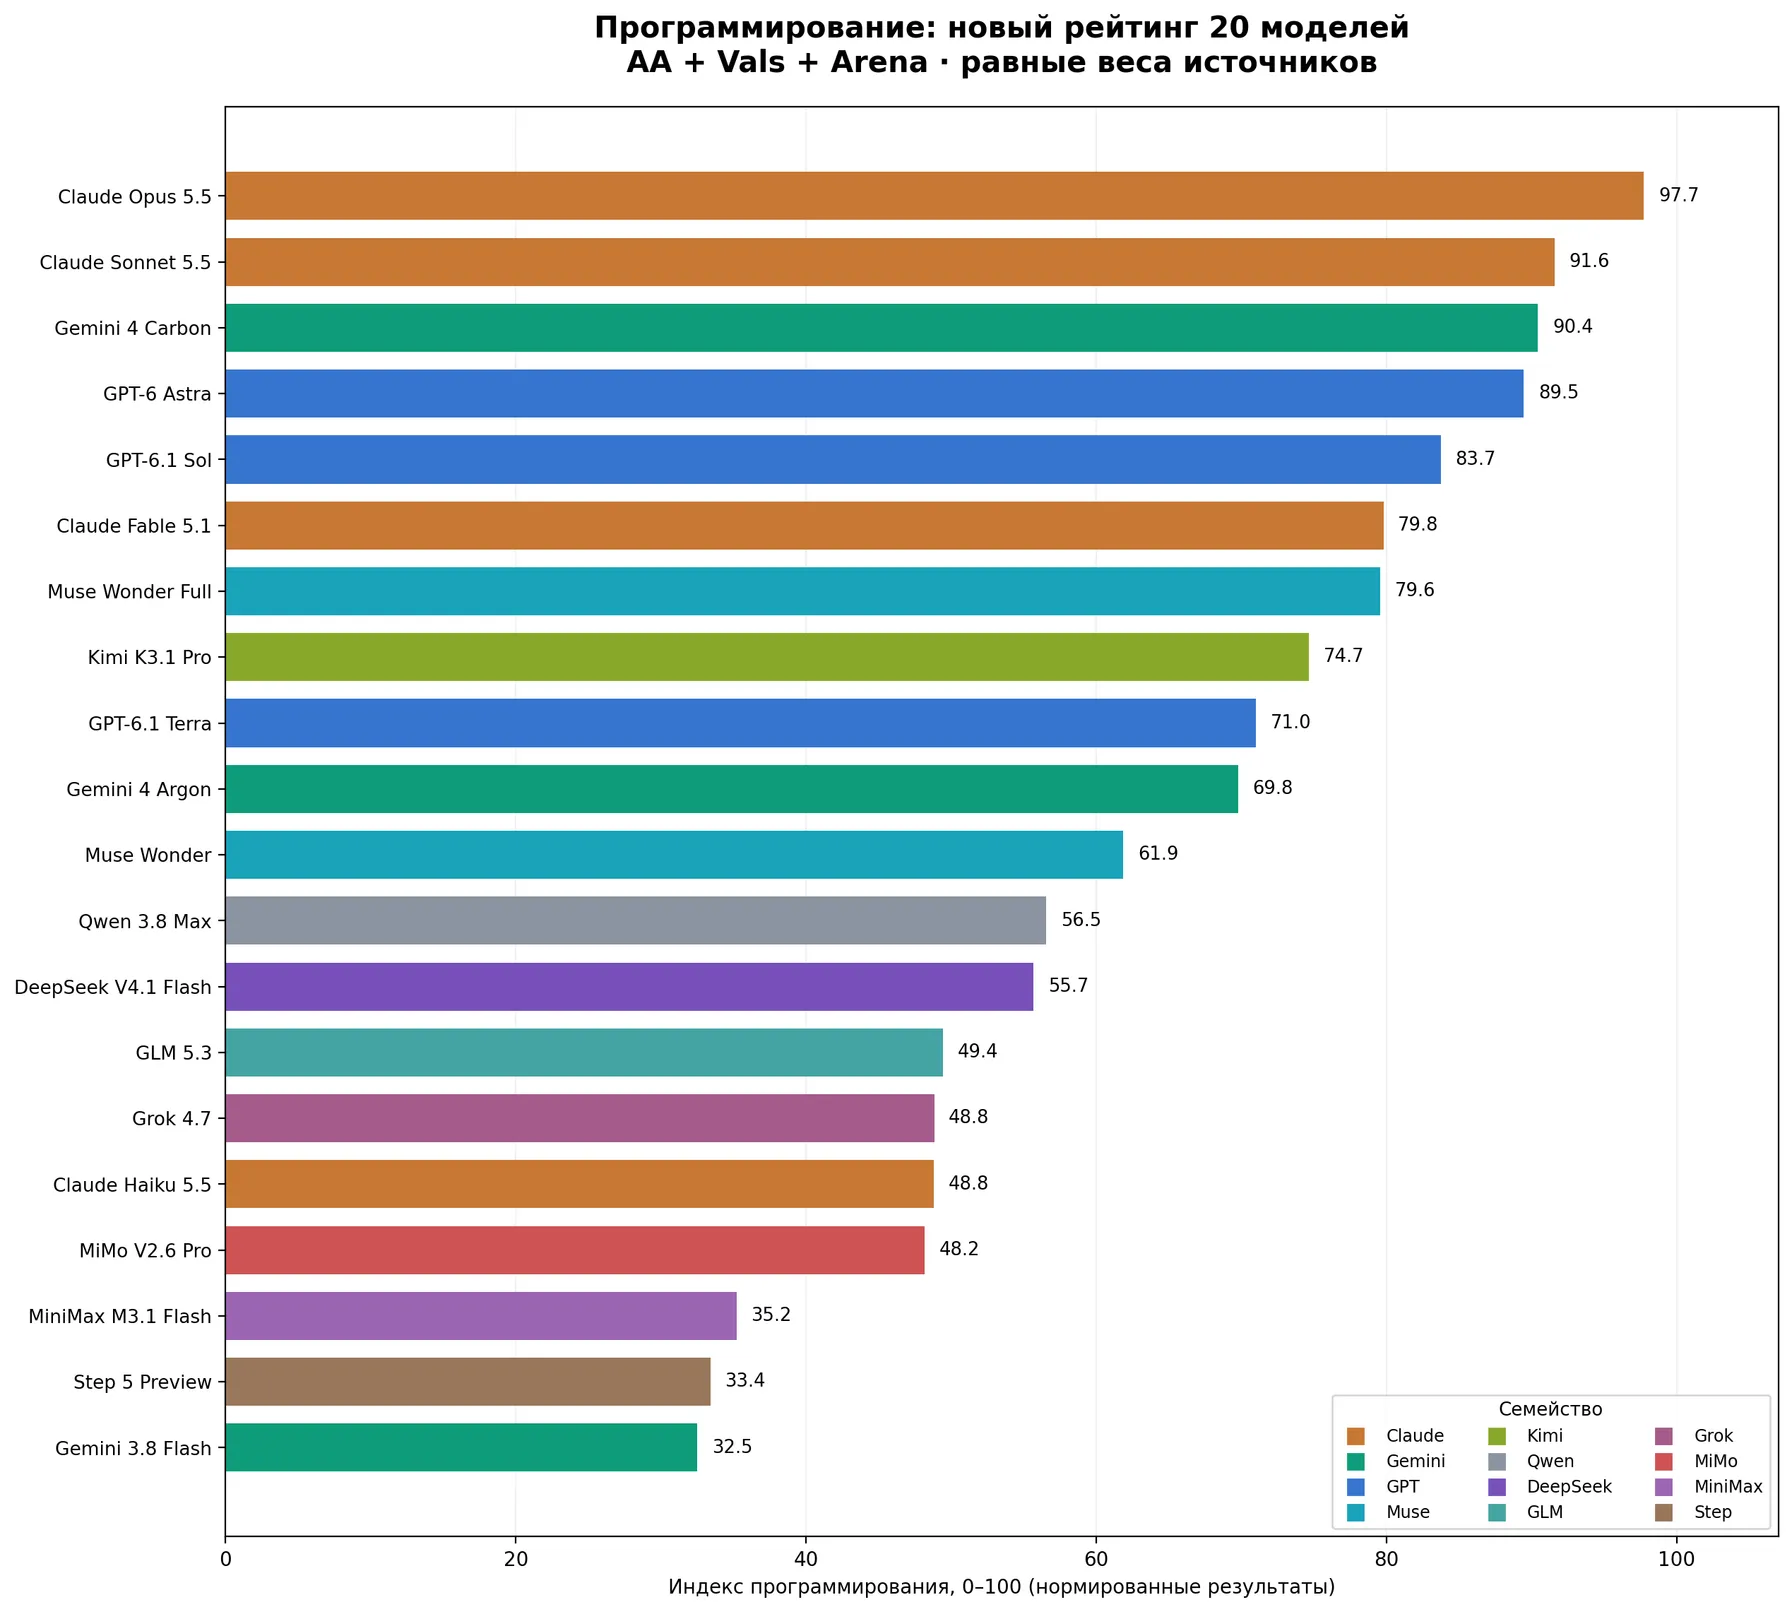
Полный рейтинг ии для программирования: 20 моделей
| № | Модель | Новый индекс | AA (норм.) | Vals (норм.) | Arena (Min-Max) |
|---|---|---|---|---|---|
| 1 | Claude Opus 5.5 | 97,74 | 94,3 | 98,9 | 100,0 |
| 2 | Claude Sonnet 5.5 | 91,56 | 92,3 | 99,2 | 83,3 |
| 3 | Gemini 4 Carbon | 90,43 | 92,3 | 96,6 | 82,4 |
| 4 | GPT-6 Astra | 89,46 | 89,7 | 94,2 | 84,5 |
| 5 | GPT-6.1 Sol | 83,72 | 85,5 | 90,4 | 75,3 |
| 6 | Claude Fable 5.1 | 79,79 | 72,7 | 93,4 | 73,2 |
| 7 | Muse Wonder Full | 79,58 | 83,2 | 91,1 | 64,4 |
| 8 | Kimi K3.1 Pro | 74,66 | 77,4 | 94,7 | 51,9 |
| 9 | GPT-6.1 Terra | 71,01 | 87,0 | 83,4 | 42,7 |
| 10 | Gemini 4 Argon | 69,76 | 70,2 | 93,9 | 45,2 |
| 11 | Muse Wonder | 61,86 | 68,8 | 82,9 | 33,9 |
| 12 | Qwen 3.8 Max 0902 | 56,55 | 54,2 | 71,6 | 43,9 |
| 13 | DeepSeek V4.1 Flash 1017 | 55,68 | 55,9 | 71,8 | 39,3 |
| 14 | GLM 5.3 | 49,43 | 54,5 | 72,1 | 21,8 |
| 15 | Grok 4.7 | 48,82 | 50,1 | 68,7 | 27,6 |
| 16 | Claude Haiku 5.5 | 48,79 | 62,0 | 76,8 | 7,5 |
| 17 | MiMo V2.6 Pro | 48,18 | 51,8 | 70,1 | 22,6 |
| 18 | MiniMax M3.1 Flash | 35,20 | 41,6 | 59,4 | 4,6 |
| 19 | Step 5 Preview | 33,40 | 37,7 | 62,5 | 0,0 |
| 20 | Gemini 3.8 Flash | 32,51 | 34,8 | 57,7 | 5,0 |
Главные выводы:
- Claude Opus 5.5 — 97,74: сохраняет лидерство. У модели максимальные результаты по Arena WebDev (1810 Elo) и FrontierCode 2.0 (46,4%), что компенсирует отставание по Terminal-Bench.
- Claude Sonnet 5.5 — 91,56: вторая и лидер нормированного агрегата Vals (99,16). Отрыв от Carbon сократился до 1,13 балла.
- Gemini 4 Carbon — 90,43 и GPT-6 Astra — 89,46: третье и четвёртое места. Разница лишь 0,97 балла, поэтому на конкретных задачах их порядок может поменяться. Carbon сильнее в AA Terminal-Bench (65,2% против 59,1%), а Astra немного выше в Arena WebDev (1773 против 1768 Elo).
- GPT-6.1 Sol — 83,72: поднялась на пятое место вместо делёжки пятого с Kimi в старом ранговом индексе. Применение нормированных величин учитывает, что Sol близка к лидерам по совокупности задач.
- DeepSeek V4.1 Flash — 55,68: конкурентоспособна по экономике, но по измеренным профильным тестам программирования заметно уступает лидерам. Индекс эффективности и индекс кодинга измеряют разные качества.
Проверка устойчивости. На 15 моделях с дополнительным фактическим Code Migration (третья составляющая Vals) лидеры идут в том же порядке: Opus → Sonnet → Carbon → Astra. При удалении обоих Terminal-Bench из расчёта на всех 20 моделях первые два места сохраняются, но Astra обходит Carbon. Следовательно, результаты Carbon и Astra особенно зависят от характера инженерных задач.
Ограничения: AA и Vals включают похожие версии Terminal-Bench, поэтому источники не полностью независимы. Arena оценивает создание веб-интерфейсов по Elo, а не долю успешно решённых задач; Min-Max зависит от крайних значений выбранной двадцатки. Условия запуска, инструменты, reasoning effort и состав тестов могут различаться. Этот индекс следует проверять на собственных репозиториях и рабочих сценариях.
Первичные источники: AA — Terminal-Bench 4.0, AA — FrontierCode 2.0, Vals Index, Arena WebDev.
Подробный расчёт: обновлённый Excel с формулами, всеми специализациями и проверкой чувствительности. Старые процентильные оценки сохранены только для сопоставления в отдельной колонке Excel; для главного рейтинга они не используются.
Лучшие ИИ для финансов: почти ничья среди лидеров
Финансовый рейтинг построен на Finance Agent v2.1 и Excel Modeling v1.1, оба из Vals, для 15 моделей.
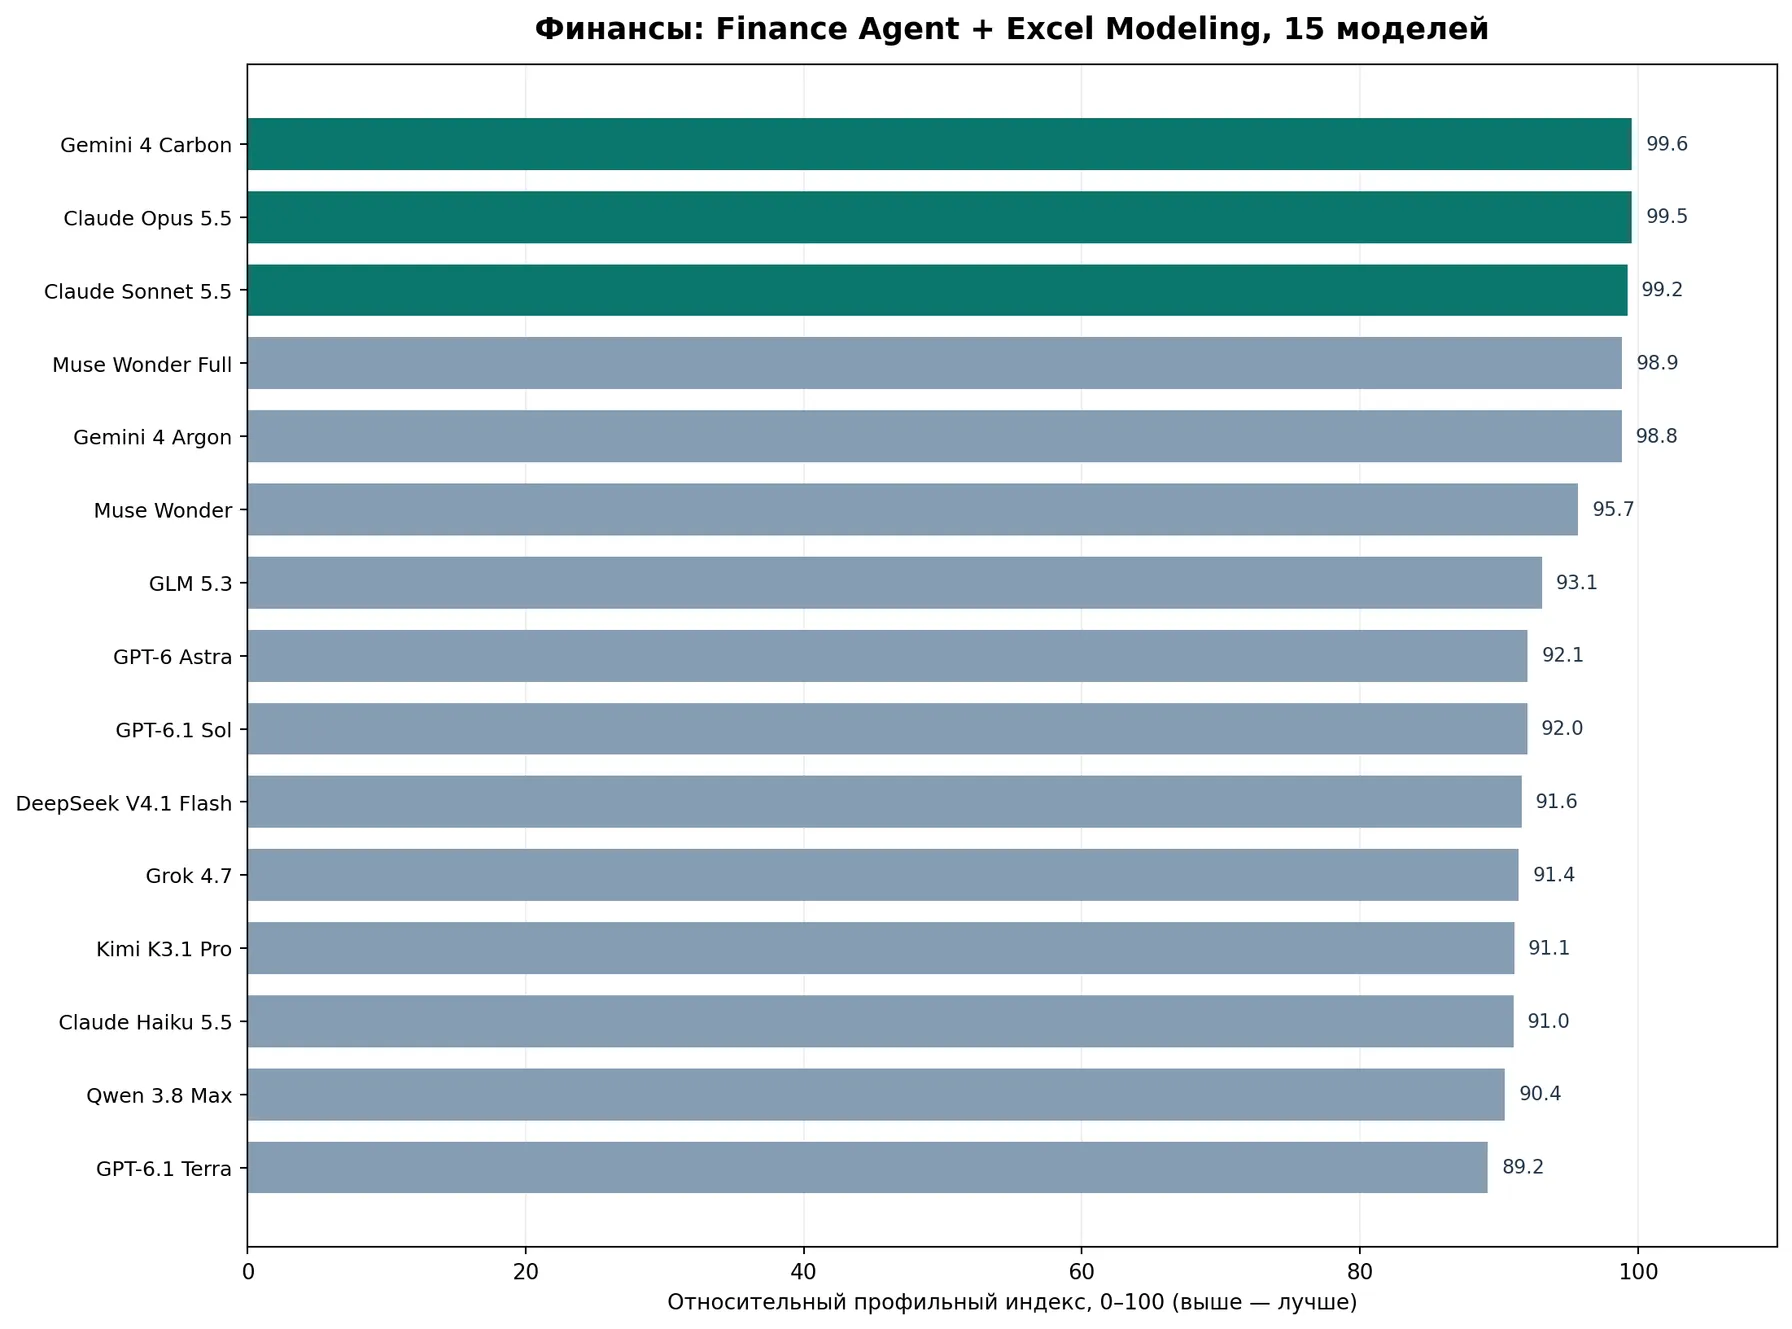
Три лидера имеют почти одинаковую оценку: Gemini 4 Carbon — 99,56; Claude Opus 5.5 — 99,54; Claude Sonnet 5.5 — 99,24. Разница между первым и вторым составляет всего 0,02 пункта нормированного индекса. Здесь некорректно объявлять Carbon убедительным победителем: при исключении одного из двух тестов лидер может измениться.
Для финансового анализа и Excel разумнее проверять два-три финалиста на конкретных файлах, формулах и требованиях. Tax Agent Bench вынесен в раздел права и налогов, чтобы не приравнивать налоговые юридические задания к моделированию в Excel.
Право и налоги
По Legal Research, HLAB-Vals-1.1 и Tax Agent Bench на 15 моделях лидирует Gemini 4 Argon — 94,8, далее Muse Wonder Full — 88,2 и Gemini 4 Carbon — 88,2. Argon выигрывает благодаря очень сильному HLAB (27,1), но её первое место не сохраняется при исключении каждого теста. Кроме того, юридические тесты не доказывают точность работы с законодательством любой конкретной страны — для российского права необходима отдельная проверка.
Агенты и автоматизация
По двум категориям LiveBench Agentic + Browser Use, для 13 моделей, лидируют GPT-6 Astra — 98,7, Claude Fable 5.1 — 98,1, Claude Opus 5.5 — 94,1 и GPT-6.1 Sol — 94,1. Разрыв Astra и Fable невелик. Более того, при исключении одного из двух компонентов победитель меняется в обоих случаях — единый лидер агентных задач неустойчив.
В отдельном наборе из пяти моделей OSWorld + AutomationBench [Zapier] лидирует Gemini 4 Carbon — 96,7, далее Argon — 90,4 и Opus — 89,4. Эти тесты отражают другую агентную нагрузку. Нельзя приравнивать их к Agent Arena Net Improvement или объявлять общим победителем суммированием всех агрегатов.
Математика, логика и научные задачи
По ARC-AGI-2 + LiveBench Reasoning удалось сравнить девять моделей с фактическими результатами обоих тестов: GPT-6 Astra — 98,7, GPT-6.1 Sol — 98,3, Gemini 4 Argon — 98,1, Claude Opus 5.5 — 97,6. Разрыв невелик, поэтому говорить о безусловном превосходстве Astra нельзя. В отдельном ARC-AGI-2 (10 фактических результатов) Astra имеет 95,0%, Sol — 94,2%, Opus — 93,3%.
В научно-математическом сравнении Terminal-Bench-Science + RiemannBench на пяти моделях лидирует Gemini 4 Carbon — 100,0, затем Astra — 93,8 и Opus — 89,0. Это не полноценный рейтинг всех научных компетенций: отдельных подтверждённых значений HLE-Diamond и CritPt v2 Hard в нашей матрице нет.
Исследования, анализ данных, дизайн и изображения
Здесь шире покрытие отдельных категорий LiveBench (по 13 моделей), но независимых компонентов недостаточно для серьёзного составного индекса:
- Исследования (LiveBench Research): Muse Wonder — 88,0; Grok 4.7 — 86,4; Astra — 85,2. Эти значения — исходные баллы теста.
- Анализ данных (LiveBench Data Analysis): Gemini 4 Argon — 85,2; Astra — 83,0; Sol — 82,7.
- Дизайн (LiveBench Design): Opus — 86,9; Sonnet — 85,0; Fable — 83,4.
- Визуальные задачи (Chartography + Blueprint-Bench 2): на пяти моделях лидирует Carbon — 100,0 по относительному индексу, затем Argon — 95,8 и Astra — 91,4.
Работа с изображениями, проектирование интерфейсов и визуальное понимание документов — разные типы задач; не следует считать эти цифры одним общим рейтингом «мультимодальности».
Длинный контекст и документы
По GraphWalks 256k–1M F1 доступны пять моделей: Carbon — 96,2 в исходных баллах, Argon — 84,2, Astra — 71,8, Opus — 66,8. Но это узкий тест длинного контекста, а не оценка любых задач по документам. AA-Briefcase и GDP.pdf в нашей базе не содержат подтверждённых отдельных баллов, поэтому общего индекса работы с документами пока нет.
Кибербезопасность
На четырёх моделях с результатами CWE-bench и ExploitGym лидирует Carbon — 100,0 по профильному индексу, далее Astra — 86,6 и Argon — 86,2. У SEC-bench Pro есть данные только для трёх моделей, поэтому этот тест не включён в общий расчёт, чтобы не менять выборку участников. Оценка отражает выполнение тестовых задач, а не гарантированную надёжность или безопасность продукта.
Медицина: недостаточно данных
Отдельный медицинский рейтинг по нашей матрице построить нельзя. Подтверждённых баллов профильных медицинских тестов для сопоставления двадцатки здесь нет. Общий интеллект, результаты исследований или умение работать с текстом не заменяют проверки медицинской точности. Для клинических сценариев требуется проверка квалифицированным специалистом.
Радарная диаграмма специализаций: Opus, Astra, Carbon, DeepSeek
На диаграмме сопоставлены четыре модели по семи направлениям: программирование, финансы, право и налоги, наука и математика, рассуждение, анализ данных, дизайн. Для программирования использован новый нормированный индекс AA + Vals + Arena, для остальных направлений — ранее рассчитанные профильные индексы.
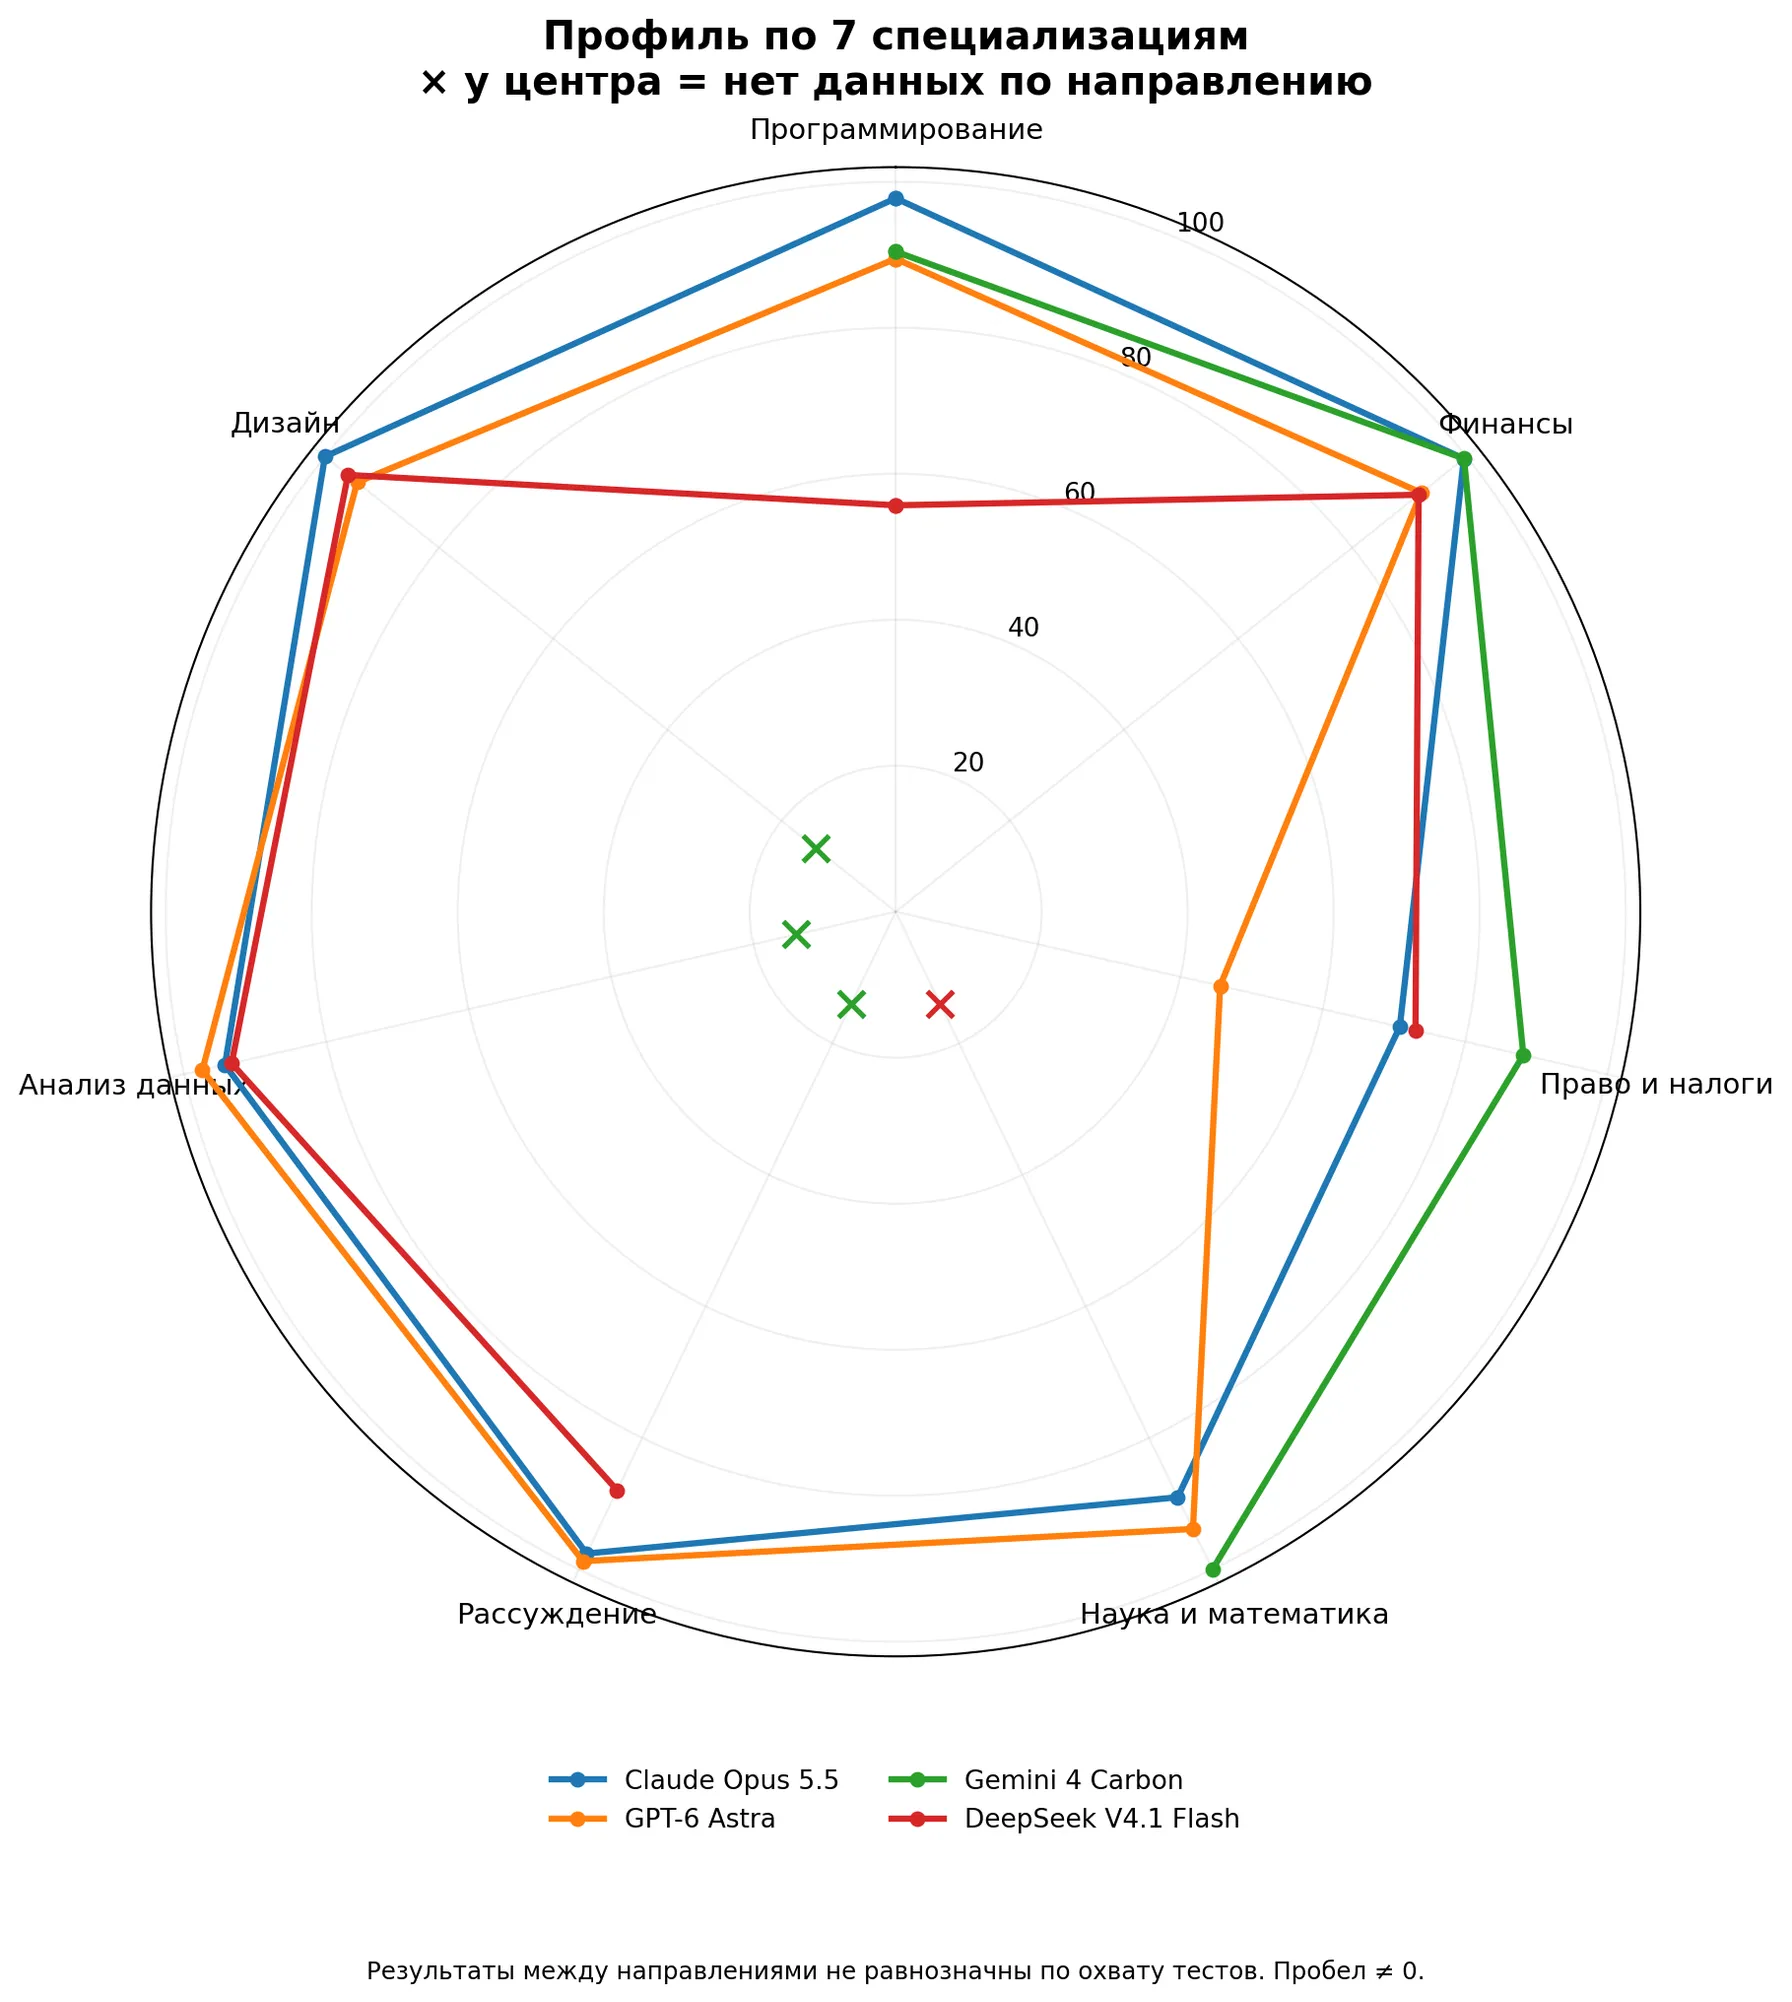
Что видно: Opus лидирует среди этих четырёх по программированию (97,74) и дизайну (100); Carbon практически равна Opus по финансам (99,56 против 99,54) и сильнее по текущему небольшому набору научно-математических тестов. Astra показывает высокий результат в рассуждениях (98,74) и анализе данных (97,42). DeepSeek значительно уступает этой группе по программированию (55,68), но её результаты в некоторых других доступных категориях заметно ближе к лидерам.
Оговорка о пропусках: у Carbon нет измерений по рассуждениям, анализу данных и дизайну в использованных панелях, а у DeepSeek — по научно-математической паре. Разрыв линии и цветной крестик «×» возле центра соответствующей оси обозначают отсутствие измерения, а не нулевую оценку. Даже после унификации программирования оси опираются на разное количество моделей и профильных тестов, поэтому площадь многоугольника нельзя считать общим рейтингом специализаций.
Что показал анализ устойчивости
Надёжнее всего подтверждены лидеры внутри согласованных наборов: Sonnet в программировании Vals сохраняет первое место после удаления любого из трёх тестов; Carbon сохраняет лидерство в небольших панелях науки, визуальных задач и кибербезопасности при исключении одного компонента.
Менее уверенные победители: Astra в агентных задачах LiveBench (лидер меняется в зависимости от теста) и Carbon в финансах: между Carbon (99,56) и Opus (99,54) всего 0,02 пункта относительного индекса. Такую разницу нельзя считать доказательством лидерства. Аналогично Carbon (90,43) и Astra (89,46) в программировании разделяет меньше балла и при исключении Terminal-Bench их места меняются. Для направлений с одним тестом проверка исключением теста невозможна.
Главное ограничение: модели с неполными данными исключаются только из той профильной панели, где отсутствует обязательный результат, а не штрафуются нулём. Gemini 3.8 Flash, MiniMax M3.1 Flash и Step 5 Preview уже входят в обновлённый рейтинг программирования всех 20 моделей, поскольку позже были добавлены данные AA. При этом во многих других узких направлениях у них по-прежнему нет достаточного покрытия. Отсутствие измерений не свидетельствует о слабости модели.
Как выбрать нейросеть под свои задачи: качество, скорость, цена и комбинации моделей
Главный принцип: сначала определить необходимое качество и специализацию, а уже затем оптимизировать цену и скорость. Наше исследование даёт для этого три разных ориентира: общий GPTunneL Intelligence Index (широта способностей), профильные рейтинги (результаты на заданиях конкретного типа) и индекс эффективности p = 3 (расчётный компромисс интеллекта, стоимости и времени). Ни один из них не заменяет остальные. Полные исходные расчёты программирования и профильных рейтингов доступны в Excel с обновлёнными индексами.
Например, Claude Opus 5.5 лидирует по общему интеллекту (97,21) и новому индексу программирования (97,74). Gemini 4 Carbon близка к нему по общему интеллекту (94,89), занимает третье место в программировании (90,43) и имеет более высокий индекс экономической эффективности (141,5 против 100 у Opus). Для массовых задач наиболее выгодными по выбранной формуле p = 3 оказались GPT-6.1 Terra (234,0), GPT-6.1 Sol (224,5) и DeepSeek V4.1 Flash (211,5). Но DeepSeek заметно отстаёт от сильных моделей в программировании (55,68): дешёвая модель не обязательно подходит для сложной работы.
Быстрый выбор: какую модель нейросети использовать в разных ситуациях
| Тип задачи | С каких моделей начать | Основание и нюансы выбора |
|---|---|---|
| Повседневный чат, тексты и универсальные запросы | GPT-6.1 Sol, GPT-6.1 Terra | Sol интеллектуальнее (83,88 против 77,83) и сильнее в программировании (83,72 против 71,01). Terra немного выше по совокупной эффективности p = 3 (234,0 против 224,5). |
| Максимальная сложность и дорогая ошибка | Claude Opus 5.5, Gemini 4 Carbon | Лидеры общего индекса (97,21 и 94,89). Для очень сложных случаев нужно сравнение ответов и фактическая проверка, а не только рейтинг. |
| Высокое качество с более рациональными расходами | Gemini 4 Carbon, GPT-6 Astra | Эффективность p = 3: Carbon — 141,5, Astra — 121,4, Opus — 100. В расширенной экономической таблице у Carbon есть прогнозные показатели: не смешивайте их с расчётом p = 3. |
| Программирование, рефакторинг, разработка интерфейсов | Opus, Sonnet 5.5, Carbon, Astra | Новый общий кодовый индекс по AA + Vals + Arena: 97,74 / 91,56 / 90,43 / 89,46. Carbon и Astra разделяет менее 1 балла; на практике важен тип репозитория и тестов. |
| Быстрые массовые операции, категоризация, черновики | DeepSeek V4.1 Flash, Terra | Эффективность 211,5 и 234,0. Для задач с точным форматом используйте автоматическую проверку; сложные запросы передавайте более сильной модели. |
| Сложная логика и ARC-подобные задания | GPT-6 Astra, GPT-6.1 Sol, Gemini 4 Argon, Opus | Сводный индекс ARC-AGI-2 + LiveBench Reasoning на 9 моделях: 98,74 / 98,26 / 98,05 / 97,58. Очень небольшие различия не доказывают универсального лидерства. |
| Наука, технические и математические исследования | Gemini 4 Carbon, Astra, Opus | Carbon — 100 в сравнении Terminal-Bench-Science + RiemannBench, но там всего 5 моделей. Для научного обзора обязательно проверяйте источники и расчёты. |
| Финансовая аналитика и Excel | Carbon, Opus, Sonnet 5.5 | Finance Agent + Excel Modeling: 99,56 / 99,54 / 99,24. Это практически ничья; выбирайте по стоимости, времени и качеству на ваших файлах. |
| Право, договоры и налоговые задачи | Gemini 4 Argon, Muse Wonder Full, Carbon | Legal Research + HLAB + Tax Agent: 94,77 / 88,23 / 88,19 (15 моделей). Для российского права и актуальных норм требуется отдельная юридическая проверка. |
| Анализ данных и таблиц | Gemini 4 Argon, Astra, Sol | В LiveBench Data Analysis лидируют Argon, Astra и Sol (относительные индексы 100 / 97,42 / 97,07). Это один тест, а не подтверждение качества любой аналитики. |
| Агенты, браузер и работа с инструментами | Astra, Claude Fable 5.1, Opus, Carbon | В LiveBench Agentic + Browser Use впереди Astra и Fable; в OSWorld + Zapier — Carbon; в Agent Arena — Opus. Универсального лидера нет, выбирайте под конкретную среду. |
| Дизайн интерфейсов | Opus, Sonnet 5.5, Fable 5.1 | LiveBench Design: 100 / 97,81 / 95,97 по относительной шкале. Для вёрстки интерфейса дополнительно смотрите рейтинг программирования и результат в браузере. |
| Длинные документы и большой контекст | Carbon, Argon, Astra | На GraphWalks Carbon лидирует (исходные 96,2 F1), но сравнивались 5 моделей по одному тесту. Для реального документа проверяйте полноту извлечения и точность цитат. |
| Работа с диаграммами и чертежами | Carbon, Argon, Astra | Chartography + Blueprint-Bench 2: первая тройка на 5 моделях. Это про понимание визуальных данных, а не обязательно качество генерации изображений. |
| Кибербезопасность | Carbon, Astra, Argon | По CWE-bench + ExploitGym Carbon первая в маленькой выборке из 4 моделей; это не оценка защищённости продукта и не замена экспертной проверки. |
| Медицинские вопросы | Не выбирать лидера на основании этого исследования | Сопоставимых профильных медицинских результатов в матрице недостаточно. Для значимых медицинских решений необходима профессиональная проверка. |
Как читать таблицу: мы называем кандидатов для проверки, а не гарантированно лучшие модели в каждой жизненной ситуации. Программирование измерено на 20 моделях по пяти тестам; у финансов и права есть несколько заданий для 15 моделей; многие другие направления охватывают только 4–5 моделей или один тест. Отсутствие модели в узкой выборке не означает, что она слабее победителя.
Как выбирать между Opus, Carbon, Sonnet, Astra, Sol, Terra и DeepSeek
Claude Opus 5.5 — когда важнее получить максимально сильный результат. По нашему срезу это лидер общего индекса интеллекта (97,21), программирования (97,74), Arena WebDev и Agent Arena. Особенно разумно включать Opus для сложной архитектуры, затруднённых исправлений кода, многоступенчатых решений и финальной проверки важных материалов. При этом Opus = 100 по эффективности p = 3: отправлять ей поток простых вопросов экономически неоптимально, если более доступная модель выполняет их с нужным качеством.
Gemini 4 Carbon — альтернатива премиальному качеству. Общий интеллект 94,89 против 97,21 у Opus; эффективность 141,5; индекс программирования 90,43 против 97,74 у Opus и 91,56 у Sonnet. Carbon особенно интересна в технических исследованиях, работе с длинным контекстом и визуальных заданиях по имеющимся тестам. Но многие узкие лидерства получены на 4–5 моделях, поэтому для анализа документов, науки или права не стоит автоматически переносить их на любые задачи.
Claude Sonnet 5.5 — сильный профильный кандидат для программирования. Второе место в объединённом кодовом рейтинге (91,56), а в финансовых задачах — практически равенство с Opus и Carbon. Но в общем индексе эффективности p = 3 Sonnet имеет 72,2, то есть уступает Opus и многим более дешёвым моделям. Её стоит выбирать по результату конкретной профильной работы, а не из предположения, что Sonnet всегда экономичнее.
GPT-6 Astra — сложная логика, программирование и инструменты. Индекс программирования 89,46, общий интеллект 87,63, эффективность 121,4. Она возглавляет нашу узкую панель ARC + LiveBench Reasoning (98,74) и LiveBench Agentic + Browser Use (98,67). В долгой агентной работе выбирайте между Astra, Opus и Carbon по фактическому проценту успешных задач и времени выполнения, а не по одному агентному бенчмарку.
GPT-6.1 Sol — универсальный компромисс, когда задачи бывают разной сложности. Общий интеллект 83,88, программирование 83,72, эффективность 224,5. Она выглядит удачным первым выбором для чата с файлами, генерации и доработки текстов, анализа данных и повседневного кода. От Terra отличается более высоким интеллектом и кодовым индексом; именно поэтому в сценариях с частой неоднозначностью Sol может оказаться выгоднее по стоимости успешного результата, несмотря на чуть меньший E₃.
GPT-6.1 Terra — экономичный основной исполнитель. Индекс эффективности 234,0 (первое место), общий интеллект 77,83, программирование 71,01. Хороший кандидат для массовых структурированных запросов, первичной обработки документов, простых преобразований кода и черновых ответов. Когда нужна высокая надёжность рассуждения, обязателен контроль качества или передача задачи Sol, Carbon либо Opus.
DeepSeek V4.1 Flash — в первую очередь для задач с низкой ценой ошибки. Эффективность 211,5, но общий интеллект 64,28, а программирование 55,68. Может быть выгодна для тегирования, фильтрации, извлечения простых полей, набросков и первоначальной маршрутизации. Использовать её как единственного исполнителя сложного кода или ответственного анализа только из-за высокого E₃ было бы ошибкой.
Когда стоит платить больше за интеллект
Цена отдельного запроса — не то же самое, что стоимость успешного решения. Дешёвая модель может потребовать больше повторных запусков, проверок и исправлений. Дорогая может окупиться, если заметно чаще справляется с задачей с первого раза.
- Высокая цена ошибки: сложное программирование, финансовые модели, правовые выводы, ответственные отчёты. Здесь допустимы дополнительные расходы на сильную модель, независимую проверку и, при необходимости, человека.
- Средняя цена ошибки: статьи, аналитические заметки, длинные ответы, презентации. Начните с Sol или Carbon, передавайте сложные фрагменты Opus или профильному лидеру и проверяйте факты.
- Низкая цена ошибки: черновики, классификация, извлечение простых полей, шаблонные ответы. Начните с Terra или DeepSeek и используйте автоматические правила проверки.
При этом эффективность p = 3 нельзя трактовать как вероятность успеха. Её формула использует куб общего индекса интеллекта и измеренные расходы/время AA + Vals для 18 моделей. А отдельные столбцы расширенной стоимости (4 источника) и времени (3 источника) содержат прогнозы и не являются прямыми входами E₃. Для узких задач — например, программирования — лучше сначала проверить специализированный индекс, а уже затем экономику.
Когда выгоднее комбинировать модели
В чат-сервисе и API маршрутизация обычно практичнее, чем использование самой мощной модели для каждого запроса. Причём задача не обязательно должна проходить все уровни: очевидно сложный запрос выгоднее сразу направить сильной модели, иначе дешёвый предварительный вызов лишь добавит стоимость и задержку.
Сценарий 1. Массовый чат и автоматизация:
- Terra или DeepSeek обрабатывает типовые запросы с понятными условиями и проверяемым форматом.
- Sol получает неоднозначные вопросы, многошаговые инструкции, запросы с несколькими документами и ошибки первого уровня.
- Carbon или Opus решает наиболее сложные случаи, проводит адресную проверку спорных выводов или работает с запросами, где цена ошибки высока.
- На каждом уровне проверяются требования к формату, факты, доступность источников и условия завершения, а не только субъективная «уверенность» самой модели.
Сценарий 2. Разработка ПО: для небольших изменений можно начать с Sol или Terra; для рефакторинга, сложных ошибок и архитектуры — с Sonnet, Carbon, Astra или Opus. При затруднении полезен другой сильный исполнитель с альтернативным решением. Но основная проверка — это сборка, тесты, линтер, дифф и ревью, а не согласие двух моделей. Разница Carbon (90,43) и Astra (89,46) по нашему кодовому индексу невелика: выбирать между ними лучше на своём репозитории.
Сценарий 3. Финансы и документы: Terra извлекает поля и собирает структуру, Carbon/Opus/Sonnet анализирует расчёты или строит финансовую модель, а формулы и цитаты проверяются программно и по исходному документу. По Finance Agent + Excel Modeling лидирующая тройка практически равна, поэтому выгоднее A/B-тестировать качество на своих таблицах, чем выбирать победителя по сотым долям балла.
Сценарий 4. Агенты: сначала определите среду — браузер, компьютер, API-инструменты или автономная цепочка шагов. Astra и Fable сильны в нашем срезе LiveBench Agentic/Browser, Carbon лидирует в маленьком OSWorld/Zapier-сравнении, Opus — в Agent Arena. Проверяйте не только конечный ответ, но и долю завершённых сценариев, число шагов, повторные попытки и тайм-ауты.
Когда запускать две модели параллельно? Если время особенно критично или полезны независимые гипотезы (сложное проектирование, поиск ошибок, многоступенчатая аналитика), можно одновременно запросить два решения. При обычной работе параллельный запуск часто означает почти двойные расходы без сопоставимого роста качества. Проверка другой моделью помогает находить ошибки, но не гарантирует независимость: обе системы могут повторить одно и то же неверное предположение.
Как понять, какая комбинация действительно дешевле
Проведите небольшой сравнительный эксперимент на реальных задачах вашего продукта, а не только на общих бенчмарках. Разделите поток на типовые, средние, сложные и критичные задания. Для каждого сценария сравните: одну универсальную модель, один дешёвый исполнитель и каскад с эскалацией.
Главный показатель — полная стоимость одного успешно выполненного задания:
Стоимость успешной задачи = (все расходы на генерации + проверки + инструменты + повторные попытки) / число успешно завершённых задач.
Дополнительно учитывайте долю успеха с первого раза, частоту эскалаций, ошибки после проверки, медианное время и p95 задержки. По итогам оставляйте модель на самом дешёвом уровне, который проходит заданный порог качества. Если каскад редко срабатывает с первой попытки или почти всегда передаёт задачи Opus, отдельный дешёвый этап может быть лишним.
Полезно вести матрицу маршрутизации по типу запроса: классификация / извлечение / текст / код / финансы / документы / агентные задачи. Сохраняйте для каждой категории частоту, нужное качество, стоимость успешного задания и наиболее удачную модель. Так собственная статистика постепенно заменит предположения, основанные на агрегированных рейтингах.
Как проверить рекомендации на собственных задачах
Для решения о рабочей модели достаточно начать с 10–30 типичных запросов каждого важного класса, заранее зафиксировав критерии успешности и допустимое время. В чате GPTunneL сравните одинаковый запрос и при необходимости одни и те же файлы у двух-трёх кандидатов; для API сохраните ответы, стоимость и длительность полных сценариев. При сравнении кода используйте тесты, финансовых документов — сверку чисел и формул, фактов — ссылки на первоисточники.
Проводите сравнение не только на простых, но и на пограничных запросах, которые требуют эскалации. Побеждает не модель с наибольшим местом в нашем рейтинге, а та, что проходит ваш порог качества с наименьшими суммарными затратами. Для первых экспериментов удобно сравнить Opus, Carbon, Sol и Terra в GPTunneL, а для узких задач добавить Sonnet, Astra или DeepSeek.
Итог: какую стратегию выбрать
Нужно максимальное качество: Opus как универсальный сильный кандидат, Carbon как близкая альтернатива; для программирования не забывайте Sonnet и Astra, а для отдельных профильных задач — подтверждённых лидеров соответствующих тестов.
Нужна одна основная модель для большинства запросов: начните с Sol. Если задачи чаще простые и особенно важны расходы — протестируйте Terra. Для сложных случаев настройте переход на Carbon или Opus.
Нужно обрабатывать большой поток через API: используйте Terra/DeepSeek для типового, Sol для неоднозначного, Carbon/Opus или профильную модель для сложного. Отбирайте вариант по стоимости успешного решения, а не по самому высокому баллу p = 3.
Ограничения исследования: общий индекс интеллекта частично использует восстановленные значения; эффективность p = 3 рассчитана на 18 моделях с фактическими экономическими данными AA + Vals; профильные рейтинги имеют разные объёмы выборок и не всегда проверены независимыми источниками. Приведённые модели — обоснованные кандидаты для тестирования, а не гарантированно оптимальный выбор в любой конкретной задаче.
Часто задаваемые вопросы
Какая нейросеть самая умная в 2026 году? В зафиксированном сводном рейтинге GPTunneL первое место у Claude Opus 5.5 (97,21), второе у Gemini 4 Carbon (94,89). Это вычисленный порядок по восьми источникам, часть баллов восстановлена; статистически доказанного универсального превосходства нет.
Что выбрать: Opus или Carbon? По нашему индексу Opus немного выше и лидирует в общем программировании, Carbon близка по интеллекту и эффективнее по экономико-временной формуле p = 3. Выберите несколько собственных задач, где важны ошибки, и сравните стоимость полного успешного решения.
Какую модель лучше использовать для программирования? По обновлённому индексу пяти тестов AA, Vals и Arena: Opus 97,74, Sonnet 91,56, Carbon 90,43, Astra 89,46. Carbon и Astra могут меняться местами при исключении Terminal-Bench, поэтому тестируйте на конкретном репозитории.
Sol или Terra для повседневного чата и API? Sol умнее по общему индексу (83,88 против 77,83), Terra чуть эффективнее по p = 3 (234,0 против 224,5). Для неоднозначных задач разумно начать с Sol, для массовой рутинной обработки — с Terra при проверяемом качестве.
Почему DeepSeek так высоко по эффективности, но ниже в программировании? Экономический индекс учитывает стоимость и время наряду с интеллектом, а профильный кодовый индекс — фактические задания программирования. Высокая экономичность не заменяет минимально допустимое качество для вашего типа задач.
Почему рейтинги бенчмарков дают разные ответы? Они оценивают разные способности, выборки и среды: предпочтение пользователей, программирование, профессиональные задачи, рассуждение или работу агентных инструментов. Итог зависит и от нормализации и весов.
Почему самая дорогая модель не всегда самая выгодная? Цена задачи, число повторных вызовов, успешность, длина ответа и время могут компенсировать цену токена. Сравнивайте полную стоимость успешной задачи, а не отдельный вызов.
Можно ли доверять прогнозным оценкам? Прогноз помогает заполнить аналитические пробелы, но не является официально измеренным результатом; поэтому в таблицах исходных бенчмарков отсутствующие значения обозначены «Нет данных».
Почему у некоторых моделей нет места в рейтинге медицины или дизайна? Если по направлению нет сопоставимых результатов, модель не получает ноль: она не участвует в соответствующей профильной панели. Срез данных ограничен, даже если модель представлена в других рейтингах.
Как практически сравнить две модели в GPTunneL? Отберите одинаковые запросы и документы, оцените качество по проверяемым критериям и посчитайте затраты и время до успешного результата. Для повторяющихся API-задач сохраняйте результаты и настройте маршрутизацию по порогу качества.
Методология, ограничения и источники
Даты и версии: исходный интеллектуальный и экономический срез — 3 ноября 2026 года (отдельные источники имеют собственные даты в разделе стоимости). Дополнение профильных результатов AA и новая редакция статьи — 5 ноября 2026 года. Это дата актуализации исследования, а не обещание, что все сайты бенчмарков одновременно обновлены. Таблица рассчитана на основании сохранённой рабочей выгрузки GPTunneL; сайты организаций могут показывать более свежие результаты. Опубликованные оценки и режимы рассуждения нужно обновлять согласованно, а не заменять отдельные числа из другого выпуска.
Не считать дважды: составные рейтинги Artificial Analysis и Vals содержат собственные бенчмарки, среди которых встречается Terminal-Bench. Наш общий индекс пока объединяет сами агрегаты и поэтому не устраняет весь коррелированный вклад. Для специализированных рейтингов отдельно требуется контролировать повторение заданий.
Прогнозы: если подтверждённого результата нет, в публичной таблице стоит «Нет данных». Для расчёта индекса GPTunneL используется историческая экстраполяция при наличии предыдущих версий того же индекса; в прочих случаях — прогноз по ближайшим моделям (kNN) и, где необходимо, приблизительное восстановление исходной шкалы из старых ранговых оценок. Прогноз не является официальным баллом бенчмарка и не должен использоваться для сравнения исходных оценок. Качество некоторых вариантов переноса оценивалось методом leave-one-out на известных результатах (см. раздел корреляций), однако это не полная проверка всей многоэтапной процедуры восстановления восьми бенчмарков и итоговых мест. Поэтому восстановленные значения остаются исследовательскими оценками, а не подтверждёнными фактами.
Основные первоисточники:
- Artificial Analysis — рейтинг
- Artificial Analysis — методология
- Vals Index v2.2
- LiveBench 2.0
- Arena Text
- Arena WebDev
- Agent Arena
- ARC Prize
- StealthMark
Как интерпретировать ограничения исследования. Все сравнительные показатели здесь привязаны к определённым версиям моделей, датам и типам задач. Измерено — результат опубликованного испытания; восстановлено/прогноз — исследовательская оценка без статуса официального измерения; нет данных — сравнительная оценка отсутствует. Для частных сценариев проверяйте качество непосредственно на вашей нагрузке. Числовая близость индексов не является доказательством статистической эквивалентности или превосходства.
Как отобраны 20 моделей. Это фиксированная исследовательская подборка, а не случайная или репрезентативная выборка всего рынка. В сохранившейся методике не документирован формальный алгоритм первичного отбора двадцатки; поэтому мы не утверждаем, что отбирали модели строго по популярности, выручке, числу бенчмарков или доступности API. Учитывайте, что смена списка участников повлияет на Min-Max и рейтинг.
Рассчитанная чувствительность: Excel с исключением восьми бенчмарков и сравнением p = 2/3/4.