
19 ноября на новом Frontier Design Benchmark появилась загадочная модель Gestalt. В слепых сравнениях сайтов, созданных по клиентским заданиям, она набрала 1931 Elo. Для сравнения, у Claude Fable 5.2 - 1713, у профессиональных дизайнеров - 1739. Неожиданно и то, что сайты Gestalt практически не выдают характерных визуальных приёмов нейросетей.
Сообщение быстро обросло предположениями о разработчике. В китайском сегменте X заговорили о GLM-5.5 от Z.ai. Однако пока обнаружено подтверждение лидерства Gestalt в одном специализированном тесте по дизайну, а её происхождение остаётся нераскрытым. Более того, появилось публичное заявление, противоречащее китайской версии.
Что показала Gestalt
По текущему рейтингу Contra Labs, Gestalt выигрывает 90% оцениваемых парных сравнений с различными участниками теста. У Claude Fable 5.2 этот показатель составляет 73%, у эталонных работ дизайнеров - 74%. Разница между Gestalt и Fable достигает 218 пунктов Elo. На следующем месте среди известных нейросетей находится Claude Opus 5.5 с 1691 Elo.
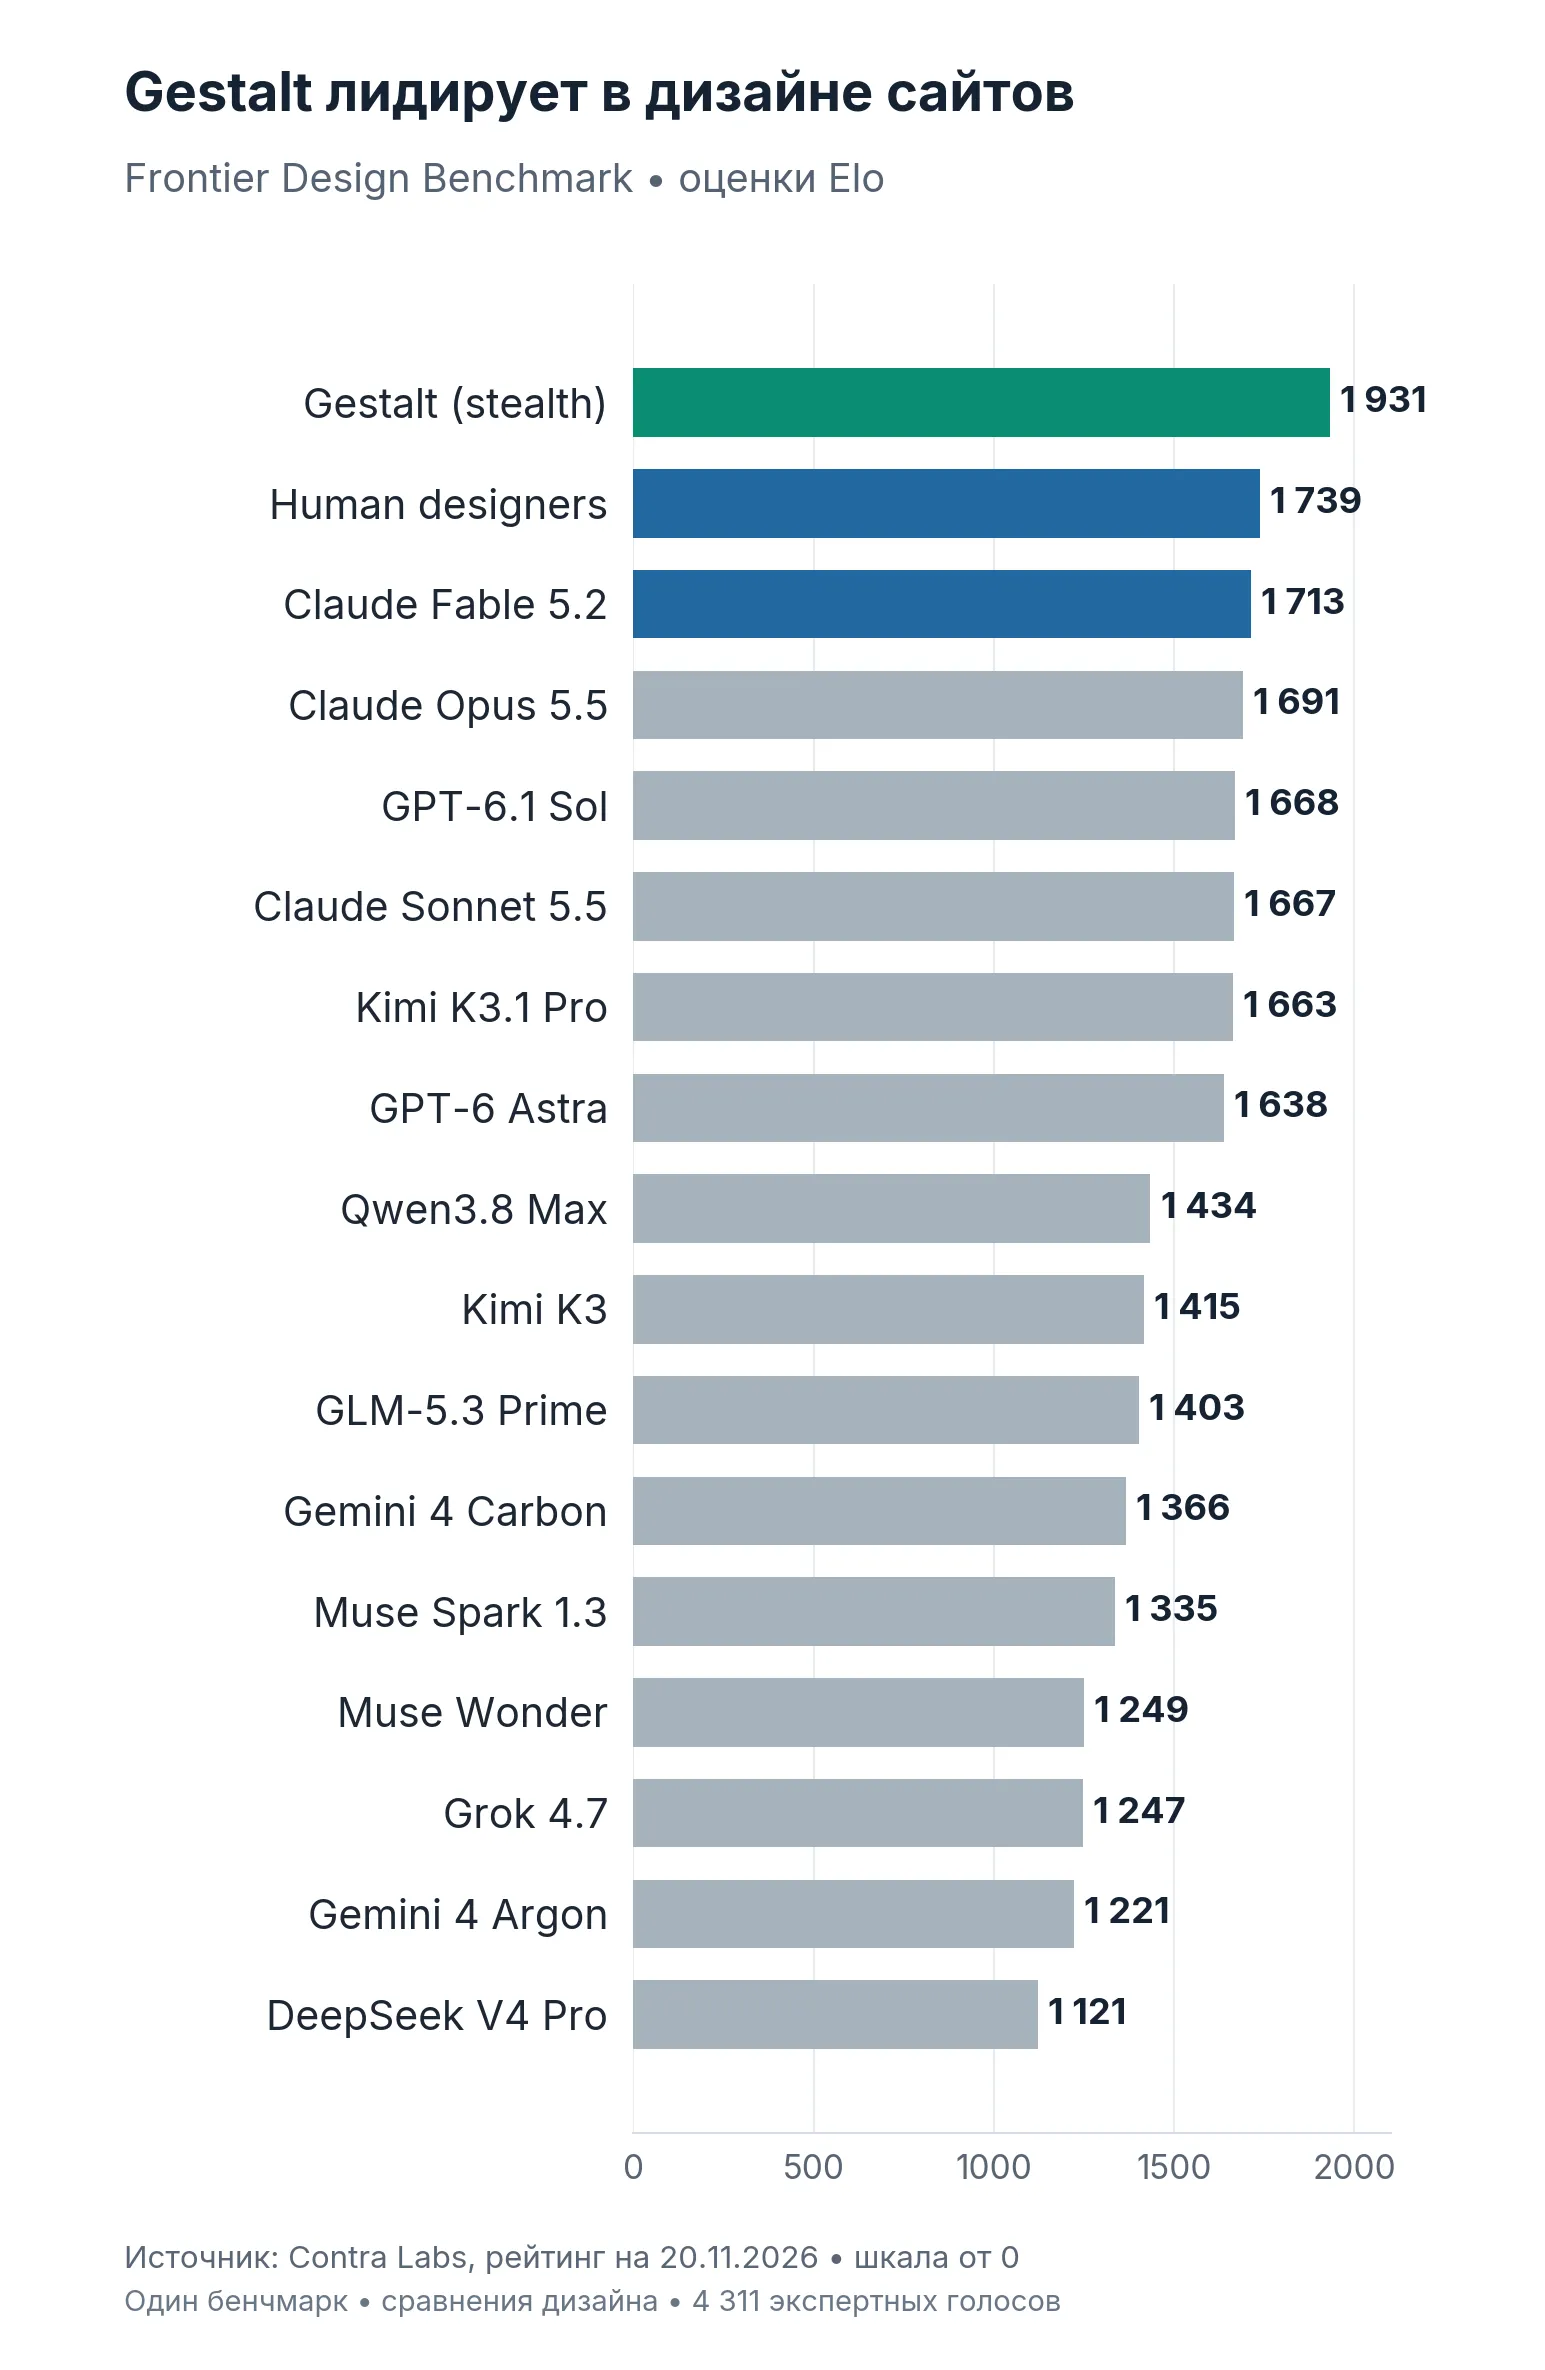
График 1. Все 17 участников Frontier Design Benchmark. Источник: Contra Labs, данные на 20 ноября 2026 года.
Важно понимать, что 90% - общая доля побед Gestalt против разных соперников, а не вероятность победить Fable в личной дуэли. Отдельной публичной таблицы очных результатов Gestalt против Claude Fable 5.2 организаторы не предоставили. В исследовательской публикации есть другое конкретное сравнение: профессионалы предпочли сайт Gestalt человеческому эталону 20 раз из 28.
Показатели слегка меняются по мере обновления рейтинга. В первоначальной статье организаторов фигурируют 1928 Elo для Gestalt и 1714 для Fable, а в актуальном лидерборде - 1931 и 1713 соответственно.
Что такое Frontier Design Benchmark и как его проводили
Бенчмарк запустили Contra Labs и BenchFlow. Организаторы проанализировали примерно 4600 заказов на разработку сайтов из сети Contra и подготовили 33 задания. Из них 27 основаны на реальных заказах, переработанных для вымышленных клиентов, а ещё шесть получены от партнёров. Текущая публичная таблица отдельно помечена как рейтинг по 27 заданиям Contra.
Это сложнее типичной просьбы «сделай красивый лендинг». Модели получают сведения о бренде, целевой аудитории и пользовательских сценариях; в части заданий есть логотипы, исходные материалы, требования к мобильной версии, доступности и работе интерфейса. Среди примеров - многостраничный сайт для компании по кибербезопасности, приложение для сбора пожертвований и образовательный сервис с тестами.
Агенты собирают работающие сайты в изолированной среде. Далее профессиональные дизайнеры вслепую выбирают лучший из двух результатов и могут объяснить, почему предпочли его. В описании методики указаны 35 дизайнеров-оценщиков, 4311 голосов и пять раундов. Рейтинг вычисляют на основе парных предпочтений по модели Брэдли - Терри и выражают в шкале Elo. При случайном разделении экспертов на две группы сходство ранжирований было высоким: коэффициент Спирмена 0,95.
Но есть и существенное ограничение: полный набор заданий, ответов и голосований закрыт и доступен исследователям по запросу. Кроме того, в тесте используются агентные окружения разных разработчиков. Итоговая оценка отражает работу всей конфигурации, включая инструменты и организацию выполнения задачи.
Почему Gestalt может быть интереснее простого лидерства в Elo
В исследовании есть две дополнительные оценки. Первая, Design Critique Rubric, проверяет результат по 35 дизайнерским критериям: композиции, типографике, контрасту, структуре, удобству и другим характеристикам.
Здесь картина меняется. Claude Fable 5.2 и Claude Opus 5.5 получают по 84 балла, Gestalt - 83. Значит, лидерство Gestalt в предпочтениях профессионалов нельзя объяснить только отсутствием формальных ошибок. Экспертам в целом больше нравится её результат, хотя отдельные правила дизайна конкуренты соблюдают чуть лучше.
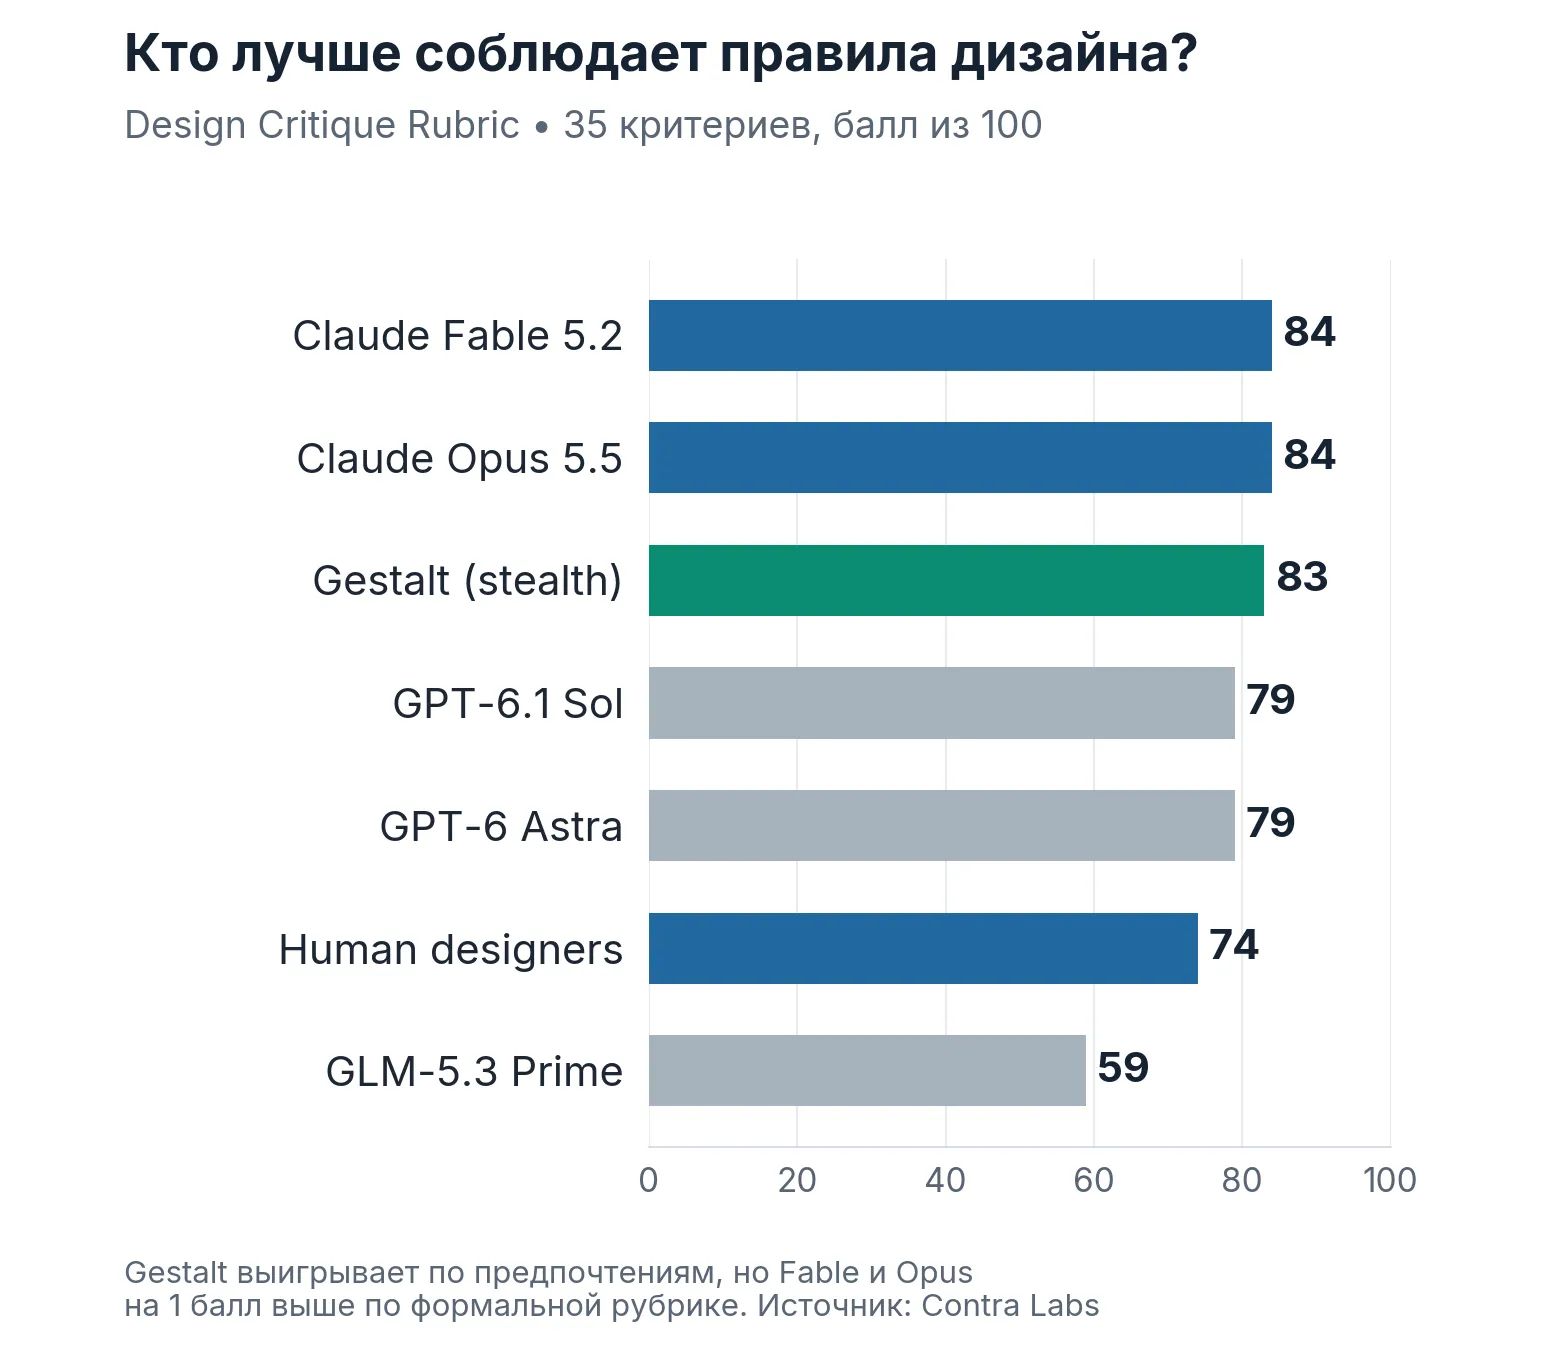
График 2. Результаты проверки по дизайнерским критериям.
Вторая оценка, Slop Detector, измеряет узнаваемость типичного нейросетевого стиля. Чем ниже значение, тем меньше таких признаков. У человеческих работ показатель около 0,9, у Gestalt - 1,2, у Fable 5.2 - 31, у GPT-6 Astra - 41, у Gemini 4 Carbon - 54.
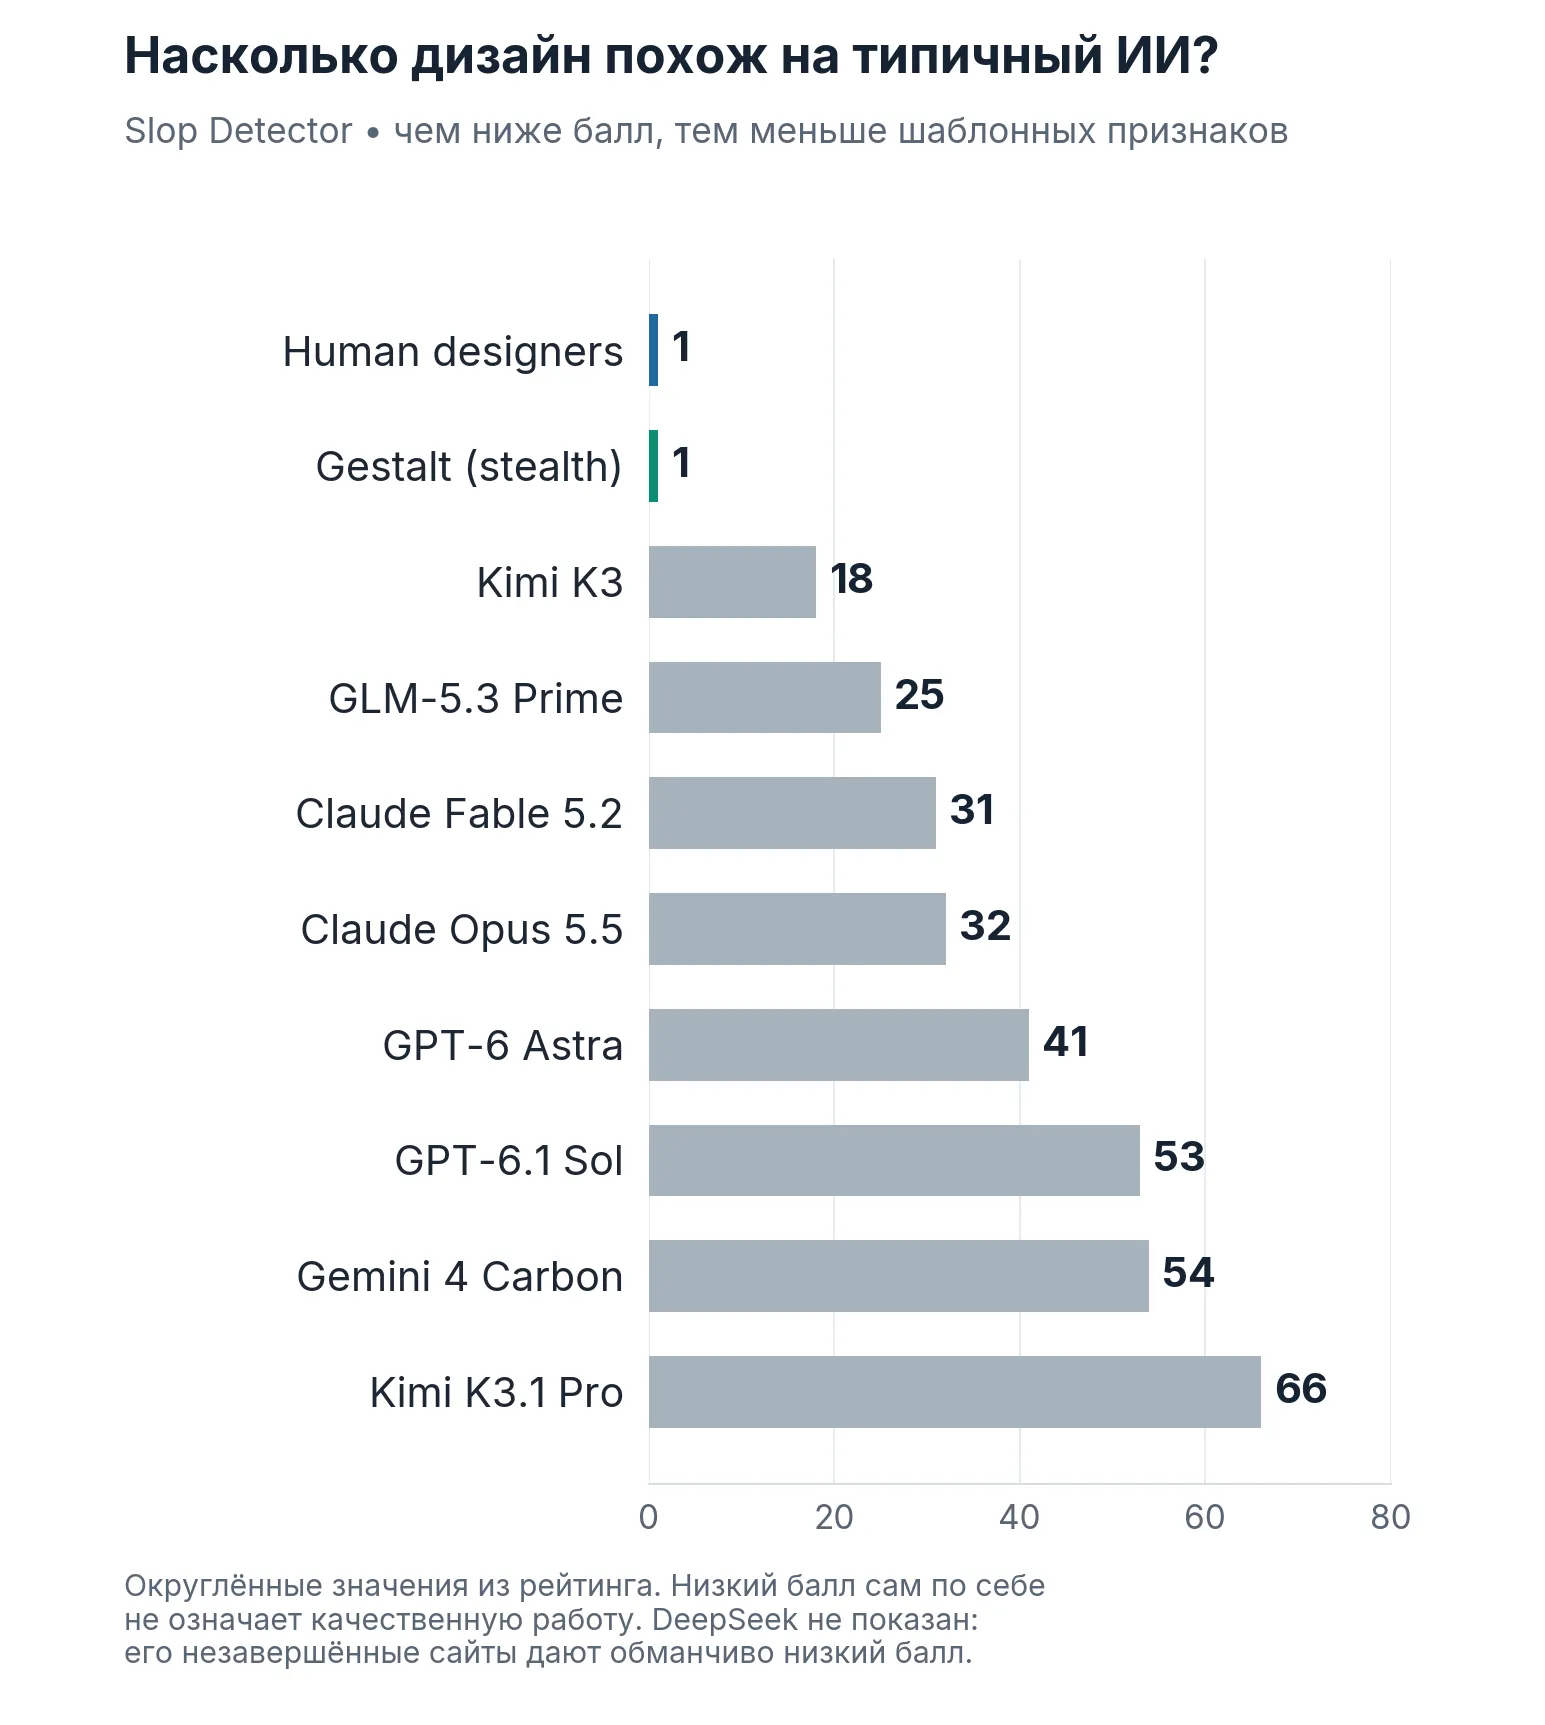
График 3. Округлённые результаты Slop Detector из официальной таблицы.
Команда Contra приводит и узнаваемые особенности других моделей: Claude часто размещает горизонтальные стрелки на кнопках, GPT - диагональные, Gemini злоупотребляет карточками и техническими подписями. Gestalt в этой проверке выглядит необычно «человечно».
При этом низкое значение Slop Detector само по себе не доказывает качество. У DeepSeek V4 Pro показатель тоже близок к единице, поскольку часть её сайтов оказалась незавершённой: детектор не узнаёт привычный ИИ-дизайн там, где работа практически не выполнена.
Откуда появилась версия о GLM-5.5
20 ноября автор X-аккаунта @mylesBaiM заявил, что Gestalt якобы является GLM-5.5. Его доводы: китайская GLM уже показывала выдающиеся результаты в веб-дизайне, после GLM-5.3 прошло несколько месяцев, а названия Gestalt и GLM начинаются на одну букву.
Реальная основа у гипотезы есть. В июне GLM-5.2 действительно занимала первое место в Design Arena по генерации HTML за один запрос, обойдя Claude Fable 5. Но это другой тест и более ранняя версия Claude. Такой результат показывает компетенцию семейства GLM в дизайне, но ничего не сообщает о том, кто разработал Gestalt.
Вдобавок предприниматель Siqi Chen, который в соцсетях намекнул на знакомство с создателем Gestalt, заявил, что модель не принадлежит Anthropic, OpenAI, Google, xAI или SSI. В отдельном сообщении он назвал её американской. Это не официальный анонс разработчика, однако заявление напрямую противоречит версии о GLM-5.5.
В обсуждении на Hacker News встречаются и догадки о GLM, и скепсис. Пользователи спрашивают, где можно попробовать Gestalt и почему нет достаточного количества открытых примеров. Представитель Contra уточнил ещё одну ошибку в распространённых сообщениях: в рейтинге одна скрытая модель, а следующая строка - работы реальных дизайнеров. Он также заявил, что Gestalt не является моделью самой Contra.
Какие вопросы остаются
Пока неизвестны разработчик, архитектура, точное агентное окружение Gestalt, стоимость генерации сайта, доступность API и дата релиза. В открытой галерее результатов можно изучить сайты известных участников, но в просмотренном примере Gestalt отсутствует. Поэтому независимо проверить именно её визуальное преимущество по публичным материалам пока затруднительно.
Результат важен для практического применения ИИ: оценка дизайна постепенно переходит от красивых одностраничных макетов к рабочим сайтам с реальными ограничениями. Но говорить, что Gestalt «мощнее Fable во многих бенчмарках», преждевременно. Для такого вывода нужны результаты независимых тестов программирования, рассуждений и агентных задач, а также открытое сравнение при одинаковых инструментах.
На 20 ноября достоверный вывод такой: Gestalt убедительно лидирует в одном новом бенчмарке профессионального веб-дизайна. Версия о GLM-5.5 не подтверждена и имеет публичное возражение. Следующим существенным событием станет раскрытие разработчика и возможность проверить результаты самостоятельно.
Основные источники
- Contra Labs: Frontier Design Benchmark, текущая таблица
- Contra Labs: исследование и результаты Gestalt
- Методология эксперимента
- Design Critique и Slop Detector
- Описание доступа к датасету
- Design Arena: исторический результат GLM-5.2
- Пост @mylesBaiM о GLM-5.5
- Siqi Chen о предполагаемом происхождении Gestalt
- Hacker News: дискуссия о Gestalt