
Кратко. В обновлении математического рейтинга MathArena от 13 ноября Gemini 4 Carbon занял первое место с ожидаемой результативностью 85,4%. За ним следуют Claude Fable 5.2 (82,8%) и GPT-6.1 Sol (80,6%). Но ожидаемая стоимость одной задачи у моделей сильно различается: $15,70, $40,20 и $1,07 соответственно. Carbon выигрывает у Sol по итоговой оценке на 4,8 процентного пункта при цене в 14,7 раза выше. Это наглядный случай, когда первое место по качеству и наиболее выгодная экономика решения задач достаются разным моделям.
Google выпустила Gemini 4 Carbon для широкого круга пользователей и разработчиков 10 ноября 2026 года. Компания представила его как свою сильнейшую модель для сложных научных, инженерных и многошаговых агентных задач. Через три дня независимый проект MathArena добавил результаты Carbon и Claude Fable 5.2 в математический лидерборд. Это позволило сравнить не только качество решений, но и вычислительные затраты, которые требуются разным моделям, чтобы прийти к ответу.
Рейтинг: три ведущие модели и разница в цене
Согласно публичной таблице MathArena на 16 ноября, первые места выглядят следующим образом:
| Модель и режим | Место | Expected performance | Expected cost за задачу | Дороже GPT-6.1 Sol |
|---|---|---|---|---|
| Gemini 4 Carbon (high) | 1 | 85,4% ± 3,0 п. п. | $15,70 ± $1,33 | 14,7 раза |
| Claude Fable 5.2 (max) | 2 | 82,8% ± 5,3 п. п. | $40,20 ± $2,59 | 37,6 раза |
| GPT-6.1 Sol (max) | 3 | 80,6% ± 2,7 п. п. | $1,07 ± $0,018 | 1 раз |
Источник: MathArena, Model performance. Все значения относятся к указанным настройкам рассуждения и к методике MathArena, а не к универсальной цене любого пользовательского запроса.
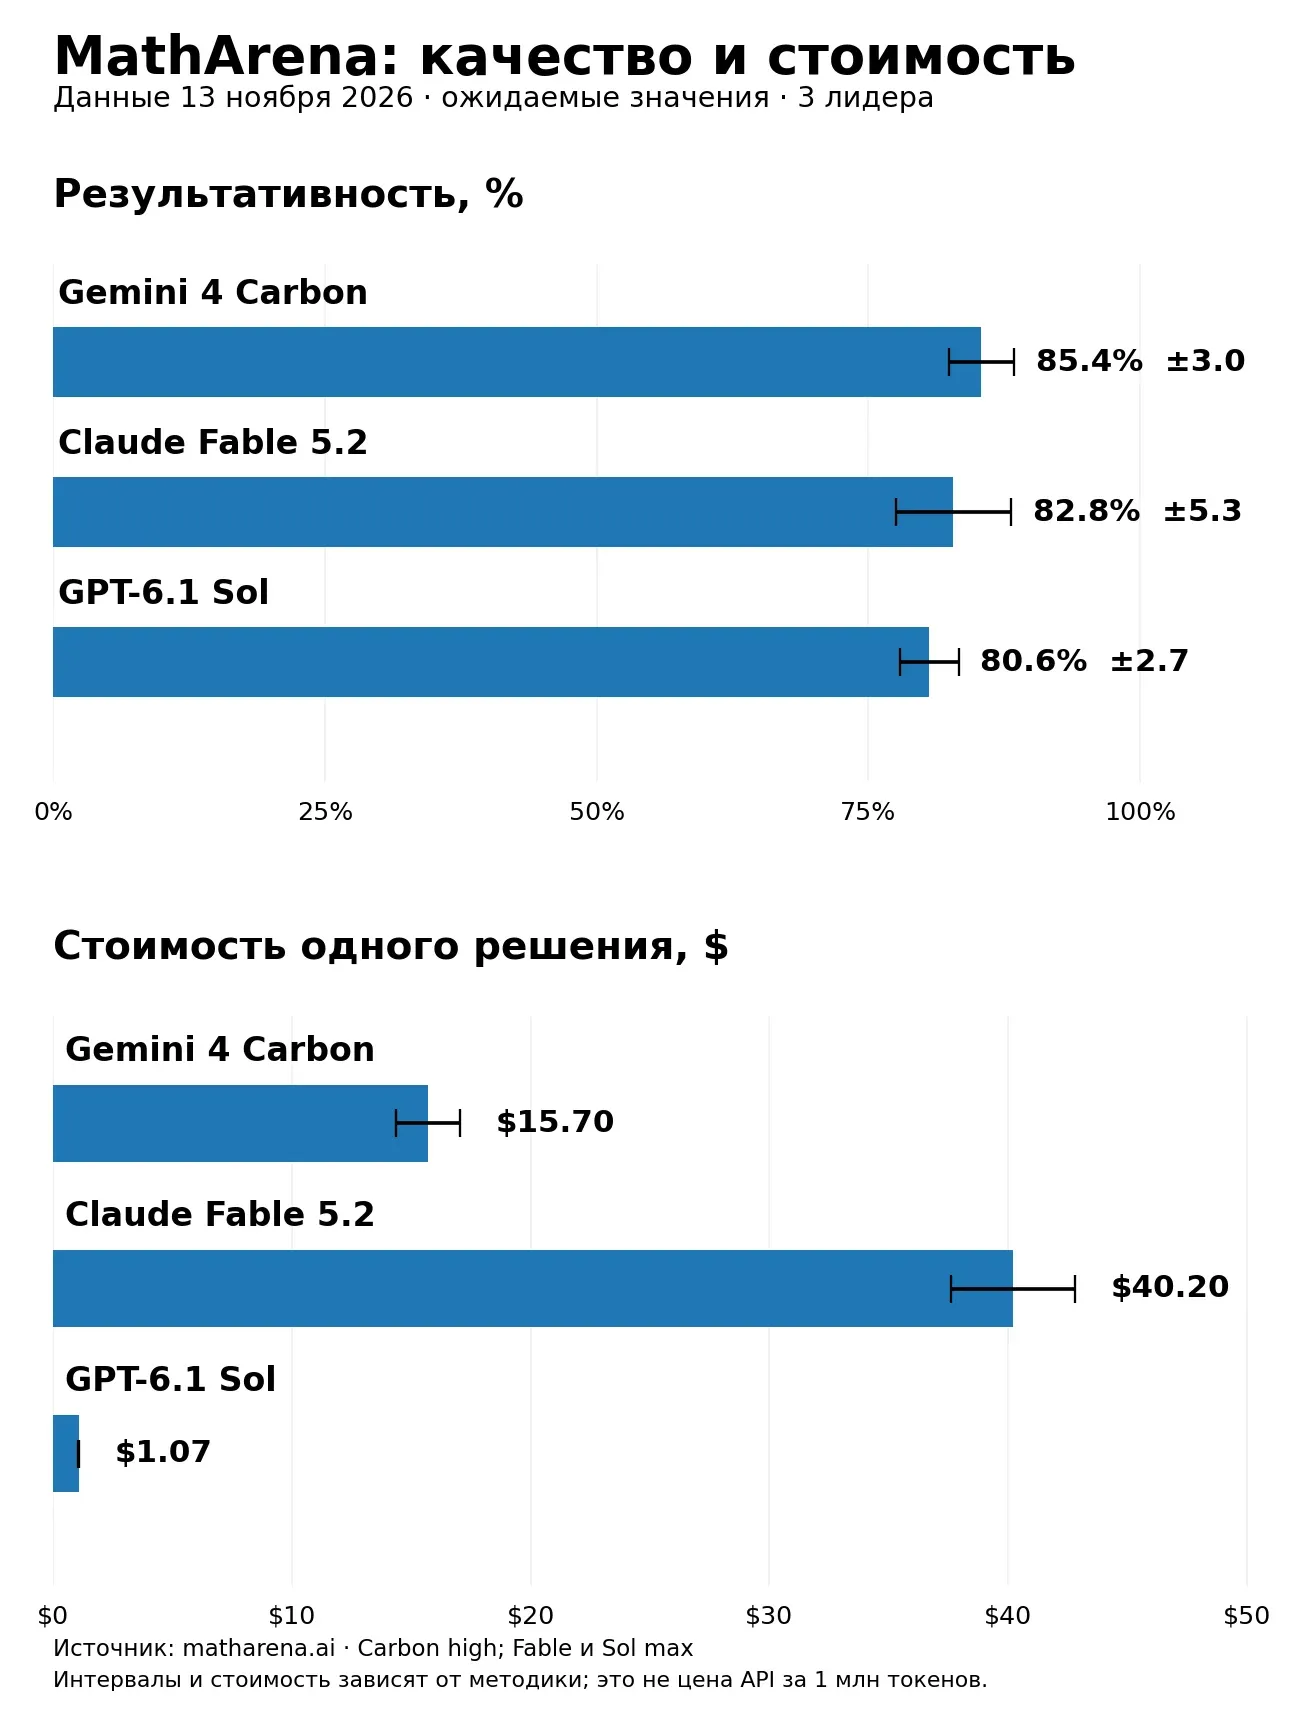
Инфографика GPTunnel по данным MathArena от 16 ноября 2026 года. Верхняя панель показывает ожидаемую результативность с интервалами неопределённости, нижняя - ожидаемые затраты на задачу в долларах.
Разница результатов между первой и третьей моделями составляет 4,8 процентного пункта. В некоторых соревнованиях и при большом количестве попыток дополнительные проценты имеют значение. Но если задача допускает повторный запуск и автоматическую проверку ответа, стоимость может оказаться важнее небольшого преимущества одной конфигурации.
Примечательно и второе место Claude Fable 5.2. По центральной оценке он уступает Carbon на 2,6 пункта, однако его решение обходится более чем в 2,5 раза дороже Carbon и примерно в 37,6 раза дороже Sol. В этом тесте высокая вычислительная интенсивность не обеспечила Anthropic лидерства ни по абсолютному результату, ни по эффективности.
Что именно измеряет MathArena
Смысл показателя expected performance легко понять неправильно. 85,4% не означает, что Carbon непосредственно решил 85,4% одного общего набора задач, полностью совпадающего для всех сравниваемых моделей. MathArena объединяет результаты нескольких математических соревнований с разными форматами и различным покрытием по моделям.
Проект использует свежие задачи математических олимпиад и исследовательских соревнований. Это важно для уменьшения риска, что модель уже видела решение во время обучения. Для каждого доступного задания её запускают четыре раза. Некоторые задания допускают частичный балл; при подсчёте средний наблюдаемый результат по заданию сохраняет такие дробные оценки.
Когда модель не тестировалась на части заданий, MathArena оценивает недостающие результаты с помощью двухпараметрической Item Response Theory (IRT). В упрощённом виде это модель, учитывающая общую «силу» нейросети и сложность конкретного вопроса. Итоговая expected performance - средняя оценка по всем актуальным заданиям, в которой наблюдаемые данные соединены с оценочными. Интервалы неопределённости получают моделированием результатов и повторной подгонкой параметров.
Стоимость считается похожим образом, но с собственной поправкой: это ожидаемые доллары за один прогон одной задачи. Для соревнований, где прямой стоимости нет, проект оценивает её по модели, построенной на известных затратах. Следовательно, $15,70 или $1,07 - не фиксированный счёт, выставляемый всем пользователям, а усреднённая оценка конкретной тестовой нагрузки.
Эти оговорки имеют практическое значение. Интервалы 85,4% ± 3,0, 82,8% ± 5,3 и 80,6% ± 2,7 перекрываются. Поэтому по текущей таблице нельзя уверенно утверждать, что Carbon статистически превосходит Fable или Sol на любой математической задаче. Корректнее говорить: Carbon занимает первое место по принятой методике и центральной оценке MathArena.
Что происходит внутри отдельных соревнований
Важнее общей цифры иногда оказывается профиль задач. В таблицах MathArena доступны результаты по соревнованиям ArXivMath и BrokenArXiv, а также ArXivLean, ориентированному на формальные доказательства.
| Соревнование | Gemini 4 Carbon (high) | Claude Fable 5.2 (max) | GPT-6.1 Sol (max) |
|---|---|---|---|
| ArXivMath, октябрь 2026 | 93,62% | 93,62% | 90,43% |
| BrokenArXiv, октябрь 2026 | 82,72% | 73,46% | 80,25% |
| BrokenArXiv, сентябрь 2026 | 82,39% | 80,50% | 82,70% |
| ArXivLean, сентябрь 2026 | 62,26% | Нет результатов | 35,85% |
Источники: карточки Gemini 4 Carbon, Claude Fable 5.2 и GPT-6.1 Sol на MathArena. «Нет результатов» означает отсутствие наблюдаемого результата по данному соревнованию, а не нулевой балл.
Эта детализация меняет восприятие лидерства. В октябрьском ArXivMath Carbon и Fable имеют одинаковую оценку 93,62%, тогда как Sol уступает чуть больше трёх пунктов. В октябрьском BrokenArXiv Carbon обгоняет Sol менее чем на 2,5 пункта, а Fable заметно отстаёт. Но в сентябрьском BrokenArXiv у Sol результат даже немного выше Carbon - 82,70% против 82,39%. По одному соревнованию невозможно объявить постоянного победителя.
Самый заметный разрыв обнаруживается в ArXivLean за сентябрь: 62,26% у Carbon против 35,85% у Sol. Это тест, связанный с формальным доказательством; он показывает, что в отдельных типах математической работы преимущество Carbon действительно может быть большим. Но распространять это преимущество на все классы задач без дополнительных испытаний нельзя.
Почему Carbon стоит в 15 раз дороже при близких тарифах за токены
Самый неожиданный момент - различие между тарифом за миллион токенов и ценой решённой задачи. На момент публикации Google установила для Carbon вводную цену $2 за миллион входных и $10 за миллион выходных токенов. Официальная стандартная цена GPT-6.1 Sol также составляет $2 и $10 соответственно. Если смотреть только на прайс-листы, модели кажутся сопоставимыми по стоимости обработки одинакового количества токенов.
Но в реальной агентной сессии важен объём работы, который модель выполняет до получения результата. Длительные рассуждения, многочисленные вызовы инструментов, повторные вычисления, промежуточные проверки и неудачные попытки увеличивают счёт. У модели с максимальной настойчивостью может оказаться прекрасный итоговый результат и очень дорогой путь к нему.
Показателен опубликованный MathArena расход выходных токенов в BrokenArXiv: у Carbon в сводке около 540 тысяч, у Fable - более 600 тысяч в октябрьском тестировании. Эти объёмы не следует сравнивать как идентичный протокол получения ответа, но они объясняют, почему стоимость сложной математической задачи измеряется уже долларами и десятками долларов.
Исследователь MathArena Яспер Деконинк (Jasper Dekoninck) обратил внимание на характерные неудачи Carbon. По его наблюдениям, модель часто упиралась во временной лимит и редко добровольно прекращала поиск решения. В одном эпизоде она запустила скрипт более чем на 11 часов, не проверяя ход его выполнения. Настойчивость полезна, когда задача действительно требует длительного исследования, но без контроля времени и бюджета она превращается в недостаток. Об этом эпизоде сообщил The Decoder со ссылкой на публикацию исследователя.
И ещё одно ограничение сравнения: условия использования инструментов у моделей различаются. В карточках MathArena для Carbon указан запуск через среду Google Antigravity, для Fable - Claude Code, для Sol - Codex. У каждой системы собственные механизмы управления задачами и вызова инструментов, а также разные настройки усилия (high и max). Мы сравниваем конкретные рабочие конфигурации, а не только базовые веса моделей в стерильном тесте без инструментов.
Как Google объясняет высокие затраты Carbon
Официальное позиционирование Google помогает понять разницу. Компания относит Gemini 4 Argon к повседневной инженерной и интеллектуальной работе, а Carbon - к задачам, в которых приходится долго удерживать цель, координировать инструменты и проводить расширенные циклы проверки. В ноябрьском анонсе Google делает акцент на научных исследованиях, сложной разработке ПО, анализе документов и защите информационных систем.
По заявлениям вендора, Carbon показывает сильные результаты не только в математике, но и в CursorBench 4.0, WANDR и AutomationBench. Однако эти результаты измеряют другие стороны работы моделей; их нельзя переносить на математическую стоимость без отдельной проверки. Здесь возникает интересное расхождение: Google утверждает, что в ряде агентных сценариев Carbon сочетает высокий результат с хорошей экономикой, тогда как MathArena обнаруживает нагрузку, в которой Sol значительно дешевле.
Google также сообщила о завершении вводного периода API-цен: с 1 декабря 2026 года тариф Carbon должен увеличиться до $4 за миллион входных и $20 за миллион выходных токенов. Если профиль токенов и остальные параметры сессии останутся неизменными, двукратное увеличение этих тарифов приведёт примерно к удвоению соответствующей части затрат. Но нельзя автоматически переписывать цену MathArena с $15,70 на $31,40: лидерборд показывает фактически использованные на тесте тарифы, кеширование и структуру вычислений, а не прогноз будущего платежа.
Кому выбирать Carbon, Fable или Sol
Для практического применения результаты предлагают стратегию распределения задач по сложности, а не универсальную замену одной модели другой.
- GPT-6.1 Sol выглядит рациональным кандидатом для массового потока математических и аналитических вопросов, где важны стоимость, скорость и возможность повторной проверки ответа. В тесте он уступает лидеру менее пяти пунктов по ожидаемой результативности, но обходится почти в 15 раз дешевле.
- Gemini 4 Carbon интересен для сложных задач, где дополнительные шансы на успешное решение могут оправдать продолжительный поиск. Особенно стоит проверить его на формальных доказательствах и многошаговых вычислениях. При работе через агентов нужны жёсткие ограничения по времени, числу вызовов инструментов и бюджету.
- Claude Fable 5.2 по этому рейтингу не выглядит экономичным выбором по умолчанию для математики. Но MathArena не измеряет все возможности модели, а результат зависит от условий выполнения и типа заданий. Её стоит оценивать отдельно, если важны код, инженерная работа, другие инструменты Claude и требования конкретного проекта.
В типичном сервисе с несколькими доступными моделями можно строить каскад: отправлять обычные задачи более экономичной модели, проверять результат вычислениями или вторым независимым методом, а к дорогостоящему режиму Carbon обращаться только при неудаче или действительно высокой цене ошибки. Однако даже такая схема требует тестов на собственных данных: математика соревнований и реальные рабочие документы создают разные типы нагрузки.
Вывод: первое место и эффективность - разные показатели
Gemini 4 Carbon действительно возглавил MathArena после обновления 13 ноября. Но лидерство относится к ожидаемой результативности в конкретной системе оценивания. В этой же системе Carbon стоит $15,70 за задачу, тогда как GPT-6.1 Sol - $1,07. Claude Fable 5.2 занимает второе место по качеству при самой высокой стоимости среди тройки.
Нельзя делать вывод, что Sol «лучше Carbon во всём» или что Carbon «всегда в 15 раз дороже». Зато можно сформулировать полезное правило выбора модели: сравнивать качество, потребление токенов, поведение агента и затраты на одну завершённую задачу, а не смотреть только на место в рейтинге и цену миллиона токенов. Именно в этом практическая ценность новых данных MathArena.
Источники
- MathArena, официальный рейтинг и методика расчёта expected performance / expected cost
- MathArena, детальные результаты Gemini 4 Carbon
- MathArena, детальные результаты Claude Fable 5.2
- MathArena, детальные результаты GPT-6.1 Sol
- Google, «Gemini 4 Carbon is now available», 10 ноября 2026
- Google, «Introducing Gemini 4 Carbon», тарифы и анонс модели
- OpenAI, официальные цены GPT-6.1 Sol
- The Decoder, комментарии Яспера Деконинка о сбоях и временных лимитах Carbon