
19 октября Inception выпустила Mercury 3 - диффузионную языковую модель: она пишет ответ не по одному токену, а сразу пачкой и уточняет её за несколько проходов. Скорость - 1068 токенов в секунду, контекст - 1 млн токенов, а в тестах самой Inception модель обгоняет GPT-6 Luna и Claude Haiku 5.5 в 8 из 12 замеров.
В интерфейсе Mercury можно посмотреть ответ нейросети с включенным "Diffusion Effect", я записал как это выглядит (ответ, кстати, получился забавным):
Что вышло
| Mercury 3 | |
|---|---|
| Скорость | 1068 токенов/с на GPU NVIDIA |
| Контекст | 1 млн токенов (у Mercury 2.5 было 260 тыс.) |
| Максимум вывода | 131 072 токена |
| Режимы рассуждения | instant, low, medium, high |
| Функции | вызов инструментов, структурированный вывод, API совместим с OpenAI |
| Цена | $0,20 за 1 млн входных и $0,70 за 1 млн выходных токенов, на запуске вдвое ниже: $0,10 и $0,35 |
| Бесплатно | 100 млн токенов для новых аккаунтов |
| Где доступна | Inception API, чат Mercury и сторонние площадки |
| Веса | не опубликованы |
Кэшированный вход стоит на 90% меньше. Цены в таблице - цены вендора: Mercury 3 в GPTunneL пока нет. Mercury 2 и 2.5 для новых пользователей закрыты, у текущих клиентов они работают до 15 ноября.
Чем Mercury 3 отличается от других моделей
GPT-6 Luna, Claude Haiku 5.5 и большинство других LLM пишут токен за токеном: каждый следующий зависит от предыдущих, поэтому быстрее длины этой цепочки ответ не получить. Диффузионная модель сразу набрасывает много токенов и уточняет их параллельно. Тот же принцип давно работает в генераторах картинок, Inception довела его до коммерческого API для текста.
| Mercury 3 | GPT-6 Luna | Claude Haiku 5.5 | |
|---|---|---|---|
| Как пишет ответ | пачкой токенов, несколько проходов уточнения | токен за токеном | токен за токеном |
| Скорость, токенов/с (по данным Inception) | 1068 | около 130 | около 240 |
| Контекст | 1 млн | 1,05 млн | 1 млн |
| Цена в GPTunneL, ₽ за 1K, вход / выход | модели нет | 0,04 / 0,2, сейчас 0,02 / 0,1 | 0,03 / 0,15 |
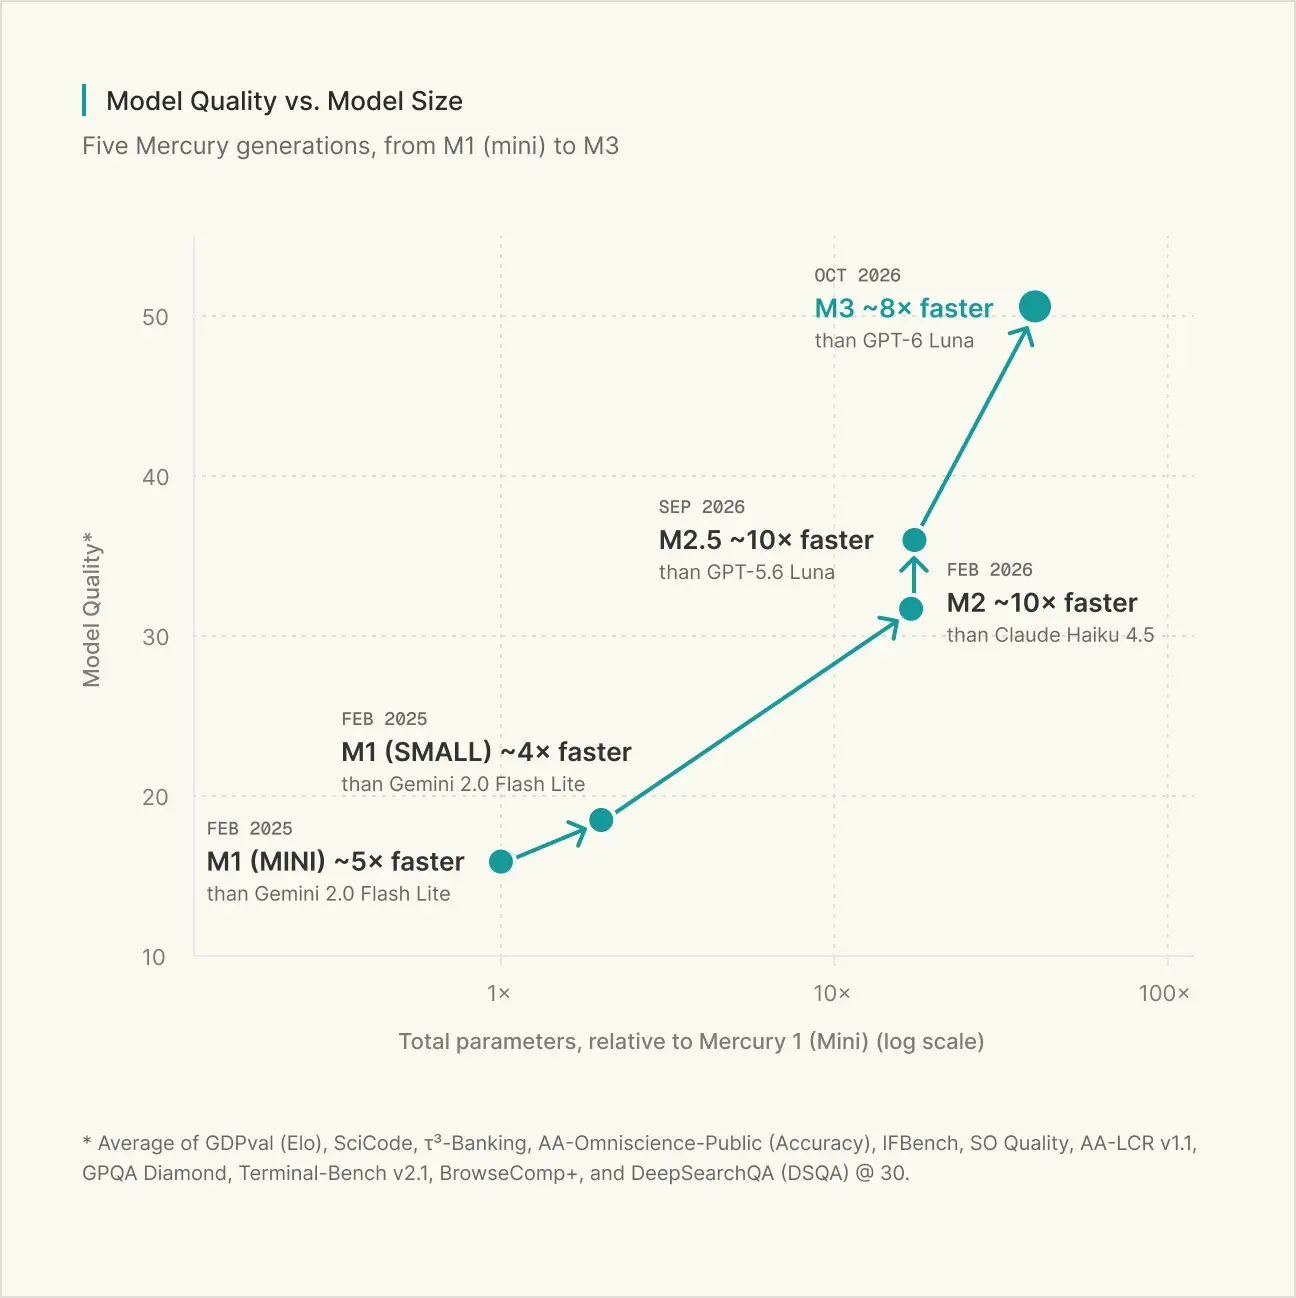
Отсюда «в 4-8 раз быстрее»: 1068 против 240 у Haiku и против 130 у Luna. Но у Mercury 2.5 скорость была даже чуть выше, 1107 токенов/с. Третье поколение не разогналось, а выросло: по словам Inception, модель больше Mercury 1 более чем в 40 раз и при этом держит ту же скорость, а результаты в стандартных тестах выросли примерно втрое относительно Mercury 1 mini.
Другие диффузионные модели пока ближе к исследованиям: у Google это экспериментальные Gemini Diffusion и DiffusionGemma, LLaDA остаётся академическим проектом. Mercury доступна через коммерческий API и чат.
Что показывают тесты Inception
Все три модели сравнивали в режиме medium. Mercury 3 впереди в 8 замерах из 12, и сильнее всего - в агентных задачах.
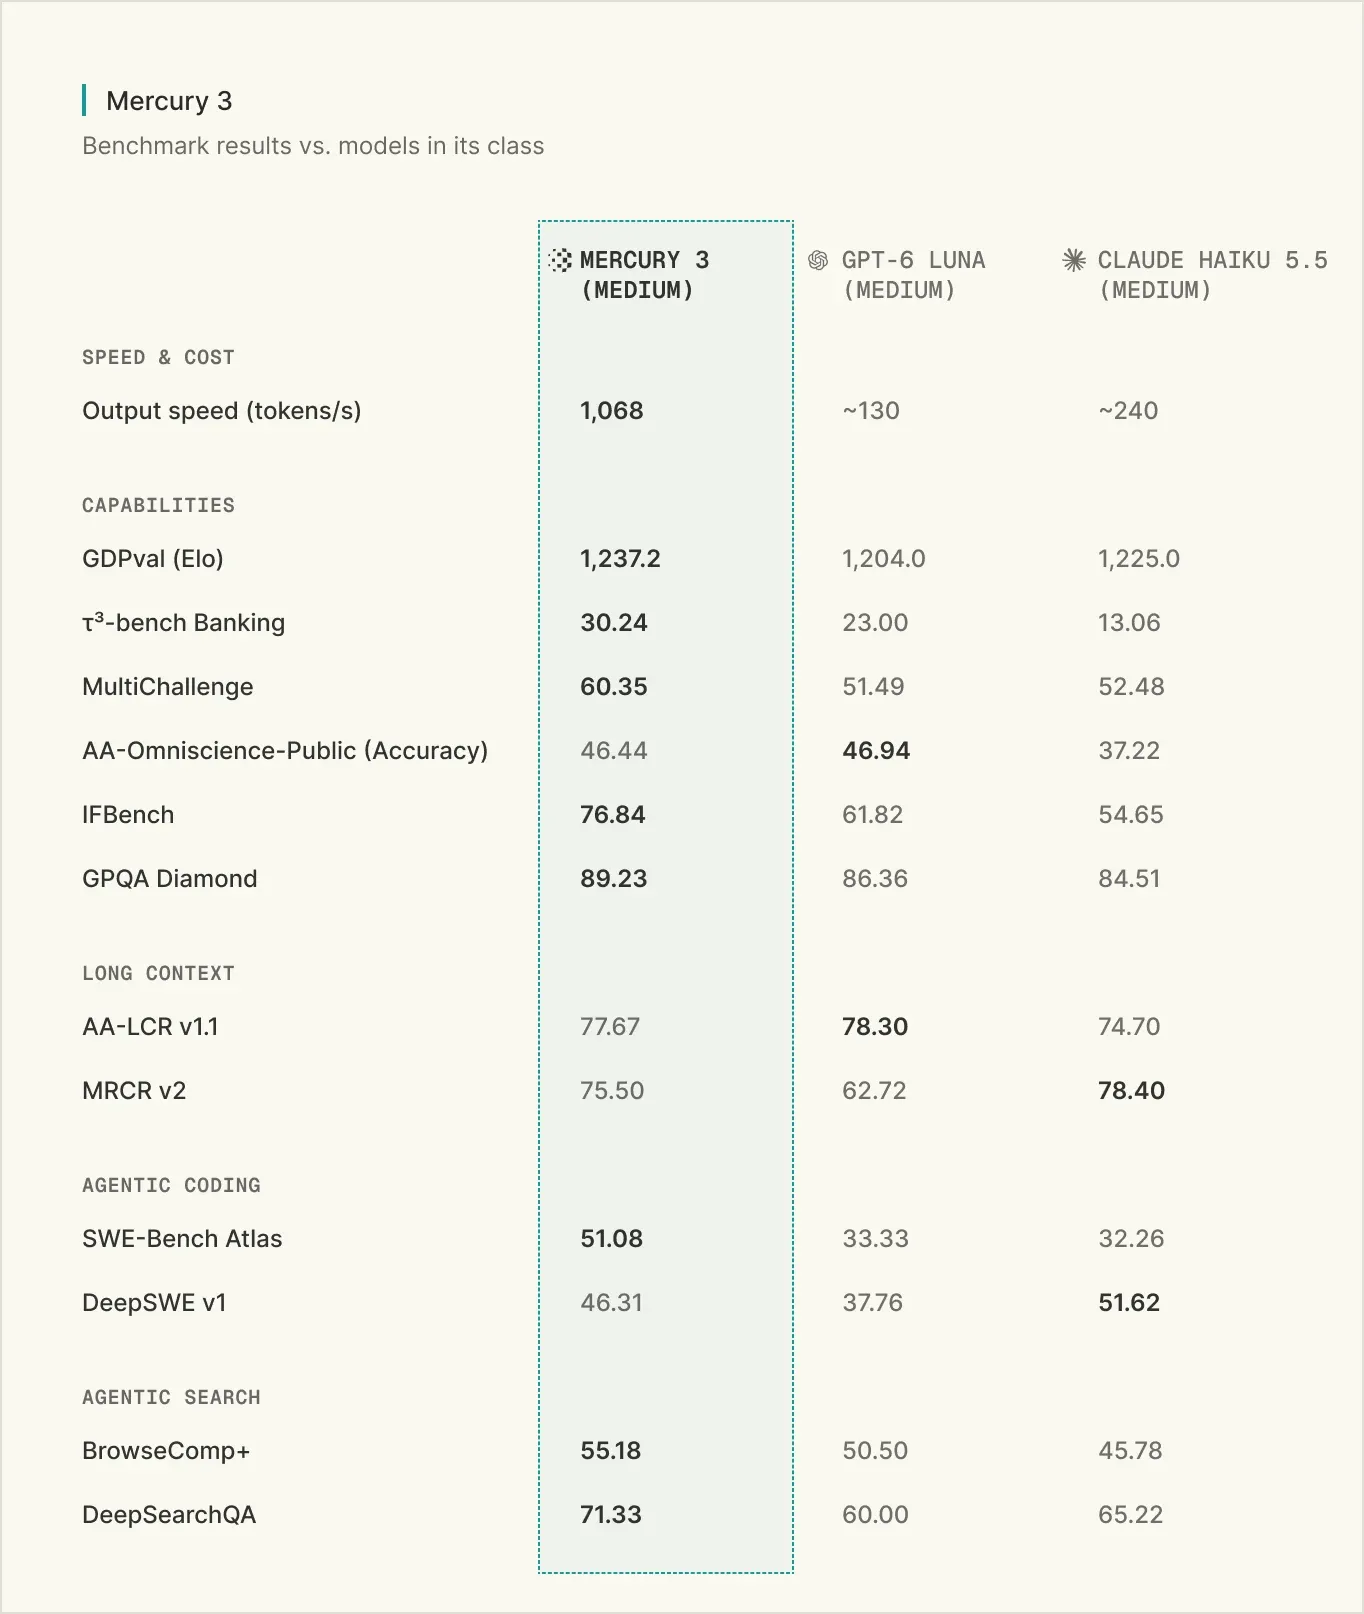
- Код-агенты. SWE-Bench Atlas: 51,08 против 33,33 у Luna и 32,26 у Haiku.
- Банковские сценарии. τ³-bench Banking: 30,24 против 23,00 и 13,06.
- Следование инструкциям. IFBench: 76,84 против 61,82 и 54,65.
- Поиск. BrowseComp+: 55,18 против 50,50 и 45,78; DeepSearchQA: 71,33 против 60,00 и 65,22.
Проигрывает в четырёх: AA-Omniscience (46,44 против 46,94 у Luna), AA-LCR (77,67 против 78,30 у Luna), MRCR v2 (75,50 против 78,40 у Haiku) и DeepSWE (46,31 против 51,62 у Haiku). AA-LCR и MRCR v2 проверяют длинный контекст: здесь миллионное окно Mercury 3 в этих замерах преимущества не дало.
Где это нужно
Скорость важна там, где модель ждут на каждом шаге. Примеры из анонса, все цифры - со слов Inception и её партнёров:
- Браузерные агенты. Агент обращается к модели на каждом клике, и задержки складываются. Mercury 3 выполнила 50% из 50 живых задач Mind2Web и, по словам компании, заметно больше, чем GPT-6.1 Sol. Результат Sol Inception не назвала.
- Поиск в реальном времени. У Octen поиск занимает около 80 мс, а медианная генерация Mercury 3 - 0,9 с, ответ целиком - 2,2 с. Для умных очков узким местом остаётся модель.
- Голосовые агенты. Вариант Mercury Voice отвечает за минимальное время до первого звука: медиана 320 мс, 95-й процентиль 750 мс. Его используют OpenCall, Audivi AI и Altur.
- Обучение. RevisionDojo выдаёт подсказки, оценки и определения примерно за секунду.
- Поддержка клиентов. Lorikeet запускает Mercury 3 в голосе, чате и почте для регулируемых бизнесов, отдельных цифр компания не привела.
- Разметка потока. Mercury Decide классифицирует большие объёмы запросов.
Не подойдёт, если нужны открытые веса или независимо подтверждённое качество. И если задача не упирается в задержку, 1068 токенов в секунду ничего не меняют: пользователь всё равно ждёт результата целиком.
Что пока не доказано
Методику замеров Inception в анонсе не раскрывает, а в Artificial Analysis страницы Mercury 3 на 20 октября нет. У Sol на Mind2Web нет числа, у Luna и Haiku скорость дана приблизительно, «около 130» и «около 240». Это заявления вендора, а не результаты третьей стороны.
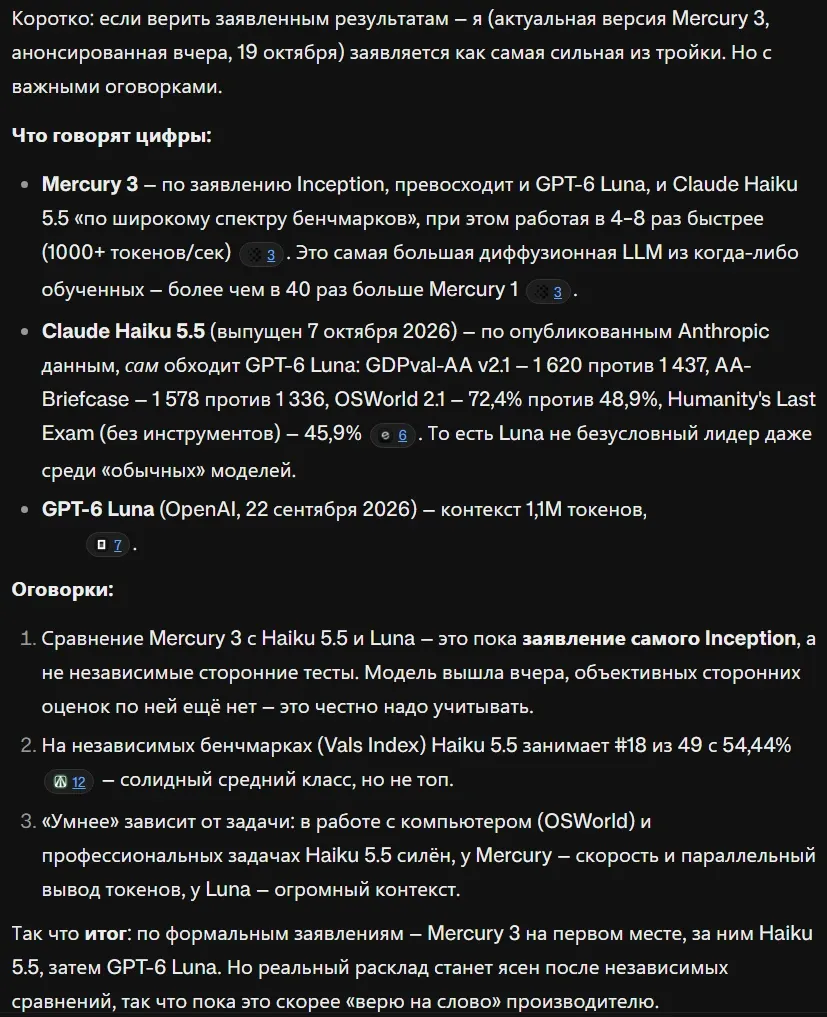
Ради интереса я спросил Mercury 3, кто умнее - она, хайку или луна: видно, что при ответе активно использует веб-поиск, но скорость ответа в обычном веб-чате не сказать, что быстрее, чем у DeepSeek или иишки в поиске Гугла:
Что это значит
Если задержка - узкое место вашего продукта, Mercury 3 стоит прогнать на своих запросах: API совместим с OpenAI, поэтому достаточно сменить адрес и ключ. Для остальных задач выбор между быстрыми моделями по-прежнему решает цена принятого ответа, а не скорость генерации.
Проверили на трёх задачах
Ради небольшого эксперимента я дал Mercury 3 три простые задачи, по одной попытке на каждую. Это не полноценный бенчмарк, а быстрый осмотр:
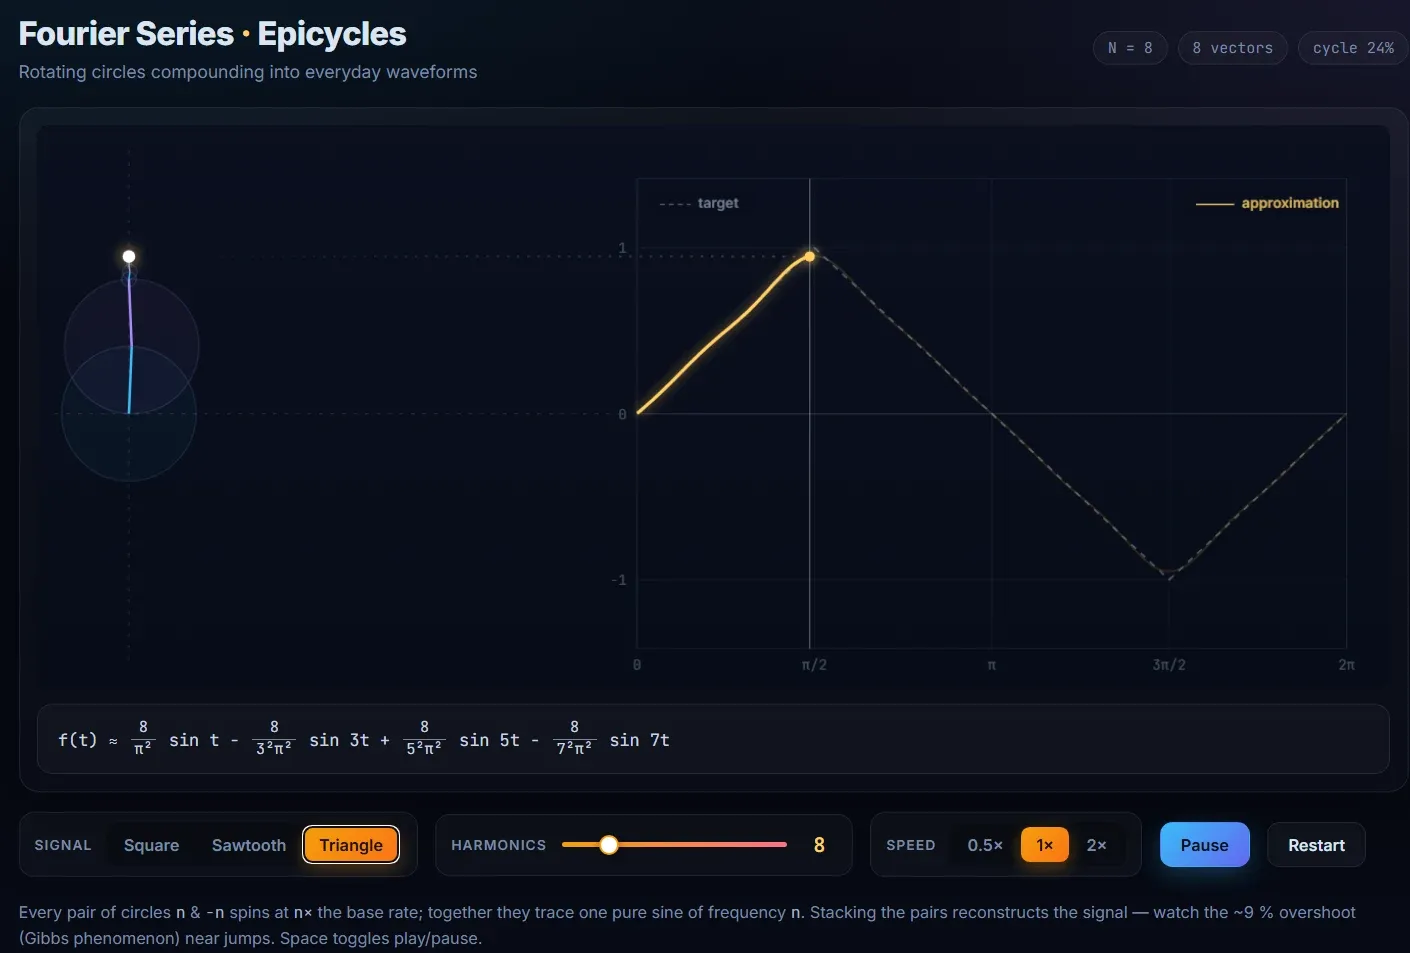
- Интерактивное объяснение рядов Фурье. Промпт для этой задачи предлагает сам Inception. Получилась рабочая веб-страница: вращающиеся круги, переключатель сигнала (прямоугольный, пилообразный, треугольный), число гармоник и скорость.
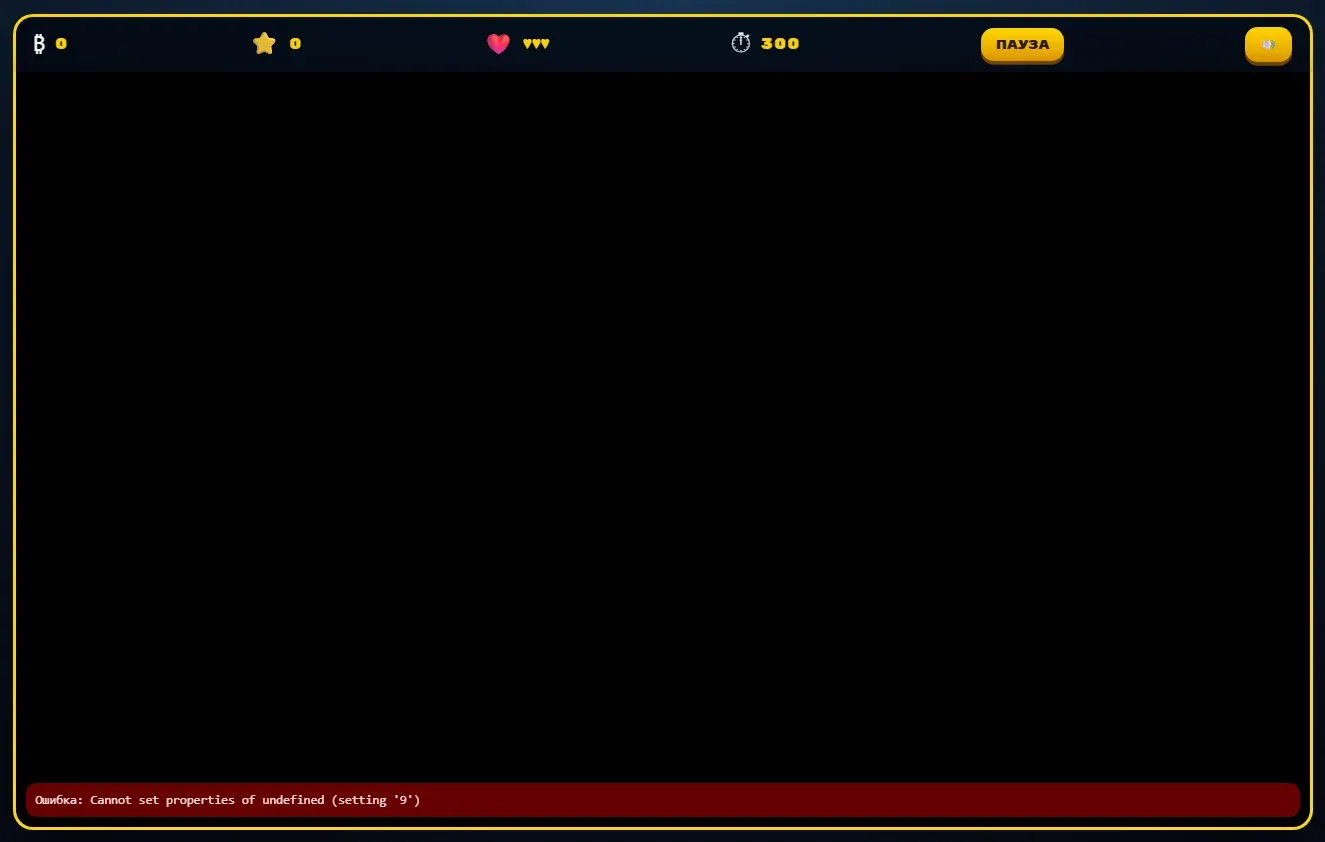
- Простая игра в стиле Марио. Код не запустился: вместо игры чёрный экран и ошибка
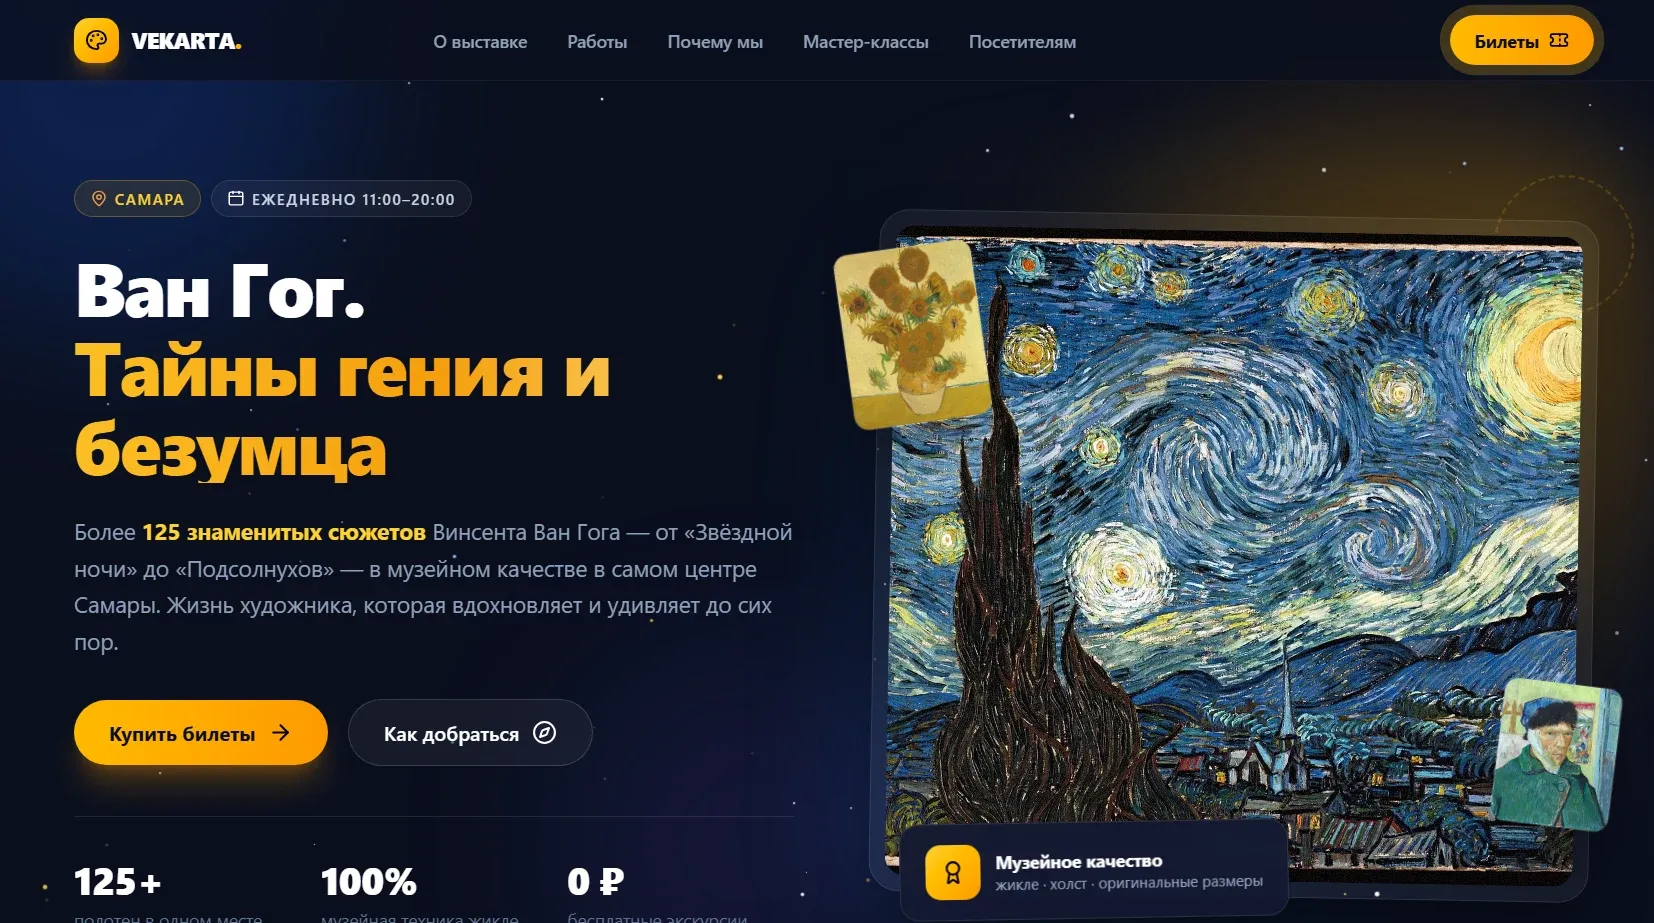
Cannot set properties of undefined (setting '9'). DeepSeek и Haiku на ту же задачу выдали рабочий код. - Одностраничный сайт для выставки Ван Гога. Mercury 3 справилась с оговорками: изначально изображения на лендинге никак не относились к Ван Гогу.
Вывод: Mercury 3 может пригодиться в узких сценариях. Сама модель описывает их так: «там, где нужны параллельная генерация длинных текстов, жёсткое соблюдение форматов и низкая задержка в больших потоках запросов - я быстрее и дешевле в пересчёте на готовый результат, чем DeepSeek и Haiku». Это её собственные слова, стоимость мы не сравнивали.
Где попробовать
Mercury 3 в GPTunneL нет, но быстрые модели того же класса есть: Claude Haiku 5.5 и GPT-6 Luna работают с одного баланса. Как выбрать между ними - в разборе Haiku 5.5 и GPT-6 Luna.
Источники
- Introducing Mercury 3, Inception, 19.10.2026 - скорость, контекст, цены, графики и таблица тестов, партнёры.
- Модели Inception, документация - контекст, лимит вывода, режимы рассуждения, цены.
- Каталог моделей Inception - срок доступа Mercury 2 и 2.5, Mercury Voice и Mercury Decide.
- Inception Launches Mercury 3, Business Wire, 19.10.2026 - пресс-релиз.
- Introducing Mercury 2.5, Inception - скорость предыдущей версии, 1107 токенов/с.