
OpenAI опубликовала исследование Research acceleration: The jagged frontier о том, как ИИ-агенты участвуют в создании следующего поколения нейросетей. Согласно внутренним данным компании, с марта по октябрь 2026 года доля задач, успешно выполненных агентами без вмешательства человека, выросла с 23% до 46% в категории работ, на которые у специалиста ушло бы от двух до четырёх часов. Для задач длительностью четыре-восемь часов показатель вырос с 13% до 35%.
Важное уточнение: это задачи из внутренней работы исследовательских команд OpenAI, а не произвольные научные исследования. В основном речь идёт о программировании, инфраструктуре, анализе результатов и запуске экспериментов. Время в заголовке — оценка того, сколько человек потратил бы на задачу, а не продолжительность автономной работы самого агента. И показатель 46% относится к конкретной группе делегированных работ, а не к доле исследований, которые ИИ уже способен проводить полностью самостоятельно.
Как быстро растёт автономность
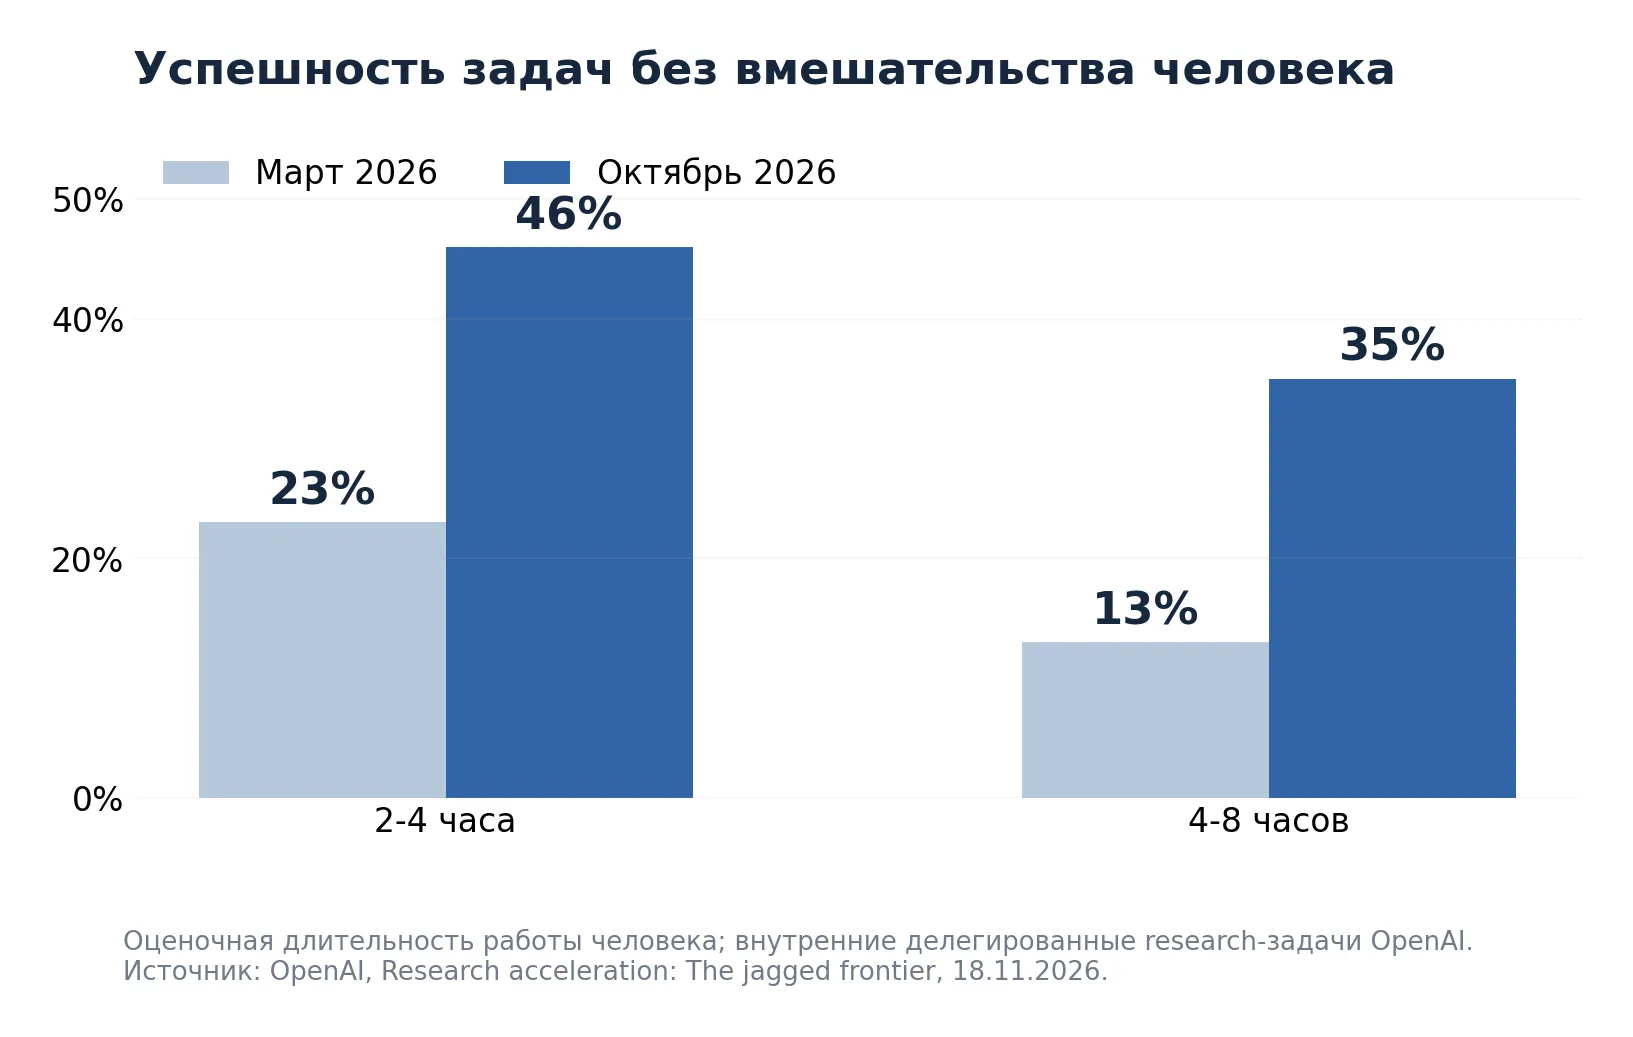
Иллюстрация 1. Оценочная доля делегированных задач, завершённых без вмешательства человека. Длительность соответствует предполагаемому времени специалиста, а не времени работы агента. Источник: OpenAI.
За семь месяцев успешность в группе двух-четырёхчасовых задач удвоилась — с 23% до 46%, прибавив 23 процентных пункта. В более сложной группе четырёх-восьмичасовых задач рост составил 22 процентных пункта, до 35%. Такую динамику трудно игнорировать: ИИ получает всё больше самостоятельных инженерных поручений, которые ещё недавно требовали отдельной сессии работы разработчика.
Но у этой статистики есть ограничения. OpenAI отмечает, что исследователи со временем меняют набор поручений. Например, они могут начать давать агентам более сложные или, наоборот, более подходящие задания. Следовательно, изменение успешности отражает одновременно развитие технологий и изменение практики их применения. Это внутренние оценки, а не слепое соревнование одинакового фиксированного набора задач.
Где агенты справляются, а где ошибаются
Самая содержательная часть отчёта — разбивка по видам работы. Между созданием кода для инфраструктуры и мониторингом уже запущенного обучения разница огромна.
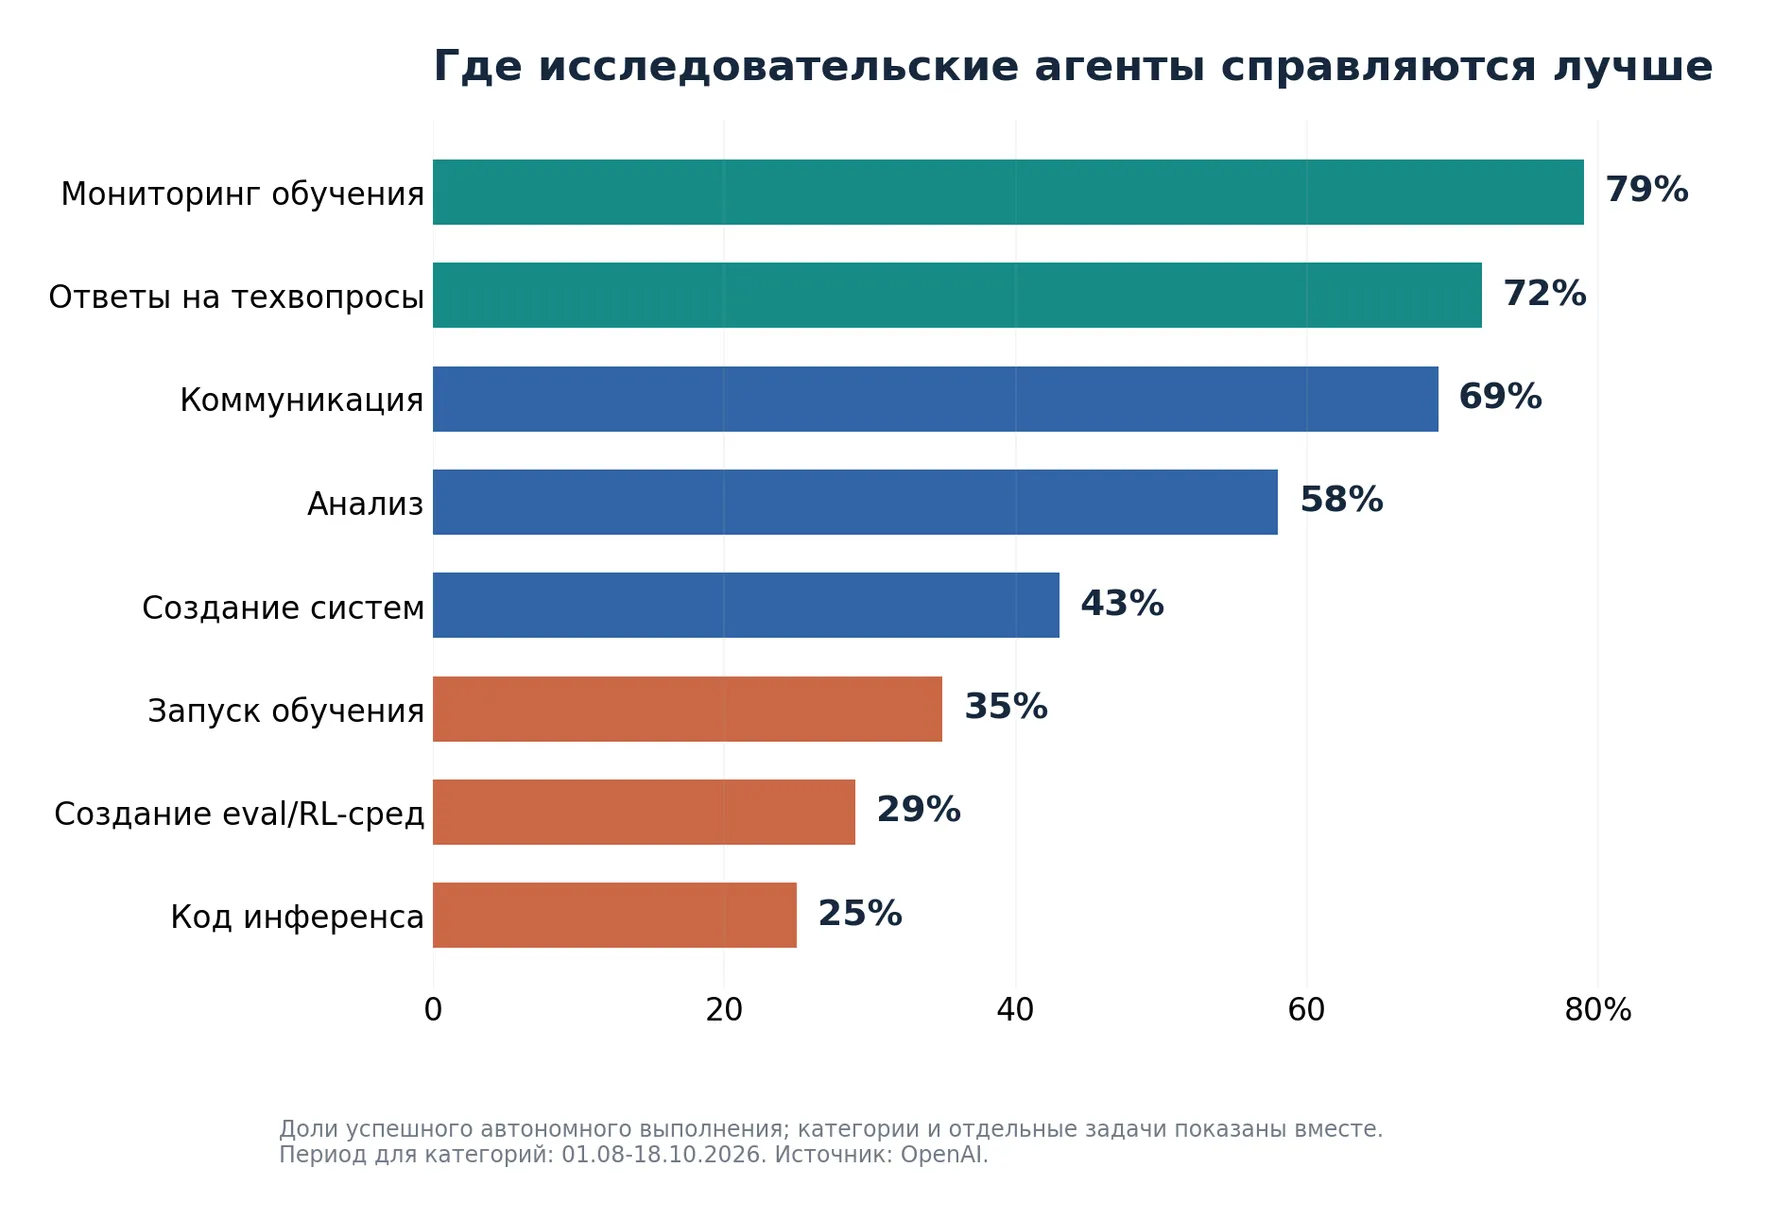
Иллюстрация 2. Успешность автономного выполнения в отдельных категориях и задачах. Категории и конкретные действия имеют разную детализацию, поэтому это не один рейтинг взаимоисключающих видов работ. Источник: OpenAI.
По категориям в период с 1 августа по 18 октября агентам лучше удавались коммуникационные задачи (69%) и анализ (58%), хуже — создание систем и компонентов (43%). Среди конкретных поручений исследование показывает ещё более резкие различия: мониторинг обучающих запусков — 79%, ответы на технические вопросы — 72%, запуск обучения — 35%, создание среды для оценивания или reinforcement learning — 29%, написание компонентов inference/serving — 25%.
Для понимания роли ИИ в исследованиях эта неоднородность важнее среднего процента. Агент может самостоятельно анализировать результаты тысяч экспериментов и предупреждать исследователя о сбое. Но когда требуется изменить низкоуровневую инфраструктуру, отладить сложное окружение или корректно организовать эксперимент, вероятность полного автономного успеха заметно ниже.
Агенты выполняют больше работы — но стали ли быстрее сами исследования?
OpenAI показывает несколько косвенных индикаторов. За четыре недели по 18 октября число зарегистрированных экспериментов в расчёте на активного экспериментатора составило 1,68 раза от базового уровня 2025 года. Рост количества изменённых строк кода также фиксируется в отчёте. Но авторы подчёркивают, что число экспериментов и строк кода нельзя автоматически приравнивать к научному прогрессу. Десять бессмысленных опытов не лучше одного корректно поставленного.
Отдельно OpenAI представляет собственный OpenAI Epoch Capabilities Index (OECI), построенный из публичных и внутренних бенчмарков. Тренд для передовых моделей OpenAI компания оценивает примерно в 16,4 пункта в год с августа 2025 года. Для сравнения приведён публичный тренд Epoch AI — около 14 пунктов в год, но состав тестов и выборка отличаются. Более высокая скорость на собственном индексе ещё не доказывает, что именно ИИ-агенты вызвали ускорение.
Сколько ресурсов тратят сотрудники OpenAI на ИИ
Ещё более неожиданна оценка ежедневного агентного потребления. В октябре медианное использование среди исследователей достигло $2400 в день по публичным API-ценам, против примерно $1500 в сентябре. На 90-м процентиле показатель вырос с $11 000 до $23 000 в день. Это условная оценка объёма использования по прейскуранту API, а не фактический денежный счёт сотруднику или доказательство таких операционных расходов компании.
Подобная статистика показывает изменение масштабов: сильные пользователи запускают больше параллельных задач и иногда направляют агентам значительную часть инженерной работы. Но производительность при этом зависит от того, как человек выбирает задачи и контролирует результаты. Значительное использование токенов не гарантирует сопоставимого прироста научных открытий.
Мнение исследователей: высокая польза и плохой «исследовательский вкус»
OpenAI опросила 101 сотрудника исследовательских подразделений. В гипотетическом сценарии трёхмесячного ограничения доступа к продвинутым агентам медианный участник оценил возможность их сохранить в 30% вычислительных ресурсов команды или в 40% её численности. Это субъективная оценка значимости инструментов, а не доказательство, что ИИ уже заменяет 40% исследователей.
Интервью с десятью исследователями раскрывают причины такой неоднозначности. Агенты ускоряют перенос оценочных наборов, проверку результатов, отладку и систематизацию больших массивов данных. Вместе с тем сотрудники отмечают слабое качество исследовательских идей, поверхностные решения, лишние действия, неудачные предположения при анализе и изменения кода, которые приходится переделывать. Одна из практик — сначала попросить агента создать один образец, проверить его вручную и только затем масштабировать процесс.
Отчёт содержит важное наблюдение о генерации идей. В описанных ключевых направлениях при создании GPT-6 Astra исследователи приписывали главные идеи людям, а агентам — помощь с реализацией. Для GPT-6.2 Astra появились примеры совместной проработки идей с Codex, включая предложения модели, которые, по словам исследователей, помогали найти работающее решение. Это первые качественные свидетельства смены роли ИИ, но не массовая статистика самостоятельных открытий.
Как это соотносится с Anthropic, Google и METR
Проблема ускорения ИИ-разработки давно вышла за пределы OpenAI. Anthropic публиковала внутренние оценки влияния Claude на собственные исследовательские процессы, а METR изучает, какие по длительности задачи могут надёжно выполнять кодовые агенты. В отчёте OpenAI прямо указаны исследования этих организаций и данные Google DeepMind об использовании ИИ при создании кода.
Сравнивать их числа напрямую опасно: разные компании используют разные наборы заданий, критерии успешности и способы оценки продолжительности. Тем не менее общий тренд согласуется: самостоятельные инженерные задачи увеличиваются по сложности, однако нуждаются в всё более продуманном контроле.
Сентябрьский отчёт OpenAI дополняет картину: уже тогда компания фиксировала увеличение продолжительности делегируемой работы и значительную потребность в человеческих вмешательствах для многих долгих задач.
Почему ускорение ИИ-разработки вызывает вопросы безопасности
Появляется потенциальная обратная связь: более сильная модель помогает разработать следующую, а новая модель ускоряет следующий цикл. В индустрии этот процесс называют recursive self-improvement (RSI). OpenAI пока не заявляет, что достигла автономного замкнутого цикла разработки моделей. Авторы призывают регулярно публиковать измеримые показатели ускорения и сохранять человеческий контроль.
Показательно, что, согласно самому отчёту, документированное участие сотрудников в работах по Safety & Alignment выросло на 77% с января по сентябрь 2026 года. Компания связывает часть ускорения с реакцией на июльский инцидент с Hugging Face и изменениями в расстановке приоритетов. Рост безопасности здесь измеряется трудозатратами, а не снижением числа инцидентов.
Вывод
46% — показатель заметного прогресса, но его смысл строго ограничен. Агенты OpenAI самостоятельно завершают почти половину внутренних research-задач из двух-четырёхчасовой категории, тогда как создание сложных инфраструктурных компонентов и экспериментов остаётся узким местом. Пока сильная сторона ИИ — выполнение большого объёма проверяемых технических операций, а главная роль человека — постановка проблем, проверка качества и принятие исследовательских решений. Именно эту комбинацию OpenAI считает важной для будущего ускорения разработки моделей.