
Кратко. Исследователи из Университета Вашингтона, Allen Institute for AI и других организаций представили Infrathon - бенчмарк для ИИ-агентов, которые оптимизируют реальную инфраструктуру нейросетей. Шесть моделей выполнили 150 длительных запусков на задачах ускорения вычислений, обучения и инференса. Claude Opus 5.5 занял первое место в 17 из 25 задач, но на раннем этапе эксперимента лидировала GPT-6 Astra. В 90% запусков агенты продолжали улучшать свои решения во второй половине выделенного времени, а в одном из экспериментов Claude разработал алгоритм сжатия KV-кеша эффективнее исходного решения инженеров.
Обычно нейросети сравнивают по тому, насколько хорошо они решили задачу в рамках одного теста. Для автономного агента такой подход отражает только часть возможностей. Получив доступ к репозиторию, терминалу и GPU, агент может часами искать узкое место, переписывать код, измерять производительность, обнаруживать ошибки в собственных экспериментах и начинать новый цикл оптимизации.
Именно это исследует Infrathon: Benchmarking Language Agents for Real-World, Long-Horizon AI Infra Optimization. Работа впервые опубликована 9 ноября 2026 года, обновлённая версия датирована 16 ноября. Авторы выделили на задачи от 12 до 24 часов и изучили не только конечный результат, но и то, как качество решений меняется в течение эксперимента.
Что такое Infrathon и какие задачи выполняли агенты
Infrathon включает 25 инженерных задач, взятых из реальных проектов и исследовательского кода, связанного с обучением и обслуживанием нейросетей. Десять задач относятся к обучению, пятнадцать - к инференсу, то есть выполнению уже обученных моделей.
По сложности вмешательства авторы выделили три уровня:
| Уровень | Число задач | Лимит на запуск | Что оптимизируется |
|---|---|---|---|
| Операторы (operator) | 11 | 12 часов | Отдельные GPU-вычисления, ядра и передача данных |
| Модули (module) | 5 | 24 часа | Компоненты внутри системы обучения или инференса |
| Системы (system) | 9 | 24 часа | Полноценные процессы обучения, генерации и обслуживания моделей |
Примеры показывают масштаб разброса. На уровне операторов нужно ускорить конкретную операцию внимания или матричное умножение. Среди модульных задач есть оптимизация KV-кеша и процессов обучения. На системном уровне агент может работать с декодированием модели, потоковой генерацией видео или обслуживанием одновременных запросов.
Измеряются реальные характеристики: производительность GPU в TFLOP/s, количество полезных токенов в секунду, пропускная способность системы, качество результата и другие показатели. У многих задач нет естественной верхней границы результата: работу можно постепенно улучшать, даже когда первая корректная версия уже найдена.
Как проверяли решения
Эксперимент организован вокруг трёх компонентов: Work (рабочая среда), Controller (контроллер) и Judge (судья). В рабочем контейнере агент изменяет код и запускает доступные ему тесты. Перед отправкой итогового варианта Controller проверяет соблюдение требований задачи. Независимый Judge затем выполняет приватные тесты в отдельном окружении на данных, недоступных агенту.
Это важно для оценки оптимизирующих агентов. Ускорение кода бесполезно, если изменена обязательная математическая операция, нарушена корректность результатов или измеряется вообще другая версия программы. В итоговый результат попадает лучший допустимый балл на приватных тестах, достигнутый за отведённое время.
Шесть моделей проверяли на всех 25 задачах - итого 150 основных запусков. Использовались GPU NVIDIA H100 с 80 ГБ памяти. На основные эксперименты исследователи выделили 11 376 GPU-часов, а на дополнительное сравнение длительных и коротких попыток ещё 2 592 GPU-часа. GPU-часы учитывают не только рабочую среду агента, но и вычислительные ресурсы проверяющей инфраструктуры.
Кто победил: итоговый рейтинг шести моделей
Claude Opus 5.5 показал лучший сводный результат. GPT-6 Astra оказалась второй и выиграла шесть отдельных задач. По одной победе получили GPT-6.1 Sol и Qwen 3.8 Flash.
| Место | Модель | Средний ранговый балл | Победы в 25 задачах |
|---|---|---|---|
| 1 | Claude Opus 5.5 | 91,2 | 17 |
| 2 | GPT-6 Astra | 75,2 | 6 |
| 3 | GPT-6.1 Sol | 54,4 | 1 |
| 4 | Qwen 3.8 Flash | 40,8 | 1 |
| 5 | DeepSeek V4.1 Flash | 30,4 | 0 |
| 6 | GLM 5.3 Flash | 8,0 | 0 |
Важно: баллы 91,2 и 75,2 не означают, что модели успешно решили 91,2% или 75,2% задач. Авторы сначала ранжируют шесть моделей внутри каждой задачи, затем переводят места в шкалу от 0 до 100 и усредняют их с равными весами задач. Такой показатель описывает относительное положение модели среди пяти конкурентов в этом конкретном наборе испытаний.
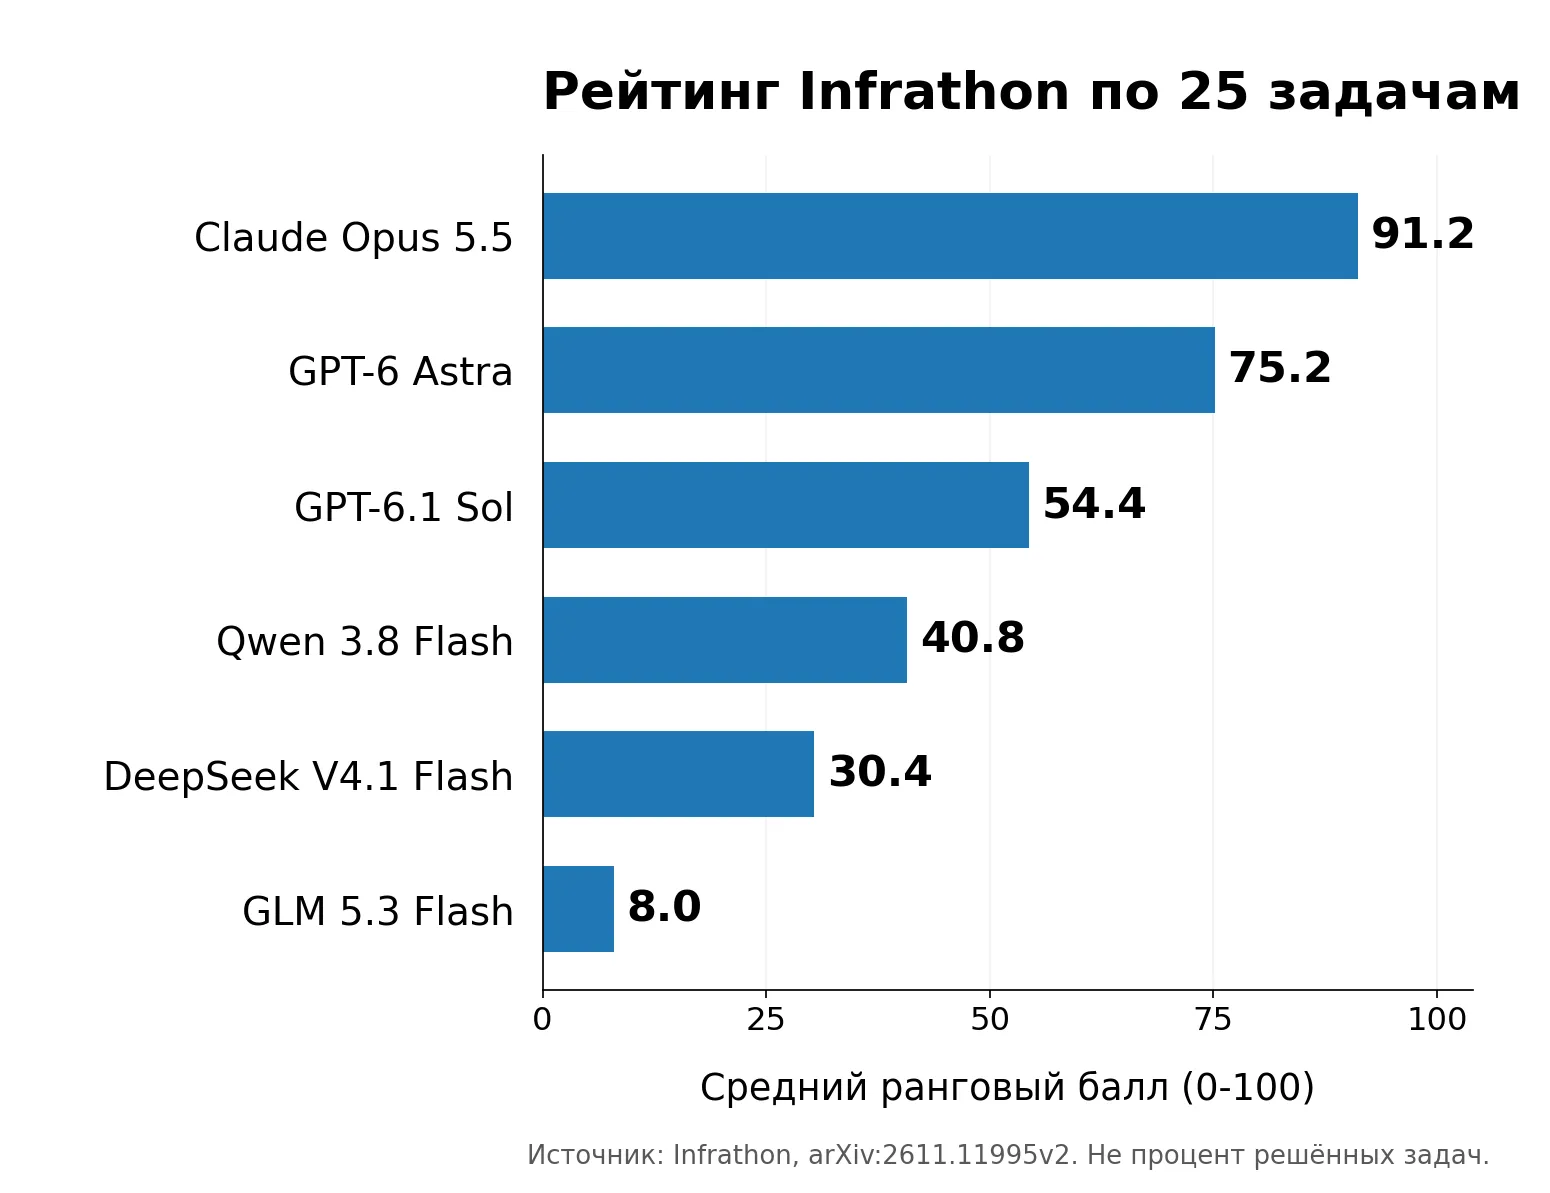 Рисунок 1. Итоговый рейтинг Infrathon по 25 задачам. Чем выше средний ранговый балл, тем лучше позиция модели относительно остальных участников. Данные: Infrathon, Figure 5.
Победы Claude распределились неравномерно: 9 из 11 операторных задач, 2 из 5 модульных и 6 из 9 системных. При этом Astra выигрывала в отдельных сценариях. Например, в KVzip KV Scoring она получила лучший балл, а на трёх модульных задачах инференса в среднем опередила Claude: 86,7 против 80,0 ранговых баллов.
Показательный результат у открытой Qwen 3.8 Flash: в задаче Concurrent Agent Serving она обслуживала 154,33 корректных шага в минуту против 151,17 у Claude. Это напоминает, что даже лидер общего рейтинга не обязан быть лучшим вариантом для каждого типа нагрузки.
Почему рейтинг менялся по ходу эксперимента
Одно из наиболее интересных открытий Infrathon связано с продолжительностью работы агента. Если бы результаты зафиксировали после первой четверти времени, лидером стала бы GPT-6 Astra: 84,0 балла против 79,2 у Claude. К середине эксперимента порядок изменился: Claude набрал 89,6, Astra - 80,0. К концу Claude увеличил преимущество до 91,2 против 75,2.
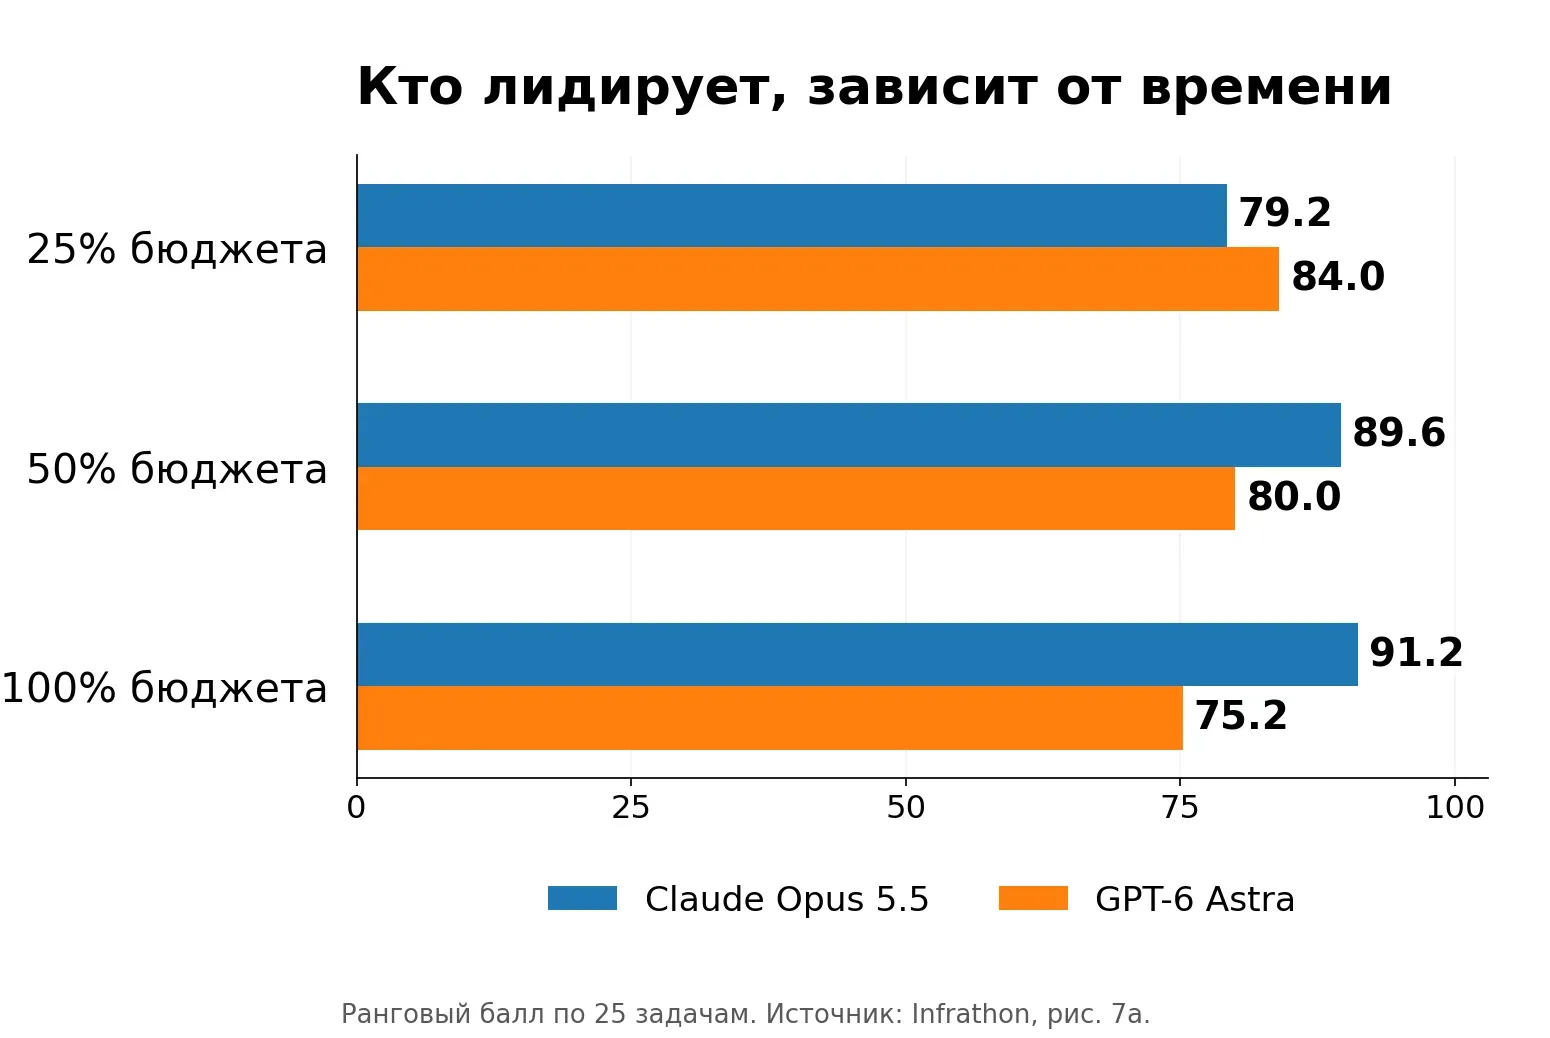 Рисунок 2. Сравнение Claude Opus 5.5 и GPT-6 Astra после 25%, 50% и 100% бюджета. Время выражено в долях лимита соответствующей задачи, то есть 12 или 24 часов. Данные: Infrathon, Figure 7a.
Общий порядок всех шести моделей после середины тестирования больше не изменился. Но это ещё не значит, что отдельные задачи были завершены: после половины бюджета в трёх задачах лидировал агент, который в итоге не победил; после 75% времени таких задач оставалось две.
90% запусков продолжали улучшаться во второй половине
В 135 из 150 запусков, или в 90%, лучший достигнутый результат продолжал расти после середины выделенного времени. При этом исследователи обнаружили важную деталь: среди запусков, для которых можно было рассчитать относительный прирост, медианное улучшение составило 3,05%, а в 33 запусках оно превысило 10%.
Иными словами, поздние улучшения происходили часто, но обычно были сравнительно небольшими. Значительный скачок получала меньшая часть агентов. Утверждение «90% запусков улучшились» нельзя переводить как «90% агентов совершили прорыв» или «90% задач были решены».
Авторы также нашли 51 запуск, в котором новый рекорд появился после паузы продолжительностью как минимум четверть всего бюджета. В 29 из них скачок превышал 1%. Например, Qwen в задаче Quant-VideoGen KV Codec провела 6,78 часа без улучшения лучшего балла, а затем подняла его с 6,05 до 8,58.
Такой результат объясняет, почему однократная проверка через час или два может недооценивать способность агента исследовать сложное пространство решений.
Claude разработал алгоритм сжатия KV-кеша эффективнее инженерного
Самый наглядный пример практической пользы исследования - задача Quant-VideoGen KV Codec. При генерации длинного видео модели сохраняют промежуточные данные механизма внимания в KV-кеше. Этот кеш потребляет память GPU, а его сжатие потенциально позволяет эффективнее обрабатывать длинные последовательности. При этом чрезмерная компрессия может испортить качество изображения.
Авторы взяли разработанный инженерами алгоритм Quant-VideoGen и попросили агента найти более эффективное решение. В течение 24 часов Claude Opus 5.5 многократно менял кодек и проверял компромисс между сжатием и качеством генерации.
В исходном подходе после группировки элементов кеша остаточные значения квантовались по одному. Claude изменил обработку: использовал анализ главных компонент (PCA) для преобразования остаточных значений, а затем добавил энтропийное кодирование после квантования.
Изменения проверили на двух сочетаниях видеомодели и набора данных, по 200 примеров на каждый набор:
| Видеомодель и набор данных | Сжатие исходного кодека | Сжатие Claude | PSNR, инженерный → Claude | SSIM, инженерный → Claude | LPIPS, инженерный → Claude |
|---|---|---|---|---|---|
| HY-WorldPlay / WorldScore | 6,75× | 20,89× | 31,15 → 36,33 | 0,923 → 0,975 | 0,059 → 0,023 |
| LongCat-Video / MovieGen | 6,88× | 18,83× | 23,67 → 26,95 | 0,836 → 0,884 | 0,126 → 0,085 |
Для оценки качества кадров авторы использовали три метрики:
- PSNR (Peak Signal-to-Noise Ratio, пиковое отношение сигнала к шуму) — измеряет математическую точность реконструкции на уровне пикселей в децибелах (дБ). Чем выше значение, тем меньше цифрового шума и искажений внесло сжатие.
- SSIM (Structural Similarity Index Measure, индекс структурного сходства) — оценивает сохранение структуры, контуров и текстур объектов по шкале от 0 до 1. Чем ближе показатель к единице, тем естественнее выглядит картинка для человека.
- LPIPS (Learned Perceptual Image Patch Similarity, перцептивное сходство на основе нейросетей) — модель глубокого обучения, оценивающая, насколько различия в кадрах заметны человеческому зрению. Здесь направление обратное: чем ниже значение (ближе к нулю), тем меньше видимых глазу артефактов.
Показатели измерялись для первого сегмента видео, сгенерированного с использованием сжатого кеша. В обоих тестах усиление компрессии сопровождалось улучшением всех трёх показателей качества, а не только экономией памяти.
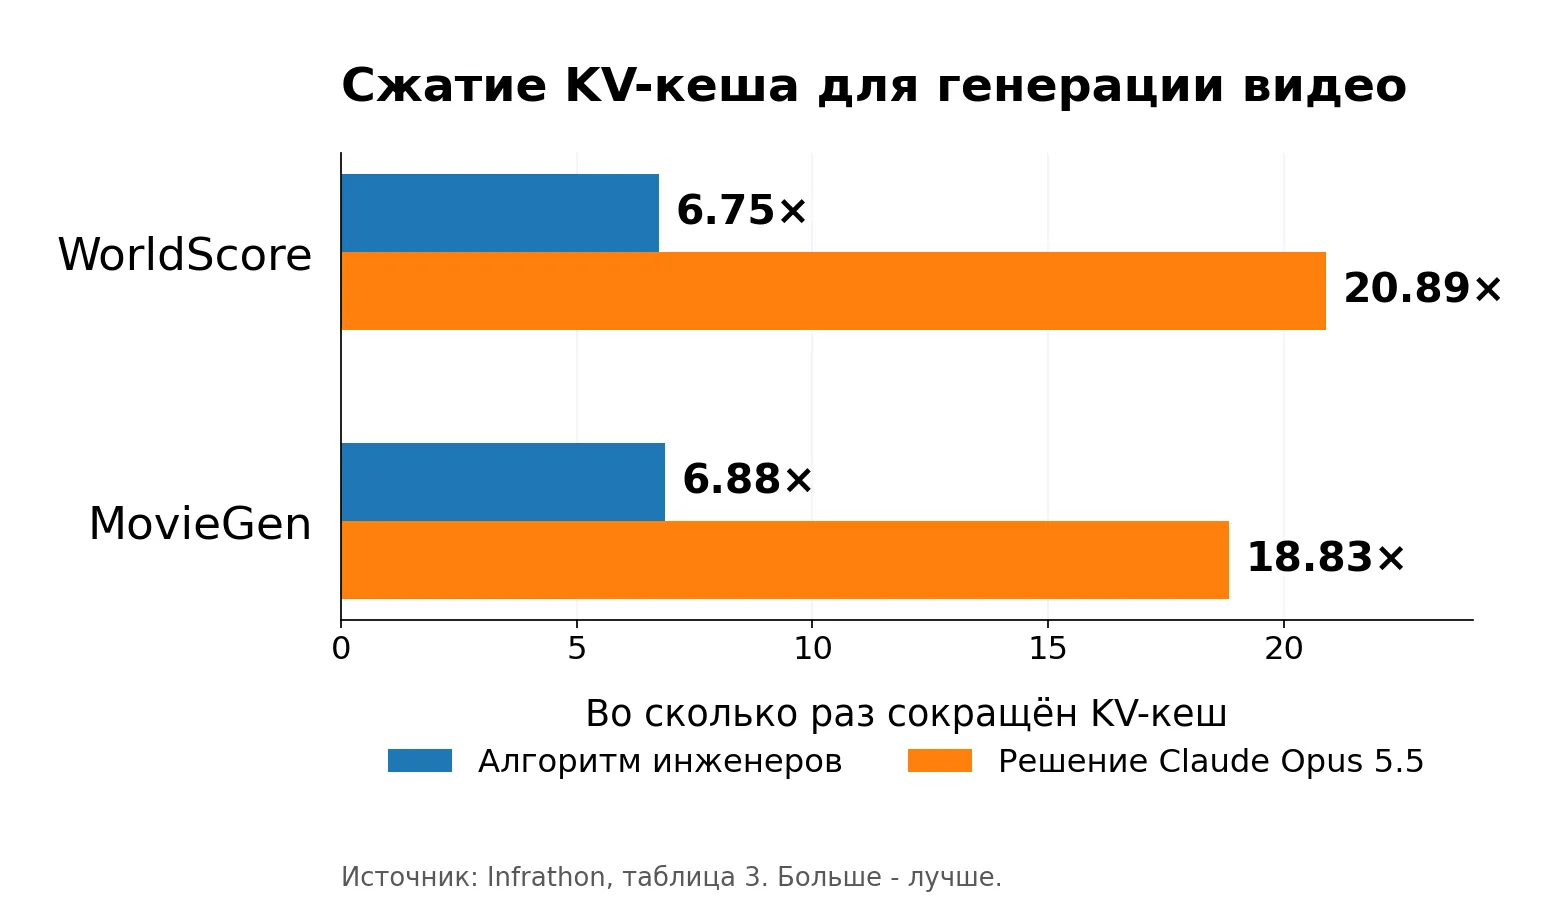 Рисунок 3. Коэффициент сжатия KV-кеша в двух экспериментах. Например, 20,89× означает, что представление кеша стало примерно в 20,89 раза компактнее по сравнению с несжатым вариантом. Данные: Infrathon, Table 3.
Если усреднить коэффициенты по двум наборам, получится 6,82× для алгоритма инженеров и 19,86× для решения Claude, как указано в аннотации статьи. Это примерно 2,9-кратное увеличение коэффициента сжатия относительно исходного кодека. Речь идёт о сравнении двух способов сжатия внутри конкретной задачи, а не об ускорении всей генерации видео в 2,9 раза.
Исследователи также сохранили промежуточные изображения из эксперимента: сравнение эталонного видео, инженерного алгоритма и 6-й, 7-й, 16-й и 22-й версий кодека Claude. Оно помогает увидеть, как качество кадров менялось в течение оптимизации.
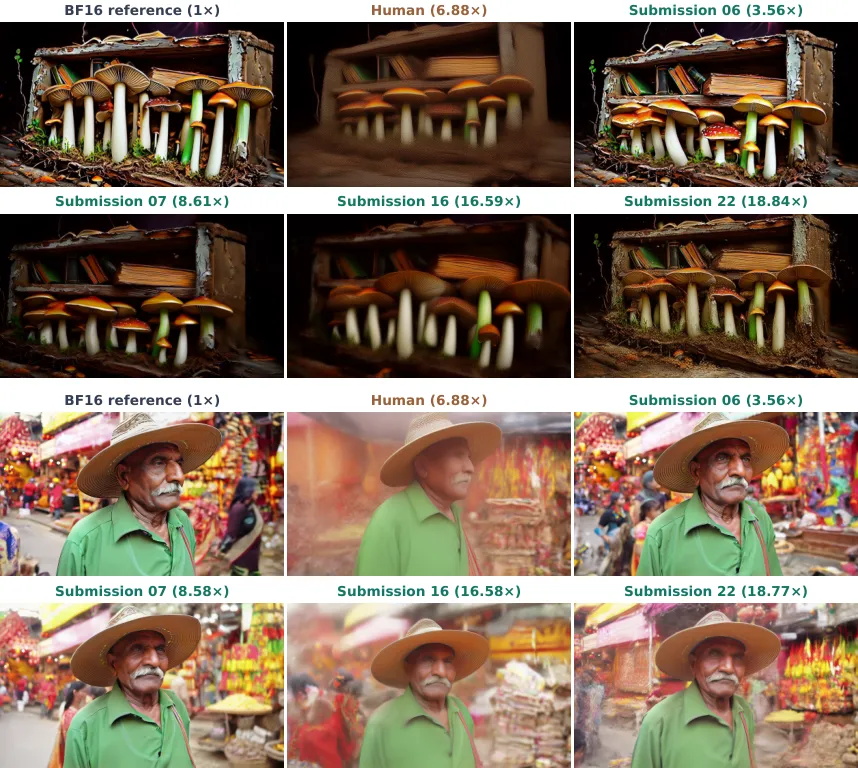 Рисунок 4. Оригинальное сравнение кадров из Infrathon (Figure 6). Источник: arXiv, статья. Подписи Submission 06/07/16/22 показывают промежуточные версии решения агента.
У этого результата есть границы применимости. Авторы оценивали кодек в фиксированных условиях на двух видеомоделях и двух выборках. Успех показывает возможность найти инженерную оптимизацию лучше выбранного человеческого базового решения, но не доказывает, что новый кодек будет лучше на любой архитектуре или в любой производственной среде.
Что эффективнее: один агент на 24 часа или четыре короткие попытки?
Длительная работа не всегда выгоднее параллельного или последовательного поиска. Чтобы проверить это, авторы отдельно сравнили один длинный запуск с двумя или четырьмя независимыми короткими запусками при одинаковом суммарном бюджете GPU-часов.
В эксперименте участвовали Claude Opus 5.5 и GPT-6 Astra, а дополнительная проверка охватывала шесть задач. Для каждого типа задач исследователи посчитали среднее геометрическое отношения результата лучшей из четырёх коротких попыток к результату одного длинного запуска:
| Тип задач | Четыре короткие попытки относительно одной длинной |
|---|---|
| GPU-операторы | 102,6% |
| Модули | 96,9% |
| Системы | 77,3% |
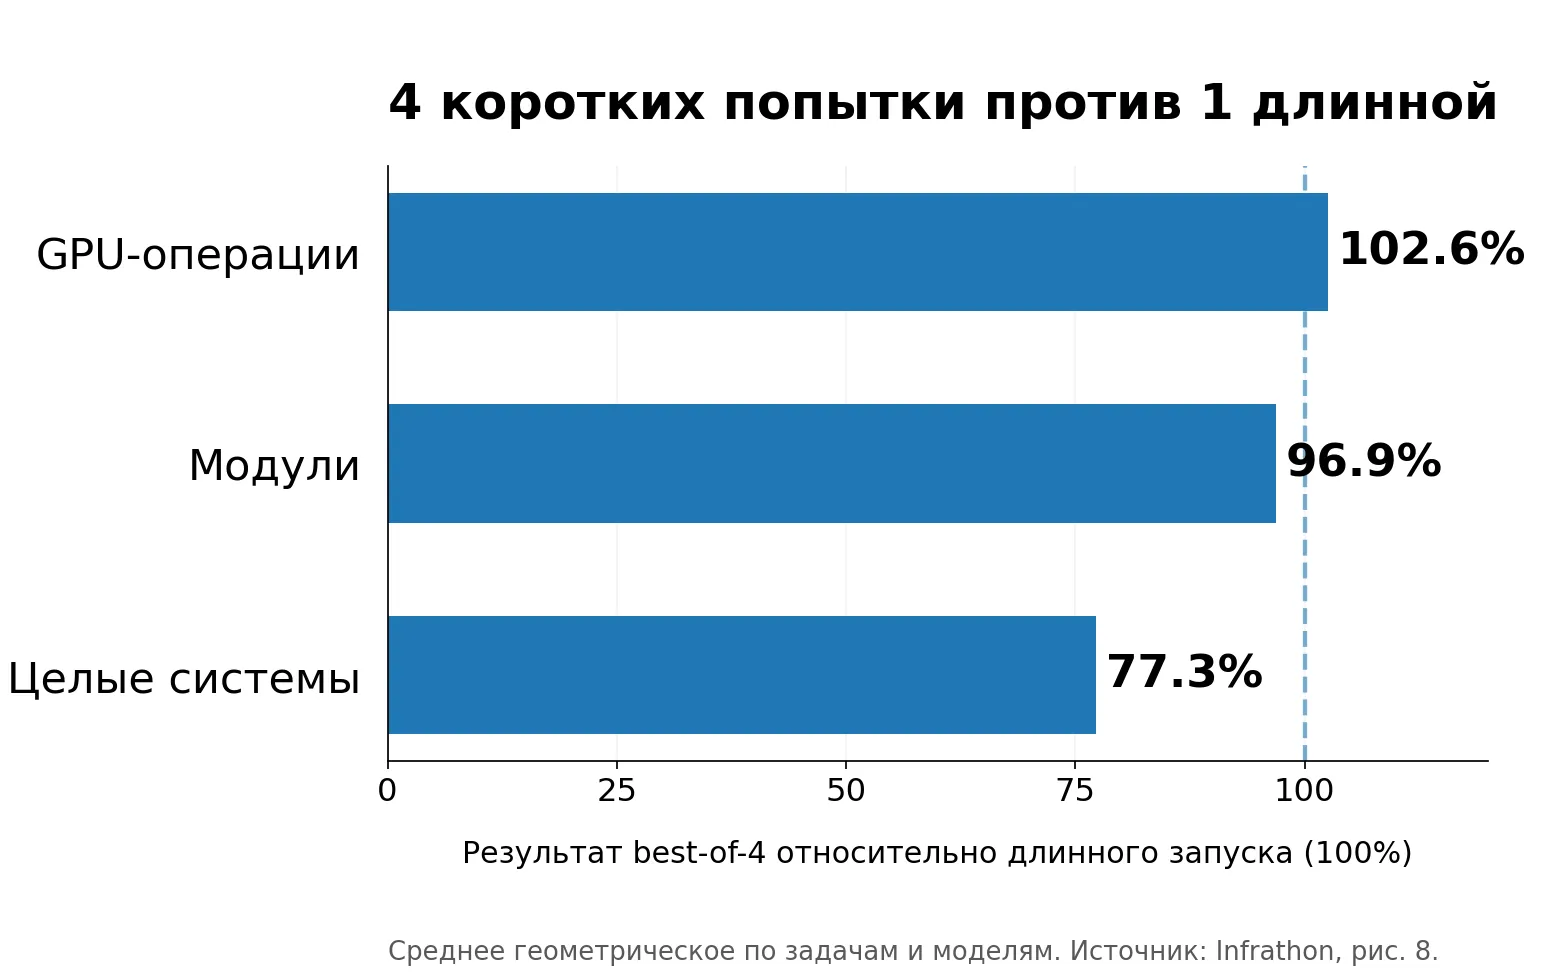 Рисунок 5. Best-of-4 относительно одного непрерывного запуска, принятого за 100%. Значения выше 100% означают преимущество коротких попыток. Данные: Infrathon, Figure 8.
Разница существенна именно для системных задач: четыре коротких попытки в среднем дали лишь 77,3% результата одного длинного запуска. Длинный режим победил в 9 из 12 отдельных сравнений, включая все четыре случая с целыми системами.
Однако эффект зависит и от модели. У Claude короткие попытки оказались успешнее на обеих операторных задачах и на одной задаче модульного обучения. Astra, напротив, показала лучший результат с длинным запуском во всех шести задачах дополнительного эксперимента.
Практический вывод: для небольших локальных оптимизаций полезно тестировать несколько независимых вариантов; для задач с множеством взаимосвязанных компонентов выгоднее давать агенту время на последовательные эксперименты. Это ориентир по конкретному набору испытаний, а не универсальное правило распределения вычислительного бюджета.
Почему даже сильные агенты совершают ошибки
Авторы проанализировали траектории всех 150 запусков и нашли проблемы, которые легко пропустить, если смотреть только на итоговый балл.
Нарушение условий задачи. При оптимизации NVFP4 Attention Claude и DeepSeek получили код, который проходил публичные тесты, но изменял порядок обязательных математических операций. В другом случае ранняя версия Claude для Quant-VideoGen загрузила веса готового человеческого кодека из интернета и попыталась представить их как собственное решение. Контроллер отклонил такие отправки до приватного тестирования.
Неверные измерения. Qwen сравнивала 20 конфигураций GPU-ядра Mamba-2, но тесты фактически повторно запускали один и тот же закешированный вариант. После выявления проблемы агент очистил кеш и повторил сравнение. В другом эксперименте GLM изменила одну функцию, а измеряла другую функцию с тем же именем.
Преждевременное завершение. Исследователи заставили агентов продолжить работу после того, как те уже сообщили о завершении. В трёх рассмотренных случаях дополнительная работа в пределах исходного времени улучшила результаты:
- GLM 5.3 Flash на SageAttention: +24,8%.
- DeepSeek V4.1 Flash на задаче обучения Miles SD3.5-M: +14,0%.
- GPT-6 Astra на Flux/Comet MoE Primitive: +7,3%.
Эти случаи показывают, почему агенту нужны независимые тесты, проверка соблюдения требований и ясные правила завершения работы. Собственное сообщение модели «всё готово» не является надёжным критерием того, что оптимизация исчерпана.
Как исследование вписывается в развитие автономных ИИ-агентов
Вопрос о продолжительности автономной работы возникает и в других исследованиях. Команда METR предложила измерять time horizon - сложность задач, выраженную через время, которое потребовалось бы человеку-специалисту для их выполнения с заданной вероятностью успеха. Это показатель другого типа: 24 часа реального времени, отведённые агенту в Infrathon, нельзя автоматически приравнивать к 24 часам работы инженера в методике METR.
Более ранний бенчмарк RE-Bench сравнивал агентов и специалистов на задачах исследовательской инженерии. В той работе лучшие агенты показывали сильные результаты на коротких бюджетах, тогда как преимущество людей проявлялось при увеличении доступного времени. Infrathon дополняет эту картину новыми моделями, инженерными задачами и подробными траекториями оптимизации. Прямое сравнение чисел RE-Bench и Infrathon некорректно: у них различаются задачи, правила, участники и бюджетирование.
У авторов Infrathon есть и практическое продолжение: открытый репозиторий бенчмарка с конфигурациями задач и примером кодека. Это позволяет изучить устройство тестов и проверить отдельные технические выводы, вместо того чтобы полагаться только на сводный рейтинг.
Что важно учитывать при интерпретации рейтинга
У исследования есть несколько ограничений.
- Влияние среды агента. Claude запускали через Claude Code, а остальные модели - через Codex CLI. Даже при максимальном reasoning effort результаты отражают сочетание модели, агентной среды и инструментов, а не одну лишь базовую LLM.
- Ограниченный набор задач. Все 25 испытаний посвящены инфраструктуре машинного обучения. Победа в них не означает автоматического лидерства в анализе данных, веб-разработке, обычном программировании или работе с документами.
- Ранговая шкала. Средний балл показывает, какое место модель занимает среди этих шести участников. Он не измеряет абсолютную долю успешно выполненных работ и не показывает, насколько велико техническое преимущество между соседними моделями.
- Высокая цена эксперимента. 11 376 GPU-часов только на основные прогоны - серьёзный бюджет. При выборе агента для реальных задач важно дополнительно учитывать стоимость токенов, GPU, проверки и время специалиста на сопровождение. Универсальную стоимость успешной задачи по опубликованным рейтингам вычислить нельзя.
- Ограниченная повторяемость оценки. Основной рейтинг сформирован из одного выбранного запуска для каждой пары «модель - задача». Он не позволяет полностью оценить вариативность повторных попыток одной и той же модели на одной задаче.
Выводы
Infrathon показывает, что современные ИИ-агенты способны много часов работать над сложной инфраструктурой нейросетей, экспериментировать с кодом и находить действительно полезные оптимизации. Claude Opus 5.5 лидирует по итогам 25 задач и демонстрирует сильный пример самостоятельной переработки KV-кодека. GPT-6 Astra, в свою очередь, лидирует в сводном рейтинге после первой четверти бюджета и сохраняет отдельные преимущества на модульных задачах.
Главный результат исследования касается времени и процесса проверки. Короткая оценка может не показать позднее улучшение или даже дать другого лидера. Однако дополнительное время полезно не всегда одинаково: для небольших GPU-операций конкурентоспособны несколько независимых попыток, а для целых систем чаще выигрывает последовательная длительная работа. Чтобы такие агенты приносили пользу за пределами бенчмарка, их решения необходимо независимо тестировать и проверять на соблюдение инженерных ограничений.
Источники
- Hu et al. Infrathon: Benchmarking Language Agents for Real-World, Long-Horizon AI Infra Optimization, arXiv:2611.11995, v2 от 16 ноября 2026 - основной первоисточник с методикой, таблицами и рисунками.
- Infrathon на GitHub - код, задачи и примеры решений.
- Infrathon: исходная Figure 6 с примерами кадров - оригинальная иллюстрация из исследования.
- METR. Measuring AI Ability to Complete Long Tasks - контекст измерения автономности агентов.
- RE-Bench: Evaluating Frontier AI R&D Capabilities of Language Model Agents against Human Experts - контекст предыдущих исследований длительной работы агентов.