
Perplexity представила новый режим Multiagent в сервисе Computer. Теперь одна задача может выполняться командой из до 16 вспомогательных ИИ-агентов, использующих разные ведущие языковые модели. В стандартной конфигурации за планирование отвечает Claude Fable 5.2, а среди вспомогательных моделей указаны Claude Opus 5.5, GPT-6.1 Sol и Gemini 4 Carbon. Агенты могут параллельно изучать проблему, передавать результаты друг другу, проверять выводы коллег и вместе работать над файлами.
Сервис доступен подписчикам Perplexity Max через веб-интерфейс Computer. Это новый уровень усилий (effort level) выше Ultra. Для пользователя работа выглядит как единая беседа с ведущим агентом, который организует команду и представляет окончательный ответ.
Зачем объединять разные модели
Современные флагманские нейросети имеют разные сильные стороны. Одна может эффективнее разбирать документы и длинный контекст, другая - создавать и тестировать код, третья - сопоставлять источники и находить противоречия. Одна мощная модель, последовательно выполняющая все этапы сложного задания, ограничена собственными ошибками, контекстом и временем на выполнение.
Multiagent использует разделение труда. Ведущий агент определяет подзадачи, часть поручает другим моделям, часть может выполнять сам. Для комплексного финансового отчёта это может означать параллельный анализ выручки, расходов, договоров и альтернативных сценариев. Далее агенты сравнивают исходные данные и сообщают друг другу об изменениях. Финальное объединение выполняет ведущий агент.
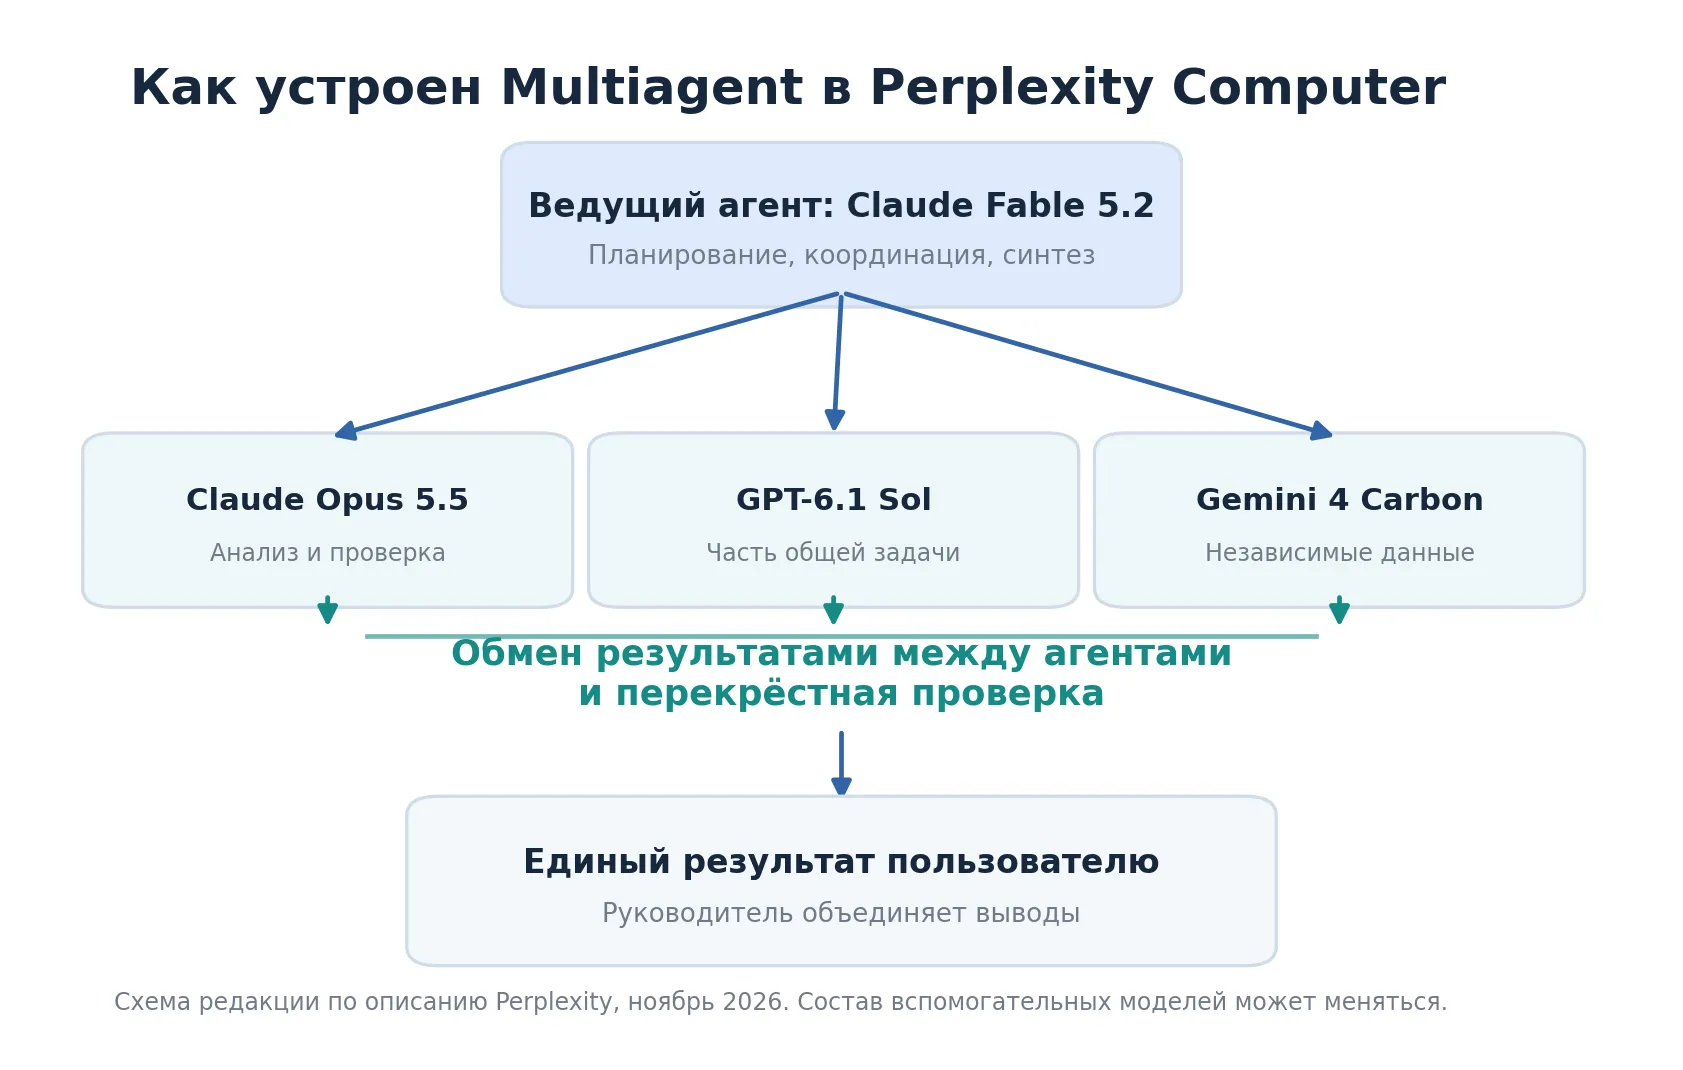
Иллюстрация 1. Упрощённая схема стандартной конфигурации Perplexity Multiagent. Состав команды и число реально запущенных агентов зависят от задачи. Источник: Perplexity.
Важно различать количество моделей и количество агентов. «До 16 агентов» не означает 16 разных LLM. Несколько экземпляров могут работать на одной модели, и для простой задачи система вовсе не обязана задействовать максимальное число участников.
Как устроено взаимодействие
Согласно официальному описанию Perplexity, роль руководителя исполняет Claude Fable 5.2. Он разбивает задачу, определяет подходящих исполнителей, сохраняет контекст и собирает итоговый результат. По умолчанию вспомогательные агенты работают на Opus 5.5, GPT-6.1 Sol и Gemini 4 Carbon. При необходимости пользователь может запросить другие модели; в статье Perplexity отдельно упоминаются Fable 5.2 и GPT-6 Astra как дополнительные варианты.
Главное техническое отличие от обычной схемы делегирования - горизонтальная коммуникация. Агент, который анализирует коммерческие договоры, может передать финансовому агенту поправку к выручке. Тот пересчитывает модель и сообщает результаты третьему участнику, ответственному за выводы. Информация проходит не только через руководителя.
По заявлению компании, участники команды координируют и правки в общих файлах. Ведущий агент остаётся единой точкой контакта: пользователь не должен писать отдельные промпты каждому исполнителю. Если человек уточняет исходные условия, изменения могут быть переданы тем агентам, на чью работу они влияют. Остановка задачи останавливает всю команду.
Multiagent, Ultra и Model Council: в чём разница
В Computer уже использовались режимы Ultra и Model Council, но они решают разные задачи.
| Режим | Как распределяется работа | Для каких заданий подходит |
|---|---|---|
| Ultra | Ведущий агент делегирует части задачи, исполнители отчитываются ему | Исследование с несколькими самостоятельными направлениями |
| Multiagent | Вспомогательные агенты напрямую обмениваются выводами, спорят и редактируют общие результаты | Проекты, где подзадачи взаимосвязаны и требуют согласования |
| Model Council | Несколько моделей независимо отвечают на один и тот же вопрос; итог сопоставляется | Решения, для которых важны разные независимые точки зрения |
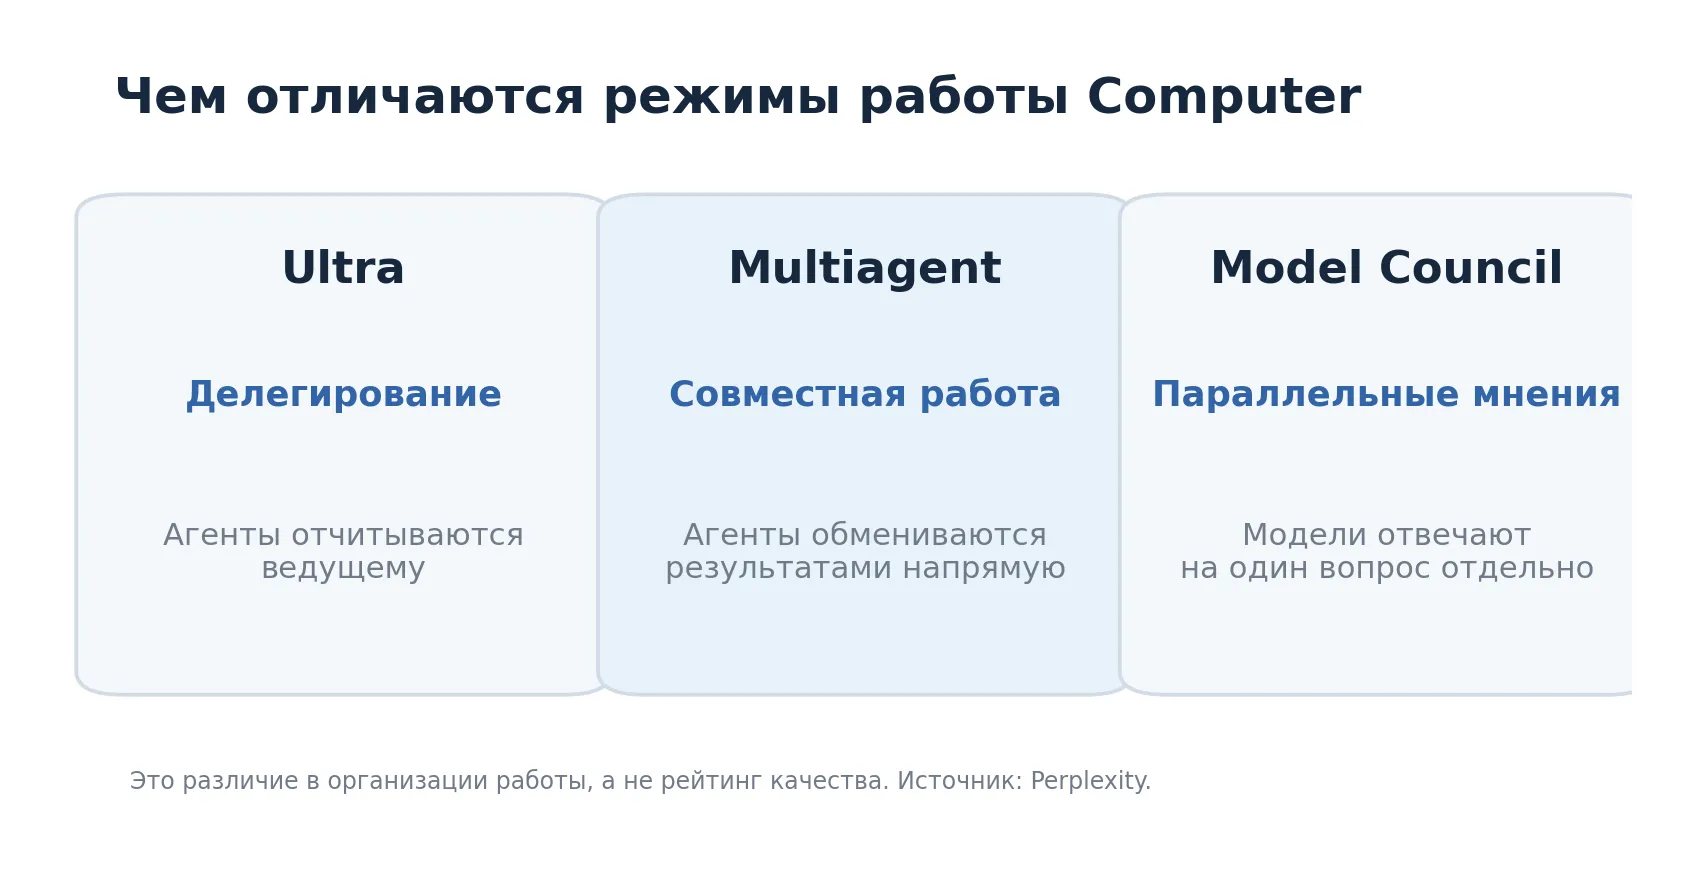
Иллюстрация 2. Три способа организовать работу ИИ. Это различие процессов, а не сравнение качества моделей.
Если нужно получить независимые оценки одной гипотезы, интереснее Model Council. Если требуется большой отчёт с зависимостями между его частями, у Multiagent больше возможностей для согласования. Ultra остаётся альтернативой для задач, где общей координации через ведущего исполнителя достаточно.
Какие задачи компания предлагает решать
В пресс-материале приведены пять основных сценариев. Первый - финансовое моделирование, когда разные агенты строят варианты прогноза, сравнивают допущения и оценивают влияние изменения выручки или расходов. Второй - аудит годовой отчётности с проверкой цифр в отчётах, сносках и комментариях руководства.
Третий сценарий - глубокое исследование спорного вопроса: участники ищут конкурирующие объяснения и проверяют, какие доказательства действительно поддерживают каждое. Четвёртый - due diligence, проверка большого массива документов перед сделкой, когда договоры могут менять ранее сделанный финансовый прогноз. Пятый - налоговое планирование, где система готовит варианты и список вопросов для профессионального консультанта.
Особенно важна первая группа: задачи с разными источниками данных и взаимосвязанными расчётами. В них ошибки часто возникают на стыках, например когда аналитик обновил финансовую предпосылку, а другой раздел отчёта продолжает использовать старое значение. Возможность обмениваться обновлениями потенциально уменьшает число таких несоответствий.
Дают ли 16 агентов лучшие ответы?
Теоретически перекрёстная проверка способна выявить ошибку, пропущенную одним исполнителем. Но существуют и обратные риски. Агенты могут повторять одинаковые заблуждения, ссылаться друг на друга вместо первоисточника, закреплять неверные предпосылки или тратить слишком много времени на согласование деталей. Если руководитель неверно сформулировал задачу, увеличение команды не исправит исходную ошибку.
Отдельный вопрос - стоимость. Параллельные исследования, повторное чтение документов и межагентные сообщения расходуют дополнительные токены и вычисления. Для Multiagent нельзя автоматически ожидать сокращения бюджета. Важен итоговый показатель: сколько стоит один проверенный результат, включая исправления, ожидание и работу человека. Perplexity не опубликовала в анонсе универсального числа, которое позволяло бы честно утверждать, что команда из 16 агентов эффективнее одного на определённый процент.
Есть и риск потери независимости. Если агенты рано обмениваются промежуточными выводами, ошибка одного может повлиять на остальных. Поэтому архитектура Model Council, где модели изначально работают отдельно, иногда методологически предпочтительнее. Multiagent особенно полезен там, где требуется именно совместная работа над взаимосвязанным результатом.
Контекст: индустрия переходит к оркестрации моделей
Perplexity развивает Computer как рабочую среду, в которой ИИ выполняет длительные задания с файлами, поиском, кодом и внешними сервисами. Новый режим продолжает общий тренд: интерфейс всё чаще скрывает от пользователя выбор конкретной LLM, а система подбирает модель и рабочий процесс для каждой подзадачи. Похожие архитектуры используют агентные оркестраторы для программирования, анализа данных и исследовательских задач.
Однако конкуренция смещается с результатов одной нейросети в бенчмарке к качеству всего агентного процесса. Надёжность инструментов, координация, доступ к данным, проверка источников и восстановление после ошибки становятся не менее значимыми, чем размер или рейтинг базовой модели.
Как попробовать и на что смотреть
Чтобы включить функцию, подписчик Perplexity Max должен открыть Computer в браузере и выбрать Multiagent в настройке уровня усилий. Во время работы сервис показывает активных агентов и используемые модели. Для первого теста стоит выбрать одну задачу с несколькими взаимосвязанными частями: например, анализ финансового отчёта с проверкой первичных документов, расчётом сценариев и единым итоговым файлом.
Проверять стоит не впечатляющее число агентов в интерфейсе, а точность цифр, полноту ссылок, отсутствие противоречий между разделами и стоимость получения принятого результата. Именно эти параметры покажут, превращается ли координация нескольких флагманов в реальную пользу.