
Представь, что тебе выдали газету за 24 декабря 2025 года и попросили расписать, что случится до конца марта. Каждый день приносят свежий номер, и ты можешь передумать: переписать проценты, признать, что вчера нёс чушь, поставить на другого. В конце тебе показывают ответы - и оценивают не число попаданий, а то, насколько твоя уверенность совпала с реальностью. Уверенно врал - минус. Молчал - ноль. Угадал и не сомневался - единица.
Именно так устроен FutureSim - тест, который придумали Шашват Гоэл, Нихил Чандак и Арвинд Арун с коллегами из ELLIS Tübingen, Института интеллектуальных систем Общества Макса Планка и Штутгартского университета. Работа вышла в мае 2026-го и взяла Best Paper на воркшопе по прогнозированию в рамках ICML 2026. 15 ноября авторы выложили результаты третьего квартала, и они интереснее, чем просто строчка в лидерборде: лучшая модель даёт там 50% точности против 25% в первом прогоне, хотя набор вопросов другой и сравнивать напрямую нельзя.
Это хроника, а не хрустальный шар
Первое, что нужно понять: агент не предсказывает будущее. Мир отматывают назад, к 24 декабря 2025-го, и прокручивают вперёд по одному дню. Новости приходят порциями, вопросы закрываются, а правильные ответы у исследователей уже есть - события отобрали из тех, что случились между январём и мартом.
Чтобы это не превратилось в подсказку, в тесте стоит дата-гейт. Корпус собран из Common Crawl News: 7,36 миллиона статей из 141 источника, за 88 дней симуляции к ним добавляется ещё 244 тысячи. Статью, вышедшую позже текущего дня симуляции, агент не достанет - ни поиском, ни терминалом, ни уговорами.
Действий у него всего два: submit_forecasts() - поставить или переписать вероятности, и next_day() - перейти к следующему дню. Что прогнозировать, сколько раз обновлять, когда двигаться дальше - решает сам агент. В этом весь смысл: проверяется не «умеет ли модель отвечать», а «умеет ли она вовремя менять ответ».
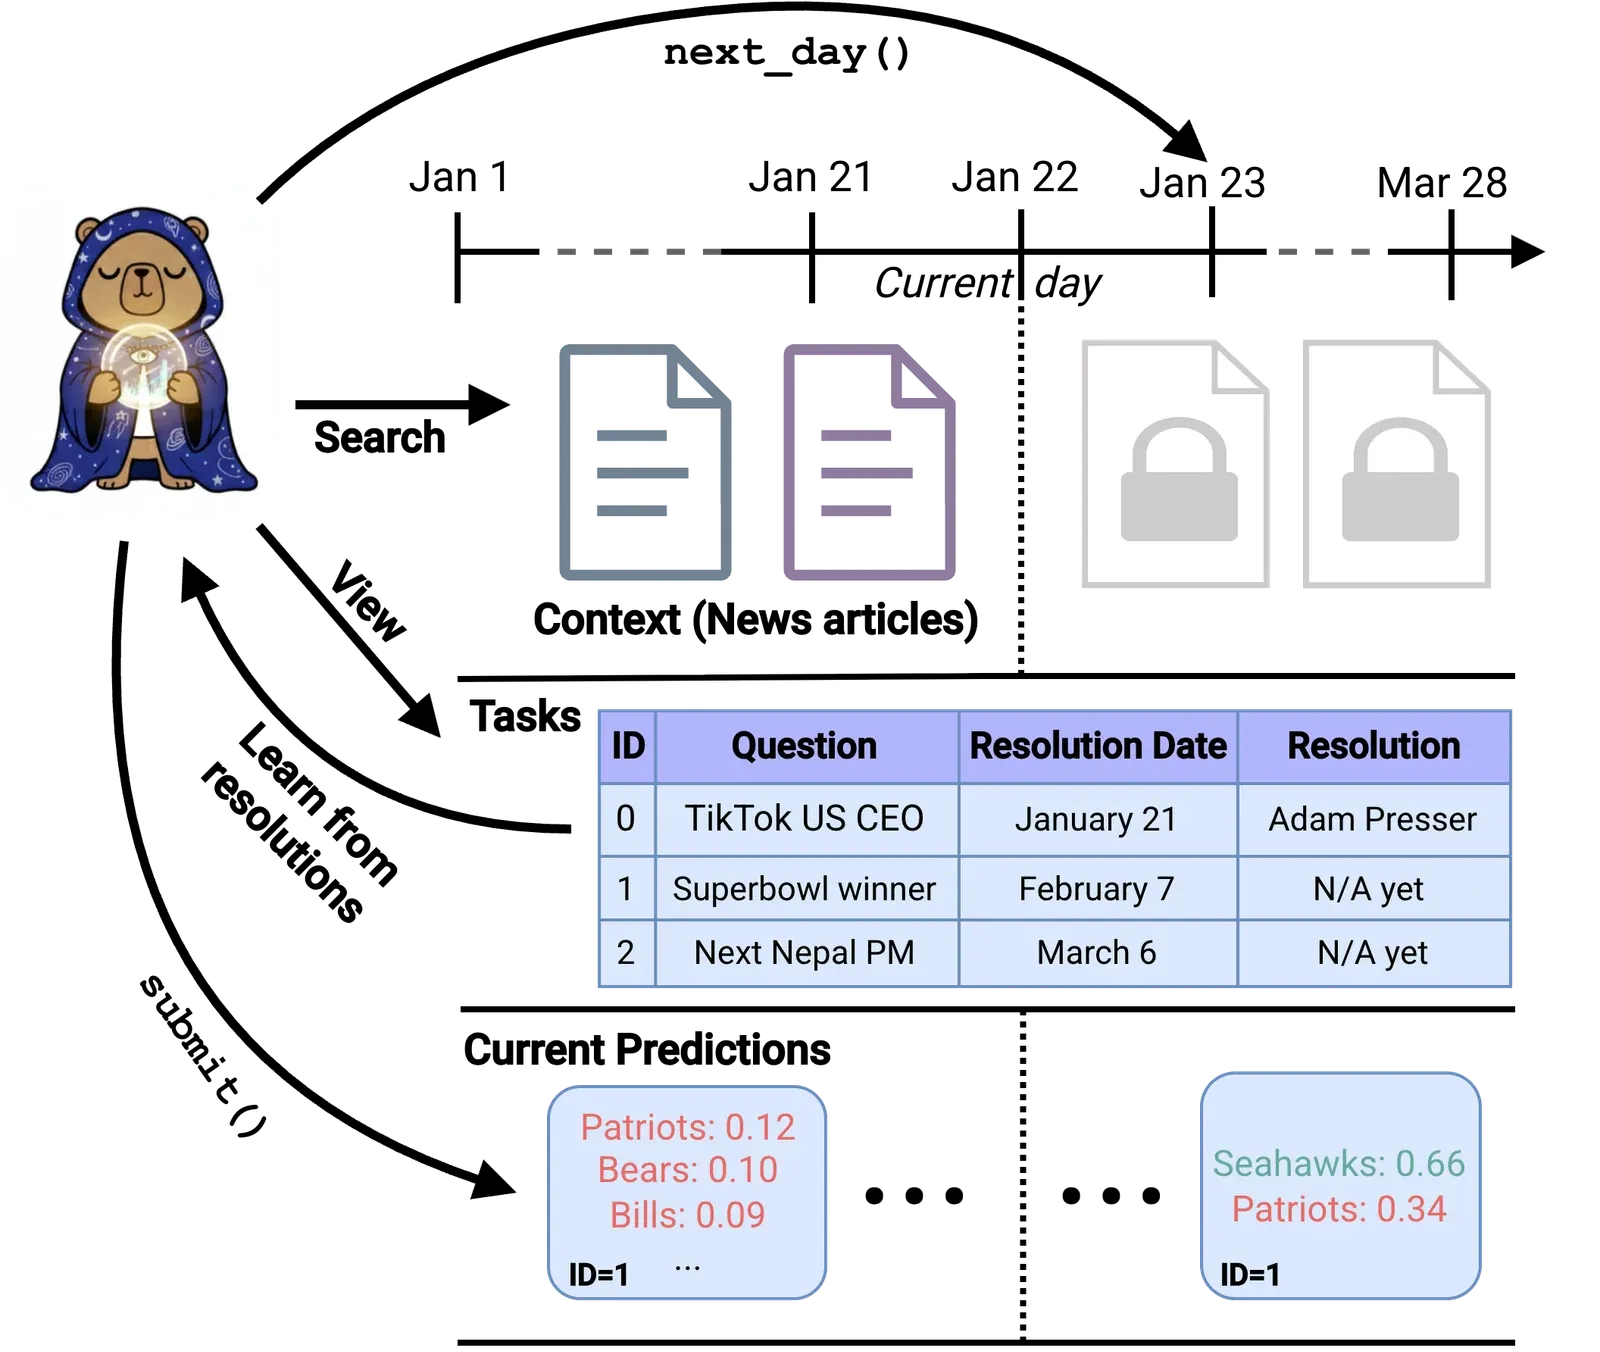
Схема: FutureSim. По ней видно, почему это не викторина: прогноз можно менять, пока не перешёл к следующему дню, а правильный ответ появляется в таблице задач только с наступлением даты резолюции - до неё там стоит «N/A yet». Справа от пунктира - то, что агенту ещё недоступно: и статьи, и ответы.
330 вопросов, 88 дней и 25%
Первый набор - 330 коротких вопросов, собранных из новостей Al Jazeera. Агент сам придумывает варианты исходов: не «да/нет», а список кандидатов с вероятностями, как у букмекера, только вместо коэффициентов проценты.
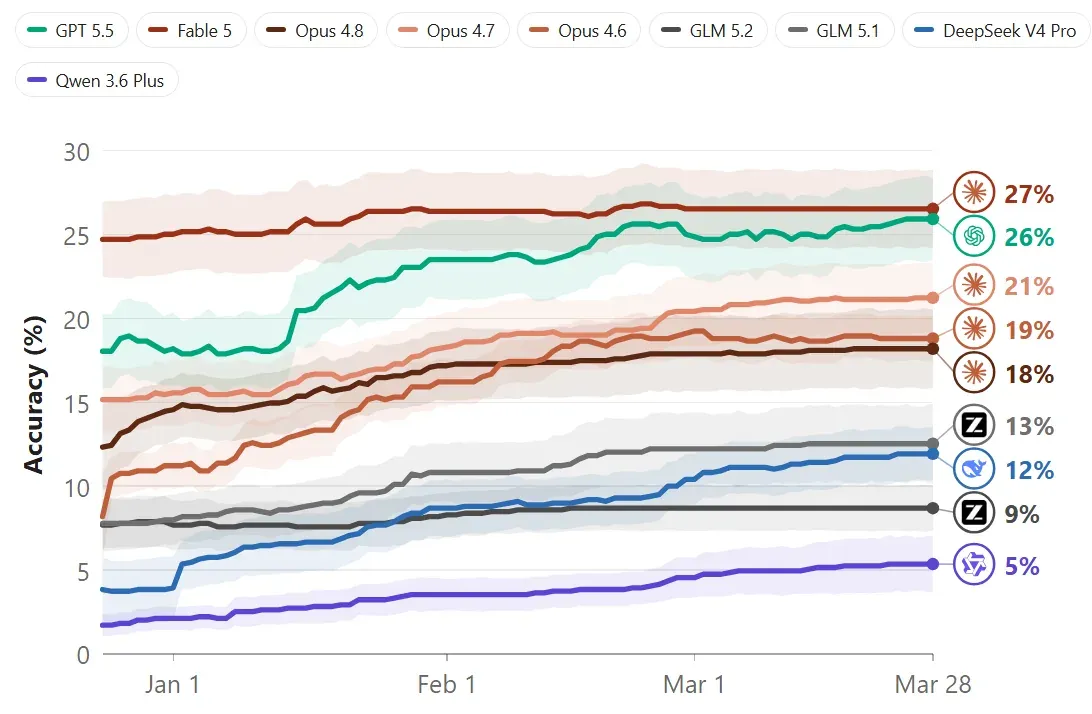
График: FutureSim, снимок 16 ноября 2026. По вертикали - точность в процентах: к 28 марта у лидера 27%, у нижней модели - 5%. В статье arXiv для лучшего агента указано 25%: цифра из препринта и цифра обновлённого лидерборда немного расходятся, и в заголовке стоит опубликованное значение.
Дальше считается Brier skill score. Формула простая: для каждого варианта берётся разница между заявленной вероятностью и фактом (единица, если вариант верный, ноль, если нет), возводится в квадрат и складывается. Результат вычитается из единицы. Единица - уверенно и правильно. Ноль - промолчать. Минус - уверенно ошибиться.
И вот здесь начинается самое интересное. В первом прогоне лучший агент дал 25% точности - то есть в четверти вопросов вариант с максимальной вероятностью оказался верным. А многие модели ушли в минус: их Brier skill score оказался ниже нуля, то есть хуже, чем не прогнозировать вообще.
Почему «хуже нуля» - это не парадокс
На первый взгляд звучит абсурдно: как можно ошибиться хуже, чем не отвечать? Разве не «0% попаданий» - это дно?
Нет. Ноль в этой шкале - не «ни одного попадания», а конкретный поступок: не поставить ни одной вероятности. Тогда штраф начисляется только за правильный ответ, который получил ноль. Разница с единицей - единица, в квадрате - единица. Балл = 1 − 1 = 0. Точка отсчёта «я промолчал».
А теперь модель ставит 0,8 на вариант B и 0,3 на вариант A, и правильным оказывается A. Штраф: 0,8² + (0,3 − 1)² = 0,64 + 0,49 = 1,13. Балл: −0,13. Она не просто ошиблась - она потратила уверенность зря, и промолчать было бы честнее. Причём вероятности не обязаны в сумме давать единицу, поэтому можно уверенно поставить сразу на два неверных варианта и уйти в минус ещё глубже.
Отсюда главный вывод теста, который важнее любой таблицы: проблема не в том, что модели мало знают. Проблема в том, что они не чувствуют границы своего знания. Ставят 80%, когда надо ставить 30%, и не пересматривают оценку, когда приходит новая порция новостей.
Отдельный эксперимент это подтвердил с другой стороны. Всем агентам дали одинаковый слабый стартовый прогноз - и ни один не обогнал нулевой уровень. События вокруг менялись, новости приходили, а модели цеплялись за первую версию. Менять мнение - навык, которого у них не было.
Второй квартал: калибровка есть, адаптации нет
Прогон по событиям апреля-июня снова перевернул картину. Лучший по точности - GPT 5.6 Sol: 31% к 28 июня, при том что начинал с 15%. Почти весь прирост он набрал по ходу симуляции, а не за счёт стартовых знаний.
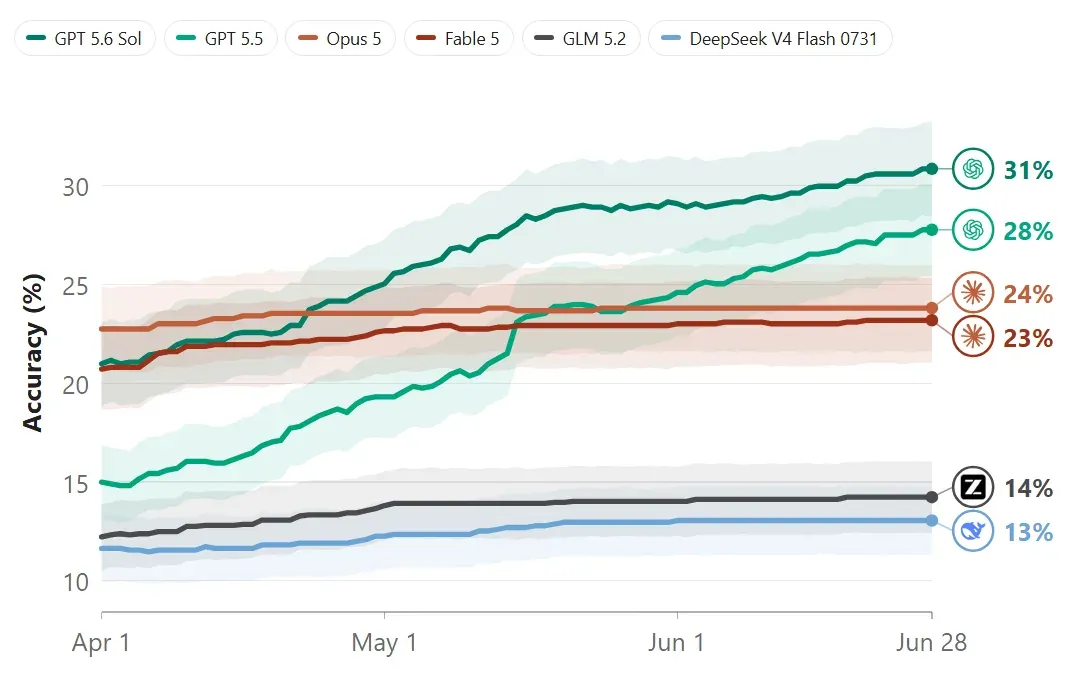
График: FutureSim, снимок 16 ноября 2026. По вертикали - точность в процентах. Видно две разные стратегии: у Claude старт выше, но линия почти горизонтальная, а у GPT старт низкий и рост крутой - к середине симуляции GPT обогнал Claude по точности.
Именно в этом прогоне у DeepSeek нашлась отрицательная калибровка: модель ставила высокие вероятности там, где ошибалась. А GPT 5.6 Sol сделал около 15 тысяч вызовов инструментов, больше, чем любая другая модель, и обошёл предыдущую версию именно за счёт активного поиска.
К третьему кварталу модели научились передумывать
Апдейт от 15 ноября 2026-го переигрывает события июля-сентября на 252 открытых вопросах, и картина другая. Поиск теперь идёт через Exa Snapshot с лимитом 3000 вызовов на прогон, а не по корпусу вручную.
Главное: вместо плоских кривых второго квартала большинство моделей прибавляет 5-15% по ходу симуляции. Не потому, что им подсказали, а потому, что они читают новости, которые сами же и получают, и корректируют прогноз. Все модели, включая открытые, стали положительно калиброванными: ставят 70% - попадают примерно в 70%.
Точность выросла вместе с калибровкой: 50% у Opus 5.5, 47% у GPT 6.1 Sol, 41% у DeepSeek V4.1 Flash, 38% у Muse Wonder Full, 30% у GLM 5.3 Flash. По шкале Бриера разброс в этом квартале - от 0,13 до 0,35, и все значения положительные. С 25% первого прогона сравнивать напрямую нельзя - другой набор вопросов, другой поиск, другие модели. Зато видно направление: за полгода лучший результат удвоился.
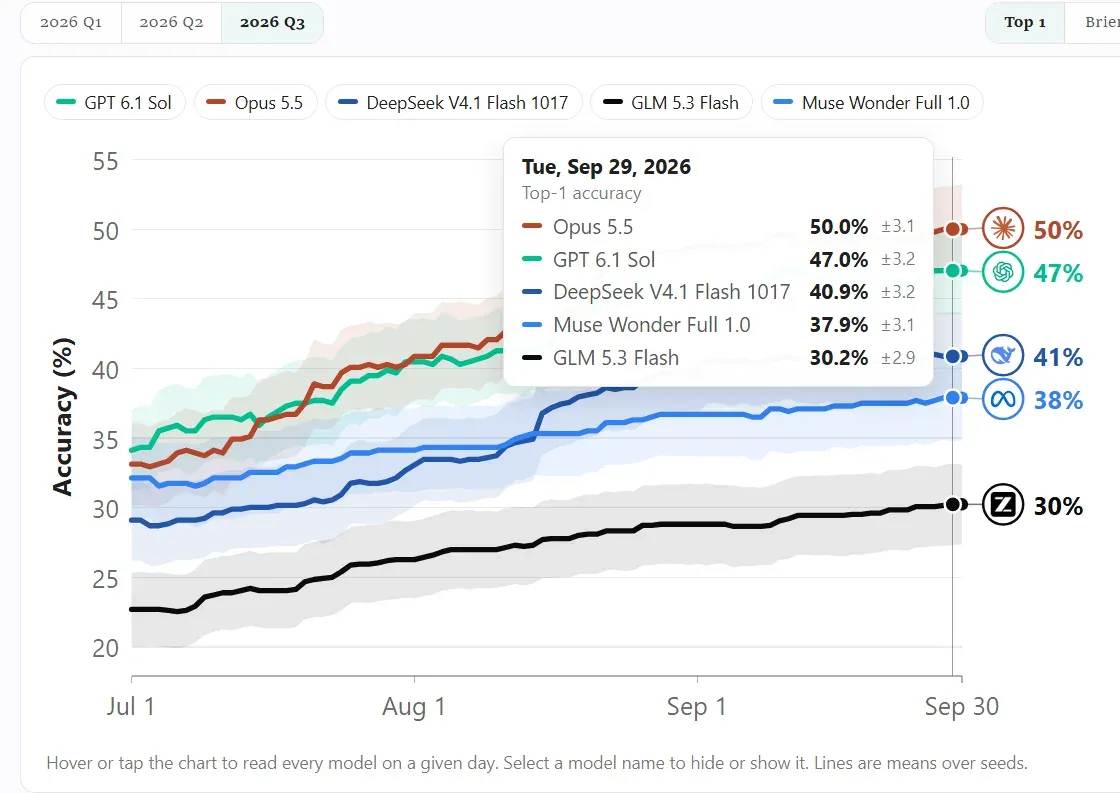
График: FutureSim, снимок 16 ноября 2026. По вертикали - точность в процентах, а не Brier: на 1 июля у топовых моделей 33-35%, к 30 сентября у Opus 5.5 - 50%. Лидер прибавляет 17 процентных пунктов, нижняя модель - около 7.
Первое место по Brier skill score и на старте, и в финале у Claude Opus 5.5. Авторы отметили любопытную деталь: модель быстро просекла, как устроена оценка, и почти перестала ставить на «ничего не произойдёт» и «другое» - в этом тесте такие ответы почти не выигрывают. Это не читерство, но и не совсем прогнозирование: скорее агент понял правила игры и подстроился под них.
Разница между моделями не совпадает с привычным рейтингом по коду: в третьем квартале последняя - GLM 5.3 Flash с 0,13, а DeepSeek V4.1 Flash держится в середине с 0,25. Зато лидер по точности сменился: во втором квартале им был GPT, в третьем вперёд вышел Opus 5.5.
Для меня тут важна не расстановка сил, а то, что адаптация оказалась отдельным навыком. Её не купить размером модели и не увидеть в рейтинге по коду.
Тест попался на подглядывании
Самая человеческая история случилась в первом квартале. В мире была одна громкая тема, и вопросов про неё много. И модели начали выводить ответы из формулировок соседних вопросов: не знаешь, кто победит, посмотри, о чём спрашивают рядом.
Это назвали перекрёстной утечкой, cross-task leakage. Починили честно: для каждого вопроса сильную модель попросили дать прогноз с доступом к остальным вопросам и без него, а те, где разница подозрительно велика, выбросили. Урок универсальный: как только в агентском тесте много связанных задач, «независимые вопросы» перестают быть независимыми, и агент получает подсказку, которую никто не закладывал.
Мне это нравится больше, чем сами цифры. Люди, которые делают бенчмарки, честно рассказали, где их измерительный прибор поехал, и показали, как починили. Так и должна выглядеть нормальная работа над ошибками - в отличие от табличек, которые годами живут с дыркой в методологии.
Что с этим делать, если ты не пишешь бенчмарки
Полезно, что у теста есть внешняя проверка - рынки предсказаний. Там, где вопрос совпадал с рынком Polymarket, ИИ вёл себя по-разному: на выборах в Непале шёл за толпой и приводил разумные аргументы, на Super Bowl с объёмом торгов 700 миллионов долларов иногда оказывался впереди, а на Grammy и окружных выборах в Британии проигрывал людям заметно.
Вывод для практики простой. В узких, хорошо изученных сюжетах прогноз ИИ полезен как второй взгляд. В широких, где решает вкус, случай или внезапное событие, уже нет.
А если ты запускаешь агента на потоке новостей, логов или отчётов, проверь одну вещь, которая дешевле любого бенчмарка. Дай ему задачу, потом добавь новый вводный факт, который противоречит первому выводу, и посмотри, изменит ли он ответ. Модель, которая упрямо повторяет первую версию, будет уверенно врать тебе месяцами - и по общим рейтингам ты этого не увидишь.
Чего этот тест не показывает
Справедливости ради, 25% - не приговор. Авторы сами называют результаты нижней границей: корпус ограничен, инструменты ограничены, поиск с надёжной отсечкой по дате - отдельная нерешённая проблема. С большим доступом к данным агенты показали бы больше.
И ещё три оговорки. Первая: цифры привязаны к харнессу. Codex, Claude Code и OpenCode - разные обвязки, и часть разрыва между моделями может быть разрывом между обвязками. Вторая: прирост «5-15% по ходу симуляции» смешан с качеством поиска - непонятно, модель стала лучше думать или просто научилась лучше искать. Третья: один балл на все домены. Политика, спорт и выборы не равны по сложности, а в таблице они слиты.
Так что красивой картинки «ИИ предсказывает будущее» из этих чисел не следует. Как и обратной, будто ИИ этого не умеет.
Вместо вывода
Способность передумывать - не бонус к интеллекту, а его часть. Мы привыкли мерить модели тем, что они знают, и забываем мерить тем, как они реагируют, когда узнают, что были неправы. FutureSim, при всех оговорках, меряет именно это - и показывает, что даже лучшие модели пока учатся этому с трудом.
Источники
- Страница FutureSim - лидерборд, дизайн теста и обновление Q3 от 15 ноября 2026 года.
- FutureSim: Replaying World Events to Evaluate Adaptive Agents - статья, 14 мая 2026 года.
- Код FutureSim и датасет OpenForesight.