
Google Cloud AI Research выложила в открытый доступ Harness² - фреймворк, который улучшает работу ИИ-агента, не меняя саму модель. Открытая GLM-5 после одного шага доработки поднялась на тесте WorkBuddy-Bench с 64,2 до 75,7 балла: +11,5 при тех же весах. Код вышел под лицензией Apache 2.0, статья появилась на arXiv 9 октября, а широко о проекте написали 18 октября.
Что такое обвязка и при чём тут она
У ИИ-агента два слоя. Первый - модель, которая думает. Второй - обвязка (harness): системный промпт, правила и ограничения, память, подсказки к инструментам, навыки, скрипты и субагенты. Claude Code и Codex - это как раз обвязки вокруг моделей, подробнее об устройстве агентов мы писали в разборе «Что такое ИИ-агент».
Обычно обвязку пишет человек и правит её вручную. Harness² делает это автоматически: под правку попадают все восемь частей обвязки, не только текст промпта.
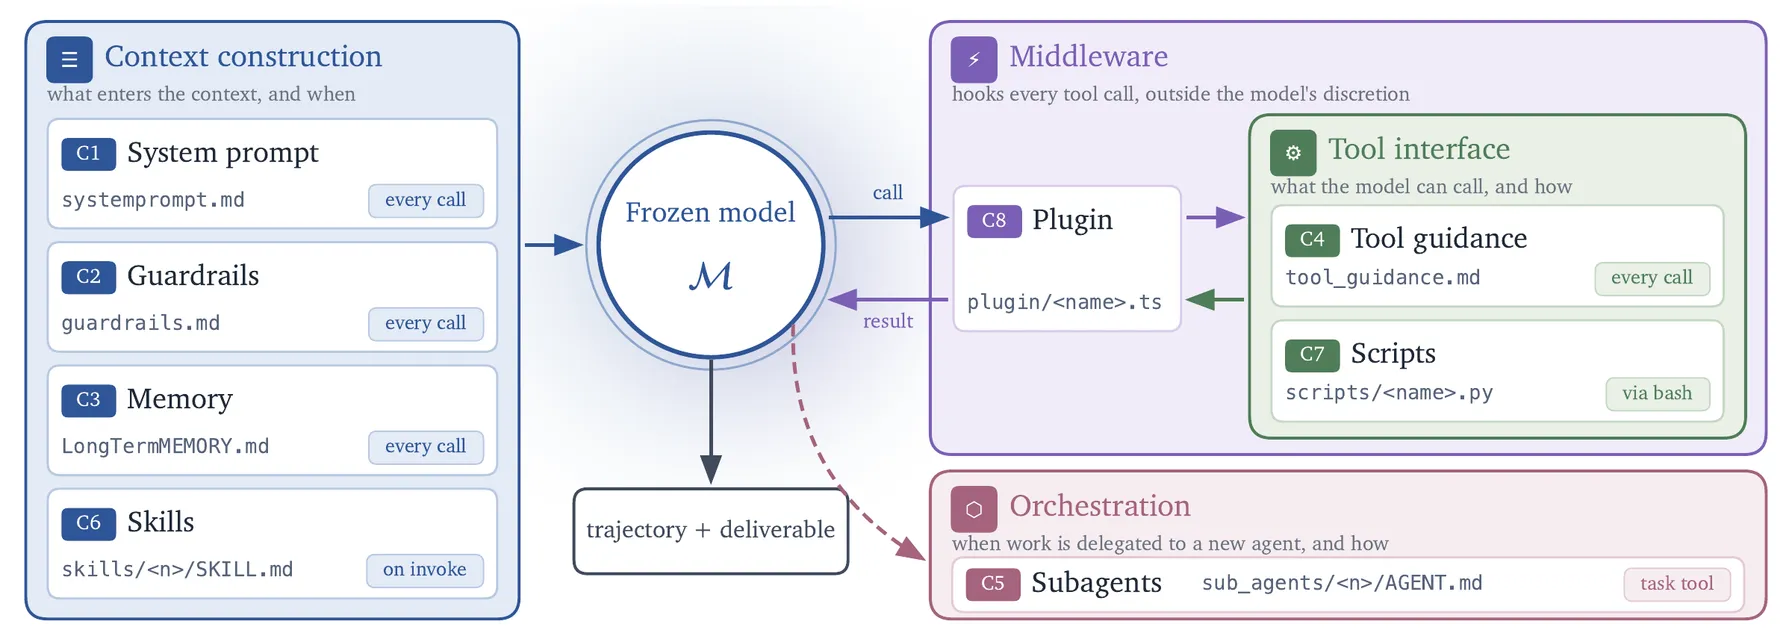
Восемь частей обвязки, которые Harness² может менять. Схема из репозитория проекта.
Как работает цикл Propose–Probe–Compose
Для каждой новой задачи система делает три шага:
- Propose. Редактор предлагает правки обвязки: общие (например, «всегда проверяй результат») и под тип задачи.
- Probe. Каждую правку прогоняют на той же задаче и смотрят, как меняется поведение агента.
- Compose. Финальную обвязку собирают только из тех правок, которые подтвердились в прогонах.
Правильный ответ для этого не нужен: система сравнивает поведение агента в разных прогонах, а не проверяет результат по эталону. Поэтому метод подходит для рабочих задач, у которых нет готового ключа. Степень в названии означает второй уровень: уроки с каждой задачи сохраняются в общем журнале и помогают на следующих.
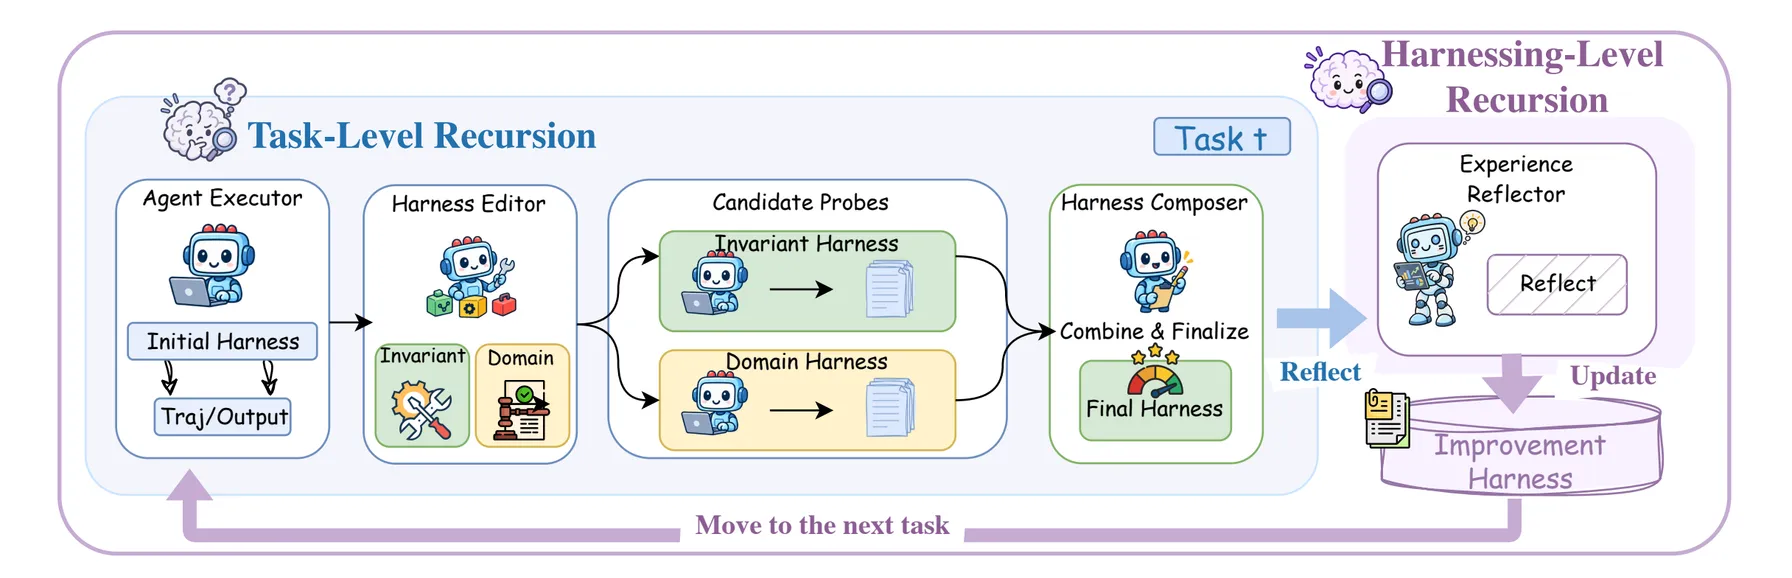
Один шаг цикла и накопление опыта между задачами. Схема из репозитория проекта.
Что показали замеры
Авторы проверили метод на трёх профессиональных бенчмарках: WorkBuddy-Bench (офис, веб и код), JobBench (рабочие задачи) и LAB (юридическая работа). Ниже - среднее по WorkBuddy-Bench, исполнитель OpenCode, средние по трём запускам. «k=1» - один шаг доработки.
| Метод | GLM-5 | Gemini 3.5 Flash |
|---|---|---|
| Исходная обвязка | 64,2 | 72,4 |
| ReasoningBank | 65,6 | 73,4 |
| Meta-Harness | 69,7 | 76,4 |
| Harness² (k=1) | 75,7 | 77,5 |
| Harness² (k=5, параллельно) | - | 80,8 |
Что видно в таблице:
- У слабой модели прирост больше. GLM-5 выросла на 11,5 балла, Gemini 3.5 Flash - на 5,1. С доработанной обвязкой GLM-5 (75,7) обошла Gemini со стандартной (72,4), но и Gemini после доработки набрала 77,5, так что догнать её по итогу не удалось.
- Метод опережает конкурентов. Обе альтернативы, Meta-Harness (метод из работы Stanford и MIT) и ReasoningBank, дали меньший прирост на обеих моделях.
- Больше шагов - выше результат. При k=5 Gemini 3.5 Flash дошла до 80,8.
На LAB у GLM-5 доля частично выполненных задач выросла с 59,6 до 71,4% (+11,8 п.п.). Прирост на JobBench скромнее: до 4,5 балла.
Пример: как два вмешательства подняли оценку с 43 до 78
В разборе одной задачи JobBench Gemini 3.5 Flash проваливалась не из-за недостатка знаний. Она не сверяла данные между исходными файлами и не открывала готовый результат, чтобы проверить его. Оценка за задачу - 43,1.
Harness² сделал два вмешательства (в сумме четыре правки):
- общее правило: перед работой составить список всех входных данных, привязать каждую цифру к источнику и проверить готовые файлы скриптом;
- навык под задачу: правила сверки файлов расписания, площадки, трудозатрат и бюджета, плюс подсказки по форматам чисел.
После этого оценка за ту же задачу - 77,8. Это один разобранный случай, а не средний результат: по всему JobBench прирост намного меньше.
Что здесь не так гладко
- Правки пишет не сам агент. По умолчанию редактором служит отдельная сильная модель, Claude Opus 4.8 под OpenCode. В отдельном эксперименте редактором и исполнителем была одна и та же модель, и все пять проверенных моделей, от GLM-5 до Claude Opus 5, выросли на каждом бенчмарке. У Opus 5 прирост составил +3,3 на WorkBuddy-Bench, +5,5 на JobBench и +3,0 на LAB, у GLM-5 на LAB - +13,7. Этот эксперимент шёл с двумя шагами (k=2), и только про него можно сказать, что агент правит себя сам.
- Цена доработки не раскрыта. Авторы пишут, что обе конфигурации лежат на границе Парето «вычисления - качество», с учётом затрат и на прогоны, и на правки. Токенов и долларов в статье нет. Число вызовов инструментов после доработки на WorkBuddy-Bench упало на 11%, а на JobBench и LAB выросло на 20% и 21%. Доля ошибок инструментов при этом снизилась на всех трёх бенчмарках, например на JobBench с 14,4% до 9,1%.
- Гарантий нет. Авторы сами отмечают, что сигнал из пробных прогонов зависит от случайности и общих «слепых пятен» моделей и не доказывает, что правка сработает на другой задаче.
- Это исследовательский проект. В репозитории (около 9 тысяч звёзд на GitHub) указано, что это не официально поддерживаемый продукт Google. Для запуска нужны Linux, Python 3.12, Google Cloud CLI и модели через Vertex AI, а для WorkBuddy-Bench ещё и Docker.
Что это значит для вас
Если вы не строите агентов, вывод простой: качество работы ИИ определяет не только модель, но и то, какие инструкции и проверки ей даны. В примере с JobBench решило дело не новое знание, а требование перепроверять результат. То же работает в обычном чате: попросите модель после ответа сверить числа с исходными данными и перечислить, что она не смогла проверить.
Если вы строите агентов, Harness² - готовый способ проверить, сколько даёт автоматическая доработка обвязки на ваших задачах. Но учтите стоимость: каждый шаг - это дополнительные прогоны и сессии редактора.
Где попробовать
GLM-5, Gemini 3.5 Flash и Claude Opus 4.8, на которых шли эксперименты, доступны в GPTunneL в одном чате. Сам Harness² у нас не запускается: это код для собственного сервера. Но сравнить, как разные модели справляются с вашей задачей до и после того, как вы добавили в инструкцию проверку результата, можно прямо в чате. Агентов в целом мы разбирали в статье про Claude Code.
Источники
- google-research/harness2, GitHub - код, лицензия Apache 2.0, описание компонентов, требования к запуску, оговорка «не официальный продукт Google».
- Harness²: Recursive Agent Harnessing for an Open World, arXiv, 9.10.2026 - статья, таблицы результатов, разбор кейса JobBench, ограничения.
- harness2.github.io, страница проекта - результаты на WorkBuddy-Bench для Gemini 3.5 Flash и сравнение с конкурирующими методами.