
Обзор GPTunnel. Данные бенчмарков актуальны на на 13 ноября 2026 года
Google в последнее время приятно удивляет рынок ИИ выпуская модели, которые действительно имеют право на борьбу за место под солнцем. Так, недавно выпущенный Gemini 4 Carbon является пожалуй лучше фронтир-моделью по соотношению интеллект/стоимость задачи. А что до Gemini 4 Hydrogen?
Первое, чем она сбивает с толку - по бенчмаркам она выглядит не хуже модели Argon, при этом дешевле и быстрее. Давайте разбираться, где же место среди моделей у Hydrogen.
Google выпустила Gemini 4 Hydrogen 12 ноября 2026 года. Компания предлагает её как быструю модель для программирования, работы с документами и ИИ-агентов - систем, которые могут самостоятельно открывать файлы, запускать инструменты и выполнять последовательность действий.
Главное: в рейтинге GPTunnel Hydrogen заняла 8-е место по индексу интеллекта. Она быстро обрабатывает аналитические задачи, хорошо реагирует на замечания пользователя и переносит программы между языками. Зато в самостоятельном поиске неизвестных ошибок заметно уступает некоторым соседям по рейтингу.
Сопоставление со знакомыми альтернативами помогает понять её место. Например, GPT-6.1 Sol получила более высокий общий балл и в среднем на 38% дешевле при выполнении тестовых заданий. Hydrogen при этом затрачивает примерно на 40% меньше времени на генерацию ответа в тесте Artificial Analysis. По сравнению с более мощной Gemini 4 Carbon Hydrogen примерно на 23% дешевле и почти вдвое быстрее. Цифры расходов относятся к одинаковому набору независимых тестовых измерений; для подписок действуют другие правила, о которых расскажем отдельно.
Что такое Gemini 4 Hydrogen и зачем Google её выпустила
Быстрая исполнительная модель в семействе Gemini
В линейке Google Hydrogen дополняет Gemini 4 Carbon и Gemini 4 Argon. Carbon позиционируется для особенно сложных рассуждений и планирования, Argon также ориентирована на задачи высокой сложности, а Hydrogen - на регулярную работу, где важны скорость выполнения, следование инструкциям и обращения к инструментам. По описанию Google DeepMind, Hydrogen создана на основе Carbon; подробности того, как Google изменила архитектуру, не раскрываются.
Пример: при разработке приложения одна модель может продумать архитектуру, а Hydrogen - написать отдельные функции, отредактировать файлы и запустить проверку. Такой подход Google развивает в системе Antigravity Orchestrator, которая распределяет задачи между моделями. В испытании Google на Terminal-Bench 4.0 её связка выполнила задачи на 19% быстрее и израсходовала на 24% меньше квоты, чем использование Carbon без такого распределения. Анонс Google.
Основные характеристики
| Параметр | Что это означает для пользователя |
|---|---|
| Поддерживаемые материалы | Текст, изображения, аудио, видео и документы. Модель может анализировать файлы, таблицы и программный код в приложениях, поддерживающих эти функции. |
| Контекст до 1 млн токенов | В один запрос можно передать большой объём текста и материалов, например части крупного репозитория. Реальные ограничения зависят от сервиса и расхода токенов на ответ. |
| Режимы рассуждения | low, medium, high, xhigh: от более быстрых и простых ответов до более глубокого анализа с повышенным расходом токенов. |
| Максимальный обычный вывод | До 65 536 токенов за один сегмент ответа; API поддерживает продолжение более длинных задач. |
| Цена Google API | $1,50 за 1 млн входных и $7,50 за 1 млн выходных токенов, включая токены рассуждений. |
| Обучающие знания | Дата отсечения: март 2026 года. Актуальные сведения могут поступать из подключённых инструментов поиска. |
Что даёт режим xhigh? Модель может дольше анализировать запрос и использовать больше токенов на рассуждения. Это потенциально улучшает решение сложной задачи, но увеличивает время и стоимость. Например, Artificial Analysis получила для Hydrogen 54 балла в режиме xhigh.
Как Hydrogen выглядит в общем рейтинге моделей
Мы собрали результаты шести независимых бенчмарков - тестовых наборов, где модели решают одинаковые типы задач. Общий рейтинг помогает сравнить модели сразу по нескольким направлениям, но каждое измерение можно проверить отдельно по таблице ниже.
В базе GPTunnel есть 85 записей моделей и их конфигураций. В итоговый рейтинг вошли 23 модели, для которых доступны результаты минимум пяти из шести выбранных тестов. Hydrogen имеет измерения по всем шести и занимает восьмое место.
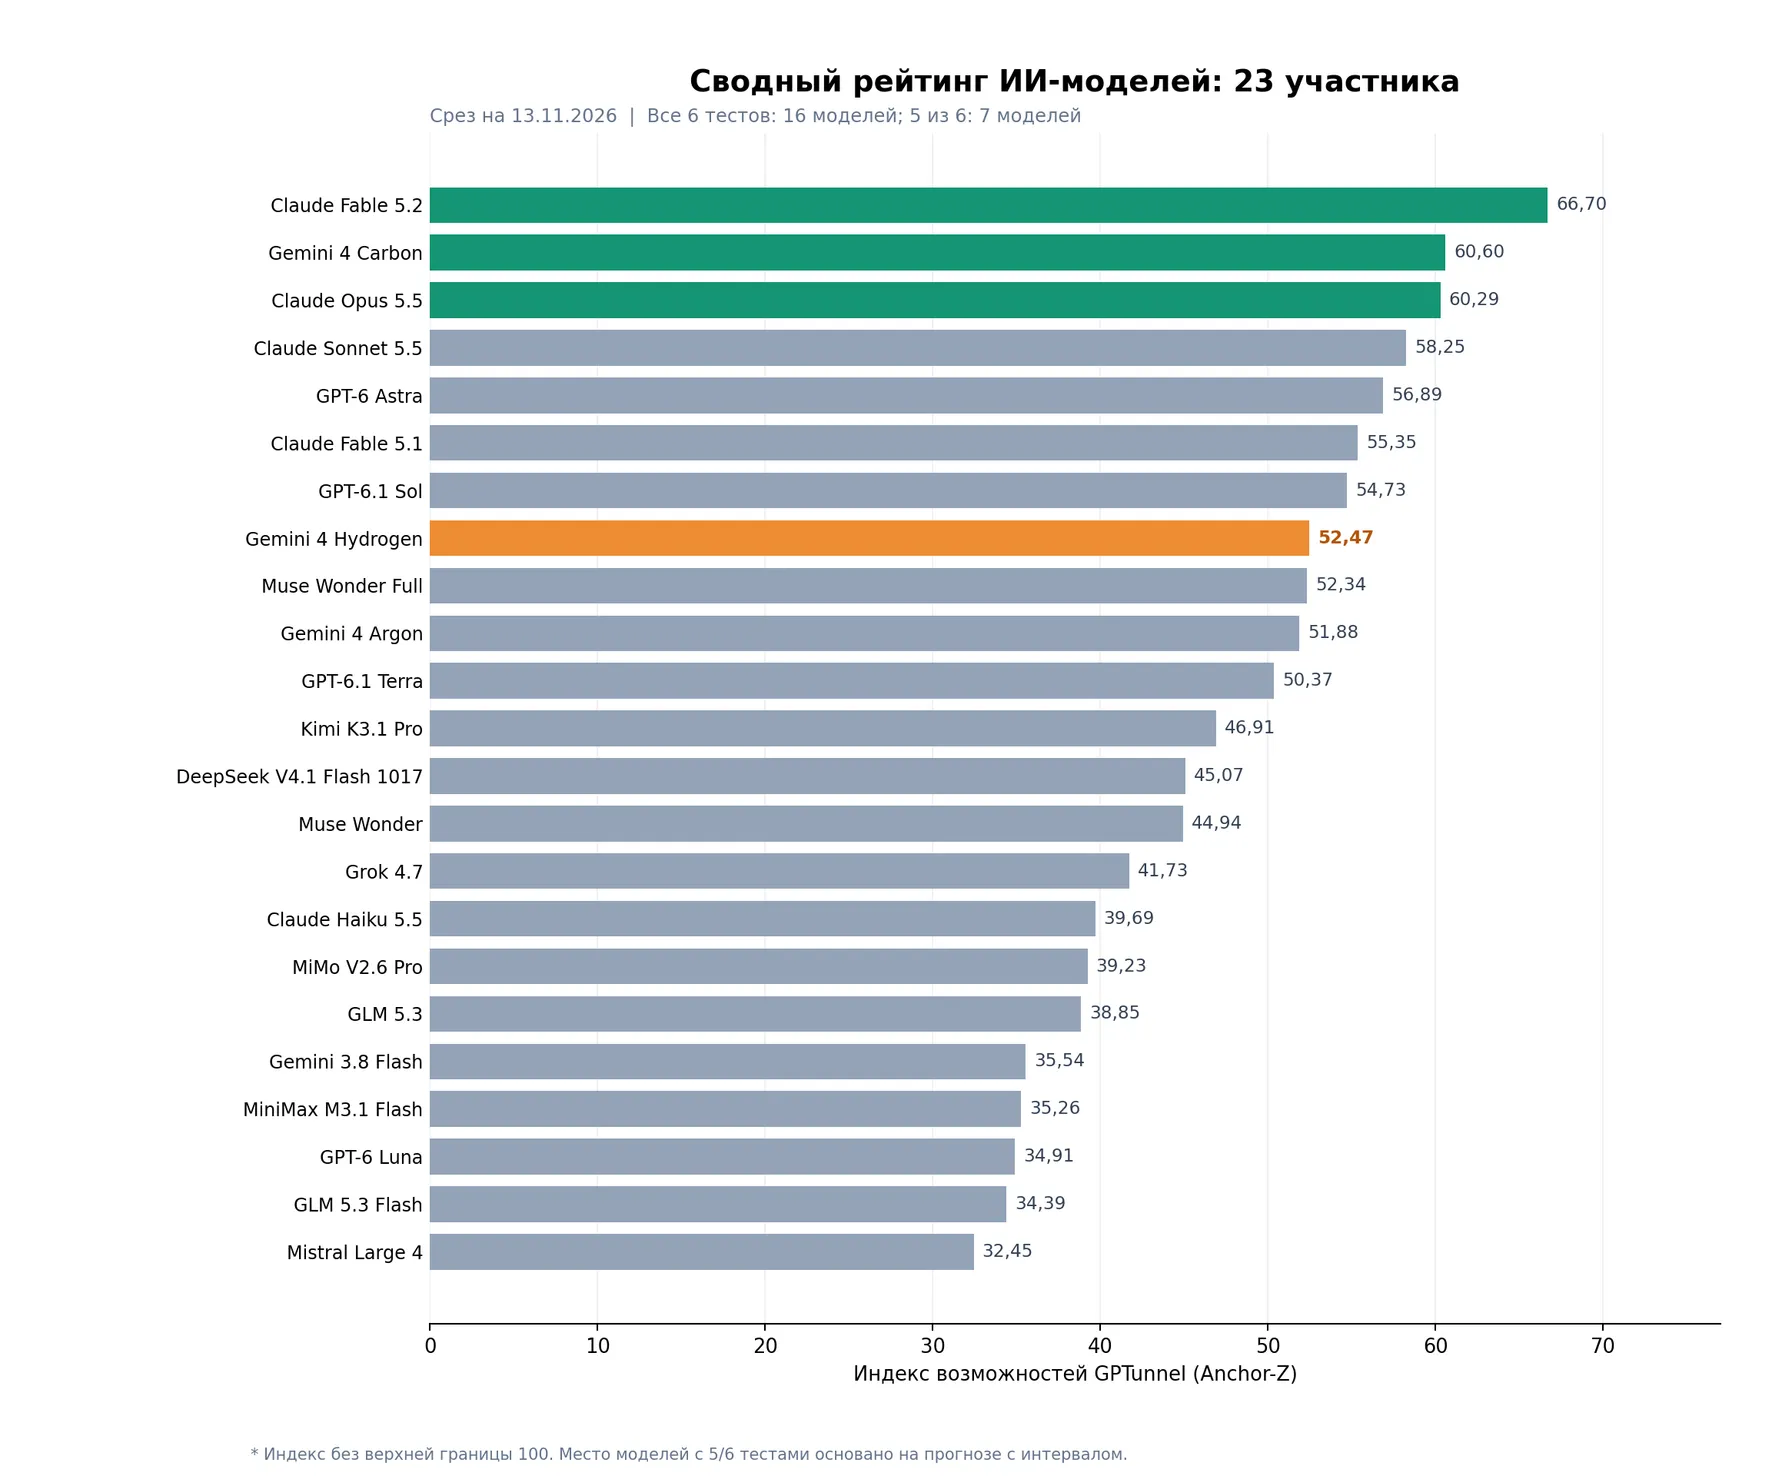
Полная таблица: итоговый рейтинг, стоимость и исходные результаты
В таблице первые два числовых показателя - расчёты GPTunnel: индекс интеллекта и индекс стоимости. Остальные шесть столбцов - опубликованные исходные результаты бенчмарков, из которых рассчитан индекс интеллекта. Теперь можно посмотреть, за счёт чего модель получила своё место.
- AA (Artificial Analysis), Vals и LiveBench - три разных набора заданий на рассуждения, программирование и другие интеллектуальные способности. Каждый использует собственную шкалу.
- WebDev проверяет создание веб-интерфейсов; Elo - сравнительный рейтинг, похожий на систему рейтинга шахматистов.
- Agent Arena показывает, насколько агент улучшает результат при работе с инструментами и обратной связью; отрицательное значение означает ухудшение по сравнению с исходным вариантом.
- Bug Hunt показывает, сколько из 105 скрытых ошибок удалось исправить в среднем.
Во всех шести тестах больше означает лучше. У индекса интеллекта тоже лучше большее значение, а у индекса стоимости лучше меньшее. Стоимость и её условная шкала подробно объяснены в следующем разделе.
| № | Модель | Индекс интеллекта | Индекс стоимости | AA | Vals | LiveBench | WebDev, Elo | Agent Arena, % | Bug Hunt, /105 |
|---|---|---|---|---|---|---|---|---|---|
| 1 | Claude Fable 5.2 | 66,70 | 5,837 | 65 | 71,31 | 84,9 | 1838 | 30,48 | 58,0 |
| 2 | Gemini 4 Carbon | 60,60 | 1,073 | 60 | 70,45 | 83,5 | 1768 | 16,90 | 57,3 |
| 3 | Claude Opus 5.5 | 60,29 | 3,482 | 59 | 70,14 | 83,4 | 1815 | 19,51 | 41,7 |
| 4 | Claude Sonnet 5.5 | 58,25 | 2,297 | 55 | 70,85 | 77,0 | 1772 | 16,07 | 51,3 |
| 5 | GPT-6 Astra | 56,89 | 2,787 | 57 | 65,02 | 84,5 | 1764 | 14,56 | 45,0 |
| 6 | Claude Fable 5.1 | 55,35* | 4,418 | 49 | н/д | 84,0 | 1742 | 14,62 | 43,0 |
| 7 | GPT-6.1 Sol | 54,73 | 0,513 | 55 | 63,94 | 81,4 | 1743 | 12,40 | 44,3 |
| 8 | Gemini 4 Hydrogen | 52,47 | 0,828 | 54 | 68,49 | 77,0 | 1704 | 14,80 | 32,7 |
| 9 | Muse Wonder Full | 52,34* | н/д | 50 | 66,79 | н/д | 1723 | 8,89 | 42,0 |
| 10 | Gemini 4 Argon | 51,88 | 0,902 | 50 | 69,39 | 77,7 | 1681 | 10,72 | 40,7 |
| 11 | GPT-6.1 Terra | 50,37 | 0,308 | 51 | 60,54 | 78,8 | 1678 | 11,96 | 40,7 |
| 12 | Kimi K3.1 Pro | 46,91 | 0,629 | 46 | 62,52 | 68,7 | 1687 | 4,83 | 36,0 |
| 13 | DeepSeek V4.1 Flash 1017 | 45,07 | 0,099 | 33 | 61,26 | 70,3 | 1664 | 2,01 | 42,7 |
| 14 | Muse Wonder | 44,94 | 1,237 | 44 | 64,88 | 70,7 | 1647 | 1,67 | 31,7 |
| 15 | Grok 4.7 | 41,73 | 2,031 | 35 | 58,62 | 67,9 | 1641 | 2,49 | 29,0 |
| 16 | Claude Haiku 5.5 | 39,69* | 0,158 | 36 | 58,73 | 68,9 | 1593 | 0,42 | н/д |
| 17 | MiMo V2.6 Pro | 39,23 | 0,068 | 30 | 57,81 | 66,1 | 1625 | 2,16 | 22,7 |
| 18 | GLM 5.3 | 38,85* | 0,998† | 32 | 59,85 | н/д | 1622 | 0,93 | 19,0 |
| 19 | Gemini 3.8 Flash | 35,54 | 0,829 | 31 | 55,95 | 57,3 | 1583 | 2,34 | 18,0 |
| 20 | MiniMax M3.1 Flash | 35,26* | 0,094 | 29 | 53,78 | 63,7 | 1584 | -2,76 | н/д |
| 21 | GPT-6 Luna | 34,91* | 0,043 | 28 | 52,32 | 60,4 | 1577 | 1,52 | н/д |
| 22 | GLM 5.3 Flash | 34,39 | 0,102 | 28 | 50,86 | 60,7 | 1609 | -2,94 | 17,7 |
| 23 | Mistral Large 4 | 32,45* | 0,387 | 26 | 56,53 | 40,9 | 1564 | 5,64 | н/д |
Как читать пропуски. н/д - результата теста нет. Звёздочка * около индекса интеллекта означает, что для модели с пятью измерениями из шести недостающий результат оценён статистически; в исходном столбце мы оставили н/д, чтобы не выдавать прогноз за измерение. Знак † около индекса стоимости означает прогноз одной недостающей цены. Для Hydrogen все шесть результатов интеллекта и все три цены измерены, без прогнозов. У моделей могли различаться режимы рассуждения и инструменты.
Что означают баллы индекса
Индекс интеллекта GPTunnel показывает, насколько сильны совокупные результаты модели относительно фиксированной группы из 16 моделей, у которых есть результаты всех шести тестов. Средний уровень этой группы принят за 50 баллов.
Получается, что 52,47 у Hydrogen - немного выше исходной точки отсчёта; 54,73 у Sol - выше на 2,26 балла, 60,60 у Carbon - выше на 8,13 балла. Это баллы нашей сравнительной шкалы, а не проценты правильных ответов: разница в 2,26 балла не означает «на 2,26% умнее». При добавлении новой модели фиксированная точка отсчёта остаётся прежней.
Как считается индекс
Для читателей, которым интересны расчёты: сначала результаты каждого теста приводятся к общей шкале с помощью якорной Z-нормализации - разницы со средним у 16 опорных моделей, разделённой на разброс результатов. Затем они объединяются с весами: 40% на Artificial Analysis, Vals и LiveBench вместе, 25% на Arena WebDev и 35% на Agent Arena и Bug Hunt вместе. У семи моделей один отсутствующий тест оценён статистически. Более подробная формула и источники приведены в конце статьи.
Что рейтинг говорит именно о Hydrogen: она занимает восьмое место по общей оценке, но в отдельных задачах обходит более высоко стоящие модели. Поэтому следующий вопрос - сколько приходится платить за результат и насколько быстро он получается.
Стоимость: сравниваем Hydrogen и конкурентов по стоимости за задачу
Важное уточнение: сравнение ИИ по стоимости актуально для использования моделей по API, лимиты в подписках у разных вендоров же дают разный объем вычислений. То есть, тот факт, что Sol 6.1 выгоднее Hydrogen или Sonnet по API не означает, что эквивалентная по стоимости подписка OpenAI выгоднее, чем подписка Google или Claude.
Наш индекс цены основан на данных 3 бенчмарков - Artificial Analysis, LiveBench и Arena WebDev (методика ниже, скрыта под спойлер). В среднем по выбранным тестам Hydrogen обходится на 62% дороже GPT-6.1 Sol, на 23% дешевле Gemini 4 Carbon и примерно в 2,7 раза дороже GPT-6.1 Terra. Для сравнения с совсем бюджетной DeepSeek V4.1 Flash разница ещё больше: Hydrogen стоит приблизительно в 8,4 раза дороже.
Как мы считаем индекс цены
Откуда получены эти числа? Мы сравнили фактическую стоимость выполнения заданий в трёх площадках: Artificial Analysis, LiveBench и Arena WebDev. На каждой площадке стоимость задания приводится к единой сравнительной шкале; затем три соотношения объединяются. Индекс стоимости показывает относительную дороговизну, поэтому его можно использовать для расчёта соотношения расходов между моделями. Само число 0,828 у Hydrogen - условный показатель, а не $0,828 за запрос. Например, 0,828 / 0,513 = 1,62: по этой корзине заданий Hydrogen дороже Sol в 1,62 раза.
Исходные цены, по которым рассчитан индекс:
| Модель | Artificial Analysis, $/задание | LiveBench, $/успешную задачу | Arena WebDev, $/задачу | Индекс стоимости |
|---|---|---|---|---|
| GPT-6.1 Terra | $0,96 | $0,673 | $0,65 | 0,308 |
| GPT-6.1 Sol | $1,27 | $0,823 | $1,86 | 0,513 |
| Gemini 4 Hydrogen | $3,16 | $1,924 | $1,35 | 0,828 |
| Gemini 4 Argon | $4,97 | $1,822 | $1,17 | 0,902 |
| Gemini 4 Carbon | $5,48 | $2,024 | $1,61 | 1,073 |
| DeepSeek V4.1 Flash | $0,60 | $0,195 | $0,12 | 0,099 |
Почему цифры отличаются от одного теста к другому? Площадки проверяют разные задачи и по-разному учитывают расходы. Например, в WebDev Hydrogen дешевле Sol ($1,35 против $1,86), но в Artificial Analysis она дороже ($3,16 против $1,27). Сводный индекс соединяет три сравнения с равным весом и поэтому удобен для общей оценки. Для конкретного проекта важнее стоимость тех задач, которые он действительно выполняет. Суммировать суммы из трёх разных тестов нельзя.
Граница Парето: есть ли модели одновременно сильнее и дешевле?
Граница Парето - это набор моделей, у которых нет конкурента одновременно с более высоким индексом интеллекта и меньшими затратами. На графике каждая точка - модель. Чем выше точка, тем сильнее её общий результат; чем левее - тем дешевле выполнение тестовых задач.
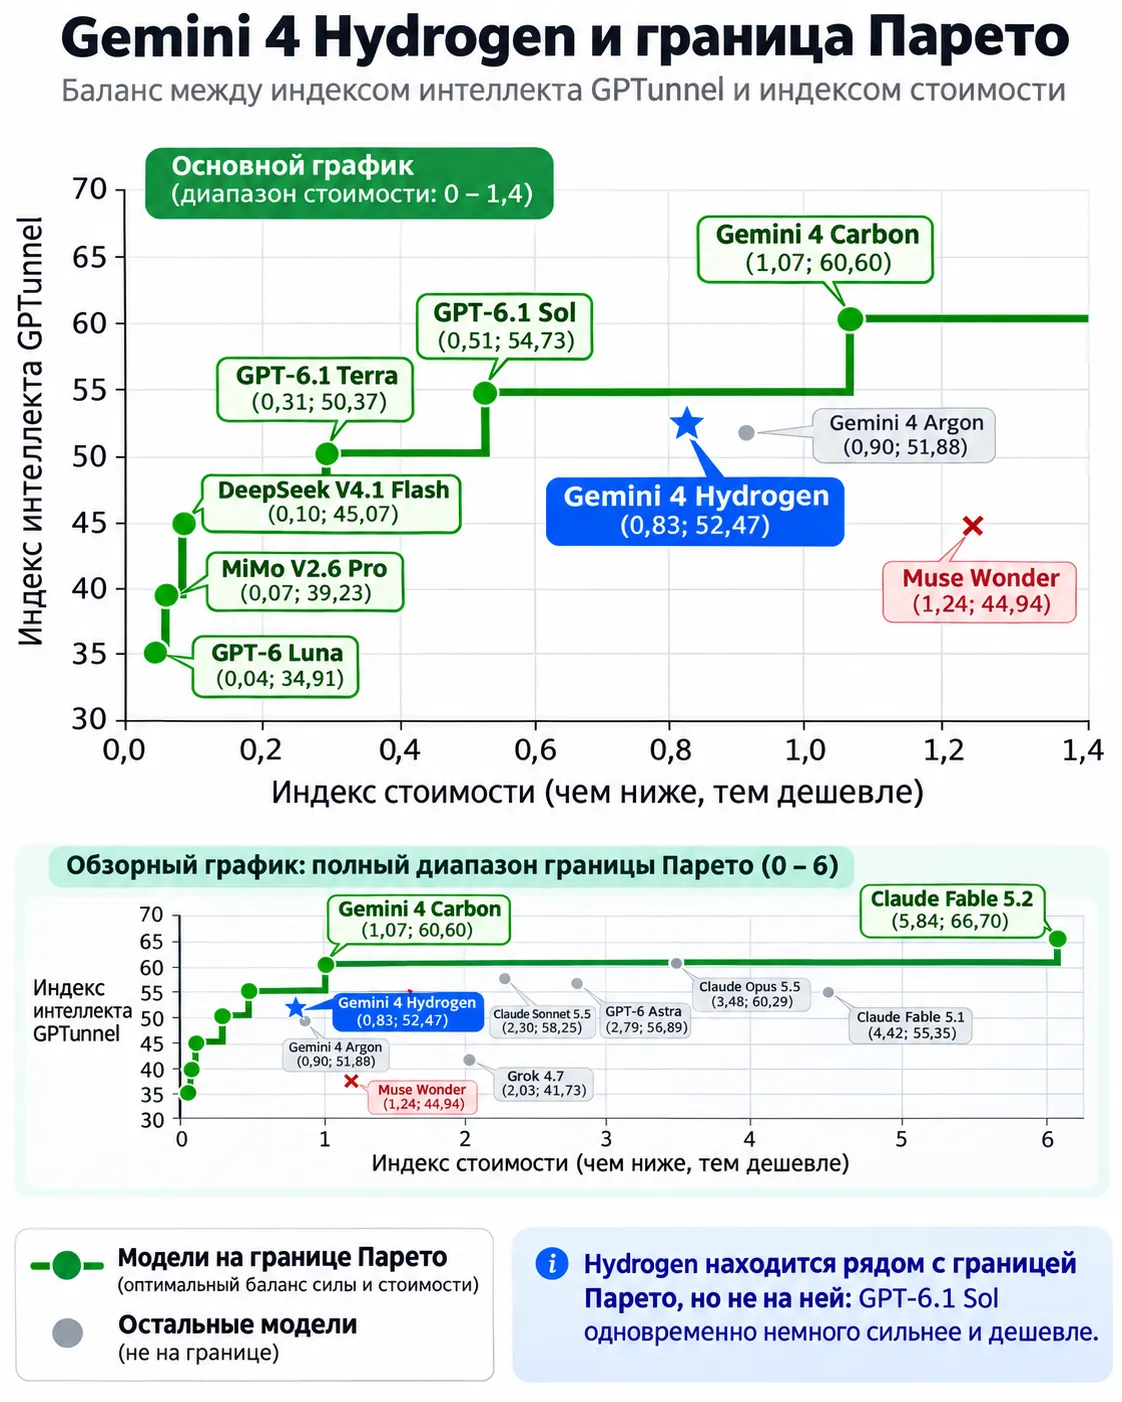
В таком сравнении Hydrogen не входит в границу Парето: Sol имеет 54,73 балла против 52,47 у Hydrogen и стоит на 38% дешевле.
Мой тест: оценка расходов на анализ отчета с 5000 строк ключевых фраз
Мне было интересно сравнить, как новая модель провяит себя в моей повседневной работе, поэтому я дал Gemini 4 Hydrogen, GPT-6.1 Sol и DeepSeek V4.1 Flash реальный отчёт по ключевым фразам рекламной кампании на 5000 строк. В данных заранее спрятали три ловушки: одну фейковую строку с "неправильными" данными, одну строку с явно завышенными данными по доходу и дубль строки, в котором одна буква отличалась регистром. Все три модели нашли все три ловушки. Помимо трёх заранее добавленных ловушек, в отчёте встретились и естественные неоднозначности. Claude Fable 5.2 отдельно оценил, как модели обработали все 18 таких случаев, и проверил ошибки в их выводах.
Фактический расход каждого прогона сравниваем с DeepSeek, приняв его за 1×. Для Sol расход показан с действовавшей скидкой 50%.
| Модель | Расход относительно DeepSeek | Наши ловушки | Ловушки по оценке Fable 5.2 | Ошибки в отчёте по оценке Fable 5.2 | Итог Fable 5.2 |
|---|---|---|---|---|---|
| DeepSeek V4.1 Flash | 1× | 3 из 3 | 14 из 18 | 5 | 9 |
| GPT-6.1 Sol | 40,95× | 3 из 3 | 18 из 18 | 0 | 18 |
| Gemini 4 Hydrogen | 47,36× | 3 из 3 | 11 из 18 | 1 | 10 |
У "Водорода" отчет получился самым дорогим, и не самым лучшим.
Больше всего мне понравился отчёт Sol 6.1. Отчёт Hydrogen оказался сухим и менее детальным; отчёт DeepSeek был неплохим, но я заметил в нём одну фактическую ошибку с подсчетом значений из дубля строки (хотя саму ошибку он нашел, при расчете конверсии он отдельно посчитал задвоение). В оценке Fable Sol тоже получила наивысший итог: 18 баллов против 10 у Hydrogen и 9 у DeepSeek.
Относительный расход показывает стоимость именно этих готовых анализов, а не разницу в тарифе за токен. Это по одному прогону на модель; результат на другом отчёте может отличаться.
Насколько быстро работает Hydrogen
Для сравнения скорости мы используем один одинаково рассчитанный показатель Artificial Analysis.
Для простых частых задач быстродействие модели очень важный показатель. После того, как привыкаешь получать результат через 1 минуту, вряд ли захочется ждать 5 минут. Мы уже проанализировали интеллект и стоимость использования модели, давайте теперь оценим скорость. Картина среди соседей по интеллекту немного меняется в пользу Hydrogen, если добавить время выполнения задания:
| Модель | Индекс интеллекта | Относительная стоимость | Время AA, мин |
|---|---|---|---|
| GPT-6.1 Terra | 50,37 | 0,308 | 14,7 |
| GPT-6.1 Sol | 54,73 | 0,513 | 23,2 |
| Gemini 4 Hydrogen | 52,47 | 0,828 | 13,9 |
| Gemini 4 Argon | 51,88 | 0,902 | н/д |
| Gemini 4 Carbon | 60,60 | 1,073 | 28,6 |
У Hydrogen расчётное время AA составляет 13,9 минуты против 23,2 у Sol, то есть примерно на 40% меньше. Для приложений, где ожидание ответа дорого обходится пользователю, это может оправдывать доплату.
Относительно других быстрых моделей:
| Модель | Время задания Artificial Analysis |
|---|---|
| GPT-6 Luna | 11,8 мин |
| Mistral Large 4 | 12,3 мин |
| Gemini 4 Hydrogen | 13,9 мин |
| GPT-6.1 Terra | 14,7 мин |
| Gemini 3.8 Flash | 14,9 мин |
| GPT-6.1 Sol | 23,2 мин |
| Gemini 4 Carbon | 28,6 мин |
| Claude Fable 5.2 | 46,1 мин |
Hydrogen занимает третье место по скорости среди 20 моделей нашего рейтинга, у которых есть это измерение.
Независимый разработчик Саймон Уиллисон попросил Hydrogen, Argon и Carbon создать SVG-рисунок пеликана на велосипеде. Hydrogen выполнила задачу за 19 секунд, Argon - за 2 минуты 29 секунд, Carbon - за 4 минуты 11 секунд. Но Hydrogen создала заметно более простой рисунок и использовала меньше токенов. Это ещё один пример обмена скорости на объём проработки. Сравнение Уиллиссона.
Поэтому в реальной работе полезнее измерять сразу три величины: качество результата, полное время и стоимость успешного выполнения. Быстрый ответ, который приходится переделывать, может оказаться менее выгодным, чем более медленный, но готовый к использованию.
А если пользоваться моделью в подписке?
По API обычно платят за объём входных и выходных токенов. На счёт влияют объём рассуждений, обращения к инструментам и повторные попытки. По подписке цена чаще фиксирована, но действует ограничение на доступные вычисления. Поэтому модель, которая дороже по API, иногда оказывается удобнее внутри уже оплаченной подписки, если её хватает на большее число выполненных задач.
Есть и технический нюанс: кэширование. Когда сервис повторно использует уже обработанные части запроса, часть входных токенов может обходиться дешевле. Участник дискуссии Hacker News, представившийся сотрудником Artificial Analysis, объяснял, что именно доля повторно использованных токенов помогает понять неожиданную разницу в стоимости отдельных тестов. Для покупателя API практичнее сравнивать цену успешно выполненной задачи, а не только тариф за миллион токенов.
Hydrogen и её ближайшие конкуренты
Общий рейтинг не всегда распространяется на профильные задачи. Профильные способности, цена и время обработки заметно различаются у соседей по общему рейтингу.
| Модель | Индекс интеллекта | Стоимость относительно Hydrogen | Время AA |
|---|---|---|---|
| Claude Fable 5.1 | 55,35* | в 5,3 раза дороже | 22,3 мин |
| GPT-6.1 Sol | 54,73 | на 38% дешевле | 23,2 мин |
| Gemini 4 Hydrogen | 52,47 | точка сравнения | 13,9 мин |
| Muse Wonder Full | 52,34* | нет достаточных данных | н/д |
| Gemini 4 Argon | 51,88 | на 9% дороже | н/д |
| GPT-6.1 Terra | 50,37 | примерно в 2,7 раза дешевле | 14,7 мин |
Звёздочка означает прогноз одного недостающего бенчмарка в общем индексе.
Hydrogen против GPT-6.1 Sol.
Sol имеет 54,73 против 52,47 по общему индексу интеллекта и обходится на 38% дешевле. Hydrogen быстрее по AA: 13,9 против 23,2 минуты. А в отдельных заданиях Hydrogen опережает Sol: 68,49 против 63,94 в Vals Index и +14,80% против +12,40% в Agent Arena. Зато Sol исправляет больше неизвестных ошибок в Bug Hunt: 44,3 против 32,7 из 105. Для недорогих сложных запросов Sol выглядит выгоднее; для работы с большой ценностью времени отклика стоит испытать Hydrogen.
Hydrogen против Gemini 4 Argon. Общая оценка почти совпадает: 52,47 у Hydrogen против 51,88 у Argon. Hydrogen примерно на 8% дешевле. В LiveBench Argon сильнее по сложным рассуждениям (95,1 против 88,6), а в Bug Hunt исправляет больше ошибок (40,7 против 32,7). Hydrogen лучше по Agent Arena (14,80% против 10,72%) и по Vals Code Migration - переносу кода между языками (82,7% против 74,4%). Для сложной логики Argon может оказаться предпочтительнее; для управляемых рабочих действий интереснее Hydrogen.
Hydrogen против GPT-6.1 Terra. Разница в индексе невелика: 52,47 против 50,37. Но Terra почти так же быстра по AA (14,7 против 13,9 минуты) и примерно в 2,7 раза дешевле. Её стоит проверять первой, если задача массовая, бюджет важнее небольшой разницы общего балла, а качество Terra подходит.
Hydrogen против Claude Fable 5.1. Предыдущая версия Fable 5.1 получила 55,35 против 52,47 по интеллекту, но стоит в 5,3 раза дороже по нашему сравнению и требует 22,3 против 13,9 минуты по времени AA. Hydrogen может быть разумнее для повседневной работы, где максимальное качество дорогой модели не используется.
Hydrogen против Muse Wonder Full.
Разница в индексе составляет всего 0,13 балла: 52,47 против 52,34. При этом для Muse Wonder Full отсутствует один результат по интеллекту и нет полноценной оценки стоимости. Поэтому здесь полезнее сравнение на своих задачах, чем десятые доли итоговых баллов.
А что насчёт дешёвых моделей и старой Gemini Flash?
DeepSeek V4.1 Flash 1017 получила 45,07 балла против 52,47 у Hydrogen, зато дешевле примерно в 8,4 раза. В некоторых задачах создания кода результаты близки, а по Bug Hunt DeepSeek даже впереди: 42,7 против 32,7 исправленной ошибки. MiMo V2.6 Pro ещё дешевле Hydrogen примерно в 12,2 раза, но по общему рейтингу заметно слабее: 39,23 балла. Для простых массовых задач экономия может перевесить преимущества Hydrogen.
Сравнение Hydrogen с Gemini 3.8 Flash показывает прирост относительно предыдущего поколения:
| Показатель | Gemini 3.8 Flash | Gemini 4 Hydrogen |
|---|---|---|
| Индекс интеллекта | 35,54 | 52,47 |
| Общий относительный расход в трёх тестах | 0,829 | 0,828 |
| Время AA | 14,9 мин | 13,9 мин |
| LiveBench: общий результат | 57,3 | 77,0 |
| LiveBench: анализ данных | 54,0 | 83,2 |
| Bug Hunt: исправленные ошибки из 105 | 18,0 | 32,7 |
| Agent Arena: изменение качества | +2,34% | +14,80% |
По этой тестовой корзине расход у двух поколений практически одинаковый, а совокупные результаты Hydrogen гораздо выше. Важно учитывать разброс по типам задач: некоторые независимые пользовательские тесты коротких запросов показали существенно более высокую стоимость Hydrogen, несмотря на выигрыш в качестве и времени. Эти примеры рассмотрим в разделе об отзывах.
Сильные стороны и слабости: почему результаты Hydrogen так различаются
Анализ данных: одна из самых сильных областей
В разделе Data Analysis теста LiveBench Hydrogen набрала 83,2 балла и заняла третье место среди 35 моделей. Впереди только Carbon (86,5) и Argon (85,2); позади, в частности, Astra (83,0), Sol (82,7) и Claude Fable 5.2 (81,5).
Есть и отдельная проверка от Plotly, разработчика инструментов визуализации данных. В тесте DataAnalyticsBench модели выполняли 43 аналитических задания, включая поиск скрытых закономерностей и ошибок в исходных данных. Hydrogen и Sol выполнили 43 из 43 заданий, Carbon - 42, Argon - 41. При одинаковом максимальном результате Sol оказалась быстрее и дешевле: медиана 18 секунд против 32 на задание, а полный запуск стоил $2,61 против $6,36 у Hydrogen. Исследование Plotly.
Так что Hydrogen действительно сильна в обработке таблиц, преобразовании данных и создании отчётов. Преимущество в одно-два задания над Carbon и Argon в эксперименте Plotly ещё стоит проверять повторными прогонами: каждая модель проходила набор один раз.
Агентная работа: особенно хорошо реагирует на замечания
В Agent Arena измеряется работа ИИ-агентов - программ, которые выполняют задачи при помощи инструментов и получают обратную связь. Hydrogen набрала +14,80% по общему показателю Net Improvement и заняла пятое место. Ещё заметнее Steerability - 20,53%, второе место. Этот показатель характеризует способность агента исправить работу после замечания пользователя. У Carbon он равен 19,06%, у Opus 5.5 - 18,41%, у Sol - 13,25%; выше Hydrogen оказалась Fable 5.2 с 32,91%.
Для пользователя это означает хорошую работу в цикле «сделай первый вариант - получи замечания - исправь». Но у модели возникают сложности, когда проблему надо сначала самостоятельно обнаружить и только потом исправить.
Программирование: удачная миграция кода и более слабый Bug Hunt
| Что проверяют | Hydrogen | Для сравнения |
|---|---|---|
| Vals Code Migration: перенос работающей программы на другой язык | 82,7% | Carbon 80,1%; Argon 74,4%; Sonnet 87,4% |
| Arena WebDev: создание веб-интерфейсов | 1704 Elo | Argon 1681; Sol 1743; Carbon 1768 |
| Bug Hunt: самостоятельный поиск и исправление неизвестных ошибок | 32,7 из 105 | Argon 40,7; Sol 44,3; Carbon 57,3 |
Разница между двумя типами программирования важна. В Code Migration есть рабочая программа: модель должна перенести известное поведение на другой язык. В Bug Hunt дают репозиторий с неизвестными ошибками; агенту приходится самому выяснять, где они и как их проверить. Hydrogen хорошо выполняет первое, но по второму тесту уступает соседям.
В трёх попытках Bug Hunt Hydrogen исправила 43, 27 и 28 ошибок. Такой разброс показывает, что результат может сильно меняться от прогона к прогону. Кроме того, участники использовали разные агентные инструменты, что тоже влияет на итог. Однако модель вполне способна находить сложные ошибки: например, в тесте MindStudio она самостоятельно обнаружила серверную ошибку, из-за которой цены в японских и корейских вонах показывались в сто раз меньше.
Вывод для практики: Hydrogen подходит для реализации известной задачи и последовательных правок. Для поиска редких дефектов в большом репозитории желательно сравнить её с Sol или Carbon и обязательно запускать тесты после изменений.
Научные задачи: ответы на вопросы и длительная работа - разные навыки
В тесте HLE-Diamond на сложные экспертные вопросы Hydrogen набрала 58,8%, столько же, сколько Sol. В Terminal-Bench-Science, где нужно выполнять многошаговые исследования с программами, расчётами и инструментами, её результат составил 49,5%. Sol получила 58,1%, Terra - 57,6%, Argon - 52,9%.
Модель может хорошо отвечать на сложный вопрос, но при длительной работе с несколькими этапами допускать больше ошибок. Поэтому для исследовательских задач, где важны воспроизводимые расчёты, полезно проверить более сильные альтернативы.
Налоговые, финансовые и юридические документы
В Vals Tax Agent Hydrogen получила 52,30%, опередив Carbon (51,78%) и Argon (49,22%). В Vals Finance Index у неё 66,14%, а в Legal Research - 53,85%. Результаты показывают потенциал модели в структурированных документах, расчётах и работе со ссылками на нормативные материалы. Отличие от Carbon в налоговом тесте составляет всего 0,52 процентного пункта, поэтому говорить о значительном отрыве оснований нет.
Здесь нужна особая осторожность при практическом применении: финансовые и юридические документы могут содержать ошибки с высокой ценой последствий. Их стоит проверять специалисту независимо от выбранной модели.
Визуальные документы и сложные рассуждения
Сильный анализ таблиц не означает столь же высокую точность распознавания сложных схем или PDF с необычной вёрсткой. В независимой оценке MKA по работе с визуальными документами Hydrogen получила 49,52%. В LiveBench Reasoning, проверяющем сложные рассуждения, её балл 88,6, тогда как у Argon 95,1.
Полезно разделять задачи: обработка понятной таблицы или отчёта - одна сильная область Hydrogen, а трактовка неочевидной схемы, противоречивого документа или сложной логической ситуации требует дополнительной проверки.
Две модели с одинаковым общим результатом, но разным профилем
Хороший пример - Hydrogen и Claude Sonnet 5.5. В общем LiveBench обе получили 77,0, однако внутри теста результаты совсем разные.
| Категория LiveBench | Hydrogen | Sonnet 5.5 |
|---|---|---|
| Анализ данных | 83,2 | 59,5 |
| Программирование | 78,5 | 77,2 |
| Использование браузера | 77,1 | 89,3 |
| Сложные рассуждения | 88,6 | 91,6 |
Hydrogen опережает Sonnet на 23,7 балла по анализу данных, зато уступает на 12,2 балла по работе в браузере. При этом по общей тестовой корзине Hydrogen примерно в 2,8 раза дешевле Sonnet. Такой профиль объясняет, почему выбирать модель только по одному общему месту бывает ошибкой.
Что говорят разработчики и сообщество
Первые обсуждения на Hacker News и Reddit скорее положительные. Пользователи отмечают ощутимый скачок относительно Gemini 3.8 Flash, быстрый отклик, обработку документов и генерацию интерфейсов. При сравнении с Carbon, Argon и моделями Claude мнения расходятся. Это подборка конкретных опытов, а не голосование всех пользователей, поэтому интереснее смотреть на сами задания.
Первые тесты компаний
В анонсе Google приведены кейсы партнёров, получивших ранний доступ к Hydrogen. Они показывают возможные сценарии, а числа относятся к испытаниям самих компаний.
| Компания | Что проверяли | Результат |
|---|---|---|
| Box | Обработка крупных корпоративных документов и таблиц | Примерно вдвое быстрее 3.8 Flash, на 12% меньше токенов по сообщениям Box |
| Pixelcut | 276 задач на создание дизайна | Компания сообщает о выполнении всех заданий и ускорении в 1,8 раза |
| Cartwheel | Сложная техническая проблема, над которой команда работала с другими моделями | Hydrogen нашла две проблемы в подходе и предложила исправление |
| LatchBio | Задачи по токсикологии и безопасности разработки антител | 67% успешных попыток против 37% у лучшей модели вне Gemini в собственном тесте |
| STAN | Соблюдение заданного формата ответа и скорость | Компания сообщила о сокращении задержки на 28%, расхода токенов на 23% |
Отзывы компаний в анонсе Google.
Независимые эксперименты
Puter проверила склонность выдумывать факты. Исследователи составили 16 вопросов с недостающей или намеренно неверной информацией и задали каждый по три раза Hydrogen и Gemini 3.8 Flash. Из 48 ответов каждой модели у Hydrogen был один ответ с ложной фактической деталью, у предыдущей Flash - шесть. Медианное время ответа составило 3,2 против 4,7 секунды, но 48 запросов Hydrogen стоили $0,232 против $0,047 у 3.8 Flash. Это полезное предостережение: скорость и качество могут улучшиться одновременно с увеличением фактической стоимости отдельных задач. Исследование Puter.
MindStudio испытала поиск ошибок и анализ кредитной заявки. В одном кейсе Hydrogen сама нашла причину неверного отображения цен в иностранной валюте. В другом организовала работу четырёх субагентов и выявила в кредитных документах риски кассовых разрывов, концентрации клиентов и недостаточного обеспечения. Это показывает, что модель способна делать сложную самостоятельную работу, хотя средние результаты Bug Hunt остаются ниже, чем у ряда конкурентов. Практический обзор MindStudio.
Reddit: удачные задачи и конкретные провалы
Проверка печатных плат. Пользователь r/google_antigravity использовал несколько моделей для проверки электронной платы и сообщил, что Hydrogen заметила вопросы целостности сигналов, пропущенные Carbon, Argon и Opus. Вместе с полезными замечаниями были и ложноположительные находки. Это пример использования модели как дополнительного проверяющего.
Финансовые PDF. В r/Bard пользователь описал обработку двух-трёх финансовых PDF по 5-8 страниц. По его словам, Hydrogen Medium подготовила анализ за 3-4 секунды при небольшом расходе квоты подписки, тогда как Argon ранее требовала около двух минут. Результат зависит от конкретных документов и тарифного плана.
Неудача с игровым ИИ. В r/GeminiAI разработчик сообщил, что Hydrogen внесла много ошибок при расширении логики игрового движка, после чего Carbon нашла и исправила часть дефектов. Это хороший контрпример к восторгам об автономном программировании.
Hacker News: на что обращают внимание опытные разработчики
Скорость не всегда равна экономии. Участник data-ottawa измерил в собственных задачах сокращение времени Hydrogen до 40-60% от времени предыдущей Flash, но стоимость одного задания у него оказалась на 37% выше. В ряде других обсуждений пользователи отмечают разное списание квот в Antigravity и приложении Gemini.
Быстрая модель в роли исполнителя. Разработчики обсуждают схемы, где более сильная модель составляет план, а Hydrogen выполняет операции с файлами и кодом. Это соответствует подходу Orchestrator от Google. Но если планировщик плохо распределяет задачи, возможная экономия уменьшается. В ветке Orchestrator приводятся и примеры аналогичных систем, построенных из моделей других компаний.
Редкие ошибки агента могут быть дорогостоящими. Один из участников Hacker News описал ситуации, когда агент делает лишние действия, продолжает работу после завершения задачи или меняет файлы, которых не просили касаться. Для автономной работы с реальным проектом такие риски иногда важнее среднего балла бенчмарка.
Как интерпретировать отзывы в целом
Пользователи и компании чаще всего хвалят Hydrogen за скорость, работу с данными и возможность быстро доводить результат по замечаниям. Основные претензии касаются непредсказуемой стоимости конкретных заданий, ошибок в сложных проектах и лимитов подписки. Картина соответствует нашим профильным тестам, но добавляет важное уточнение: даже при невысоком среднем Bug Hunt модель способна успешно диагностировать отдельные нетривиальные проблемы.
Для каких задач выбирать Hydrogen, а когда есть варианты выгоднее
| Сценарий | Стоит ли выбирать Hydrogen | Что учитывать |
|---|---|---|
| Анализ таблиц и подготовка отчётов | Один из лучших кандидатов | 83,2 в LiveBench Data Analysis, 43/43 у Plotly; Sol может быть дешевле |
| Повторные правки кода и документов | Хороший выбор | Второе место Steerability, быстро реагирует на обратную связь |
| Перенос программы на другой язык | Хороший выбор | 82,7% в Code Migration; финальные тесты программы всё равно нужны |
| Быстрое создание прототипа интерфейса | Подходит | Хорошие примеры 3D-интерфейсов, возможны недоработки и дефекты |
| Массовые недорогие API-задачи | Сначала сравнить с Terra, DeepSeek, MiMo | Они существенно дешевле на нашей корзине |
| Самостоятельный поиск неизвестных ошибок в большом проекте | Проверить Sol или Carbon | В Bug Hunt Hydrogen исправила меньше дефектов |
| Долгое исследование с инструментами и расчётами | Испытать более сильные модели | Результат Terminal-Bench-Science ниже ряда конкурентов |
| Налоговые и юридические материалы | Возможна как помощник | Сильные профильные тесты, требуется проверка специалиста |
| Работа в оплаченной подписке | Смотреть на лимиты продукта | API-индекс стоимости не показывает, сколько задач удастся выполнить по тарифу |
Вывод
Gemini 4 Hydrogen - быстрая модель высокого класса с заметной специализацией. Она заняла 8-е место из 23 по индексу интеллекта GPTunnel, вошла в тройку сильнейших моделей LiveBench по анализу данных и оказалась одной из самых быстрых по расчётному времени Artificial Analysis.
Её сильные стороны - обработка таблиц, миграция существующего кода, выполнение понятных задач с инструментами и правки по обратной связи. Более слабые результаты в Bug Hunt и научных агентных тестах напоминают, что для длительной автономной разработки и сложной диагностики могут подойти другие модели. Первые пользовательские кейсы подтверждают и сильные стороны, и ограничения.
Главный выбор для пользователя: Sol лучше по общему интеллекту и обходится дешевле, Hydrogen заметно быстрее; Terra обеспечивает близкую скорость при значительно меньшей стоимости; Carbon сильнее, но медленнее и дороже. При выборе стоит оценивать, что именно должна сделать модель, сколько стоит успешный результат и сколько времени можно ждать.
Источники и подробности методики
Шесть основных тестов: Artificial Analysis, Vals Index, LiveBench, Arena WebDev, Agent Arena, Bug Hunt Bench. Все численные результаты общего рейтинга взяты из объединённого среза GPTunnel на 13 ноября 2026 года.
Индекс интеллекта: для каждого теста берётся разница между результатом модели и средним по фиксированной группе из 16 моделей, разделённая на стандартное отклонение этой группы. Итоговый балл равен 50 + 10 × взвешенное среднее нормализованных результатов. Веса: 13,33% для AA, Vals и LiveBench, 25% для WebDev, 17,5% для Agent Arena и Bug Hunt. Для моделей с пятью результатами прогнозируется только один отсутствующий тест; в таблице реальный пропуск виден. Это статистическое сравнение в пределах выбранной программы тестов, а не измерение абсолютного интеллекта.
Индекс стоимости: стоимость задания на AA, LiveBench и WebDev делится на фиксированную опорную цену каждого теста; затем вычисляется геометрическое среднее трёх отношений с одинаковым весом. Опорные цены на нашем срезе: $5,225 (AA), $1,873 (LiveBench), $1,475 (WebDev). Формула: C = [(AA/R_AA) × (LiveBench/R_LB) × (WebDev/R_WD)]^(1/3). Так как шкала отношений едина, деление индекса одной модели на индекс другой показывает их относительную дороговизну на этой корзине заданий. В одном случае из 23 (GLM 5.3) используется прогноз одного отсутствующего измерения стоимости; Muse Wonder Full не получила итоговый ценовой индекс.
Особенности измерений: результаты разных бенчмарков получены в опубликованных ими конфигурациях модели и инструментов. Агентные тесты могут зависеть от среды выполнения. Время AA рассчитано для типового тестового задания AA и не заменяет фактические задержки в конкретном приложении.
Дополнительные проверки: Plotly, Puter, MindStudio, Simon Willison, Hacker News о Hydrogen, Hacker News об Orchestrator, корпоративные кейсы Google.