
Разработчики искусственного интеллекта соревнуются в размере контекстного окна: чем больше информации модель может обработать за один раз, тем лучше. Однако исследователи NVIDIA поставили под сомнение эту логику. В их экспериментах нейросети успешно решали сложные задачи, даже когда историю работы сокращали после каждого действия. Разбираемся, как это возможно, что говорят другие исследования и сколько контекста ИИ использует в реальности.
Почему нейросетям постоянно увеличивают контекст
Представьте, что вы несколько часов работаете с ChatGPT над сложным проектом. Вы обсуждаете архитектуру, исправляете ошибки, загружаете документы, меняете требования и постепенно приближаетесь к результату.
Чтобы ответить на очередной вопрос, нейросети может потребоваться информация из предыдущих сообщений. Чем длиннее диалог, тем больше данных приходится учитывать.
Это и есть контекст - информация, доступная языковой модели во время обработки очередного запроса. Контекстное окно измеряется в токенах: небольших фрагментах текста. В контекст входят сообщения, инструкции, документы, ответы инструментов и история действий ИИ-агента.
Большое окно позволяет обрабатывать объёмные материалы без предварительного сокращения. Поэтому увеличение его размера воспринимается как технологическое преимущество. Но действительно ли нейросети нужно постоянно держать перед собой всю историю?
В ноябре 2026 года исследователи NVIDIA опубликовали работу You Don't Need Long Context, в которой попытались ответить на этот вопрос экспериментально.
Исследование NVIDIA: нейросети могут обходиться коротким контекстом
Авторы проверяли, насколько сильно сокращение контекста влияет на выполнение длительных и сложных задач. Среди тестов - SWE-bench Verified и Terminal-Bench 2.1, где агентам необходимо исследовать программные проекты, исправлять ошибки, запускать команды и использовать результаты предыдущих действий.
Были сопоставлены три режима:
- Полная история. Модель получает накопленную переписку и результаты предыдущих шагов.
- Периодическое сжатие. При достижении порога история сокращается до важных фактов и состояния задачи.
- Сжатие после каждого действия. После каждого шага агент сохраняет краткое описание состояния и продолжает работу с новой историей.
Третий режим, single-action compaction (SAC), особенно интересен. Вместо нарастающей цепочки сообщений агенту достаточно сохранить краткую рабочую память: что уже сделано, к какому выводу он пришёл и какой шаг необходим дальше.
Результаты: 7-9 тысяч токенов вместо огромной истории
| Модель и тест | Полная история | Сжатие после каждого действия | Медианный пиковый контекст SAC |
|---|---|---|---|
| Claude Opus 4.5, SWE-bench Verified | 70,0% | 70,2% | 8 тыс. |
| Claude Opus 4.5, Terminal-Bench 2.1 | 47,2% | 51,8% | 9 тыс. |
| GPT-5.6 Sol, SWE-bench Verified | 84,4% | 82,4% | 7 тыс. |
| GPT-5.6 Sol, Terminal-Bench 2.1 | 87,6% | 84,3% | 8 тыс. |
Источник: NVIDIA, таблица 2. Контекст SAC - медиана максимального размера контекста на задачу, а не суммарный расход токенов за сессию.
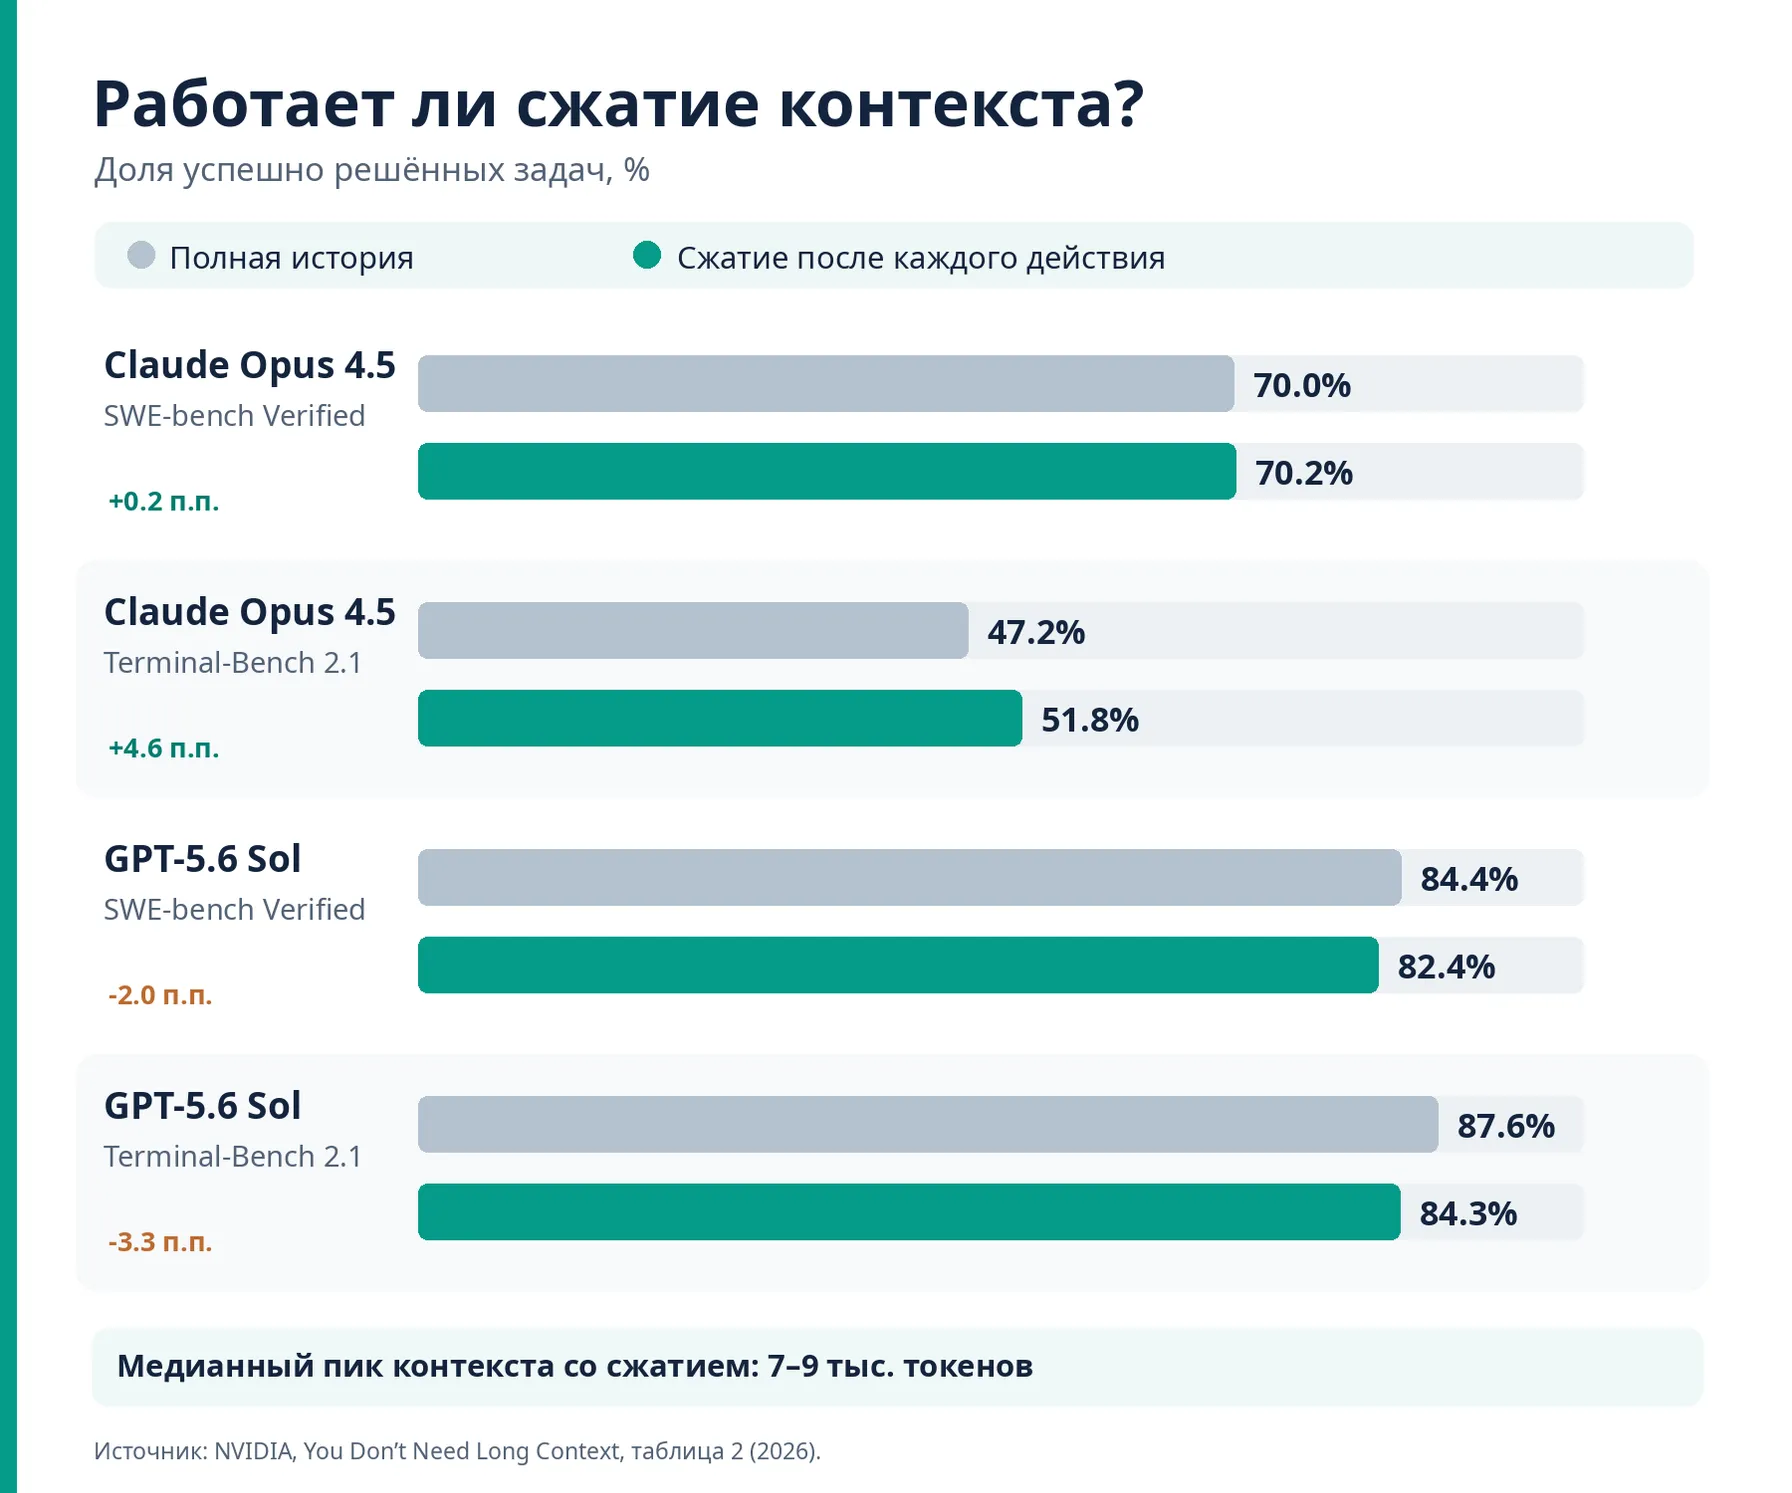
Рисунок 1. В экспериментах NVIDIA сжатие после каждого действия почти не изменило результаты Claude Opus 4.5, но снизило показатели GPT-5.6 Sol на 2-3,3 процентного пункта. Источник данных: NVIDIA, таблица 2.
Claude Opus 4.5 сохранил результат на SWE-bench Verified, а на Terminal-Bench даже улучшил его на 4,6 процентного пункта. GPT-5.6 Sol оказался чувствительнее: оценки снизились на 2,0 и 3,3 пункта соответственно.
В этих экспериментах медиана максимального размера активного контекста со сжатием составляла лишь 7-9 тысяч токенов, хотя отдельные задачи в исходном режиме накапливали гораздо более длинную историю. Максимальный размер контекста с SAC снизился до 15-37 тысяч токенов против 130-200 тысяч токенов при полной истории.
Это не доказательство того, что все задачи можно решить с контекстным окном 8 тысяч токенов. Оно показывает: при определённой организации работы агенту не обязательно одновременно видеть всю последовательность собственных действий.
Как нейросеть может работать, не помня весь диалог
Представим ИИ-агента, который исправляет ошибку при оформлении заказа в интернет-магазине. За время работы он прочитал файлы, просмотрел логи, запустил тесты и несколько раз исправил код. В полной истории сохраняются полезные решения, неудачные попытки, промежуточные ответы инструментов и длинные технические журналы.
Для следующего действия агенту может быть достаточно короткой записи:
- Цель: исправить ошибку оформления заказа.
- Причина: неверно рассчитывалась стоимость доставки.
- Исправление: изменён метод расчёта в нужном модуле.
- Проверка: основные тесты проходят.
- Следующий шаг: проверить заказ с промокодом.
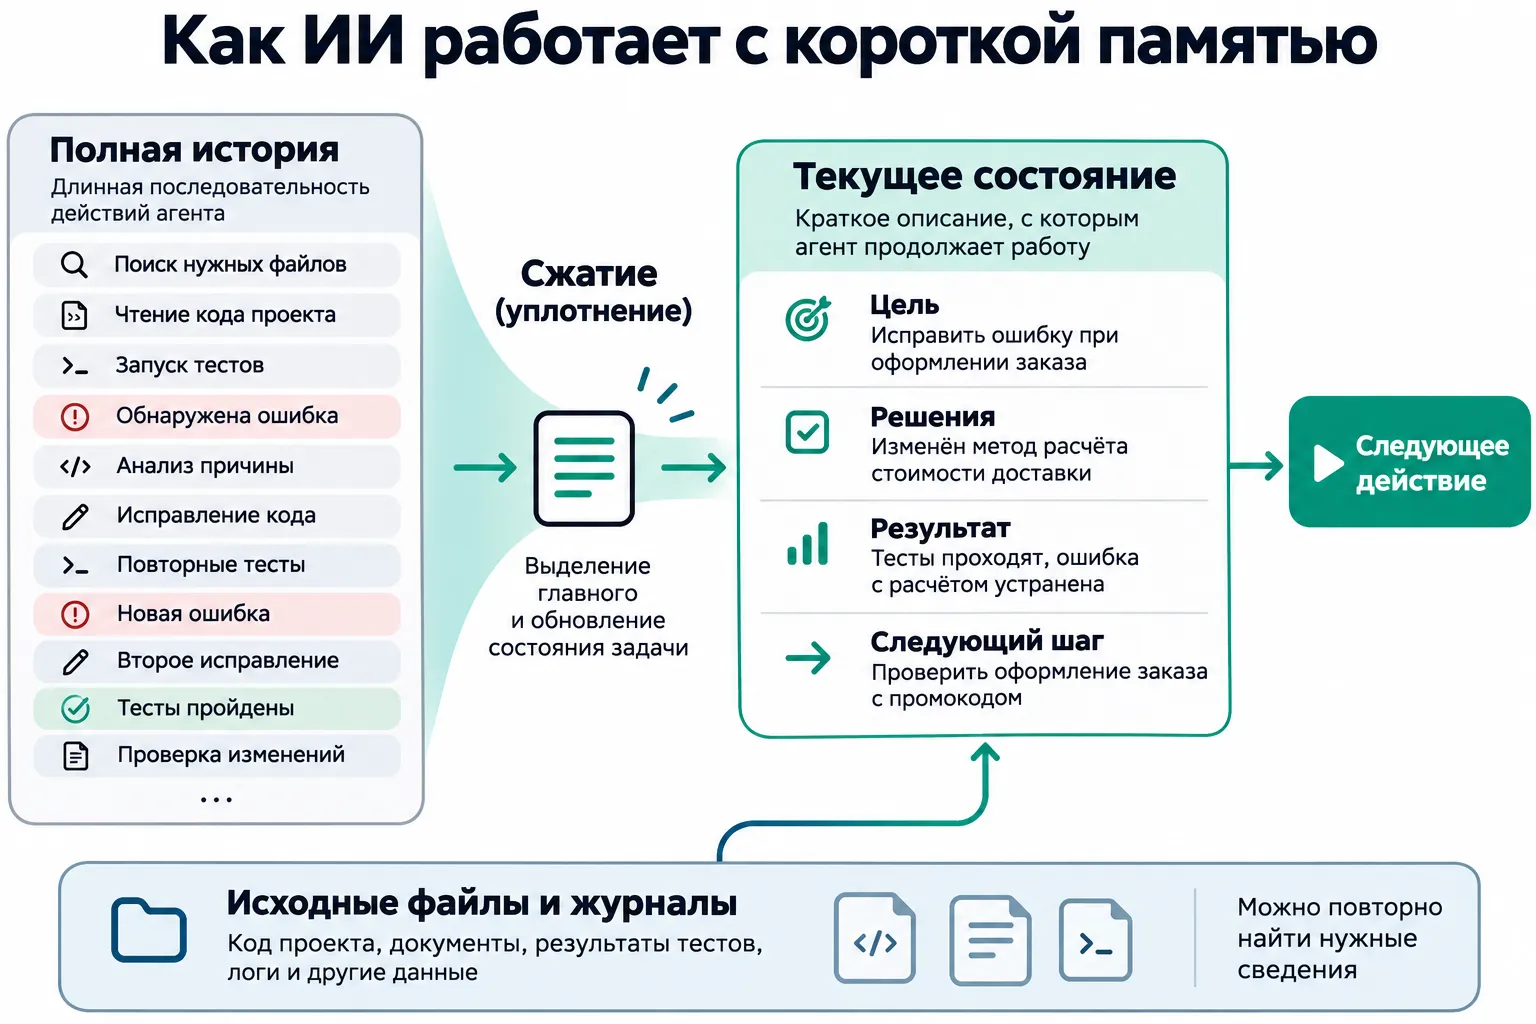
Рисунок 2. Принцип сжатия контекста: агент сохраняет текущее состояние задачи и следующее действие, а исходные файлы, документы и логи остаются доступны для повторного чтения. Схема подготовлена для статьи по мотивам подхода NVIDIA.
Здесь есть важная оговорка: исходные данные не обязательно удаляются. Код, документы и результаты тестов могут храниться во внешней среде, где модель при необходимости откроет нужный файл заново.
Такой подход напоминает рабочий блокнот человека: мы сохраняем главное, а подробности извлекаем из документов тогда, когда они снова понадобятся.
Почему загрузить документ целиком - не всегда лучший способ его прочитать
Сжатие диалога - только часть исследования. Авторы NVIDIA также проверили выборочное чтение больших документов. Вместо того чтобы загружать тысячи страниц непосредственно в контекст, агент мог просматривать исходные файлы инструментами поиска и чтения.
Представим вопрос о выручке компании за пять лет. Можно передать модели все финансовые отчёты сразу. А можно сначала найти подходящие документы, затем открыть таблицы с выручкой и только после этого сопоставить цифры.
В одной из экспериментальных конфигураций на тесте LOONG средняя оценка Claude Opus 4.5 выросла с 70,1 до 79,8, а GPT-5.6 Sol - с 79,3 до 84,6 при использовании выборочного чтения и управления контекстом.
Результат не означает, что выборочное чтение всегда лучше: алгоритм поиска может пропустить важный фрагмент. Однако он показывает, что размер исходной информации и размер информации, которую нужно одновременно удерживать в контексте, - разные величины.
Длинный контекст может ухудшать ответы
Lost in the Middle: информация теряется в середине
В исследовании Lost in the Middle (2024) авторы изучили, как языковые модели используют длинные документы. Для многих протестированных моделей ответ зависел от положения релевантной информации: они лучше справлялись, когда нужный фрагмент находился ближе к началу или концу входного текста, и чаще ошибались, когда он оказывался в середине.
Следовательно, возможность принять большой контекст ещё не гарантирует одинаково качественного использования всех его частей.
NoLiMa: без буквальных подсказок длинный контекст сложнее
Работа NoLiMa (2025) проверяет задачи, где нельзя просто найти в документе слова, совпадающие с вопросом. Нужны смысловые связи. На 32 тысячах токенов десять из двенадцати протестированных моделей показали менее половины своего результата на коротком контексте. У GPT-4o оценка в эксперименте сократилась с 99,3% до 69,7%.
Тест относится к конкретным версиям моделей и задачам. Тем не менее он показывает разницу между максимальной технической длиной входа и эффективным использованием информации.
Context Rot: чем больше постороннего текста, тем труднее найти главное
В исследовании Context Rot (Chroma, 2025) на 18 моделях изучалось ухудшение качества ответов по мере роста входного текста. Особенно заметными трудности становились при наличии отвлекающих сведений и задач, где важны смысловые связи.
Общий вывод трёх работ: релевантность, структура и расположение информации способны сильно влиять на итоговый ответ.
А сколько контекста используется в реальных запросах? Данные OpenRouter
По данным OpenRouter, средний объём входных токенов одного API-запроса вырос примерно в четыре раза с начала 2024 года, достигнув более 6000 токенов к концу 2025 года.
Поскольку входные токены включают передаваемую модели историю переписки, системные инструкции и другие данные, показатель отражает средний объём информации на входе модели при отдельном обращении.
Однако он не позволяет определить максимальную длину контекста пользовательской сессии. Для этого необходимо измерять максимальный объём контекста каждого диалога и рассчитывать распределение по сессиям, включая медиану, 90-й и 95-й процентили.
Harvard: реальные программные агенты используют гораздо большие контексты
На первый взгляд данные OpenRouter могут создавать впечатление, будто длинные контексты почти не нужны. Но более специализированное исследование показывает другую картину.
В ноябре 2026 года Harvard Systems Group опубликовала From Requests to Sessions - исследование примерно 12 тысяч реальных сессий программных агентов, включавших около 1,2 миллиона обращений к моделям и 209 миллиардов входных токенов.
В этих трассировках медианный запрос содержал 129,1 тысячи входных токенов. Медиана новых, не извлечённых из кеша входных токенов составляла лишь 491 токен, а медианный ответ - 227 токенов.
Это объясняется работой с кешем: ИИ-агент многократно передаёт модели предыдущий контекст, но большая его часть может повторно использовать уже обработанный префикс. Среди запросов с известными данными кеширования кешированные токены составляли 97,4% объёма входа и 72,9% расчётной стоимости API.
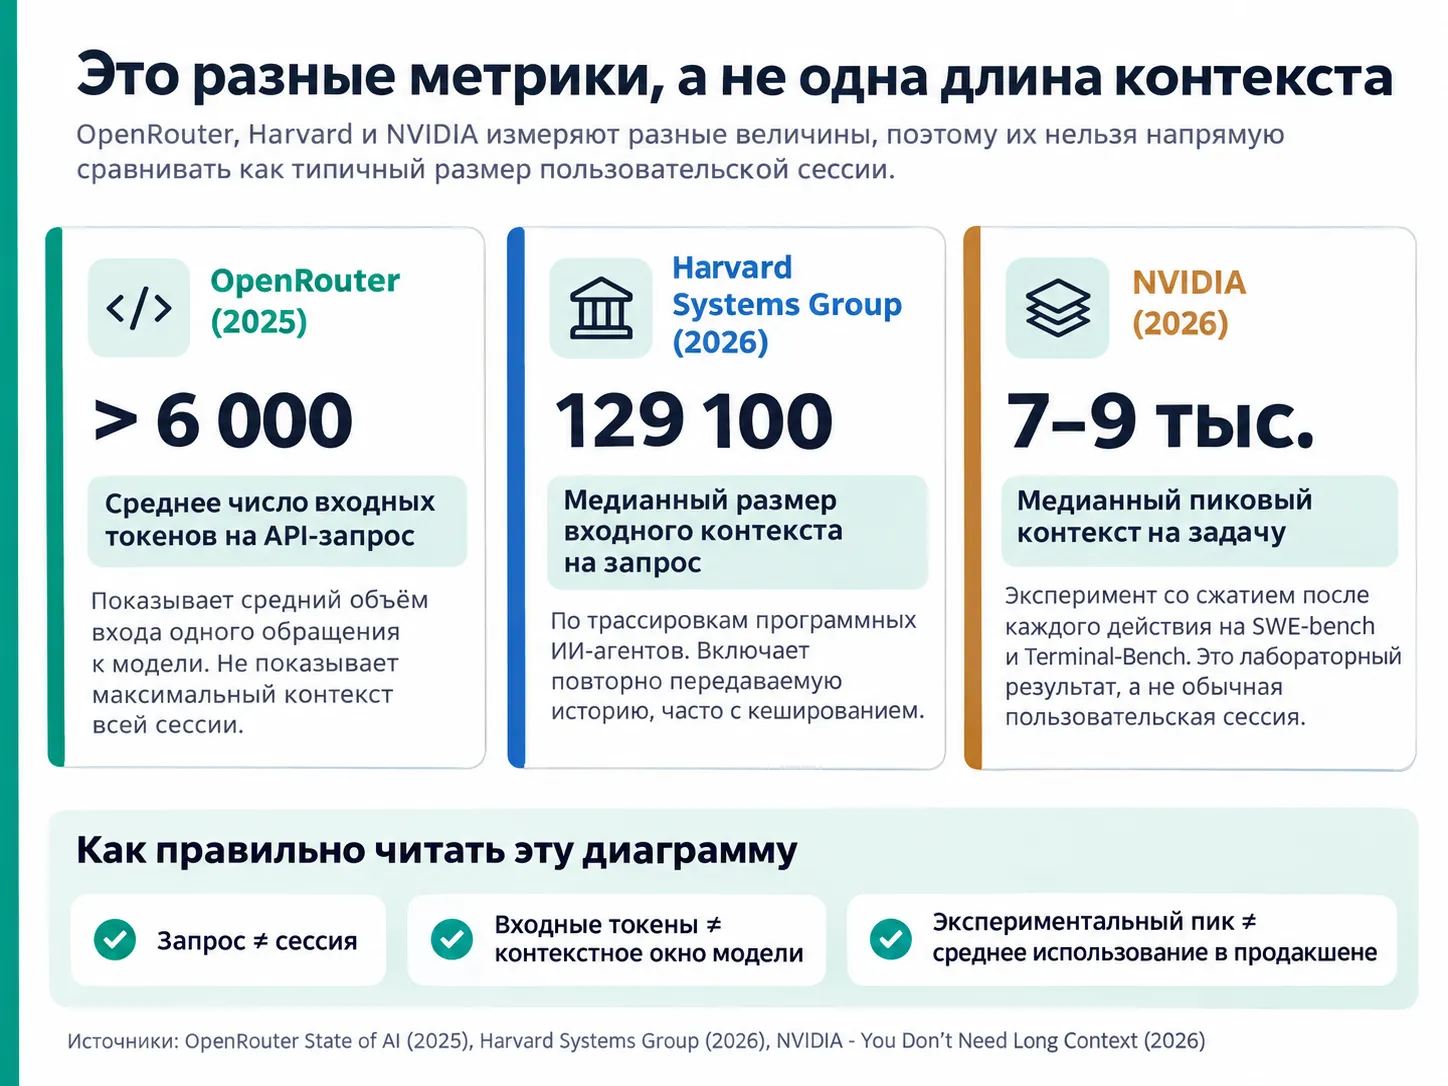
Рисунок 3. По данным OpenRouter, средний входной запрос в конце 2025 года превышал 6 тысяч токенов. В выборке программных агентов Harvard медиана входного запроса была 129,1 тысячи. В эксперименте NVIDIA медианный пиковый активный контекст со сжатием составлял 7-9 тысяч. Это разные выборки и метрики; график не показывает распределение размеров пользовательских сессий.
На первый взгляд возникает противоречие: NVIDIA демонстрирует возможность работать с существенно более коротким активным контекстом, тогда как реальные программные агенты передают длинную историю.
На практике это вопрос не только качества, но и архитектуры вычислений. Повторно использовать кешированный префикс может быть выгодно, а частое сжатие способно нарушать кеширование и требовать дополнительных вычислений. Универсально оптимального подхода для всех моделей и задач пока нет.
Сравнивать медиану 129,1 тысячи токенов в реальных запросах Harvard с медианным пиком 7-9 тысяч в управляемом эксперименте NVIDIA как значения одного распределения нельзя.
Почему длинный контекст обходится дороже
Контекст влияет на задержку, вычислительную нагрузку и требования к памяти. При генерации новых токенов модель продолжает учитывать предыдущие, а цена такого вычисления зависит от глубины контекста и особенностей архитектуры.
В исследовании NVIDIA измерили производительность ряда открытых моделей на ускорителях H100. При переходе от окна 16K к 256K расчётная себестоимость генерации выходного токена выросла:
| Модель | Рост вычислительных затрат при 256K против 16K |
|---|---|
| GLM 5.2 | 3,6 раза |
| Kimi K2.6 | 5,6 раза |
| Qwen 3 Coder Next | 7 раз |
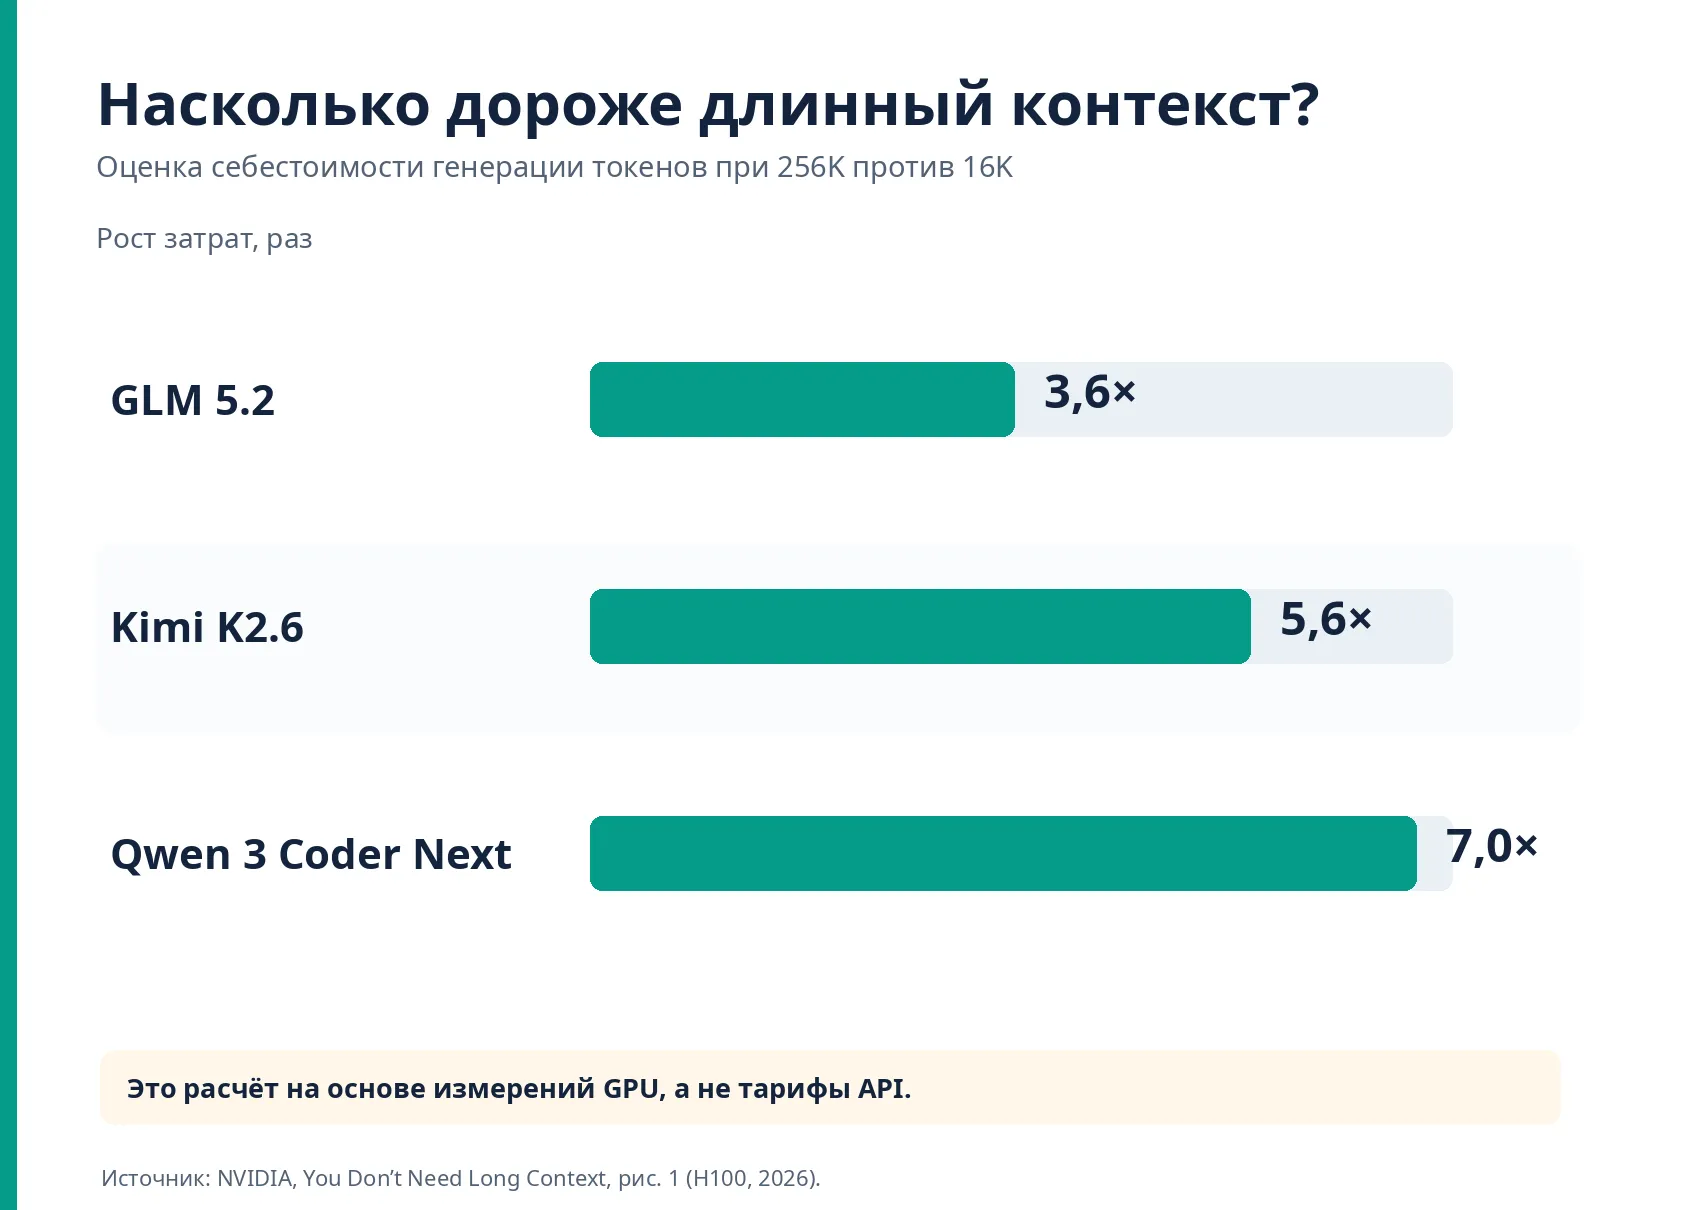
Рисунок 4. Оценка NVIDIA на основе измеренной пропускной способности GPU H100 и стоимости GPU-часов. Показаны относительные затраты на генерацию токенов при контексте 256K против 16K, не тарифы API для пользователей. Источник: NVIDIA, рисунок 1.
Эти цифры нельзя интерпретировать как обещанное снижение цены подписки или стоимость конкретного API-запроса. Фактический счёт зависит от входных и выходных токенов, кеширования, тарифа, оборудования и количества дополнительных действий агента.
Но для провайдеров нейросетей потенциальный эффект заметен: при удачном управлении коротким активным контекстом можно снизить вычислительные затраты или обслуживать больше запросов на той же инфраструктуре.
Когда короткий контекст проигрывает
Исследование NVIDIA содержит и контрпримеры. На SWE-bench Verified модель Qwen 3 Coder Next показала 53,0% с полной историей, но лишь 3,6% при особенно жёстком режиме периодического сжатия с лимитом 16K и порогом 12K. Это отдельный режим EoCC, а не тот же SAC, который использовался в основной сравнительной таблице Claude и GPT.
Авторы связывают потерю качества с длинными траекториями действий модели: до следующего сжатия она не успевала добиться полезного прогресса. Этот результат показывает, что стратегия управления контекстом должна подходить конкретной модели.
Большой контекст также сохраняет значение там, где нужно одновременно сопоставить множество точных фрагментов и деталей. Любая сводка может упустить факт, который станет важным позднее. А выборочный поиск может не найти нужный документ.
Нейросети будущего: обновляемое состояние вместо бесконечной истории
Исследователи NVIDIA предложили концепцию Semantic State Space Models (SSSM). Идея: модель получает краткое описание состояния задачи, принимает решение, выполняет действие, фиксирует результат и обновляет семантическое состояние для следующего шага.
Схематично: текущее состояние → решение → действие → результат → обновлённое состояние.
Это пока архитектурная гипотеза и предложение для будущего обучения моделей. В работе не представлена отдельная полностью обученная SSSM, которая доказала бы универсальное превосходство над обычными длинноконтекстными моделями.
Идеи многоуровневой памяти развивались и раньше. Например, в MemGPT (2023) предлагалось разграничить активный контекст и внешние хранилища, извлекая данные по необходимости.
Что это означает для пользователей ChatGPT и других нейросетей
Практический вывод: длинный диалог необязательно продолжать бесконечно. При работе над проектом несколько часов или дней может помочь промежуточная фиксация состояния.
Например, после завершения этапа можно попросить нейросеть:
Составь структурированное резюме нашей работы: цель, принятые решения, важные факты, ограничения, обнаруженные проблемы и следующие шаги. Отдельно перечисли сведения, которые нельзя потерять, и вопросы, которые ещё не решены.
Такую сводку удобно использовать при продолжении в новом чате. Но резюме не заменяет оригиналы: файлы, документы, код, исходные расчёты и полные результаты тестов следует сохранять отдельно.
Для разработчиков ИИ-приложений вывод ещё важнее. Стоит измерять не только размер контекста и стоимость входных токенов, но и качество выбора полезной информации, частоту повторных обращений к исходным файлам, эффективность кеширования и цену полного решения задачи.
Вывод: нейросетям нужна не самая большая память, а самая полезная
Исследование NVIDIA не отменяет преимущества моделей с длинным контекстом. Оно показывает, что для ряда сложных задач объём информации, одновременно доступной модели, можно существенно сократить без катастрофического падения качества.
Другие работы подтверждают, что большой контекст не гарантирует одинаково надёжного использования всех его частей. А реальные производственные трассировки Harvard показывают, что программные агенты сегодня всё равно могут передавать сотни тысяч токенов за запрос.
Наиболее перспективным выглядит сочетание нескольких механизмов: короткого текущего состояния, доступа к полным материалам, точного поиска и эффективного кеширования.
Возможно, в будущем ключевой характеристикой ИИ-систем станет способность выбирать, что стоит помнить в данный момент, а не только максимальное число токенов, которое они могут обработать за один раз.